【自然语言处理】Transformer 模型中的专家混合(Mixture of Experts,MoE)架构

技术前沿 |【大型深度学习模型中的多面手:混合专家(Mixture of Experts,MoE)机制详解】 本文将带您走进MoE的世界,了解其基本概念、原理、应用场景以及与其他注意力机制的比较,并对未来的发展进行展望。不同的专家模型可以处理不同类型的输入或任务部分,从而实现对复杂任务的全面覆盖。这些专家模型各自擅长处理不同的输入或任务部分,而MoE机制则负责根据输入的特点动态地选择最合适的专家模型进行处理。MoE机制可以根据输入的特点动态地选择最合适的专家模型进行处理,因此具有很高的灵活性。相比之下,传统的注意力机制通常只能对输入进行固定的处理,无法根据输入的特点进行动态调整。 阅读详情

【精选优质专栏推荐】


每个专栏均配有案例与图文讲解,循序渐进,适合新手与进阶学习者,欢迎订阅。

在这里插入图片描述

Transformer 模型在许多自然语言处理任务中表现出极高的有效性。虽然通过增加模型维度和层数可以提升其能力,但这也会显著增加计算复杂度。专家混合(Mixture of Experts, MoE)架构提供了一种优雅的解决方案:通过引入稀疏性,使模型能够高效扩展,而无需按比例增加计算成本。

在本文中,你将了解 Transformer 模型中的专家混合架构,具体包括:

  • 为什么 MoE 架构对于高效扩展 Transformer 模型是必要的

  • MoE 的工作原理及其关键组成部分

  • 如何在 Transformer 模型中实现 MoE

为什么 Transformer 需要专家混合架构

专家混合(Mixture of Experts, MoE)概念最早由 Jacobs 等人在 1991 年提出。它使用多个“专家”模型处理输入,并通过“门控”机制选择使用哪一个专家。

MoE 在 2021 年的 Switch Transformer 和 2024 年的 Mixtral 模型中得到了复兴。在 Transformer 模型中,MoE 对每个输入仅激活部分参数,这使得可以定义大规模模型,同时每次计算只使用其中的一部分。

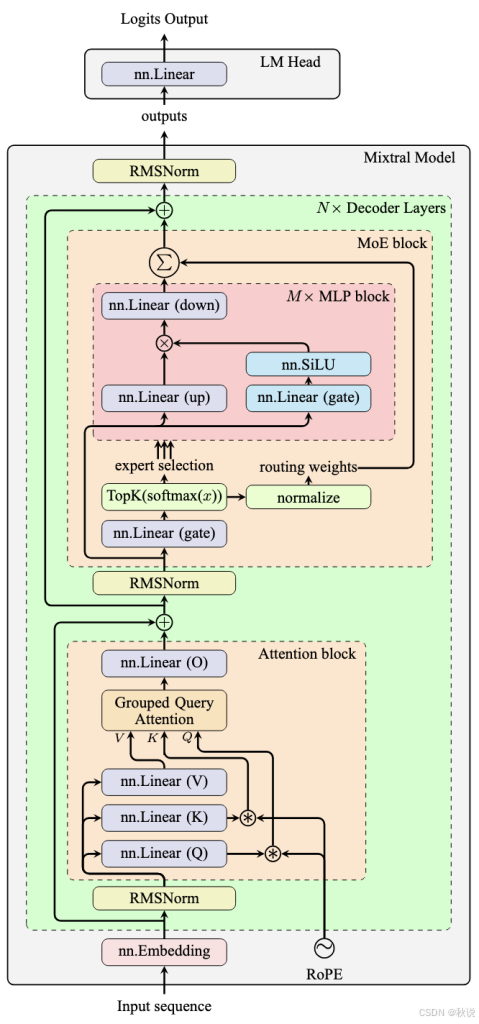
以 Mixtral 模型架构为例:
在这里插入图片描述

如前文所述,MLP 块为 Transformer 层引入了非线性,而注意力块仅通过线性组合对输入序列的信息进行重组。Transformer 模型的“智能”主要体现在 MLP 块中。

这也解释了为什么 MLP 块通常包含 Transformer 模型中最多的参数和计算负载。训练 MLP 块以在各种任务上表现良好具有挑战性,因为不同任务可能需要相互矛盾的行为。

一种解决方案是为每个任务创建专门的模型,并使用路由器选择合适的模型。另一种方法是将多个模型和路由器合并为一个单一模型,并一并训练。MoE 的核心正是这一思想。

MoE 通过引入稀疏性实现这一点:多个专家网络中每次只激活稀疏子集。MoE 架构仅修改 MLP 块,而所有专家共享同一个注意力块。每个 Transformer 层拥有独立的一组专家,使各层之间可以自由组合。这允许创建大量专家而不显著增加参数总量,从而在扩展模型的同时保持较低计算成本。

核心观点是:不同的输入适合不同的专门化计算。通过拥有多个专家网络并配合路由机制选择使用的专家,模型能够以更少的计算资源实现更优的性能。

专家混合(MoE)的工作原理

MoE 架构由三个关键组件组成:

  1. 专家网络(Expert Networks):
    多个独立的神经网络(专家)处理输入,类似于其他 Transformer 模型中的 MLP 块。

  2. 路由器(Router):
    决定哪些专家处理每个输入的机制。通常由一个线性层加 softmax 组成,生成针对 N N N 个专家的概率分布。路由器输出通过“门控机制”选择前 k k k 个专家。

  3. 输出组合(Output combination):
    前 k k k 个专家处理输入,并根据路由器归一化概率的加权和组合输出。

基本 MoE 操作如下:对于来自注意力块输出序列的每个向量 x x x,路由器将其与矩阵相乘生成 logits(图中门控层)。经过 softmax 转换后,这些 logits 通过前 k k k 操作筛选,得到 k k k 个索引和 k k k 个概率。索引用于激活专家(图中 MLP 块),处理原始注意力块输出。专家输出按路由器归一化概率加权求和,得到最终结果。

概念上,MoE 块计算公式为:

MoE ( x ) = ∑ i ∈ TopK ( p ) p i ⋅ Expert i ( x ) \text{MoE}(x) = \sum_{i \in \text{TopK}(p)} p_i \cdot \text{Expert}_i(x) MoE(x)=i∈TopK(p)∑​pi​⋅Experti​(x)

其中 k k k 是模型超参数,即使 k = 2 k=2 k=2 通常也能获得良好性能。

在 Transformer 模型中实现 MoE

下面是一个使用 PyTorch 实现的 Transformer 层示例,其中 MoE 替代了传统的 MLP 块:

import torch
import torch.nn as nn
import torch.nn.functional as F

class Expert(nn.Module):
    def __init__(self, dim, intermediate_dim):
        super().__init__()
        self.gate_proj = nn.Linear(dim, intermediate_dim)
        self.up_proj = nn.Linear(dim, intermediate_dim)
        self.down_proj = nn.Linear(intermediate_dim, dim)
        self.act = nn.SiLU()

    def forward(self, x):
        gate = self.gate_proj(x)
        up = self.up_proj(x)
        swish = self.act(gate)
        output = self.down_proj(swish * up)
        return output

class MoELayer(nn.Module):
    def __init__(self, dim, intermediate_dim, num_experts, top_k=2):
        super().__init__()
        self.num_experts = num_experts
        self.top_k = top_k
        self.dim = dim
        self.experts = nn.ModuleList([
            Expert(dim, intermediate_dim) for _ in range(num_experts)
        ])
        self.router = nn.Linear(dim, num_experts)

    def forward(self, hidden_states):
        batch_size, seq_len, hidden_dim = hidden_states.shape
        hidden_states_reshaped = hidden_states.view(-1, hidden_dim)
        router_logits = self.router(hidden_states_reshaped)
        routing_probs = F.softmax(router_logits, dim=-1)

        top_k_probs, top_k_indices = torch.topk(routing_probs, self.top_k, dim=-1)
        top_k_probs = top_k_probs / top_k_probs.sum(dim=-1, keepdim=True)

        output = []
        for i in range(self.top_k):
            expert_idx = top_k_indices[:, i]
            expert_probs = top_k_probs[:, i]
            expert_output = torch.stack([
                self.experts[exp_idx](hidden_states_reshaped[j])
                for j, exp_idx in enumerate(expert_idx)
            ], dim=0)
            output.append(expert_probs.unsqueeze(-1) * expert_output)

        output = sum(output).view(batch_size, seq_len, hidden_dim)
        return output

class MoETransformerLayer(nn.Module):
    def __init__(self, dim, intermediate_dim, num_experts, top_k=2, num_heads=8):
        super().__init__()
        self.attention = nn.MultiheadAttention(dim, num_heads, batch_first=True)
        self.moe = MoELayer(dim, intermediate_dim, num_experts, top_k)
        self.norm1 = nn.RMSNorm(dim)
        self.norm2 = nn.RMSNorm(dim)

    def forward(self, x):
        input_x = x
        x = self.norm1(x)
        attn_output, _ = self.attention(x, x, x)
        input_x = input_x + attn_output

        x = self.norm2(input_x)
        moe_output = self.moe(x)
        return input_x + moe_output

完整的 MoE Transformer 模型由多个此类 Transformer 层组成,每层包含注意力子层和 MoE 子层,其中 MoE 子层类似于传统 Transformer 中的 MLP 子层。

在 MoELayer 类中,forward() 方法的输入形状为 (batch_size, seq_len, hidden_dim)。由于每个序列向量独立处理,输入首先被重塑为 (batch_size * seq_len, hidden_dim)。路由器和 softmax 生成 routing_probs,形状为 (batch_size * seq_len, num_experts),表示每个专家对输出的贡献。

top-k 操作选择专家及其对应概率。在 for 循环中,每个向量由对应专家处理,并将输出堆叠在一起。循环生成一个加权张量列表 output,最终求和得到输出,并重塑回原始形状 (batch_size, seq_len, hidden_dim)。

Expert 类与前文中的 MLP 块相同,但 MoE 子层使用多个实例,而不是单个 Transformer 层中的 MLP。

我们可以使用以下代码测试 Transformer 层:

batch_size = 4
seq_len = 10
dim = 16
intermediate_dim = 72
num_experts = 8

x = torch.randn(batch_size, seq_len, dim)
model = MoETransformerLayer(dim, intermediate_dim, num_experts)
y = model(x)

共享专家(Shared Experts)

上述实现是最简单的 MoE 架构。最近,DeepSeek 模型提出并推广了一种新思路:在 MoE 架构中加入少量“共享专家”,这些共享专家会对任何输入始终被使用。数学上,MoE 的计算公式变为:

MoE ( x ) = Expert ∗ ( x ) + ∑ i ∈ TopK ( p ) p i ⋅ Expert i ( x ) \text{MoE}(x) = \text{Expert}^*(x) + \sum_{i \in \text{TopK}(p)} p_i \cdot \text{Expert}_i(x) MoE(x)=Expert∗(x)+i∈TopK(p)∑​pi​⋅Experti​(x)

其中额外的专家就是共享专家。显然,你可以使用多个共享专家。在所有情况下,共享专家不依赖路由器,而是无条件处理输入。

要实现共享专家,可以复用前面的代码,并在 MoETransformerLayer 类中添加额外的专家网络:

class MoETransformerLayer(nn.Module):
    def __init__(self, dim, intermediate_dim, num_experts, top_k=2, num_heads=8, num_shared_experts=1):
        super().__init__()
        self.attention = nn.MultiheadAttention(dim, num_heads, batch_first=True)
        self.moe = MoELayer(dim, intermediate_dim, num_experts, top_k)
        # 共享专家
        self.shared_experts = nn.ModuleList([
            Expert(dim, intermediate_dim) for _ in range(num_shared_experts)
        ])
        self.norm1 = nn.RMSNorm(dim)
        self.norm2 = nn.RMSNorm(dim)

    def forward(self, x):
        # 注意力子层
        input_x = x
        x = self.norm1(x)
        attn_output, _ = self.attention(x, x, x)
        input_x = input_x + attn_output

        # MoE 子层
        x = self.norm2(input_x)
        moe_output = self.moe(x)
        for expert in self.shared_experts:
            moe_output += expert(x)
        return input_x + moe_output

总结

本文详细介绍了 Transformer 模型中的专家混合(MoE)架构及其实现方法。通过引入多个专家网络和路由机制,MoE 能在保证计算效率的前提下扩展模型规模,提高对不同输入的处理能力。

掌握 MoE 架构后,可在实际项目中针对不同任务灵活设计专家网络,提升模型性能,同时控制计算成本,为大规模 Transformer 模型的高效部署提供基础。
9.2 MoE混合专家架构:提升模型效率的新思路 MoE(混合专家)架构是一种高效的大模型设计方法,通过动态路由机制选择特定专家网络处理不同输入。其核心组件包括专家网络、路由机制和组合机制,能够在保持性能的同时显著减少计算资源消耗。本章介绍了简单MoE层和带权重组合MoE层的实现,展示了如何通过路由网络选择top-k专家并加权组合其输出。这种架构特别适合大规模语言模型,实现了"术业有专攻"的计算效率提升。 阅读详情

相关推荐

MoE(Mixture of Experts,混合专家模型

MoE模型支持用较少的算力预训练大模型,这意味着可以在有限的算力预算下训练出比稠密模型大得多的稀疏模型,或者在更大的数据集上进行训练。例如,尽管只有较少的参数,但MoE模型的性能可以媲美传统的更大参数模型,在推理速度上也显著超越了其他同类模型。- 特定领域的应用:在计算机视觉(CV)领域,可以采用single-gated MoE模型,该模型在推理时计算成本合理,适用于训练大规模模型。- 解决多模态大模型冲突的方法:通过利用稀疏专家模型(MoE),不同的专家处理不同的任务,并设计一种数据划分的方法。

汽车软件开发 1462

8类CNN-Transformer混合架构魔改方案盘点,附23个配套模型&代码

为进一步提高模型的性能,我们将。目前,它已经成为我们研究视觉任务、发文章离不开的模型。针对CNN+transformer组合方向的研究也成为了当下计算机视觉领域研究中的大热主题。CNN-Transformer架构凭借众所周知的优势,在视觉任务上取得了令人瞩目的效果,它不仅可以提高模型在多种计算机视觉任务中的性能,还能实现较好的延迟和精度之间的权衡。为挖掘CNN-Transformer混合架构更多的潜力,有关于它的各种变体的研究也逐步增多。为了方便同学们了解,我这次就和大家分享该架构。

学姐带你玩AI的博客 1万+

从《Mixtral of Experts》开始讲讲MoE

我们介绍了,一种稀疏专家混合模型(Sparse Mixture of Experts,SMoE)语言模型。Mixtral 的架构与 Mistral 7B 相同,不同之处在于每一层由 8 个前馈块(即专家)组成。对于每个 token,在每一层中,路由网络会选择两个专家来处理当前状态并结合它们的输出。尽管每个 token 仅会接触到两个专家,但每个时间步选择的专家可以不同。因此,每个 token 可以访问到 470 亿个参数,但在推理过程中仅使用了 130 亿个活跃参数。

qq_51957239的博客 2289

硬核:分布式推理优化思路分享

摘要:本文探讨了大模型推理应用中的并行策略优化思路,针对不同场景和模型层特点提出针对性优化方案。文章分析了主流的并行策略(DP/TP/SP/EP/CP/PP/ZeRO)及其组合应用,特别讨论了MoE模型、Attention模块和FFN层的优化策略。在MoE模型方面,建议采用DP/TP/EP组合并行;Attention模块优化包括通信调整、DP间SP并行和显存优化;FFN层则推荐EP转AFD等策略。文章还涉及Embedding层的优化思路,强调并行策略需根据具体场景进行测试调整,以实现最佳性能。

InfraTech 1226

【AI就业干货24】Mixture of Experts(MoE):通往高效大模型的钥匙

本文将带你全面理解: MoE 是什么? 它如何工作? 为什么它能实现“高效扩展”? 在大模型、自动驾驶、机器人中的应用 实际部署的挑战与未来趋势

m0_51738372的博客 2020

华为服务器RAID配置避坑指南:如何通过iBMC快速识别阵列卡型号并完成初始化

本文详细解析华为服务器RAID配置全流程,重点介绍通过iBMC快速识别阵列卡型号、硬盘健康诊断及RAID级别选择的场景化策略。提供从iBMC登录到缓存策略调优的实战技巧,帮助工程师避免常见配置陷阱,提升服务器存储系统性能和稳定性。

weixin_28475533的博客 492

大模型基石:Transformer架构深度拆解,一文读懂核心原理

大模型基石:Transformer架构深度拆解,一文读懂核心原理

大模型研究中心 1969

故障处理:Oracle一体机磁盘故障时磁盘组重平衡失败的故障处理

摘要: Oracle Exadata一体机出现磁盘故障案例,存储节点故障灯未亮但磁盘已产生大量坏块,导致重平衡失败。文章强调了一体机硬件巡检需检查6个关键维度:节点messages日志、存储cell告警日志、CellCLI日志、ASM告警日志、ILOM日志及服务器信号灯。故障分析显示硬盘物理故障导致磁盘组冗余受损,自动修复流程受阻。文中详细记录了通过CellCLI工具排查损坏磁盘的过程,并提供了完整的故障处理流程和命令输出。文章同步发布于微信公众号"IT民工的龙马人生"和博客网站(www

提供数据库技术支持(系统优化,故障处理,安装升级,数据恢复等) 1231

架构之比较混合专家(MoE)与Transformer

Transformer和混合专家(Mixture of Experts,MoE)架构都是现代深度学习中的重要架构。Transformer于2017年由Google在论文《Attention Is All You Need》中提出,彻底改变了自然语言处理领域。MoE架构则是一种条件计算方法,通过在推理时激活部分参数来实现模型规模的扩展。

d3y1`5 81_09 1093

从Jira到Notion:用Sequential Thinking重构你的敏捷工作流(含GPT-6配置模板)

本文探讨了如何利用Sequential Thinking这一AI认知模型,重构敏捷开发工作流。通过连接Jira、Notion等工具,构建动态依赖图谱,实现从被动响应到主动规划的转变。文章提供了详细的配置教程和GPT-6配置模板,帮助团队实现任务自动拆解、智能看板生成与跨平台协调,从而提升项目管理效率。

gpt4scribbler的博客 205

别再说Fortran过时了!手把手教你用VS Code + gfortran搭建现代开发环境(2024版)

本文打破Fortran过时的刻板印象,详细介绍如何利用VS Code和gfortran搭建现代开发环境。从编译器安装、VS Code插件配置到项目结构标准化,提供完整的2024版跨平台解决方案,并展示Fortran 2023标准的协程、并行计算等现代特性,助力科学计算与高性能开发。

weixin_42629815的博客 242

混合专家模型(Mixture of Experts,MoE)——综述

目录摘要(Overview)1 引言(Motivation 与历史脉络)2 概念与基本构件(Router 与 Experts)3 设计动机:为什么在 Transformer 中使用 MoE4 核心挑战与解决路径(以负载均衡与系统为中心)4.1 专家负载不均衡(为何出现、为何重要、如何解决)4.2 训推基础设施与通信开销5 路由机制与专家设计的演化(从静态到自适应)6 工程实践:从训练到部署的经验教训7 典型应用与实证效果8 研究前沿与未来方向9 小结混合专家模型(Mixture of Experts, Mo

u012133341的博客 2422

实战演练 | ABAQUS显式动力学分析在金属切削仿真中的应用

本文详细介绍了如何利用ABAQUS显式动力学分析进行金属切削过程的二维仿真。通过从零开始的完整流程,包括几何建模、材料本构与失效定义、网格划分、接触设置、边界条件施加,到结果后处理与切削力提取,为工程师和研究人员提供了实用的仿真方法,以优化刀具设计和加工工艺。

purple的博客 931

【大模型理论篇】--Mixture of Experts架构

概括来看,在MoE模型中,用混合专家层替换 Transformer 模型的每个前馈网络层,混合专家层由一个门控网络和一定数量的专家组成。在MoE模型的核心是“专家”子网络。这些专家是更大神经网络中的独立模块,每个模块都能够处理输入数据。其概念是不同的专家专注于输入数据的不同方面,从而使模型能够有效利用专门的知识。门控机制是一个关键组件,负责将输入引导至适当的专家网络。它根据一组门控值来决定每个专家的参与程度。门控机制可以实现为稠密或稀疏结构,其中稀疏结构由于选择性地激活部分专家,因而在计算上更加高效。

我是个好人呀,O(∩_∩)O 5334

保姆级教程:用Multisim仿真快速上手二极管、MOSFET和IGBT的开关特性

本文提供了一份详细的Multisim仿真教程,帮助读者快速掌握二极管、MOSFET和IGBT的开关特性。通过搭建实验电路、观察波形特征和参数影响分析,深入解析了反向恢复过程、米勒平台现象和拖尾电流效应。适合电力电子初学者和工程师通过仿真建立直观理解,提升电路设计能力。

weixin_29290863的博客 499

孔雀优化算法(POA)详解:从孔雀智能到优化引擎

孔雀优化算法(POA)是一种新型元启发式优化算法,灵感来源于孔雀的社会行为和智能狩猎策略。该算法将孔雀群体分为雄孔雀、雌孔雀和幼孔雀三个阶层,分别对应全局探索、平衡搜索和局部开发三种搜索策略。通过模拟孔雀的求偶展示、自适应接近和Levy飞行等行为,POA实现了探索与开发的动态平衡。算法采用角色分配机制和位置更新方程,结合参数自适应调整,展现出优于传统算法的全局搜索能力和收敛性能。POA已成功应用于多个优化问题,其生物启发机制为解决复杂优化问题提供了新思路。

qq_42212808的博客 135

MoE(Mixture of Experts,混合专家模型)

要理解所谓的专家,容易把在图片中的每一层的每一个专家或者小的网络模型理解成具体学习的是不同的知识,例如专家一学习Psychology的知识,专家三学习Biology的知识,每个专家都有自己学习的能力和内容,但是,在真正的执行当中,或者真正的数学计算和模型结构学的不是所谓的这些专家知识,而是学习syntactic information所谓的。,在最原始的文章里面说到是一个门控网络通过一个开关去决定选择不同的专家,随着大家对整个计算的认识,就把它变成Router,主要是指路由去决定输入。

m0_66855407的博客 1194

RandLA-Net Tensorrt 推理 c++

RandLA-Net 实现 Tensorrt 部署.

J。 1110

Mixture of Experts 在AI模型中解释混合专家(MoE)

在其核心,MoE,特别是在转换器模型的上下文中,由两个主要元素组成:稀疏的MoE层和一个门网络(或路由器)。

数智笔记 2666

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

大模型【进阶】(一)MoE(mixture of experts)混合专家结构

(Mixture of Experts,专家混合模型)是一种深度学习模型架构,通常用于处理大规模模型和计算资源效率的挑战。在 MoE 结构中,模型由多个“专家”组成,每个专家处理不同的任务或输入数据的不同部分,而不是让所有专家都参与每次计算。这种方式提高了计算效率,并在某些情况下有助于增强模型的表现。

人工智能中的一枚螺丝钉 3598

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

CMU 10423 Generative AI:lec16(Mixture of Experts 混合专家模型)

这个文档是关于背景与动机上一节课讨论了大规模语言模型(如GPT-3和GPT-4)随着规模的增大,在训练和推理上的一些优劣点。大模型具有更强的容量和更快的收敛速度,但在推理时成本较高。本次课的目标是通过模型来减少推理成本,使模型在推理时只激活少量的权重,从而提高效率。Mixture of Experts 的定义MoE层包含多个专家(M个专家),通过一个称为"top-k routing"的机制进行专家选择。

不精,不诚,不足以动人 1230

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

【MoE-1】MoE(Mixture-of-Experts)混合专家模型理解

MoE(混合专家模型)的算法设计基于条件计算和稀疏激活两大核心思想,通过门控网络和专家网络的协同工作实现高效计算。MoE的算法设计通过条件计算、稀疏激活和智能路由机制,成功解决了大模型训练中的计算效率与模型容量之间的矛盾,为构建万亿参数级别的模型提供了可行的技术路径。

AbiUni(YY熊) 1202

复现Mixture of Experts(MOE)架构

所以可以反过来思考,experts数量是固定的,我们可以对experts进行遍历,从第一个expert开始,看那些想了选择了第一个expert,然后将该向量输入到第一个expert的模型进行推理,然后将结果存放到y的对应位置。MoE更像是一种思想,它的处理流程是:假设有n个专家,输入向量x,经过一个门控网络(Gating Network)生成n个概率,取top_k个概率对应的专家执行对x的推理,然后进行加权融合。接下来是将x输入到对应的experts进行推理,这里有一个巧妙的设计,对于x来说,它的第一维。

Whiser的博客 766

Mixture-of-Experts MOE模块实现(代码)

Mixture-of-Experts MOE模块实现(代码)

weixin_44986037的博客 1431

Awesome-Mixture-of-Experts-Papers实战教程:用DeepSpeed-MoE训练你的第一个混合专家模型

混合专家模型(Mixture-of-Experts,简称 MoE)已成为大模型时代的核心架构之一,而 Awesome-Mixture-of-Experts-Papers 正是你进入这个领域的最佳起点——它是一份持续更新的 MoE 论文精选清单,按算法、系统、应用三大维度收录了近年最具代表性的研究。本篇文章是一份面向初学者的混合专家模型训练实战教程,我们将从克隆仓库、读懂论文地图开始,一步步用 De

gitblog_00411的博客 961

一个基于稀疏混合专家模型(Sparse Mixture of Experts, Sparse MoE) 的 Transformer 语言模型

flyfish

二分掌柜的 1087
上一篇: 【人工智能】一文教你用Python创建你的第一个LLM API项目
下一篇: 【语言模型】7分钟讲懂大型语言模型的7个概念
秋说
秋说 优质创作者: 编程框架、信息安全技术领域 优质创作者: 编程框架、信息安全技术领域
博客等级 码龄4年 3万+粉丝 1906原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

秋说

感谢打赏

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值