编码学习——UTF-8与Unicode互转具体流程

C语言实现Unicode编码和UTF-8互转 在C语言中,我们需要进行Unicode编码和UTF-8编码的转换,本篇文章将介绍如何实现这两个编码之间的相互转换。UTF-8编码使用1~4个字节来表示不同的字符,每一个字节都以“0”开头,其中第一个字节还包含了该字符所需的字节数信息。UTF-8编码使用1~4个字节来表示不同的字符,每一个字节都以“0”开头,其中第一个字节还包含了该字符所需的字节数信息。最后,我们将解析出的Unicode编码放入wchar_t类型的数组中,并且在数组末尾添加一个L’\0’字符,以表示数组的结束。 阅读详情

了解最早以前的只有英文数字字符、控制代码、空格与二进制之间的关系——ASCII码

在计算机内部,所有数据都是使用二进制存储。每一个二进制都代表一位(bit),这一位数有0和1两种状态,在ASCII中是由一个字节表示,也就是8位。最前面的数统一规定为0,那么ASCII编码操作的位数只有7位数,是一个7位的编码标准。因此只能规定128种不同的字符编码,在十进制中为0~127,其中包括26个小写字母、26个大写字母、10个数字、32个符号、33个控制代码(不能打印)和一个空格。
        例如:空格“SPACE”是32(二进制00100000),大写的字母A是65(二进制01000001)。

缺点就是:因为太少只有128种,不能代表所有字符,也就是不满足世界互联网的语言需求。

了解万能编码——Unicode码

乱码:世界上存在着多种编码方式,同一串二进制数字可以被解释成不同的符号。因此,想要保存一个文本文件,必须选择编码方式。反而言之,要想打开一个文本文件,就必须知道它的编码方式,否则用错误的编码方式解读,就会出现乱码。
Unicode:是一种编码方式,将世界上所有的符号都纳入其中。每一个符号都给予一个独一无二的编码,使用Unicode 没有乱码的问题。
Unicode 的缺点:Unicode 只规定了所有语言的二进制代码,却没有规定这个二进制代码应该如何存储,因此计算机无法区别Unicode 和ASCII。例如计算机无法区分两个字节一起表示一个符号还是分别表示两个符号。另外,我们知道,英文字母只用一个字节表示就够了,如果unicode统一规定,每个符号用两个字节表示,那么每个英文字母前都必然有一个字节是0,这对于存储空间来说是极大的浪费。此时UTF-8代码诞生了

了解UTF-8 码

UTF-8 是在互联网上使用最广的一种Unicode 的实现方式。
UTF-8 是一种变长的编码方式。它可以使用1-6 个字节表示一个符号,根据不同的符号而变化字节长度。(在标准UTF-8编码中,超出基本多语言范围(BMP-Basic Multilingual Plane)的字符被编码为4字节格式,但是在修正的UTF[编码中,他们由代理编码对(surrogatepairs)表示,然后这些代理编码对在序列中分别重新编码。结果标准UTF-8编码中需要4个字节的字符,在修正后的UTF-8编码中将需要6个字节)
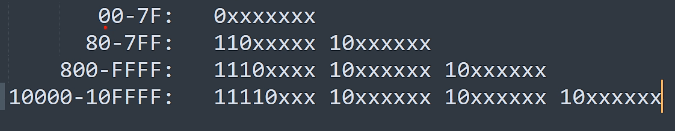
UTF-8的编码规则(参考如下黑色背景图):
对于单字节的UTF-8编码,该字节的最高位为0,其余7位用来对字符进行编码(等同于ASCII码)。
对于多字节的UTF-8编码,如果编码包含n 个字节,那么第一个字节的前n位为1,第一个字节的第n+1 位为0,该字节的剩余各位用来对字符进行编码。在第一个字节之后的所有的字节,都是最高两位为"10",其余6位用来对字符进行编码。
UTF-8与Unicode互转流程(重点)

存储过程

描述:

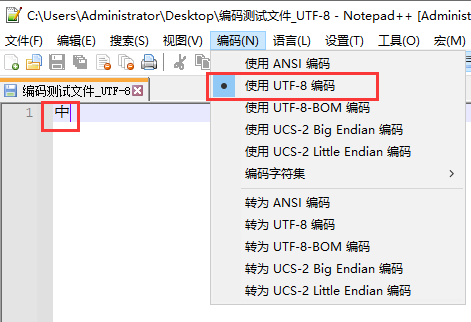
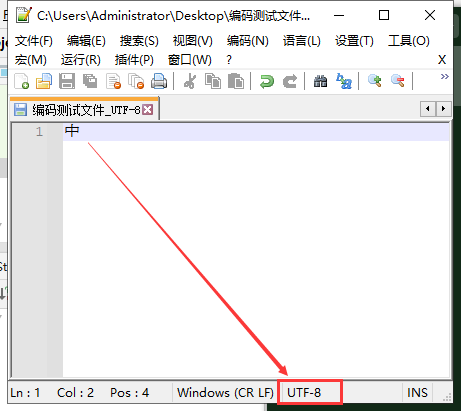
  1. 在文本框输入"中"一个字符,然后选择UTF-8编码方式保存,此时该文件就是用UTF-8编码方式保存的
  2. 使用UTF-8解码再次打开文件时发现编码无异常,“中”字也正常显示
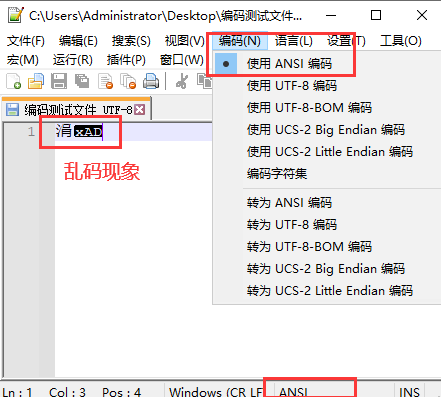
  3. 如果用了不符合的编码格式解码打开文件就会乱码,例图使用ANSI编码解码打开UTF-8编码格式的文件
  4. "中"字符在Unicode编码表十进制是20013,Unicode表中对应的是"\u4e2d",也就是十六进制为4E2D,二进制为100 1110 0010 1101
            int i = (int)'中';//字符串根据Unicode转十进制
            System.out.println(i);//20013
            String s1 = Integer.toHexString(i);//十进制转十六进制
            System.out.println(s1);//4e2d
            String s2 = Integer.toBinaryString(i);//十进制转二进制
            System.out.println(s2);//100 1110 0010 1101
  5. 然后再将十六进制的4E2D转换成"100 1110 0010 1101"的二进制数,其中
    • 4的二进制是100
    • E是15,转成二进制就是1110
    • 2的二进制是0010
    • D是14,转换成二进制就是1101
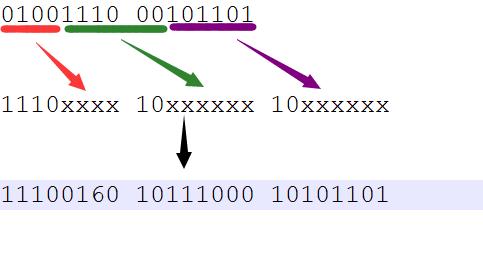
  6. 如果按照Unicode编码方式存放,此时的二进制"100 1110 0010 1101"会加一个0,变成两个字节"01001110 00101101"存在计算机中,但是这样存入后读取时计算机编码时不知道怎么读,回到之前提出的疑问:"计算机无法区分两个字节一起表示一个符号还是分别表示两个符号"
  7. 因此我们引入UTF-8完善Unicode存储,使得既可以读又可以写,下面我们查看UTF-8的在不同的Unicode的十六进制值的范围内的存储区别,来选择应该用第几行的方式存储。我们的十六进制“4E2D”明显是属于800-FFFF之间的,因此
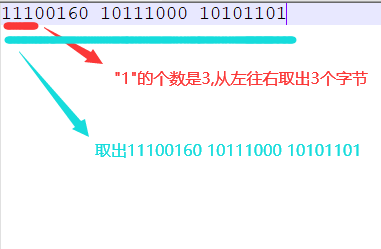
  8. 我们的"4E2D"就选择第三行的方式存储,也就是用三个字节存储我们的Unicode.然后把两个字节的数从左往右填入到第三行的xxxx....中,造出的"11100160 10111000 10101101"就是我们通过UTF-8的编码方式将“中”字存储到磁盘的三个字节
 

读取过程

描述:

  1. 通过UTF-8的格式读取数据,先通过开头的"1"的位数从左到右取出几个字节
  2. 取出UTF-8的XXXX的代替数,也就是Unicode的二进制数"0100111000101101"
  3. 把二进制数"01001110 00101101"翻译成16进制的数"4E2D"
  4. 将二进制数前加上"/u",也就是"/u"+"4E2D"组成"/u4E2D"
  5. 对照Unicode表对照翻译就是"中"字符
ASCII码,Unicode,UTF-8,URL编码详解 前言 想必大家都知道计算机所识别的语言是二进制语言,也就是0和1的代码,任何字符最终都要被计算机所转换为0和1组成的代码。而在我们计算机领域呢,涉及到许许多多除二进制编码以外的编码。如ASCII码,Unicode,UTF-8,URLcode等。今天我们就来详细的学习一下这四种编码,也是我们平时接触最多的。 ASCII码 起初,计算机是由美国人发明出来的,所以老美们为了将自己的语言也就是英语转换成计算机所识别二进制语言,于是乎呢,就自己编写一套编码,也就是ASCII码。 在计算机种中,1 字节对应 8 位二进 阅读详情

相关推荐

unicode转utf8,utf8转unicode

如果想要允许中文做变量名的话,做这个前我以为要做utf8的转换,但是做的时候越想越不明白。无论在文本文件中输入的中文是utf8编码还是gbk编码的,其实都无所谓,编译的时候只要保存一段uint8_t数组(或者char数组)的内容就行了,至于内容是什么都无所谓。 再者,输入的内容本身就是utf8编码的了,为什么要转成unicode?比如用记事本输入一个【苏】,然后用二进制编辑软件打开,显示EB 8B 8F,本身就已经是utf8编码的字了!!! 推荐:UTF8编码表 原理 码农翻身:两位巨佬的一顿晚饭,...

痛苦的时候装出幸福相,这不是那么难做到的事 3510

UTF8与UniCode之间的相互转换

UTF8与UniCode之间的相互转换

小木子先生的博客 4773

泰文utf-8转unicode编码实现

前言:最近的有个项目是要读取泰文然后将泰文叠加到图片上。查了一周的资料,所有的流程已经走通了。 实现原理 想要将泰文叠加到图片上需要两个步骤: 泰文转成unicode编码: 泰文实际上是utf-8编码的,这也就是编译器以utf-8的格式才可以正常显示泰文的原因。 unicode编码转成泰文并进行图片叠加: 泰文渲染是采用了freetype第三方库进行显示的,freetype需要的是unicode...

故事就酒的博客 5595

字符串乱码问题

UTF8转Unicode、Unicode转UTF8、string和wstring互转

心愿许得无限大 1852

一文读懂字符编码ASCII、Unicode与UTF-8

最近在写一个Http协议栈当涉及CRLF控制字符写入时,发现自己对CRLF与\r\n的关系不太了解,因此决定详细学习一下;查阅资料的同时,又遇到UTF-8与ASCII编码的疑问。

bjxiaxueliang的CODING小栈 1792

C语言实现Utf8转Unicode

在上面的代码中,我们定义了一个包含UTF-8编码的字符串utf8_str,然后依次处理每个字符,将其转换为对应的Unicode字符集中的字符。具体操作是,首先判断该字符需要使用几个字节进行编码(即判断它的前几位是0、110、1110还是11110),然后根据不同的字节数,使用位运算将其转换为对应的Unicode字符集中的字符。在程序开发中,需要将UTF-8编码的字符转换为Unicode字符集中的相应字符,这就需要进行UTF-8到Unicode的转换。了解完UTF-8编码的原理后,我们就可以开始编码了。

HackQuestR的博客 1331

从 ASCII 到 UTF-8 - Unicode 码的诞生与实现

最近我在整理过往笔记时,发现涉及到了 UTF-8、Unicode的相关内容,相信大家中的很多人和之前的我一样,在过去的很长一段时间里,并没有搞清楚什么是 Unicode、什么是UTF-8,于是就有了这篇文章,我将带大家梳理一下关于 Unicode 码的诞生与实现,用正确的姿势学习认识 Unicode 和UTF-8。

栗筝i的博客 3667

DESeq2实战:如何用LRT检验分析基因表达随时间变化的模式(附完整代码)

本文详细介绍了如何使用DESeq2中的LRT检验分析基因表达随时间变化的模式,包括实验设计、数据预处理、模型构建、结果提取与可视化等完整流程。通过实战案例和完整代码,帮助生物信息学研究者掌握时间序列RNA-seq分析的核心技术,特别适合需要快速上手的实践者。

weixin_42620255的博客 465

带你正确认识Unicode和UTF-8

前言 相信很多小伙伴跟我一样,之前很长一段时间对Unicode和UFT-8一直搞得不清不楚,等到用的时候就网上搜一搜,大概懂了点是什么,隔一段时间后又搞忘了,简直阔怕啊。今天我将带您轻轻松松出困境,用正确的姿势学习和认识Unicode和UTF-8 ASCII码 由于计算机这玩意儿是英文为母语的老外发明的,在计算机发展早期,能用到计算机的也就是用英语的那么些国家,因此对于他们来说,用于表示计算机显示屏上要显示的字符也就大小写的英文字母、数字、标点符号、特殊符号、一些特殊字符再加上些控制字符就足矣,总共加起来.

qq_20255275的博客 8822

三相电路小白必看:正弦量向量表示法保姆级教程(附欧拉公式推导)

本文为电气工程初学者详细解析了三相电路中正弦量的向量表示法,即相量法。通过几何直观和欧拉公式推导,阐明如何将时变正弦量转化为静态复平面向量进行运算,并利用平行四边形法则简化同频正弦量的加减计算。文章结合Python代码进行可视化验证,帮助读者牢固掌握这一分析交流电路的核心工具。

linux6sysadmin的博客 992

《软件工程——实践者的研究方法》重难点复习笔记(第八章——理解需求)

8项需求工程任务 inception 开始 8.1.1 identify stakeholders 定义:从软件开发中收益 例如:市场人员、销售经理、顾客、顾问、维护团队等(P139) 8.1.2 这个阶段的问题是context-free的。有三套(P140) 8.1.3 提到NFR(nonfunctional requirement)和QFD(quality

whooiif的博客 1814

unicode编码和utf-8编码的区别

内容仅用于个人学习,如有侵权请联系删除~ 原文链接:https://www.zhihu.com/question/23374078 一、解释1 简单来说: Unicode 是「字符集」 UTF-8 是「编码规则」 其中: 字符集:为每一个「字符」分配一个唯一的 ID(学名为码位 / 码点 / Code Point) 编码规则:将「码位」转换为字节序列的规则(编码/解码 可以理解为 加密/解密 的过程) 广义的 Unicode 是一个标准,定义了一个字符集以及一系列的编码规则,即 Unic.

小唐要努力的博客 4414

人机交互期末复习笔记

人机交互期末复习笔记 进行复习的童鞋们可以跟着清华大学《人机交互基础教程第3版(孟祥旭、李学庆、杨承磊、王璐编著)的书籍参照借阅。上面的一字一句皆是敲键盘敲出来的,并且掌握课本的基本内容。 博客中的知识点有些地方会进行粗略的跳过(主要的大框架没有省略),建议有同样需求的读者结合书本与博客一同借阅。本博客有错误的地方多多指正,谢谢大家~ 文章目录人机交互期末复习笔记第一章 绪论 P11.1 人机交互的概念1.2 人机交互的研究内容1.3 人机交互的发展历史(只介绍人机交互阶段)第二章 感知和认知基础 P122

server643的博客 5023

字符串的Unicode编码和UTF-8编码

无论是在客户端与服务器端之间传递数据,还是在浏览器环境中展示多语言内容,正确的编码知识都能确保你的应用程序以最佳状态运行。由于其向后兼容ASCII编码,且能高效地表示各种语言的字符,因此成为了互联网上最常用的编码格式之一。希望您在这里可以感受到一份轻松愉快的氛围,不仅可以获得有趣的内容和知识,也可以畅所欲言、分享您的想法和见解。注意,该方法返回的是基于零的索引位置的字符编码值。一个做过前端开发的产品经理,经历过睿智产品的折磨导致脱发之后,励志要翻身农奴把歌唱,一边打入敌人内部一边持续提升自己。

一个做过前端开发的产品经理,经历过睿智产品的折磨导致脱发之后,励志要翻身"农奴"把歌唱,一边打入敌人内部一边持续提升自己,为我们广大开发同胞谋福祉,坚决抵制睿智产品折磨我们码农兄弟! 1652

硬件笔记——HDMI接口

HDMI可以同时传输视频信号、音频信号和控制信号。其中高速信号有四组:从Data TX到Data RX有3组差分数据信号(TMDS_DATA0~2)和一组差分时钟信号(TMDS_CLOCK)。以及若干低速线。脚编号信号名称信号类型功能说明1热插拔检测连接状态检测。接收端通过此引脚向源端发送高电平信号,通知其已连接并可以开始读取EDID。2UTILITY车载用途悬空3TMDS数据通道2差分信号正极,用于传输视频像素、音频和数据包。4TMDS数据2屏蔽。

2501_94625908的博客 534

12.工具高级参数CogCalibNPointToNPointTool

CogCalibNPointToNPointTool是一种多点2D坐标校正工具,用于将图像像素坐标转换为物理世界坐标。该工具通过两组点(图像坐标点和物理坐标点)计算最佳转换关系,并将结果保存供后续使用。操作步骤包括获取图像、添加坐标点对、计算转换参数。校正结果会显示平移、缩放、旋转等参数及RMS误差值,较大的误差可能表明点位置不准确或自由度不足。该工具广泛应用于机器视觉领域,通过9点标定等案例可验证坐标转换的准确性并优化参数设置。

202

Unicode、ASCII、UTF-8编码关系和底层原理

Unicode是一个字符集标准,ASCII则是Unicode的一个子集,包含最基本的字符,而UTF-8、UTF-16和UTF-32是实现Unicode这个标准的不同编码方式,UTF-8的底层原理参考上面我推荐的文章,我这里就不做详细的解释了。

Happy learning and coding journey! 2554

顶级AI大模型白嫖ChatGPT Plus1个月,0成本薅顶配功能

Chat*** Plus限时免费1个月!原价20美元/月的顶配功能

BUG猿的博客 7262

彻底弄懂 Unicode 编码(UTF-8/UTF-16)

今天,在学习 Node.js 中的 Buffer 对象时,注意到它的 alloc 和 from 方法会默认用 UTF-8 编码,在数组中每位对应 1 字节的十六进制数。想到了之间学习 ES6 时关于字符串的 Unicode 表示法,突然就很想知道 UTF-16 是如何进行编码的,我尝试将一些汉字转换成二进制数,然后简单的按 2 个字节一组转换成十六进制,发现对于那些码点较大的汉字,结果并不仅仅是简单的二进制转十六进制。于是,我开始在网上找资料,决心彻底弄明白 Unicode 编码。 ASCII码 在学...

agony_isolate的博客 2621

Matlab:Matlab 软件学习之Matlab内置的各种系统的简介、案例应用(基于Simulink模糊控制仿真/二阶瞬态震荡电路案例)之详细攻略

选择左上角要编辑变量的图标,给定当前变量的论域Range,设置隶属函数类型type(八种隶属函数类型以供选择),最后选中某个隶属度函数(选中为红色),移动绘图区的每个隶属度函数的三个端点(竖向为权重)。(1)、首先在模糊规则编辑器左边选择一个输入变量,并选中它的一个语言值(隶属函数),然后编辑器右边选择一个输出变量,并选中它的一个语言值(隶属函数),然后将这种关系添加到模糊规则中。制定完成后,会形成模糊规则矩阵,系统会根据模糊输入量(如r1、r2),经过模糊规则(如45条),进而确定输出量(Y1、Y2)。

走向CTO之路 1122

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

Unicode和UTF-8编码

弄清楚几个概念 什么是字符? 百科定义:字符指类字形单位或符号,包括字母、数字、运算符号、标点符号和其他符号,以及一些功能性符号。 个人理解:字符是所有语言中最小单位的具有含义的一个符号,比如英语的字母、标点,中文的汉字、标点,还有其他语言的符号等等,可以简单理解为一个每种语言的字母或单独的字; 什么是字符编码?为什么需要字符编码? 字符编码是把字符集中的字符编码为指定集合中的某一对象(...

u013409186的专栏 2977

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

Golang 字符编码、UTF-8、Unicode之间的关系

Unicode 编码 UTF-8编码

Muti-Agent 3878

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

VS2008中Unicode编码转UTF-8编码

今天在pc客户端传数据(Json格式)给服务端时,在存储到数据库(Mysql)时总是出现乱码现象,使用的是http协议,以及json的解码(后一篇说明),这里我们先说下转码 在vs2008中编码方式有Unicode编码和多字节两种,由于我这里使用的是Unicode编码方式,而在后一篇中在对http的编程中就已经处理了多字节下转utf8格式,直接忽略本节使用即可。 涉及到的几个函数如下 st...

天行健的博客 2649

我所了解的GB2312、Unicode、GBK、UTF-8、BIG5等编码

小编一直对文字编码感到模糊,在学习、编程等过程中也经常会遇到与之相关的问题,无奈只能问百度。于是,为解决这一问题,小编花了一些时日了解和学习这些编码,整理出了这些编码的“性格特点”,“兴趣爱好”等等(文章中可能不全面,接受建议)。 有关文章参见:趣谈unicode,ansi,utf-8,unicode big endian这些编码有什么区别。 在这之前,我得先提一下ASCII码(American ...

Yangchenju的博客 1万+

Unicode与UTF-8编码互转C语言实现:项目的核心功能/场景

Unicode与UTF-8编码互转C语言实现:项目的核心功能/场景 去发现同类优质开源项目:https://gitcode.com/ Unicode与UTF-8编码互转C语言实现,助您轻松处理字符编码转换问题。 项目介绍 在全球化编程与数据处理中,字符编码的统一至关重要。Unicode与UTF-8是两种常见的编码方式。Unicode提供了一套全球统一的字符集,而UTF-8则是一种变长的编码方式,兼...

gitblog_06779的博客 871

Unicode UTF-8与GB18030编码解析(golang)

2019独角兽企业重金招聘Python工程师标准>>> ...

weixin_34221112的博客 2417
上一篇: idea注解能使用,但是注解不变色,注解依旧是灰色,也许不是网上说的省电模式的模式问题
下一篇: JavaSE(1)_计算机发展介绍、JAVA发展介绍、Java注解
自律彭于晏
博客等级 码龄5年 946粉丝 43原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值