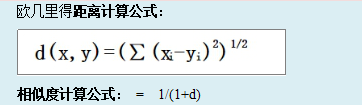大数据开发之机器学习总结(数学知识)(三)

【图书推荐】《Spark 3.0大数据分析与挖掘:基于机器学习》 Spark作为新兴的、应用范围广泛的大数据处理开源框架,吸引了大量的大数据分析与挖掘从业人员进行相关内容的学习与开发,其中ML是Spark 3.0机器学习框架使用的核心。本书用于Spark 3.0 ML大数据分析与挖掘入门,配套示例源码、PPT课件、数据集、思维导图、开发环境和作者答疑服务。 阅读详情

大数据开发之机器学习总结(数学知识)(三)

背景

  1. 在大数据开发业务场景中,如果是对数据做聚合或者明细统计等,则使用大数据的框架结合逻辑代码即可。
  2. 如果需要有更高层级的需求,例如做数据预测或者分类,则需要使用机器学习的技术来处理了。
  3. 如果需要更进一步让算法模型可以自我学习提升,则需要用到人工智能的技术。
  4. 机器学习是一门涉及到知识点非常广泛的计算机学科,概率统计,线性代数,高等数学,各类编程语言下的算法框架等等。
  5. 在现有大数据处理框架下,spark和flink对机器学习都有做支持,但相对更成熟的是spark的mllib模块。如果公司技术团队有使用spark经验,则学习和使用成本会大幅降低,唯一需要补充的就是算法知识和API调用。

1. 机器学习基础数学知识

1.1. 向量

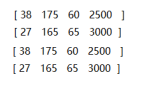
  1. 概念,简单来说,向量可以看成一串数字,不过每个数字都有自己的含义。如在这里插入图片描述
    这里可以看成是年龄,身高,退休年龄,工资。直接使用这样的形式表达含义。
    也可以结合多维空间坐标来理解向量,如(1,2,3)可以理解为x,y,z轴的坐标。当然实际开发时,往往不局限于3个坐标,往往是多个指标。就类似Kylin框架的多维立方体。
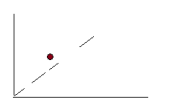
  2. 向量距离(可以理解为相似度)。向量是一个点,则向量和向量之间存在距离的概念。而测量距离在数学领域有很多方法,经典的欧几里德距离,但也还有曼哈顿距离和余弦距离。

有时候又将向量点之间距离称之为相似度,但注意,相似度和距离其实是相反的,距离越近,相似度越高。距离越大,相似度越小在这里插入图片描述

  1. 在机器学习算法中,相似度的计算是很核心的一个要素。如KNN分类,KMeans聚类,协同过滤推荐算法等,本质就是在计算事物和事物之间的相似度,即特征向量之间的相似程度。

可以看到,上述提到的算法其实就是做分类或者聚类,大家可以想一下,人以群分,如果一个app可以计算出一个用户是哪一类的用户,可以计算出一个用户和另外一个用户相似度多少,这时候就可以针对性给这个用户做推荐,或者做关联用户推荐(两个相似用户,则可以给一个用户推荐另外一个用户喜欢的东西,大概率也会很高)

  • 欧几里德距离在这里插入图片描述
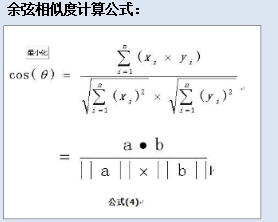
  1. 余弦相似度距离
    在这里插入图片描述
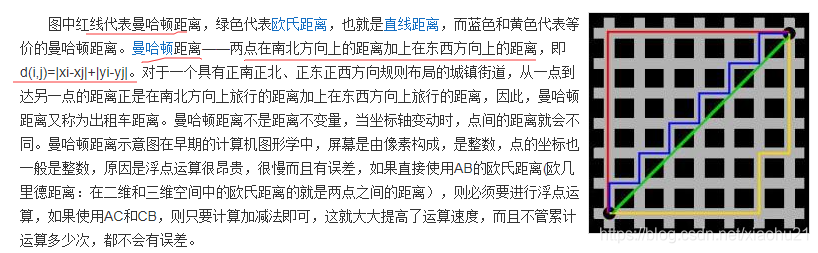
  2. 曼哈顿距离
    在这里插入图片描述

注意,这几个距离的适用场景不太一样,如果需要计算相似度,则余弦法更合适,如果计算空间距离也就是典型的2个特征之间距离,欧几里德方法更合适

1.2 矩阵

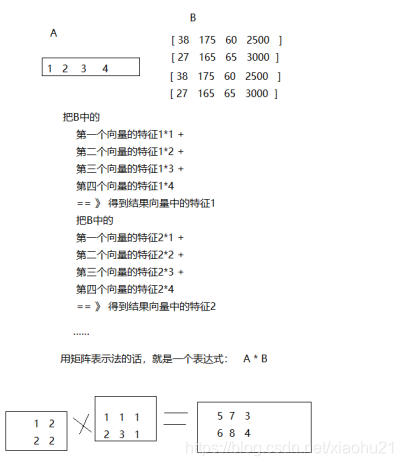
  1. 矩阵可以看作是多个向量之间的集合
    在这里插入图片描述
    从这个角度来看,矩阵方便对向量做批量运算,如需要对上述矩阵每个向量都乘以5,可以直接表达成 矩阵*5 =》C * 5
  2. 矩阵简单计算在这里插入图片描述
  3. 矩阵在代码中,可以理解为多维数组,其实图片就可以看成是2维数组,每一个像素的信息就保存在一个二维数组的元素中。
  4. 其实在机器学习,人工智能等尖端领域,数学计算会大量用到矩阵,编程代码则会大量用到迭代(类似递归的思想)

1.3 概率

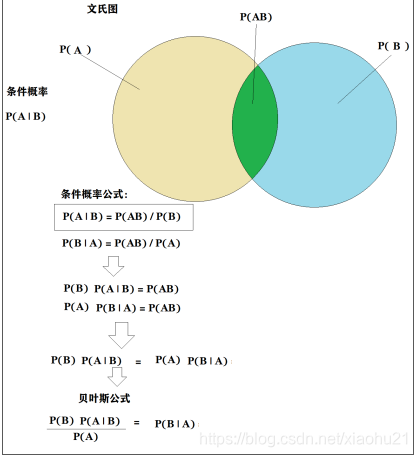
  1. 联合概率 P(A^B) :多件事情都发生的可能性!
  2. 条件概率
    P(A | B) = P(A^B) / P(B)
    P(B | A) = P(A^B) / P(A)
    在这里插入图片描述

这个概率公式可以看出,如果P(B|A)不好计算,可以反过来,拿P(A|B),很多时候可能就有不一样的结果。
在概率统计中,有先验概率和后验概率,很多时候后验概率不好计算,可以利用这个公式,用先验概率换个思路得出

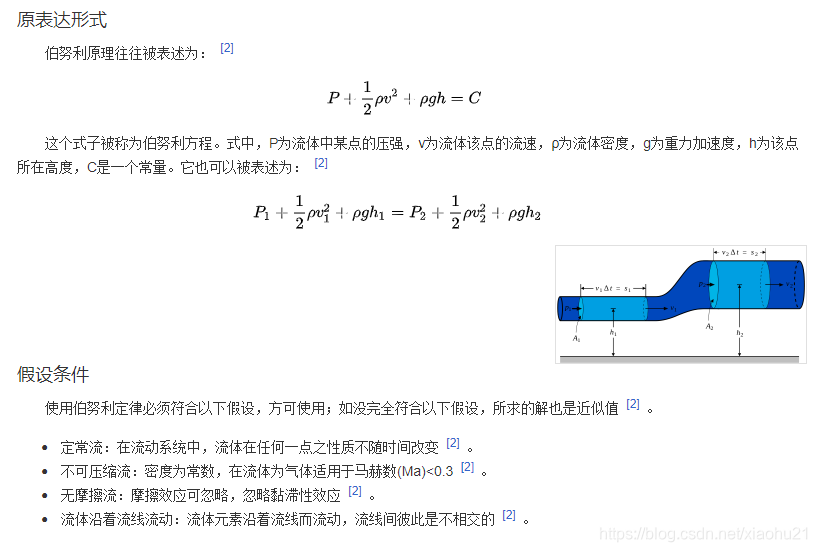
  1. 伯努利方程
    在这里插入图片描述
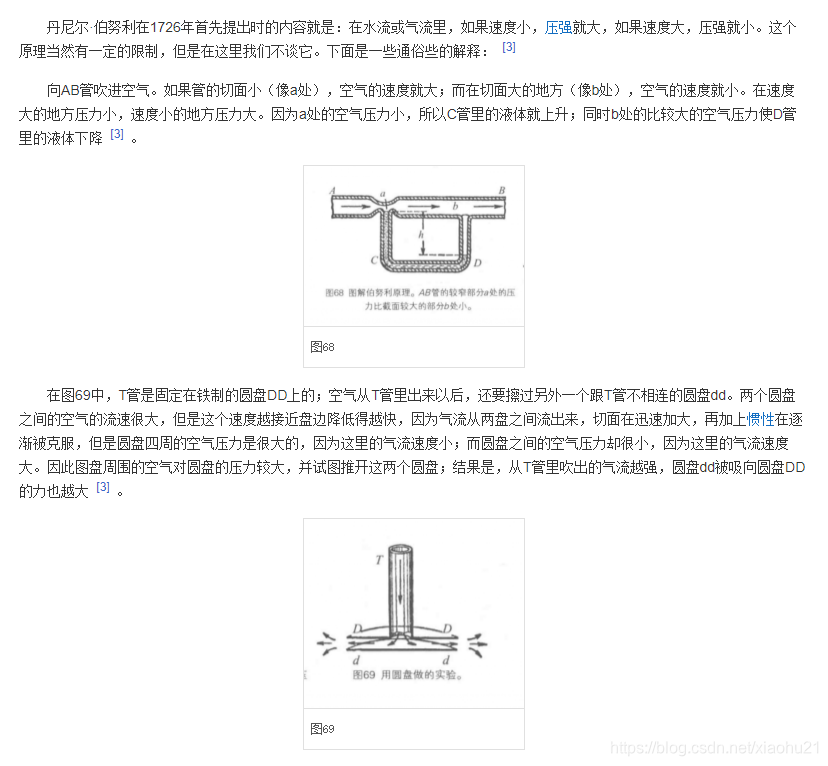
    在这里插入图片描述
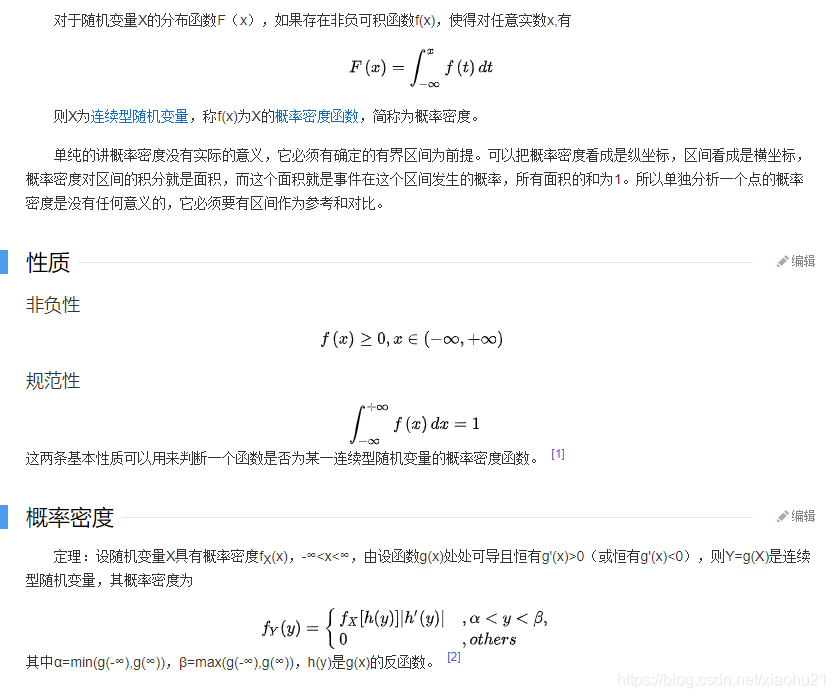
  2. 概率密度
    概率指事件随机发生的机率,对于均匀分布函数,概率密度等于一段区间(事件的取值范围)的概率除以该段区间的长度,它的值是非负的,可以很大也可以很小在这里插入图片描述
    在这里插入图片描述
  3. 概率分布
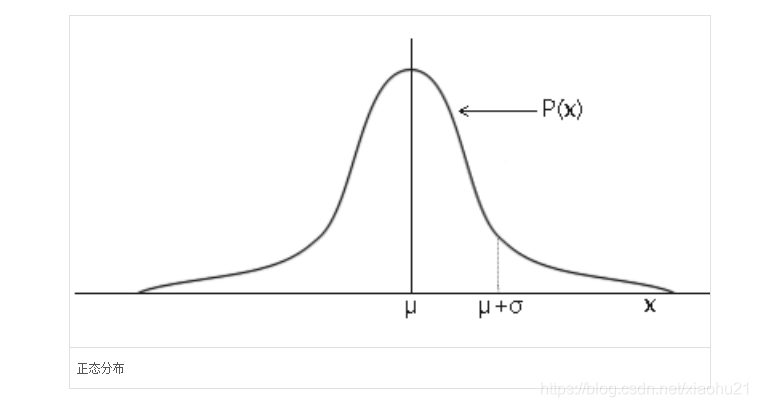
  • 正态分布
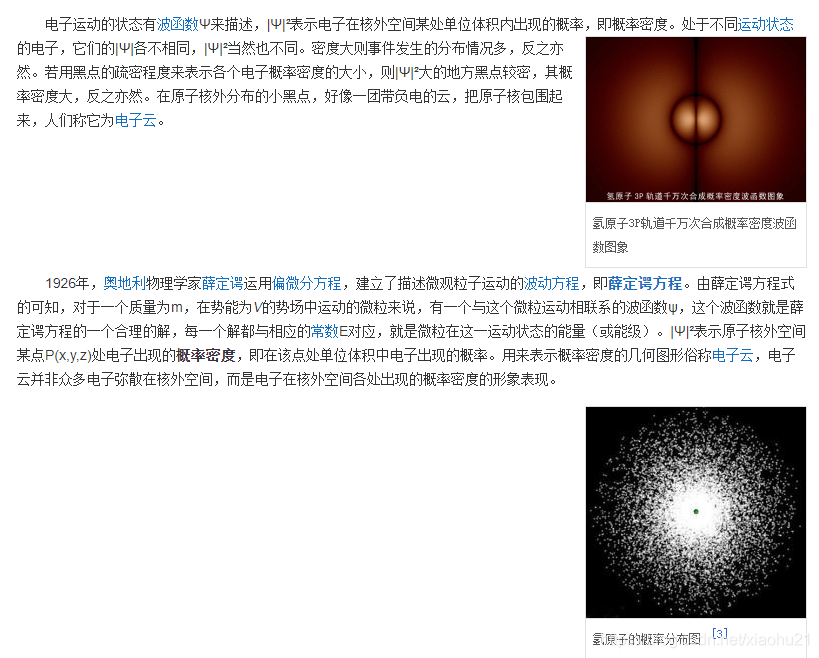
    在这里插入图片描述
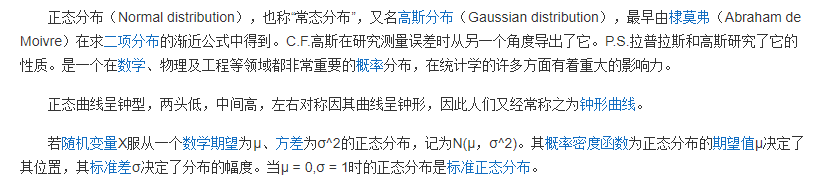
    在这里插入图片描述
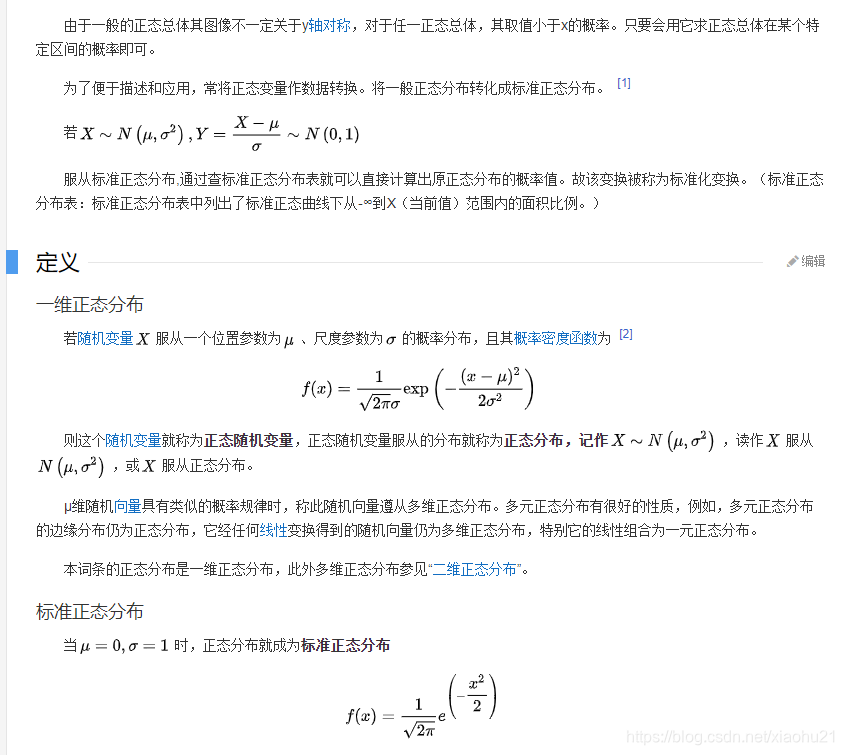
    在这里插入图片描述

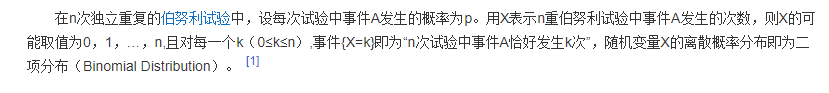
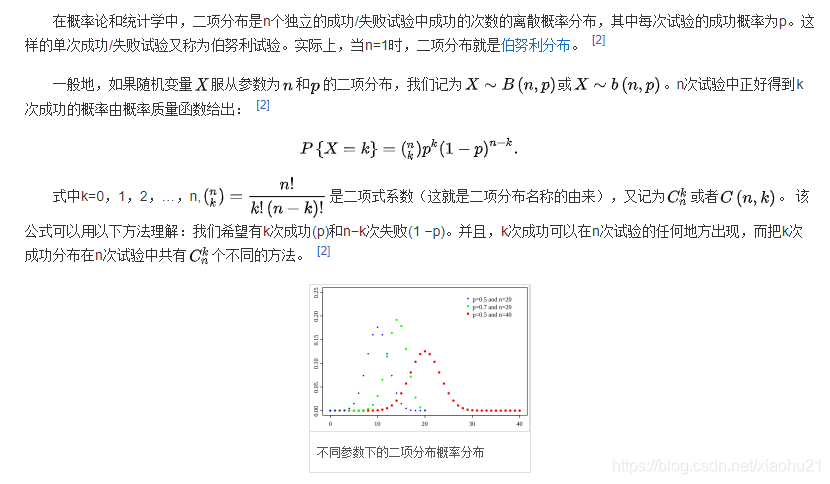
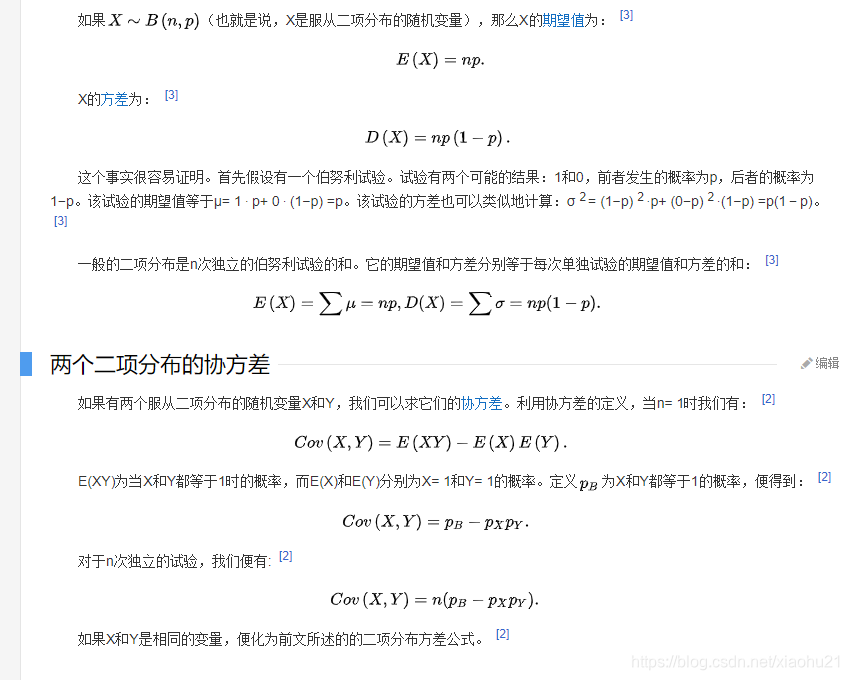
  • 二项分布
    在这里插入图片描述
    在这里插入图片描述
    在这里插入图片描述

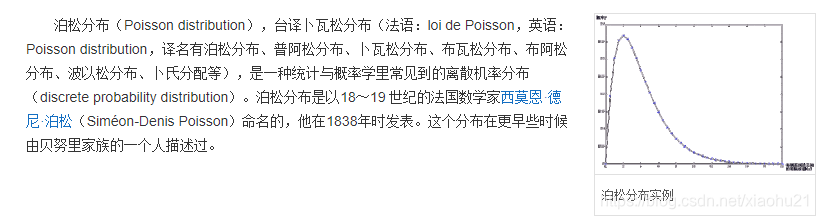
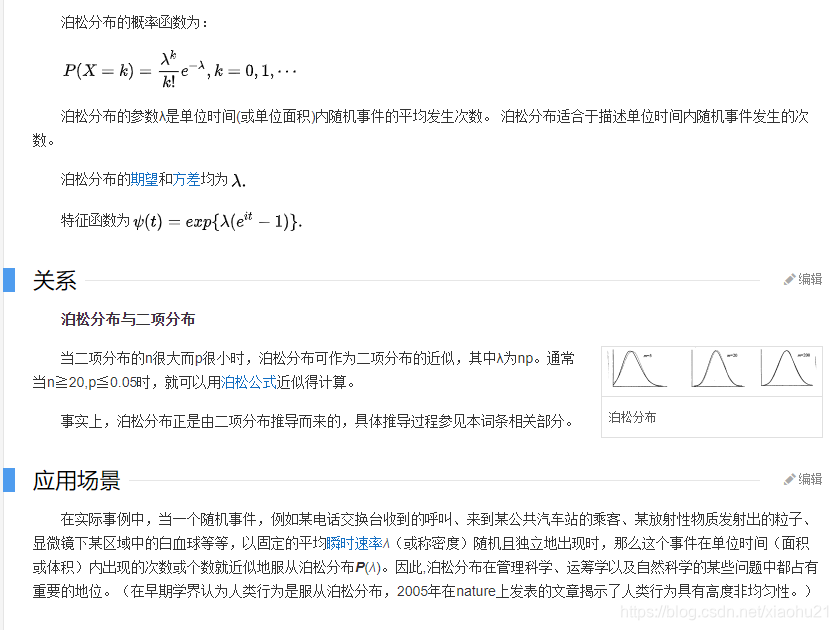
  • 泊松分布
    在这里插入图片描述
    在这里插入图片描述
    在这里插入图片描述

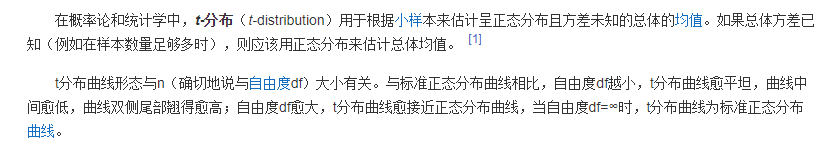
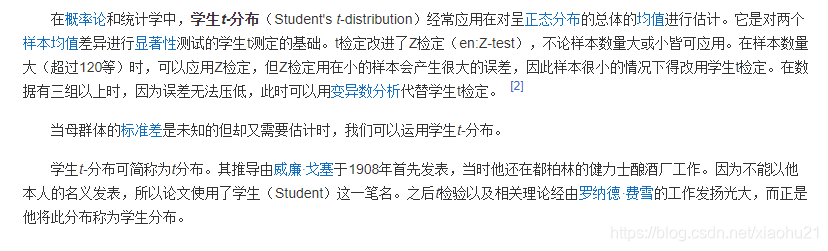
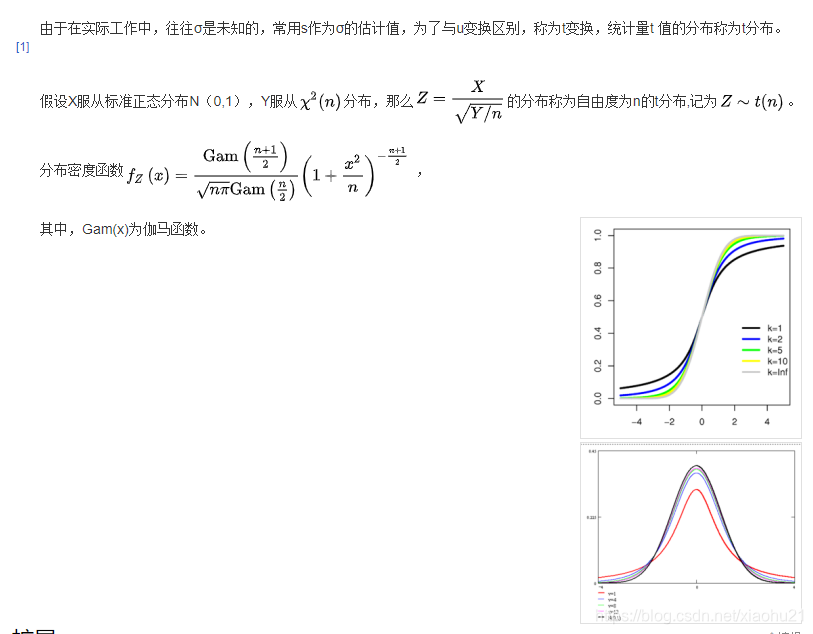
  • t分布
    在这里插入图片描述
    在这里插入图片描述
    在这里插入图片描述

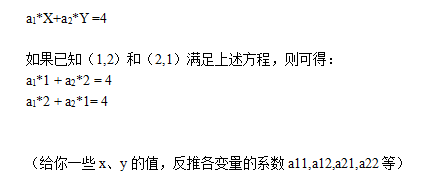
1.4 线性方程

  1. 其实就是类似初中学习的线性方程,因变量和自变量之间关系是一次方关系
    在这里插入图片描述

2. 总结

  1. 从编程角度来看,算法可以分为数据结构算法和 数学算法
  2. 数学结构算法,常常可以在各个框架中接触到,如排序算法,如贪心算法等等
  3. 数学算法,则往往是数学算法用于编程问题解决,这类场景在机器学习和人工智能应用最广泛和普遍
  4. 大学毕业之后,如果打算学习机器学习,但是忘记了线性代数,概率统计,高等数学的,可以准备捡起来了

新手学习大数据必问的十个问题 无论在学习群、星球还是私底下,总有很多想学大数据的同学会问这几个问题。今天列举了这十个高频问题,虽然基础,但是经典。 1. 电脑需要什么配置? 学大数据的电脑配置主要在内存方面,至少8G,上不封顶,一般16G够用。当然这只是学习层面,自己搭虚拟机玩玩。工作中,公司自然会给你分配服务器让你工作。 2. 有哪些方向? 数据开发、数据分析、数据挖掘。其中每个大方向又拆分了几个小方向。 三者... 阅读详情

相关推荐

大数据开发技能更进一步

学习大数据开发前需要掌握哪些技能?   1. 数学知识   数学知识是数据分析师的基础知识。   对于初级数据分析师,了解一些描述统计相关的基础内容,有一定的公式计算能力即可,了解常用统计模型算法则是加分。   对于高级数据分析师,统计模型相关知识是必备能力,线性代数(主要是矩阵计算相关知识)也有一定的了解。   而对于数据挖掘工程师,除了统计学以外,各类算法也需要熟练使用,对...

qq_43958381的博客 502

大数据和机器学习的关系

在网上查了一些资料,整理了一下大数据,数据挖掘,机器学习,深度学习和云计算这些概念的区别和联系,希望能对数据科学的初学者有所帮助

猿始森林 1万+

大数据,算法总结

本文档,整理总结了大数据平台相关知识,常用机器学习算法以及深度学习等算法方面的知识

大数据开发中关于机器学习,需要掌握哪些知识点呢?

在我们平时的大数据开发工作中,机器学习也是经常用到的技能。相对于其他知识点,这部分的内容相对占的比重也是很高的。那么想要从事大数据开发应该掌握哪些机器学习的技术呢? 大数据开发及架构师相关课程免费推广报名中,点击“了解更多”报名学习 机器学习相关的知识点如下: 1、机器学习介绍 什么是机器学习、机器学习与人类思考的对比、简单的线性回归 2、线性回归详解 简单的线性回归 多元现行回归...

wshyb0314的博客 912

PLC1200使用CB1241RS485通讯模块做从站进行Modbus Rtu通信

添加新设备(PLC)->设备和网络管理->点击PLC->看到硬件目录选择通信板->点到点->CB1241(RS485)->看到6ES7241-1CH30-1XB0选择添加,如图。指向Modbus保持寄存器数据块的指针 我这里指向了自定义的DB块数据中一个INT数组。在通信->通信处理模块->MODBUS(选择不带RTU的通信指令块)注意:接线时,TRA接485调试模块的B- TRB接调试模块的A+组态后的硬件标识符 270 对应自己组态后自动生成的。1:事务完成,且无任何错误。波特率对应自己使用的。

swmyaopeng的博客 2万+

别再傻傻分不清:PX4、Pixhawk、ArduPilot、APM到底啥关系?一张图给你讲明白

本文全面解析开源飞控领域核心概念,厘清PX4、Pixhawk、ArduPilot与APM的定位与关系。通过硬件平台演进史和飞行控制软件对比,帮助开发者理解开源飞控生态,并提供新项目开发建议与特殊需求考量,助力无人机开发中的明智选择。

weixin_32770423的博客 413

最全解析:大数据和机器学习有什么区别

最全解析:大数据和机器学习有什么区别     大数据的定义 大数据(big data),指无法在一定时间范围内用常规软件工具进行捕捉、管理和处理的数据集合,是需要新处理模式才能具有更强的决策力、洞察发现力和流程优化能力的海量、高增长率和多样化的信息资产。 大数据是一个笼统的概念暂未发现和准确的定义。 大数据的核心是利用数据的价值,机器学习是利用数据价值的关键技术,对于大数据而言

分享AI、区块链技术及应用,未来已来 1062

模型参考自适应控制(MRAC):让PID参数动态优化

本文深入解析模型参考自适应控制(MRAC)技术,它通过实时调整PID参数,使控制系统能自动适应系统特性变化和外部干扰。文章详细介绍了MRAC的工作原理、数学基础,并提供了用C语言实现的实战代码示例,帮助工程师解决传统PID控制在非线性、时变系统中参数整定繁琐的难题。

tequila的博客 903

大数据开发之机器学习总结(二)

大数据开发之机器学习总结(二) 1. 精确率和召回率 监督学习中,如何评估一个模型的效果,这时候就需要相办法做指标评估。 监督学习中,针对分类场景,一般是分类准确率,定义为分类器对测试集正确分类的样本数与总样本数之比 对于二类分类问题,常用指标就是精确率和召回率,这时候按照真实数据所属类比与模型预测结果组合划分,有如下 2. 回归问题 监督学习中,回归就是基于已有数据,找出输入和输出之间规律,然后根据输入的数据,得出预测的结果数据。 有点类似新建一个函数,来贴合现有的函数。这叫做拟合 回归问题分类

xiaohu21的博客 331

转录因子详细介绍(motif)

转录因子详细介绍(motif) TF: transcription factor转录因子TFBS: transcription factor binding site转录因子结合位点TFBS是序列内的location,TF特异结合在这里,这个site有这种特点 1 和一些参考相关的一个位置(开始,结束,strand),这些reference可以是染色体开始,geneTSS。也可以是一段sequence 2 A SITE可以是实验证实的(已知的),也可以是一些算法(预测的) 3 例子,下面这个图是酵母

wangprince2017 3万+

告别抓包:一个Xposed模块教你监控抖音App的本地数据变化

本文详细介绍了如何利用Xposed框架开发模块,实现抖音App本地数据监控的技术方案。通过Hook关键方法,开发者可以实时获取用户信息、推荐算法参数等核心数据,无需Root设备即可高效调试。文章包含完整的环境配置、代码实现和优化技巧,为移动应用开发与测试提供创新解决方案。

weixin_27015733的博客 385

什么是大数据开发?

♥️大数据开发是干什么的? 大数据作为时下火热的IT行业的词汇,随之而来的数据开发、数据仓库、数据安全、数据分析、数据挖掘等等围绕大数据的商业价值的利用逐渐成为行业人士争相追捧的利润焦点。随着大数据时代的来临,大数据开发也应运而生。 大数据开发其实分两种,第一类是编写一些Hadoop、Spark的应用程序,第二类是对大数据处理系统本身进行开发。第一类工作感觉更适用于data analyst这种...

大数据工程师 7820

Android Framework SurfaceFlinger面试题及参考答案

请简述 SurfaceFlinger 在 Android 系统中的作用。 SurfaceFlinger 是 Android 系统中一个非常关键的服务。它主要负责将多个应用程序的 Surface 合成到一个屏幕显示内容中。 从应用程序的角度来看,每个应用都有自己的 UI 界面,这些 UI 界面实际上是由一系列的图层(Surface)构成。例如,一个应用可能有背景图层、按钮图层、文本图层等。应用通过向 SurfaceFlinger 提供这些 Surface 来请求显示。 SurfaceFl

大模型大数据攻城狮的专栏 1186

学习机器学习,主要牵涉到哪些数学知识?

放假在家想写写机器学习系列的文章,除夕前先来开个头,后面会一直写下去,搞机器学习算法也有一年多了,体会多少还是有一些的,这里记录在博客中,一来为自己后面的面试做点储备,二来是为了分享,因为很多都是从大家的博客中去学习的,所以这里也要将我理解的新的内容反馈出来,大家一起学习进步。      机器学习中涉及到的数学知识      数学在计算机中的重要性不言而喻,这里也不多说了,先在这里罗列一下机器学习...

多智时代的博客 3021

SD卡烧写Linux kernel——SD卡分区,并烧写uboot,kernel,DTB及filesystem

Linux Ubuntu环境下对SD卡分区(烧写uboot,kernel,及filesystem) 介绍dd命令的使用,SD卡分区、格式化、复制文件等 fdisk命令

weixin_42408707的博客 5057

ARM CoreLink 系列 5.1.1 -- CI-700 System Address Map 】

所有的CHI 命令都包含一个 Source ID 和 Target ID, 其中 Source ID 可以来自于 RN Node, Target ID 可以来自于HN node或者其他 SN node. 其中 Target ID 是通过 SAM解析传入的地址得到的。对于 CI-700中的所有 RN Node 中的 SAM 多会进行配置,因为RN Node 访问的是整个地址空间,不同的地址空间会有不同的属性(I/O, DRAM),所以会对RN SAM 配置多个不同属性的区域。

CodingCos的博客 771

jem-video:助您掌握大数据必备数学知识

jem-video:助您掌握大数据必备数学知识 项目介绍 jem-video 是一个开源项目,它包含了一系列视频教程、代码样例和补充资料,旨在帮助商务人士和工程师掌握大数据分析所需的数学知识。这个项目是 O'Reilly Media 视频教程《Just Enough Math》的配套资源库,由 Paco Nathan 主导开发。通过这个项目,用户可以学习到高级数学概念,并通过实际业务案例和简单的 ...

gitblog_00635的博客 757

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

从入门到精通,计算机er如何快速掌握机器学习(ML)?

写在前面 机器学习是一门涉及概率论、统计学、逼近论、凸分析、算法复杂度理论等多门学科的多领域交叉学科,在当下各个领域运用十分广泛。不仅是业内人士,许多业外人士为了丰富自己的知识涉猎领域,提升自身竞争力,也或多或少的开始尝试接触机器学习。 需要进行大量手工调整才能解决的问题,机器学习算法通常可以简化代码、提高性能; 问题复杂,传统方法难以解决,最好的机器学习方法可以找到解决方案; 复杂世界有波动,机器学习算法可以适应新数据;洞察问题和大量数据…… 那么,对于计算机小白来说,如何

Baoyan_cs的博客 2822

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

《Spark 3.0大数据分析与挖掘:基于机器学习》简介

#好书推荐##好书奇遇季#《Spark 3.0大数据分析与挖掘:基于机器学习》,京东当当天猫都有发售。Spark作为新兴的、应用范围广泛的大数据处理开源框架,吸引了大量的大数据分析与挖掘从业人员进行相关内容的学习与开发,其中ML是Spark 3.0机器学习框架使用的核心。本书用于Spark 3.0 ML大数据分析与挖掘入门,本书配套示例源码、PPT课件、数据集与答疑服务。 本书内容 本书共分13章,从Spark 3.0大数据分析概述、基础安装和配置开始,依次介绍ML的DataFrame、ML的基

夏天又到了的专栏 3786

新手大数据必问十个问题

无论在学习群、星球还是私底下,总有很多想学大数据的同学会问这几个问题。今天列举了这十个高频问题,虽然基础,但是经典。 1. 电脑需要什么配置? 学大数据的电脑配置主要在内存方面,至少8G,上不封顶,一般16G够用。当然这只是学习层面,自己搭虚拟机玩玩。工作中,公司自然会给你分配服务器让你工作。 2. 有哪些方向? 数据开发、数据分析、数据挖掘。其中每个大方向又拆分了几个小方向。 三者...

大数据Hadoop学习 961

python大数据工程师薪资待遇_大数据开发工程师薪资待遇及招聘要求?

目录:大数据开发是干什么的?大数据开发需要掌握哪些技术?学习路线如何?大数据开发需要掌握数学知识吗?大数据开发就业前景如何?大数据开发工程师薪资待遇及招聘要求?大数据开发是干什么的?大数据作为时下火热的IT行业的词汇,随之而来的数据开发、数据仓库、数据安全、数据分析、数据挖掘等等围绕大数据的商业价值的利用逐渐成为行业人士争相追捧的利润焦点。随着大数据时代的来临,大数据开发也应运而生。大数据开发其实...

weixin_39794734的博客 370
上一篇: Hive数据导入到HBase
下一篇: 大数据开发之机器学习总结(Spark Mllib)(四)
闻香识代码
博客等级 码龄12年 314粉丝 223原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值