


目录
一.基础概念
1.概述
数据仓库(Data Warehouse)工具
基于Hadoop的
将 结构化的数据文件 映射成一张表
提供了类SQL的HQL的查询功能
本质:将sql语句转换为MapReduce任务进行运行( 记住 ),本质上就是MapReduce
作用: 对海量的大数据(结构化)数据进行分析和统计。
HQL:HQL是Hibernate Query Language的缩写,提供更加丰富灵活、更为强大的查询能力;
HQL更接近SQL语句查询语法。
数据仓库: 英文名称为Data Warehouse ,存储各种类型的数据,面向主体(分类存储), 存储大量的数据,数据的不可以更新,可以一直追加数据。
2.组成架构
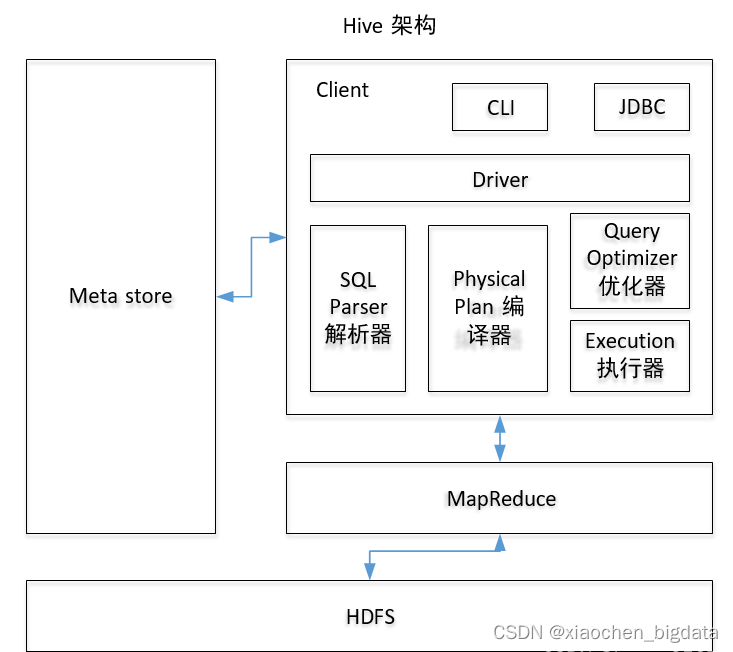
1. 用户使用命令行工具或者JDBC发送HQL
2. 使用Driver驱动结合MetaStore元数据,将指定翻译成MapReduce
3. 首先使用SQL Parser解释器进行HQL的翻译
4. 使用编译器对解释结果进行编译
5. 使用优化器对编译结果进行优化
6. 最后将优化的结果使用执行器进行执行操作(本质上就是在Hadoop集群上使用MapReduce操作)
7. 将处理结果返回给客户端用户
组成:客户端接口、Hive的引擎(驱动)、元数据、Hadoop
说明:
元数据(数据的描述信息:表的名称,数据库的名称,权限,所有者,组成字段等等)
默认情况下存储在hive内部自带的derby数据库中
问题:derby数据库,在同一时刻,只允许一个线程操作
建议:使用MySQL对元数据进行存储
Hive的引擎:
解释器、编译器、优化器、执行器 (顺序)
Hadoop:
执行Hive
Client 接口:用户操作、访问Hive 的方式(jdbc,cli... ...)
3.特点
Hive使用HQL实现对数据的操作,操作方便简单(比MapReduce操作方便)
Hive处理大数据(比MySQL/Oracle强大)
Hive提供的大量的工具
Hive支持自定义函数,使用自定义需求
Hive实现离线数据分析
Hive使用类SQL语句实现功能,处理业务的范围受限(SQL语法所能表达的业务受限)
Hive运行效率较低(延迟高,离线数据分析)
4.hive和传统数据库区别比如mysql
存储位置:Hive数据存储在HDFS上。数据库保存在块设备或本地文件系统 。
数据更新:Hive不建议对数据改写。数据库通常需要经常修改 。
执行引擎:Hive通过MapReduce来实现。数据库用自己的执行引擎 。
执行速度:Hive执行延迟高,但它数据规模远超过数据库处理能力时,Hive的并行计算能力就体现优势了。数据库执行延迟较低。
数据规模:hive大规模的数据计算。数据库能支持的数据规模较小 。
扩展性:Hive建立在Hadoop上,随Hadoop的扩展性。数据库由于ACID语义的严格限制,扩展有限 。
二.基础操作
常用命令
1.进入hive数据库
hive
2.查看某个数据库
show databases;
3.进入某个数据库
use 数据库;
4.查看所有表
show tables;
5.显示表结构
desc 表名;
6.查询表数据
select * from 表名;
7.显示表名的分区
show partitions 表名;
8,创建数据库
CREATE SCHEMA userdb;
9.删除数据库
DROP DATABASE IF EXISTS userdb;
DROP SCHEMA userdb;
10.创建数据表
use xxdb; create table xxx; #内部表
创建一个表,结构与其他一样
create table xxx like xxx;
创建一个表,结构数据与其他一样,相当于复制一个表
create table xxx as xxx;
创建内部表
创建内部表,制定分隔符为tab键
create table tb_name(name1 int,name2 string) row format delimited fields terminated by '\t';
创建外部表
创建外部表,制定分隔符为tab键
create external table tb_name(name1 int,name2 string) row format delimited fields terminated by '\t';
创建分区表
创建分区:分区依据(Id int)
create table tb_name(
id int,
name string
) partitioned by (Id int)
row format delimited fields terminated by '\t';
普通表和分区表区别:有大量数据增加的需要建分区表
内外表转换
内部表转外部表
alter table table-name set TBLPROPROTIES('EXTERNAL'='TURE');
外部表转内部表
alter table table-name set TBLPROPROTIES('EXTERNAL'='FALSE');
删除分区
#注意:若是外部表,则还需要删除文件(hadoop fs -rm -r -f hdfspath)
alter table table_name drop if exists partitions (d='2016-07-01');
11.加载数据列表
把本地数据装载到数据表,也就是在metastore上创建信息
load data local inpath '/root/a.txt' into table tb_name;
把HDFS上的数据装载到数据表
load data inpath '/target.txt' into table tb_name;
加载数据到分区表必须指明所属分区
load data local inpath './book.txt' overwrite into table tb_name partition (Id = 10);
12.重命名表
ALTER TABLE 表名1 RENAME TO 表名2;
13.删除表
drop table 表名;
或者
drop table if exists 表明;
14.插入表数据
向有分区的表插入数据
(1)覆盖现有分区数据,如果没有该指定分区,新建该分区,并且插入数据
INSERT OVERWRITE TABLE 库名.表名 PARTITION(dt='2018-09-12',name='Tom', ...)
SELECT ... FROM 库名.表名 where...
(2)向现有的分区插入数据 (之前的数据不会被覆盖)
INSERT INTO TABLE 库名.表名 PARTITION(dt='2018-09-12',name='Tom',...)
SELECT ... FROM 库名.表名 WHERE ...
向无分区的表插入数据
(1) 覆盖原有表里的数据,命令和有分区的表类似,只是去掉后面的PARTITION(dt=’ ‘,name=’ ')
INSERT OVERWRITE TABLE 库名.表名
SELECT ... FROM 库名.表名 where...
(2) 向现有的表插入数据 (之前的数据不会被覆盖)
INSERT INTO TABLE 库名.表名
SELECT ... FROM 库名.表名 WHERE ...
15.表结构修改
增加字段
alter table table_name add columns(newscol1 int conment '新增');
修改字段
alter table table_name change col_name new_col_name new_type;
删除字段
删除字段(COLUMNS中只放保留的字段)
alter table table_name replace columns(col1 int,col2 string,col3string);
16.分桶表
对于每一个表或者分区,Hive可以进一步组织成桶,也就是说桶是更为细精度的数据范围划分。
桶的使用一定要设置如下属性:
hive.enforce.bucketing = true;
创建一个桶:
# 按(id)分为4个bucket
create table tb_name (
id int,
name string
) clustered by (id) into 4 buckets
row format delimited fields terminated by ',';
通过子查询插入数据:
insert into tb_name1 select * from tb_name;
17.创建一个视图
create view v_name as
select table1.column1, table2.column2, table3.column3
where table1.column1 = table2.column2;

 3万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


