
HBase系列(四)、HBase优化之RowKey 设计

【大数据学习 | HBASE高级】rowkey的设计,hbase的预分区和压缩 regionserver堆栈内存大小,官方推荐每台regionserver内存大小设置20-24G,不推荐设置更大,因为更大的堆栈内存GC效率较低。,rowkey的设计至关重要,会影响region分布,如果rowkey设计不合理还会出现region写热点等一系列问题。需求:hbase存储的是用户的交易信息, 我想查某个用户在某个时间段内的交易记录,如何设计rowkey。用户id(md5), 用户名称, 交易时间, 交易金额, 交易说明。,或者数据在刚开始插入的数据都在一个region中,使得。 阅读详情

目录

前言

RowKey设计

设计原则

解决热点问题

Salt加盐

Reverse反转

Hash散列或Mod取余


HBase系列:


前言

上一篇中我们提到了HBase的读写原理,可以看出HBase是为写操作优化,更适合写多读少的场景,尤其是因为数据按列族和Region切分成一个个的StoreFile,在跨多文件查询数据的时候就会很慢。同时,由于Region切分策略,会让HFile出现数据倾斜的情况,因此我们在实际应用中首先要先设置预分区,指定HBase表有几个分区,每个分区内的RowKey范围,然后我们只要将RowKey的值尽可能均匀的放置在这些Region内即可。本篇我们就来介绍如何通过RowKey的设计提升HBase的读性能。

前面的文章中也提到,HBase只能通过RowKey查询数据:指定RowKey查询、指定RowKey区间查询、全表扫描。所以通常我们也会利用第三方组件如solr,elasticsearch对HBase做二级索引,提升查询效率,在后面的文章中再具体介绍。

RowKey设计

设计原则

Rowkey设计的优劣直接影响读写性能,HBase中的数据是按照RowKey的ASCII 字典顺序进行全局排序。ASCII码表:
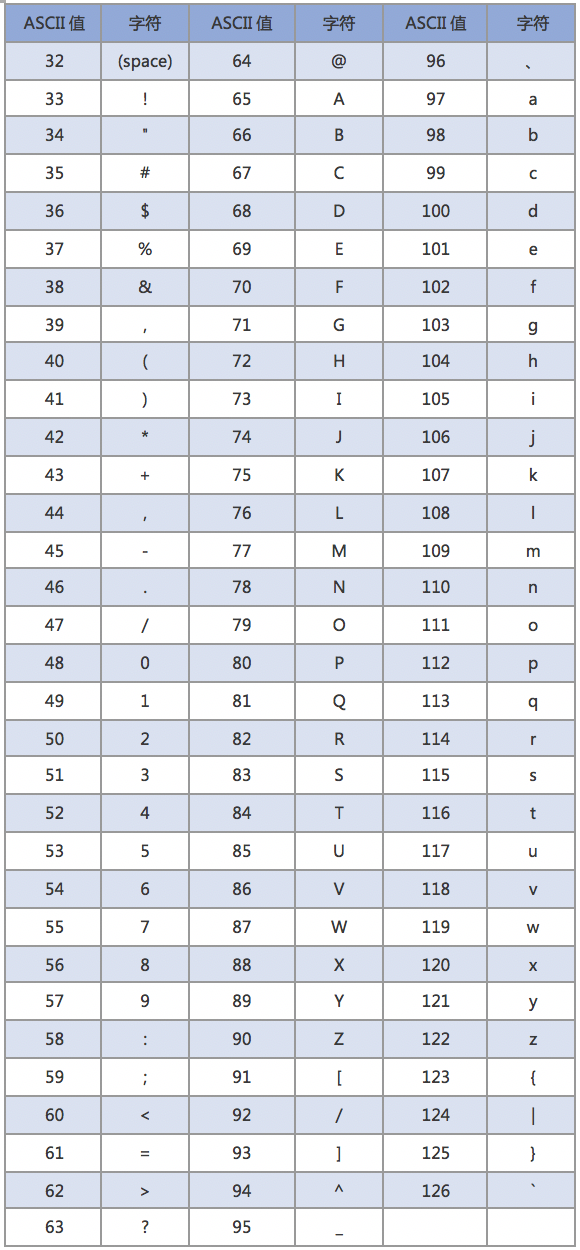
RowKey设计应遵循以下原则:

长度原则

RowKey是一个二进制存储的值,RowKey的长度尽量控制在10~100个字节,建议是越短越好。 原因如下:

  • HFile 按照KeyValue存储,如果RowKey过长比如500个字节,1000万列数据光是RowKey就要占用500*1000万=50亿个字节≈5GB数据,非常影响HFile的存储效率;
  • MemStore中维护着Flush之前的数据,如果RowKey字段过长的话会占用很多内存,导致系统无法缓存更多的数据,影响查询效率;

唯一原则

由于RowKey用来唯一标识一行记录,所以必须在设计上保证RowKey的唯一性:

  • HBase中数据存储是Key-Value形式,若HBase中同一表插入相同Rowkey,则原先的数据会被覆盖掉(如果表的version设置为1的话),所以务必保证Rowkey的唯一性;

排序原则

HBase会把RowKey按照ASCII进行自然有序排序,所以反过来我们在设计RowKey的时候可以根据这个特点来设计完美的RowKey,好好的利用这个特性就是排序原则;

散列原则

在上面也提到,只要我们尽量将数据均衡的分布在每个Region内,就可以预防数据倾斜的情况。假如按照时间戳作为rowkey的前缀会导致大量数据堆积在一个RegionServer上导致Region热点问题,当大量读写请求到该RegionServer上时会对该RS的负载压力过高从而影响性能甚至出现故障;

解决热点问题

解决RegionServer热点现象需要良好的RowKey设计,让数据尽可能均匀的分布在每个Region下,通常有三种方案:加盐、反转、散列。 

Salt加盐

在原RowKey的前面添加固定长度的随机数,也就是给RowKey分配一个随机前缀使它和之前的RowKey的开头不同。

例:在一个有3个Region以(,h)、[h,x)、[x,z)为Region分区的HBase表中,有下面三个rowkey:wykcsdn001,wykcsdn002,wykcsdn003 ,这三个rowkey会被分布在[x,z)这个region内,加盐后变成qwe_wykcsdn001,asd_wykcsdn002,zxc_wykcsdn003,这三个rowkey会被均匀分布在三个region分区内。

wykcsdn001-->qwe_wykcsdn001

wykcsdn002-->asd_wykcsdn002

wykcsdn003 -->zxc_wykcsdn003

加盐之后的吞吐量是之前的三倍,但加盐也有缺点:盐是随机字符串,在查找的时候不知道该盐的内容,读这些数据时需要耗费更多的时间,所以加盐增加了写操作的吞吐量,不过缺点是同时增加了读操作的开销。

Reverse反转

针对固定长度的Rowkey进行反转,将Rowkey中经常改变的部分放在最前面,可以有效的随机Rowkey。典型的比如手机号,时间戳这类数据前缀几乎都是一样的,最后几位更有随机性。反转之后得到的字符串即保证了随机性又不会像加盐一样无法得知rowkey的真实值。但反转也牺牲了Rowkey的有序性。

例:

182xxxx7890-->0987xxx281

182xxxx6379-->9736xxx281

182xxxx1355-->5531xxx281

20200911145043-->34054111900202

20200911145058-->85054111900202

20200911145501-->10554111900202

Hash散列或Mod取余

hash比较好理解,将原来的rowkey内容或部分前缀通过hash算法(MD5、sha1、sha256、sha512)生成更加随机的字符串。相比于加盐的方式,hash后的字符串既可以使负载分散到整个集群,又可以通过原rowkey的值算出hash值来读取数据。

对于纯数字型的rowkey,也可以使用mod取余的方式来将其打散。

例:

wyk001-->66079de6861d926bcd08da5878283601

wyk002-->344fd201bd135f5ad7d45ad5668e1438

wyk003-->81264b3ace502fec8c76a6991c0eeaed

123456789%21-->15

123459999%21-->12

123458888%21-->14

在工作中,我们也可以结合项目的实际情况结合这几种方式来设计RowKey,以预防Region热点。


希望本文对你有帮助,请点个赞鼓励一下作者吧~ 谢谢! 

大白话彻底搞懂HBase RowKey详细设计 本文从RowKey的原理,可能出现的问题,如何优化及各个优化措施对应的缺点和适用的场景,设计原则等角度对RowKey进行了详细全面的解析,相信一定能对你有所帮助。 阅读详情

相关推荐

hbase系列-Hbase热点问题、数据倾斜和rowkey的散列设计

1、分布式与并行处理 分布式系统 通常,我们说分布式系统的时候,我们都会想到Dubbo框架和SpringCloud框架。这两个框架现在应该是国内用的比较多的两个分布式框架了,特点都是很容易把服务部署在多台机器组成一个高可用的服务集群来应对高并发。所以,我们通常认为分布式系统就是多台机器组成一个集群对外提供服务,每个请求也会被分配到集群中的一台或者多台机子上完成,而用户是感觉不同整个系统封装

weixin_41279060的博客 1万+

rowkey设计原则和方法

rowkey设计首先应当遵循三大原则: rowkey长度原则 rowkey是一个二进制码流,可以为任意字符串,最大长度为64kb,实际应用中一般为10-100bytes,它以byte[]形式保存,一般设定成定长。 一般越短越好,不要超过16个字节,注意原因如下: 1、目前操作系统都是64位系统,内存8字节对齐,控制在16字节,8字节的整数倍利用了操作系统的最佳特性。 2、hbase将部分数据加载到...

qq_34896163的博客 3303

HBase(18):表空间设计之ROWKEY设计原则

因为ROWKEY我们是使用多个字段拼接,而且前缀不是完全随机的,所以需要使用HexStringSplit。long类型为8个字节,8个字节可以保存非常大的无符号整数,例如:18446744073709551615。如果是字符串,是按照一个字节一个字符方式保存,需要快3倍的字节数存储。如果ROWKEY设计的都是按照顺序递增(例如:时间戳),这样会有很多的数据写入时,负载都在一台机器上。在HBase中,可以通过指定start key、end key来进行分区,还可以直接指定Region的数量,指定分区的策略。

u013938578的博客 1041

HBase之Rowkey设计

HBase之Rowkey设计 Rowkey基础 Rowkey按自然顺序存储的,且具有唯一性,示例如下a_022 a_101 b_123 f_031 f_051 f_131 z_121 当数据是有序的时候,通常利用二分查找的方式进行点查询、范围查询是最有效的(hash只能进行点查)。HBase的Rowkey查询正是遵循这种规律。 Rowkey的查询可以分为两大类 Get 点查询,给定一个ro...

蒋含竹的博客 2169

HBase RowKey设计与Spark数据存储优化案例

RowKey是HBase表中每行数据的唯一标识符,类似传统关系型数据库中的主键概念。它不仅用于唯一标识表中的行,而且在HBase中还决定了行的物理存储位置。HBase使用RowKey作为行的排序依据,因此RowKey的值会直接影响到数据的存储方式和访问顺序。本章节介绍了RowKey在HBase中的基本概念、设计原则以及设计对数据访问性能的影响。在设计RowKey时,需要综合考虑其唯一性、紧凑性、倾斜性及预见性,以及如何通过合适的RowKey设计来优化数据的读写和查询性能。

weixin_29215509的博客 903

STM32L452与FPGA通信翻车?手把手教你关闭I2C时钟延展避坑(附OVR错误解决方案)

本文深入解析STM32L452与FPGA在I2C通信中因时钟延展功能导致的常见问题,提供关闭I2C时钟延展的详细配置方法(NOSTRETCH模式),并针对可能出现的OVR错误给出Combined模式解决方案。通过实战案例和波形分析,帮助工程师快速排查和解决嵌入式系统中的I2C兼容性问题。

e3f4g5的博客 215

rowKey设计原则

rowkey设计原则 a.唯一原则 一定要保证当前的rowkey是所有数据的唯一一行 b.长度原则 在满足唯一原则的基础上,尽可能的减少rowk的容量大小 如果rowkey有特殊的排序需求的时候,要补齐位数 rowkey理论上支持64k的容量,一般10-100byte比较合理,越短越好 c.散列原则 如果按照keyPrefix原则拆分region,容易产生热点问题,比如手机号段 解决热点问题: 1...

weixin_47869733的博客 2126

CNN卷积神经网络手写数字识别实例及代码详解

本文的代码来自githup的Deep Learning的toolbox,是用Matlab实现的。感谢该toolbox的作者付出和分享。 我在应该该代码进行训练时,出现一些报错,如expand函数应用不对,flipall函数未定义等问题,对这些问题进行了修正,完成网络训练和验证。 本文mnist_uint8.mat的获取可以参照我的另一篇博客:MNIST数据库处理--matlab生成mnist_

VivienFu的专栏 6万+

HBase的RowKey详解、RowKey设计原则和RowKey优化方法

HBase的RowKey详解、RowKey设计原则和RowKey优化方法

xdx_dili的博客 7612

macOS Jdk1.8安装(目前主流版本的jdk)

添加环境环境变量,类似于windows的高级设置中path配置的环境变量。查看 JAVA_HOME 目录。查看 JDK 版本信息。一直下一步安装就好了。在终端的根目录下运行。

m0_50207524的博客 9353

[kriging](一)网上下载的kriging克里金的C++程序的初步调试

笔者在网上下载了一份克里金的C++程序,水平有限,正在逐步地调试中。 初步 克里金法现在在许多软件都已经有集成了,据笔者所知: arcgis : 看过有的arcgis培训视频里面简略介绍了里面的插值方法,有克里金。 surfer :笔者用过这个,效果很好。 gocad :听说有 landmark &jason :研究生时候用的专业的石油物探软件,里面有克里金法,万恶的开始。 pykrig...

FOREST优快云 5610

HBase RowKey设计原则深度解析:构建高性能HBase应用的关键

原则核心思想实现方法效果长度原则短小精悍定长设计、编码压缩节省内存、提高效率散列原则分布均匀散列前缀、加盐负载均衡、避免热点唯一原则绝不重复组合键、时间戳数据完整、排序有效最佳实践口诀RowKey设计三原则,牢记在心不犯错长度要短定长好,内存节省效率高散列前缀分布匀,热点问题都跑掉唯一性要保证好,排序特性利用妙组合设计多思考,业务需求兼顾到核心要点长度原则:RowKey越短越好,建议10-20字节散列原则:高位散列,避免热点Region唯一原则:组合保证唯一,利用排序特性。

✨ 欢迎来到【Seal ^_^ 的优快云博客】!✨ 2779

SAP Fiori单点登录避坑指南:从SAML原理到实战,解决‘第一次登录跳转主页失败’和‘偶发进不了单点’

本文深入解析SAP Fiori单点登录(SSO)的SAML实战与疑难排查,涵盖SAML协议核心机制、SICF登录优先级控制及安全诊断工具的高级用法。针对‘首次登录跳转主页失败’和‘偶发单点登录失效’问题,提供从配置优化到生产环境稳定运行的全面解决方案,助力企业高效实现数字化转型。

weixin_29327977的博客 405

HBase RowKey设计

检索habse的记录首先要通过row key来定位数据行。当大量的client访问hbase集群的一个或少数几个节点,造成少数region server的读/写请求过多、负载过大,而其他region server负载却很小,就造成了“热点”现象。

爱是与世界平行 2184

大数据运营可视化:Tableau+PowerBI数据看板搭建教程

当企业数据量从“GB级”跃升到“TB级”,运营人员面临的最大挑战不再是“如何收集数据”,而是“如何让数据说话”。数据看板作为“运营指挥中心的仪表盘”,能将零散的用户行为、业务指标、流量趋势浓缩成可快速解读的视觉语言。本文结合Tableau(自由探索的“数据瑞士军刀”)与PowerBI(微软生态的“组合家具”)两大工具,从需求分析→数据准备→指标设计→视图搭建→ dashboard 组合,一步步教你搭建符合业务逻辑的运营看板。

AI智能探索者的博客 1362

TC3XX - MCAL知识点(二十九):FLS MCAL配置及代码实战(英飞凌DFLASH)

FLS驱动程序为DFlash 0的初始化、读取、写入和擦除提供了定义良好的配置和标准服务。除此之外,我们还提供一些非autosar服务示例 Fls_17_Dmu_CompareWordsSync、Fls_17_Dmu_CancelNonEraseJobs、Fls_17_Dmu_VerifyErase,LFls_17_Dmu_VerifySectorErase、Fls_17_Dmu_GetNotifCaller等。用户通过FLS驱动程序获得对底层DFlash0的封装访问。

梦想技术家 2363

HBase的RowKey设计

HBase是三维有序存储的,通过rowkey(行键),column key(column family和qualifier)和TimeStamp(时间戳)这个三个维度可以对HBase中的数据进行快速定位。HBase中rowkey可以唯一标识一行记录,在HBase查询的时候,有三种方式:通过get方式,指定rowkey获取唯一一条记录通过scan方式,设置startRow和stopRow参数进行范围匹配全表扫描,即直接扫描整张表中所有行记录。

a_black03的博客 1304

海康visionmaster开发笔记10-集成HALCON第三方算子到VM工具箱的方法

海康visionmaster开发笔记10-HALCON第三方算子到VM工具箱的方法

视觉人机器视觉的博客 4347

Hbase之Rowkey设计原则

一、rowkey设计原则 二、不同模式下rowkey设计 1.写优化 hashing散列 salting加盐 Reverse反转 2.读优化 三、rowkey设计案例 1 设计订单状态表 2 登录、下单等等统称事件(event)的临时存储

南风知我意 3819

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

用大白话彻底搞懂 HBase RowKey 详细设计

来源 |且听_风吟 来源 | 优快云 博客,责编 | Carol封图| 优快云 付费下载于东方 IC 前言RowKey作为HBase的核心知识点,RowKey设计会影响到数据在H...

优快云云计算 7974

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

HBase系列--RowKey的设计原则

1. RowKey是什么? 与nosql数据库们一样,RowKey是用来检索记录的主键。访问HBASE table中的行,只有三种方式: 通过单个RowKey访问(get) 通过RowKey的range(正则)(like) 全表扫描(scan) RowKey行键 (RowKey)可以是任意字符串(最大长度是64KB,实际应用中长度一般为 10-100bytes),在HBASE内部,RowKey保存为字节数组。存储时,数据按照RowKey的字典序(byte order)排序存储。设计RowKey时,要充分

qq_32961283的博客 1912

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

HBase之rowkey如何设计

1.HBase的存储形式 Key由RowKey(行键)+ColumnFamily(列族)+Column Qualifier(列修饰符)+TimeStamp(时间戳–版本)+KeyType(类型)组成,而Value就是实际上的值。修改一条数据其实上是在原来的基础上增加一个版本的,那我们要准确定位一条数据,那就得(RowKey+Column+时间戳)。 其在region内大多以升序的形式排列,唯一的时logTime是以降序的形式进行排列。 所以,rowKey里越靠近左边的信息越容易被检索到。其设计时,要考虑把重

古柏树下的博客 2174

总结:HBase的rowkey设计

参考:一篇文章带你快速搞懂HBase RowKey设计 一、RowKey在查询中的作用 HBase中RowKey可以唯一标识一行记录,在HBase中检索数据有以下三种方式: 通过 get 方式,指定 RowKey 获取唯一一条记录 通过 scan 方式,设置 startRow 和 stopRow 参数进行范围匹配 全表扫描,即直接扫描整张表中所有行记录 二、rowkey设计技巧 1、越高频的查询字段排列越靠左 下面根据一个例子分别介绍下根据RowKey进行查询的时候支持的情况。 如果我们Ro

w2009211777的专栏 4249

【HBase学习之三】HBase RowKey设计

一、背景        HBase是三维有序存储的,通过rowkey(行键),column key(column family和qualifier)和Timestamp(时间戳)三个维度可以对hbase中的数据进行快速定位。RowKey可以唯一标识一行记录,在HBase查询的时候,常见有以下两种方式: 1)通过get方式,指定rowkey获取唯一一条记录。 2)通过scan方式,设置star...

懂幸福,爱生活 1723

HBase RowKey设计和实现

HBase由于存储特性和读写性能,在OLAP即时分析中发挥重要作用,Rowkey的设计好坏关乎到HBase的使用情况。我们知道HBase中定位一条数据需要四个维度的限制:RowKey,Column Family,Column Qualifier,Timestamp。RowKey是其中最容易出错的,不仅需要根据业务和查询需求来设计,还有很多地方需要关注。

wenqi 2757

Hbase的二级索引和RowKey的设计

Hbase查询简介 Hbase查询的时候,有以下几种方式: • 通过 rowkey方式,指定 获取唯一记录 • 通过 scan方式,设置satrtRow 和stopRow 参数进行范围匹配(模糊查询) • 全表扫描,即直接扫描整张表中所有行记录 HBase里面只有rowkey作为一级索引 Hbase的scan,不走主键索引,而是全表扫描,性能奇差。 为了HBase的数据查询更高效、适应更多的场景, 诸如使用非rowkey字段检索也能做到秒级响应,或者支持各个字段进行模糊查询和多字段组合查询等,

数据与算法架构提升之路专栏 2513
上一篇: HBase系列(三)、读写原理,Flush刷写,HFile Compact合并,Region Split切分
下一篇: 分布式存储系统Kudu(一)、核心原理
王义凯_Rick
王义凯_Rick 领域专家: 大数据技术领域 领域专家: 大数据技术领域
博客等级 码龄14年 858粉丝 162原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

王义凯_Rick

遇见即是缘,路过就给个评论吧~

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值