impala&hive大数据平台数据血缘与数据地图(一)-解析impala与hive的血缘日志

HIVE数仓数据血缘分析工具-SQL解析 一、数仓经常会碰到的几类问题: 1、两个数据报表进行对比,结果差异很大,需要人工核对分析指标的维度信息,比如从头分析数据指标从哪里来,处理条件是什么,最后才能分析出问题原因。 2、基础数据表因某种原因需要修改字段,需要评估其对数仓的影响,费时费力,然后在做方案。二、问题分析: 数据源长途跋涉,经过大量的处理和组件来传递,呈现在业务用户面前,对数据进行回溯其实很难。元数据回溯在有效决策、策略制定 阅读详情

impala数据血缘与数据地图系列:

1. 解析impala与hive的血缘日志

2. 实时采集impala血缘日志推送到kafka

---------------------------------解析impala与hive血缘日志-------------------------------------------------------------

Impala血缘:

CDH官方文档impala数据血缘:

https://docs.cloudera.com/documentation/enterprise/latest/topics/impala_lineage.html

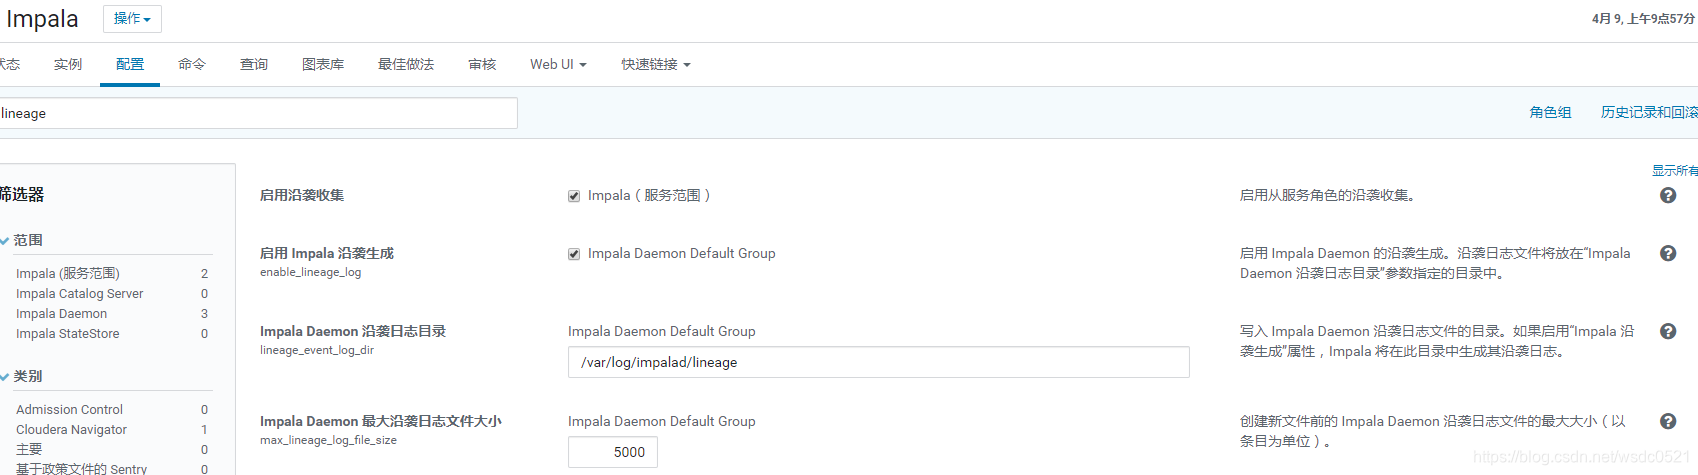
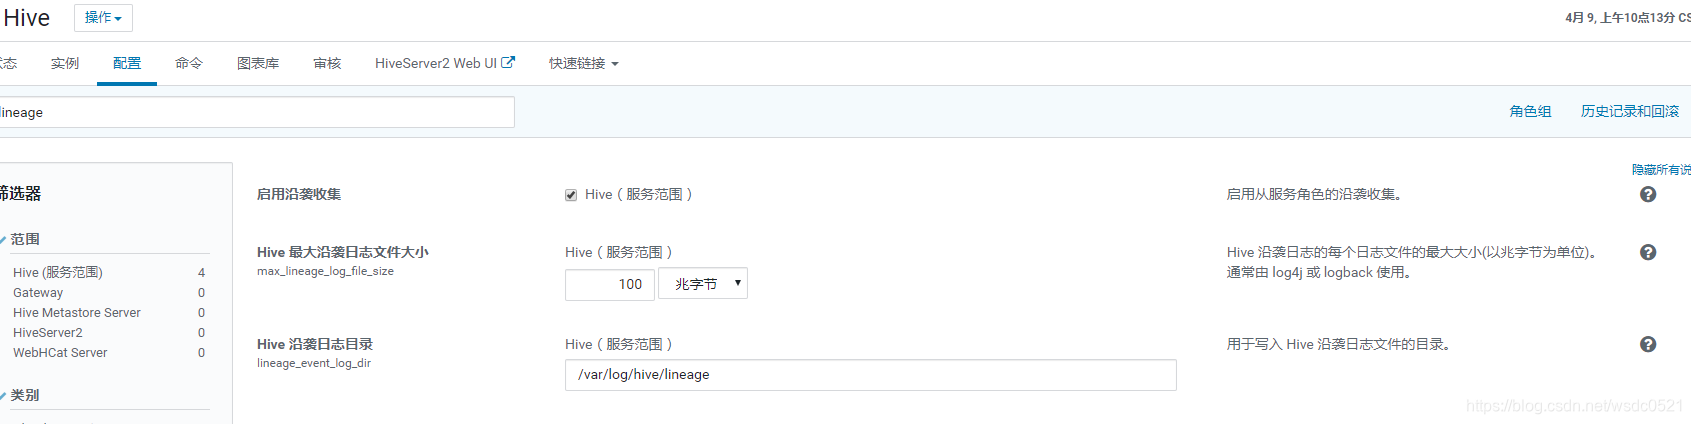
在CM中找到该参数:

开启impala血缘,以及配置血缘日志路径及文件最大限制。

参数:lineage_event_log_dir

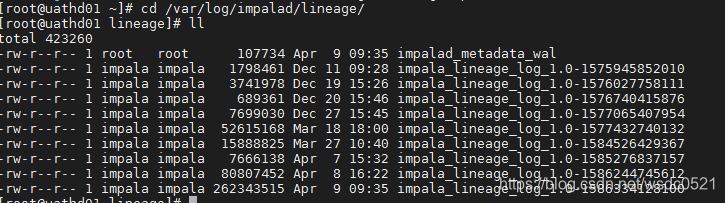
目录:每个impala daemon节点下 /var/log/impalad/lineage

需要注意的是这里只记录执行成功的脚本。

我这里使用的是CDH6.2版本,与CDH5的版本在日志记录的结构上有所区别,但区别不大。 


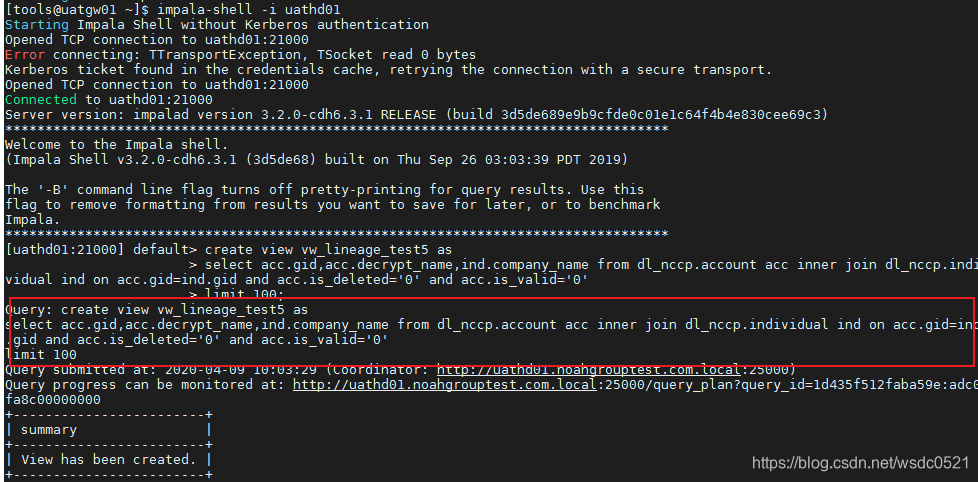
测试:使用impala-shell 指定impala daemon节点启动命令行,执行SQL命令,然后查看该daemon节点最新日志。

impala-shell -i uathd01

这里我创建一个视图:
然后到uathd01的节点看最新血缘日志:
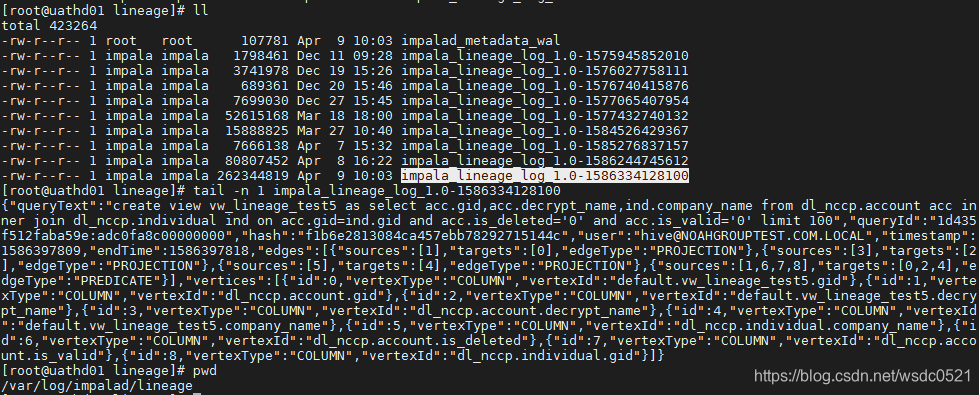
把这段json串拿出来格式化一下看看:

queryText:执行的命令

queryId : impala的执行ID

hash: sql的hash

user:执行该命令的用户

timestamp: 开始时间戳

endTime:结束时间戳

edges: 记录每个source到target的映射关系,edgeType为PREDICATE的部分是所有source字段到所有的target字段id的映射,edgeType为PROJECTION的是每个source字段到每个target字段的映射,这里是多对一的关系,即如果有一个目标字段是由两个源字段处理得来的话,这里的sourceid和targetid就是一个多对一的关系,但如果是一个源字段处理出了两个目标字段,在这里仍旧是两个代码块。

vertices: 该SQL内所有的源和目标字段,与edges中的id一一对应。

{
	"queryText": "create view vw_lineage_test5 as select acc.gid,acc.decrypt_name,ind.company_name from dl_nccp.account acc inner join dl_nccp.individual ind on acc.gid=ind.gid and acc.is_deleted='0' and acc.is_valid='0' limit 100",
	"queryId": "1d435f512faba59e:adc0fa8c00000000",
	"hash": "f1b6e2813084ca457ebb78292715144c",
	"user": "hive@NOAHGROUPTEST.COM.LOCAL",
	"timestamp": 1586397809,
	"endTime": 1586397818,
	"edges": [
		{
			"sources": [
				1
			],
			"targets": [
				0
			],
			"edgeType": "PROJECTION"
		},
		{
			"sources": [
				3
			],
			"targets": [
				2
			],
			"edgeType": "PROJECTION"
		},
		{
			"sources": [
				5
			],
			"targets": [
				4
			],
			"edgeType": "PROJECTION"
		},
		{
			"sources": [
				1,
				6,
				7,
				8
			],
			"targets": [
				0,
				2,
				4
			],
			"edgeType": "PREDICATE"
		}
	],
	"vertices": [
		{
			"id": 0,
			"vertexType": "COLUMN",
			"vertexId": "default.vw_lineage_test5.gid"
		},
		{
			"id": 1,
			"vertexType": "COLUMN",
			"vertexId": "dl_nccp.account.gid"
		},
		{
			"id": 2,
			"vertexType": "COLUMN",
			"vertexId": "default.vw_lineage_test5.decrypt_name"
		},
		{
			"id": 3,
			"vertexType": "COLUMN",
			"vertexId": "dl_nccp.account.decrypt_name"
		},
		{
			"id": 4,
			"vertexType": "COLUMN",
			"vertexId": "default.vw_lineage_test5.company_name"
		},
		{
			"id": 5,
			"vertexType": "COLUMN",
			"vertexId": "dl_nccp.individual.company_name"
		},
		{
			"id": 6,
			"vertexType": "COLUMN",
			"vertexId": "dl_nccp.account.is_deleted"
		},
		{
			"id": 7,
			"vertexType": "COLUMN",
			"vertexId": "dl_nccp.account.is_valid"
		},
		{
			"id": 8,
			"vertexType": "COLUMN",
			"vertexId": "dl_nccp.individual.gid"
		}
	]
}

Hive:
 同impala类似,不再赘述,区别仅仅是日志的json格式以及记录的详细程度的区别。

 应用:

接下来就是如何使用这些血缘的日志,我们已经分析了impala血缘日志的结构,接下来只要使用日志采集工具filebeat或flume,logstash等工具采集每个impala daemon节点上的日志,然后对每个json串进行解析即可,后面的文章会演示如何实时采集impala血缘到kafka,消费kafka里的血缘数据处理后写入neo4j数据库内进行数据血缘数据地图的展示。
Hive数据血缘分析:追踪数据来源的完整方案 数据血缘(Data Lineage)指的是数据从产生到最终使用的整个过程中,数据的流动和转换轨迹。在Hive中,数据血缘包括数据的来源表、经过的查询操作、转换逻辑以及最终的输出表或查询结果。例如,一个Hive查询从一个原始的销售记录表中提取数据,经过计算销售额、分组等操作后,插入到一个汇总表中,这个过程中数据从销售记录表到汇总表的流动及中间的转换就是数据血缘的体现。本文深入探讨了Hive数据血缘分析这一重要主题。 阅读详情

相关推荐

深入解析Vivado FIFO的Standard与FWFT模式:性能对比与应用场景

本文深入解析了Vivado FIFO的Standard与FWFT两种工作模式的核心差异。通过对比数据就绪时机、读延迟、控制逻辑和有效深度等关键特性,并结合图像处理、数据包转发等典型应用场景,为FPGA设计者提供了清晰的选择依据和实战配置指南,帮助优化数据流性能与设计效率。

weixin_29219189的博客 254

impala&hive大数据平台数据血缘与数据地图(四)-impala血缘架构图及功能介绍

最近在内部做了个分享,顺便画了一下这次impala数据血缘的架构图: 架构图: 如果想了解如何实现请参照前面几篇文章: impala数据血缘与数据地图系列: 1. 解析impala与hive的血缘日志 2. 实时采集impala血缘日志推送到kafka 3. 实时消费血缘记录写入neo4j并验证 ---------------------------------Impala血缘 架构图-----------------------------------------------------

王义凯 的博客 5551

时间序列分析:ARCH、GARCH、TGARCH与DCC-GARCH波动率模型(含代码)

关注TGARCH模型和DCC-GARCH的应用,通过在沪深300和中证500指数上应用TGARCH和DCC-GARCH模型,揭示这两个指数之间的条件异方差及动态相关性的变化规律。

celiaweiwei的博客 1万+

Impala查询流程日志分析

UHP博客文章地址:http://yuntai.1kapp.com/?p=1060 原创文章,转载请注明出处:http://blog.youkuaiyun.com/wind5shy/article/details/8563355 物理环境 主节点 10.28.171.33 处理节点1 10.28.171.40 处理节点2

风之谷 1万+

pgsql:还原数据库后出现重复序列导致“more than one owned sequence found“报错问题的解决

pgsql数据库通过备份数据库文件进行还原时,如果表中有自增序列,还原后可能会出现重复的序列,此时若向表中插入新行时会出现“more than one owned sequence found”的报错提示。还原数据库时把序列取消勾选,选择不还原序列。因为还原表的同时,会自动将自增序列还原上去,此处勾选会导致数据库重复创建序列。点击还原数据库完毕后,可以看到序列仅有一个,没有出现重复序列。但此时的序列当前值是从1开始的,需要重置。点击菜单“其它”-》“序列”,可以看到有多个重复序列。

奋斗鱼 1043

Python气象雷达数据处理实战:用PyCINRAD从基数据到PPI图的完整流程

本文详细介绍了使用PyCINRAD库处理气象雷达基数据并生成PPI图的完整流程,涵盖环境配置、数据读取、反射率与速度数据提取、可视化优化等关键步骤。通过实战案例演示如何从原始雷达数据到专业级PPI图像生成,为气象研究和业务应用提供高效解决方案。

yog99的博客 758

使用 Impala 日志(翻译)

2019独角兽企业重金招聘Python工程师标准>>> ...

weixin_34241036的博客 1269

EDA虚拟机分享2020版本(Synopsys2020)

EDA虚拟机分享

亦安的数字小站 9189

如何查看Impala集群的状态和日志

【代码】如何查看Impala集群的状态和日志。

大模型大数据攻城狮的专栏 1178

【OpenClaw企业级智能体实战】第27篇:Skill生态运营——企业私有Skill商店的搭建与审核机制

2026年ClawHavoc供应链攻击事件曝光超1200个恶意Skill渗透公共技能市场,工信部明确要求企业审慎使用第三方技能包并严格审查代码。本文基于真实安全事件与行业实践,完整讲解企业私有Skill商店从0到1搭建方案,覆盖小团队极简GitLab私有仓库、中大型企业Nacos 3.2私有Registry两种主流架构,配套企业级安全审核四步法、静态代码扫描规则、CI/CD自动化审计、数字签名校验与版本生命周期管理。

专注于人工智能、软件开发、工控自动化、工厂数字化及智能化等领域,希望和大家共同进步! 500

STM32F103VCT6+W5500 TCP 服务端通信

STM32F103VCT6 W5500的TCP连接通讯的程序

坚韧与专注 7818

impala&hive大数据平台数据血缘与数据地图(三)-实时消费血缘记录写入neo4j并验证

impala数据血缘与数据地图系列: 1. 解析impala与hive的血缘日志 2. 实时采集impala血缘日志推送到kafka -----------------------------------------实时采集impala血缘日志推送到kafka----------------------------------------------------- 前两篇介绍了如何采集impala和hive的血缘日志以及如何实时将该日志采集到kafka消息队列中,今天来介绍如何实时消费血缘日志并写入

王义凯 的博客 3812

【图论】系列(一)之图论的构成

图论是研究图的数学分支,本章介绍了图论的基本构成和概念

qq_30066733的博客 748

impala&hive大数据平台数据血缘与数据地图(二)-实时采集impala血缘日志推送到kafka​​​​​​​

impala数据血缘与数据地图系列: 1. 解析impala与hive的血缘日志 2. 实时采集impala血缘日志推送到kafka -----------------------------------------实时采集impala血缘日志推送到kafka----------------------------------------------------- 使用filebeat采集...

王义凯 的博客 1719

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

IMSL CNL 7.0.0 (x86-64)Crack

IMSL CNL 7.0.0 (x86-64)Crack intel的算法库破解文件,这是C++版本的破解文件

数仓字段血缘解析实现—hive版

​【本文大纲】 1、字段血缘分析的意义 2、实现方案选择 3、实现过程 4、总结 字段血缘分析的意义 数仓经常会碰到的两类问题: 1、两个数据报表进行对比,结果差异很大,需要人工核对分析指标的维度信息,比如从头分析数据指标从哪里来,处理条件是什么,最后才能分析出问题原因 ——数据回溯问题 2、基础数据表因某种原因需要修改字段,需要评估其对数仓的影响,费时费力,然后...

张伟的专栏 6268

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

聊聊Hive数据血缘——从Atlas没有列级血缘的Bug讲起

正文共:9053字12图预计阅读时间:23分钟前几天,Datahub提供了最新的字段级别数据血缘功能,很多朋友迫不及待想对比一下Datahub的字段级血缘与Atlas的区别。这个时候问题来了,在Atlas收集Hive血缘的时候,由于部分版本问题,没有显示出字段级的数据血缘。这是为什么呢?其实只要做一个简单的修复就可以了,但是知其然也要知其所以然。今天我们就来看一下这个问题到底...

大数据流动 3190

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

Hive SQL血缘解析

Druid可以直接获得所有的列 http://t.csdn.cn/mO4TX 利用Hive提供的LineageLogger与Execution Hooks机制做血缘 https://blog.youkuaiyun.com/qq_44831907/article/details/123033137 Apache Calcite gudusoft 解析方案 商业 https://blog.youkuaiyun.com/qq_31557939/article/details/126277212 6.github开源项目: https:

qq_40382400的博客 2831

HIVE 字段级血缘分析 写入Neo4j

Step 1. 利用HIVE Hook LineageLogger 获取字段之间的依赖关系 注意:LineageLogger Hook 是Hive2.0版本之后存在的,如果HIVE版本不够需要升级HIVE版本。PS.CDH有的HIVE版本添加此功能 下面以hive 2.5.3版本为例 添加参数 vim /usr/local/hive/conf/hive-site.xml <property&...

xw514124202的博客 1万+

python抽取数据库元数据_0797-使用HDP或CDP的Atlas采集CDH6的元数据和血缘

作者:谢敏灵Atlas元数据采集框架 目的基于以上框架,使用HDP或CDP的Atlas采集CDH6的元数据和血缘,理论上只需要将相应的Atlas Hook正确部署到CDH6对应的服务上即可。本文以采集Hive元数据和血缘为例,描述如何部署Atlas Hive Hook到CDH6上。验证环境HDP 3.1.5集群。组件版本:Atlas 2.0.0.3.1.5.0-152,Hadoop 3.1.1, ...

weixin_39889544的博客 559

顺丰 基于 Hook 机制实现数据血缘系统

目前已经实现了对 Hive 和 DataX 的 Hook 模块开发,能够满足对基于 Hive 的离线数据计算任务和基于DataX 的离线数据集成任务进行血缘采集,基本满足了大多数场景下的离线任务血缘采集的需求。Hook 模块采取插件式开发模式,实现多种大数据执行引擎各自的 Hook 函数,对其任务配置参数进行解析,获取当前任务的集群信息、数据流向信息,操作规则等,并进行相应的血缘解析工作,生成TableLineageInfo 对象,最后通过 Http 请求的方式将结果发送到 Collector 端。

SmartSi 1981

java impala 查询,从日志分析impala查询慢的原因(1)

本文只是分析和代码的关联,并没有解决慢的问题。有些语句在impala查询很慢,尝试把日志和代码关联起来,便于之后的分析。由于impala涉及到多个对象,有些代码搞不清楚是如何调用的。当前发现在获取元数据的过程很慢。代码中有fe和be两个目录,be是c++写的,fe是java写的。c++通过jni调用java代码(或许还有rpc调用)在be\src\service\impala-hs2-server...

weixin_30562757的博客 1518

什么是数据地图、血缘分析和数据资产?

这是我的第85篇原创取名字是一门学问,理科生取名字的确让人难以捉摸。比如这个数据地图、血缘分析和数据资产。如果不是干数据这行的,根本不会想到这仨词居然有关系!数据地图数据地图是数据治理的重...

weixin_52346300的博客 2079

探索利用 LineageLogger 获取hive的字段级血缘关系

但是又由于 org.apache.hadoop.hive.ql.optimizer.Optimizer。源码中有 org.apache.hadoop.hive.ql.hooks.LineageLogger。搭配日志监测服务来实现字段级血缘。类无法实现字段级血缘。

DeaSun 799
上一篇: 解除HUE下载10万行的限制
下一篇: impala&hive大数据平台数据血缘与数据地图(二)-实时采集impala血缘日志推送到kafka​​​​​​​
王义凯_Rick
王义凯_Rick 领域专家: 大数据技术领域 领域专家: 大数据技术领域
博客等级 码龄14年 858粉丝 162原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

王义凯_Rick

遇见即是缘,路过就给个评论吧~

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值