CUDA by example Chapter9 原子性

GPU 高性能编程 CUDA :原子性 NVIDIA GPU 的计算功能集:NVIDIA 将 GPU 支持的各种功能统称为计算功能集nvcc -arch=sm_11 //告诉编译器需要1.1版本或者更高 nvcc -arch=sm_12 //告诉编译器需要1.2版本或者更高原子操作简介:在执行过程中不能分解为更小的部分,将满足这种条件限制的操作称为原子操作,当有数千个线程在内存访问上发生竞争时,这些操作可以保证在内存上实现安全的操作... 阅读详情


与在操作系统中的线程竞争相似,GPU编程各个线程之间也存在竞态条件,为了保证程序按照我们设计的逻辑运行,原子性操作必不可少。
本章以计算直方图为例,说明在GPU上使用原子操作的方法。

在CPU上计算直方图

这是平凡的

// 代码9.4.1在CPU上计算直方图
//时间:2019.07.30
#include "cuda_runtime.h"
#include "device_launch_parameters.h"
#include <iostream>
#include "book.h"

#define SIZE (10*1024*1024)

int main()
{
	unsigned char *buffer = (unsigned char *)big_random_block(SIZE);
	unsigned int histo[256];

	//对直方图数组进行初始化
	for(int i = 0; i < 256; i++)
	{
		histo[i] = 0;
	}
	//CPU统计直方图信息
	for (int i = 0; i < SIZE; i++)
	{
		histo[buffer[i]]++;
	}

	//验证直方图统计的正确性
	long histoCount = 0;
	for (int i = 0; i < 256; i++)
	{
		histoCount += histo[i];
	}
	printf("Histogram Sum:%ld\n", histoCount);

	free(buffer);
	system("pause");
	return 0;

}

在这里插入图片描述
显然,10485760 = 1024102410,验证通过!

在GPU上计算直方图

通过GPU的多个线程来处理输入缓冲区的不同部分,在这个过程中,多个线程可能同时对输出直方图的同一个元素进行递增。在这种情况下,我们需要通过原子递增操作来避免线程竞争问题。

一些重要函数及技巧

1. cudaMemset
类似于memset,cudaMemset对GPU上的内存初始化数值,如果初始化失败,将返回一个错误码,用法示例:

cudaMemset(dev_histo, 0, sizeof(int)* 256);//对GPU上的内存初始化数值

2. block数量的选择技巧

  • 由于直方图包含了256个元素,因此threadsPerBlock可以设置成256,这样做方便又高效。
  • block数量的选择
    假设我们有100MB数据,也就是104857600个字节。我们可以用一个block,每个thread处理409600个数据元素;也可以用409600个block,每个thread处理一个数据元素。
    通过一些性能实验,发现当block的数量为GPU中处理器数量的2倍时,将达到最优性能。

3. GPU原子递增操作
atomicAdd(addr,y)是CUDA提供的原子递增操作函数,它包含两个参数,第一个参数是要递增的变量地址,第二个参数是每次递增的步长。
这个函数将生成一个原子操作序列,这个操作序列包括读取地址addr处的值,将这个值增加y,以及将结果保存到addr。
底层硬件将确保执行这些操作时,其他任何线程都不会读取或者写入地址addr上的值,示例如下:

atomicAdd(&histo[buffer[i]], 1);//每次递增1

使用GPU全局内存原子操作计算直方图

// 代码9.4.2.1在GPU上计算直方图(全局内存)
//时间:2019.07.30
#include "cuda_runtime.h"
#include "device_launch_parameters.h"
#include <iostream>
#include "book.h"

#define SIZE (10*1024*1024)


__global__ void histo_kernal(unsigned char *buffer, long size, unsigned int *histo)
{
	int i = threadIdx.x + blockIdx.x*blockDim.x;
	int stride = gridDim.x*blockDim.x;
	while (i < size)
	{
		atomicAdd(&histo[buffer[i]], 1);//原子性操作
		i += stride;
	}

}


int main()
{
	unsigned char *buffer = (unsigned char *)big_random_block(SIZE);

	//记录起始事件
	cudaEvent_t start, stop;
	cudaEventCreate(&start);
	cudaEventCreate(&stop);
	cudaEventRecord(start, 0);

	//在GPU上为文件数据分配内存
	unsigned char *dev_buffer;
	unsigned int *dev_histo;

	cudaMalloc((void **)&dev_buffer, SIZE);
	cudaMemcpy(dev_buffer, buffer, SIZE, cudaMemcpyHostToDevice);

	cudaMalloc((void **)&dev_histo, sizeof(int)* 256);
	cudaMemset(dev_histo, 0, sizeof(int)* 256);//对GPU上的内存初始化数值

	//执行kernal函数,经验发现当线程块的数量为GPU中处理器数量的2倍时,将达到最优性能
	cudaDeviceProp prop;
	cudaGetDeviceProperties(&prop, 0);
	int blocks = prop.multiProcessorCount;
	histo_kernal << <blocks * 2, 256 >> >(dev_buffer, SIZE, dev_histo);


	//将GPU统计得到的直方图copy到CPU
	unsigned int histo[256];
	cudaMemcpy(histo, dev_histo, sizeof(int)* 256,cudaMemcpyDeviceToHost);

	//得到停止时间并显示计时结果
	cudaEventRecord(stop, 0);
	cudaEventSynchronize(stop);
	float elapsedTime;
	cudaEventElapsedTime(&elapsedTime, start, stop);
	printf("Time to generate:%3.1f ms\n", elapsedTime);

	//验证直方图总和是否正确
	long histoCount = 0;
	for (int i = 0; i < 256; i++)
	{
		histoCount += histo[i];
	}
	printf("Histogram Sum:%ld\n", histoCount);

	//验证与CPU得到的是相同的计数值
	for (int i = 0; i < SIZE; i++)
	{
		histo[buffer[i]]--;
	}
	for (int i = 0; i < 256; i++)
	{
		if (histo[i] != 0)
			printf("Failure ar %d!\n", i);
	}

	//释放CUDA事件,主机内存,GPU内存
	cudaEventDestroy(start);
	cudaEventDestroy(stop);
	cudaFree(dev_histo);
	cudaFree(dev_buffer);
	free(buffer);

	system("pause");
	return 0;
}
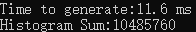
在这里插入图片描述

使用GPU共享内存原子操作计算直方图

全局内存dev_histo只有256个字节,当数千个线程尝试访问如此少量的内存位置时,将发生大量的竞争。为了保证递增操作的原子性,对相同内存位置的操作都将被硬件串行化,这是效率低下的。
使用共享内存可以有效解决以上问题,思路如下:
将直方图计算分为两个阶段,在第一个阶段,使用共享内存,每个并行block将独立计算它所处理数据的直方图,每个block中的所有线程在该block中对共享内存缓冲区的操作仍然需要保证原子性。显然,在一个block中只有256个线程在256个地址上发生竞争,这将极大地减少在使用全局内存时在数千个线程之间发生竞争的情况。在第二个阶段,将第一个阶段每个block产生的统计结果,加和到最终直方图相应的元素上,同时,必须要注意的是,第一个阶段完成之后需要线程同步,等到所有block都完成了局部计算之后,第二个阶段才可以进行。

// 代码9.4.2.2在GPU上计算直方图(共享内存)
//时间:2019.07.30
#include "cuda_runtime.h"
#include "device_launch_parameters.h"
#include <iostream>
#include "book.h"

#define SIZE (10*1024*1024)


__global__ void histo_kernal(unsigned char *buffer, long size, unsigned int *histo)
{
	//每个block中都包含一个独立的共享内存temp,每个block中有256个thread
	__shared__ unsigned int temp[256];
	temp[threadIdx.x] = 0;//初始化为0
	__syncthreads();

	//每个block中计算一下计数值
	int i = threadIdx.x + blockIdx.x*blockDim.x;
	int stride = gridDim.x*blockDim.x;
	while (i < size)
	{
		atomicAdd(&temp[buffer[i]], 1);//原子性操作
		i += stride;
	}
	__syncthreads();

	//将每个block中的temp内容汇总到histo
	atomicAdd(&(histo[threadIdx.x]), temp[threadIdx.x]);

}


int main()
{
	unsigned char *buffer = (unsigned char *)big_random_block(SIZE);

	//记录起始事件
	cudaEvent_t start, stop;
	cudaEventCreate(&start);
	cudaEventCreate(&stop);
	cudaEventRecord(start, 0);

	//在GPU上为文件数据分配内存
	unsigned char *dev_buffer;
	unsigned int *dev_histo;

	cudaMalloc((void **)&dev_buffer, SIZE);
	cudaMemcpy(dev_buffer, buffer, SIZE, cudaMemcpyHostToDevice);

	cudaMalloc((void **)&dev_histo, sizeof(int)* 256);
	cudaMemset(dev_histo, 0, sizeof(int)* 256);//对GPU上的内存初始化数值

	//执行kernal函数,经验发现当线程块的数量为GPU中处理器数量的2倍时,将达到最优性能
	cudaDeviceProp prop;
	cudaGetDeviceProperties(&prop, 0);
	int blocks = prop.multiProcessorCount;
	histo_kernal << <blocks * 2, 256 >> >(dev_buffer, SIZE, dev_histo);


	//将GPU统计得到的直方图copy到CPU
	unsigned int histo[256];
	cudaMemcpy(histo, dev_histo, sizeof(int)* 256, cudaMemcpyDeviceToHost);

	//得到停止时间并显示计时结果
	cudaEventRecord(stop, 0);
	cudaEventSynchronize(stop);
	float elapsedTime;
	cudaEventElapsedTime(&elapsedTime, start, stop);
	printf("Time to generate:%3.1f ms\n", elapsedTime);

	//验证直方图总和是否正确
	long histoCount = 0;
	for (int i = 0; i < 256; i++)
	{
		histoCount += histo[i];
	}
	printf("Histogram Sum:%ld\n", histoCount);

	//验证与CPU得到的是相同的计数值
	for (int i = 0; i < SIZE; i++)
	{
		histo[buffer[i]]--;
	}
	for (int i = 0; i < 256; i++)
	{
		if (histo[i] != 0)
			printf("Failure ar %d!\n", i);
	}

	//释放CUDA事件,主机内存,GPU内存
	cudaEventDestroy(start);
	cudaEventDestroy(stop);
	cudaFree(dev_histo);
	cudaFree(dev_buffer);
	free(buffer);

	system("pause");
	return 0;
}
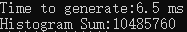
在这里插入图片描述
显然,性能是确有提升的。

大模型抽取知识图谱三元组的可行性分析 通过结合传统信息抽取模型与大语言模型的混合架构,可高效完成从学术文献到知识图谱三元组的全流程构建。分阶段优化:传统模型负责粗粒度抽取,大模型负责细粒度修正。灵活提示设计:通过少样本学习引导大模型理解领域本体。严格质量控制:结合规则引擎和人工校验,确保三元组准确性。该方案可显著提升知识图谱构建效率,适用于学术研究、企业知识库等场景。 阅读详情

相关推荐

Ubuntu18.04下Carla安装——经验史

Ubuntu下的Carla安装

m0_51267207的博客 2680

CUDA原子操作

这是因为更广泛的分布范围上的原子操作有利于利用多个能执行原子操作的单元,以及每个原子操作单元上面的竞争性的原子事务也相应减少了。在这个代码中,1 000个线程对同一内存区域进行原子+1操作,这1 000次相同区域上的操作,每次都将从逻辑上安全地完整执行。该函数会从逻辑上保证,每个调用它的线程对相同的内存区域上的“读取旧值-累加-回写新值”操作是不可被其他线程扰乱的原子性的整体完成的。在main函数中,具有10个元素的数组被初始化成0值,然后传递给了内核,但现在,内核中的代码将执行原子累加操作。

taifyang的博客 504

自动驾驶入门到进阶完整指南:感知、预测、规划、端到端、仿真测评与场景挖掘全解析

对小白来说,不建议一开始直接冲端到端大模型。先学数据和坐标系:否则所有结果都看不懂。再学 LiDAR 3D 检测:最容易建立空间感。再学 BEV/多相机感知:这是当前主流。再学轨迹预测:理解交互和多模态。再学规划控制:理解车为什么这样开。再学仿真和闭环评测:理解 open-loop 和 closed-loop 差异。最后学端到端/VLM/VLA:这时候你才知道它到底替代了哪些模块。贯穿始终学习场景挖掘和安全测评:这是工业界最核心的能力之一。

u013250861的博客 395

CUDA编程模型系列八(原子操作 / 规约 / 向量元素求和)

本期我介绍了cuda 当中规约算法的一种情况, 也是小何尚职业生涯中的第一道面试题, 计算数组中所有元素的和.本系列视频目的是帮助开发者们一步步地学会利用CUDA编程模型加速GPU应用, 我们的口号是: 让GPU飞起来。CUDA编程模型系列八(原子操作 / 规约 / 向量元素求和)

专注于人工智能领域的小何尚 1686

手把手教你用8位单片机IO口直接驱动WS2812灯带(附完整代码和避坑指南)

本文详细介绍了如何使用8位单片机IO口直接驱动WS2812灯带,包括硬件准备、时序生成、色彩引擎与特效算法的实现,以及调试技巧与性能优化。通过汇编语言优化和精确时序控制,实现高效的LED驱动和炫酷的彩虹灯效,适合嵌入式开发者和硬件爱好者参考。

weixin_42696271的博客 304

YOLOv12改进策略【注意力机制篇】| 2024 PPA 并行补丁感知注意模块,提高小目标关注度(二次改进A2C2f)

本文记录的是利用改进检测精度,详细说明了优化原因,注意事项等。原论文在红外小目标检测任务中,小目标在多次下采样操作中容易丢失关键信息。通过替代编码器和解码器基本组件中的传统卷积操作,更好地保留小目标的重要信息。HCF-Net: Hierarchical Context Fusion Network for Infrared Small Object Detection采用多分支特征提取策略,通过不同分支提取不同尺度和层次的特征。利用局部、全局和串行卷积分支,对输入特征张量进行处理。通过控制 patch si

Limiiiing的博客 1888

CUDA By Example(七)——原子性

简单介绍CUDA的原子操作,并利用直方图算法,详细解释如何在GPU上使用原子操作。

hhhcbw的博客,欢迎各位来访 977

自动化Google Chrome的强大工具:chromedriver下载、安装、简单使用

本文介绍了 ChromeDriver 的基本概念和安装配置方法,重点讲解了如何通过 Selenium 实现 Chrome 浏览器的自动化测试。内容涵盖了 ChromeDriver 下载、版本匹配、依赖引入和简单的自动化测试脚本示例,帮助读者快速上手并避免常见问题。

曾经“等你生日那天”都遥远得像未来,如今却可欢愉的挥手说“下个十年见” 88万+

cuda学习笔记(5)

目录原子操作(Atomics) 笔记(2)中提到当cuda需要对同一个内存地址中的值进行读写访问时,需要原子操作(Atomics)(类似cpu多线程的互斥锁mutex或原子变量),本章通过一个列子介绍原子操作。 原子操作(Atomics) 有些操作不能被拆分, 多线程要针对同一内存地址进行操作,这时需要对该内存使用原子操作,来保证线程对资源有暂时的”独占性”, 避免计算错误。原子操作是把双刃剑,因...

Frizy的博客 1154

光学系统仿真软件:Finesse_(6).噪声分析与优化

在Finesse中,噪声源的定义可以通过在光学元件的参数中添加噪声项来实现。以下是一个简单的示例,展示了如何在激光器和反射镜中定义噪声源。# 定义噪声传递函数# 绘制噪声传递函数plot NTF1在这个例子中,定义了一个噪声传递函数NTF1,描述了激光器L1到反射镜M1的噪声传递过程。plot NTF1命令绘制了噪声传递函数的频谱图。# 定义耦合路径# 绘制耦合噪声频谱图plot C1在这个例子中,定义了一个耦合路径C1,描述了激光器L1和反射镜M1之间的噪声耦合关系。plot C1。

kkchenjj的博客 874

即插即用篇 | 手把手教你 YOLOv11 添加注意力机制 | 适用于【检测任务】【分类任务】【分割任务】【关键点任务】| 20+ 种全打通!

即插即用篇 | 手把手教你 YOLOv11 添加注意力机制 | 适用于【检测任务】【分类任务】【分割任务】【关键点任务】| 20+ 种全打通!

Coding... 2833

CUDA by example Chapter10 流

流为什么要使用CUDA流页锁存主机内存CUDA流使用单个CUDA流使用多个CUDA流GPU工作调度机制高效地使用多个CUDA流 为什么要使用CUDA流 前面章节实现的GPU并行性都是把同一个任务分成可以并行执行的子任务,利用GPU中数量众多的cuda核来实现单个任务的并行性。而如果要实现任务并行性,就需要使用CUDA流来实现。 页锁存主机内存 1. 页锁存内存的概念及用途 页所存内存也称为固定内...

wolfcsharp的博客 336

基于GA-BP遗传算法优化神经网络的多输入多输出数据预测-Python代码实现

多输入多输出的GA-BP神经网络

2301_80449389的博客 2308

《CUDA By Example》【Chapter 09】原子性?

9.1 概述 了解不同NVIDIA GPU的计算功能集 了解原子操作以及为什么需要使用 了解如何在CUDA C核函数中执行带有原子操作的运算 9.2 计算功能集 不同架构的CPU有不同的功能和指令集(如MMX,SSE,SSE2),对于CUDA支持的GPU也一样。NVIDIA将GPU支持的各种功能统称为计算功能集(Compute Capability)。 9.2.1 NVIDIA...

wondervictor的博客 365

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

CUDA by example Chapter3 CUDA C简介

CUDA C简介CPU上的Hello WorldGPU上的Hello World__global__修饰符:向kernal()中传递参数cudaMalloc()函数:cudaFree()函数:cudaMemcpy()函数:查询设备信息cudaGetDeviceCount()函数:结构体cudaDevicePropcudaGetDeviceProperties()函数:设备属性的使用:选择一个符合条...

wolfcsharp的博客 394

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

《CUDA By Example》【Chapter 10】流?

10.1 概述 并行性分数据并行性和任务并行性。GPU是SIMD天生的数据并行,同时也能支持类似于CPU多线程应用程序中的任务并行性。 GPU任务并行性不像CPU上那样灵活,但仍然可以进一步提高GPU上的运行速度。本章,介绍CUDA流,以及如何通过流在GPU上同时执行多个任务。 了解如何分配也锁定(Page-Locked)类型的主机内存 了解CUDA流的概念 了解如何使用CUDA流...

wondervictor的博客 324

CUDA by example Chapter5 线程协作

线程协作并行线程块的分解使用线程实现GPU上的矢量求和 并行线程块的分解 使用线程实现GPU上的矢量求和

wolfcsharp的博客 388

CUDA by example Chapter4 CUDA C并行编程

CUDA C 并行编程CPU矢量求和运算GPU矢量求和运算尖括号语法<<CPU矢量求和运算 /* //代码4.2.1.1基于CPU的矢量求和运算 //时间:2019.07.20 */ #include "cuda_runtime.h" #include "device_launch_parameters.h" #include <iostream> #define N 1...

wolfcsharp的博客 369

《CUDA By Example》【Chapter 05】线程协作 ?

概述 本章介绍代码在各个并行副本之间的通信和协作。 1,了解不同线程之间的通信机制; 2,了解并行执行线程的同步机制; 5.2 并行线程块的分解 add&lt;&lt;&lt;N,1&gt;&gt;&gt;( dev_a, dev_b, dev_c); //第一个参数为想要启动的线程块数量; //第二个参数为CUDA运行时在每个线程块中创建的线程数量; //共创建了N个线程块,N*1...

wondervictor的博客 294

《CUDA By Example》【Chapter 04】CUDA C 并行编程

GPU计算的应用前景在很大程度上取决于能否从很多问题中发掘出大规模并行性。 add_loop_cpu.cu #include &amp;amp;amp;amp;quot;../common/book.h&amp;amp;amp;amp;quot; #define N 10 void add( int *a, int *b, int *c ) { int tid = 0; // this is CPU zero, so we start at ze...

wondervictor的博客 299

《CUDA By Example》【Chapter 06】常量内存与事件 ?

6.1 本章目标 高级些的功能,通过GPU上特殊的内存区域来加速应用程序的执行。其中一种内存区域:常量内存(Constant Memory)。介绍一种增强CUDA C应用程序性能的方法,了解如何通过事件来测量应用程序的性能。 如何在CUDA C中使用常量内存 了解常量内存的性能性能 学习使用CUDA事件来测量应用程序的性能 6.2 常量内存 由于GPU有很多ALU, 所以计算能力往...

wondervictor的博客 330

CUDA by example Chapter7 纹理内存

纹理内存纹理内存简介热传导模拟简单的传热模型代码中温度更新的计算GPU不使用纹理内存的热传导模拟计算GPU使用一维纹理内存的热传导模拟计算GPU使用二维纹理内存的热传导模拟计算 纹理内存简介 和常量内存一样,纹理内存是另一种类型的只读内存。纹理内存是专门为那些在内存访问模式中存在大量空间局部性的图形应用程序而设计的。假如在某个计算应用程序中,一个线程读取的位置与邻近线程读取的位置"非常接近",使用...

wolfcsharp的博客 599

《CUDA By Example》【Chapter 07】纹理内存 ?

7.1 本章目标 纹理内存和常量内存一样,都是只读内存,用来减少带宽流量,提升性能。 1,了解纹理内存的特性 2,了解如何在CUDA C中使用一维纹理内存 3,了解如何在CUDA C中使用二维纹理内存 7.2 纹理内存简介(Texture Memory) 7.3 热传导模拟...

wondervictor的博客 357

CUDA by example Chapter11 多GPU系统上的CUDA C

多GPU系统上的CUDA C零拷贝主机内存通过零拷贝内存实现点积运算零拷贝内存的性能使用多个GPU 零拷贝主机内存 零拷贝主机内存是另一种固定内存,它也不能被CPU从物理内存交换出去或者重新定位。同时,这种内存除了可以用于主机与GPU之间的内存复制外,还可以在CUDA C核函数中直接访问这种类型的主机内存。由于这种内存不需要复制到GPU,因此也称为零拷贝内存。 通过零拷贝内存实现点积运算 1. 测...

wolfcsharp的博客 400

《CUDA By Example》【Chapter 11】多GPU系统上的CUDA C?

11.1 概述 了解如何分配和使用零拷贝内存(zero-copy memory) 了解如何在同一个应用程序中使用多个GPU 了解如何分配和使用可移动的固定内存(Portable pinned Memory) 11.2 零拷贝主机内存 固定内存(页锁定内存)能确保不会交换出物理内存。我们通过调用cudaHostAlloc()来分配这种内存,并且传递参数cudaHostAllocDefa...

wondervictor的博客 613

《CUDA By Example》【Chapter 03】CUDA C简介

3.2 第一个CUDA程序 simple_kernel.cu #include &amp;amp;quot;../common/book.h&amp;amp;quot; __global__ void kernel( void ) { } int main( void ) { kernel&amp;amp;amp;lt;&amp;amp;amp;lt;&amp;amp;amp;lt;1,1&amp;amp;amp;gt;&amp;amp

wondervictor的博客 362

CUDA by example Chapter6 常量内存与事件

常量内存与事件常量内存光线跟踪在GPU上实现光线追踪通过常量内存来实现光线追踪使用事件来测量性能 常量内存 使用常量内存的原因: GPU中含有数量庞大的计算单元,因此性能瓶颈通常并不在于芯片的数学计算吞吐量,而是在于芯片的内存带宽。 在某些情况下,使用常量内存可以显著减少内存通信量 光线跟踪 光信跟踪是从三维对象场景中生成二维图像的一种方式。将跟踪从像素中投射出的光线穿过场景,直到光线命中某个物体...

wolfcsharp的博客 536
上一篇: CUDA by example Chapter7 纹理内存
下一篇: CUDA by example Chapter10 流
Leo-Ma
博客等级 码龄11年 1701粉丝 124原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
