python爬虫之Beautiful Soup

《Python3网络爬虫开发实战》第3章 网页数据的解析获取之Beautiful Soup的使用 例如,要查询id为list-1的节点,就可以传人attrs={'id':'list-1'}作为查询条件,得到的结果是列表形式,列表中的内容就是符合id为list-1这一条件的所有节点。除了find_all方法,还有find方法也可以查询符合条件的元素,只不过find方法返回的是单个元素,也就是第一个匹配的元素,而find_all会返回由所有匹配的元素组成的列表。在做选择的过程中,有时不能一步就选到想要的节点,需要先选中某一个节点,再以它为基准选子节点、父节点、兄弟节点等,下面就介绍一下如何选择这些节点。 阅读详情
安装

pip install beautifulsoup

解析器

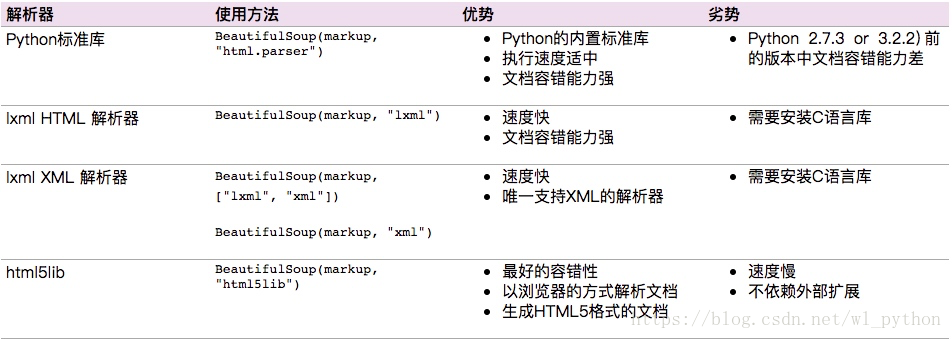
Beautiful Soup支持Python标准库中的HTML解析器,还支持一些第三方的解析器,如果我们不安装它,则 Python 会使用 Python默认的解析器,lxml 解析器更加强大,速度更快,推荐安装。
这里写图片描述

简单实用
from bs4 import BeautifulSoup

html='<p>hello<h1 class= big><span id="num1">test</span><span id=num2>test2</span></h1><h2>python</h2></p>'

#解析html对象
soup=BeautifulSoup(html,'html.parser')
print(soup)

#prettify()方法 按格式返回html,可以补齐缺失的引号
fixed_html=soup.prettify()
print(fixed_html)

#按标签查找,返回第一个符合的标签
print(soup.h1)
print(soup.span)


#标签名
print(soup.h1.name)

#返回标签的文本内容
print(soup.span.string)
#获取嵌套标签的内童
print(soup.h1.span.string)

#返回父节点信息
print(soup.span.parent)
print(soup.span.parent.name)

#返回第一个查找道德属性值
print(soup.span['id'])

#返回一个列表,包含所有的标签信息
print(soup.find_all('span'))

#按属性查找指定的标签信息
print(soup.find(id='num2'))

#获取所有的文本信息,返回一个字符串
print(soup.get_text())

#link.get('href')可以获取标签中的链接


######contents和children的用法:返回所有子节点的信息,contents返回的是一个列表,
# 而children返回的时已迭代器,需要for循环来查看
print(soup.p.contents)
print(soup.p.children)
for i in soup.p.children:
    print(i)

python爬虫开发之Beautiful Soup模块从安装到详细使用方法与实例 python爬虫模块Beautiful Soup简介 简单来说,Beautiful Soup是python的一个库,最主要的功能是从网页抓取数据。官方解释如下: Beautiful Soup提供一些简单的、python式的函数用来处理导航、搜索、修改分析树等功能。它是一个工具箱,通过解析文档为用户提供需要抓取的数据,因为简单,所以不需要多少代码就可以写出一个完整的应用程序。Beautiful So... 阅读详情

相关推荐

【MOOC】Python网络爬虫与信息提取-北京理工大学-part 2

【第二周】 网络爬虫之提取Beautiful Soup库入门Beautiful Soup库的安装与测试中文文档:Beautiful Soup 4.4.0 文档 安装方式:pip install beautifulsoup4 测试网站(http://python123.io/ws/demo.html)的源代码(当然用requests库获取便可):<html><head><title>This is

linzch3的博客 8495

Python爬虫:BeautifulSoup库

Beautiful Soup的简介 Beautiful Soup是python的一个库,最主要的功能是从网页抓取数据。官方解释如下: 1、Beautiful Soup提供一些简单的、python式的函数用来处理导航、搜索、修改分析树等功能。它是一个工具箱,通过解析文档为用户提供需要抓取的数据,因为简单,所以不需要多少代码就可以写出一个完整的应用程序。 2、Beautiful Soup自动将输...

不怕猫的耗子A 2万+

网络爬虫基础教程 Web scraping using Beautiful soup in Python: An introduction

作者:禅与计算机程序设计艺术 1.简介 1.1什么是web scraping? Web scraping,即网络爬虫,是一个广义的概念,包括从互联网上抓取信息、数据等过程。Web scraping可以用来获取特定网站的数据、进行数据分析、

AI天才研究院 263

Python爬虫利器之Beautiful Soup入门详解,实战总结!!!

文章目录1、简介2、解析库3、讲解3.1、Tag(标签选择器)3.2、标准选择器(find、find_all)3.2.1、find_all()3.2.2、find()3.3、Select选择器4、实战 1、简介 Beautiful Soup 是一个可以从HTML或XML文件中提取数据的Python库.它能够通过你喜欢的转换器实现惯用的文档导航,查找,修改文档的方式.Beautiful Soup会帮你节省数小时甚至数天的工作时间. 2、解析库 灵活又方便的网页解析库,处理高效,支持多种解析器。 利用

Code皮皮虾的博客 1万+

文章五:Python 网络爬虫实战:使用 Beautiful Soup 和 Requests 抓取网页数据

在Python中,可以使用。在实际应用中,可以尝试实现更复杂的功能,如自动翻页、数据清洗和存储、分布式爬取等。数据清洗和分析:对抓取到的数据进行清洗、整理和分析,使用Pandas、NumPy等库进行数据处理,使用Matplotlib、Seaborn等库进行数据可视化。遵守爬虫道德规范:在编写网络爬虫时,要遵守爬虫道德规范和网站的robots.txt文件规定,避免对目标网站造成过大的访问压力。数据存储:将抓取到的数据存储到数据库中,如SQLite、MySQL、MongoDB等,方便进一步处理和分析。

斌擎科技 1566

【Python入门】7天速成Python网络爬虫高手,Beautiful Soup从零基础到实战只需一篇

恭喜你,已经完成了Python网络爬虫中使用Beautiful Soup提取数据的基础学习!通过今天的讲解,你应该已经掌握了如何使用Beautiful Soup解析HTML文档、导航解析树、搜索解析树、提取网页中的数据、处理嵌套标签和表格数据。这些技能不仅能够帮助你在工作中提高效率,还能让你在朋友面前显得特别酷。所以,赶紧动手试试吧,也许你下一个爬虫项目就是用Beautiful Soup开发的呢!

java专栏 814

python爬虫——Beautiful Soup库(数据解析)模块讲解

一、概述 Beautiful Soup (简称bs4)是一个可以从HTML或XML文件中提取数据的Python库。提供一些简单的、python式的函数用来处理导航、搜索、修改分析树等功能。它是一个工具箱,通过解析文档为用户提供需要抓取的数据,因为简单,所以不需要多少代码就可以写出一个完整的应用程序。注:Beautiful Soup自动将输入文档转换为Unicode编码,输出文档转换为utf-8编码。所以仅仅只需要说明一下原始编码方式就可以。 二、数据解析 数据解析就是将爬取到的整个页面中的局部的内容进

记录并分享学习安全的知识点.. 3377

Python爬虫:使用Beautiful Soup解析HTML并提取数据

在本文中,我们介绍了如何使用Python中的Beautiful Soup库来解析HTML,并提取其中的数据。在本文中,我们将使用Beautiful Soup库来解析HTML,并提取其中的数据。我们将以一个示例开始,展示如何使用Beautiful Soup从一个网页中提取标题和链接的信息。除了提取标题和链接,Beautiful Soup还提供了许多其他功能,如搜索特定的元素、遍历解析树等。请注意,上述代码中的URL是一个示例URL,你需要将其替换为你想要爬取的实际网页地址。

HackNebulaZ的博客 389

Python网络爬虫-Beautiful Soup库学习笔记

首先,Beautiful Soup库是解析、遍历、维护“标签树”的功能库。1) prettify()为HTML文本<>及其内容增加换行’\n‘2) Python 3.0默认支持编码是utf-8,解析无障碍。1) bs4库将任何HTML输入都变成utf-8编码。BeautifulSoup类型是标签树的根节点。

YSF_BEST的博客 319

网络爬虫(Python:Requests、Beautiful Soup笔记)

网络爬虫(Python:Requests、Beautiful Soup笔记)

算法工程师 2253

electron windows设置镜像地址环境变量报错npm error `ELECTRON_MIRROR` is not a valid npm option

如果你是在使用某个特定的脚本或配置文件,请检查该文件中是否有不正确的配置项,并进行相应的修正。确保你遵循electron的官方安装指南,并且没有包含不必要的或错误的配置选项。如果问题依然存在,可以查看npm的官方文档或者相关社区获取更多帮助。

qq_36158551的博客 3324

Python爬虫-Beautiful Soup库学习

Beautiful Soup 是一个强大的基于Python语言的XML和HTML解析库,它提供了一些简单的函数来处理导航、搜索、修改分析树等功能,结合requests库可以写出简洁的爬虫代码。

m0_61796189的博客 1628

实验五 循环结构第1关:斐波那契数列第2关:统计一段英文语句中的单词数和句子数第3关:密码判断第4关:通过数列求自然常数e第5关:双倍余额递减法计算固定资产折旧第6关:销售统计第7关:投资年限计算

第1关:斐波那契数列第2关:统计一段英文语句中的单词数和句子数第3关:密码判断 第4关:通过数列求自然常数e 第5关:双倍余额递减法计算固定资产折旧

pro_daily的博客 8168

使用Beautiful Soup进行网页数据提取:Python网络爬虫入门指南

Beautiful Soup是一个强大的Python库,专门用于从HTML和XML文件中提取数据。它的名字来源于"tag soup"(标签汤),暗示了它能够处理格式不规范的标记语言。易于使用的API强大的解析能力,可以处理不规范的HTML支持多种解析器提供了丰富的导航、搜索和修改解析树的方法Beautiful Soup是一个强大而灵活的工具,适用于各种网页数据提取任务。通过本文的介绍和示例,你应该已经掌握了Beautiful Soup的基本用法。

qq_29929123的博客 1618

【福建dem】原始高程数据tif格式

DEM(Digital Elevation Model,数字高程模型)是一种地理信息系统中的关键数据集,它提供了地表地形的三维信息,通常用于分析地貌特征、模拟水文过程、规划建设、灾害预警等多个领域。这种数据对于地理分析非常有价值,例如,它可以用于计算坡度、坡向、地形粗糙度等地形特征,或者进行洪水模拟、地质灾害评估、太阳能辐射分析等。“福建dem原始高程数据tif格式”是研究和理解福建省地形地貌的重要资源,结合GIS工具,可以揭示丰富的地理信息,为科研、工程和决策提供有力支持。

鸿业远图科技 943

深入解析西门子S7通信协议:从抓包到实战应用

本文深入解析西门子S7通信协议,从环境搭建、抓包分析到实战应用,提供了一套完整的协议分析方法。通过Wireshark工具进行抓包分析,详细拆解了S7协议各层结构,并结合真实案例,展示了如何利用抓包技术解决通信故障、优化性能及进行安全审计,是掌握工业通信底层原理的实用指南。

weixin_29224529的博客 282

利用Python进行网络爬虫:Beautiful Soup和Requests的应用

在网络数据变得日益丰富和重要的今天,网络爬虫成为了获取和分析数据的重要工具之一。Python作为一种强大而灵活的编程语言,在网络爬虫领域也拥有广泛的应用。本文将介绍如何使用Python中的两个流行库Beautiful Soup和Requests来创建简单而有效的网络爬虫,以便从网页中提取信息。

一键难忘的博客 6242

保姆级教程:用掘金量化API手把手复现一个年化17%的网格交易策略(附完整Python代码)

本文提供了一份详细的掘金量化API教程,手把手教你构建一个年化17%的网格交易策略。通过完整的Python代码实现,深入解析网格交易的核心逻辑、参数配置和动态调仓机制,帮助量化新手快速掌握策略开发全流程。教程包含环境配置、代码实现、回测分析和常见问题解答,是学习量化投资的实用指南。

weixin_33709364的博客 300

python网络爬虫自学笔录4_Beautiful Soup解析库

Beautiful Soup 简单来说,Beautiful Soup 是 python 的一个库,最主要的功能是从网页抓取数据。官方解释如下: Beautiful Soup 提供一些简单的、python 式的函数用来处理导航、搜索、修改分析树等功能。它是一个工具箱,通过解析文档为用户提供需要抓取的数据,因为简单,所以不需要多少代码就可以写出一个完整的应用程序。 Beautiful Soup 自动将输入文档转换为 Unicode 编码,输出文档转换为 utf-8 编码。你不需要考虑编码方式,除非文档没有指定.

Kobe123brant的博客 1037

10|Git Diff 与增量代码识别:本次到底改了哪些代码?

本文介绍 Git Diff 和增量代码识别,帮助你理解精准测试如何先找到本次真正变化的代码。测试开发工程师。Java 后端开发工程师。质量平台 / DevOps 平台建设者。想了解精准测试落地方法的技术负责人。

专注 AI 精准测试平台实战落地,分享从代码 Diff 到回归决策的完整工程闭环。主张“先建数据链路,再上 AI 智能”,让测试从“靠经验”走向“基于风险”。 160

绿米Aqara S1【妙控开关 S1E】版本降级或升级自定义固件的方法

绿米Aqara S1【妙控开关 S1E】版本降级或升级自定义固件的方法

LeeKwen的专栏 2171

《Python网络爬虫与信息提取》第二周 网络爬虫之提取 学习笔记(一)Beautiful Soup库入门

目录 一、Beautiful Soup库入门 1、Beautiful Soup库入门 (1)Beautiful Soup库的定义 (2)Beautiful Soup库的官网 (3)Beautiful Soup库的安装 (4)Beautiful Soup库的安装小测 2、Beautiful Soup库的基本元素 (1)Beautiful Soup库的理解 (2)Beautiful ...

wyatt007的博客 576

多后端系统统一聚合与智能分流:用 Multi Origin Composition 与 Routing 打造一套可扩展的 SAP Gateway 架构

本文针对企业级SAP集成场景,详细介绍了如何利用SAP Gateway的MOC(多源组合)和Routing功能实现多后端系统的智能路由与数据聚合。通过系统别名配置、用户角色绑定和主机名分流等机制,可实现按用户、按域名的精确路由。文章还提供了配置清单、性能优化建议和常见问题解决方案,帮助工程师落地多后端OData服务的最佳实践。

2007 年 ~ 2025 年,深耕 SAP 技术 18 年 186

2- Python 网络爬虫 — 如何精准提取网页数据?XPath、Beautiful Soup、pyquery 与 parsel 实战指南

在网络爬虫与数据采集场景中,是核心步骤之一。当我们通过请求工具(如requestsaiohttp)获取到网页的 HTML/XML 源码后,需要从中精准提取目标数据(如文本、链接、属性等)。目前 Python 生态中,常用的解析工具包括和。它们各有特点:有的基于路径表达式,有的模仿前端语法,有的专注于高效解析。本文将系统讲解这四种工具的使用方法、优缺点及适用场景。

wh1236666的博客 1200

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

Python爬虫第11节-解析库Beautiful Soup的使用上篇

在之前的内容中,我们深入探讨了正则表达式的多种用法。然而,正则表达式并非十全十美,一旦出现编写错误或逻辑漏洞,最终得到的结果往往与我们的预期大相径庭。网页作为一种具有特定结构和层级关系的信息载体,许多节点都通过 id 或 class 进行了明确区分。那么,能否利用这些网页的结构和属性特点,找到一种更为高效、准确的提取方法呢?在本节中,我们将为大家介绍一个强大的网页解析工具 ——Beautiful Soup。它能够依据网页的结构和属性等特性,轻松地对网页进行解析。

攻城狮7号的博客 1234

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

【Python爬虫】Beautiful Soup 文档

【Python爬虫】Beautiful Soup 文档 文章目录【Python爬虫】Beautiful Soup 文档快速开始安装 Beautiful Soup安装解析器如何使用对象的种类Tag搜索文档树字符串正则表达式列表Truefind_all()find()CSS选择器 Beautiful Soup是一个可以从HTML或XML文件中提取数据的Python库。 快速开始 手动定义一个网页文件,供后续使用。 html_doc = """ <html><head><title&

UIBE纪涵柏的博客 604
上一篇: Flask面试问题
下一篇: python爬虫之lxml
wl_python
博客等级 码龄9年 21粉丝 28原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
