


http://witmax.cn/character-encoding-notes.html
字符编码笔记:ASCII,Unicode和UTF-8
作者: 阮一峰
版权声明:自由转载-非商用-非衍生-保持署名 | Creative Commons BY-NC-ND 3.0
最后修改时间:2007年10月29日 09:46
今天中午,我突然想搞清楚Unicode和UTF-8之间的关系,于是就开始在网上查资料。
结果,这个问题比我想象的复杂,从午饭后一直看到晚上9点,才算初步搞清楚。
下面就是我的笔记,主要用来整理自己的思路。但是,我尽量试图写得通俗易懂,希望能对其他朋友有用。毕竟,字符编码是计算机技术的基石,想要熟练使用计算机,就必须懂得一点字符编码的知识。
1. ASCII码
我们知道,在计算机内部,所有的信息最终都表示为一个二进制的字符串。每一个二进制位(bit)有0和1两种状态,因此八个二进制位就可以组合出256种状态,这被称为一个字节(byte)。也就是说,一个字节一共可以用来表示256种不同的状态,每一个状态对应一个符号,就是256个符号,从0000000到11111111。
上个世纪60年代,美国制定了一套字符编码,对英语字符与二进制位之间的关系,做了统一规定。这被称为ASCII码,一直沿用至今。
ASCII码一共规定了128个字符的编码,比如空格“SPACE”是32(二进制00100000),大写的字母A是65(二进制01000001)。这128个符号(包括32个不能打印出来的控制符号),只占用了一个字节的后面7位,最前面的1位统一规定为0。
2、非ASCII编码
英语用128个符号编码就够了,但是用来表示其他语言,128个符号是不够的。比如,在法语中,字母上方有注音符号,它就无法用ASCII码表示。于是,一些欧洲国家就决定,利用字节中闲置的最高位编入新的符号。比如,法语中的é的编码为130(二进制10000010)。这样一来,这些欧洲国家使用的编码体系,可以表示最多256个符号。
但是,这里又出现了新的问题。不同的国家有不同的字母,因此,哪怕它们都使用256个符号的编码方式,代表的字母却不一样。比如,130在法语编码中代表了é,在希伯来语编码中却代表了字母Gimel (ג),在俄语编码中又会代表另一个符号。但是不管怎样,所有这些编码方式中,0—127表示的符号是一样的,不一样的只是128—255的这一段。
至于亚洲国家的文字,使用的符号就更多了,汉字就多达10万左右。一个字节只能表示256种符号,肯定是不够的,就必须使用多个字节表达一个符号。比如,简体中文常见的编码方式是GB2312,使用两个字节表示一个汉字,所以理论上最多可以表示256×256=65536个符号。
中文编码的问题需要专文讨论,这篇笔记不涉及。这里只指出,虽然都是用多个字节表示一个符号,但是GB类的汉字编码与后文的Unicode和UTF-8是毫无关系的。
3.Unicode
正如上一节所说,世界上存在着多种编码方式,同一个二进制数字可以被解释成不同的符号。因此,要想打开一个文本文件,就必须知道它的编码方式,否则用错误的编码方式解读,就会出现乱码。为什么电子邮件常常出现乱码?就是因为发信人和收信人使用的编码方式不一样。
可以想象,如果有一种编码,将世界上所有的符号都纳入其中。每一个符号都给予一个独一无二的编码,那么乱码问题就会消失。这就是Unicode,就像它的名字都表示的,这是一种所有符号的编码。
Unicode当然是一个很大的集合,现在的规模可以容纳100多万个符号。每个符号的编码都不一样,比如,U+0639表示阿拉伯字母Ain,U+0041表示英语的大写字母A,U+4E25表示汉字“严”。具体的符号对应表,可以查询unicode.org,或者专门的汉字对应表。
4. Unicode的问题
需要注意的是,Unicode只是一个符号集,它只规定了符号的二进制代码,却没有规定这个二进制代码应该如何存储。
比如,汉字“严”的unicode是十六进制数4E25,转换成二进制数足足有15位(100111000100101),也就是说这个符号的表示至少需要2个字节。表示其他更大的符号,可能需要3个字节或者4个字节,甚至更多。
这里就有两个严重的问题,第一个问题是,如何才能区别unicode和ascii?计算机怎么知道三个字节表示一个符号,而不是分别表示三个符号呢?第二个问题是,我们已经知道,英文字母只用一个字节表示就够了,如果unicode统一规定,每个符号用三个或四个字节表示,那么每个英文字母前都必然有二到三个字节是0,这对于存储来说是极大的浪费,文本文件的大小会因此大出二三倍,这是无法接受的。
它们造成的结果是:1)出现了unicode的多种存储方式,也就是说有许多种不同的二进制格式,可以用来表示unicode。2)unicode在很长一段时间内无法推广,直到互联网的出现。
5.UTF-8
互联网的普及,强烈要求出现一种统一的编码方式。UTF-8就是在互联网上使用最广的一种unicode的实现方式。其他实现方式还包括UTF-16和UTF-32,不过在互联网上基本不用。重复一遍,这里的关系是,UTF-8是Unicode的实现方式之一。
UTF-8最大的一个特点,就是它是一种变长的编码方式。它可以使用1~4个字节表示一个符号,根据不同的符号而变化字节长度。
UTF-8的编码规则很简单,只有二条:
1)对于单字节的符号,字节的第一位设为0,后面7位为这个符号的unicode码。因此对于英语字母,UTF-8编码和ASCII码是相同的。
2)对于n字节的符号(n>1),第一个字节的前n位都设为1,第n+1位设为0,后面字节的前两位一律设为10。剩下的没有提及的二进制位,全部为这个符号的unicode码。
下表总结了编码规则,字母x表示可用编码的位。
Unicode符号范围 | UTF-8编码方式
(十六进制) | (二进制)
——————–+———————————————
0000 0000-0000 007F | 0xxxxxxx
0000 0080-0000 07FF | 110xxxxx 10xxxxxx
0000 0800-0000 FFFF | 1110xxxx 10xxxxxx 10xxxxxx
0001 0000-0010 FFFF | 11110xxx 10xxxxxx 10xxxxxx 10xxxxxx
下面,还是以汉字“严”为例,演示如何实现UTF-8编码。
已知“严”的unicode是4E25(100111000100101),根据上表,可以发现4E25处在第三行的范围内(0000 0800-0000 FFFF),因此“严”的UTF-8编码需要三个字节,即格式是“1110xxxx 10xxxxxx 10xxxxxx”。然后,从“严”的最后一个二进制位开始,依次从后向前填入格式中的x,多出的位补0。这样就得到了,“严”的UTF-8编码是“11100100 10111000 10100101”,转换成十六进制就是E4B8A5。
6. Unicode与UTF-8之间的转换
通过上一节的例子,可以看到“严”的Unicode码是4E25,UTF-8编码是E4B8A5,两者是不一样的。它们之间的转换可以通过程序实现。
在Windows平台下,有一个最简单的转化方法,就是使用内置的记事本小程序Notepad.exe。打开文件后,点击“文件”菜单中的“另存为”命令,会跳出一个对话框,在最底部有一个“编码”的下拉条。
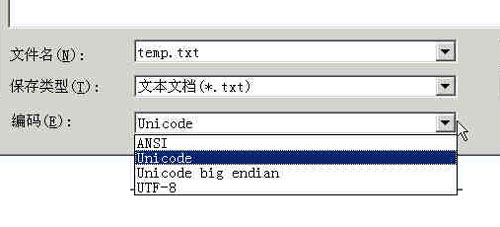
里面有四个选项:ANSI,Unicode,Unicode big endian 和 UTF-8。
1)ANSI是默认的编码方式。对于英文文件是ASCII编码,对于简体中文文件是GB2312编码(只针对Windows简体中文版,如果是繁体中文版会采用Big5码)。
2)Unicode编码指的是UCS-2编码方式,即直接用两个字节存入字符的Unicode码。这个选项用的little endian格式。
3)Unicode big endian编码与上一个选项相对应。我在下一节会解释little endian和big endian的涵义。
4)UTF-8编码,也就是上一节谈到的编码方法。
选择完”编码方式“后,点击”保存“按钮,文件的编码方式就立刻转换好了。
7. Little endian和Big endian
上一节已经提到,Unicode码可以采用UCS-2格式直接存储。以汉字”严“为例,Unicode码是4E25,需要用两个字节存储,一个字节是4E,另一个字节是25。存储的时候,4E在前,25在后,就是Big endian方式;25在前,4E在后,就是Little endian方式。
这两个古怪的名称来自英国作家斯威夫特的《格列佛游记》。在该书中,小人国里爆发了内战,战争起因是人们争论,吃鸡蛋时究竟是从大头(Big-Endian)敲开还是从小头(Little-Endian)敲开。为了这件事情,前后爆发了六次战争,一个皇帝送了命,另一个皇帝丢了王位。
因此,第一个字节在前,就是”大头方式“(Big endian),第二个字节在前就是”小头方式“(Little endian)。
那么很自然的,就会出现一个问题:计算机怎么知道某一个文件到底采用哪一种方式编码?
Unicode规范中定义,每一个文件的最前面分别加入一个表示编码顺序的字符,这个字符的名字叫做”零宽度非换行空格“(ZERO WIDTH NO-BREAK SPACE),用FEFF表示。这正好是两个字节,而且FF比FE大1。
如果一个文本文件的头两个字节是FE FF,就表示该文件采用大头方式;如果头两个字节是FF FE,就表示该文件采用小头方式。
8. 实例
下面,举一个实例。
打开”记事本“程序Notepad.exe,新建一个文本文件,内容就是一个”严“字,依次采用ANSI,Unicode,Unicode big endian 和 UTF-8编码方式保存。
然后,用文本编辑软件UltraEdit中的”十六进制功能“,观察该文件的内部编码方式。
1)ANSI:文件的编码就是两个字节“D1 CF”,这正是“严”的GB2312编码,这也暗示GB2312是采用大头方式存储的。
2)Unicode:编码是四个字节“FF FE 25 4E”,其中“FF FE”表明是小头方式存储,真正的编码是4E25。
3)Unicode big endian:编码是四个字节“FE FF 4E 25”,其中“FE FF”表明是大头方式存储。
4)UTF-8:编码是六个字节“EF BB BF E4 B8 A5”,前三个字节“EF BB BF”表示这是UTF-8编码,后三个“E4B8A5”就是“严”的具体编码,它的存储顺序与编码顺序是一致的。
9. 延伸阅读
* The Absolute Minimum Every Software Developer Absolutely, Positively Must Know About Unicode and Character Sets(关于字符集的最基本知识)
* RFC3629:UTF-8, a transformation format of ISO 10646(如果实现UTF-8的规定)
来源:http://www.ruanyifeng.com/blog/2007/10/ascii_unicode_and_utf-8.html
字符编码:Unicode/UTF-8/UTF-16/UCS/Endian/BMP/BOM
Unicode(Universal Multiple-Octet Coded Character Set):目前最流行和最有前途的字符编码规范,因为它解决了不同语言编码的冲突。
Uicode由来:
最初的字符编码ascii(8bit,最高位为0)只能表示128个字符,表示英文、数字和一些符号是没问题。但是世界不止一种语言,即使用上了最高为1的扩展ascii码,也只有256个字符。
对中日韩文、阿拉伯文之类复杂的文字,就无法使用了。
于是,各国都制定了自己的兼容ascii编码规范,就是各种ANSI码,比如我国的gb2312,用两个扩展ascii字符来表示一个中文。但是这些ansi码无法同时存在,因为它们的定义互相重叠,要自由使用不同语言就必须有一个新编码,为各种文字统一分配编码。
ISO(国际标准化组织)和Uicode协会(一个软件制造商的协会)分别开始了这个工作。即ISO的ISO 10646项目和Unicode协会的Unicode项目。后来它们开始合并了双方的工作成果,采用相同的字库和字码。但目前两个项目都存在并独立地公布自己的标准。
UCS(Unicode Character Set):
这是Uicode在ISO的名称,目有两套编码方法,UCS-2(Unicode)用2个字节表示一个字符,UCS-4(Unicode-32)用4个字节表示一个字符。UCS-4是由USC-2扩展来的,增加了2字节的高位。即使是老UCS-2,它也可以表示2^16=65535个字符,基本上可以容纳所有常用各国字符,所以目前基本都使用UCS-2。
UTF(UCS Transformation Format):
Unicode使用2个字节表示一个字符,ascii使用1个字节,所以在很多方面产生了冲突,以前处理ascii的方法都必须重写。而且C语言用/0作为字符串结束标志,但Unicode中很多字符都含/0,C语言的字符串函数也无法正常处理Unicode。为了把unicode投入实用,出现了UTF,最常见的是UTF-8和UTF-16。
其中UTF-16和Unicode本身的编码是一致的,UTF-32和UCS-4也是相同的。最重要的是UTF-8,可以完全兼容ascii编码 。UTF是一种变长的编码,它的字节数是不固定的,使用第一个字节确定字节数。第一个字节首为0即一个字节,110即2字节,1110即3字节,字符后续字节都用10开始,这样不会混淆且单字节英文字符可仍用ASCII编码。理论上UTF-8最大可以用6字节表示一个字符,但Unicode目前没有用大于0xffff的字符,实际UTF-8最多使用了3个字节。
unicode转化为UTF-8的方法
Unicode码范围 UTF-8编码(把Unicode码转为二进制填充x处)
0000-007F 0xxxxxxx
0080-07FF 110xxxxx 10xxxxxx
0800-FFFF 1110xxxx 10xxxxxx 10xxxxxx
汉字的Unicode编码范围是0080-07FF,因此是2字节编码。
Big Endian(大字节序)和Little Endian(小字节序):
Unicode存储时有个字节序问题,就是一个多字节数字,是从大到小排列还是反之。这和CPU处理有关,一般x86处理时都是倒置的,即大数在前。就像“莫”字的Unicode码0x83ab,按Big Endian就变成了0xab83。
BOM(Byte Order Mark):
因为Unicode存储时字节序的问题,在Unicode文本前插入一个不存在的字符(ZERO WIDTH NO-BREAK SPACE)作为标志来分辨两种字节序。标志0xfeff说明按Big Endian字节序,而0xfffe说明Little-Endian。
UTF-8不需要BOM来说明字节序,但可以用BOM标志编码方式。遇到带0xefbbbf开头的文本,计算机就可以不需要分辨直接按UTF-8编码处理。
BMP(Basic Multilingual Plane):
这是Unicode实际和字符对应的划分方式中的概念。
按UCS-4为例子
首字节首位恒为0,剩下7位可以划分2^7=128个group(组)。
第二个字节,每个group下面可以有2^8=256个plane(平面)。
第三个字节,可以给每个palne带来256个row(行)。
第四个字节,这里的8位又可以每row可以划分256个cell(格子)。
group 0中的plane 0就是BMP,即前两个字节为0×0000的UCS-4码。去掉0×0000的BMP上的UCS-4就变成了UCS-2编码。或者说UCS-2是USC-4的子集,BMP就是UCS-2在USC-4中的位置。我们从这里还可以得到USC-2转为UCS-4的方法,再UCS-2前面插入2个字节0×0000。
来源:http://blog.youkuaiyun.com/zzcv_/archive/2007/06/03/1636085.aspx
谈谈Unicode编码
这是一篇程序员写给程序员的趣味读物。所谓趣味是指可以比较轻松地了解一些原来不清楚的概念,增进知识,类似于打RPG游戏的升级。整理这篇文章的动机是两个问题:
问题一:
使用Windows记事本的“另存为”,可以在GBK、Unicode、Unicode big endian和UTF-8这几种编码方式间相互转换。同样是txt文件,Windows是怎样识别编码方式的呢?
我很早前就发现Unicode、Unicode big endian和UTF-8编码的txt文件的开头会多出几个字节,分别是FF、FE(Unicode),FE、FF(Unicode big endian),EF、BB、BF(UTF-8)。但这些标记是基于什么标准呢?
问题二:
最近在网上看到一个ConvertUTF.c,实现了UTF-32、UTF-16和UTF-8这三种编码方式的相互转换。对于Unicode(UCS2)、GBK、UTF-8这些编码方式,我原来就了解。但这个程序让我有些糊涂,想不起来UTF-16和UCS2有什么关系。
查了查相关资料,总算将这些问题弄清楚了,顺带也了解了一些Unicode的细节。写成一篇文章,送给有过类似疑问的朋友。本文在写作时尽量做到通俗易懂,但要求读者知道什么是字节,什么是十六进制。
0、big endian和little endian
Big endian和Little endian是CPU处理多字节数的不同方式。例如“汉”字的Unicode编码是6C49。那么写到文件里时,究竟是将6C写在前面,还是将49写在前面?如果将6C写在前面,就是big endian。还是将49写在前面,就是little endian。
“endian”这个词出自《格列佛游记》。小人国的内战就源于吃鸡蛋时是究竟从大头(Big-Endian)敲开还是从小头(Little-Endian)敲开,由此曾发生过六次叛乱,其中一个皇帝送了命,另一个丢了王位。
我们一般将endian翻译成“字节序”,将big endian和little endian称作“大尾”和“小尾”。
1、字符编码、内码,顺带介绍汉字编码
字符必须编码后才能被计算机处理。计算机使用的缺省编码方式就是计算机的内码。早期的计算机使用7位的ASCII编码,为了处理汉字,程序员设计了用于简体中文的GB2312和用于繁体中文的big5。
GB2312(1980年)一共收录了7445个字符,包括6763个汉字和682个其它符号。汉字区的内码范围高字节从B0-F7,低字节从A1-FE,占用的码位是72*94=6768。其中有5个空位是D7FA-D7FE。
GB2312支持的汉字太少。1995年的汉字扩展规范GBK1.0收录了21886个符号,它分为汉字区和图形符号区。汉字区包括21003个字符。2000年的GB18030是取代GBK1.0的正式国家标准。该标准收录了27484个汉字,同时还收录了藏文、蒙文、维吾尔文等主要的少数民族文字。现在的PC平台必须支持GB18030,对嵌入式产品暂不作要求。所以手机、MP3一般只支持GB2312。
从ASCII、GB2312、GBK到GB18030,这些编码方法是向下兼容的,即同一个字符在这些方案中总是有相同的编码,后面的标准支持更多的字符。在这些编码中,英文和中文可以统一地处理。区分中文编码的方法是高字节的最高位不为0。按照程序员的称呼,GB2312、GBK到GB18030都属于双字节字符集 (DBCS)。
有的中文Windows的缺省内码还是GBK,可以通过GB18030升级包升级到GB18030。不过GB18030相对GBK增加的字符,普通人是很难用到的,通常我们还是用GBK指代中文Windows内码。
这里还有一些细节:
GB2312的原文还是区位码,从区位码到内码,需要在高字节和低字节上分别加上A0。
在DBCS中,GB内码的存储格式始终是big endian,即高位在前。
GB2312的两个字节的最高位都是1。但符合这个条件的码位只有128*128=16384个。所以GBK和GB18030的低字节最高位都可能不是1。不过这不影响DBCS字符流的解析:在读取DBCS字符流时,只要遇到高位为1的字节,就可以将下两个字节作为一个双字节编码,而不用管低字节的高位是什么。
2、Unicode、UCS和UTF
前面提到从ASCII、GB2312、GBK到GB18030的编码方法是向下兼容的。而Unicode只与ASCII兼容(更准确地说,是与ISO-8859-1兼容),与GB码不兼容。例如“汉”字的Unicode编码是6C49,而GB码是BABA。
Unicode也是一种字符编码方法,不过它是由国际组织设计,可以容纳全世界所有语言文字的编码方案。Unicode的学名是”Universal Multiple-Octet Coded Character Set”,简称为UCS。UCS可以看作是”Unicode Character Set”的缩写。
根据维基百科的记载:历史上存在两个试图独立设计Unicode的组织,即国际标准化组织(ISO)和一个软件制造商的协会(unicode.org)。ISO开发了ISO 10646项目,Unicode协会开发了Unicode项目。
在1991年前后,双方都认识到世界不需要两个不兼容的字符集。于是它们开始合并双方的工作成果,并为创立一个单一编码表而协同工作。从Unicode2.0开始,Unicode项目采用了与ISO 10646-1相同的字库和字码。
目前两个项目仍都存在,并独立地公布各自的标准。Unicode协会现在的最新版本是2005年的Unicode 4.1.0。ISO的最新标准是10646-3:2003。
UCS规定了怎么用多个字节表示各种文字。怎样传输这些编码,是由UTF(UCS Transformation Format)规范规定的,常见的UTF规范包括UTF-8、UTF-7、UTF-16。
IETF的RFC2781和RFC3629以RFC的一贯风格,清晰、明快又不失严谨地描述了UTF-16和UTF-8的编码方法。我总是记不得IETF是Internet Engineering Task Force的缩写。但IETF负责维护的RFC是Internet上一切规范的基础。
3、UCS-2、UCS-4、BMP
UCS有两种格式:UCS-2和UCS-4。顾名思义,UCS-2就是用两个字节编码,UCS-4就是用4个字节(实际上只用了31位,最高位必须为0)编码。下面让我们做一些简单的数学游戏:
UCS-2有2^16=65536个码位,UCS-4有2^31=2147483648个码位。
UCS-4根据最高位为0的最高字节分成2^7=128个group。每个group再根据次高字节分为256个plane。每个plane根据第3个字节分为256行 (rows),每行包含256个cells。当然同一行的cells只是最后一个字节不同,其余都相同。
group 0的plane 0被称作Basic Multilingual Plane, 即BMP。或者说UCS-4中,高两个字节为0的码位被称作BMP。
将UCS-4的BMP去掉前面的两个零字节就得到了UCS-2。在UCS-2的两个字节前加上两个零字节,就得到了UCS-4的BMP。而目前的UCS-4规范中还没有任何字符被分配在BMP之外。
4、UTF编码
UTF-8就是以8位为单元对UCS进行编码。从UCS-2到UTF-8的编码方式如下:
╔══════════════╦═════════════════════╗
║UCS-2编码(16进制) ║UTF-8 字节流(二进制) ║
║————————-║————————————–║
║0000 – 007F ║0xxxxxxx ║
║0080 – 07FF ║110xxxxx 10xxxxxx ║
║0800 – FFFF ║1110xxxx 10xxxxxx 10xxxxxx ║
╚══════════════╩═════════════════════╝
例如“汉”字的Unicode编码是6C49。6C49在0800-FFFF之间,所以肯定要用3字节模板了:1110xxxx 10xxxxxx 10xxxxxx。将6C49写成二进制是:0110 110001 001001, 用这个比特流依次代替模板中的x,得到:11100110 10110001 10001001,即E6 B1 89。
读者可以用记事本测试一下我们的编码是否正确。
UTF-16以16位为单元对UCS进行编码。对于小于0×10000的UCS码,UTF-16编码就等于UCS码对应的16位无符号整数。对于不小于0×10000的UCS码,定义了一个算法。不过由于实际使用的UCS2,或者UCS4的BMP必然小于0×10000,所以就目前而言,可以认为UTF-16和UCS-2基本相同。但UCS-2只是一个编码方案,UTF-16却要用于实际的传输,所以就不得不考虑字节序的问题。
5、UTF的字节序和BOM
UTF-8以字节为编码单元,没有字节序的问题。UTF-16以两个字节为编码单元,在解释一个UTF-16文本前,首先要弄清楚每个编码单元的字节序。例如收到一个“奎”的Unicode编码是594E,“乙”的Unicode编码是4E59。如果我们收到UTF-16字节流“594E”,那么这是“奎”还是“乙”?
Unicode规范中推荐的标记字节顺序的方法是BOM。BOM不是“Bill Of Material”的BOM表,而是Byte Order Mark。BOM是一个有点小聪明的想法:
在UCS编码中有一个叫做”ZERO WIDTH NO-BREAK SPACE”的字符,它的编码是FEFF。而FFFE在UCS中是不存在的字符,所以不应该出现在实际传输中。UCS规范建议我们在传输字节流前,先传输字符”ZERO WIDTH NO-BREAK SPACE”。
这样如果接收者收到FEFF,就表明这个字节流是Big-Endian的;如果收到FFFE,就表明这个字节流是Little-Endian的。因此字符”ZERO WIDTH NO-BREAK SPACE”又被称作BOM。
UTF-8不需要BOM来表明字节顺序,但可以用BOM来表明编码方式。字符”ZERO WIDTH NO-BREAK SPACE”的UTF-8编码是EF BB BF(读者可以用我们前面介绍的编码方法验证一下)。所以如果接收者收到以EF BB BF开头的字节流,就知道这是UTF-8编码了。
Windows就是使用BOM来标记文本文件的编码方式的。
6、进一步的参考资料
本文主要参考的资料是 “Short overview of ISO-IEC 10646 and Unicode” (http://www.nada.kth.se/i18n/ucs/unicode-iso10646-oview.html)。
我还找了两篇看上去不错的资料,不过因为我开始的疑问都找到了答案,所以就没有看:
“Understanding Unicode A general introduction to the Unicode Standard” (http://scripts.sil.org/cms/scripts/page.php?site_id=nrsi&item_id=IWS-Chapter04a)
“Character set encoding basics Understanding character set encodings and legacy encodings” (http://scripts.sil.org/cms/scripts/page.php?site_id=nrsi&item_id=IWS-Chapter03)


 4万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


