Redis sds packed对齐理解

redis核心技术梳理(持续更新) redis常用命令 get/set/exists/del/keys/rename/dbsize/type/mget/mset/expire/setnx/incr/decr/append/flushall redis的数据类型 String/Hash/List/Set/Zset/Hyperloglog/Geo/Stream/BitMaps redis事务 redis的单个命令是原子性的(比如get/set/mget/mset),要么成功要么失败,不存在并发干扰的问题。如果涉及到多个命令的. 阅读详情

Redis sds 的源码中,使用了 __attribute__ ((__packed__)) ,一般情况下,结构体会按其所有变量大小的最小公倍数做字节对齐,而用packed修饰以后,结构体则变为按1字节进行对齐。这个最小公倍数如何进行理解呢?

以以下结构进行举例:

#include <stdio.h>

typedef struct MemAlign  
{  
    char a[18];  
    double b;     
    char c;  
    int d;    
    short e;      
}MemAlign;

typedef struct __attribute__ ((__packed__))  MemAlignPacked  
{  
    char a[18];  
    double b;     
    char c;  
    int d;    
    short e;      
}MemAlignPacked;  

int main(void){
    struct MemAlign m;
    struct MemAlignPacked mp;
    printf("========>%d", sizeof(m));
    printf("========>%d", sizeof(mp));
}

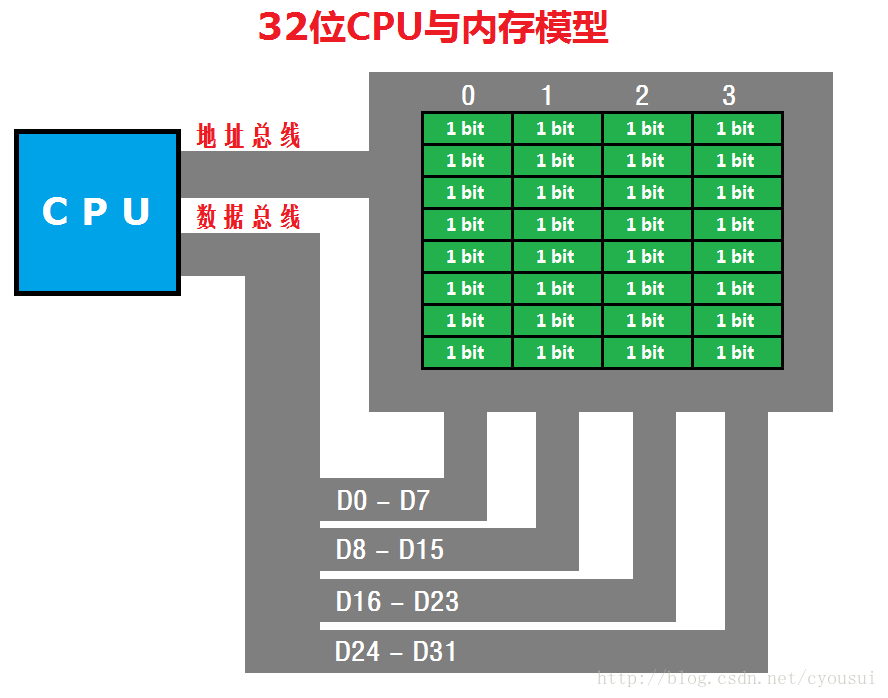
内存存放数据是为了给CPU进行使用,而CPU访问内存数据时会受到地址总线宽度的限制,并且CPU从内存中获取数据时起始地址必须是地址总线宽度的倍数,也就是说CPU是将内存分为一块一块的,块的大小取决于地址总线宽度,并且CPU读取数据也是一块一块读取的,块的大小称为(memory granularity)内存读取粒度。

上面的结构中,有char a[18]这个属性,说明这个属性是占个字节的,在32位CPU的内存模型中,以4个字节对齐(如下图1),属性char a[18]因为占了18个字节,会需要补齐2个字节达到4的最小公倍数20,然后接着分配double b的内存地址(如下图2)。而使用了__packed__修饰以后,就不需要补齐。
而在64位CPU的内存模型中,以8个字节进行对齐(如下图1)。则案例结构如下图2。我的mac是64位的,跑文章开始的代码跑出的结果和猜测的一样。

所以在redis的sds的源码中,出现的sdshdr5 、sdshdr8、sdshdr16、sdshdr32、sdshdr64,都使用了 __attribute__ ((__packed__))进行紧凑排列。好处在于节省内存和方便buf[-1]取到flags地址,获取类型更加方便。

/* Note: sdshdr5 is never used, we just access the flags byte directly.
 * However is here to document the layout of type 5 SDS strings. */
struct __attribute__ ((__packed__)) sdshdr5 {
    unsigned char flags; /* 3 lsb of type, and 5 msb of string length */
    char buf[];
};
struct __attribute__ ((__packed__)) sdshdr8 {
    uint8_t len; /* used */
    uint8_t alloc; /* excluding the header and null terminator */
    unsigned char flags; /* 3 lsb of type, 5 unused bits */
    char buf[];
};
struct __attribute__ ((__packed__)) sdshdr16 {
    uint16_t len; /* used */
    uint16_t alloc; /* excluding the header and null terminator */
    unsigned char flags; /* 3 lsb of type, 5 unused bits */
    char buf[];
};
struct __attribute__ ((__packed__)) sdshdr32 {
    uint32_t len; /* used */
    uint32_t alloc; /* excluding the header and null terminator */
    unsigned char flags; /* 3 lsb of type, 5 unused bits */
    char buf[];
};
struct __attribute__ ((__packed__)) sdshdr64 {
    uint64_t len; /* used */
    uint64_t alloc; /* excluding the header and null terminator */
    unsigned char flags; /* 3 lsb of type, 5 unused bits */
    char buf[];
};

一般情况下windows64位一般使用LLP64模型,64位Unix,Linux使用的是LP64模型

DatetypeLP64ILP64LLP64ILP32LP32
char88888
short1616161616
int3264323216
long6464323232
long long6464646464
pointer6464643232

参考:

https://juejin.cn/post/7074538808259117064

https://blog.youkuaiyun.com/wejack/article/details/127686029

https://blog.youkuaiyun.com/weixin_40997360/article/details/79948968

https://zhuanlan.zhihu.com/p/140063999

https://juejin.cn/post/6922352059517779976

C语言数据类型深度解析:从二进制原理到实战避坑指南 数据类型是编程语言中用于分类和组织数据的基础概念,它定义了数据的存储方式、取值范围和可执行的操作。其核心原理在于通过二进制位的宽度、符号位和编码规则(如补码、IEEE 754)来高效表示信息,从而在内存利用、运算效率和程序安全性之间取得平衡。理解数据类型的取值范围对于编写健壮、高效的代码至关重要,能有效避免数据溢出、精度丢失等常见问题。这一技术价值在底层系统开发、嵌入式编程和高性能计算等应用场景中尤为突出。本文以C语言为切入点,深入剖析了整数和浮点类型的底层表示与取值范围推导,并结合**整数溢出**和**隐 阅读详情

相关推荐

基于STM32与HRTIM的四开关Buck-Boost双向DC-DC电源设计实战(附源码、仿真与设计解析)

本文详细介绍了基于STM32F334的HRTIM高分辨率定时器实现四开关Buck-Boost双向DC-DC电源的设计实战。通过精准的PWM控制、双环PID算法和智能模式切换逻辑,解决了电压震荡与效率优化等关键问题,并提供了完整的源码、PSIM仿真及参数计算,为高性能电源设计提供了实用参考。

7z8x2c4v6b9的博客 299

C语言 | 结构体内存对齐

本文中所有示例代码都是在64位linux系统下使用gcc编译。目录前言1、默认对齐规则2、修改对齐规则3 位域结构体3.1 相邻位域类型相同3.2 相邻位域类型不同(和编译器有关)3.3 位域和非位域穿插参考文章。

weixin_44775036的博客 2214

ADC INL&DNL测试方法和实例

本文介绍了一种可操作的ADC INL和DNL的测试方法--直方图法(也称码密度法)。并实际使用该方法测试了两款芯片的ADC INL和DNL

APTCHIP的博客 1万+

不同编译器字节对齐方式的修改办法

的效果是一样的,它们都用于告诉编译器将结构体或联合体中的成员按照最小对齐方式进行排列,从而减少内存占用并确保数据在内存中的布局紧凑。虽然语法和具体的实现方式有所不同,但在实际使用中,这三种方法都可以达到相同的效果。是一种编译器相关的关键字,用于告诉编译器将结构体或联合体中的成员按照最小对齐方式进行排列,以减少内存占用。是一种通用的跨平台设置对齐方式的方法。在使用时,应根据具体的编译器和平台选择合适的方式来实现结构体或联合体的紧凑排列。是一种通用的跨平台方法,可以在需要的地方设置结构体或联合体的对齐方式。

2301_77864469的博客 686

大数据面试题(附答案,持续更新...)

说说对hadoop的理解,都有哪些组件,分别是干什么的 还了解大数据其他组件嘛? kafka在什么地方需要用到zookeeper 了解HBase吗? 说下spark中的transform和action 为什么spark要把操作分为transform和action spark中有了RDD,为什么还要有Dataframe和DataSet? 了解函数式编程吗?说下c/c++和scala这种函数式编程语...

xiaozhaoshigedasb的博客 9948

数值天气预报期末复习

数值天气预报期末复习

m0_60394632的博客 7681

C语言结构体中__packed 和位段的理解!

C语言中__packed 和位段的理解 一:__packed typedef __packed struct struct常用在数据结构中。而struct的字节对齐方式对于嵌入式底层的程序员来讲是必须掌握的。现代计算机中内存空间都是按照byte划分的,从理论上讲似乎对任何类型的变量的访问可以从任何地址开始,但实际情况是在访问特定类型变量......

魏波 4万+

AutoDock Vina多配体对接 (Simultaneous Multiple Ligand Docking)

多配体分子对接(Simultaneous Multiple Ligand Docking, SMLD)或(Multiple Ligand Simultaneous Docking, MLSD)是一种分子对接技术,用于将多个配体(小分子药物候选物)同时对接到一个蛋白质分子的结合位点。与传统的分子对接技术不同,传统方法通常只考虑一个配体与一个蛋白质的相互作用。SMLD的目标是更高效地研究多个配体如何与同一个蛋白质相互作用,以寻找潜在的药物候选物。

MurphyStar的博客 7146

packed 对齐方式 c语言,C语言结构体变量字节对齐问题总结(示例代码)

结构体字节对齐在用sizeof运算符求算某结构体所占空间时,并不是简单地将结构体中所有元素各自占的空间相加,这里涉及到内存字节对齐的问题。从理论上讲,对于任何 变量的访问都可以从任何地址开始访问,但是事实上不是如此,实际上访问特定类型的变量只能在特定的地址访问,这就需要各个变量在空间上按一定的规则排列, 而不是简单地顺序排列,这就是内存对齐。内存对齐的原因:1)某些平台只能在特定的地址处访问特定类...

weixin_35953155的博客 541

cadence——MOS晶体管I-V特性曲线仿真

MOS晶体管I-V特性曲线仿真 目标:使用cadence绘制晶体管的I-V特性曲线(dc仿真) 流程: 新建原理图,将MOS管的栅极电压设为变量Vg,漏极电压设为变量Vd 打开ADEL,点击Variables——Copy From Cellview添加变量;并选择dc仿真,对Vd进行扫描 以Vg作为参变量进行仿真,点击Tools——Parametric Analysis进行设置 选择漏极电流作为输出,进行仿真即可得到I-V特性曲线 ...

skycmq的博客 1万+

高效与灵活相结合:Verilog编写的跨时钟域循环缓冲控制器解析

循环缓冲区,也被称作循环队列、环形缓冲区,是一种数据结构,其主要特性是使用一个固定大小的缓冲区作为数据的存储空间,这个缓冲区在逻辑上被视作是首尾相接的。虽然Verilog是一种常用的硬件描述语言,被广泛应用在FPGA和ASIC设计中,但是在描述循环缓冲区时,它并没有提供一种直接且灵活的方式来指定循环缓冲区的参数,如字长、缓冲区深度、缓冲区数量等。这给硬件设计带来了一定的不便。同时,该控制器的设计也充分考虑了硬件资源的利用率,通过优化的算法和数据结构,使得在实现高性能的同时,也能够有效地节省硬件资源。

qq_38334677的博客 1221

结构对齐--__packed与#pragma pack

结构对齐--__packed与#pragma pack

2423

材料仿真软件:Quantum Espresso_(15).声子与振动模式计算

通过上述步骤和代码示例,您应该能够使用 Quantum Espresso 进行声子与振动模式的计算。声子计算是材料科学研究中的重要工具,可以帮助我们更好地理解和设计材料的性能。希望本节内容对您有所帮助。

kkchenjj的博客 1185

Redis中的SDS理解

Redis中的SDS理解

alian 366

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

RU DOS版、EFI版32bit/64bit BIOS常用工具

DOS版、EFI版的RU工具,可用来查看IO、MEM、PCI、SMBIOS等资源。亲测在EFI SHELL下可用。

redis字符串sds源码分析

被天美面试官怼了没有技术深度,确实看源码看的少,趁着毕业前看看redis的源码。 操作命令 Get、Set、mset、mget 后面nx表示不存在key才创建,xx表示key存在才可以修改。 mset nx 如果有一个key存在那么这条命令就不对了。 strlen获得字符串,时间复杂度是O(1) getrange 获取范围字符串,支持正索引和负索引值 setrange,在范围内赋值,如果位数不够0来补齐 append 追加新的内容到字符串尾部 incrby decrby incr decr incrbyf

dxgzg的博客 952

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

【Redis-6.0.8】数据结构之SDS-简单动态字符串

1.字符串 2.哈希 3.列表 4.集合 5.有序集合

Edidaughter的博客 352

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

c语言packed,结构体声明当中 __attribute__ ((__packed__))关键字

数要多出一些,而如何减少内存占用,计算内存使用量,也是很多面试题里经常出现的题目。(字节对齐的详细内容请自行寻找资料,不要依靠本篇文章中的现象跟结果来理解字节对齐)但是稍微当我们真的不想要字节对齐的时候,有没有办法取消字节对齐?答案是可以,就是在结构体声明当中,加上__attribute__ ((__packed__))关键字,它可以做到让我们的结构体,按照紧凑排列的方式,占用内存。来段实际代码:...

weixin_28942523的博客 733

Redis源码:从struct __attribute__ ((__packed__)) sdshdr到回忆C语言中的字节对齐

关于字节对齐的一次整理

woshiyuxie的博客 338

Redis学习笔记&源码阅读--简单动态字符串

申明 本文基于Redis源码5.0.8 本文内容大量借鉴《Redis设计和实现》和《Redis5设计与源码分析》 概念 简单动态字符串(Simple Dynamic Strings, SDS)是Redis的基本数据结构之一,用于存储字符串和整型数据。SDS兼容C语言标准字符串处理函数,且在此基础上保证了二进制安全。 对于字符串,一般有两种保存方式,一种是使用’\0‘作为字符串的结束符,另一种是记录字符串的长度。SDS采用的是第二种方式来存储字符串,那么按照理解,SDS的结构大致如下所示: struct

一哲寒流的专栏 327

Redis存储原理与数据模型

Redis采用单线程处理命令,主要出于两个原因:一是多线程加锁机制复杂,可能影响性能;二是单线程模型简单可靠,配合多路复用能高效处理请求。为避免单线程阻塞,Redis将持久化、网络I/O等耗时操作交给子进程或异步线程,并通过渐进式处理分散重负载。其高性能源于内存操作、高效数据结构和Reactor网络模型。关键优化包括:渐进式rehash、柔性数组紧凑存储、64字节分界策略等。持久化方面,RDB通过fork子进程保存快照,AOF记录写命令日志,两者结合确保数据安全与快速恢复。fork机制利用写时复制(COW)

m0_74124909的博客 307

Redis相关命令详解及其原理

如果不使用柔性数组,而是使用char* buffer的话,那么就需要malloc两次(一次是申请struct结构体的内存,还有一次是申请char* buffer的内存);同理释放也需要释放两次柔性数组的优点方便内存的分配及释放(只需要调用一次malloc)减少内存碎片(只需要调用一次malloc)分清楚几个概念:对象类型:抽象的数据结构数据结构、内存存储的结构:落盘的时候写到磁盘的结构内存中的结构:字符串使用的是sds的数据结构来进行存储的size_t sz;*/

qjh_serena的博客 1136

C语言 __attribute__ 关键字理解

出现的问题 下面是一段redis源码,其中出现了__attribute__,那么它到底是啥意思呢? //redis-6.0.5/src/sds.h struct __attribute__ ((__packed__)) sdshdr64 { uint64_t len; /* used */ uint64_t alloc; /* excluding the header and null terminator */ unsigned char flags; /* 3 lsb of ty

worse_man的博客 3022

C语言结构体字节对齐(内存对齐)之#pragma pack和__attribute__((packed)的使用

在不使用和本文主要讨论如何使用#pragma pack和__attribute__((packed)等选项来自定义字节对齐大小。使用pack功能将数据结构进行打包,以减小应用程序对内存的占用,这一点在嵌入式系统中,尤其是需要存储和访问大量的时候,显得尤其重要。如果没有使用#pragma pack和__attribute__((packed)等选项,将数据结构进行打包。编译器为了提高对数据成员的访问速度,通常会在不同大小的数据成员之间插入空白内存(padding),进行补齐操作,即内存对齐。

DayDayUp 1万+

C/C++字节对齐(pack)

字节对齐

嵌入式与人工智能 1666

字节对齐详解

一.什么是字节对齐,为什么要对齐?    现代计算机中内存空间都是按照byte划分的,从理论上讲似乎对任何类型的变量的访问可以从任何地址开始,但实际情况是在访问特定类型变量的时候经常在特 定的内存地址访问,这就需要各种类型数据按照一定的规则在空间上排列,而不是顺序的一个接一个的排放,这就是对齐。    对齐的作用和原因:各个硬件平台对存储空间的处理上有很大的不同。一些平台对某些特定类型的数据只

Embedded System-DTV/STB Development 7191

内存对齐.结构体对齐

<br />gcc 中的"__attribute__ ((packed))"<br /> <br /><br />__attrubte__ ((packed)) 的作用就是告诉编译器取消结构在编译过程中的优化对齐,按照实际占用字节数进行对齐。<br /><br />#define __u8    unsigned char<br />#define __u16   unsigned short<br /><br />/* __attribute__ ((packed)) 的位置约束是放于声明的尾部“;”之前

1万+
上一篇: linux中结构体对齐
下一篇: 分布式AKF拆分原则
不与天斗8866
博客等级 码龄18年 651粉丝 196原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
