算法的试金石:模型训练、评估与调优的艺术

Sklearn切分数据集(超详细) 当一个数据集足够大时,可将同一数据集按比例切分为训练集和测试集。Sklearn库在机器学习中具有非常重要的作用。在本篇文中,将介绍如何使用sklearn库的model_selection模块,以及具体实现细节。 阅读详情

前言:
在上一篇博客中,我们化身“数据炼金术师”,将杂乱无章的原始数据清洗、编码、缩放,打磨成了晶莹剔透的“特征宝石”。现在,这些宝石已经整齐地摆放在实验台上,等待着被赋予生命。

本篇是“机器学习实战四部曲”的第三篇,我们将进入最核心的环节:模型训练与评估。
很多初学者有一个误区:认为选一个最贵的算法(比如深度神经网络),跑一遍代码,任务就完成了。大错特错!
真正的机器学习工程,80% 的精力花在如何科学地评估模型、诊断问题以及微调参数上。 如果评估方法错了,你所谓的“高精度”可能只是自欺欺人。今天,我们就来拆解这套科学的验证体系,并深入几个经典算法的内核。


🧪 一、黄金法则:训练集与测试集的分离

在开始训练之前,我们必须确立一条不可逾越的红线:永远不要用考试卷来复习功课。

1. 为什么要切分数据?

如果我们用所有数据来训练模型,然后又在同一批数据上测试它,模型很可能会“死记硬背”下每一个样本的细节(包括噪声和异常值)。这在机器学习中称为过拟合 (Overfitting)。

  • 训练集 (Training Set):课本。模型通过学习它来掌握规律(通常占 70%-80%)。
  • 测试集 (Test Set):考卷。完全 unseen(未见过的)数据,用来检验模型是否真的学会了举一反三(通常占 20%-30%)。

2. 代码实现:train_test_split

Scikit-learn 提供了极其便捷的工具来完成这一步。

from sklearn.model_selection import train_test_split
from sklearn.datasets import make_classification

# 1. 生成一些模拟的分类数据 (1000个样本,20个特征)
X, y = make_classification(n_samples=1000, n_features=20, random_state=42)

# 2. 切分数据
# test_size=0.2 表示 20% 做测试集
# random_state=42 保证每次运行结果一致,方便复现
# stratify=y 表示分层采样,保证训练集和测试集中各类别的比例一致(非常重要!)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, 
    test_size=0.2, 
    random_state=42, 
    stratify=y
)

print(f"训练集样本数: {X_train.shape[0]}")
print(f"测试集样本数: {X_test.shape[0]}")

💡 专家提示:
如果你的数据中正负样本比例严重失衡(例如 99% 是正常用户,1% 是欺诈用户),务必使用 stratify=y 参数。否则,测试集中可能一个欺诈样本都没有,导致评估完全失效。

image-20260318090511656


🌲 二、经典算法巡礼:从逻辑回归到随机森林

虽然深度学习很火,但在结构化数据(表格数据)领域,传统机器学习算法依然是王者。我们重点介绍三个最具代表性的算法。

1. 逻辑回归 (Logistic Regression) —— 分类界的“基准线”

不要被名字里的“回归”误导,它是一个分类算法。

  • 原理:在线性回归的基础上,加了一个 Sigmoid 函数,把输出值压缩到 (0, 1) 之间,代表属于某一类的概率。
  • 优点:计算快、可解释性强(能看出哪个特征权重高)、不易过拟合。
  • 适用:作为 baseline(基准模型),或者需要解释“为什么”的场景(如信贷审批)。

2. 决策树 (Decision Tree) —— 模拟人类决策

  • 原理:像流程图一样,通过一系列“如果是…那么…”的问题(节点分裂),最终得出结论(叶子节点)。
    • 根节点:收入 > 5000 吗?
    • 左分支:是 -> 年龄 < 30 吗?
    • 右分支:否 -> 拒绝贷款。
  • 优点:直观易懂,无需数据缩放,能处理非线性关系。
  • 缺点:极易过拟合(树长得太深,把特例都记住了)。

3. 随机森林 (Random Forest) —— 集体的智慧

  • 原理:集成学习 (Ensemble Learning) 的代表。它构建几十甚至上百棵决策树,每棵树只看到部分数据和部分特征。最后,通过“投票”决定结果。
  • 核心思想:三个臭皮匠,顶个诸葛亮。单棵树可能犯错,但一百棵树同时犯错的概率极低。
  • 优点:精度极高、抗过拟合能力强、对异常值不敏感。是目前表格数据竞赛中的常客。
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import RandomForestClassifier

# 初始化三个模型
lr = LogisticRegression()
dt = DecisionTreeClassifier(random_state=42)
rf = RandomForestClassifier(n_estimators=100, random_state=42) # 100棵树

# 训练
lr.fit(X_train, y_train)
dt.fit(X_train, y_train)
rf.fit(X_train, y_train)

print("三个模型训练完成!")

image-20260318091059283

📏 三、评估指标:准确率是个“骗子”?

模型训练好了,怎么知道它好不好?
新手最爱用 准确率 (Accuracy):预测对的样本数 / 总样本数。
但在很多场景下,准确率会骗人!

1. 准确率陷阱

假设我们要检测癌症,1000 个人里只有 1 个患者。
如果模型是个“懒汉”,它全部预测为“健康”。

  • 准确率 = 999/1000 = 99.9%。看起来棒极了!
  • 但实际上,它漏掉了唯一的患者,召回率 (Recall) 为 0。这在医疗上是致命的。

2. 四大金刚指标

我们需要更细致的维度,这就引入了混淆矩阵 (Confusion Matrix):

预测正例 (Positive)预测负例 (Negative)
真实正例TP (真阳性)FN (假阴性 - 漏报)
真实负例FP (假阳性 - 误报)TN (真阴性)

基于此,衍生出核心指标:

  • 精确率 (Precision):预测为正例的里面,有多少是真的?
    • 公式: T P / ( T P + F P ) TP / (TP + FP) TP/(TP+FP)
    • 场景:垃圾邮件检测。宁可漏掉一封垃圾邮件,也不能把重要邮件误判为垃圾(FP 代价大)。
  • 召回率 (Recall):所有真实的正例里,找回来了多少?
    • 公式: T P / ( T P + F N ) TP / (TP + FN) TP/(TP+FN)
    • 场景:地震预测、癌症筛查。宁可误报,也不能漏报(FN 代价大)。
  • F1-Score:精确率和召回率的调和平均数。当两者需要平衡时使用。
    • 公式: 2 × ( P r e c i s i o n × R e c a l l ) / ( P r e c i s i o n + R e c a l l ) 2 \times (Precision \times Recall) / (Precision + Recall) 2×(Precision×Recall)/(Precision+Recall)

3. 代码实战:全方位体检

from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score, classification_report, confusion_matrix
import seaborn as sns
import matplotlib.pyplot as plt

# 使用随机森林进行预测
y_pred = rf.predict(X_test)

# 计算各项指标
acc = accuracy_score(y_test, y_pred)
prec = precision_score(y_test, y_pred)
rec = recall_score(y_test, y_pred)
f1 = f1_score(y_test, y_pred)

print(f"准确率: {acc:.4f}")
print(f"精确率: {prec:.4f}")
print(f"召回率: {rec:.4f}")
print(f"F1 分数: {f1:.4f}")

print("\n--- 详细分类报告 ---")
# 直接打印每个类别的指标
print(classification_report(y_test, y_pred))

# 绘制混淆矩阵
cm = confusion_matrix(y_test, y_pred)
sns.heatmap(cm, annot=True, fmt='d', cmap='Blues')
plt.title('混淆矩阵')
plt.ylabel('真实标签')
plt.xlabel('预测标签')
plt.show()
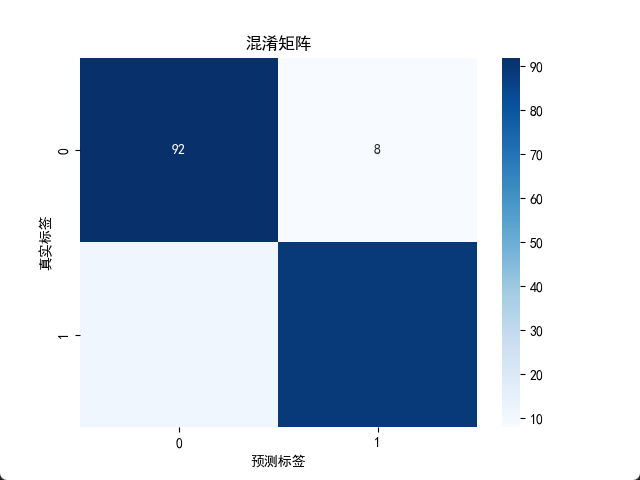
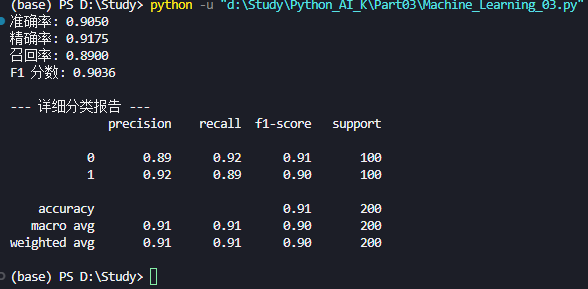
image-20260318091149981

image-20260318091208285

🎛️ 四、超参数调优:寻找模型的“甜蜜点”

模型内部有两类参数:

  1. 模型参数:算法自己学出来的(如线性回归的权重 w w w)。
  2. 超参数 (Hyperparameters):我们在训练前手动设定的(如随机森林的树的数量 n_estimators、决策树的最大深度 max_depth)。

超参数设不好,模型性能天差地别。怎么找最好的组合?

  • 笨办法:人工一个个试(累死且不全)。
  • 聪明办法:网格搜索 (Grid Search)。

网格搜索原理

它会把所有可能的参数组合列成一个表格(网格),然后自动遍历每一种组合,利用交叉验证 (Cross Validation) 来评估,最后选出得分最高的那组。

from sklearn.model_selection import GridSearchCV

# 1. 定义我们要尝试的参数网格
param_grid = {
    'n_estimators': [50, 100, 200],      # 树的数量
    'max_depth': [None, 10, 20],         # 树的最大深度
    'min_samples_split': [2, 5]          # 内部节点再划分所需最小样本数
}

# 2. 初始化网格搜索对象
# cv=5 表示 5 折交叉验证:把训练集分成 5 份,轮流做验证,结果更稳
grid_search = GridSearchCV(
    estimator=RandomForestClassifier(random_state=42),
    param_grid=param_grid,
    cv=5,
    scoring='f1',           # 我们优化的目标是 F1 分数
    n_jobs=-1,              # 使用所有 CPU 核心加速
    verbose=1               # 显示进度
)

# 3. 开始搜索 (这步比较耗时)
grid_search.fit(X_train, y_train)

# 4. 输出最佳结果
print("最佳参数组合:", grid_search.best_params_)
print("最佳交叉验证得分:", grid_search.best_score_)

# 5. 使用最佳模型在测试集上验证
best_model = grid_search.best_estimator_
final_score = best_model.score(X_test, y_test)
print(f"测试集最终得分: {final_score:.4f}")
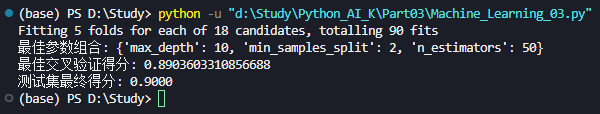
image-20260318091324543

通过这一步,我们不再是“拍脑袋”定参数,而是用数据驱动的方式找到了当前数据集下的最优解。


📉 五、学习曲线:诊断模型的“健康状况”

调优结束后,如果效果还是不理想,该怎么办?这时候需要画出学习曲线 (Learning Curve) 来诊断病因。

  • 现象 A:训练集得分高,验证集得分低,且随着数据量增加,两者差距依然很大。
    • 诊断:过拟合 (High Variance)。
    • 药方:增加正则化、减少特征、增加更多训练数据、降低模型复杂度。
  • 现象 B:训练集和验证集得分都很低,且两者靠得很近。
    • 诊断:欠拟合 (High Bias)。
    • 药方:增加模型复杂度、增加新特征、减少正则化。
from sklearn.model_selection import learning_curve
import numpy as np

train_sizes, train_scores, val_scores = learning_curve(
    best_model, X_train, y_train, 
    cv=5, 
    scoring='f1', 
    train_sizes=np.linspace(0.1, 1.0, 10),
    n_jobs=-1
)

# 计算均值和标准差
train_mean = np.mean(train_scores, axis=1)
val_mean = np.mean(val_scores, axis=1)

plt.plot(train_sizes, train_mean, 'o-', color='blue', label='训练集得分')
plt.plot(train_sizes, val_mean, 'o-', color='green', label='交叉验证得分')
plt.xlabel('训练样本数量')
plt.ylabel('F1 分数')
plt.title('学习曲线')
plt.legend()
plt.grid(True)
plt.show()
image-20260318091627581

看着这张图,你就能像医生看 X 光片一样,清晰地判断模型是“太胖了”(过拟合)还是“太瘦了”(欠拟合),从而对症下药。


🔮 下一篇预告:迈向巅峰——集成学习与实战项目

至此,我们已经掌握了机器学习的完整闭环:

  1. 数据预处理:清洗、编码、缩放。
  2. 模型训练:逻辑回归、决策树、随机森林。
  3. 科学评估:混淆矩阵、F1 分数、交叉验证。
  4. 参数调优:网格搜索、学习曲线诊断。

但这还不是终点。在工业界和顶级竞赛中,高手们往往不满足于单个模型的表现。
在**第四篇(终章)**博客中,我们将:

  • 进阶集成策略:除了随机森林,还有更强大的 Gradient Boosting (GBDT, XGBoost, LightGBM) 和 Stacking 融合技术,它们是如何通过“接力赛”的方式不断修正错误的?
  • 全流程实战:我们将把这些知识串联起来,完成一个完整的端到端项目(例如:房价预测或客户流失分析),从数据加载到模型部署,输出一份可落地的解决方案。
  • 避坑指南:总结新手最容易犯的 5 个致命错误。

准备好了吗?让我们收官之作中,见证从“熟练工”到“架构师”的最后一步跨越!

毒 vs 误报病毒),你应该优先优化哪个指标?你会如何调整模型的阈值来实现这一点?

Python临床预测模型实战:从数据清洗到模型评估的完整指南 机器学习在医疗健康领域的应用日益广泛,其中临床预测模型通过分析患者历史数据来估计疾病风险概率,为辅助诊断和预后评估提供了量化工具。其核心原理在于将统计学方法与领域知识相结合,构建可靠的概率估计模型。相较于通用机器学习模型,临床预测模型更强调校准度、可解释性和临床验证,技术价值体现在能够为医疗决策提供循证支持。在实际应用中,开发者常面临数据质量、模型解释和临床效用评估等挑战。本文以糖尿病风险预测为例,详细介绍了使用Python进行数据预处理、特征工程、逻辑回归与随机森林建模的完整流程,并重点探讨了校准曲线和决 阅读详情

相关推荐

CEC2022测试函数集:从基准解读到实战调优指南

本文深入解析CEC2022测试函数集的核心价值与应用场景,涵盖单峰、多峰、混合及动态函数四大类挑战。通过实战案例与调优策略,帮助研究者提升优化算法性能,特别适合算法论文对比、工业级系统开发及新型算子验证。文章还提供了高效测试工具链与可视化分析技巧,助力快速定位算法缺陷并实现持续改进。

weixin_29250403的博客 101

sklearn.model_selection.train_test_split

使用sklearn.model_selection.train_test_split可以在数据集上随机划分出一定比例的训练集和测试集,并返回拆分得到的train和test数据集。 使用格式: from sklearn.model_selection import train_test_split X_train, X_test, y_train, y_test = train_test_split...

Dear_D的博客 2456

大语言模型七类基准测试:从能力评估到业务落地的完整框架

大语言模型(LLM)评估已超越单一准确率指标,进入多维能力验证阶段。其核心在于解构模型的原子能力——如知识记忆、逻辑推理、事实性判断与人类偏好对齐,并将这些能力映射到真实业务的价值链条中。MMLU、GSM8K等测试衡量基础认知能力,TruthfulQA、FActScore聚焦事实性与幻觉控制,而AlpacaEval、MT-Bench则反映用户侧体验质量。技术价值体现在风险前置识别与部署可行性验证,应用场景覆盖金融风控、政务问答、教育陪伴及智能客服等高要求领域。本文系统梳理构成工业级LLM评估骨架的七类基准测

weixin_30239339的博客 578

sklearn之train_test_split()函数各参数含义(非常全)

转载于:https://www.cnblogs.com/Yanjy-OnlyOne/p/11288098.html 作者:The-Chosen-One 在机器学习中,我们通常将原始数据按照比例分割为“测试集”和“训练集”,从 sklearn.model_selection 中调用train_test_split 函数 简单用法如下: X_train,X_test, y_train, y_test =sklearn.model_selection.train_test_split(train_data,tra

Andrew_SJ的博客 3219

大模型评估不是跑分,而是业务价值校准

大语言模型(LLM)评估本质上是验证模型在真实业务场景中交付稳定价值的能力,而非追求公开榜单上的高分。其核心原理在于弥合‘任务形态、数据分布、风险容忍度’三重场景鸿沟;技术价值体现在将抽象能力转化为可测量的事实一致性、指令遵循性与格式鲁棒性等基础保障,并支撑任务层的关键信息召回率、幻觉率等性能指标;典型应用场景覆盖金融风控报告生成、法律合同审查、医疗病历摘要、客服对话总结等高可靠性需求领域;最终必须收敛到以黄金样本集、多维指标矩阵和轻量级自动化流水线为支柱的工程化评估实践。

weixin_30411239的博客 288

数学建模与数据分析实战:从问题定义到模型部署的完整闭环

数学建模与数据分析是解决现实复杂问题的核心方法论。其本质是通过数学语言抽象现实问题,并利用数据驱动模型求解。从技术原理看,它遵循严谨的工作流:首先将模糊业务需求转化为可量化问题,明确预测、分类或优化等模型类型;接着进行数据采集与深度清洗,处理缺失值与异常值,这是决定模型性能上限的关键;然后通过特征工程构造和选择有效特征,并基于问题特性选型模型,从简单的基线模型开始迭代;最后通过训练集-验证集-测试集划分、交叉验证和超参数调优来评估与优化模型。在工程实践中,这一流程常借助Python生态工具链高效实现,例如使

weixin_34252090的博客 474

sklearn.model_selection中的train_test_split

sklearn.model_selection.train_test_split用来随机划分训练集和测试集 随机数种子:其实就是该组随机数的编号,在需要重复试验的时候,保证得到一组一样的随机数。比如你每次都填1,其他参数一样的情况下你得到的随机数组是一样的。但填0或不填,每次都会不一样。 随机数的产生取决于种子,随机数和种子之间的关系遵从以下两个规则: 种子不同,产生不同的随机数;种子相同,即使...

weixin_43976903的博客 6449

工业级计算机视觉模型选型实战指南:精度、速度、资源与鲁棒性四维评估法

计算机视觉模型选型本质是工程决策问题,而非单纯追求学术指标。其核心在于理解骨干网络(如ResNet、ViT、ConvNeXt)的底层原理差异——CNN侧重局部归纳与硬件友好性,Transformer擅长长程建模但计算开销大,Hybrid架构则尝试兼顾二者。技术价值体现在将抽象能力转化为可量化的精度、推理延迟、显存占用与扰动鲁棒性四大维度,并通过真实产线验证(如AOI检测、手术器械识别、货架盘点)实现成本效益最优。本文聚焦工业落地场景,深度融合计算机视觉模型选型与骨干网络对比,提供一套可复现、可度量、可部署的

weixin_30952479的博客 570

【Pytorch】进阶学习:深入解析 sklearn.model_selection 中的 train_test_split(划分数据集一步到位)

🔥【Pytorch进阶】数据预处理神器!train_test_split让你划分数据集更高效🚀 🌵在机器学习中,数据集划分是确保模型泛化能力的关键。📚而train_test_split则是sklearn提供的强大数据划分工具。💻它能轻松实现数据的训练集和测试集划分,📈通过调整参数,你可以控制划分比例和随机性。🔍进阶用法更是能让你的数据预处理更精细。🎉掌握它,你的模型训练将更高效! #Pytorch进阶 #train_test_split #数据集划分 #机器学习预处理

创作高质量博文,分享知识,共同进步! 2857

Proteus+汇编+8086电子时钟实战:从框架搭建到中断驱动的核心实现

本文详细介绍了使用Proteus仿真软件和8086汇编语言实现电子时钟的完整过程。从程序框架搭建、内存分段模型理解,到核心的8259中断控制器配置与编程,再到中断服务程序编写和数码管动态扫描显示驱动,系统阐述了底层软硬件协同开发的核心原理与实战步骤。该项目是深入理解计算机中断机制和汇编语言编程的绝佳实践。

weixin_29189381的博客 413

FPGA+CMV4000实战:从零搭建20fps成像系统的5个关键步骤(附避坑指南)

本文详细介绍了如何从零搭建基于FPGA和CMV4000传感器的20fps成像系统,涵盖硬件选型、SPI通信优化、LVDS数据采集、DDR2内存管理及系统集成等5个关键步骤。特别针对CMV4000传感器的SPI配置和高速数据处理的常见问题提供实用解决方案,帮助开发者避免常见陷阱,提升成像系统性能。

weixin_42628688的博客 428

Python实现简单的模型调优技术

通过以上的内容,我们已经领略了模型调优的魅力及其重要性。无论是手动还是自动化的方法,调优都是一个充满挑战与机遇的过程。只要掌握了正确的方法和工具,你也可以成为一名出色的调优大师,让你的模型在各种数据集上展现出色的表现。接下来,让我们一起进入实战阶段,运用所学的知识来提升模型的性能吧!嘿!欢迎光临我的小小博客天地——这里就是咱们畅聊的大本营!能在这儿遇见你真是太棒了!我希望你能感受到这里轻松愉快的氛围,就像老朋友围炉夜话一样温馨。这里不仅有好玩的内容和知识等着你,还特别欢迎你畅所欲言,分享你的想法和见解。

master_chenchen的博客 1108

MemSeg:一种差异和共性来检测图像表面缺陷的半监督方法

本文认为人为创建类内差异和保持类内共性可以帮助模型实现更好的缺陷检测能力,从而更好地区分非正常图像。如图一所示。差异(differences):MemSeg引入人工模拟的异常图像在训练阶段使模型能够区分正常和异常的图像,减轻了半监督学习只能用正常样本进行训练的不足,然后在推理阶段可以直接输入图像无需做任何后处理。共性(commonalities):MemSeg引入了一个记忆池来记录正常样本的通用模式,在训练和推理阶段,比较输入图像和记忆池中的样本之间的差异,为异常区域的定位提供有用的信息。

斯人若彩虹,遇上方知有! 4841

【机器学习】揭秘分类与预测算法“试金石”:一场数据技艺比拼

精度(Precision)如同剑客刺出的一剑封喉,衡量的是预测为正类的样本中实际为正类的比例,反映算法在识别目标类别的准确性。理解并熟练运用这些评价方式,不仅能使我们慧眼识珠,挑选出最优秀的算法“侠客”,更能助力我们在现实世界的商业决策、科研探索中,借力AI,洞悉数据背后的奥秘,精准预知未来趋势。交叉验证(Cross-validation)如同连续多轮的车轮战,通过将数据集分割成k个子集(如k-fold交叉验证),每次用k-1个子集训练模型,剩下的子集做测试,重复k次,最终综合k次测试结果得出平均性能。

qq_38378771的博客 652

AI驱动的CNC闭环加工系统:边缘实时控制与IIoT反馈实践

闭环控制是工业自动化的核心概念,指通过实时反馈调节系统输出以逼近目标值;其技术原理在于构建短于被控对象时间常数的确定性反馈链路,从而保障动态响应精度与稳定性。在智能制造落地中,AI正从离线分析工具演进为嵌入式实时决策单元,其核心价值在于将工艺知识模型化、控制指令轻量化、执行路径边缘化。典型应用场景包括CNC加工过程中的振动自适应调参、刀具磨损在线补偿及多机协同优化。本实践聚焦FANUC 0i-MF平台,基于Modbus TCP硬实时通信与轻量LSTM+CNN融合模型,实现217毫秒级AI推理与PMC寄存器直

weixin_29704001的博客 323

基于MATLAB的小波包分解(WPD)算法详解

本文详细介绍了基于MATLAB的小波包分解(WPD)算法。WPD作为信号处理领域的重要技术,继承并发展了小波分析的优点,通过正交镜像滤波器组将信号分解为不同频率子带,形成完整的二叉树结构。相比传统小波变换,WPD具有更精细的频带划分、自适应基选择能力和更高的灵活性,特别适合分析非平稳信号。文章系统阐述了WPD的数学原理、算法实现流程及其在机械故障诊断、生物医学信号处理等领域的应用。通过MATLAB代码示例展示了WPD的具体实现方法,并分析了不同参数设置对分解效果的影响,为工程实践提供了有价值的参考。

qq_42212808的博客 292

32B医疗大模型训练实战:突破收敛与成本困境

大规模预训练模型在医疗AI领域面临数据质量、多模态融合和训练成本等核心挑战。从技术原理看,模型收敛速度受数据分布、硬件性能及梯度竞争共同影响,而成本控制需平衡计算效率与存储策略。工程实践中,动态梯度调和算法可提升多模态训练稳定性,差分检查点策略能显著降低存储开销。医疗场景特有的标注不一致性和知识图谱融合问题,需要通过数据增强流水线和时间感知知识融合来解决。本文以32B参数医疗模型为例,详解如何通过数据管道优化、硬件利用率提升等方法突破训练瓶颈,为医疗AI模型开发提供实用参考。

civtsbiqr522632413的博客 353

RK3568平台开发系列讲解(NPU篇)什么是RKNPU

📢本篇章将介绍RKNPU。

内核笔记 4355

医疗AI多标签分类:大语言模型不确定性量化与性能评估实践

在多标签分类任务中,模型不仅需要输出预测结果,更重要的是评估其预测的置信度,这在医疗等高风险领域尤为关键。不确定性量化技术通过计算模型对自身预测的把握程度,将传统的“黑箱”决策转化为可解释的概率输出。其核心原理包括模型校准(如温度缩放)和认知不确定性估计(如蒙特卡洛Dropout),旨在使置信度分数与真实错误概率相匹配。这项技术的价值在于提升AI系统的可靠性和安全性,使临床决策支持、电子病历自动编码等应用能够基于风险阈值进行预测拒绝或人工复核。本文聚焦于医疗文本场景,针对其专业术语复杂、标签长尾分布等特点,

weixin_34378969的博客 394

PCL点云库入门(第6讲)——PCL库中Eigen数学工具库的基本使用(持续更新)

Eigen库是一个高性能的C++模板库,专注于线性代数、矩阵和向量运算,以及相关的数值分析和算法。在Eigen库中,所有的矩阵和向量均被视为矩阵模板类的实例。向量可以被看作是特殊形式的矩阵,具体表现为只包含1行或1列。

qq_36812406的博客 1753

自然语言处理之机器翻译:Transformer:Transformer在低资源语言翻译中的应用

Transformer模型是自然语言处理领域的一个重要突破,由Vaswani等人在2017年的论文《Attention is All You Need》中提出。它摒弃了传统的循环神经网络(RNN)和卷积神经网络(CNN)的序列依赖性,采用自注意力机制(Self-Attention)处理输入序列,极大地提高了训练效率和模型性能。

zhubeibei168的博客 1015

DCT-Net模型量化分析:生成质量评估体系构建

本文介绍了如何在星图GPU平台上自动化部署DCT-Net 人像卡通化模型GPU镜像,实现高效、稳定的人像转卡通图像生成。该镜像支持手绘、3D、水彩等多种风格迁移,典型应用于社交头像定制、电商海报批量制作及数字内容创意生产,显著提升视觉内容工业化输出质量与一致性。

weixin_32535825的博客 173

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

PACS数据集实战:用PyTorch轻松搞定多领域迁移学习(附完整代码)

本文以PACS数据集为核心,详细介绍了使用PyTorch进行多领域迁移学习的实战流程。通过构建高效的数据加载管道、设计迁移学习策略(如特征提取与微调),并实现多源领域训练循环,帮助开发者快速掌握处理领域偏移、提升模型泛化能力的关键技术。文章提供了完整代码,是进入多领域自适应研究的理想起点。

butter的博客 574

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

从汉字笔画到AI艺术:解码中文文字生成的视觉密码学

本文探讨了AI在中文文字生成中的视觉密码学挑战与突破,揭示了汉字复杂拓扑结构和文化内涵对多模态AI理解能力的考验。通过分析笔画顺序、间架结构及文化符号学,介绍了工业级解决方案如清华大学'墨魂'系统的文化感知模块,展示了AI在非遗数字化和字体创新中的应用前景。

m3n5b7v8c9x的博客 988

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

26种MM-LLM模型竞技场:谁是最强‘跨界艺术家’?

本文深入分析了26种多模态大模型(MM-LLM)在参数效率、模态兼容性和创意生成力三大赛道的表现,揭示了多模态AI技术的跨界应用潜力。腾讯AI Lab的研究显示,这些模型在电商、影视、教育等领域展现出强大的商业价值,其中LLaVA-1.5等模型在成本与性能平衡上表现突出。文章还探讨了人机共创模式的优势,为行业应用提供了实用指南。

weixin_29185199的博客 387

CrowS-Pairs:衡量掩码语言模型中社会偏见的挑战数据集

CrowS-Pairs是一个专门设计用于评估掩码语言模型(MLM)中社会偏见的基准测试数据集,由Nikita Nangia、Clara Vania、Rasika Bhalerao和Samuel R. Bowman于2020年提出。这个基准测试包含1,508个句子对,覆盖九种社会偏见类型,旨在测量模型在生成或理解文本时是否依赖于社会刻板印象和偏见。🤖掩码语言模型(如BERT、RoBERTa等)在训练过程中吸收了海量的人类文本数据,这些数据中不可避免地包含了许多人类社会固有的社会刻板印象和偏见。

拒绝AI玄学,只聊真技术▲ 1131
上一篇: 数据炼金术:机器学习背后的“脏活”与特征工程
下一篇: 机器学习终章:集成学习的巅峰与全流程实战复盘
Yardon_Official
博客等级 码龄5年 800粉丝 207原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

Yardon_Official

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值