一文搞定llama在linux的下载(huggingface版,使用镜像)

【Llama2-Chinese】搭建本地llama2-chinese中文模型步骤 Llama2-Chinese本地环境搭建步骤说明,以及运行中遇到的问题 阅读详情
AI摘要

博客介绍了在Linux环境下下载Llama模型的两步流程。首先是申请参数,推荐在huggingface上进行,注册并填信息时注意国家填写的坑,审批通过会发邮件。然后是下载模型,需创建write类别的token,设置镜像源,登录huggingface后用命令行下载。

下载Llama需要两步走

  • 申请参数
  • 下载模型

申请参数

首先我在github上找到llama项目,链接:Llama3
权限申请我推荐使用huggingface。这是因为用meta llama官网申请的时候,我把信息都填好了,结果按accept and continue它没动静。但huggingface申请参数就很顺利。

我们在huggingface上找到了meta-llama项目,找到我们要下载的模型:比如Llama-3.2-1B

我们需要注册才能下载模型:
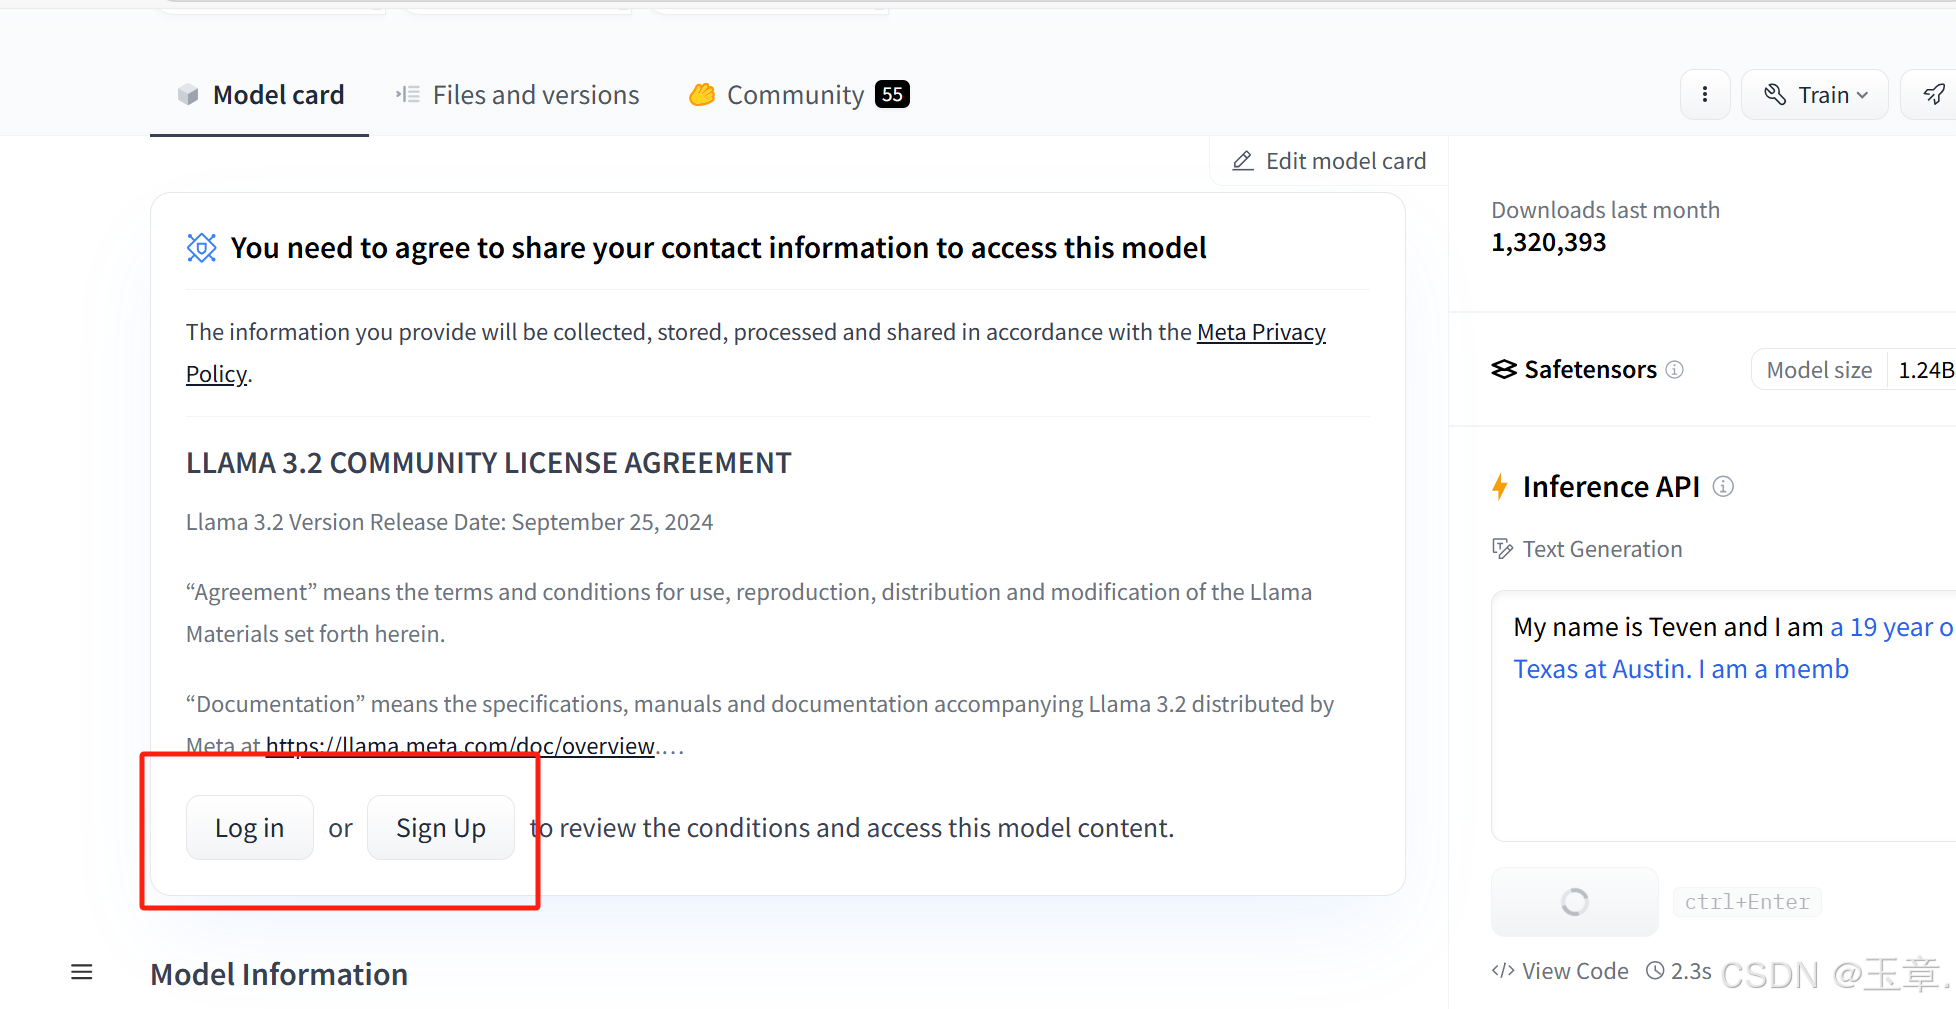
在这里插入图片描述

注册完了以后填信息,注意这里有个坑。这个table填China是批准不了的,可以天别的国家(学校等可以填别的国家的学校),邮箱我用的是个人邮箱。
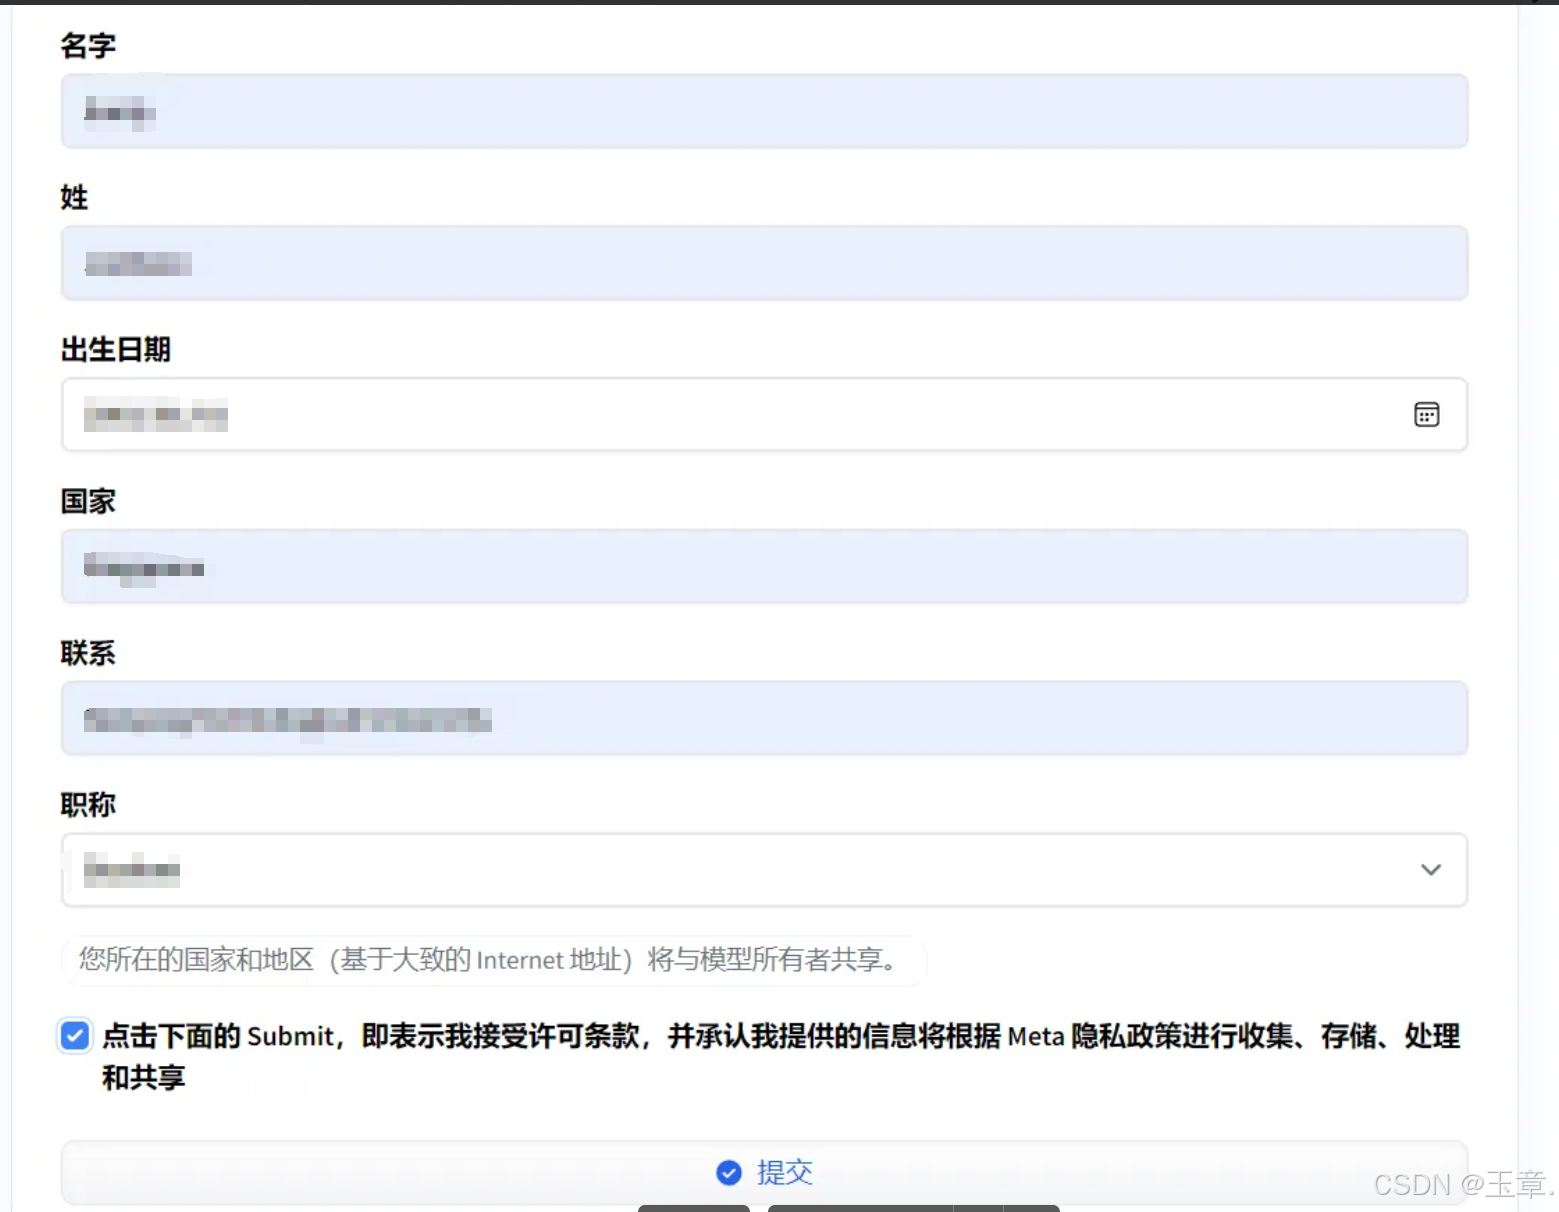
在这里插入图片描述

填完了以后它审批好会发邮件给你(huggingface注册用的邮箱)这个时候你就能下载了。

下载模型

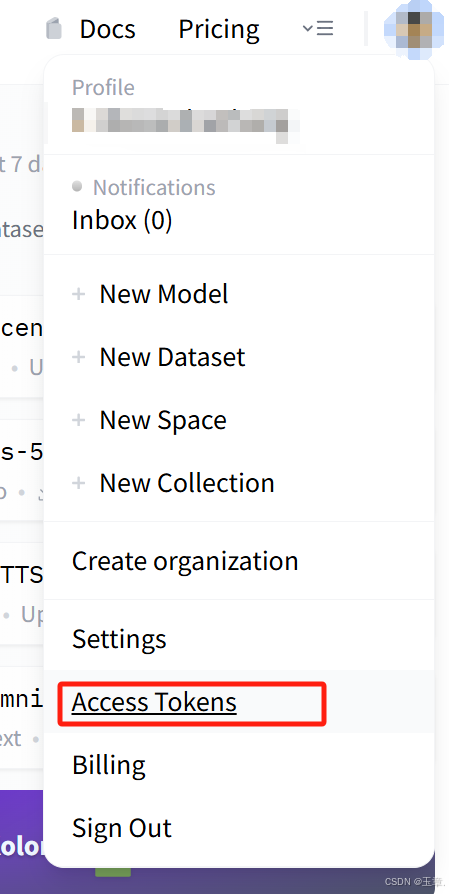
  1. huggingface access token
    在这里插入图片描述
    创建token,token是write类别,然后把api key复制下来

  2. 设置镜像源 (可以将它写入~/.bashrc)

# 这个是设置镜像源的环境变量,建议将上面这一行写入 ~/.bashrc。若没有写入,则每次下载时都需要先输入该命令
export HF_ENDPOINT=https://hf-mirror.com 
  1. linux登录huggingface:
    这里我用的是huggingface-hub==0.23.4
    如果没有install的可以pip install 一下
huggingface-cli login
之后输入你的api key,你就成功登录了
  1. 用命令行进行下载
huggingface-cli download --resume-download meta-llama/Llama-3.2-1B --local-dir meta-llama/Llama-3.2-1B
# local dir代表本地存储的位置

参考链接:
api key的获取
huggingface login 的方式
国内镜像源使用方法
huggingface申请方法借鉴

本地部署Llama-3中文微调全链路:从下载到生产集成 大语言模型本地化部署不是简单下载安装,而是涵盖模型加载、Tokenizer对齐、显存友好微调、环境确定性构建及生产服务封装的系统工程。核心在于解决中文语义适配不足、Git LFS大文件下载失效、CUDA与PyTorch版本隐式绑定、LoRA量化兼容性等底层技术卡点。本文聚焦Meta-Llama-3-8B-Instruct在消费级GPU上的中文能力重建,覆盖魔搭/HF双源下载校验、conda+Python 3.10环境锁死、LLaMA-Factory Web界面7层白屏排查、512长度截断与rank=16的显 阅读详情

相关推荐

Ollama、llama.cpp、LM Studio本质区别与选型指南

大模型本地部署工具常被泛化为‘跑模型的软件’,但其底层定位截然不同:Ollama是面向开发者的模型运行时环境,提供开箱即用的API与抽象化封装;llama.cpp是轻量级推理引擎,专注CPU/GPU极致性能与量化控制;LM Studio则是基于llama.cpp的桌面GUI外壳,主打零配置可视化交互。三者在模型格式支持(如GGUF vs safetensors)、硬件调度粒度(全层GPU加载 vs 自定义ngl)、API兼容性(OpenAI标准程度)上存在根本差异。理解这些原理,才能避免‘装上就崩’的踩坑现

weixin_33904756的博客 586

llama2模型下载

LLaMA 2-CHAT与OpenAI ChatGPT效果一样好。LLaMA 2与LLaMA 1架构相同,LLaMA 2训练数据是2000000000000个tokens,还是用了1000000个人类新标注的数据。上下文长度由2048提升为4096。

artistkeepmonkey的博客 6771

本地AI助手搭建实战:Ollama、llama.cpp与Qwen2.5全栈指南

本地AI助手是指在个人设备上离线运行的大语言模型系统,其核心在于模型本地化部署、推理全程不联网、数据零外泄。技术原理基于GGUF量化格式与硬件加速(Metal/CUDA)协同优化,通过Q4_K_M等轻量级量化实现精度与速度的平衡,显著降低内存占用和响应延迟。该方案具备强隐私保障、低成本可持续、低延迟高可控三大技术价值,广泛适用于代码补全、文档摘要、合同审阅、RAG知识库等办公与开发场景。本文聚焦Windows/macOS/Linux平台下Ollama、llama.cpp及LM Studio三类主流工具链的实

chunchan1381的博客 414

如何在国内下载llama模型

由于项目需求要下载llama模型,本来觉得这是个很简单的事情,直接去huggingface上下载就行,但是没想到遇到了重重问题,于是写下这篇博客记录一下,希望对别人也有帮助!刚开始搜到的教程是官方给出的,先去https://llama.meta.com/llama-downloads/申请一个URL,再下载GitHub的脚本进行下载,但是我实操之后总是在下载过程中返回403forbidden,所以感觉这条路行不通,所以只能试一下通过huggingface能不能下载。

weixin_45783996的博客 1万+

Qwen3.5 GGUF下载与LM Studio加载全指南

GGUF是一种专为本地大模型推理设计的二进制模型格式,其核心在于统一张量存储、内嵌分词器与量化元数据。理解GGUF需从LLAMA.cpp底层解析机制出发,它决定了模型能否被LM Studio等运行时正确识别和加载。技术价值体现在跨平台兼容性、内存映射效率及量化精度可控性,广泛应用于桌面端AI助手、边缘设备部署及Android本地推理(需适配MNN等框架)。而Qwen3.5作为最新一代开源大语言模型,其官方GGUF版本严格遵循Hugging Face发布规范,依赖特定llama.cpp构建版本(v0.2.82

weixin_34130389的博客 402

llama.cpp、Ollama与LM Studio三者定位与协作逻辑解析

本地大模型运行依赖三大核心工具链:llama.cpp作为底层推理引擎,提供对GGUF模型的原子级控制与硬件直通能力;Ollama是标准化服务层,封装为OpenAI兼容API,解决多环境部署与模型生命周期管理;LM Studio则是面向终端用户的GUI沙盒,专注交互式调试而非生产承载。三者并非替代关系,而是分层协作——llama.cpp决定性能上限,Ollama保障工程稳定性,LM Studio提升验证效率。理解其原理差异,可规避‘no lm runtime found for model format gg

子夜轻风 495

Llama2下载流程与报错:download.sh: [[: not found Downloading LICENSE and Acceptable Usage Policy..

Llama2下载方式与报错解决

小孙不够睡的博客 5053

Llama本地部署实战:量化推理与CPU运行原理

大语言模型(LLM)的本地化运行是AI民主化的核心路径,其技术基础在于模型量化、轻量推理引擎与精简架构设计。量化通过分组压缩与异常值保留(如Q4_K_M)在精度与速度间取得平衡;llama.cpp等C++原生推理引擎绕过Python开销与GPU内存搬运,实现CPU/GPU协同加速;而Llama系列采用RMSNorm、RoPE、SwiGLU等可解释性强的设计,显著降低学习与调试门槛。这些技术共同支撑起从笔记本到树莓派的全场景部署能力,使7B级模型真正具备工程可用性。本文聚焦Llama-2-7B在真实硬件上的量

weixin_34268579的博客 484

Meta的LLama模型非官方下载方法

Llama模型是一个用于自然语言处理的大型语言模型,它由Meta AI开发,拥有65亿个参数。该模型的目的是帮助研究者在AI的子领域中推进他们的工作。Llama模型结构巨大,最小的模型LLaMA 7B也经过了超过1万亿个代币的训练。Llama模型的论文比较冗长,但通过阅读页面,可以了解该模型的下载方法和使用指南。除此之外,Llama模型的表现被认为比OpenAI的ChatGPT更优秀,部署教程和泄露版模型已经都被公开。

年少的勇气已经用完,剩下的就是三思而后行 1万+

Hugging Face新标准hf download:模型下载全攻略

在深度学习工程实践中,从Hugging Face下载模型和数据集是高频操作。随着huggingface_hub库升级至1.0,官方命令行工具迎来重大重构,统一的hf命令取代了旧版huggingface-cli,其中`hf download`成为模型下载的标准姿势。该命令不仅简化了参数结构,还默认支持断点续传、文件级过滤(--include/--exclude)以及指定本地目录(--local-dir),大幅提升了下载效率与可管理性。对于国内开发者,配合HF_ENDPOINT镜像环境变量或hf_transfe

weixin_34082854的博客 431

突破Ollama限制:利用llama.cpp转换Qwen3架构模型为GGUF格式的完整指南

本文提供了一份详细指南,教你如何利用llama.cpp工具将Ollama不支持的Qwen3架构模型转换为GGUF格式,从而突破Ollama的模型架构限制。文章涵盖了从环境搭建、模型转换、量化选择到创建Ollama Modelfile的完整流程,并分享了常见问题的解决方案,帮助用户轻松在Ollama中部署各类新模型。

weixin_29057237的博客 695

RTX2060 6G显卡在Ubuntu 22.04上跑通中文羊驼2的完整踩坑记录(附Makefile修改方案)

本文详细记录了在Ubuntu 22.04系统上使用RTX2060 6G显卡部署中文羊驼2模型的全过程,重点解决了CUDA架构不匹配、内核镜像缺失等关键问题,并提供了Makefile修改方案(-arch=compute_75)。文章包含完整的部署流程、常见问题解决方案及性能优化建议,为开发者提供了实用的技术参考。

anshaobiao6449的博客 356

本地大模型部署实战:Ollama、transformers与llama.cpp量化指南

近年来,大模型的本地部署已经从一个实验性玩法,发展为团队和个人必备的工程能力。其核心价值在于数据隐私、离线运行与可控成本,而实现这一目标的关键技术之一便是量化。量化通过将模型权重从高精度浮点映射到低精度整数,显著降低显存占用,使得在普通消费级显卡甚至纯CPU设备上运行7B、14B甚至更大规模模型成为可能。在实际应用中,不同的工具链承担着不同角色:Ollama提供开箱即用的部署与API服务,适合快速搭建私有知识库和内部对话系统;transformers侧重于研究、评测与微调,能够灵活加载原始权重并执行量化与Q

优快云头条 744

Folia 全屏歌词播放器国内安装完整指南:3 条路线 5 分钟跑起来

在国内直连下载 Folia 安装包,最常见的抱怨就是限速和断流。这篇指南把 **Folia 安装** 的三条官方路线拆开讲清楚:Windows / macOS 走网盘镜像,非 Arch 的 Linux 走便携包,Arch Linux 走 AUR 一条命令。每条路线都给出前提、步骤、成功标志和验收方法,照着走,约 5 分钟就能让这台全屏歌词动画播放器出声。 ## 30 秒对号入座:你的系统走哪条路

gitblog_01040的博客 192

vLLM部署Llama系列大模型实战指南

大语言模型推理引擎是支撑私有化AI服务的核心基础设施,其性能直接决定低延迟、高吞吐与显存效率。vLLM凭借PagedAttention内存管理与Continuous Batching动态批处理技术,显著提升KV Cache利用率和请求吞吐能力,已成为Llama、Qwen等Decoder-only架构模型的首选推理框架。相比transformers静态批处理易OOM、llama.cpp CPU推理延迟抖动大等局限,vLLM在A10/A100等主流GPU上实现实测128+ QPS与亚秒级P99延迟,同时原生兼容

anwenzhao0749的博客 479

LLaMA-Factory实战指南:消费级显卡微调Qwen/LLaMA模型全链路

LoRA微调是大模型轻量化适配的核心技术,其本质是在冻结主干参数前提下,通过低秩矩阵注入任务知识,显著降低显存开销与训练门槛。结合QLoRA量化与Flash Attention等优化手段,可在单张RTX 4090(24GB)上稳定完成7B级模型的监督微调、适配器导出与Web UI部署。该技术路径已广泛应用于客服话术优化、商品描述生成等企业级场景,兼顾效果、效率与工程落地性。本文聚焦LLaMA-Factory这一面向生产环境的微调工作台,深入解析其与vLLM推理引擎、Gradio交互界面的协同机制,并覆盖CU

benben 435

零成本本地运行Gemma 4:Ollama/llama.cpp/MLX三方案实操指南

大语言模型本地部署正从‘能跑’迈向‘好用’阶段,核心在于脱离中心化API、实现端侧可控推理。其技术基础是轻量化模型架构(如Gemma系列)与高效推理框架(Ollama、llama.cpp、MLX)的协同演进——前者优化KV缓存与量化兼容性,后者提供跨平台、低依赖的执行能力。这种组合显著降低硬件门槛,使MacBook Air、RTX 3090等主流设备即可承载12B级模型,兼顾响应速度与隐私安全。典型应用场景包括私有知识库问答、离线编程辅助、政务/金融文档摘要等对数据不出域、低延迟、高可控性有强需求的工程实践

weixin_30915275的博客 388

IIS - 会话cookie中缺少HttpOnly属性

不啰嗦,我们直接开始! 先进行常规设置 打开配置编辑器 选中图中节点,将httpOnlyCookies设置为true 然后。。。不起作用。。。 换种方式 通过配置出站规则getcookie添加HttpOnly 在Web.config中添加如下出站规则 <rewrite> <outboundRules> <rule name="Add HttpOnly"> <match serverVa.

。 21万+
上一篇: 一文解决latex附录重新编号问题,解决Algorithm的编码,以及重新编号后引用链接错误问题
下一篇: 超全!Neo4j linux 5.26版本下载安装和使用
玉章.
博客等级 码龄6年 24粉丝 13原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值