论文阅读笔记——representation learning on graphs:methods and application

【论文笔记】Representation Learning on Graphs: Methods and Applications Hamilton W L, Ying R, Leskovec J. Representation learning on graphs: Methods and applications[J]. arXiv preprint arXiv:1709.05584, 2017. 该论文是斯坦福大学的Jure组的博士生出的关于图表示学习的综述,系统的介绍了图表示学习领域目前的发展现状。 目标 图... 阅读详情

Hamilton W L, Ying R, Leskovec J. Representation learning on graphs: Methods and applications[J]. arXiv preprint arXiv:1709.05584, 2017.

1. Introduction

①图表示学习领域的主要挑战:找到一种表示或编码图形结构的方法,方便机器学习利用。从机器学习的角度来看,面临的挑战是没有直接的方法将有关图结构的高维非欧式信息编码为特征向量。

②关于图的机器学习的一个关键问题是:找到一种将图结构信息整合到机器学习模型中的方法。

③图表示学习的思想:将节点或整个(子)图作为点嵌入到低维向量空间中是映射。
目标:优化此映射,使嵌入空间中的几何关系能反映原始图的结构

④传统的图结构信息提取方法:人工选取的图的特征来统计信息(如度或聚类系数)——>缺点:普适性差、耗时。

⑤表示学习方法与以前的工作间的主要区别:它们如何处理表示图结构的问题。此前的工作将图结构表示视为预处理步骤,使用手工设计的统计信息来提取结构信息。而表示学习方法将该问题视为机器学习任务本身,使用数据驱动的方法来学习对图结构进行编码的嵌入。

2.Embedding nodes

2.1方法概述:encoder-decoder perspective

①encoder-decoder framework在这里插入图片描述
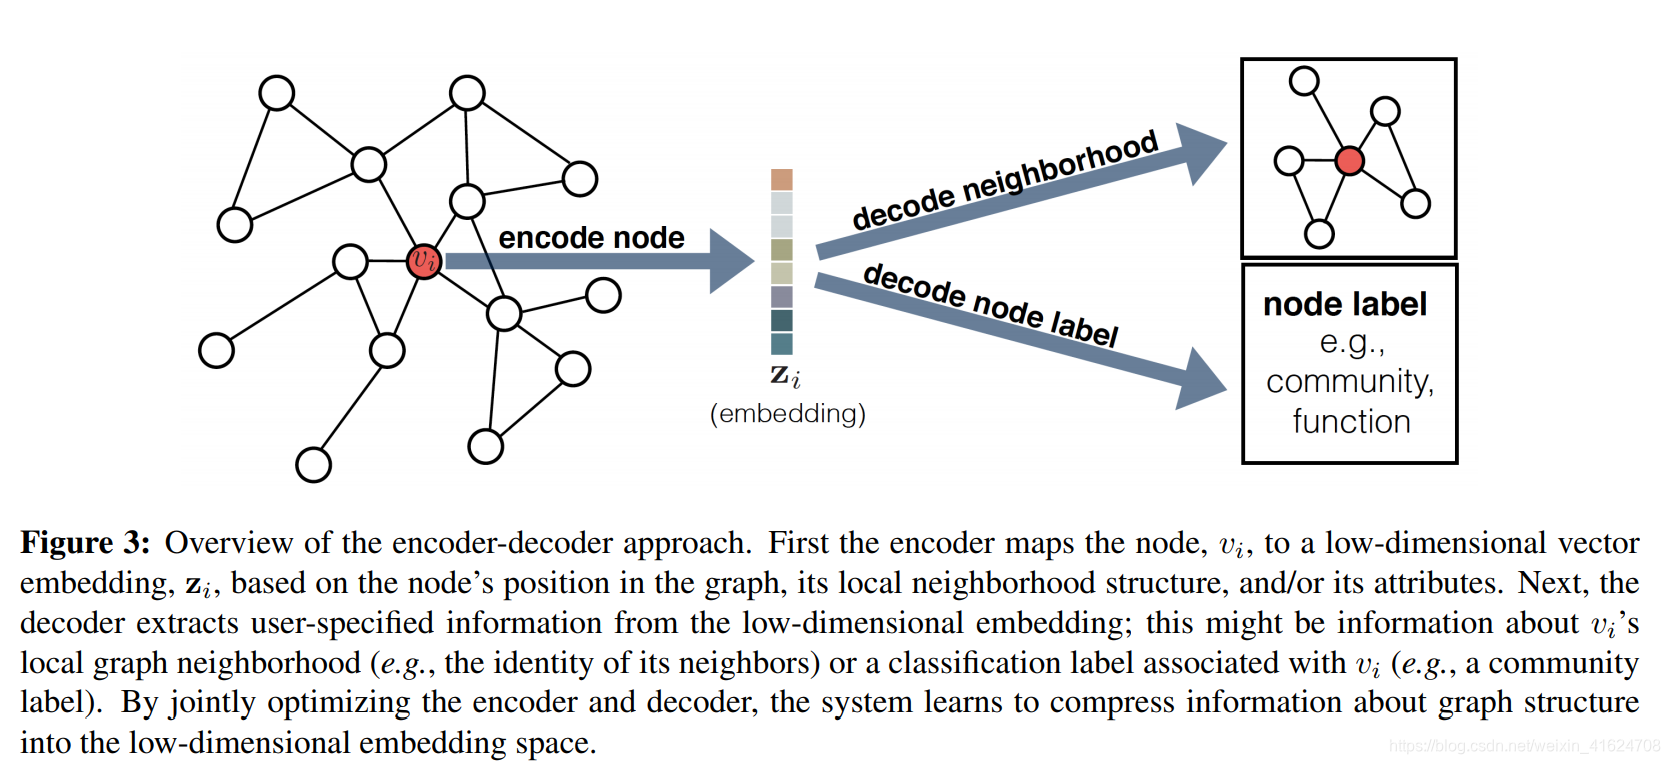
encoder:将每个节点映射为低维向量或嵌入
decoder:将学习到的关于图的嵌入解码为图的结构信息

encoder-decoder架构缺点:
a)encoder中参数不能共享
b)在编码过程中浅层嵌入不能利用节点属性
c)浅层嵌入方法本质上是transductive
“Transductive learning:unlabelled data is the testing datainductive learning:unlabelled data is not the testing data
在训练过程中,已知testing data(unlabelled data)是transductive learing
在训练过程中,并不知道testing data ,训练好模型后去解决未知的testing data 是inductive learing”

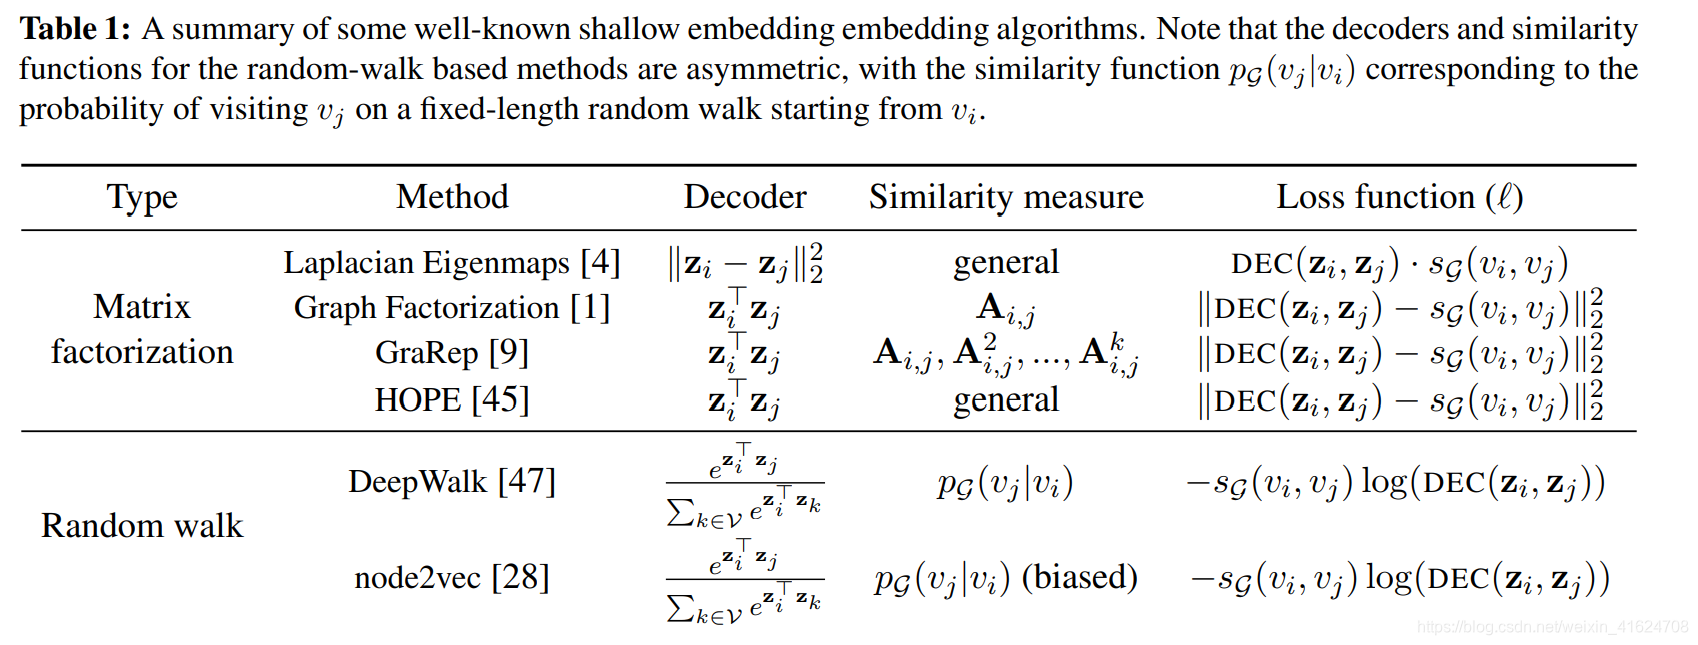
②按照以下四个组成部分,对节点嵌入方法进行分类:
1)A pairwise similarity function
2)An encoder function
3)A decoder function
4)A loss function
在这里插入图片描述

2.2 浅层嵌入方法 Shallow embedding approaches

①Factorization-based approaches:学习每个节点的嵌入。使学习的嵌入向量之间的内积近似于某种确定性的节点相似性度量
1)Laplacian Eigenmaps
2)Inner-product methods

②Random walk approaches
创新点:优化节点嵌入,使得倾向于在较短的随机游走中同时出现的节点具有相似嵌入
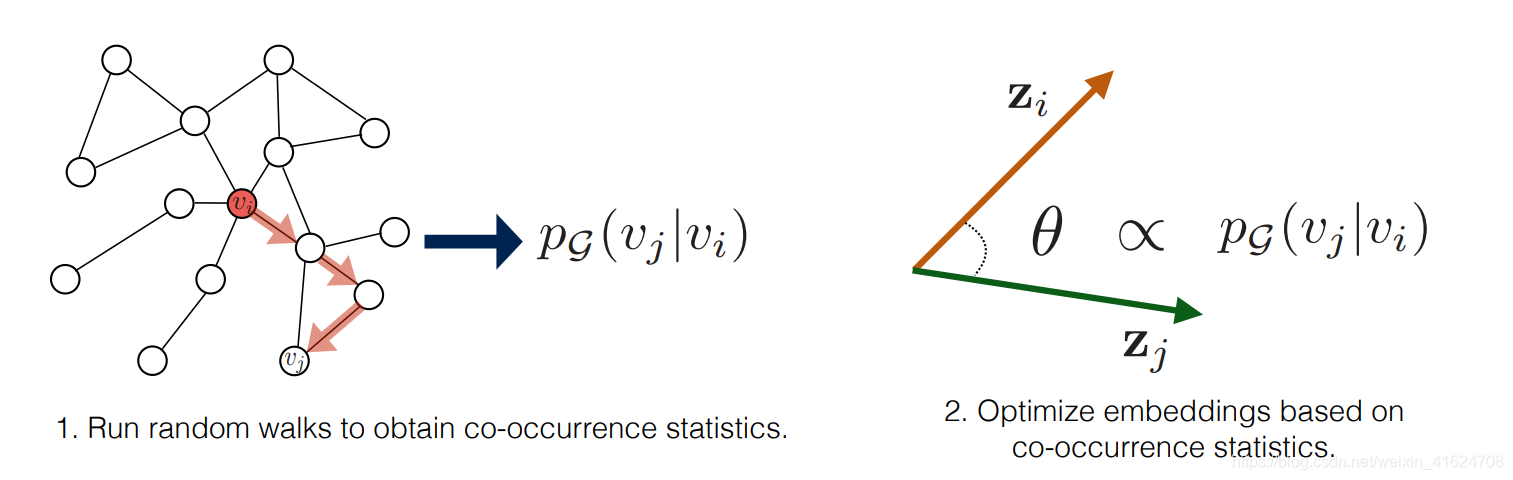
在这里插入图片描述
1)Deepwalk
2) node2vec
注:Deepwalk与node2vec的不同:a)使用了不同的优化和近似值计算公式中的损耗;b)node2vec允许灵活定义随机游走,而DeepWalk在图形上使用简单的无偏随机游走
3)Large-scale information network embeddings(LINE):LINE相较于Deepwalk和 node2vec也使用了概率解码器和损失,但明确的分解了一阶与二阶相似性,而不是将他们组合成固定长度的随机游走
4)HARP:Extending random-walk embeddings via graph pre-processing:引入一种成为HARP的“元策略”,用于通过图形预处理步骤改进各种随机游走方法
5)Additional variants of the random-walk idea

2.3 based on deep learning

与浅层嵌入的区别:基于深度学习的方法使用深度神经网络将图的结构直接合并到编码器算法中,即使用自动编码器压缩有关节点本地邻居的信息,如图
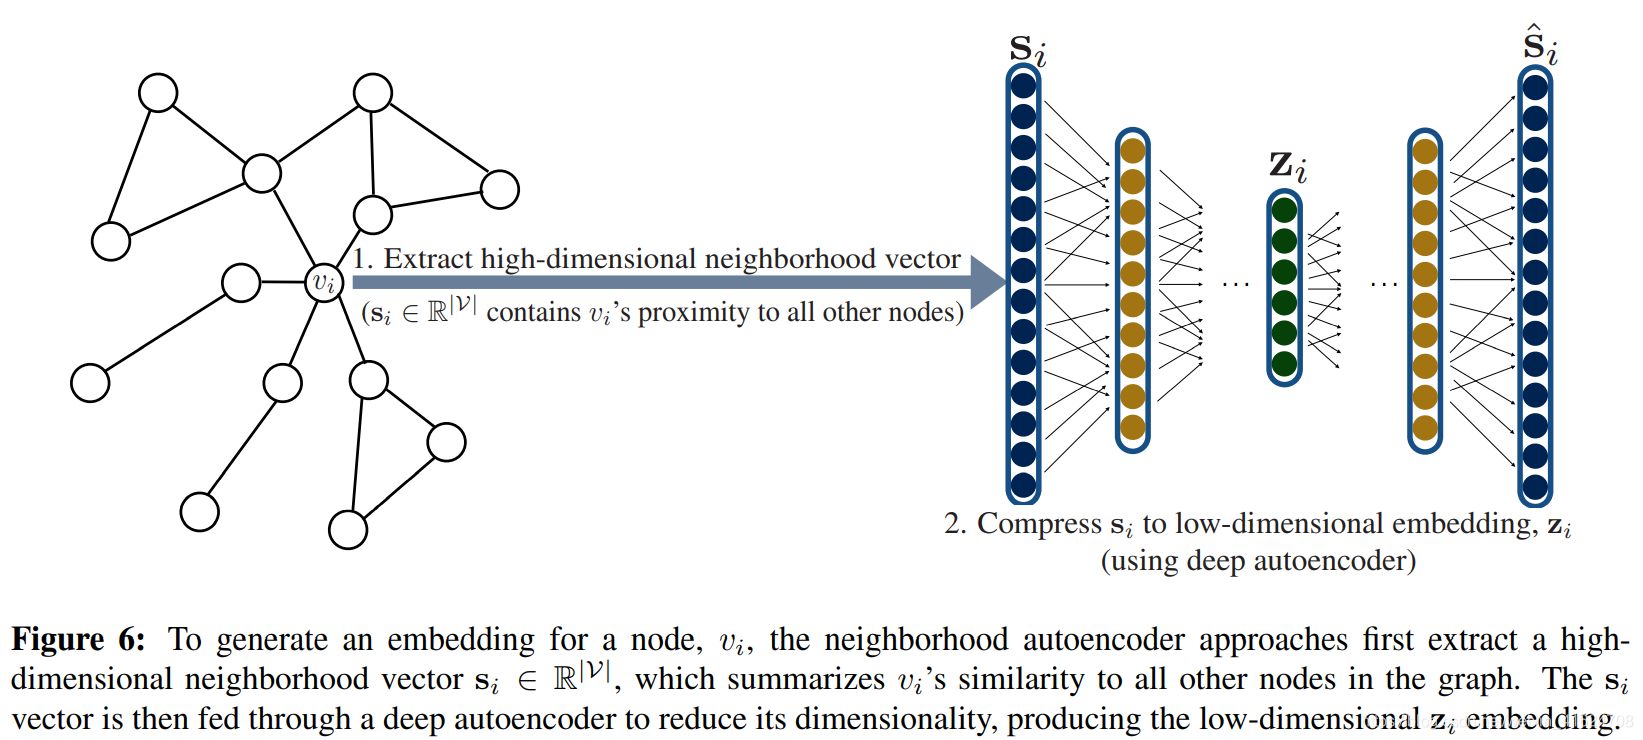
在这里插入图片描述

①neighborhood autoencoder methods
1)Deep Neural Graph Representations(DNGR)
2)Structure Deep Network Embeddings(SDNE)
DNGR和SDNE的编码器和解码器功能均由多个堆叠的神经网络层组成:编码器的每一层都减小了其输入的维度,解码器的每一层都增大了其输入的维度。
autoencoder方法面临的限制:a)自编码器的输入维数固定为|V|,这对于具有数百万各节点的图来说可能是非常昂贵的。b)自编码器的结构和大小是固定的,SDNE和DNGR是tranductive的,无法应对不断变化的图,也无法在图之间进行概况。

②neighborhood aggregation and convolutional encoders
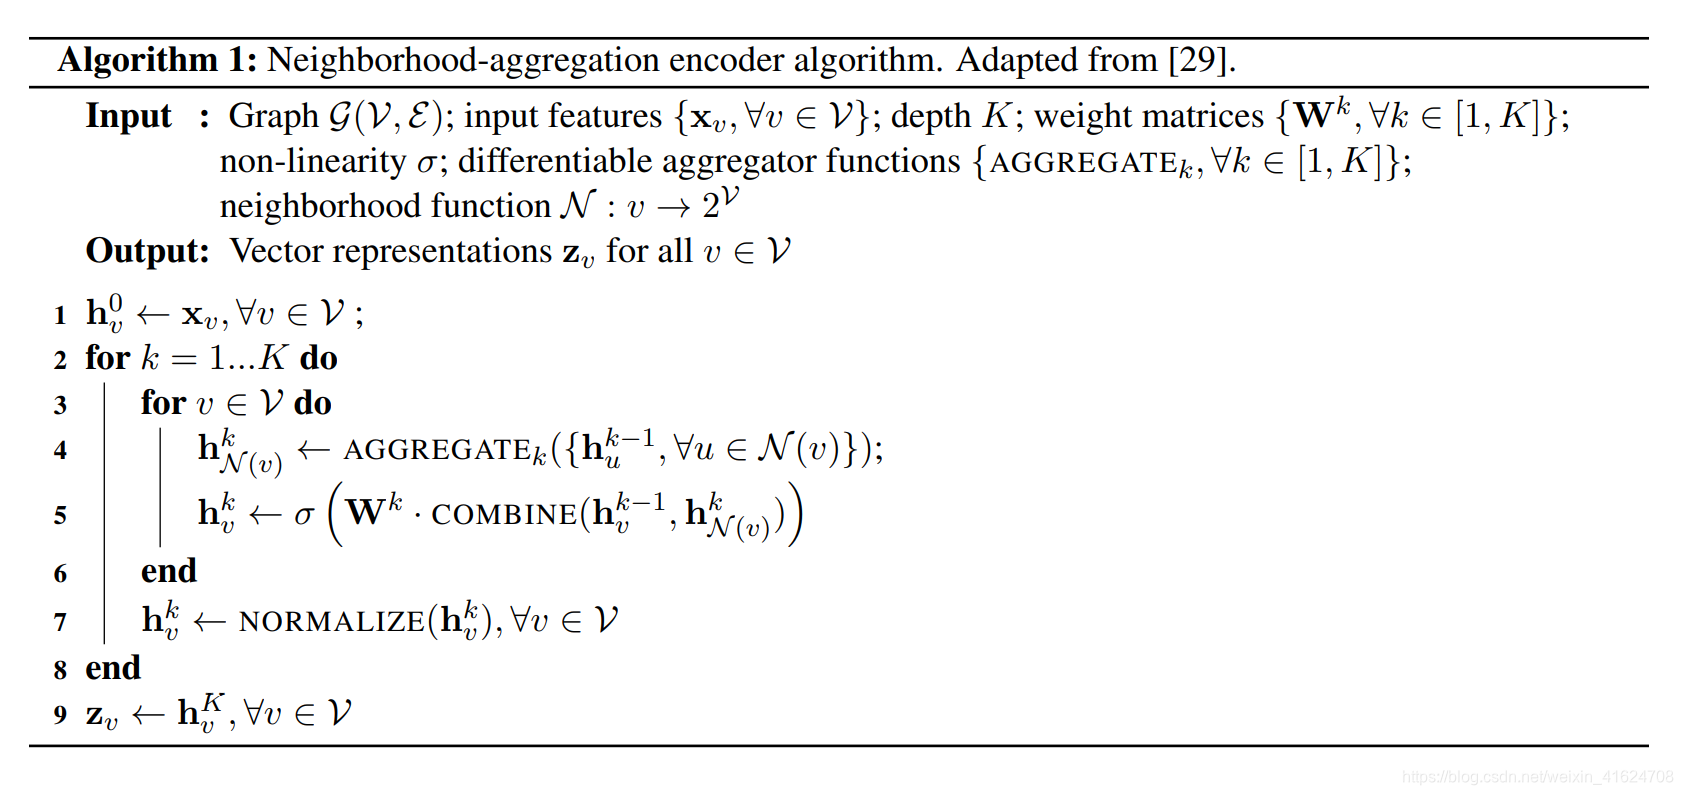
具体思想:通过聚合来自其本领域的信息来生成节点的嵌入,如下图
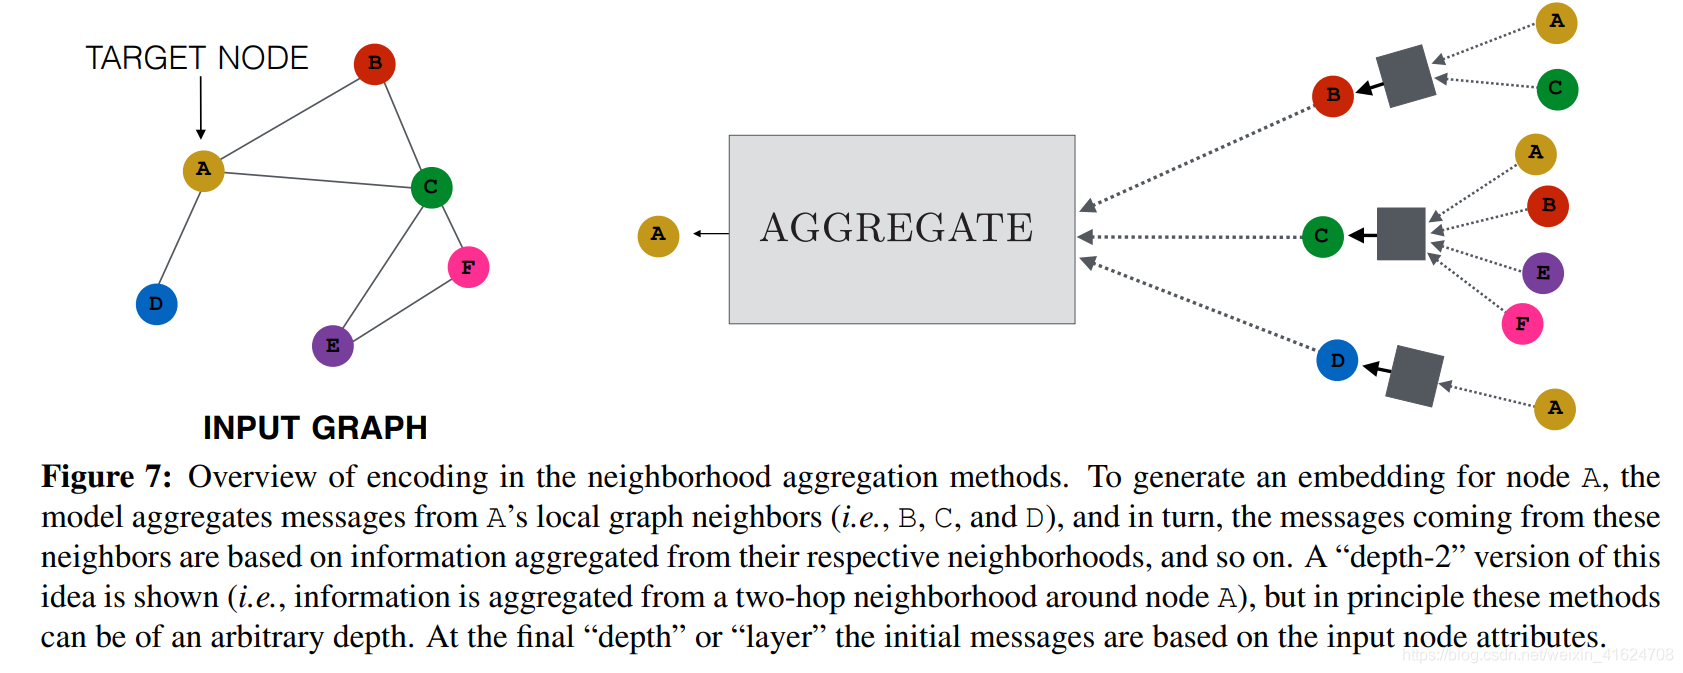
在这里插入图片描述
算法:
在这里插入图片描述

1)graph convolutional networks(GCN)
2)column networks
3)GraphSAGE
三种方法的主要不同之处在于执行汇总和向量组合的方式

2.4 Incorporationg task-specific supervision

2.5 Extensions to multi-modal graphs

①Dealing with different node and edge types
问题:以上的方法专注于无向图,但现实中的图往往具有复杂的多峰或多层结构,如:异构节点和边类型
——>解决方法:1)对不同类型的节点使用不同的解码器
2)使用特定于类型的参数扩展成对解码器
3)从异构图采样随机游走的策略,其中随机游走仅限于特定类型节点之间的过渡

②Typing node embeddings across layers
在某些情况下,图具有多个“层”,其中包含相同节点的副本(如图8 a)
——>可跨层共享信息
——>Ohmnet:将node2vec与一个regularization penalty 结合,regularization penalty将各层之间的嵌入联系在一起
——>有人进一步提出:利用图层之间的层次结构进一步扩展此(如图8 b)
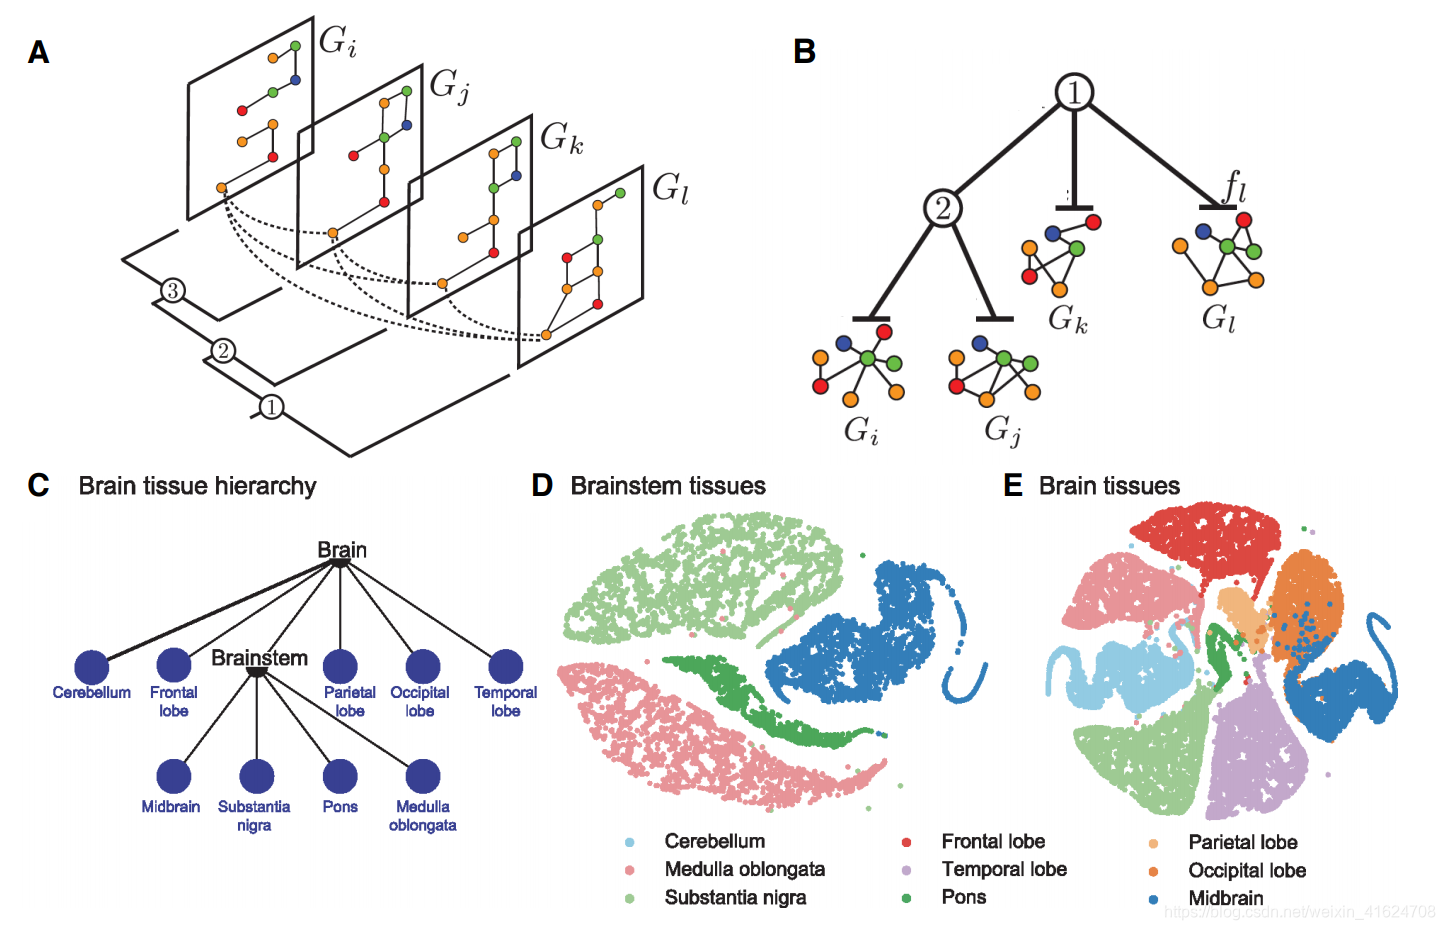
在这里插入图片描述

2.6 Embedding structural roles

①问题:以上的所有方法都是优化节点嵌入,使图中的附近节点具有相似的嵌入。但在许多任务中,更重要的是学习与节点的结构角色相对应的表现形式,而与它们的全局图位置无关。

②解决方法:
1)struc2vec
2)GraphWave

2.7 Applications of node embeddings

① Visualization and pattern discovery
② Clustering and community detection
③ Node classification and semi-supervised learning
④ Link prediction

3.Embedding subgraphs

子图的表示学习任务:将一组节点和边编码为低维向量嵌入。
graph kernels的设计定义了子图之间的距离度量,故其与子图上的表示学习密切相关。

3.1 sets of node embeddings and convolutional approaches

基本思想:将子图等同于节点嵌入集,使用卷积领域聚合思想为节点生成嵌入,然后使用其他模块聚合与子图对应的节点嵌入集。
对于以下的方法之间的主要区别在于:它们如何聚合与子图相对于的节点嵌入集。
①Sum-based approaches
通过将子图中的所有单个节点嵌入求和来表示分子图表示中的子图。
②Graph-coarsening approaches
采用了卷积方法,在图粗化层中,将节点聚合在一起(使用任何图聚类方法),并且聚合的节点嵌入使用逐元素的最大池合并。聚类后,新的较粗图再次通过卷积编码器输入,然后重复该过程。
③Further variations
1)使用“模糊“直方图而不是总和来聚合节点集
2)在节点上定义顺序,并使用此排序,将所有节点的嵌入连接起来,并通过标准的卷积神经网络将此连接的向量馈入。

3.2 Graph neural networks

图形卷积神经网络GNN:将图视为指定节点之间“消息传递”算法的支架,而不是从邻居那里收集信息。

3.3 Applications of subgraph embeddings

子图嵌入的主要用例是子图分类

4.Conclusion and future directions

4.1 Important open problems

①scalability
②Decoding higher-order motifs
③Modeling dynamic,temporal graphs
④Reasoning about large sets of candidates subgraphs
⑤Improving interpretability

Representation Learning on Graphs: Methods and Applications阅读笔记 Representation Learning on Graphs: Methods and Applications 摘要: 1 introduction 1.1 符号和基本假设 2 Embedding nodes 2.1 方法概览:一个编码解码的视角 讨论方法之前先提出一个统一的编码解码框架,我们首先开发了一个统一的编译码框架,它明确地构建了这种方法的多样性,并将各种方法置于相同的标记和概念基... 阅读详情

相关推荐

KDD 2023 | 先睹为快!KDD 2023论文合集50篇(附下载地址)

Area:基于通用语言模型 (GLM) 的网络增强型问答系统。Area:一种用于股票趋势预测增量学习的元学习方法。Area:位置之间的多时态关系推断、图学习。Area:提示学习少样本文本分类。Area:图上的聚类加速表示学习。Area:半监督图不平衡回归。Area:类不平衡节点分类。Area:多模态联邦学习。Area:小样本节点分类。Area:工业推荐系统。Area:外卖推荐系统。Area:会话推荐系统。Area:图对比学习。Area:弱监督学习。Area:图神经网络。Area:假新闻检测。

5426

Representation Learning on Network 网络表示学习

Note: 以下是根据综述 [1][2] 梳理的笔记,由于是初探,语言和理论必然有不严谨之处,欢迎指正。 网络表示学习(Representation Learning on Network),一般说的就是向量化(Embedding)技术,简单来说,就是将网络中的结构(节点、边或者子图),通过一系列过程,变成一个多维向量,通过这样一层转化,能够将复杂的...

weixin_34415923的博客 958

Inductive Representation Learning On Large Graphs【阅读笔记】

GraphSAGE,一种高效的归纳式网络表征学习算法。

宋卫平的博客 1万+

【论文笔记】图的表示学习:方法和应用

Representation Learning on Graphs:Methods and Applications William L. Hamilton、Rex Ying、Jure Leskovec Department of Science Standford University 论文地址:https://arxiv.org/abs/1709.05584v3 目录 文章目录Representation Learning on Graphs:Methods and Applications摘要1.

如是我闻__一时__的博客 1628

图机器学习(8)——经典监督图嵌入算法

监督学习 (Supervised Learning, SL) 代表了大多数实际机器学习 (Machine Learning, ML) 任务的应用场景。得益于日益高效的数据采集,带标签数据集已经非常普遍。对于图数据同样如此,在图数据中,标签可以分配给节点、社群,甚至整个图结构。此时的任务就是学习输入数据与标签(也称为目标或标注)之间的映射函数。本节将探讨监督学习的概念及其在图数据上的应用,我们还将系统介绍经典监督图嵌入方法。

盼小辉丶的博客 9561

图表示学习(Graph representation learning) (part2 and part3).zip

图表示学习,是2018年火爆全球的一个深度学习方向,从以Line, meta-path等为首的节点表示学习,到以GCN,GraphSAGE,为首的图卷积方法,在到近期的以GraphVAE为首的生成图模型,图表示学习方向的文章如过江之鲫。在昨天的AAAI 2019 Tutorial环节,来自Facebook AI Research 的 William Hamilton 和加拿大蒙特利尔算法研究所的Jian Tang 跟大家交流了图表示学习的当前进展。

DBeaver 插件扩展:3 个入口 + 1 条排障思路

查询结果要给业务方,手工粘到 Excel 太慢;公司跑着某个冷门数据库,DBeaver 默认不认;或者 SQL 写了半小时还是跑不通。DBeaver 插件扩展就是干这个的:把连库、增强功能、对接外部工具拆成一个个可装卸的模块。📌 挑对装好,事就成了。 [![DBeaver Community 版启动页,展示连接与数据源模块](https://raw.gitcode.com/GitHub_Tre

gitblog_01137的博客 163

图表示学习-GraphRepresentationLearning

资料包括Representation Learning on Graphs- Methods and Applications 、图表示学习-AAAI 2019 Tutorial和GraphRepresentationLearning-Mila-2020.5

PointWorld: 动作条件的全场景3D点flow 预测(用同一种3D物理空间模态来表示状态和动作)

PointWorld: Scaling 3D World Models for In-The-Wild Robotic Manipulation

u013250861的博客 328

2018-arXiv-Graph Neural Networks A Review of Methods and Applications.pdf

该论文是清华大学2018年的工作,是图神经网络的入门佳物,

知识图谱研究综述论文: 表示学习、知识获取与应用【107篇参考文献】.zip

最近Shaoxiong Ji, Shirui Pan, Erik Cambria, Pekka Marttinen, Philip S. Yu等学者发表了关于知识图谱的最新综述论文《A Survey on Knowledge Graphs: Representation, Acquisition and Applications》,25页pdf涵盖107篇参考文献,对知识图谱进行了全面的综述,涵盖了知识图谱表示学习、知识获取与补全、时序知识图谱、知识感知应用等方面的研究课题,并总结了最近的突破和未来的研究方向。我们提出对这些主题进行全视角分类和新的分类法。是关于知识图谱最近非常重要的参考文献。

从叙事型人工智能到真理约束型智能:人类认知地基、AI 认知镜像与技术风险放大机制研究

本文以“认知地基—技术架构—输出叙事—社会反馈”为框架,提出AI认知镜像假说:AI认知边界由人类认知前提、研究范式、目标函数、数据筛选与评价体系共同塑造,形成人类认知缺陷的规模化复制器与权威化包装器,即“人类危害放大器”。文章严格区分“证伪”与“可证伪性”,提出“方法不能自动升级为宪法”原则,并以USDS-2.0框架整合KLA逻辑审查、LWEVSD真理硬度、KCIT认知免疫与TMM本体分层。文章提出地基测试与认知可靠性乘法模型,主张AI应从认知镜像转向认知纠错器,以逻辑、事实与独立验证为底层约束。

首席技术执行官CTO(Chief Technology Officer)|技术总监--邓斌博客 555

AD(AltiumDesigner)封装导入allegro生成allegro封装

AD(AltiumDesigner)封装导入allegro生成allegro封装 貌似PCB的封装问题是一个无尽话题,为了简单我总是想找捷径(主要还是太懒了),因为也是近期才开始学习使用allegro进行PCB设计,在最近的一个设计中,很多器件封装allegro中都没有,一个一个画感觉很费时间,但是在AD(AltiumDesigner)的封装库中是有的,于是便想着AD的封装库能不能倒入到alleg...

yangh2560的博客 2万+

Representation Learning of Knowledge Graphs with Hierarchical Types

层次类型知识图的表示学习

weixin_44466434的博客 1236

瑞萨芯片串口配置,基于RL78芯片的串口使用配置

在这里隆重给大家介绍瑞萨编辑器CS+ for CA 的自动生成代码功能,只需要配置几个参数,就可以得到你想要的串口配置了,我现在已经忘记怎么手动配置寄存器了,哈哈。选择设置,此时将端口设置成功接下来设置时钟,根据自己的芯片所需设置相应的时钟,自己芯片是什么时钟查看数据手册和原理图可以找到。瑞萨芯片的串口配置其实和ST芯片的串口配置差不多,只是ST芯片的中文数据手册比较多,就更好配置了,找到所需要的串口配置IO口,此时将UART0 配置为引脚P61和P62,瑞萨芯片的串口配置竟然要配置串口。

qq_45315904的博客 4303

【Konva】解决图形加入group后无法获取到绝对坐标,以及group内绘制新图形坐标偏移的问题

解决konva绘图开发时“图形加入group后坐标不会变动,无法获取到绝对坐标”的问题

近10年前端开发工作经验,为你分享日常经验所得 1500

其他图嵌入方法(6)

(3)浅层图嵌入方法只能采用直推式学习,如果它们要学习一个节点的嵌入, 则这个节点必须是在训练过程中出现的,对于未出现过的节点则无能为力。相比之下,图神经网络(如图卷积网络)的参数是用来将节点本身的属性向量映射到一个更低维的向量,与节点的数量无关,只与节点属性向量的维度。(1)浅层图嵌入方法是对图中出现的所有节点直接习得最终的表示,它们的编码器是将每个节点线性映射到最终的嵌入向量f(x)=Zx, 因此参数。(2)浅层图嵌入方法通常只考虑图的结构,而忽略了节点本身的属性。实际上使得图的嵌入尽量光滑。

m0_63860007的博客 1330

手把手教你用STM32F103的IO口模拟XY2-100协议驱动数字振镜(附Keil O3优化代码)

本文详细介绍了如何使用STM32F103的IO口模拟XY2-100协议驱动数字振镜,包括协议解析、偶校验算法、寄存器级优化及Keil O3编译下的性能调优。通过硬件配置、核心代码实现和优化技巧,帮助开发者实现高速二维偏转控制,适用于工业激光雕刻和精密定位系统。

weixin_42527401的博客 261

【论文分享-影响力最大化IM:DeepIM】Deep Graph Representation Learning and Optimization for Influence Maximization

基于学习的IM方案根据不同的应用场景设计了不同的目标函数,并且对于所有与节点中心性相关的约束都没有一个定义良好的方案。挑战一:大多数现有的基于学习的IM框架通过计算潜在节点嵌入来选择高影响力的节点。需要先随机选择N组种子节点集合,每组种子记为x(大小不等),使用IC、LT或SIS等传播模型计算出相应的影响扩散y,得到相应的(x,y)对。挑战三:此外,为了减轻P - hard影响估计的计算开销,基于学习的IM方法依赖于传统方法的技术,例如基于代理和基于采样的估计方式,这使得可扩展性和泛化性更差。

weixin_46234454的博客 2680

ROS2前置基础教程 | 使用CMakeLists.txt编译ROS2节点

答案是有的,那就是cmake工具。cmake通过调用CMakeLists.txt直接生成Makefile。 2.新建CMakeLists.txt 在新建,输入下面内容。 3.编译代码 我们一般会创建一个新的目录,运行cmake并进行编译,这样的好处是不会显得那么乱。 创建好文件夹,接着运行cmake指令,代表到上级目录找。 运行完cmake你应该可以在build目录下看到cmake自动生成的Makefile了,接着就可以运行make指令进行编译 运行完上面的指令,就可以在build目录下发现节点了。ROS2

生活不止眼前的苟且 1万+

爬取二手房数据:Python爬虫+Geopy实战,看透房价与地理位置的隐藏关系

哪些区域单价虚高(房源少但单价远高于周边);哪些小区性价比高(靠近地铁/学校,单价低于同地段平均水平);房价与地理位置的量化关系(如距离地铁每远1公里,单价下降多少)。如果想扩展分析范围,可爬取多个城市/区域的数据,对比不同城市的房价差异;或结合时间维度(定期爬取),分析房价的涨跌趋势。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 949

网络表示初学习--节点嵌入 node embedding

Node Embedding四步骤 根据在原空间中想求的相似关系,定义相似函数,但是有一个问题,如果我们已经知道在原空间中的相似关系,为什么还要映射到欧氏空间中? 答:为了更适应深度学习等的处理方法,且原数据多为结构化数据,且维数过多。 相似函数是最重要的!一般根据任务来选择设计。 编码方式有两种:浅层(node2vec,DeepWalk,LINE…其实就是一个查询表,无法得到全局最优的结果)和深层。 浅层嵌入方式(node2vec,DeepWalk,LINE,struc2vec)的区别是原始网络的相似

qq_35780315的博客 4700

LangGraph实战:用Plan-and-Execute模式5步搭建智能问答机器人(附Tavily搜索集成)

本文详细介绍了如何利用LangGraph的Plan-and-Execute模式,通过规划、执行、动态调整三个核心阶段,构建一个能够处理复杂多步骤问题的智能问答机器人。文章提供了从环境配置、状态管理到核心节点(规划、执行、重新规划)实现的完整实战指南,并集成了Tavily搜索工具,展示了如何将智能任务规划应用于实际信息查询场景。

weixin_29258297的博客 342

NRL: network representation learning & NE: network embedding. 相关论文总结

Must-read papers on NRL/NE.NRL: network representation learning. NE: network embedding. DeepWalk: Online Learning of Social Representations. Bryan Perozzi, Rami Al-Rfou, Steven Skiena. KDD 2014. paper

BVL的博客 4205

【Mode】微带传输线阻抗

微带线,英文名称为 (Microstrip) 是一种常见的平面传输线,主要用于传输微波频率信号(通常在射频和微波电路重中使用)。

u011699626的博客 244

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

推荐系统初学者系列(8)-- Graph Embedding(网络嵌入表示)做Top-K推荐

上一篇:Surprise库做Top-K推荐

私人天地 1万+

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

上一篇: 论文阅读笔记——Graph Embedding Techniques,Applications, and Performance:A survey
BoomSnowing
博客等级 码龄9年 2粉丝 8原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值