Kafka之数据存储

【大数据学习 | kafka】kafka的数据存储结构 也就是说,写到磁盘的数据是按照1G分为一个整体部分的,但是这个整体部分需要4KB写一次,并且一次会生成一个索引问题信息,在检索的时候可以通过稀疏索引进行数据的检索,效率更快。那么查询数据还是需要在1G大小的内容中找寻是比较麻烦的,这个时候可以从index索引出发去检索,首先我们可以通过kafka提供的工具类去查看log和index中的内容。所以首先检索数据的时候就可以跳过1G为大小的块,比如检索888这条数据的,就可以直接去00000000000000000000.log中查询数据。一个数据段大小是1G。 阅读详情


Zebul博 2018-05-03 15:09:00  2958  已收藏 1

本文主要讲述以下两部分内容:

  • kafka数据的存储方式;
  • kafka如何通过offset查找message。

1.前言

写介绍kafka的几个重要概念(可以参考之前的博文Kafka的简单介绍):

  • Broker:消息中间件处理结点,一个Kafka节点就是一个broker,多个broker可以组成一个Kafka集群;
  • Topic:一类消息,例如page view日志、click日志等都可以以topic的形式存在,Kafka集群能够同时负责多个topic的分发;
  • Partition:topic物理上的分组,一个topic可以分为多个partition,每个partition是一个有序的队;
  • Segment:每个partition又由多个segment file组成;
  • offset:每个partition都由一系列有序的、不可变的消息组成,这些消息被连续的追加到partition中。partition中的每个消息都有一个连续的序列号叫做offset,用于partition唯一标识一条消息;
  • message:这个算是kafka文件中最小的存储单位,即是 a commit log。

kafka的message是以topic为基本单位,不同topic之间是相互独立的。每个topic又可分为几个不同的partition,每个partition存储一部的分message。topic与partition的关系如下:


topic.pnguploading.4e448015.gif转存失败重新上传取消topictopic

其中,partition是以文件夹的形式存储在具体Broker本机上。

2.partition中的数据文件

有了上面的介绍,下面我们开始介绍Topic中partition的数据文件类型。

2.1.segment中的文件

对于一个partition(在Broker中以文件夹的形式存在),里面又有很多大小相等的segment数据文件(这个文件的具体大小可以在config/server.properties中进行设置),这种特性可以方便old segment file的快速删除。

下面先介绍一下partition中的segment file的组成:

  • segment file 组成:由2部分组成,分别为index file和data file,这两个文件是一一对应的,后缀”.index”和”.log”分别表示索引文件和数据文件;
  • segment file 命名规则:partition的第一个segment从0开始,后续每个segment文件名为上一个segment文件最后一条消息的offset,ofsset的数值最大为64位(long类型),20位数字字符长度,没有数字用0填充。如下图所示:

segment.pnguploading.4e448015.gif转存失败重新上传取消segmentsegment

关于segment file中index与data file对应关系图,这里我们选用网上的一个图片,如下所示:

index.pnguploading.4e448015.gif转存失败重新上传取消indexindex

segment的索引文件中存储着大量的元数据,数据文件中存储着大量消息,索引文件中的元数据指向对应数据文件中的message的物理偏移地址。以索引文件中的3,497为例,在数据文件中表示第3个message(在全局partition表示第368772个message),以及该消息的物理偏移地址为497。

注:Partition中的每条message由offset来表示它在这个partition中的偏移量,这个offset并不是该Message在partition中实际存储位置,而是逻辑上的一个值(如上面的3),但它却唯一确定了partition中的一条Message(可以认为offset是partition中Message的id)。

2.2.message文件

message中的物理结构为:

message.pnguploading.4e448015.gif转存失败重新上传取消messagemessage

参数说明:

关键字解释说明
8 byte offset在parition(分区)内的每条消息都有一个有序的id号,这个id号被称为偏移(offset),它可以唯一确定每条消息在parition(分区)内的位置。即offset表示partiion的第多少message
4 byte message sizemessage大小
4 byte CRC32用crc32校验message
1 byte “magic”表示本次发布Kafka服务程序协议版本号
1 byte “attributes”表示为独立版本、或标识压缩类型、或编码类型
4 byte key length表示key的长度,当key为-1时,K byte key字段不填
K byte key可选
value bytes payload表示实际消息数据

2.3.数据文件的内部实现方法

Partition数据文件包含了若干上述格式的message,按照offset由小到大排列在一起,它实现的类是FileMessageSet,类图如下:

filemessageset.pnguploading.4e448015.gif转存失败重新上传取消filemessagesetfilemessageset

它的主要方法如下:

  • append: 把给定的ByteBufferMessageSet中的Message写入到这个数据文件中。
  • searchFor: 从指定的startingPosition开始搜索,找到第一个Message判断其offset是大于或者等于指定的offset,并返回其在文件中的位置Position。它的实现方式是从startingPosition开始读取12个字节,分别是当前MessageSet的offset和size。如果当前offset小于指定的offset,那么将position向后移动LogOverHead+MessageSize(其中LogOverHead为offset+messagesize,为12个字节)。
  • read:准确名字应该是slice,它截取其中一部分返回一个新的FileMessageSet。它不保证截取的位置数据的完整性。
  • sizeInBytes: 表示这个FileMessageSet占有了多少字节的空间。
  • truncateTo: 把这个文件截断,这个方法不保证截断位置的Message的完整性。
  • readInto: 从指定的相对位置开始把文件的内容读取到对应的ByteBuffer中。

3.查找

3.1.遇到的问题

我们首先试想一下,如果对于Kafka的一个topic而言,如果topic的partition中只有一个数据文件的话会怎么样?

  • 新数据是添加在文件末尾(调用FileMessageSet的append方法),不论文件数据文件有多大,这个操作永远都是O(1)的。
  • 查找某个offset的Message(调用FileMessageSet的searchFor方法)是顺序查找的。因此,如果数据文件很大的话,查找的效率就低。

3.2.如何去解决这个问题

由上述我们知道,如果在topic的partition中只有一个数据文件的话,Kafka插入的效率虽然很高,但是查找的效率非常低,那么Kafka在内部是如何解决查找效率的的问题呢?对于这个问题,Kafka有两大法宝:分段和索引。

数据文件的分段

这个是比较好理解的,加入有100条message,它们的offset是从0到99,假设将数据文件分为5端,第一段为0-19,第二段为20-39,依次类推,每段放在一个单独的数据文件里面,数据文件以该段中最小的offset命名。这样在查找指定offset的Message的时候,用二分查找就可以定位到该Message在哪个段中。

为数据文件建索引

数据文件分段使得可以在一个较小的数据文件中查找对应offset的message了,但是这依然需要顺序扫描才能找到对应offset的message。为了进一步提高查找的效率,Kafka为每个分段后的数据文件建立了索引文件,文件名与数据文件的名字是一样的,只是文件扩展名为.index。

索引文件中包含若干个索引条目,每个条目表示数据文件中一条message的索引。索引包含两个部分(均为4个字节的数字),分别为相对offset和position。

  • 相对offset:因为数据文件分段以后,每个数据文件的起始offset不为0,相对offset表示这条message相对于其所属数据文件中最小的offset的大小。举例,分段后的一个数据文件的offset是从20开始,那么offset为25的message在index文件中的相对offset就是25-20 = 5。存储相对offset可以减小索引文件占用的空间。
  • position:表示该条message在数据文件中的绝对位置。只要打开文件并移动文件指针到这个position就可以读取对应的message了。

在kafka中,索引文件的实现类为OffsetIndex,它的类图如下:
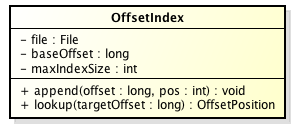
offsetindex.pnguploading.4e448015.gif转存失败重新上传取消offsetindexoffsetindex

主要的方法有:

  • append方法:添加一对offset和position到index文件中,这里的offset将会被转成相对的offset。
  • lookup:用二分查找的方式去查找小于或等于给定offset的最大的那个offset

3.3.通过offset查找message

假如我们想要读取offset=368776的message(见前面的第三个图),需要通过下面2个步骤查找。

  1. 查找segment file
    00000000000000000000.index表示最开始的文件,起始偏移量(offset)为0.第二个文件00000000000000368769.index的消息量起始偏移量为368770 = 368769 + 1.同样,第三个文件00000000000000737337.index的起始偏移量为737338=737337 + 1,其他后续文件依次类推,以起始偏移量命名并排序这些文件,只要根据offset 二分查找文件列表,就可以快速定位到具体文件。
    当offset=368776时定位到00000000000000368769.index|log
  2. 通过segment file查找message
    通过第一步定位到segment file,当offset=368776时,依次定位到00000000000000368769.index的元数据物理位置和00000000000000368769.log的物理偏移地址,然后再通过00000000000000368769.log顺序查找直到offset=368776为止。

segment index file并没有为数据文件中的每条message建立索引,而是采取稀疏索引存储方式,每隔一定字节的数据建立一条索引,它减少了索引文件大小,通过map可以直接内存操作,稀疏索引为数据文件的每个对应message设置一个元数据指针,它比稠密索引节省了更多的存储空间,但查找起来需要消耗更多的时间。

总结:

Kafka高效文件存储设计特点:

  • Kafka把topic中一个parition大文件分成多个小文件段,通过多个小文件段,就容易定期清除或删除已经消费完文件,减少磁盘占用。
  • 通过索引信息可以快速定位message和确定response的最大大小。
  • 通过index元数据全部映射到memory,可以避免segment file的IO磁盘操作。
  • 通过索引文件稀疏存储,可以大幅降低index文件元数据占用空间大小。
Kafka的数据存储 kafka数据存储详细说明 阅读详情

相关推荐

【kafka】简介Kafka之数据存储

文章目录1.视界概念2. partition中的数据文件2.1.segment中的文件2.2.message文件2.3.数据文件的内部实现方法3.查找3.1.遇到的问题3.2.如何去解决这个问题3.2.1 数据文件的分段3.2.2 为数据文件建索引3.3.通过offset查找message 1.视界 概念 写介绍kafka的几个重要概念(可以参考之前的博文Kafka的简单介绍): Broker:消息中间件处理结点,一个Kafka节点就是一个broker,多个broker可以组成一个Kafka集群; To

九师兄 440

【Kafka】Kafka 数据存储

Kafka 中的消息是存储在磁盘上的,一个分区副本对应一个 日志(Log)。为了防止 Log 过大,Kafka 又引入了 日志分段(LogSegment)的概念,将 Log 切分为多个 LogSegment ,相当于一个巨型文件被平均分配为多个相对较小的文件,这样也便于消息的维护和清理。事实上,Log 和 LogSegment 也不是纯粹物理意义上的概念,Log 在物理上只以文件夹的形式存储,而每个 LogSegment 对应于磁盘上的一个日志文件和两个索引文件,以及可能的其他文件。

Data · Model · Agent · Repeat 2117

人工势场法在自动驾驶避障中的实践与优化

本文深入探讨了人工势场法在自动驾驶避障中的核心原理与实践优化。通过解析引力与斥力模型,揭示了经典算法在局部最优和目标不可达等问题上的局限性,并重点介绍了改进斥力场函数、引入道路边界斥力及动态参数调整等关键优化策略,有效提升了该局部路径规划算法在复杂动态场景下的实用性与鲁棒性。

weixin_29208327的博客 927

kafka-大数据存储的基础理解

Kafka 是一个分布式的基于发布/订阅模式的消息队列(Message Queue),主要应用于大数据实时处理领域。Kafka是由Apache软件基金会开发的一个开源流处理平台,由Scala和Java编写。Kafka是一种高吞吐量的分布式发布订阅消息系统,它可以处理消费者在网站中的所有动作流数据。

北城青的博客 780

Metal 一、初识 Metal 及其语言规范

游戏开发者的新的技术平台,该技术能够为3D图像提高 10 倍的渲染性能。苹果2018年推出 Metal,在此之前一直使用OpenGL ES。1图形渲染;2高并发计算。苹果文档给出的 Metal 优化:CPU 低消耗、GPU 高利用、连续处理器并行、有效的资源利用Metal 官方文档。

irainsa的博客 1219

AI办公Agent技术:文档与表格智能处理实践

办公自动化技术正从规则驱动转向语义理解,大语言模型(LLM)为办公Agent赋予了智能决策能力。这类系统通过五层架构整合自然语言处理、工具API调用和任务规划引擎,能自动完成文档分类、表格分析等高重复性工作。关键技术包括基于TF-IDF和BERT的特征提取、Excel公式自动生成等,在财务报告、法律审查等场景可实现90%以上的效率提升。随着多模态能力和领域专业化发展,办公Agent正在重塑企业文档处理流程,成为数字化转型的核心基础设施。

weixin_30263277的博客 519

kafka的数据存储

解决单台服务器内存有限的情况,将数据分成多个partition存放在多个服务器上,每个服务器上的数据叫做一个分片kafka中的消息以topic进行分类,生产者和消费者都是面向topic的。topic是逻辑上的概念,partition是物理上的概念,每个partition对应一个log文件,log文件中存储的是producer生产的数据,producer生产的数据不断地追加到log文件的末尾,每条数据有自己的offset。消费者会记录消费到了哪个offset副本机制解决了数据存储的高可用的问题。

jx的博客 441

UniApp实战:从文件下载到本地保存与预览的一站式解决方案

本文深入解析了UniApp开发中文件下载、保存与预览的完整流程,提供了基于uni.downloadFile、uni.saveFile和uni.openDocument API的一站式实战解决方案。文章详细拆解了核心API的使用方法、多平台(App、H5)的兼容性处理、常见坑点(如文件路径、权限、格式支持)以及进阶优化技巧(如进度提示、文件管理),旨在帮助开发者构建健壮、用户体验良好的跨平台文件处理功能。

d3e4f的博客 614

KafKa存储机制

Kafka 是为了解决大数据的实时日志流而生的, 每天要处理的日志量级在千亿规模。1. 数据实时产生2. 海量数据存储与处理所以它必然要面临分布式系统遇到的高并发、高可用、高性能等三高问题。对于 Kafka 的存储需要保证以下几点:1. 存储的主要是消息流(可以是简单的文本格式也可以是其他格式,对于 Broker 存储来说,它并不关心数据本身)2. 要支持海量数据的高效存储、高持久化(保证重启后数据不丢失)3. 要支持海量数据的高效检索(消费的时候可以通过offset或者时间戳高效查询并处理)

jianfeng123123的博客 4521

15、SQL Server查询优化与CPU负载管理

本文深入探讨了SQL Server查询优化与CPU负载管理的关键技术,包括强制连接类型的使用、键查找问题的解决、索引设计的最佳实践、高CPU负载的排查与优化,以及并行性的利弊与调整策略。通过优化查询逻辑、合理设计索引、监控与管理CPU资源,可以显著提升SQL Server的性能和稳定性。适用于数据库开发人员和DBA进行性能调优参考。

pz8901234的博客 77

【C语言笔记初级篇】第一章:C语言快速入门及注意事项

(1)第一个C语言程序 A:利用vs2010写C语言程序 1:按以下步骤新建工程 2:添加源文件,“.c”文件 B:第一个C语言代码 1:以下是基本的C语言程序 2:由于没有设置连接器,所以打印结果没有显示,按照如下步骤链接控制台 (2)数据类型 A:基本数据类型及占用字节 B:一些概念的梳理 概念一:关于计算机的单位 位(bit):计算机通过电路的开关和闭合处理信息,电路通...

快乐江湖的博客 3737

Kafka数据存储结构

Kafka 的数据分为两部分:元数据、消息数据。 元数据:元数据包括集群信息、节点信息、队列信息、主从信息、分区信息、分区分布信息等,这类信息都存储在 Zookeeper 上,Kafka 的任何一个节点都可以读取元数据信息。 消息数据:生产者向集群发送的消息。生产者直接向分区的 Leader 发送消息,Leader 会同步至 Flowers 节点,分区的 Leader 及 Flowers 节点都存储了一份消息数据。 元数据结构clustercontrollercontroller_epochbroke

死牛胖子的技术随笔 3687

SpringBoot集成auth0-jwt插件,实现jwt的token生成、校验,用户登录验证,配置拦截器拦截请求校验token功能

该文章介绍了SpringBoot如何集成auth0-jwt插件,实现jwt的token生成、校验,用户登录验证,配置拦截器拦截请求校验token功能. JWT(JSON Web Token)是一种开放标准(RFC 7519),用于在各方之间安全地传输信息。它以JSON对象的形式存在,并使用数字签名来验证信息的完整性和真实性。JWT由三部分组成,分别是Header、Payload和Signature。

yunnuo的博客 1246

Kafka:数据存储、删除,查询

kafka数据删除存储查询

Joseph25的博客 1406

通过Simulink搭建一个智能微电网能量管理系统(Energy Management System, EMS)

通过上述代码实现,您可以逐步创建一个智能微电网能量管理系统。多源能量集成:整合光伏、风力发电、柴油发电机、电池储能等多种能源资源。负荷预测与调度:基于历史数据和天气预报,预测未来负荷和可再生能源输出,进行优化调度。储能系统优化:设计合理的充放电策略,确保储能系统的高效利用和寿命延长。经济性分析:评估不同运行模式下的经济性,考虑电价、维护成本等因素。环境影响评估:分析微电网对环境的影响,如减少碳排放、提高可再生能源利用率等。硬件在环仿真(HILS)

amy_mhd的博客 314

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

kafka能不能作为数据存储,你不知道的秘密!

Kafka你不知道的秘密!   人们总是问是否可以把 Kafka 作为长期的数据存储来使用,很显然,如果把数据保留策略设置为“永久”或者启用主题的日志压缩功能,那么数据就可以被永久保存下来。但我觉得人们其实真正想知道的是,这样做是不是很疯狂。 简而言之,这样做不算疯狂。实际上,人们一直都在这么做,而且 Kafka 的设计意图之一就是要将它作为数据存储系统。不过问题是,为什么我们要把 Kafk...

tp15868352616的博客 1万+

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

Kafka数据存储概述

Kafka这款分布式消息队列使用文件系统和操作系统的页缓存(page cache)分别存储和缓存消息,摒弃了Java的堆缓存机制,同时将随机写操作改为顺序写,再结合Zero-Copy的特性极大地改善了IO性能。而提起磁盘的文件系统,相信很多对硬盘存储了解的同学都知道:“一块SATA RAID-5阵列磁盘的线性写速度可以达到几百M/s,而随机写的速度只能是100多KB/s,线性写的速度是随机写的上千倍”,由此可以看出对磁盘写消息的速度快慢关键还是取决于我们的使用方法。鉴于此,Kafka的数据存储设计是建立在对

weixin_57763462的博客 1532

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

Kafka面试小结八:kafka数据存储在内存还是磁盘

然后,Kafka使用一定的时间间隔将缓存中的消息批量写入磁盘。缓存的大小可以通过Kafka配置中的`log.flush.interval.messages`和`log.flush.interval.ms`参数来配置。当缓存中的消息被写入磁盘时,它们被追加到一个或多个日志文件中。需要注意的是,Kafka的数据存储在磁盘上是持久的,而在内存中的缓存则具有一定的容量限制。当缓存的大小达到了阈值或者达到了一定的时间间隔时,Kafka会将缓存中的消息写入磁盘,以确保数据的安全性和可靠性。

之乎者也·的博客 2634

kafka原理—01数据存储、日志清理

kafka数据存储、日志清理

AlbertLiangzt的博客 1947

Kafka 学习笔记之 数据存储与高效读写

前言 ​ 上一篇笔记中概述了一下什么是消息队列以及 kafka 的组织架构,这篇笔记就来整理一下 kafka 是如何存储数据,以及其怎么保证了大数据场景下的高效读写,文中如有错误与纰漏欢迎指正,共同进步! kafka 数据存储结构 topic 与 partition ​ 在 kafka 的架构中有讲到作为基于订阅/发布模式的消息队列 kafka 的所有操作都是面向 topic 的,而为了水平扩展的弹性和增大吞吐量在 kafka 中又可以将一个 topic 分成多个 partition 分布在不同的机

an_vana的博客 533

3.Kafka-数据存储流程

Kafka数据存储流程分为四个阶段:1)生产者发送消息到Broker;2)日志追加与持久化,包括分配偏移量、写入页缓存和ISR副本同步;3)异步数据持久化到物理磁盘;4)索引更新与日志段滚动。整个过程通过顺序写入、页缓存和副本机制实现了高吞吐与可靠性,其中ISR机制和异步刷盘是关键优化点。日志段滚动策略则便于文件管理和数据清理。

zhuzhu_YT的博客 745

Kafka 数据存储Topic和Partition

对于Kafka 数据的存储,我们最经常听到的两个概念就是Topic和Partition了,下面就简单介绍下他们在Kafka系统中的意思和作用。 Topic Topic是Kafka中消息的逻辑分类,每个Topic可有多个Partition Partition Partition是Kafka中实际的数据存储单元,每个Partition可以看做一个可以被订阅和消费的消息队列。每个Topic的pa...

Rocky的技术博客 1442

大数据环境下 Kafka 的数据存储与管理

在大数据时代,数据的产生速度和规模呈爆炸式增长。Kafka 作为一种高性能、分布式的消息队列系统,在大数据处理流程中扮演着至关重要的角色。本文的目的在于深入剖析 Kafka 在大数据环境下的数据存储与管理机制,详细介绍其核心原理、算法、实际应用场景等内容。范围涵盖 Kafka 的基本概念、存储架构、数据管理策略、相关算法和数学模型,以及在实际项目中的应用案例和开发工具推荐等方面。本文将按照以下结构展开:首先介绍 Kafka 的核心概念与联系,包括其架构和主要组件;

专注搜索引擎技术 1056

Kafka 数据存储形式以及数据清理

在Kafka当中数据是以日志的形式存在的。 Kafka 的存储日志 日志的观察模式 日志写入模式 日志读写模式 删除消息

古城的博客 3052

Kafka的数据存储结构及命令行操作

一、Kafka的数据存储结构 由于生产者生产的消息会不断追加到log文件末尾,为防止log文件过大导致数据定位效率低下,Kafka采取了分片和索引机制,将每个partition分为多个segment。每个segment对应两个文件:“.index”文件和“.log”文件。这些文件位于一个文件夹下,该文件夹的命名规则为:topic名称-分区序号。 例如,test这个topic有三个分区,则其对应的文件夹为test-0,test-1,test-2。 index和log文件以当前segment的第一条消

qq_30612351的博客 695
上一篇: KafKa数据存储与数据一致性保证
下一篇: TCP 三次握手和四次挥手面试题
王树民
博客等级 码龄10年 912粉丝 560原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
