


轻松一刻:ai能写代码能写文档,为啥不用ai代替程序员呢?ai不给钱就不干活,而且还不能背锅,所以咱们还是得招俩程序员,又能吃饼又能背锅
(文末有调用实例代码rag_qa.py)
1. 为什么要学 RAG
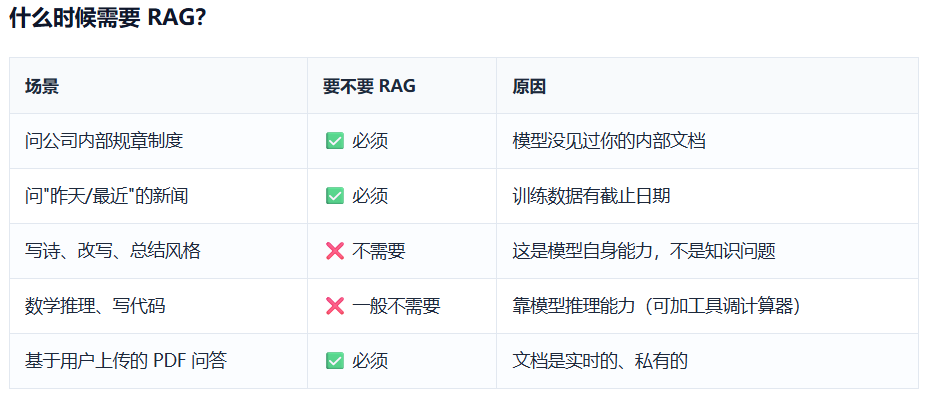
普通 LLM 是闭卷考试:只能答脑子里背过的题,没背过就瞎编。RAG(Retrieval-Augmented Generation,检索增强生成)是开卷考试:先翻书找到相关页面,照着资料答题。
三个普通 LLM解决不了的痛点,决定了RAG的地位:
- 知识截止:模型只知道训练截止日期之前的事,问“上周的”就抓瞎
- 私有知识:你公司的制度文档、你电脑里的 PDF,模型从来没见过
- 幻觉:不知道还硬答,一本正经地胡说八道
什么时候不需要 RAG:写诗改文案(靠模型能力)、数学推理(靠模型脑子,最多配个计算器工具)。判断标准一句话:问题是“知道不知道”,就需要 RAG;问题是“会不会”,就不需要。
💡 为什么不微调(Fine-tune)?
① 微调贵且慢,知识更新要重训;② 微调擅长改风格,不擅长记事实,容易记混;③ RAG 答案可溯源到文档,微调不能。企业知识库场景 95% 选 RAG。两者也可结合:微调教“怎么说”,RAG 给“说什么”。
2. 核心概念速览
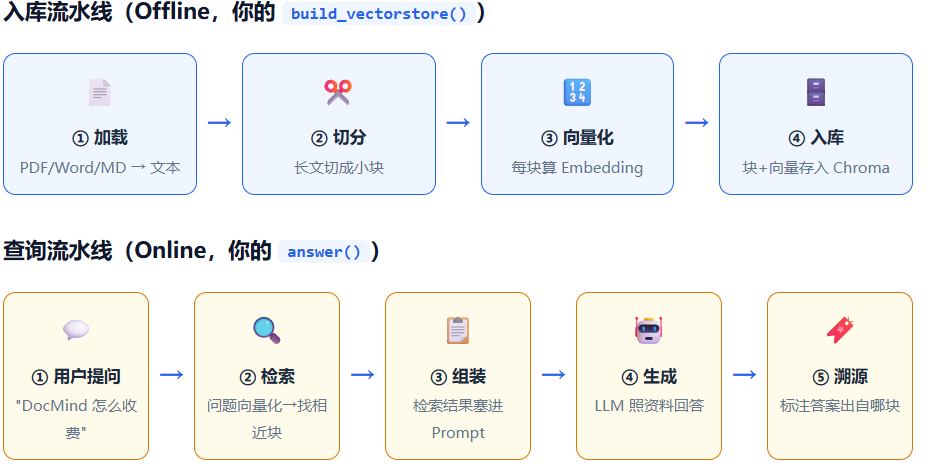
RAG 系统分两条流水线:入库(离线,做一次)和查询(在线,每次提问)。
|
组件 |
作用 |
rag_qa.py代码里的对照 |
|
Embedding |
把文本变成高维向量,语义近则距离近 |
OpenAIEmbeddings(text-embedding-v3) |
|
TextSplitter |
把长文档切成小块 |
RecursiveCharacterTextSplitter |
|
VectorStore |
存块+向量,按语义距离查找 |
Chroma + persist_directory |
|
Retriever |
检索的统一抽象,可进 LCEL 管道 |
store.as_retriever() |
|
format_docs |
把检索结果拼成带编号的资料 |
rag_qa.py 里的 format_docs() |
|
RAG Prompt |
强制“只根据资料回答” |
RAG_PROMPT 常量 |
|
Reranker |
对召回结果精排(进阶) |
暂未用 |
一句话理解:RAG = 先检索后生成。入库像图书馆编目上架,查询像读者查索引卡翻到对应页,再让 LLM 阅读理解后作答。
3. Embedding —— 把文字变成坐标
3.1 基本用法
Embedding 模型把一段文本映射成一个数组(text-embedding-v3 是 1024 维),并且让语义相近的文本向量距离也近。想象把全世界的句子钉在一张地图上:“猫在吃鱼”和“小猫进食”钉在一起,“猫在吃鱼”和“股票大跌”离得很远——Embedding 就是句子的语义坐标。
from langchain_openai import OpenAIEmbeddings

embeddings = OpenAIEmbeddings(
    model="text-embedding-v3",          # 阿里的向量模型,中文效果好
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
    check_embedding_ctx_length=False,      # 坑:不关会报 contents is neither str...
)
⚠️ 容易踩的坑(重要)
OpenAIEmbeddings 默认先用 tiktoken 把文本切成 token 数组再发(OpenAI 官方接口支持),但 DashScope 兼容接口只收字符串,报错 contents is neither str nor list of str。设 check_embedding_ctx_length=False 改为直接发字符串。以后接任何国产模型 Embedding 都要想到这层。
3.2 距离怎么算
|
度量 |
直觉 |
备注 |
|
余弦相似度 |
两向量方向是否一致,不看长度 |
文本检索主流,越大越相似 |
|
欧氏距离 L2 |
坐标空间两点的直线距离 |
Chroma 默认,越小越相似 |
⚠️ 方向别搞反
Chroma 的 similarity_search_with_score 返回的是距离,越小越好;很多教程里的“相似度分数”越大越好。方向反了,阈值过滤就会反向淘汰好结果。
3.3 常用模型选型
|
模型 |
来源 |
特点 |
|
text-embedding-v3 |
阿里 |
OpenAI 兼容接口,中文强,便宜 |
|
bge-large-zh / bge-m3 |
智源开源 |
可本地部署,中文榜单前列,免费 |
|
text-embedding-3-small/large |
OpenAI |
效果标杆,需海外网络 |
🚨 铁律
入库和查询必须用同一个 Embedding 模型。不同模型的向量空间完全不同——A 模型入库、B 模型查询,等于用英语索引卡查中文书。升级模型 = 全量重新入库。
# 感受"语义距离":数值越大越相似
pairs = [
    ("小猫在吃鱼", "猫正在进食"),
    ("小猫在吃鱼", "今天股票大跌"),
    ("怎么退款", "退款流程是什么"),
]
for a, b in pairs:
    va, vb = embeddings.embed_query(a), embeddings.embed_query(b)
    score = np.dot(va, vb) / (np.linalg.norm(va) * np.linalg.norm(vb))
    print(f"{a} vs {b}: {score:.4f}")  # 括号里那对会明显更高
4. 文档加载 —— Loader
LangChain 用一整套 Loader 处理不同格式,统一输出 Document 对象(page_content + metadata)。rag_qa.py 里为了教学用的是直接 open() 读文件,实际项目换 Loader 就行:
from langchain_community.document_loaders import TextLoader, PyPDFLoader, Docx2txtLoader
# from langchain_community.document_loaders import WebBaseLoader   # 网页
# from langchain_community.document_loaders import CSVLoader       # 表格

docs = PyPDFLoader("产品手册.pdf").load()      # 每页一个 Document
for d in docs:
    d.metadata["source"] = "产品手册.pdf"   # 手动补来源,检索时可过滤、回答时可溯源
|
格式 |
Loader |
需安装 |
|
txt / md |
TextLoader |
— |
|
|
PyPDFLoader |
pip install pypdf |
|
Word |
Docx2txtLoader |
pip install docx2txt |
|
网页 |
WebBaseLoader |
pip install beautifulsoup4 |
|
文件夹批量 |
DirectoryLoader("docs/", glob="**/*.pdf") |
— |
⚠️ PDF 是个深坑
扫描件 PDF 没有文字层,读出来是空的,需要 OCR;表格被拆散、双栏排版顺序错乱也常见。企业级方案通常用专门的文档解析服务。
5. 文本切分 —— RAG 效果的第一决定因素
5.1 为什么要切
① Embedding 模型有输入长度限制;② 长文本的向量是“平均味”——一整篇文章压成一个向量,什么都像又什么都不像;③ 只把相关小块给 LLM,省 token 又聚焦。
5.2 RecursiveCharacterTextSplitter(默认首选)
递归策略:优先按段落切(\n\n),块还超尺寸就降级到行(\n)、再降到句号、逗号,最后才硬切字符——尽量让每块语义完整。
splitter = RecursiveCharacterTextSplitter(
    chunk_size=300,        # 每块目标字符数
    chunk_overlap=50,     # 相邻块重叠 50 字符
    separators=["\n\n", "\n", "。", ";", ",", " ", ""],  # 中文要加"。"";"
)
5.3 chunk_size 怎么选
|
块大小 |
优点 |
缺点 |
适合 |
|
小(100-300) |
向量味纯,检索准 |
上下文碎 |
FAQ、条款类 |
|
大(800-1500) |
上下文完整 |
向量语义稀释,检索粗 |
长论述推理 |
没有万能值,一定拿自己的语料实验
5.4 chunk_overlap 为什么存在
防止关键信息骑在切块边界上被腰斩:“年费是 5 万——”和“元,含免费维护”切成两块,两块都不完整。重叠 50 字符就是给相邻块留缓冲带。你实测里“支持私有化部署”的信息排在召回第 4 位,就是靠重叠内容被带进上下文的。
5.5 Markdown 结构化切分
from langchain_text_splitters import MarkdownHeaderTextSplitter

headers = [("#", "h1"), ("##", "h2"), ("###", "h3")]
md_split = MarkdownHeaderTextSplitter(headers, strip_headers=False)
sections = md_split.split_text(markdown_text)   # 每个小节一个块,且 metadata 带 h1/h2/h3
# metadata["h2"] == "主要产品线" → 检索时可按章节过滤,回答时可标注"出自哪一章"
💡 生产常用组合拳
先用 MarkdownHeaderTextSplitter 按章节切开(拿干净 metadata),再对每章用 RecursiveCharacterTextSplitter 二次切小。既保结构,又保粒度。
6. 向量数据库 —— Chroma
6.1 建库与落盘
from langchain_chroma import Chroma

# 建库并落盘(persist_directory 让数据存到磁盘,重启不丢)
store = Chroma.from_texts(
    texts=chunks,
    embedding=embeddings,
    persist_directory="./rag_chroma_db",
    metadatas=[{"source": "company_knowledge.md"}] * len(chunks),  # 可选:溯源用
    collection_name="my_kb",   # 多个知识库分开存,一个 collection = 一个库
)

# 下次启动直接加载,不重复算 Embedding(省时间省钱)
store = Chroma(persist_directory="./rag_chroma_db", embedding_function=embeddings)
rag_qa.py 里的 build_vectorstore(force_rebuild) 就是这个逻辑:目录存在就加载,不存在就建——改了语料才需要重建。
6.2 检索的几种方式
# 检索:返回 Top-K 相似的块
docs = store.similarity_search("怎么退款", k=3)

# 带分数检索(分数是距离,越小越相似——注意不是越大越好!)
docs_scores = store.similarity_search_with_score("怎么退款", k=3)

# 增量添加新文档(不用重建整个库)
store.add_texts(["新的知识内容..."])

# 按 metadata 过滤检索(多知识库/权限隔离的基础)
docs = store.similarity_search("价格", k=3, filter={"source": {"$eq": "price.pdf"}})
6.3 选型速查
|
方案 |
类型 |
适合 |
|
Chroma |
嵌入式(本地文件) |
学习、原型、单机小项目(你在用) |
|
FAISS |
库(Meta 开源) |
单机、量大、追求速度 |
|
Milvus / Qdrant |
独立服务(分布式) |
生产、海量、高并发 |
|
pgvector |
PostgreSQL 插件 |
已有 PG 栈,数据要和业务表 JOIN |
💡 好消息
LangChain 屏蔽了差异:Chroma/FAISS/Qdrant 接口一致(from_documents / similarity_search / as_retriever)。学习期用 Chroma,将来切 Milvus 基本只改 import 和建库两行。
7. 检索策略 —— 不只是 Top-K
7.1 as_retriever():向量库的管道化
任何东西只要能“输入问题、输出文档列表”,就能包装成 Retriever 插进 LCEL 管道——这是 RAG 链能写成 {retriever | format_docs} 的基础:
retriever = store.as_retriever(search_kwargs={"k": 3})
docs = retriever.invoke("DocMind 怎么收费")   # 和 similarity_search(k=3) 等价
# 它能直接进 LCEL 管道 —— 这就是 RAG 链的 {retriever | format_docs} 部分
7.2 三种基础模式
|
模式 |
行为 |
什么时候用 |
|
similarity(默认) |
最相近的 K 个 |
绝大多数场景 |
|
mmr |
既相关又彼此不重复的 K 个 |
召回总是换汤不换药的重复块时 |
|
similarity_score_threshold |
只留相似度过线的 |
过滤弱相关噪声 |
# Maximal Marginal Relevance: 先找最相关的 1 块,再挑"相关但和已选的不重复"的
retriever = store.as_retriever(
    search_type="mmr",
    search_kwargs={"k": 4, "fetch_k": 20},  # 先粗取20块,再从里头挑多样的4块
)
7.3 K 值怎么调
K 太小(1-2)答案只看局部,漏信息;K 太大(10+)噪声块涌入,模型被带偏还烧 token。经验起点 3-5,配合 Reranker 效果最好。动手实验:把 answer() 里的 k=3 改成 k=1,再问“云帆智能有哪些产品线”——答案立刻残缺,这就是 K 值的意义。
8. 高级检索 —— 检索不准了怎么救
基础检索打不稳,问题多半出在问题的表述和文档的表述对不上。四个招数按成本从低到高:
8.1 MultiQueryRetriever:让 LLM 把问题问出花来
用户问“这玩意儿贵不贵”,文档写的是“计费方式:按容量收费”——向量对不上。MultiQuery 让 LLM 先把问题改写成多个角度,各查一遍再合并去重:
from langchain.retrievers.multi_query import MultiQueryRetriever
import logging
logging.getLogger("langchain.retrievers.multi_query").setLevel(logging.INFO)  # 能看到改写出的问题

mq_retriever = MultiQueryRetriever.from_llm(retriever=base_retriever, llm=llm)
# "多少钱" → 被改写成: "价格是多少" "收费标准" "计费方式" → 各查3块 → 合并去重
8.2 HyDE:先编一个假答案,拿它去搜
反直觉但好用:让 LLM 先假想一个答案(细节可以是编的),用假答案去检索——因为答案和文档的向量距离,往往比问题和文档更近:
from langchain.retrievers import HypotheticalDocumentEmbedder

hyde = HypotheticalDocumentEmbedder.from_llm(llm, base_embeddings, prompt_key="web_search")
# 问题"DocMind私有化多少钱" → LLM编一个假的产品页段落 → 用它检索 → 命中真产品页
8.3 父子块:小块检索,大块回答
解决“块小检索准,但上下文不够”的矛盾:用小块(子)算向量和检索,命中后返回它所属的大块(父)给 LLM:
from langchain.retrievers import ParentDocumentRetriever
from langchain.storage import InMemoryStore

# 子切分器(检索用,小块) / 父切分器(回答用,大块)
child_splitter = RecursiveCharacterTextSplitter(chunk_size=150)
parent_splitter = RecursiveCharacterTextSplitter(chunk_size=1000)
docstore = InMemoryStore()   # 存"子块id → 父块全文"的映射

pdr = ParentDocumentRetriever(
    vectorstore=store, docstore=docstore,
    child_splitter=child_splitter, parent_splitter=parent_splitter,
)
8.4 混合检索:向量 + 关键词
向量检索擅长“意思相近”,但对型号、编号、人名这类精确关键词反而拉胯(H-2000 和 H2001 的向量可能很近)。BM25 是传统关键词检索,两者互补,结果用 RRF 融合:
# 思路示意:两路检索,各取Top-K,按排名倒数融合
vec_docs = store.similarity_search(q, k=5)          # 语义路
kw_docs  = bm25_retriever.invoke(q)                  # 关键词路(BM25Retriever)
# doc 在两路中的排名 r 越靠前,RRF 分数 = 1/(60+rank) 越高 → 合并排序
💡 怎么选?决策顺序
① 跑基础检索看 bad case:是“没召回”还是“召回了但排序差”?② 没召回 → MultiQuery(成本最低);③ 召回对了但缺上下文 → 父子块;④ 精确关键词查不到 → 混合检索;⑤ 好块排后面 → Reranker(下一章)。
9. Reranker —— 粗排之后的精排
Embedding 检索是“海选”:快但粗。Reranker 是“评委席”:慢(每对〈查询,文档〉单独打分)但准。区别在结构——Embedding 是双塔(问题和文档分别编码再比距离,没“见过面”),Reranker 是交叉编码(拼在一起进模型,逐字互动)。
生产标配是两阶段:Embedding 召回 Top-20/50 → Reranker 精排 → 取 Top-2/3 进 LLM。好块本来在第 8 名,精排后提到第 1。
from langchain.retrievers import ContextualCompressionRetriever
from langchain.retrievers.document_compressors import CrossEncoderReranker
from langchain_community.cross_encoders import HuggingFaceCrossEncoder

# 本地跑一个开源 reranker(BGE 系列,中文强)。需: pip install sentence-transformers
reranker = CrossEncoderReranker(
    model=HuggingFaceCrossEncoder(model_name="BAAI/bge-reranker-base"),
    top_n=2,   # 20个候选精排后只留最好的2块给LLM
)
compression_retriever = ContextualCompressionRetriever(
    base_compressor=reranker, base_retriever=store.as_retriever(search_kwargs={"k": 20})
)
10. Prompt 组装与防幻觉
检索是“把书翻到对的那页”,Prompt 是“考场的答题要求”。rag_qa.py 里的 RAG_PROMPT 包含三个关键要素:
你是一位知识库问答助手。请只根据下面的【检索资料】回答用户问题。        # ① 角色约束
如果资料里没有相关内容,直接说"知识库中未找到相关信息",禁止编造。    # ② 兜底出口 ★最重要
回答末尾标注依据的资料编号,例如[资料1]。                             # ③ 溯源要求

【检索资料】
{context}

用户问题: {question}
为什么兜底出口最重要:LLM 天性是“一定给你答点什么”,不给台阶它就硬编。有了这句,问“OpenAI 是谁创立的”才能得到“未找到相关信息”而不是一篇编造的百科。允许模型说不知道,是防幻觉的第一道闸。
10.1 组块格式:带编号,方便引用
def format_docs(docs):
    return "\n\n".join(f"[资料{i+1}] (来源:{d.metadata.get('source','未知')})\n{d.page_content}"
                   for i, d in enumerate(docs))
10.2 生成参数
temperature 建议 0~0.2(你用的 0.1):要忠于原文,不要自由发挥。max_tokens 按需设上限,防止长篇大论稀释重点。
🤔 答案对不上资料,怪谁?排查顺序
① 检索根本没召回正确块(检索问题,第 7-9 章的药)→ ② 召回了但 Prompt 没约束住(Prompt 问题)→ ③ 资料本身自相矛盾(数据治理问题)。RAG 效果差八成是第一种——调试时永远先看“检索到了什么”再看“模型答了什么”。你界面里的“检索到的原文块”面板就是为这个准备的。
11. 完整 RAG 链 —— LCEL 标准写法
rag_qa.py 的 answer() 为了在界面展示检索详情写得偏教学,生产标准写法是文件末尾注释里那版——检索只调一次,整条链一个表达式:
# 准备 20 个测试问题 + 每题标注的正确块id
hits = 0
for q, gold_id in test_set:
    docs = retriever.invoke(q)
    if gold_id in [d.metadata["id"] for d in docs]:
        hits += 1
print(f"Hit Rate: {hits/len(test_set):.1%}")
# 改了 chunk_size / 加了 Reranker → 重跑一遍 → 数字对比 → 调优有依据
对照你学过的 LangChain:这就是 LCEL 管道符——retriever | format_docs 表示检索结果自动流给格式化函数;字典做并行分发(context 走检索,question 原样传递);后面接 Prompt、LLM、解析器。Day 2 的管道符 + Day 3 的检索,拼起来就是一条生产级 RAG 链。
12. 评估 —— 怎么知道做得好不好
分两层看:检索层(正确块进 Top-K 了吗)和生成层(答案忠于资料吗)。最朴素但够用的方法——Hit Rate:
# 准备 20 个测试问题 + 每题标注的正确块id
hits = 0
for q, gold_id in test_set:
    docs = retriever.invoke(q)
    if gold_id in [d.metadata["id"] for d in docs]:
        hits += 1
print(f"Hit Rate: {hits/len(test_set):.1%}")
# 改了 chunk_size / 加了 Reranker → 重跑一遍 → 数字对比 → 调优有依据
自动化评估用 Ragas(pip install ragas,LLM 当裁判)四个核心指标:
# pip install ragas  —— 用 LLM 自动打分
from ragas import evaluate
from ragas.metrics import faithfulness, answer_relevancy, context_precision, context_recall

result = evaluate(
    dataset,  # 包含 question / answer / retrieved_contexts / ground_truth 四列
    metrics=[faithfulness, answer_relevancy, context_precision, context_recall],
)
|
指标 |
含义 |
对应层 |
|
context_recall |
该召回的都召回了? |
检索 |
|
context_precision |
召回的都有用?好块排在前面? |
检索 |
|
faithfulness |
答案每句话都有资料支撑? |
生成 |
|
answer_relevancy |
答案答的是问的问题? |
生成 |
💡 实用主义评估法
没有标注集时:准备 15-20 个真实问题,人工看两件事——检索面板里第一条对不对(检索质量)、答案有没有编(生成质量)。糙,但能发现 80% 的问题,而且你的 rag_qa.py 现在就能做。
13. 常见坑速查表
|
症状 |
根因 |
解法 |
|
答案完全是编的 |
检索没命中 + Prompt 没兜底出口 |
加“没找到就明说”,查召回日志 |
|
中文场景效果差 |
separators 没加中文标点 |
切分器加“。”和“;” |
|
召回一堆重复块 |
纯 similarity + 块重叠大 |
换 mmr |
|
型号/编号查不到 |
纯向量检索 |
混合检索 + BM25 |
|
改了语料没生效 |
旧向量库被直接加载 |
删 rag_chroma_db 重建或增量更新 |
|
API 报 contents neither str |
OpenAIEmbeddings 发 token 数组 |
check_embedding_ctx_length=False |
|
分数过滤反向淘汰 |
把距离当相似度 |
Chroma 的 score 越小越相似 |
|
升级模型后检索崩了 |
新旧向量空间混用 |
换 Embedding 模型必须全量重建 |
14. 速查表
从零搭一条 RAG 链的最短路径(背下来):
1. 加载: TextLoader / PyPDFLoader → Document 列表
2. 切分: RecursiveCharacterTextSplitter(chunk_size=300, chunk_overlap=50)
3. 入库: Chroma.from_texts(texts, embeddings, persist_directory=...)
4. 检索: store.as_retriever(search_kwargs={"k": 3})
5. 组装: {context: retriever | format_docs, question: RunnablePassthrough()}
6. 生成: | RAG_PROMPT | llm | StrOutputParser()
调优优先级(效果不对时按这个顺序查):切分参数 → 检索 K 值/模式 → MultiQuery/混合检索 → Reranker → Prompt 约束 → 换 Embedding 模型(最后才动,要全量重建)。
下一步:RAG 之后是 LangGraph——把 RAG 包成 Agent 的一个工具,让 Agent 自己决定“这个问题要不要查知识库”。那时你会同时用到 Day 1 的 Function Calling 和这份笔记里的 RAG。
实例代码rag_qa.py
import os
import time
from dotenv import load_dotenv

load_dotenv()  # 读取 .env 里的 DEEPSEEK_API_KEY / DASHSCOPE_API_KEY

# ============================================================
# 模型配置
# ============================================================
# LLM 用 DeepSeek(生成回答)
from langchain_openai import ChatOpenAI, OpenAIEmbeddings

llm = ChatOpenAI(
    model="deepseek-chat",
    api_key=os.getenv("DEEPSEEK_API_KEY"),
    base_url="https://api.deepseek.com",
    temperature=0.1,  # RAG 场景建议低温:答案要忠于检索到的原文,不要自由发挥
)

# Embedding 用通义千问(DeepSeek 没有提供 Embedding 接口,
# 阿里的 DashScope 提供 OpenAI 兼容接口, langchain_openai 可以直接调)
embeddings = OpenAIEmbeddings(
    model="text-embedding-v3",
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
    # 关键坑: 默认会把文本先切成 token 数组再发, 但 DashScope 只收字符串,
    # 不关这个参数会报 "contents is neither str nor list of str"
    check_embedding_ctx_length=False,
)

# ============================================================
# 第一步: 加载文档
# ============================================================
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_chroma import Chroma

KNOWLEDGE_FILE = os.path.join(os.path.dirname(__file__), "rag_docs", "company_knowledge.md")
PERSIST_DIR = os.path.join(os.path.dirname(__file__), "rag_chroma_db")  # 向量库落盘位置


def load_document(path: str) -> str:
    """读文件。真实项目里会用 PyPDFLoader/Docx2txtLoader 等,这里从简."""
    with open(path, encoding="utf-8") as f:
        return f.read()


# ============================================================
# 第二步: 切分文档
# ============================================================
def split_document(text: str):
    """
    RecursiveCharacterTextSplitter 的"递归"体现在:
    先尝试用 \n\n(段落)切 → 块太大就退而用 \n(行)→ 再大就切句 → 最后硬切字符。
    目的是尽量让每个块语义完整。

    chunk_size:    每块目标字符数
    chunk_overlap: 相邻块重叠的字符数,防止关键信息正好被切断
    """
    splitter = RecursiveCharacterTextSplitter(
        chunk_size=300,
        chunk_overlap=50,
        separators=["\n\n", "\n", "。", ";", ",", " ", ""],  # 中文场景记得加"。"和";"
    )
    chunks = splitter.split_text(text)
    return chunks


# ============================================================
# 第三步: 向量化并写入 Chroma
# ============================================================
def build_vectorstore(force_rebuild: bool = False):
    """
    如果本地已经落盘过(rag_chroma_db 目录存在)就直接加载,不用重新算 Embedding
    (省时间也省钱)。force_rebuild=True 时强制重建——改了语料后需要重建。
    """
    if os.path.exists(PERSIST_DIR) and not force_rebuild:
        print(f"[向量库] 直接加载已有库: {PERSIST_DIR}")
        return Chroma(
            persist_directory=PERSIST_DIR,
            embedding_function=embeddings,
        )

    text = load_document(KNOWLEDGE_FILE)
    chunks = split_document(text)
    print(f"[切分] 原文 {len(text)} 字符 → {len(chunks)} 个块")
    for i, c in enumerate(chunks[:3]):
        print(f"  块{i + 1} ({len(c)}字): {c[:60]}...")

    store = Chroma.from_texts(
        texts=chunks,
        embedding=embeddings,
        persist_directory=PERSIST_DIR,  # 传了这个参数就会自动落盘
    )
    print(f"[入库] {len(chunks)} 个块已向量化并存入 Chroma")
    return store


# ============================================================
# 第四步: 检索
# ============================================================
def retrieve(store: Chroma, question: str, k: int = 3):
    """
    similarity_search 做的事:
    1. 把 question 也变成向量(用同一个 Embedding 模型!)
    2. 在 Chroma 里找语义距离最近的 k 个块
    """
    docs = store.similarity_search(question, k=k)
    print(f"\n[检索] 问题: {question!r}")
    for i, d in enumerate(docs):
        # page_content 是块内容, metadata 里可以放来源/页码(溯源用)
        print(f"  召回{i + 1}: {d.page_content[:70]}...")
    return docs


# ============================================================
# 第五、六步: 组装 Prompt + LCEL 生成
# ============================================================
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough

# RAG 的灵魂就是这个 Prompt: 强制模型"只根据给定资料回答"
RAG_PROMPT = ChatPromptTemplate.from_messages([
    ("system",
     "你是知识库问答助手。请只根据下面的【检索资料】回答用户问题。\n"
     "如果资料里没有相关内容,直接说'知识库中未找到相关信息',禁止编造。\n"
     "回答末尾标注依据的资料编号,例如[资料1]。\n\n"
     "【检索资料】\n{context}"),
    ("human", "{question}"),
])


def format_docs(docs) -> str:
    """把检索到的块拼成带编号的资料文本(编号方便模型引用溯源)"""
    return "\n\n".join(
        f"[资料{i + 1}] {d.page_content}" for i, d in enumerate(docs)
    )


def answer(question: str, use_rag: bool, store: Chroma) -> tuple[str, str]:
    """
    返回 (回答, 检索过程文本)。
    use_rag=False 时走普通 LLM —— 用于直观对比"没有检索会怎样"。
    """
    if not use_rag:
        print(f"\n[直答] 问题: {question!r} (未使用RAG)")
        chain = ChatPromptTemplate.from_messages([("human", "{question}")]) | llm | StrOutputParser()
        return chain.invoke({"question": question}), "(未启用检索)"
    docs = retrieve(store, question, k=3)
    retrieved_text = "\n\n".join(
        f"召回{i + 1}: {d.page_content[:120]}..."
        for i, d in enumerate(docs)
    )

    # 检索只发生一次,结果直接作为 context 塞进链里
    chain = RAG_PROMPT | llm | StrOutputParser()
    answer_text = chain.invoke({
        "context": format_docs(docs),
        "question": question,
    })
    return answer_text, retrieved_text


# ============================================================
# Gradio 界面 (Gradio 6.0: theme 参数放在 launch 里)
# ============================================================
import gradio as gr


def create_interface():
    store = build_vectorstore()

    def on_submit(question: str, use_rag: bool):
        if not question.strip():
            return "请输入问题", ""
        try:
            ans, retrieved = answer(question, use_rag, store)
            return ans, retrieved
        except Exception as e:
            return f"出错了: {e}", ""

    with gr.Blocks(title="RAG 文档问答系统") as demo:
        gr.Markdown(
            "## 📚 RAG 文档问答系统\n"
            "**知识库**: rag_docs/company_knowledge.md (虚构公司资料,模型不可能认识——"
            "全靠检索)\n\n"
            "试试问: 云帆智能是做什么的 / DocMind 怎么收费 / 免费试用政策是什么"
        )
        with gr.Row():
            with gr.Column():
                question = gr.Textbox(
                    label="你的问题",
                    placeholder="例如: 云帆智能的 DocMind 是怎么收费的?",
                    lines=2,
                )
                use_rag = gr.Checkbox(label="使用 RAG 检索(取消勾选=纯LLM直答,观察幻觉)", value=True)
                btn = gr.Button("提问", variant="primary")
            with gr.Column():
                output = gr.Markdown(label="回答")
        with gr.Accordion("🔍 检索到的原文块", open=False):
            retrieved_box = gr.Textbox(label="召回内容", lines=8)

        btn.click(on_submit, [question, use_rag], [output, retrieved_box])
        question.submit(on_submit, [question, use_rag], [output, retrieved_box])
    return demo


if __name__ == "__main__":
    demo = create_interface()
    demo.launch(server_name="127.0.0.1", server_port=7862, theme=gr.themes.Soft())
 370


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


