Claude Opus 4.7 升级引发“中文税”讨论:分词器差异如何影响模型成本与理解?

Claude Opus 4.7深度实测:工作流嵌入与上下文记忆实战指南 大语言模型的‘上下文记忆’能力正从技术概念走向工程现实——它不再仅指对话历史长度,而是指AI对用户任务目标、关键实体、决策逻辑的持续建模与跨会话激活能力。Opus 4.7通过服务端状态协同与客户端索引管理,首次在消费级工具链中实现了接近人类协作者的‘职业感’连续性。其技术价值体现在三方面:基于锚定-沉淀-激活范式的长周期知识管理、xhigh档位驱动的高精度静态分析、以及与VS Code/Notion等工具的双向上下文同步。典型应用场景包括UI设计评审、API文档协同编写、安全编码审查与跨会议风险整合。本文聚 阅读详情

01 中文税

Opus 4.7 发布后,X 上怨声载道,英文开发者账单震荡,而中文用户因新 tokenizer 升级通胀几乎只发生在英文上,躲过涨价。在 Claude 和 GPT 上,中文一直比英文贵;在 Qwen 和 DeepSeek 上,中文反而比英文便宜。token 消耗差异还影响工作空间大小,中文用户付更多钱却得到更小工作空间,根源在于 tokenizer 词表对中文的不同处理。

02 一个汉字,可以切成几块?

模型通过 tokenizer 把输入切成 token,英文切法符合直觉,中文则因 BPE 算法在不同 tokenizer 下切法不同。GPT - 2 时代中文被拆成字节,后来 GPT - 4 词表扩大,中文效率提升,而 Qwen 和 DeepSeek 从设计之初就把中文当作默认语言,中文效率更高。

03 古文真的更便宜吗?

测试证实古文比现代汉语更省 token,因其用字精炼且常用字在词表有独立位置。但古文省 token 却增加模型推理负担,降低理解准确度。

04 碎片里长出偏旁

论文研究发现,汉字拆成多 token 时,模型识别共享部首准确率更高,编码为单个 token 时准确率下降。虽整字 / 整词分词器能提升模型整体性能,但也可能抹掉意外的语义通道。

05 林语堂

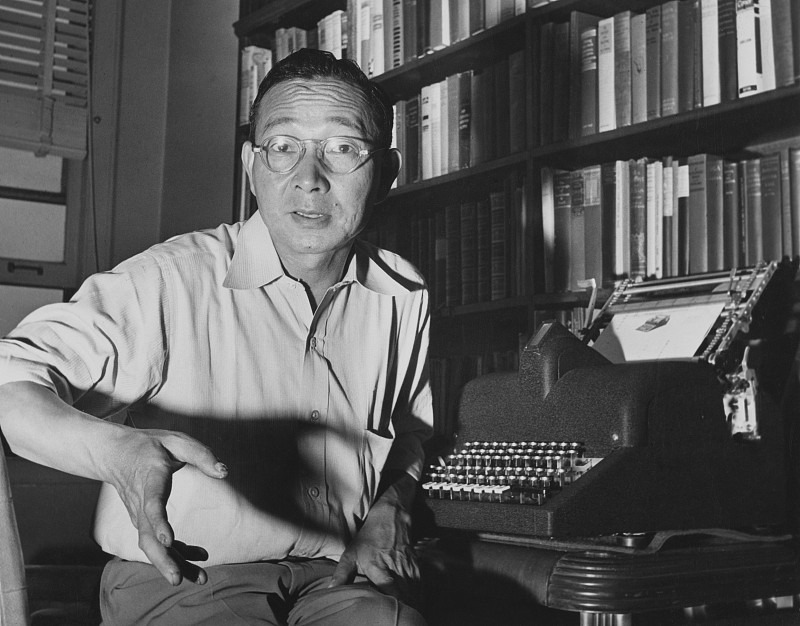
2025 年失踪近 80 年的林语堂“明快打字机”原型机重见天日,它和如今的分词器都面临中文适配西方技术基础设施的问题。明快打字机技术突破但商业失败,却奠定了现代中文输入法底层逻辑。

Claude Opus 4.7工程哲学:从生成答案到交付可运行代码 大语言模型在软件工程中的价值正从‘能回答问题’转向‘可交付生产就绪产物’。这背后涉及指令遵循严格性、自我验证机制、状态化Agent能力等核心原理。技术价值在于显著降低人工校验与返工成本,提升CI/CD通过率与线上稳定性;典型应用场景包括微服务重构、Kubernetes配置生成、自动化代码审查及视觉驱动的架构分析。Claude Opus 4.7通过‘字面执行’‘嵌入式TDD’和‘风险感知的xhigh模式’,将LLM真正嵌入工程师工作流——它不追求通用智能,而专注成为可信赖的虚拟同事。GPT味与稳稳接住,正是这 阅读详情

相关推荐

Claude Opus 4.7深度解析:可控性驱动的LLM行为优化

大型语言模型(LLM)的核心价值正从‘能答多少题’转向‘是否稳定可靠’。随着工程落地深化,指令遵从度、上下文稳定性与中文语义锚定能力成为影响实际效能的关键瓶颈。Claude系列由Anthropic主导设计,始终聚焦可预测性与行为可控性——这使其在真实工作流中展现出远超参数规模的鲁棒性。Opus 4.7并非基座模型升级,而是通过推理时策略层重构,实现对‘不要改动’‘仅限指定范围’等强约束的动态高权重响应,并借助语义感知分词校准显著改善中文技术术语理解。其技术价值在于将LLM从‘智能但难控’的助手,转变为可嵌入

weixin_33725722的博客 505

Claude Opus 4.7词表缩减原理:BPE语义聚类与tokenizer协同进化

Tokenizer是大语言模型输入处理的核心组件,其本质是基于BPE(字节对编码)等子词算法将文本映射为离散token序列。传统BPE追求统计压缩率,易产生语义薄弱的碎片化子词;而Claude Opus 4.7的词表缩减并非简单删减,而是通过系统性移除中频‘粘合型’token,推动词元向高信息密度、强语义完整性方向重构——典型表现为中文专业术语(如‘人工智能’)和英文形态完整词(如‘preprocessing’)被统一编码为单token。这一变化显著提升模型对领域术语与长程语义的建模鲁棒性,直接影响toke

weixin_30652897的博客 409

Claude Code 4.7工作流升级指南:从结对编程到工程委派

AI编程助手已从辅助型‘结对程序员’演进为具备目标导向与可验证交付能力的‘初级工程师’。其核心原理在于严格遵循提示词约束、强化上下文锚点与验收标准,并通过agentic workflow实现单轮深度推理。这一转变带来显著技术价值:首版交付正确率提升至92%、交互轮次减少63%、token消耗反降22%。典型应用场景涵盖多文件重构、自动化Code Review、UI像素级视觉测试及跨服务接口设计。Claude Code 4.7的落地成败,不再取决于模型参数调优,而在于是否完成从模糊提问到结构化委派的工作流重构

weixin_30835649的博客 324

Claude Opus 4.7实战指南:任务闭环、文档智能体与视觉工作流

大语言模型正从‘文本生成器’演进为‘任务执行引擎’,其核心在于对真实业务闭环的理解与可控推理能力。Claude Opus 4.7通过任务预算机制、语义驱动分词和xhigh effort认知调度,显著提升长文档解析、多格式PDF处理及视觉-文本联合推理的可靠性与保真度。相比传统模型依赖模糊提示与被动响应,4.7强调上下文约束显性化、错误边界主动声明和结构化输出可编程性,特别适用于合同审查、财报分析、知识库构建等高确定性知识工作场景。本文聚焦工程落地细节,涵盖DeepSider插件配置、文档智能体搭建、视觉输入

weixin_30552811的博客 460

Claude 4.7:从AI工具到工程协作者的可靠性跃迁

大语言模型正从‘能生成’迈向‘可信赖’的关键拐点。可靠性(Reliability)与工具调用韧性(Tool Use Resilience)已成为衡量AI工程价值的核心指标,远超单纯参数规模或基准分数。其底层逻辑在于:通过训练阶段的反幻觉锚点、推理时的事实核查缓存、输出端的风险熔断机制,构建起拒绝编造、拒绝盲目服从、拒绝半途而废的智能边界;再结合多步任务中的故障自愈、路径重规划与跨模态结构理解,使AI真正具备软件工程师所需的审慎性、容错性与决策透明度。这一演进正重塑需求澄清、技术评审与上线决策等关键研发环节,

weixin_30326515的博客 337

CAPL基础篇-----CAPL中如何发送自定义报文

CANOE CAPL CAN消息发送

WlzSnail的专栏 1万+

Claude Code v2.1.111深度解析:Opus 4.7、xhigh与Auto模式实战指南

代码智能辅助工具正从‘提示补全’迈向‘工程级决策支持’,其核心演进围绕大模型能力升级、推理控制粒度细化及自动化权限边界重构展开。Claude Code作为典型代表,依托Opus 4.7模型在逻辑闭环与多步验证上的增强,显著提升软件工程类任务表现;而xhigh思考等级则填补了高阶推理与资源消耗间的空白区间,实现更精准的effort-accuracy权衡。这类技术价值在真实开发场景中体现为:PR审查深度强化、跨文件语义理解提升、重构方案风险预判前置。尤其当结合Auto模式与/ultrareview等云沙箱机制时

aqc802886的博客 402

最全卷积总结篇(分组、深度可分离、空洞、转置等)

分组卷积(Group Convolution)是一种卷积操作方式,它最早在AlexNet中引入,并在深度学习中被广泛使用,尤其是在高效模型设计(如MobileNet和ResNeXt)中。分组卷积通过将输入特征通道分为若干组,并在每组内单独进行卷积操作,可以减少计算复杂度和参数量,同时有效利用模型的结构特性。分组卷积的工作原理通道分组:输入特征图的通道图为C_in,输出特征图的通道数为C_out,将每组的C_in和C_out分为G组,每组的通道数为C_in/G和C_out/G。组内卷积。

qq_44815135的博客 4226

Claude Opus 4.7:面向Agent时代的工程化可信编码引擎

大语言模型正从‘对话式助手’迈向‘自主任务执行体’,其核心演进在于将多步决策、工具调用与跨模态理解内化为可验证的工程能力。Agentic coding强调字面级指令遵循与输出前自我验证,Visual reasoning则要求图像与代码语义空间对齐,实现Figma到React组件的端到端生成。这类能力不再依赖提示词技巧,而是依托模型底层的任务状态机、分层注意力锚定与视觉token嵌入对齐等架构创新,显著提升长周期开发任务的闭环成功率与生产环境可信度。本文聚焦Claude Opus 4.7在真实IDE场景中支撑

ajwh64482的博客 338

RV1106G3的AOV下的yolov5调试记录

本文介绍了基于LuckFoxPicoMax开发板的RV1106芯片调试经验,重点包括AOV(Always-On Vision)和Yolov5目标检测的实现。在硬件方面,板载1TOPS NPU、256MB内存,并更换为SPI NOR存储。软件调试涉及MK配置文件修改、设备树调整(按键唤醒和sensor配置)以及程序自启动设置。Yolov5模型优化为320*320尺寸,推理时间约45ms。系统采用VI采图与AI识别通过共享内存通信的方案,实测功耗在20-35mA范围。文章还指出了当前存在的功耗优化、ISP调试等

fzktongyong的博客 1718

告别迷茫!用ETAS RTA-OS配置你的第一个AUTOSAR OS任务(含VRTA虚拟ECU实战)

本文详细介绍了如何使用ETAS RTA-OS工具链在VRTA虚拟ECU上配置和运行第一个AUTOSAR OS任务。通过从XML配置到任务调度的全流程实战,帮助开发者快速掌握嵌入式操作系统开发的核心步骤,特别适合刚接触AUTOSAR的开发者快速上手。

weixin_42533622的博客 422

Claude Opus 4.7国内实测避坑指南:视觉、xhigh档位与指令遵循三大实操门槛

Claude Opus 是 Anthropic 推出的高性能大语言模型,广泛应用于代码审查、多模态分析与复杂推理任务。其核心能力依赖于视觉理解精度、推理档位选择逻辑与结构化指令遵循机制。在真实国内网络环境下,模型虽可直连,但375万像素支持不等于全场景可用,xhigh档位实为精度临界点而非速度妥协,而指令遵循已从模糊响应转向严格字面执行。这些特性深刻影响产品设计、前端开发与技术写作等工程实践——尤其在设计稿分析、PRD解析与跨文件代码审查中,需针对性优化输入格式、图像预处理与prompt结构。本文基于72小

weixin_30509393的博客 330

vmware vsphere 证书过期告警处理方法

vSphere Clinet 管理页面出现“证书告警” ,检查证书未发现现有证书有过期现象

m0_51902127的博客 3641

Claude Code与Opus 4.6生产级API接入实战指南

大型语言模型(LLM)的API集成已从概念验证迈向工程落地,其核心挑战在于稳定调用、精准token控制与长上下文可靠性。Claude Code api接入强调低延迟与代码语义理解,而Claude Opus4.6则聚焦高阶推理与万token级上下文处理能力。二者均依赖v1/messages标准协议、anthropic-version认证头及原生HTTP精细化管控,技术价值体现在可监控、可重试、可审计的生产就绪性。典型应用场景包括Git仓库智能分析、PR前SQL注入自动检测、多文件React组件安全审查等。本文

a4512138的专栏 375

2、OTA/gm - C滤波器的架构与设计

本文深入探讨了OTA/gm-C滤波器的两种主要设计方法:基于LC梯形网络的设计与多环反馈(MLF)结构。前者包括元件替代法和信号模拟法,分别通过电感替代或电路方程模拟实现低敏感度滤波器;后者通过积分器级联与反馈网络合成全极点或含任意传输零点的传递函数。文中详细分析了不同结构如IFLF和LF的反馈矩阵、传递函数及性能差异,指出LF结构在敏感度、噪声和整体性能上的优势。同时比较了各类方法的优缺点及适用场景,为高频连续时间集成电路滤波器的设计提供了系统性指导。

fanta的博客 139

WRFDA如何读取风云四号A 星的GIIRS数据?

🏆本文收录于 《全栈 Bug 调优(实战版)》 专栏。专栏聚焦真实项目中的各类疑难 Bug,从成因剖析 → 排查路径 → 解决方案 → 预防优化全链路拆解,形成一套可复用、可沉淀的实战知识体系。无论你是初入职场的开发者,还是负责复杂项目的资深工程师,都可以在这里构建一套属于自己的「问题诊断与性能调优」方法论,助你稳步进阶、放大技术价值。

**My Coding Family** 1031

Claude Opus 4.7三大核心能力解析:长程逻辑、多源缝合与模糊意图显性化

大语言模型在企业级AI应用中面临的核心瓶颈,从来不是‘能否生成文本’,而是‘能否稳定维持长程推理、跨段落整合证据、准确还原用户真实意图’。这三者分别对应逻辑一致性、信息溯源能力与意图理解深度——正是当前行业高频搜索的‘大模型幻觉治理’‘AI可解释性’‘提示词工程优化’等关键技术诉求的底层支撑。Claude Opus 4.7通过分层记忆锚定架构(HMA)、证据缝合引擎(ESE)和意图解码器(ID),首次在合同审查、工业故障诊断、法律合规分析等高确定性场景中实现工程级可用。它不追求参数规模,而聚焦于让AI输出具

dengyulong的专栏 402

DeepSeek+即梦:AI视频创作从0到1全突破

本文为 DeepSeek 与即梦生成视频全攻略,从前期注册登录、熟悉工具界面及硬件网络准备入手,助读者开启 AI 视频创作。详细阐述利用 DeepSeek 构思脚本、即梦实现画面生成与静态图转动态视频的方法,包括提示词编写、参数调整等技巧。同时介绍后期合成音画、添加字幕特效及多平台适配要点,结合实战案例解析全流程。还分享进阶提示词优化、版权注意等避坑指南,为创作者提供从 0 到 1 的 AI 视频创作完整解决方案。

邓邓子的博客 8124

Claude-Opus-4.7驱动的AI知识库馆长系统设计

知识库系统是企业级AI应用的核心基础设施,其本质是将非结构化文档转化为可检索、可验证、可推理的认知资产。传统RAG方案依赖单一向量检索,难以应对模糊查询、跨文档逻辑推演与事实冲突等真实场景。本文聚焦于构建具备‘典藏—索引—策展—守门’四重能力的知识协作者,以Claude-Opus-4.7为推理中枢,深度融合结构化属性索引、语义向量索引与知识图谱索引,通过强制溯源验证、时效性校验与矛盾检测三大守门协议,显著提升答案的事实准确性与可审计性。该方案适用于技术文档密集型场景,如架构决策支持、合规条款比对与客户需求提

389

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

android 蓝牙通讯demo

android 下蓝牙通讯demo,实现了发现蓝牙,使能蓝牙,通过蓝牙发送消息。

大模型应用实战:从Token、上下文理解到成本控制与模型选型

在构建大模型应用时,理解其核心工作机制是工程实践的基础。大模型通过处理称为Token的基本语义单元来完成理解和生成任务,其计算量和成本直接与Token数量相关。同时,模型的上下文窗口定义了单次交互中能处理的Token总量,直接影响其信息处理能力和请求成本。掌握这些原理,对于实现高效、经济的大模型集成至关重要。在应用层面,开发者需要根据具体场景,在效果与成本间进行精细权衡。通过优化提示词工程、实施分层调用策略(如将简单任务路由至低成本模型)以及建立用量监控体系,可以有效控制资源消耗。无论是调用云端API还是部

weixin_34050005的博客 429

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

大模型实战指南:Token、上下文与计费原理详解与成本优化策略

在自然语言处理领域,大模型的核心运作机制建立在Token和上下文等基础概念之上。Token作为模型处理文本的基本语义单元,其切分方式和数量直接影响模型的理解与生成过程,是计费与性能评估的关键依据。上下文长度则决定了模型的“工作记忆”范围,是实现长文档理解与多轮对话连贯性的技术基础。理解这些原理对于构建高效、低成本的大模型应用具有重要价值,尤其在检索增强生成(RAG)等架构中,通过精炼输入和分层处理策略管理上下文,能有效平衡效果与资源消耗。在实际工程实践中,结合模型选型与提示词工程,开发者可以系统性地优化To

weixin_34195546的博客 538

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

GLM-5.1开源实测:中文长文本理解与低资源推理突破

大语言模型的‘长文本理解’能力,本质是位置编码精度、语义分块机制与推理引擎协同优化的结果。RoPE位置编码的theta值提升至50万级、ZPM多级中文分词器对法律复合词的原子化处理、以及动态KV Cache压缩等技术,共同支撑起超128K tokens的稳定上下文建模。这类能力在合同审查、金融文档解析等中文垂直场景中,直接转化为低幻觉、高召回、强可追溯的工程价值。尤其当部署受限于24GB显存的A10服务器时,GLM-5.1-1B凭借INT4量化、专用推理引擎ZhiPu-Infer和领域知识内化,展现出远超通

weixin_30700977的博客 483

大模型API成本全解析:一块钱能买多少Token?

Token是大模型处理文本的基本单位,其计算方式因模型而异,通常中文1-2个汉字对应1个Token。大模型API按输入和输出Token分别计价,输出价格普遍高于输入,因为生成过程需逐Token计算,算力消耗更大。理解Token机制和定价原理,有助于优化API使用成本,在批量数据处理、长文档分析等场景中显著节省费用。通过提示词压缩、模型路由、输出长度控制以及缓存和批处理等技巧,可以进一步降低开销。本文深入横评主流大模型API价格,结合具体场景算账,并分享省钱实操与选型避坑指南,帮助开发者高效控制成本。

weixin_34088583的博客 382

从Claude到GLM:AI Agent工作流迁移实战与架构重构指南

大语言模型(LLM)作为AI应用的核心组件,其API调用与集成方式直接影响系统的稳定性和可维护性。在工程实践中,通过抽象层设计实现模型供应商的无缝切换,是构建健壮AI系统的关键架构原则。本文聚焦于AI Agent工作流场景,针对常见的服务稳定性问题(如unable to connect to anthropic services)和成本优化需求,深入解析了从Anthropic Claude到智谱GLM模型的技术迁移全流程。通过对比API设计差异、流式输出实现、上下文长度管理等核心技术要点,提供了完整的适配层

weixin_30301449的博客 411

100万Token长上下文落地:RAG边界、模型分工与缓存实践

上下文窗口是大模型处理长材料的基础参数,决定信息完整度与可推理范围。窗口从十万级扩展到100万Token,不只是“能塞更多字”,还会改变切片、向量化、召回与拼接的RAG管线设计:检索负责从海量语料中定位候选,长上下文负责在完整材料内做全局一致性判断。其工程价值在于降低跨章节矛盾、跨文件依赖和长会话状态保持的难度,适用于合同比对、招投标审计、全仓代码审查等场景。落地时需关注注意力中段衰减、缓存断点、模型路由与输入预算,并用Opus 4.6/Sonnet 4.6按错误成本分工,平衡成本、延迟与稳定性。

weixin_29038155的博客 206

DeepSeek V4实测:稀疏注意力机制下的API调用避坑指南

大模型的‘百万上下文’能力并非简单堆叠token,其底层依赖稀疏注意力机制(如DSA)实现长文本高效处理。该机制通过语义块划分重构模型记忆方式,带来推理行为变异、header校验强化、prompt引导依赖等工程新范式。技术价值在于平衡推理质量与成本效率,尤其在代码审查、文档分析、IDE实时补全等场景中,需适配块感知型输入与精确参数配置。本文聚焦DeepSeek V4系列(V4-Pro/V4-Flash)在真实生产环境中的API对接、错误诊断与性能调优,覆盖Claude Code兼容接入、LangChain定

weixin_30379531的博客 485
上一篇: 美五大科技巨头Q1财报:业绩超预期股价分化,AI投入回报成焦点
下一篇: 美五大科技巨头财报:业绩超预期股价分化,谷歌云利润率成AI投资回报参照
IT界那些事儿
博客等级 码龄6年 2万+粉丝 22原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值