世界模型成AI底层范式总线:具身、自动驾驶、3D生成场景各有玩法,产业分工初现

VLA与世界模型:自动驾驶决策范式的双螺旋演进 视觉-语言-动作(VLA)模型和世界模型是当前自动驾驶系统构建智能决策能力的两大基础技术路径。VLA强调端到端的感知-理解-执行闭环,依托多模态联合建模实现毫秒级响应;世界模型则聚焦于对物理环境的高保真3D内化与因果推演,支撑安全验证与长尾场景仿真。二者分别对应实时性与安全性的工程权衡,而非互斥替代关系。随着Alpamayo 2 Super等VLA大模型落地车规平台,以及OmniDreams推动神经渲染与物理约束融合,产业正走向‘VLA主控+世界模型校验’的混合架构。这种协同范式,正在重塑L4级自动驾驶的研 阅读详情

世界模型的误区

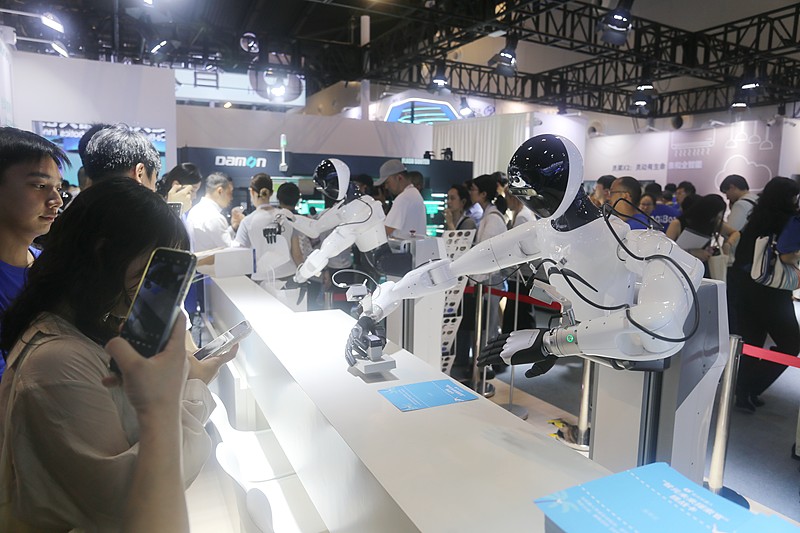
如果你最近关注AI产业,大概率会感到困惑,这个月的新闻似乎被 "世界模型" 四个字占领。大厂、机器人公司、自动驾驶公司都在发布世界模型,各家用词还不统一,像世界模型、统一世界模型、具身世界模型等。它们看似是同一件事,实则不然,这种混乱折射出一个产业事实:一个重要技术概念正在渗入多个赛道,每个赛道都在用自己的语言定义它。要理解当下的混乱,得先回答:当我们谈论世界模型时,到底在谈论什么?常见误区是把世界模型和具身智能混为一谈。当下受关注的几家具身智能公司都有世界模型叙事。比如,无界动力把世界模型放到核心架构,强调 "原生世界模型+强化学习",将隐空间世界模型作为通用具身大脑的核心;极佳视界打出 "具身世界模型" 旗号,重点是用世界模型弥补真实数据不足、提升策略训练和场景泛化能力;智元机器人、星动纪元是完整具身系统玩家,世界模型是提升泛化、仿真等能力的关键模块;银河通用被理解为 "通用具身大脑" 路线,世界模拟能力是其重要组成部分。具身智能叙事易让人困惑,它出现了 "世界模型" 等多个说法,但它们并非同义词。准确来说,世界模型是底层能力,具身世界模型是其在机器人场景的版本,原生世界模型是以世界建模为中心的技术路线,通用具身大脑是驱动机器人行动的完整系统。所以,具身智能和世界模型高度相关,但并不等同。一个机器人完成任务依赖整套具身智能系统,世界模型在其中占据关键位置,是物理后果的推演引擎。审视具身智能赛道公司会发现,他们关注的底层问题,如机器人能否形成可推演的世界模型、该模型能否理解空间等,正是狭义世界模型的核心命题,关键词是生成、表征、预测、推演。

世界模型的落地方向

事实上,世界模型并非只有具身智能一个落地场景。其玩家跨越学术与产业,都在从不同方向逼近同一目标。先看最接近原生定义的一端。图灵奖得主Yann LeCun创立的AMI Labs口号最决绝,公开批评LLM路线是死胡同,认为真正的世界模型要在抽象表征空间中学习世界状态等,支持预测与规划。AMI打出 "world models" 标签,定位为区别于纯大语言模型路线的下一代AI核心架构。李飞飞创立的World Labs也站在定义权这一端,她强调的概念是spatial intelligence,其产品Marble能生成空间一致、可穿行、可编辑的3D世界。沿着光谱往下,是两大中国互联网巨头,方向更偏向可交互世界的工业化落地。阿里巴巴的Happy Oyster能让创作者用文字操控虚拟世界变化,本质是生成可持续、可编辑的时空序列;腾讯的HY - World 2.0是3D世界模型,核心能力是对接游戏引擎,解决三维世界可生产性问题。阿里和腾讯重点在内容与空间世界。自动驾驶赛道提供了另一种验证方式。Waymo将世界模型用于自动驾驶仿真,推演车辆等之间的时空交互;小鹏汽车的X - World能预测未来路况,把长尾场景训练变成日常仿真。它们关注用世界模型预测物理世界多智能体动态演变,完成仿真等。把这几条线并置,一个清晰结构浮现:世界模型是底层范式的总线,具身智能、自动驾驶、3D世界生成是其当前显眼的分支场景,这解释了为何大家都谈世界模型却又好像说的不是同一件事,世界模型正在成为一种底座能力。

世界模型的产业分工

把世界模型的三个落地方向并置,会出现看似矛盾的现象。自动驾驶方向有清晰的验证闭环、迫切的产业需求和可量化的效果指标,按理应聚集最多玩家和资本,但现实是大厂重注3D世界生成,热钱涌入具身智能,自动驾驶世界模型多是行业内部推进。同一项底层技术在三个方向资源分布不均衡,这是理解世界模型产业逻辑的钥匙。自动驾驶是世界模型当前最强的现实落点,原因在于其受物理定律严格约束、对预测精度要求高、容错空间小,世界模型在其中的任务明确,评估标准可精确量化。这带来两个好处:一是技术验证周期短,二是产业需求真实且紧迫。那为何大厂和资本没把筹码全押在自动驾驶?阿里和腾讯选择3D世界生成,是因为离主营业务近、变现路径短,世界模型可直接融入现有生态,该方向确定性高、落地快。自动驾驶公司选择仿真预测,是生存问题,但玩家集中在行业内部,融资和估值受汽车产业资本逻辑限制,不会有爆炸式估值增长。而风投押注具身智能,赌的是世界模型能否成为通用底层,机器人是离通用性最近的训练场,若模型能在不同环境学习,可能成为机器人泛化能力的核心组件,甚至形成更统一的具身大脑。由此,一个清晰的产业分工格局出现:大厂抢离钱最近的内容出口,自动驾驶抢确定性最高的工程出口,资本赌天花板最高的通用出口。它们串联起的产业共识是:世界模型不是某行业附属品,而是渗入多个产业的底层建模能力。大厂、自动驾驶巨头和风险资本的站位差异,是在赌这个内核在哪个场景最先触达终极形态,这或许能解释产业界既亢奋又混乱的状态。未来人们回看这个春天,会发现所有喧嚣不过是一项技术从实验室走向产业底座时必经的模糊地带。

生成式世界模型:自动驾驶闭环仿真的新范式 生成式世界模型是一种将物理规律与神经网络深度融合的动态仿真技术,其核心在于建模世界状态转移函数P(sₜ₊₁|sₜ, aₜ),实现对交通流、天气、传感器噪声等多模态要素的联合因果推演。相比传统基于预设规则或静态场景库的开环仿真,它通过可微分隐状态建模、实时物理约束嵌入和闭环反馈机制,显著提升规控算法的泛化性与实车一致性。该技术正成为自动驾驶研发中降低路测成本、突破仿真瓶颈的关键基础设施,尤其适用于L3+系统验证、数字孪生构建及高保真传感器建模等工程场景。 阅读详情

相关推荐

OpenDriveVLA:3D感知与大语言模型融合的自动驾驶新范式

端到端自动驾驶正从模块化架构迈向统一智能体范式。其核心在于突破‘语义鸿沟’——即3D感知结果(如点云、BEV特征)与高层决策指令之间的失配问题。OpenDriveVLA通过构建视觉-语言-动作(VLA)联合嵌入空间,使3D感知直接生成语言化、可执行的驾驶语义向量,让大语言模型在具备时空因果性与物理约束的前提下进行推理。这种融合不仅提升雨雾、无标线等长尾场景鲁棒性,更支撑归档可审计、部署可量化、决策可追溯的工程落地能力,标志着自动驾驶由‘多模块拼装’转向‘具身认知演化’的关键跃迁。

weixin_34056162的博客 667

世界模型,为什么突然成了一门显学?

感知模型负责看见环境,世界模型负责理解环境状态并预测动作后果,任务规划模型负责拆解目标,VLA或策略模型负责把视觉和语言指令转成动作,底层控制系统再把动作落到机械臂、关节、底盘和传感器反馈上。更准确的关系是,世界模型是底层能力,具身世界模型是它在机器人场景里的版本,原生世界模型是一种以世界建模为中心的技术路线,而通用具身大脑则是把这些能力组织起来、驱动机器人行动的完整系统。各家用词甚至都不统一:世界模型、统一世界模型、具身世界模型、空间智能、Physical AI、机器人大脑、自动驾驶世界模型……

2501_91883294的博客 337

具身智能系统架构:从STM32 PID到Dreamer世界模型的三层耦合

具身智能不是单纯算法选型问题,而是物理系统与智能决策深度耦合的工程挑战。其核心在于理解真实世界的四大约束:部分可观测性、动作执行延迟、奖励信号脆弱性及嵌入式算力天花板。由此催生‘系统即算法’范式——将强化学习解耦为适配不同硬件层级的专用模块:在微控制器(如STM32)上,RL作为PID参数在线调节器,保障毫秒级实时性与安全性;在边缘计算单元(如Jetson Orin)上,PPO/SAC承担中层协调任务,依赖多源同步感知与鲁棒reward shaping;在高性能平台,Dreamer类世界模型构建隐状态预测能

dingdi3021的博客 460

2025世界人工智能大会:智能时代 同球共济

身高175cm、体重75kg,全身有52个自由度,整机算力达100tops,能够实现高效的决策能力,自研行星滚柱丝杠执行器,具有高负载、长续航、高精度的特性,自研精旋动力旋转执行器,保障机器人动作的精准性和高稳定性,能够实现充电1小时,连干8小时的超长续航与30公斤负载能力。宇树科技展示了g1机器人与真人展开的格斗表演,还发布了第三款人形机器人unitree r1,定价3.99万元人民币起,拥有26个自由度,包括双足、双臂、手部、腰部和头部等完整人形结构,整机仅重约25kg。

2401_87350631的博客 860

DriveWorld-VLA:统一潜在空间驱动的自动驾驶世界模型

世界模型是具身智能的核心基础,指AI在内部构建可推演、可干预的环境表征;其技术本质依赖多模态对齐与状态空间建模。VLA(视觉-语言-动作)框架正成为实现世界模型的关键路径,通过共享潜在空间打破感知、理解与执行的语义割裂,显著提升长尾场景鲁棒性与零样本泛化能力。该范式已从仿真验证走向真实道路部署,在小米SU7等量产车型中支撑NOA功能,并向服务机器人、车云协同等跨设备场景延伸。DriveWorld-VLA作为典型代表,以结构化SSM动力学建模与物理约束解码,实现了高稳定性、低延迟的世界状态演化与动作生成。

weixin_33674976的博客 444

BEV+3DGS:自动驾驶从猜距离到造世界的范式跃迁

BEV(鸟瞰图)与3DGS(3D高斯泼溅)正推动自动驾驶感知从2D检测迈向3D世界建模。其核心原理是将多源传感器数据统一映射至几何一致的BEV空间,并以可微分、可增量更新的3D高斯场表征动态环境,实现对道路结构、障碍物运动及物理属性的显式建模。这一技术路径显著提升系统在遮挡、雨雾、长尾场景下的鲁棒性与可解释性,支撑轨迹预测、安全走廊规划等高阶决策。相比传统mAP评估,它更强调‘能否通行’‘位置可预测’等世界状态级能力。本文聚焦BEV+3DGS融合架构的工程落地——涵盖视图变换优化、跨模态不确定性融合、3DG

weixin_33984032的博客 281

具身机器人硬件全景拆解

《具身机器人硬件全景拆解:决策层、感知层、执行层、支撑层四大系统》

上海越微信息技术有限公司官方技术博客,专注工业 AI 视觉算法定制、机器人二次开发与 RK3588 边缘计算落地实战。 1200

VLA、世界模型与端到端:自动驾驶算法三大前沿方向深度解析

自动驾驶正经历从模块化向统一认知范式的根本性跃迁。VLA(视觉-语言-动作)突破传统多模态理解边界,将动作空间作为第三模态嵌入联合表征;世界模型不再追求渲染逼真,而是构建可微分、可推演的物理状态演化系统,支撑长时序因果预测;端到端则超越‘像素到扭矩’的表层映射,走向可验证、可降级、符合车规安全要求的混合式工程实现。三者以Transformer为通用接口,在语义对齐、物理建模与系统集成层面深度咬合。本文聚焦VLA的数据构造范式、世界模型的物理先验设计及端到端的HVEE可验证架构,揭示2024年国内头部具身智能

weixin_33767813的博客 395

多模态具身交互方法

在“工业大模型 × 具身智能(Embodied AI) × 柔性控制”深度融合的现代化智能工厂语境下,多模态具身交互方法(Multimodal Embodied Interaction Methods)已彻底超越了传统“屏幕UI点击、键盘敲击或语音指令转文字”的平面局限。制造现场具有“物理环境高噪声、多轴机械轨迹复交、工艺机理容错率为零”的刚性红线。

Cat_fish_snow的博客 361

VLA与世界模型不是对手,而是物理AI的左右脑

VLA(视觉-语言-动作)和世界模型是物理人工智能的两大基础范式:前者聚焦于跨模态语义理解与可执行动作生成,后者致力于构建可微分、带物理先验的动态环境仿真。其技术价值在于突破传统模块化架构的误差放大瓶颈,实现‘理解即控制’与‘推演即决策’的紧耦合。典型应用场景包括自动驾驶、具身机器人等强实时物理交互系统,尤其依赖二者协同支撑长尾场景泛化与闭环强化学习。本文深入解析MindVLA-o1如何将VLA作为世界模型的操作界面,把世界模型作为VLA的思考沙盒,在毫秒级延迟下完成神经突触级别的协同。

weixin_29056145的博客 233

空间具身技术如何落地?从感知到操作的完整工程解析

在机器人研发与智能制造领域,空间具身正成为连接三维空间理解与物理动作执行的关键技术架构。想要机器人真正完成抓取、装配或服务任务,仅靠目标检测或单一运动控制远远不够,必须打通从传感器数据采集、空间表征建模到机械臂坐标变换与执行反馈的完整闭环。其中,RGB-D相机的深度对齐、点云反投影、手眼标定以及统一的坐标系定义,是决定系统能否稳定工作的基础工程问题。从仓储料箱抓取到工业柔性装配,再到家庭移动操作,空间具身新品类带来的不仅是设备形态的变化,更是一种以任务成功率和异常恢复能力为衡量标准的系统集成方式。解析空间具

weixin_33910759的博客 443

自动驾驶三大认知范式:端到端、VLA与世界模型演进路径

自动驾驶正经历从‘感知-决策-控制’流水线向统一智能体的范式跃迁。端到端模型通过原始传感器到控制指令的直接映射,提升数据利用效率与行为一致性;VLA(视觉-语言-动作)模型构建跨模态语义空间,使系统能理解‘黄灯→减速’背后的因果逻辑,支撑自然语言指令响应;世界模型则进一步引入可微分物理约束,实现反事实推演与长尾场景泛化。三者并非并列技术选型,而是代表‘学映射→学理解→学推演’的认知升维。当前工程落地的关键,在于突破模块割裂、语义鸿沟与仿真-现实鸿沟——这正是端到端训练优化、VLA物理引导对齐与世界模型梯度归

cong84596496的博客 371

具身意图感知:工业安全从被动告警到主动合规校验

具身智能是当前工业AI落地的核心范式,其本质在于系统对自身物理存在与环境约束的联合建模能力。不同于传统计算机视觉仅识别‘正在发生什么’,具身意图感知聚焦于‘为何在此不应发生’,通过多模态对齐、动态约束图谱和可验证推理,实现对人机操作目标与安全规程兼容性的毫秒级校验。该技术突破了行为识别的滞后性瓶颈,支撑起实时合规审计、临时工况响应、人机协同干预等高价值场景,正成为智能制造中安全合规数字化转型的关键基础设施。

weixin_34166472的博客 402

DriveGEN:面向自动驾驶的3D感知鲁棒性增强生成模型

在自动驾驶视觉感知中,3D理解的鲁棒性并非源于单纯提升2D图像质量,而是取决于模型对分布外输入(OOD)的几何一致性响应能力。传统数据增强与通用生成模型(如Stable Diffusion)缺乏对深度、表面法向、BEV空间等3D物理约束的硬性保障,导致增强后图像虽视觉合理却引发下游3D任务失效。DriveGEN作为一款条件可控的3D-aware生成模型,通过几何一致性损失与BEV一致性损失联合优化,在推理端实现像素级、语义不变且3D结构可信的实时增强,显著缓解雨雾、反光、遮挡等长尾场景下的语义歧义问题,为B

devon2014的博客 349

自动驾驶模型范式迁移:3D检测、端到端与VLM的物理重构

自动驾驶正经历从模块化感知到语义驱动系统建模的根本性转变。其核心在于突破传统2D→3D升维的几何建模瓶颈,以物理先验(如运动学约束、时空一致性)替代纯数据拟合;同时,端到端架构不再追求黑箱性能,而是通过VLM/VLA实现可验证的语义-动作闭环。这一演进使3D检测评估指标与真实风险对齐成为可能,也让功能安全认证(如ASIL-D)从障碍变为设计原生要求。当前技术价值已不在于提升nuScenes mAP,而在于构建具备物理合理性和失效可解释性的车载智能体——这正是本期聚焦3D检测几何重构、VLM语义升维与世界模型

weixin_30764883的博客 373

Oracle 11g版本下载及安装超详细教程图解

新手Oracle安装教程

weixin_43738344的博客 10万+

自动驾驶世界模型:从潜空间编码到车载物理实现

世界模型是自动驾驶迈向预判式决策的核心技术,其本质并非新AI模型,而是融合感知、预测与物理约束的统一表征框架。它通过将多源传感器数据映射至可微分潜空间,实现对动态场景的时间连续建模,支撑3D高斯泼溅(3DGS)的几何先验注入与视觉语言动作(VLA)的语义理解。技术价值在于突破传统‘感知-预测-规划’流水线的信息断层,提升长尾场景泛化能力与功能安全可验证性。典型应用场景包括城市NOA中的鬼探头响应、施工区自适应预测及雨雾天气鲁棒控制。本文聚焦其在真实车载环境中的三层物理实现与动态潜空间编码机制。

weixin_33853794的博客 713

Vue3项目实战:用vue-print-nb搞定多页表格打印(附样式不丢失解决方案)

本文详细介绍了在Vue3项目中,如何利用vue-print-nb插件解决Element Plus多页表格打印的样式丢失与分页错乱等核心难题。通过分离打印视图、编写专用CSS控制分页行为、以及深入理解浏览器打印原理,提供了一套从基础配置到高级技巧的完整企业级打印解决方案,确保打印输出专业可靠。

linux的博客 1233

撕开大模型的“物理盲盒”:OpenWorldLib 深度解析——给世界模型装上“统一操作系统”

大航海时代那种靠盲目堆叠参数(Scaling Law)就能抢占高地的粗暴红利期正在结束。我们正在进入一个需要严谨定义、标准化接口和底层系统架构设计的“大基建时代”。它告诉你,未来的 AI 不仅仅需要会作诗和画画,更需要懂得“水往低处流”和“苹果掉在地上会碎”。# 开启你的物理世界模拟之旅}, 20);// 20毫秒一次 (50Hz)**就业收益**:这套云边协同和轻量化部署的思路,直接击中了当前所有具身智能公司的痛点。带着这套实现方案去面试机器人大厂,绝对是极佳的敲门砖。------

542

离散数学期末复习笔记【精华版】

文章目录前言一、????理逻辑1. 命题逻辑2. 等值演算3. 主合取范式、主析取范式4. 【题】推理证明5. 辖域、自由变元、约束变元二、????合1. 环和、环积,幂集,笛卡尔乘积三、 ????????关系1. 自反、对称、传递2&3. 合成运算,逆关系、闭包4. 哈斯图、上下界、偏序5. 等价关系、划分四、????1. 幺元(么元、单位元)、零元、逆元,半群、群、阿尔贝群、独异点、循环独异点2. 【题】由表判断3. 【题】证明五、????论1. 简单图、平凡图、多重图、子图、补图、出度、入度、

林大夕可的博客 17万+

UE5抗锯齿实战:如何用TAA解决闪烁问题(附参数优化指南)

本文深入探讨了UE5中TAA(时间性抗锯齿)技术如何有效解决画面闪烁问题,并提供了详细的参数优化指南。通过基础参数配置、高级优化技巧以及材质层面的策略,帮助开发者显著提升视觉质量。文章还介绍了诊断工具链,助力快速定位并解决顽固闪烁问题。

solidity8miner的博客 428

世界模型与VLA在自动驾驶中的技术本质与工程选型指南

世界模型和VLA是当前自动驾驶系统构建物理世界认知的两大核心范式。世界模型聚焦于隐空间内的时空、语义与因果压缩,强调可解释性、确定性推理与功能安全;VLA则追求视觉-语言-动作的端到端联合表征,擅长处理弱结构化、需社会语义理解的开放场景。二者差异本质在于认知分工:前者支撑高置信度决策闭环,后者弥补不确定性交互缺口。技术价值体现在实时性保障(世界模型满足ASIL-D延迟要求)、数据效率(世界模型适配无标注视频,VLA依赖毫米级同步动作真值)及迭代敏捷性(世界模型支持模块热更新,VLA面临灾难性遗忘)。典型应用

weixin_34014555的博客 449

cesium 深度图(获取区域最高最低点位)

文章摘要: Cesium深度图技术可用于获取区域地形高程数据,核心实现步骤包括:1)通过离屏相机构建独立渲染环境,使用正交投影确保采样精度;2)采用离屏渲染技术获取均匀分布的地形点数据。关键技术点包含多边形外包矩形计算、后台相机配置(5km高度正交投影)、1024×1024像素离屏视图设置,以及深度数据解析(RGBA格式转换和三维坐标还原)。该方法避免了主视图干扰,可精准获取区域内地形高程信息,为填挖方分析等应用提供基础数据支持。

God's asylum的博客 283
上一篇: AI 风向转变:GPU 不再独美,CPU 借 Agent 与强化学习迎来事业第二春!
下一篇: DeepSeek与Kimi:知春路AI双星的技术默契、海外影响力与融资热潮
IT界那些事儿
博客等级 码龄6年 2万+粉丝 22原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值