


外界对DeepSeek期待复杂
外界对DeepSeek的期待变得具体而复杂,它能否重新证明技术领导力、将技术势能转化为营收,甚至用有限算力训练出“中国模型”?4月初,The Information报道DeepSeek V4将在4月下旬发布,且率先支持华为新一代AI芯片昇腾950PR。4月18日,该媒体又称DeepSeek正与投资者洽谈首轮外部股权融资,计划以不低于100亿美元估值,募集不少于3亿美元资金。不过,这些消息均未得到DeepSeek确认,且《财经》从相关资本机构了解到,The Information有关DeepSeek的估值和融资规模信息不准确。
市场传闻不断,发布频率低
有关DeepSeek的市场传闻几乎每月都有,但它几乎从不回应,却仍能引发市场广泛讨论。DeepSeek很少像其他模型公司那样及时公布业务进展。2025年1月DeepSeek - R1发布引发全球震动,此后一年,DeepSeek - V4/R2不断被传闻即将发布却一直未发布,也未高频率推出新模型。其最新模型DeepSeek - V3.2于2025年12月1日发布,截至2026年4月20日,已有近五个月未发布新模型,发布频率在主流模型厂商中几乎最低。据《财经》不完全统计,2025年12月1日 - 2026年4月20日,11家主流模型公司至少发布或迭代了50款模型,几乎每2.8天就有一款。
性能不再领先
由于五个月未发布新模型,DeepSeek - V3.2在最新基准测试中性能不领先。国际市场调研机构Artificial Analysis截至4月20日的测试显示,其综合性能、Coding性能、Agent性能分别处于全球第16名、第17名、第15名,落后于多家旗舰模型。它的相对排名未超越2025年1月发布的DeepSeek - R1。2025年12月1日发布的DeepSeek - V3.2对标多款旗舰模型,发布之初就存在差距,且发布后未像其他模型一样迅速迭代,导致与国际领先模型差距拉大。2026年是模型竞赛拐点,Coding能力对Agent任务很重要,DeepSeek - V3.2在这方面被拉开差距,对比国产模型也相对落后。前沿开发者考虑AI代码生成或Agent任务成功率时,不在意价格会优先选OpenAI、Anthropic旗舰模型,考虑性价比会选月之暗面、智谱、MiniMax等模型,DeepSeek - V3.2通常用于纯文本任务。
市场份额领先
尽管性能不领先,但DeepSeek - V3.2市场份额长期领先。它在全球模型聚合平台OpenRouter上的Token调用排名长期位居全球前五,截至4月20日月调用量达5.35万亿,位居全球第三,近五个月市场份额在5% - 10%之间。这得益于其定价在主流模型中几乎最低,每百万Tokens输入/输出价格是很多国产模型的10% - 30%,是OpenAI、Anthropic、谷歌Gemini旗舰模型的2% - 5%。而且,DeepSeek生命力强,即使五个月未发布新模型,各版本模型仍被广泛使用。其开源是关键因素,采用最宽松的MIT开源许可,开发者部署、使用、修改几乎无心理门槛和法律风险。OpenRouter数据显示,20多款不同版本的DeepSeek近三个月仍在被使用,且DeepSeek - V3.2被广泛部署在流行的Agent工具中,DeepSeek - V3/R1仍被AI角色扮演应用使用。免费、开源且版本众多,让DeepSeek在中国和全球发展中国家或地区有巨大影响力。
唯一未大规模商业化
DeepSeek市场份额庞大,但一直未开启大规模商业化。它是中国大模型创业公司中唯一专注研究和技术、未全面考虑商业化、坚定选择开源路线且未融过资的公司。其公开的商业化路径是通过官网调用模型API,但不稳定,开发者不一定通过官网调用,还可在云上部署免费的DeepSeek。开源策略也影响商业化,主流云厂商部署其模型却无需付费或分成。市场关注其是否融资,因为一旦融资,后续大概率会大规模商业化。今年3月,DeepSeek某高管透露一直在做努力和尝试,也初步验证找到一些路径。目前,主流模型公司几乎都脱离“纯研究”阶段,国内外模型厂商都在大规模商业化且收入快速增长,追求商业化和提升模型性能并不矛盾,但几家模型公司也在亏损。
市场期待国产芯片训练新模型
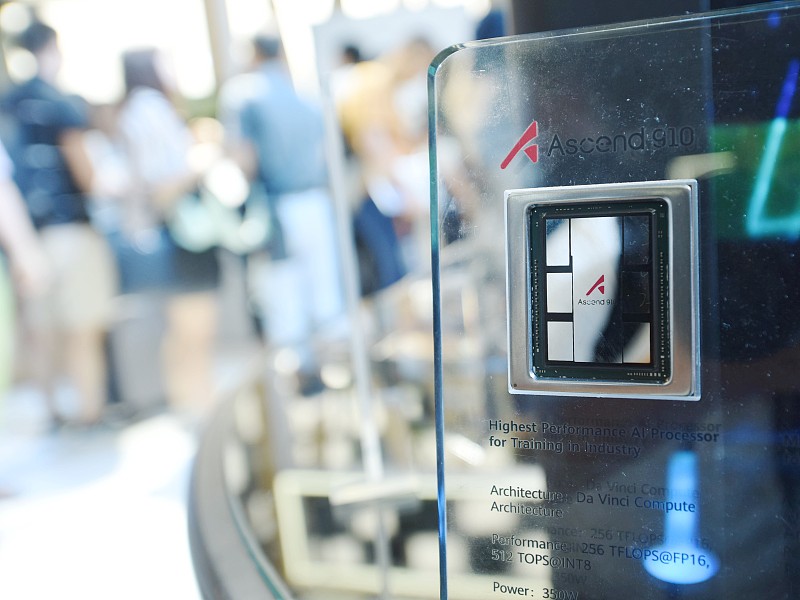
市场还关注DeepSeek新一代模型是否会提前适配华为昇腾950PR等国产AI芯片,甚至基于国产AI芯片完成训练。DeepSeek自建了AI Infra,研究团队有能力折腾算力集群等硬件基础设施,但能否用国产AI芯片训练出模型仍是未知数。一位算法工程师表示,新模型适配国产AI芯片在预期内,若能在国产AI芯片上从零开始训练并开源训练工具和经验,意义重大。英伟达创始人黄仁勋关注这一动向,认为DeepSeek在华为芯片上首发会威胁美国AI技术栈的全球领导地位。目前中国主要模型公司核心训练任务仍用英伟达芯片,从零开始训练全球领先基础模型且大规模使用和部署的完整工程路径未被公开验证。利用英伟达之外的芯片训练模型有难度,但并非不可能,已有一些国产AI芯片开始支撑部分国产模型的训练工作,但缺乏万亿参数规模以上且大规模商用的公开案例,国产AI芯片性能落后、软件栈不成熟,训练工程代价高。2025年初中国市场焦虑基础模型与美国的差距,2026年新焦虑是能否用国产AI芯片训练出足够强的国产模型,这种期待落到了DeepSeek身上。
 437


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


