Kimi推出最强代码模型K2.6,探索跨数据中心架构降本,为中国芯片打开推理大门

NIM平台上线GLM-5与Kimi K2.5:国产大模型推理标准化实践 大模型推理服务正从自建部署走向标准化交付,其核心在于模型、推理引擎与硬件加速的深度协同。TensorRT-LLM编译优化、FP8张量核心加速、KV Cache动态管理等关键技术,显著提升吞吐与稳定性,降低长上下文场景下的延迟抖动。这种工业级推理范式不仅支撑GLM-5在结构化任务中的高精度输出,也保障Kimi K2.5在超长文本(200K+ tokens)和中文语境下的鲁棒响应,为教育、中小团队及个人开发者提供零运维、低门槛、可对比的模型即服务体验。本文聚焦NVIDIA NIM平台对国产大模型的工程化集成路径 阅读详情

小插曲:Kimi与DeepSeek或再撞车

4月20日晚间,Kimi宣称“K2.6是我们迄今为止最强代码模型”,并推出开源模型K2.6,距K2.5发布约一个季度。传闻本周DeepSeek V4将发布,若按预期推进,这将是Kimi和DeepSeek的第N次撞车。在底层基础设施层面,Kimi和DeepSeek这两个大模型创业公司,将与国产芯片创业公司共进退。

技术路线与模型迭代

2026年3月,杨植麟在英伟达GTC演讲谈及Kimi技术路线图,指出当前技术标准渐成Scaling瓶颈。为解决问题,Kimi贡献二阶优化器MuonClip、Kimi Linear架构和Attention Residuals。杨植麟认为Kimi进化逻辑包括Token效率、长上下文及智能体集群“合体”,K2.6是该路径下新成果。代码是前沿模型必争之地,Kimi开源模型保持约一季度迭代节奏,小版本号暗示杨植麟或有更多底牌。

K2.6性能亮点

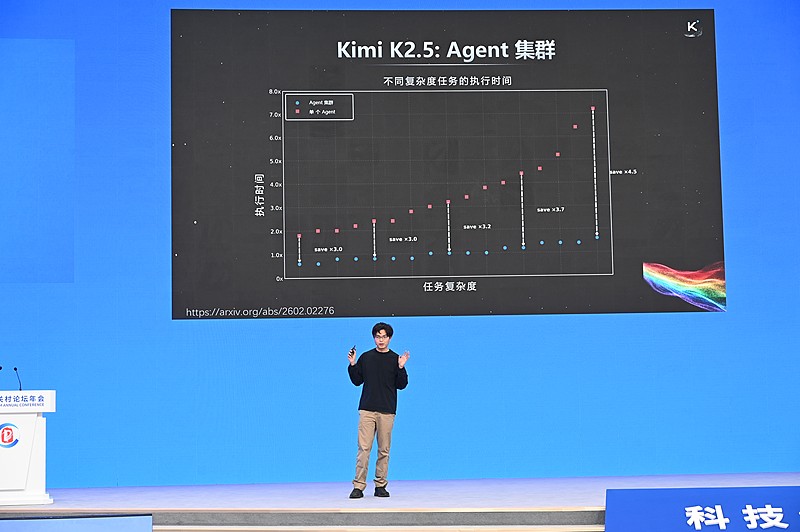
Kimi称K2.6长程编码能力显著提升,测试中可不间断编码13小时,编写或修改超4000行代码,在Kimi Code Bench中成绩比K2.5提升约20%。K2.5曾在OpenRouter 2月霸榜,联合创始人张宇韬貌似很满意。在通用Agent等基准测试上,K2.6对Agent框架核心提升在API调用精准性和长时间运行稳定性。K2.5提出“Agent集群”概念,K2.6进一步放大该能力,最多支持300个子Agent并行完成4000个协作步骤。K2.6亮点包括代码和长程任务能力、Agent集群能力进化及与主流Agent框架适配优化,Agent集群能力最具价值。K2.5被学界研究员评价无短板,可作科研助手,K2.6效果值得期待,在Artifacial Analysis智能榜单中仅次于三家闭源模型,领跑开源模型权重榜单。

新论文与架构探索

3月中旬,Kimi发布Attention Residuals论文,马斯克称是“令人印象深刻的突破”。上周末,Kimi发布新论文提及架构新探索,核心讨论PD分离。PD分离旨在解耦计算和带宽密集型任务,降本增效,但需基于同机房RDMA高速网络。Kimi论文基于混合模型缩减KV缓存体积,将Prefill和Decode解耦到不同异构集群。实验示例显示了集群配置和测试模型,实测结果表明PrfaaS - PD跨数据中心方案吞吐量提升54%,P90 TTFT降低64%,跨数据中心KV缓存传输带宽仅占13%。论文还通过实验证明混合模型架构可将KV缓存传输需求压至普通以太网可承载范围。

Token降本与国产芯片机遇

Kimi官方称“跨数据中心 + 异构硬件”可降低单token成本。此前提到模型、硬件层面有优化空间,胡延平教授强调降本需多方面因素。在预填充即服务论文中,异构硬件启示可用国产卡降本增效。Kimi为中国芯片打开大模型推理大门,但国产算力要接住流量利好仍需解决生态问题。过去中国大模型因生态难题被卡在国产算力之外,且H20已断供一年,推理芯片短期内只有国产选项。随着推理需求暴涨,中国大模型对国产算力依赖增强。很多预测称DeepSeek V4在适配国产算力,Kimi已为中国模型 + 中国芯片结合探索出可行路径,率先伸出橄榄枝,问题交给国产芯片创业公司。黄仁勋曾表示禁售阻挡不了中国芯片进步,DeepSeek和Kimi的下一步给出答案。

schrodinger 薛定谔 链接: https://pan.baidu.com/s/1Duh4GsoytIklvZp7TdHpWg 密码: wmr1 Linux系统版 进入 Schrodinger_Suites_2021-2_Linux-x86_64 sudo ./INSTALL 中间按默认的来即可,也可以自己调整安装目录。安装目录一定要记住。 安装完,把patcher 拷贝到安装目录 sudo ./patcher 点击Patch即可。 启动程序,进入安装目录 ./maestro ... 阅读详情

相关推荐

HFSS与AI融合:智能算法如何重塑天线设计流程

本文探讨了HFSS与AI融合如何通过智能算法革新天线设计流程。在5G/6G通信时代,AI技术如机器学习和遗传算法显著提升了高频电磁场仿真效率,将传统设计周期从数周缩短至数小时,并优化了天线性能。文章详细介绍了AI与HFSS的集成策略、关键技术突破及典型应用案例,展示了智能算法在天线设计中的巨大潜力。

weixin_29035147的博客 781

月之暗面科技开源kimi核心推理架构:“月饼”

而且,传统的LLM服务架构通常都假设有足够的资源来处理所有的请求,但随着需求的增加,特别是在高峰时段,这变得越来越难。实验结果表明,与基线相比,月饼在模拟场景中实现了高达五倍的吞吐量增加,并在现实世界的工作负载下实现了75%更多的请求处理。月饼利用以KVCache为中心的预填充-解码(PD)分离技术和存储-计算解耦架构,显著提高了月之暗面科技的LLM服务Kimi的推理吞吐量。这种分离带来了显著的性能提升。未来,他们还计划在传输引擎的基础上构建月饼存储,它支持池化的KVCache,以实现更灵活的P/D解耦。

qianggezhishen的专栏 1937

Unity WebGL项目如何实现画布透明,完美融入网页背景(附.jslib文件与完整配置)

本文详细解析了Unity WebGL项目实现画布透明化的技术原理与实战步骤,从.jslib文件配置到前端框架集成,帮助开发者解决默认背景色问题,实现3D内容与网页设计的无缝融合。重点介绍了透明化核心机制、常见误区及React/Vue等现代框架中的最佳实践方案。

weixin_31896061的博客 301

2026年大模型横评:DeepSeek V4 vs GPT-5.5 vs Kimi K2.6实测对比

DeepSeek V4发布一周了,各种测评满天飞,但大多数要么只跑benchmark,要么只试一两个case就下结论。日常开发中,这些模型到底哪个好用?(1.6万亿参数,MIT开源,API价格约$0.28/百万token)GPT-5.5(OpenAI旗舰,API价格约$2.80/百万token)Kimi K2.6(月之暗面最新版,中文优化,API价格约$1.20/百万token)本文全部数据来自实际API调用测试,测试脚本和prompt已上传GitHub,欢迎复现。

csdngouwei的博客 5576

基于紫光展锐平台的音频调用到hal层逻辑

基于紫光展锐平台的音频调用到hal层逻辑 1、数据流程图 AudioPolicyService和AudioFlinger的创建: 这两个服务都在audioserver中启动,文件路径: frameworks/av/media/audioserver/main_audioserver.cpp 从AudioFlinger和AudioPolicyService的创建,到output的打开,以及AudioFlinger开始往底层写入数据的具体流程如下图: #mermaid-svg-kjHL4XWwkQXN6NdA

weixin_55053963的博客 1355

SPI 总线信号完整性与时序一致性测试

SPI总线测试的核心目标是验证其电气与时序行为是否满足芯片规格要求,确保通信可靠性

硬核科技 332

一文了解大语言模型推理性能优化关键技术之 PD 分离及典型的 PD 分离方案

本文首先明确大语言模型推理系统的关键性能指标,继而剖析预填充(Prefilling)与解码(Decoding)这两个阶段的核心特征。基于上述分析,本文指出:持续批处理(Continuous Batching)采用阶段隔离与抢占机制,虽有助于提高系统吞吐量并降低首令牌延迟(Time To First Token,TTFT),但会显著增加词元间延迟(Token-to-Token Delay,TBT),进而对端到端(End-to-End,E2E)延迟造成不利影响。最后,本文简要回顾了预填充与解码相分离(Prefi

叶庭云 成为自己的光 5835

OpenClaw人人养虾:配置通义千问(Qwen)

通义千问(Qwen)是阿里云推出的大语言模型系列。OpenClaw 支持通过 Qwen Portal 插件实现 OAuth 免费额度认证,每日可免费使用 2000 次请求,无需绑定支付方式。

王国平的博客 1270

大模型推理-基于prefill和decode阶段特性,PD分离,势在必行!

• 服务级目标 service level objectives (SLO):为提供一个满意的用户体验,大模型推理服务需要满足的一系列指标,一般包括首字延迟 (TTFT),平均出词时间(TPOT),端到端延迟(E2E),指数移动平均(EMA)。• 首字延迟 time to first token latency (TTFT):模型服务产生首字的延迟时间。• 平均出词时间 time per output token (TPOT):模型服务生成单字的平均时间,生成token的总时间处于总token数量。

2401_84495872的博客 4156

客服转人工率直降60%!OpenClaw深度集成NLP引擎,打造企业级对话自动化智能客服系统

本文介绍了一套基于OpenClaw智能体框架和NLP大模型引擎的智能客服系统解决方案。该系统通过深度集成NLP引擎实现精准语义理解,采用分层架构设计支持多渠道接入和业务系统对接,显著提升了客服效率。核心亮点包括:92%的重复问题自动解决率,60%的转人工率下降,40%的人力成本降低,以及从30秒压缩至0.5秒的平均响应时长。文章详细阐述了技术选型、系统架构设计、核心模块实现等关键环节,展示了如何通过智能对话系统破解传统客服业务中的人力资源与服务质量矛盾。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 363

2026 企查查/天眼查:IP频率限制 + 验证码策略,企业工商数据采集实战

企业工商数据采集技术解析与解决方案 本文深度剖析了2026年企查查和天眼查平台的反爬机制与技术对抗方案。主要内容包括: 反爬机制分析: 采用JA4+ TLS指纹识别、极验v6验证码等多层防护 IP限制策略严格区分未登录/普通/VIP账号 精准识别并封禁数据中心IP 核心解决方案: 构建高可用住宅代理池,动态轮换真实用户IP 基于YOLOv8的验证码缺口识别技术(准确率99%) 分布式架构设计,支持千万级数据采集 多账号池管理与行为模拟技术 技术亮点: 动态住宅IP池实现1%以下封禁率 Playwright浏

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 1330

Kimi推出开源模型K2.6:代码与Agent能力进化,探索Token降本与国产芯片适配路径

需要注意,H200和H20在芯片架构上仍然是Hopper架构,论文提到的异构代指带宽、算力上的异构,它的启示在于:可以用一部分算力强的国产卡来做Prefill,或者带宽强的国产卡来做Decode,当然也可以与海外卡混用来实现降本增效。换句话说,推理芯片短期内只有国产一个选项。有人认为Agent集群是最有价值的一个能力,它直接将并行计算爆炸性能力具象化了——无论是代码,还是长程任务的稳定性,这些都是模型迭代必须去做的事情,更重要的是,基于这些能力提升,推动Agent的工作方式、效率甚至是交互方式创新。

IT界那些事儿 237

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

2026年2月-哪款大模型编程最强?GPT-5.3、Claude Opus 4.6、GLM-5、Kimi K2.5、MiniMax M2.5、Gemini 3 Pro 和 DeepSeek v3.2

顶级梯队(Frontier Models)这三款模型代表了当前大语言模型技术的最高水平,在推理能力、多模态处理、长上下文管理等关键维度全面领先其中 Claude Opus 4.6 在长上下文推理和终端操作方面表现最佳,GPT-5.3 在编程能力和智能体任务上优势明显,Gemini 3 Pro 则在多模态融合能力上独占鳌头高性能梯队(High-Performance Models)这些模型在特定领域展现出与顶级梯队相当甚至更优的性能,同时在成本效益方面具有明显优势。

言之。 1万+

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

文档:亲测可用解决vnc灰屏,黑屏,鼠标大黑叉情况

主要解决vnc-viewer灰屏,黑屏,鼠标大黑叉等现象,详细见文档。

Kimi 2.5与Kimi 2.7版本全面对比解析

Kimi 2.5与Kimi 2.7版本全面对比解析

【可全包】本人程序员,不需要做任何吹嘘,只是实在写点程序,写点文档,熟悉各类主流框架,SSM,SpringBoot,Flask,Djiango,Mysql,Sqlite,VUE,Uniapp等,各类程序设计专家,优质作者 4274

2026年春节后,AI大模型格局彻底变了——Claude 4.6、GPT-5.2与六大国产模型全面横评

使用场景推荐模型企业级Agent/自动化(不计成本)企业级Agent/自动化(性价比优先)数学竞赛/极限推理开源自部署(中文生态)最低成本API调用国内政务/教育/搜索集成文心5C端多模态产品豆包 2.0大规模代码仓库维护2026年的AI竞争已经不是单点的能力比拼,而是能力、成本、生态与合规四个维度的综合博弈。Claude Sonnet 4.6的出现,让"旗舰级能力"第一次以中端价格大规模普及;

nmdbbzcl的博客 5211

无需人类干预,300 轮自主思考!Kimi K2 Thinking 模型发布,多项基准达 SOTA

月之暗面发布新一代开源模型KimiK2Thinking,实现"模型即Agent"突破。该模型具备300轮自主思考与工具调用能力,在Humanity's Last Exam测试中取得44.9%的SOTA成绩,网络浏览能力达人类水平的2倍。支持原生INT4量化推理,速度提升2倍,已上线Kimi产品并开放API。此次升级标志着AI从助手向自主问题解决者的转变,特别擅长多步推理和长程规划任务。

OpenCSG的博客 1270

Kimi K3:智能的新前沿

为了复现计算天体物理中的 I-Love-Q 普适关系,它阅读并交叉验证了 20 多篇论文,实现了完整的数值流程,评估了 300 多种状态方程,发现了已发表公式中的不一致之处,生成了 3,000 多行 Python 代码,并产出了一个用于探索结果的交互式 HTML 仪表盘。1. 对历史思考内容敏感: Kimi K3 在后训练过程中全程使用思考历史保留模式,如果 agent 框架未按要求回传全部历史思考内容,或从其他模型正在进行的会话中切换到 Kimi K3,则有可能引发上下文干扰,导致内容生成质量不稳定。

具身机器人和通用AI 576

中国芯片,DeepSeek与Kimi的隐秘交点

如果要从上述的功能特性里面找一个个人的偏好,我认为Agent集群是最有价值的一个能力,它直接将并行计算爆炸性能力具象化了——无论是代码,还是长程任务的稳定性,这些都是模型迭代必须去做的事情,更重要的是,基于这些能力提升,推动Agent的工作方式、效率甚至是交互方式创新。1月份上线的K2.5当中,Kimi提出了“Agent集群”的概念,将一项任务拆分成多个子项目,自动化分配给不同领域的Agent来跟进处理,进而缩短任务处理的失效,同时避免串行任务流下整个项目崩溃的可能性。

2501_91883294的博客 615

Kimi K3!全球首个3万亿级开源模型王者

月之暗面今天放出了 Kimi K3,这个模型有2.8万亿参数,是全球首个开源的3万亿级别模型。它在长程编程、知识工作和推理这些前沿场景里,整体实力接近最强的闭源模型 Claude Fable 5 和 GPT-5.6 Sol。但在 Frontend Code Arena 中,Kimi K3 以1679分超越 Claude Fable 5,位居第一。其他部分基准测评上,也超越了 Claude Fable 5 和 GPT-5.6 Sol。

SuaniCommunity的博客 338

Kimi发布2.8万亿参数开源模型Kimi K3,多维度评测亮眼且成本低于闭源模型!

Kimi K3发布推动开源模型迈向超大规模,更值得关注的是其长程任务执行探索,展示了大模型从内容生成向复杂任务执行和完整工作流交付的延伸。但模型规模扩大后,提升推理效率、降低成本、缩小与顶级闭源模型体验差距仍是开源模型发展需解决的问题。

IT界那些事儿 100

2.8万亿参数开源神作!Kimi K3 正式发布:48小时自主设计AI芯片,长程代码能力直逼克劳德寓言5?

摘要: 月之暗面开源2.8万亿参数大模型KimiK3,刷新全球开源模型规模纪录,获马斯克公开点赞。其核心突破包括: 技术架构:采用KDA混合注意力与超稀疏MoE设计,支持百万级上下文,计算效率提升2.5倍; 硬核能力: 登顶UCBerkeley编程榜,超越ClaudeFable5; 48小时零干预完成AI芯片全流程设计(Verilog→GDSII); 开发者实践:提供兼容OpenAI的Python API,支持长上下文缓存优化(成本低至$0.3/百万Token),模型权重将于2026年7月全量开源。 Kim

lzj781210的博客 978

Kimi K3 全球首发:2.8T 参数开源,首个 3T 级大模型登场

今天,我们正式推出 Kimi K3——我们迄今为止最强的模型。Kimi K3 是一颗**2.8T 参数**的大模型,基于自研的与架构,具备**原生视觉能力**和**1M token 上下文窗口**。它是**全球首个开源的 3T 级模型**,专为长程编码 (long-horizon coding)、知识工作和推理而设计,面向 frontier intelligence 这一目标。虽然整体性能仍落后于目前最强的闭源模型和。

专注 AI 大模型 API 与 Token 中转服务,提供稳定、低延迟、高并发的多模型调用解决方案。 159

Kimi K3震撼发布:2.8万亿参数开源大模型改写AI格局

Kimi K3的发布,不仅刷新了开源模型的参数上限,更重新定义了高性能AI的获取方式。本地微调自由:企业可将模型部署于私有机房,结合业务数据进行定制化训练;审计透明自由:开发者可审查权重与推理过程,确保模型行为符合预期;私有部署自由:金融、医疗等高合规行业可在不泄露敏感数据的前提下使用前沿AI能力。正如月之暗面官方所言:“K3的整体表现仍落后于Claude Fable 5和GPT-5.6 Sol,但在特定前沿任务上已展现出稳定领先能力。” 这种坦诚,恰恰体现了技术自信。

weixin_69359007的博客 544

Kimi K3 开源登顶编程榜、WAIC 2026:中国 AI 生态的系统化崛起

Kimi K3 开源模型在编程基准上击败 GPT 和 Claude,WAIC 2026 展示中国 AI 全产业链实力。深度解析中国 AI 生态从单点突破到系统化崛起的趋势。

2404_89164415的博客 139

Sam Altman 承认「搞砸了」,阿里芯片对标英伟达,国产三巨头 DeepSeek、Kimi、Qwen 同周炸场!| AI Weekly 1.26-2.1

Sam Altman 承认「搞砸了」,阿里芯片对标英伟达,国产三巨头 DeepSeek、Kimi、Qwen 同周炸场!| AI Weekly 1.26-2.1

hunteritself的博客 1059

国产大模型全员实现半步fable5?迈入 2T+ 时代:2.8T Kimi K3 官宣开源,2.4T Qwen 3.8 Preview 上线

Kimi K3 与 Qwen3.8 的发布,意味着国产基础模型竞争已经从"参数规模"进入"工程能力"的新阶段。对于多数开发团队而言,真正需要解决的不只是"选哪个模型",还有模型的持续接入与管理。相比自行维护多个模型接口,通过平台统一调用通常更加省心。例如魔芋 AI MaaS提供统一 API 接入多家主流模型,支持通过一个 API Key 灵活切换不同模型,在兼顾价格、响应速度、稳定性和安全性的同时,也降低了多模型协同和后续迁移的成本。通过链接注册可获百万token包福利。

JJJennie777的博客 629
上一篇: ChatGPT Images 2.0发布:跨越“意图鸿沟”,重塑AI图像生成格局
下一篇: DeepSeek:技术领先不再,开源优势仍在,商业化与国产芯片训练成关键考验
IT界那些事儿
博客等级 码龄6年 2万+粉丝 22原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值