Day 5 --- OpenMMLab系列之目标检测基础(二)

【七班】MMPose代码实践与耳朵穴位数据集实战【OpenMMLab AI实战营第二期Day3+作业1】 但是Linux操作系统操作中是有问题的,!wget https://zihao-openmmlab.obs.cn-east-3.myhuaweicloud.com/20220716-mmclassification/dataset/SimHei.ttf -O /environment/miniconda3/lib/python3.7/site-packages/matplotlib/mpl-data/fonts/ttf/SimHei.ttf中,下载的文件似乎有问题无法生效,且下载路径不准确, 阅读详情

三、算法概述

在近些年的发展中,各类目标检测算法层出不穷,不过大体上可为以R-CNN为代表的两阶段算法以及以YOLO为代表的单阶段算法,下面将对这两种算法进行简单概述:

1、两阶段算法

两阶段算法主要包含区域提议和区域识别两个阶段,通过结合先进Backbone和多尺度FPN技术可以实现较为优越的检测精度,使用范围也较广。
image.png

R-CNN

R-CNN中采用Selective Search方式生成候选提议框,避免了传统方法中穷举式滑窗所带来的繁琐。在生成候选区域后,R-CNN模型采用基于AlexNet的CNN模型进行特征提取,以取代传统HOG特征或Haar特征方法。提取出的特征会被送到SVM分类模型中,每个类别对应一个SVM分类器,选取最高置信度作为结果。

在模型测试阶段,R-CNN中采用NMS非极大值抑制方法以获取无冗余的区域子集。
yuque_diagram.jpg
虽然这种方法相较于传统DPM方法在效率和精度上有所提升,但在候选区生成阶段,由于模型至少生成2000个以上候选框,每个框在CNN中传播时都要耗费大量时间,且由于重叠部分会通过相同卷积核计算两次,缩放会导致计算结果不同,从而检测出不同结果。例如对于重叠的人骑马部分,有时会检测成人,有时会检测成马。

Fast R-CNN

Fast R-CNN是为了减少R-CNN计算量而诞生的,该方法在产生提议框阶段保留了R-CNN中的Selective Search方法,仍依赖传统CV方法。但针对第二阶段区域识别任务,该模型将卷积层由之前的仅应用提议框改为应用到全图,从而一次性计算出所有位置图像特征,随后裁剪出提议框所对应区域的特征图,将其送入全连接层进行计算分类,不过需要注意的是,由于提议框大小不同,因此特征区域需要通过RoI Pooling或RoI Align方法处理为固定尺寸后,才可输入全连接层。
image.png

2、单阶段算法

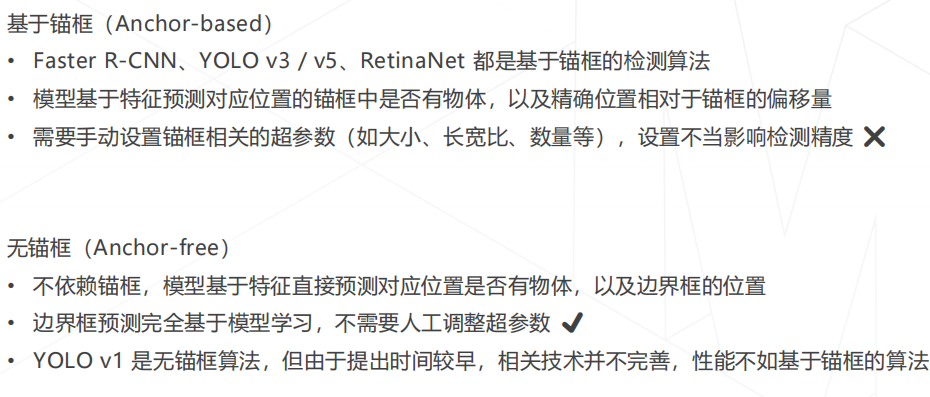
与两阶段算法中对锚框进行二分类来区分是否存在目标物体不同,单阶段算法在生成全局特征图后,直接对每个锚框进行多分类来以此提高检测效率,通过这种方法提出的模型结构简单、速度快,且易于在设备上部署,在工业界很受欢迎,虽然早期因为主干网络和多尺度技术不成熟问题在性能上弱于两阶段算法,但随着算法性能的不断提升,目前逐渐成为目标检测的主流方法。
image.png

YOLO

作为最早的单阶段算法之一,YOLO将目标检测问题转化为直接从图像中提取边界框和类别概率的回归问题,直接输出目标类别和位置,其自行设计的DarkNet结构由两层全连接层作为检测头预测结果,输出预测框位置以及预测框和真实值的IoU Score。
image.png

YOLO将原图切分成 S×S 大小的格子,对应预测图上 S×S 个位置,如果原图上某个物体的中心位于某个格子内,则对应位置的预测值应给出物体类别和B组边界框位置,其余位置则预测为背景类别,不涉及边界框预测结果

在Pascal VOC数据集上,YOLO使用VGG 16作为backbone后,相较于同样backbone的Fast R-CNN,可以达到三倍的检测速度

但由于每个格子只能预测 1 个物体,因此对重叠物体、尤其是大量重叠的小物体容易产生漏检,而直接回归边界框有难度,回归误差较大,故自YOLO v2 开始使用锚框。

样本不均衡问题: 需要注意的是,在单阶段算法中,需要对每个锚框进行多分类任务,在训练时计算每个预测的分类损失。但是显然在图像中,锚框的数量常常远大于真值框,即存在大量的锚框其所预测的真值仅为背景部分,这部分数据即为目标检测时的负样本。这些负样本占据数据的主要部分,会使得训练出的分类器更倾向于预测背景,从而出现漏检现象,而两阶段检测器通过区域提议拒绝了大量负样本,区域检测头接收的正负样本比例并不悬殊,因而不会出现该问题,检测精度也高得多。

对于这种样本不均衡问题,单阶段算法需要进行专门处理,YOLO中针对正负样本采用了不同的权重,面对比例严重失衡时效果颇为不错。SSD中则是采用困难负样本挖掘策略,即选取分类损失最大的部分负样本(困难负样本)计入损失,将正负样本比例在 1:3。

3、无锚框算法
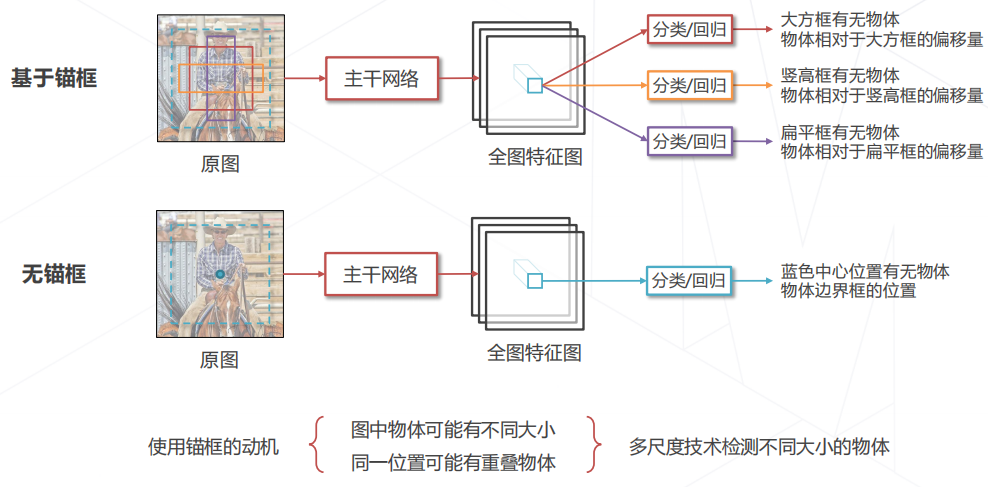
image.pngimage.png

四、目标检测新范式 —DETR

在之前的目标检测任务中,大部分的目标检测方法还需要NMS进行后处理来消除冗余框,但由于并非所有硬件都支持NMS,因此使得模型的调参和优化都非常困难。DETR脱离了密集预测范式,依靠Transformer的全局建模能力,其将目标检测建模转为集合预测问题,也避免了造成冗余框产生
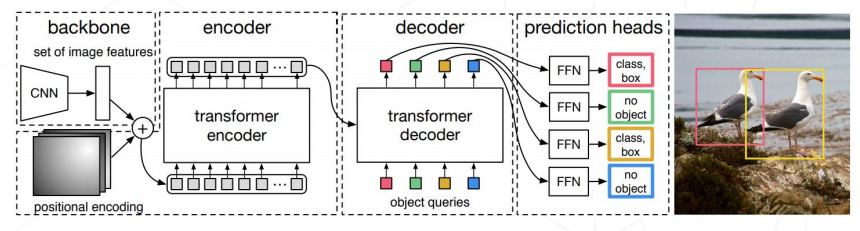
image.png

1、主要工作

  1. DETR将一系列锚框看作一个集合,针对给定的图像去预测该集合,实现了将目标检测问题转为集合预测问题
  2. 去掉了对人先验知识的依赖,如NMS和Anchor生成,真正实现了End-to-End的目标检测框架
  3. 采用二分图匹配策略,强制模型输出唯一的预测结果,避免了大量冗余框生成
  4. 采用Transformer Encoder和Decoder结构,在采用解码器时还加入了另一个输入可学习的Object Query,在给定Object Query后,DETR会根据这些Query和全局图像的结合,采用注意力操作生成唯一预测框
  5. DETR在全景分割领域也取得了不错的结果,仅需在尾部加一个DETR专用的分割头,大体结构无需变化

2、主体结构

DETR的最终输出是一个固定的集合,对于任意的Input均有N个输出,通常N的数量要大于图像中的实际物体数,在论文中,作者设置的N=100

  1. 二分图匹配

    DETR中采用最优二分图匹配(匈牙利算法)减少冗余框生成,假设存在3个工人,对于其完成三个任务x,y,z所组成的损失矩阵,二分图的本质是找到一个唯一解,使得完成三个工作的代价最低。

  2. 损失函数

    在DETR中,三个工人即为N个生成框,ground truth即为需要完成的三个工作,损失矩阵cost matrix即为分类loss和框的准确度loss。
    Loss=−l{ci≠ϕ}P^σ(i)(ci)+l{ci≠ϕ}Lbox(bi,b^σ(i)Loss=-l_{\{c_i \not=\phi \}}\hat{P}_{{\sigma(i)}}(c_i)+l_{\{c_i \not=\phi \}}L_{box}(b_i , \hat{b}\sigma(i)Loss=−l{ci​=ϕ}​P^σ(i)​(ci​)+l{ci​=ϕ}​Lbox​(bi​,b^σ(i)
    加号前部分为分类Loss,后面部分为框Loss

  3. 主体

    为了让模型收敛更快,作者在计算loss时在Decoder后加入很多Auxiliary Loss,即额外目标参数,这种思路在目标检测和分割领域很常见,即不仅在最后一层计算loss,在Decoder层中也进行Loss计算,因为每个Decoder的输出均为100x256,故均可在这些100x256输出上作FFN来获得输出,这些FFN参数共享

3、训练流程

  1. CNN进行特征提取,将特征输入到Transformer Encoder-Decoder结构中
  2. Encoder进一步学习全局信息,为后续Decoder作铺垫
  3. Decoder输出生成框,在Decoder过程中,Object Query会不停与特征进行交互,限定生成框数量,在Decoder中进行自注意力操作,生成最终生成框
  4. 模型推理阶段不同于训练阶段,无需最后的二分图Loss,仅在第三步处设置一个阈值来规定输出置信度即可,模型会保留大于置信度的物体,剩余归为背景类

注:在DETR论文中,框数被认为限制为100,即针对每张Input都会生成100个框,为了令100个框与Ground Truth作匹配计算loss,作者将之看作集合预测问题,通过二分图匹配的方法计算Loss

五、评估方法与评价指标

  • 正确结果(TP):算法检测到物体,图中也有该物体,检测结果正确
  • 假阳性(FP):算法检测到物体,图中没有这个物体,检测结果错误
  • 假阴性(FN):算法没有检测到物体,图中有该物体,检测结果错误
  • 正确结果(TN):算法没检测到物体,图中没有物体,检测结果正确

检测到的衡量标准:对于某个检测框,图中存在同类型的真值框且与之交并比大于阈值(通常取0.5)

准确率: 表示正确识别物体数占总识别出物体数的百分比,用来衡量算法模型的查准程度
Precision=TPTP+FPPrecision = \frac {TP} {TP + FP}Precision=TP+FPTP​
召回率: 表示正确识别物体数占测试集中物体总数的百分比,用来衡量算法模型的查全程度
Recall=TPTP+FNRecall = \frac {TP}{TP+FN}Recall=TP+FNTP​
真值框总数(TP+FP)与检测算法无关,因此只需将检测结果区分为 TP 和 FP 即可计算 recall 和 precision

AP(average precision):计算单类别的平均准确度。

m AP @0.5:计算每一类别 IoU 设为 0.5 时的 AP,对所有类别的 AP 求平均值。

【七班】人体姿态估计概论笔记【OpenMMLab AI实战营第二期Day2】 【课程说明】人体姿态估计(Human Pose Estimation)是计算机理解人类动作、行为必不可少的一步,本次课程涵盖人体姿态估计的介绍与应用、2D 姿态估计、3D 姿态估计、DensePose、Body Mesh 以及 MMPose 等内容。【讲师介绍】卢策吾 上海交通大学电院计算机系教授、博士生导师。【课程地址】【ToDo】本课作为概论性质的介绍,内容挺多,因此打算再分为两到三次笔记进行学习和总结,敬请期待!0. 人体姿态估计的介绍与应用什么是姿态估计? 阅读详情

相关推荐

RT-DETR论文解读与代码

目前以大名鼎鼎的YOLO为代表的基于CNN的实时监测网络需要NMS进行后处理,导致不能很好的优化网络,并且网络不够健壮,从而导致检测器的推理速度出现延迟。研究者也分析了Anchor-based和Anchor-free的YOLO的性能,发现Anchor并不是影响实时监测的关键要素,而NMS后处理彩色。DETR很好的解决了后处理对于模型的限制,却受限于Transformer巨大的计算量,无法发挥实时监测性。因此,作者想要重构detr,使其具有实时性。

qq_52053775的博客 7181

7、DETR:基于Transformer的端到端目标检测

尽管在速度上可能不如一些专门为实时应用设计的检测模型,DETR的架构为未来的研究和应用提供了一个有趣的新方向。包括编码器和解码器。,可以发现,不同于Faster RCNN, RetinaNet等方法在特征的每个像素上构建稠密的anchor不同,detr只用少量稀疏的anchor(object queries)做预测,这也启发了后续的一系列工作。:DETR彻底改变了目标检测的传统流程,实现了真正的端到端训练,将图像特征提取、目标定位和分类任务全部整合在Transformer中,提升了模型的整体优化效果。

sinat_34461199的博客 1392

代码审计工具学习之RISP(安装以及初步操作)

1 代码审计 1.1名词解释 代码审计(Code audit)是一种以发现程序错误,安全漏洞和违反程序规范为目标的源代码分析。软件代码审计是对编程项目中源代码的全面分析,旨在发现错误,安全漏洞或违反编程约定。 它是防御性编程范例的一个组成部分,它试图在软件发布之前减少错误。 C和C ++源代码是最常见的审计代码,因为许多高级语言(如Python)具有较少的潜在易受攻击的功能(例如,不检查边界的函数)。 顾名思义就是检查源代码中的安全缺陷,检查程序源代码是否存在安全隐患,或者有编码不规范的地方,通过..

weixin_52515588的博客 1万+

【计算机视觉 | 目标检测】RT-DETR:DETRs Beat YOLOs on Real-time Object Detection

【计算机视觉 | 目标检测】RT-DETR:DETRs Beat YOLOs on Real-time Object Detection

wzk4869的博客 8440

避坑指南:ZYNQ MPSOC QSPI固化时MT25QU256闪存的特殊配置

本文针对Xilinx ZYNQ UltraScale+ MPSoC平台,详细解析了使用Vitis工具将BOOT.bin固化至Micron MT25QU256ABA QSPI NOR Flash时的特殊配置与避坑指南。重点阐述了Init文件的真实作用、电压与频率的精确匹配策略,以及针对该闪存型号的初始化序列,帮助工程师解决烧录失败、启动异常等常见问题,确保系统可靠启动。

weixin_29175469的博客 270

【漏洞修复】Diffie-Hellman Key Agreement Protocol 资源管理错误漏洞(CVE-2002-20001)

Diffie-Hellman Key Agreement Protocol 存在安全漏洞,远程攻击者可以发送实际上不是公钥的任意数字,并触发服务器端DHE模幂计算。

我的博客 1万+

【OpenMMLab】AI实战营第二期Day6:目标检测与MMDetection

这篇文章讨论了目标检测和MMDetection,并介绍了相关的基本思路和概念。

墨门 1252

miRNA测序数据生信分析——第二讲,数据库下载整理

一个非编码RNA的整合数据库,可用来识别鉴定各种类型的ncRNA。提供的是ncRNA在基因组上的基因序列,而非转录成熟ncRNA的序列。最新版:2022-11-02Rfam数据库中ncRNA类型分三大类:Cis-reg和Gene和Intron。这三大类又有子类。一个提供包括miRNA序列数据、注释、预测基因靶标等信息的全方位数据库,是存储miRNA信息最主要的公共数据库之一。最新版:2018-12-01。

weixin_44616693的博客 4098

You Only Look One-level Feature

You Only Look One-level Feature 翻译:You Only Look One-level Feature - 追风赶月的少年 - 博客园 (cnblogs.com) 目标检测算法YOLOF:You Only Look One-level Feature - 云+社区 - 腾讯云 (tencent.com) YOLOF:You Only Look One-level Feature(CVPR 2021) - 知乎 (zhihu.com) 代码:https://github.com/

qq_44810144的博客 509

QGis软件 —— 2、QGis加载在线地图两种方式(谷歌地图、天地图)

QGis软件 —— 2、QGis加载在线地图两种方式(谷歌地图)

1万+

Python爬虫教程:抓取电商网站评论(以淘宝和京东为例)

通过本文的介绍,我们学会了如何使用Python编写爬虫,抓取淘宝和京东等电商平台的商品评论数据。我们介绍了如何使用电商平台提供的开放API以及如何通过模拟浏览器来抓取动态加载的数据。此外,我们还讨论了如何应对反爬虫技术,如何存储抓取的数据等。爬取电商平台的数据是一个强大的工具,能够为市场分析、消费者行为研究、产品优化等领域提供有力的支持。然而,在使用爬虫技术时,我们必须遵循法律法规,尊重平台的隐私政策,避免滥用数据。

2201_76125261的博客 1737

day1-OpenMMLab概述

部署框架MMDeploy算法框架MMPretrain:预训练+多模态MMDetection:目标检测MMDetection3D:3D目标检测MMRotate:旋转目标检测MMSegmentation:语义分割MMPose:姿态估计MMAction2:视频动作分析MMOCR:光符识别MMagic:底层视觉+AIGCMMYOLO:目标检测MMFlow:光流估计MMTracking:目标跟踪MMHuman3D:人体参数化模型。

kkz2756275580的博客 642

3. UFS 电气时钟、复位、信号和电源

当接收到用于从 HS-MODE 到 LS-MODE 转换的 DME_POWERMODE.ind 或用于从 HS-MODE 到 HIBERN8 转换的 DME_HIBERNATE_ENTER.ind 时,UFS 主机可以启动一个计时器。在整个 PA_INIT 过程中,不应门控参考时钟。如果 UFS 主机启动从 HS-MODE 到 LS-MODE 或 HIBERN8 的电源模式更改,则应确保在关闭参考时钟之前,至少已经经过了由 bRefClkGatingWaitTime 定义的最小时间间隔,见图 6.3。

qq_42238448的博客 1293

OpenMMlab AI实战营 打卡笔记DAY1

OpenMMLab AI实战营 打卡笔记DAY1

weixin_49644231的博客 368

【人工智能之深度学习】23. 推荐系统升级实战:LightGCN重构协同过滤全流程(Amazon-Beauty数据集+完整代码)

摘要:传统协同过滤(如矩阵分解)在电商推荐中存在三大痛点:忽略用户-物品高阶关联、交互数据稀疏导致冷启动、特征工程依赖人工设计。本文基于Amazon-Beauty数据集(含20万+用户交互),用LightGCN图神经网络重构推荐系统:1)构建用户-物品二部图,通过3层图卷积捕捉“用户→物品→用户”的多跳关联;2)采用BPR负采样损失优化嵌入学习,缓解数据稀疏;3)端到端输出用户/物品嵌入,无需人工特征。

专注于人工智能、软件开发、工控自动化、工厂数字化及智能化等领域,希望和大家共同进步! 1493

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

OpenMMlab学习-day1

【代码】OpenMMlab学习-day1。

weixin_45485986的博客 68

LinePhone3.2.7(android端最新版本) sip客户端

SIP客户端For android:LinePhone3.2.7(最新版本),官网地址:http://www.linphone.org/

OpenMMLab AI实战训练营day6MMDetection代码教程

1.Open-Vocabulary Object Detection:开放词汇目标检测,给定图片和类别词汇表,检测所有物体。2.Grounding Object Detection:给定图片和文本描述,预测文本中所提到的在图片中的物体位置。该方向的典型算法是GLIP,目前在MMDetection的dev-3.x中已经支持。由于目标检测的特殊性,实际上使用Grad Box AM进行可视化。若想要进行离线测试,则可以使用提供的test.py脚本。Grad-Based CAM可视化。

lgwwslgw的博客 342

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

OpenMMLab AI 实战营day5 目标检测实战

day5

aso538的博客 230

OpenMMLab AI 实战营day4 目标检测理论

狠狠的补充了一下目标检测的相关基础,以前基础不太牢。

aso538的博客 215

OpenMMlab AI实战营Day5 MMDtetection教学

OpenMMlab AI实战营Day5 MMDtetection教学

一只大憨憨的博客 1328

OpenMMLab AI 实战营 Day 1

mmlab训练营听课笔记

钢之乐学的博客 328

每日总结day23-25

力扣题目链接(opens new window)使用栈实现队列的下列操作:push(x) -- 将一个元素放入队列的尾部。 pop() -- 从队列首部移除元素。 peek() -- 返回队列首部的元素。 empty() -- 返回队列是否为空。示例: 说明: 思路与注意点:1】在这里需要两个栈分别模拟输入端和输出端。 2】这里pop()注意:分为stOut为空和不为空的情况,为空则表示第一次进行pop或peek。 3】这里peek函数中使用pop为基础获取开头元素后将值push回去时应该从stOut回

qq_36756312的博客 573

MobileMamba轻量化视觉模型实战指南

状态空间模型(SSM)作为新一代序列建模架构,通过结构化状态空间序列(S4)机制突破了传统CNN和Transformer的局限。其核心价值在于线性计算复杂度下的全局感受野特性,特别适合移动端部署的计算机视觉任务。在目标检测和实例分割领域,这种架构能高效捕捉长程依赖关系,同时保持轻量级参数规模。基于CVPR2025最新提出的MobileMamba模型实践表明,该方案在COCO数据集上可达78.3% mAP50精度,且计算量仅3.2G FLOPs。通过动态路径激活等创新设计,模型在移动设备上展现出卓越的小目标检

aoe41606的博客 416

手把手复现LSKNet在DOTA-v1.0上的81.64% mAP:完整训练日志

LSKNet(Large Selective Kernel Network)是一款面向遥感目标检测的轻量级基础骨干网络,论文发表于ICCV 2023与IJCV 2024。本文带来一份完整的LSKNet复现教程:从环境搭建、数据集准备,到使用Oriented R-CNN检测器在DOTA-v1.0数据集上跑出81.64% mAP的全过程,并附上逐阶段训练日志解读与避坑经验。即使你是遥感检测新手,跟着本

gitblog_00954的博客 291

深度学习与计算机视觉:一个月高效产出毕业论文的完整实践指南

深度学习作为机器学习的重要分支,通过构建多层神经网络从数据中自动学习特征与规律,其核心原理在于利用反向传播等算法优化模型参数以拟合复杂函数。这一技术因其强大的表征学习能力,在推动人工智能发展中展现出巨大价值,尤其在计算机视觉领域应用广泛。计算机视觉旨在赋予机器“看懂”图像与视频的能力,其经典任务如图像分类、目标检测和图像分割,已成为自动驾驶、医疗影像分析等场景的关键支撑技术。随着PyTorch、TensorFlow等开源框架的成熟,以及ImageNet、COCO等公开数据集的普及,基于深度学习的计算机视觉研

weixin_30755393的博客 410

【读点论文】DETRs Beat YOLOs on Real-time Object Detection,detr也能实时目标检测,去除了NMS耗时操作,混合编码器加上IOU感知查询助力检测

近年来,基于transformer的端到端检测器(DETRs)取得了令人瞩目的进展。然而,DETRs的高计算成本问题并没有得到有效解决,这限制了它们的实际应用,并阻碍了它们充分利用无后处理的好处,如非最大抑制(NMS)。本文首先分析了现代实时目标检测器中NMS对推理速度的影响,并建立了端到端的速度基准。为了避免NMS造成的推理延迟,本文提出了实时检测变压器(RT-DETR),这是本文所知的第一个实时端到端对象检测器。

白水空空 1913
上一篇: Day 4 --- OpenMMLab系列之目标检测基础(一)
下一篇: Day 6 --- OpenMMLab系列之图像分割算法基础(一)
Aaaaaki
博客等级 码龄9年 884粉丝 26原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

Aaaaaki

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值