


一、图像分类基础
任务目标:给出图像识别出图像内物体
在图像分类任务中,往往将图像理解为由像素所构成的数组X∈RH×W×3X \in \mathbb{R}^{H \times W \times 3}X∈RH×W×3,同时对所检测物体进行编号y∈{1,...,K}y \in \{1,...,K\}y∈{1,...,K},最终构建出一个抽象函数F:RH×W×3→yF:\mathbb{R}^{H \times W \times 3} \rightarrow yF:RH×W×3→y,从而完成对图像中物体的分类。
但由于图像内容往往与单个像素无关,而与其表现出的特征有关,因此对于图像分类任务,无法设置具体的规制使得算法对图像完成分类,而是需要构建出模型,获取到具体的图像特征,根据该特征完成对物体的分类。
机器学习的局限
传统机器学习任务在处理图像分类任务时,由于图像数据往往在高维空间中以复杂方式进行缠腰(如下图),仅靠常规的机器学习算法很难处理这种复杂分布的数据,因此需要手动设计特征。
在特征工程中,人们通过手动设计特征(如HOG),提取出高维图像内的特征并将其转化为低维特征向量,在保留大部分物体信息的前提下,极大降低数据维度,最后根据机器学习算法对低维数据进行处理完成分类。例如2010年ILSVRC冠军方案NEC-UIUC,通过手工设计特征+机器学习方法将Top-5错误率降低到了28%左右。但此后受限于信息丢失,在视觉任务中基本达到了性能瓶颈。
深度学习:
不同于传统机器学习方案,深度学习标志着图像任务从特征工程时代开始步入特征学习时代。通过卷积(CNN)、多头注意力(Transformer)等可学习的特征提取模块进行复合,构建出一个端到端的复杂分类器,轻松实现图像特征提取,大幅度提高了检测精度。
二、神经网络与模型学习策略
神经网络设计
自AlexNet在ILSVRC横空出世后,图像任务正式步入深度学习时代,大量优秀的神经网络结构开始涌现,下面主要对几种经典内容进行介绍分析:
-
AlexNet
作为第一个吃螃蟹的,AlexNet所做的工作不仅仅只有将深度学习方法带入视觉领域,研究团队使用ReLU函数取代了常用的Sigmoid函数,大幅度提高了收敛速度。

同时团队通过实现并开源cuda-convnet,首次将大规模神经网络在GPU上进行训练,在当时那个以CPU训练为主流的环境中,显著提升了训练速度,为后续研究也奠定了良好的基础 -
VGG
对于VGG来说,其特点更多在于将此前的5×55 \times55×5大尺寸卷积核拆解为了两个3×33\times33×3卷积,这种做法在保证了相同感受野的同时,具备更少的参数量和更多的层数和表达能力。

以一个尺寸大小为xxx的图像为例,假设padding为1:- 5×55 \times55×5:横纵向各滑动(x−5+1)(x-5+1)(x−5+1)次,所得输出图大小为(x−4)×(x−4)(x-4)\times(x-4)(x−4)×(x−4)
- 3×33 \times 33×3:其中第一个3×33\times33×3卷积核卷积后,所得输出图大小为(x−3+1)×(x−3+1)(x-3+1)\times(x-3+1)(x−3+1)×(x−3+1),在该输出图的基础上继续应用第二个卷积核,最终所得输出图大小为(x−3+1−3+1)×(x−3+1−3+1)(x-3+1-3+1)\times(x-3+1-3+1)(x−3+1−3+1)×(x−3+1−3+1),即(x−4)×(x−4)(x-4)\times(x-4)(x−4)×(x−4)
可以发现二者所得输出图尺寸相同,即二者**感受野相同,**在感受野相同的情况下,计算二者参数量:
- 5×55\times55×5:5×5×in_ch×out_ch5\times5\times in\_ch \times out\_ch5×5×in_ch×out_ch
- 3×33\times33×3:2×3×3×in_ch×out_ch2\times3\times3\times in\_ch \times out\_ch2×3×3×in_ch×out_ch
发现前者参数量是后者的1.39倍,但大卷积核也并非无用,由于有效感受野的大小是正比于卷积核大小,因此大卷积核可以增加有效感受野,这一点是小卷积核无法替代的,ConvNeXt中7×77\times77×7大尺寸卷积核的使用就是个明显的例子。
-
ResNet
由于CNN中网络深度越深,其特征层次越丰富,因此网络模型纷纷开始追求更深的深度,但随着模型的加深,精度退化问题开始凸显,由于ReLU在反向传播时带来的不可逆信息损失,更深的层次往往精度不增反降。

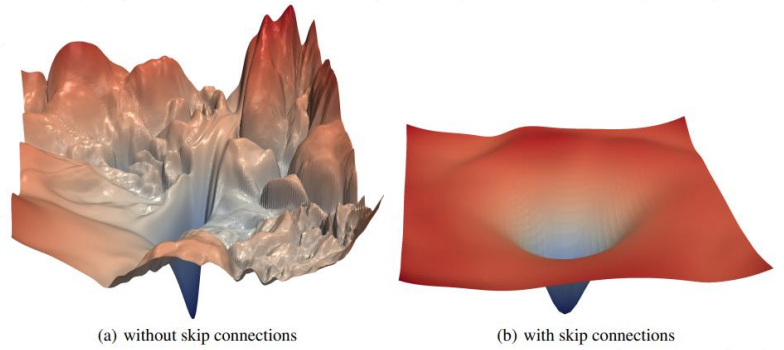
为了缓解精度退化问题,ResNet在设计时引入Skip Connections来实现**恒等映射,**通过跳接在激活函数前,将上一层的输出与本层输出相加,将求和的结果输入激活函数作为本层的输出,即H(x)=F(x,Wi)+xH(x)=F(x,W_i)+xH(x)=F(x,Wi)+x,其中F(x,Wi)F(x,W_i)F(x,Wi)就是需要学习的残差。
ResNet 效果好的原因:- 等同于多模型集成,残差网络有 𝑂(2 𝑛 ) 个隐式的路径来连接输入和输出,每添加一个块会使路径数翻倍
- 使得loss 曲线更加平滑,更容易收敛到全局最优解,可参考论文(Visualizing the Loss Landscape of Neural Nets)
-
ViT与Swin Transformer
在介绍ViT之前,首先需要对注意力机制和Transformer有所了解。
虽然注意力机制与卷积都注重实现层次化特征,即对空间邻域内的前层特征加权求和,权重越大表示对应位置的特征就越重要。
但在卷积中,权重是可学习的参数,与输入无关,受限于局部感受野仅建模局部关系,其对于远距离的关系只能通过多层卷积去建模实现,但由于池化的存在,使得多次池化后达到理论全局感受野,但实际感受野要小得多。注意力机制则很好的弥补了这一点,其权重是输入的函数,且不受限与局部,通过时空关系可直接显示的建模全局感受野。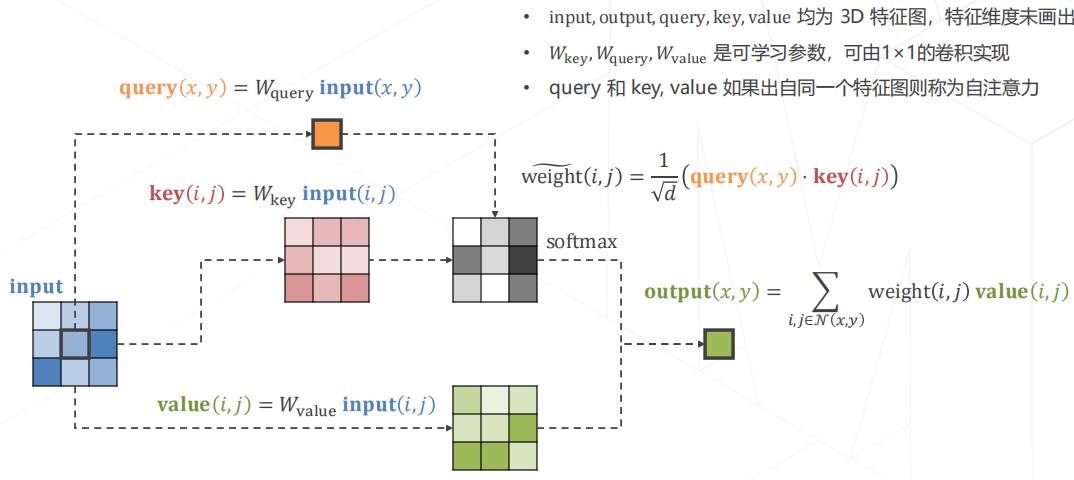
Vision Transformer(ViT)
ViT是在Transformer的基础上诞生而来的,由于在NLP任务中,Transformer受限于结构常用于处理一维数据,因此在迁移到视觉领域后,需要将图像切分成若干16×1616\times1616×16的小块(Patch),并将这些小块组合成一列向量输入到Transformer的Encoder层中进行处理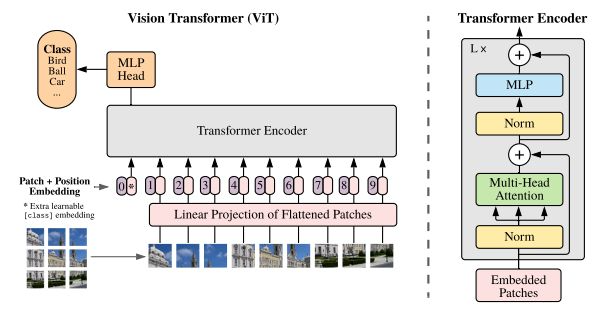
Swin Transformer
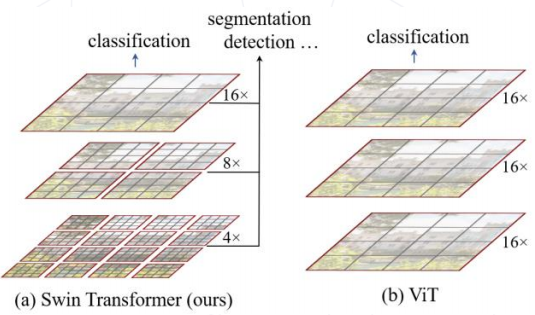
与NLP相比,Transformer应用在视觉领域有两个难点:- 物体尺度变化大,ViT无法处理多尺度问题
- 图像像素点数量要远大于文本数量,无法直接当作token处理,但采用ViT中的Patch作为输入会使得特征非常粗糙,无法处理精细任务。
基于上述问题,Swin Transformer的主要思想是把建模能力很强的transformer和视觉信号的先验联系起来,这些先验具有层次性、局部性和平移不变性,具体做法是用shifted window来建立分层特征图,有了分层特征图就可以用FPN/Unet等结构去做密集预测的任务,而且计算量与图片尺寸成正比。
模型学习
目前在深度学习任务中,模型的学习常见的是监督学习和自监督学习两种学习方法,下面对着两种方法进行介绍。
监督学习
-
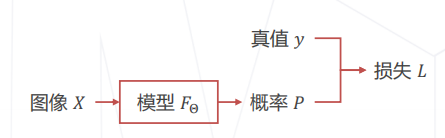
获取标注后的数据集,包括图像XiX_iXi和标签yiy_iyi
-
定义损失函数L:[0,1]K×N→RL:[0,1]^K\times \mathbb{N} \rightarrow \mathbb{R}L:[0,1]K×N→R,模型会依据损失函数来计算预测值和标签的差距,以此衡量单个预测结果的好坏
-
求解最优化问题,获取使得总Loss值最小的参数(梯度下降)
自监督学习
-
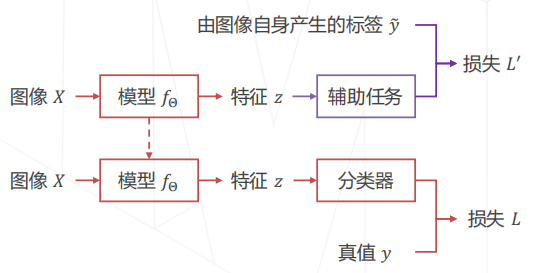
通过设计辅助任务,使得模型在大规模无标注数据中通过**前置任务(Pretext Task,也叫辅助任务)**去自动构建监督信息,以此获取预训练模型
-
对于新的下游任务,采用监督学习方法迁移预训练模型参数,并以此在下游任务中进行微调即可。
三、模型训练时的常用策略
学习率与优化器策略
- 权重初始化
- 随机初始化:朴素方法、Xavier方法以及Kaiming方法(主要针对ReLU)
- 预训练模型:采用预训练模型进行权重初始化,通过替换预训练模型的分类头进行finetune
- 学习率策略
- 退火(Annealing):在训练初始使用较大学习率,待损失稳定后对学习率进行降低,常按步长、倒数、比例以及余弦函数对学习率进行下降。
- 升温(Warmup):在训练前几轮学习率逐渐上升,直到预设的学习率,以稳定训练的初始阶段
- Linear Scaling Rule:针对同一个训练任务,当 batch size 扩大为原来的 𝑘 倍时,学习率也应对应扩大 𝑘 倍,例如预训练模型使用 lr=0.1,8卡数据并行训练,如果希望用1卡复现实验,lr 应设置为 0.0125,进行等比例缩小。
- 自适应梯度算法:不同的参数需要不同的学习率,根据梯度的历史幅度自动调整学习率
- 优化器策略
- 正则化与权重衰减(Weight Decay):该方法常用于应对过拟合问题,通过为模型Loss函数添加正则化项作为惩罚项,来使得学出的模型参数值较小。这种通过惩罚绝对值较大的模型参数为需要学习的模型增加了限制的方法,在应对过拟合问题时常常有效。
- 早停(Early Stopping):当验证集的分类精度达到最值时,停止训练,防止模型过拟合
- EMA:复制一份模型所有权重的备份(记为EMA_weights),训练过程中每次更新权重时同时也对EMA_weights进行滑动平均更新,训练阶段结束后用EMA_weights替换模型权重进行预测。更新流程如下:
- Weights∗=Weights+LR∗Grad(模型正常的梯度下降)Weights^*=Weights+LR*Grad (模型正常的梯度下降)Weights∗=Weights+LR∗Grad(模型正常的梯度下降)
- EMA_weights=EMA_weights∗decay+(1−decay)∗Weights∗EMA\_weights=EMA\_weights*decay+(1-decay)*Weights^*EMA_weights=EMA_weights∗decay+(1−decay)∗Weights∗
- Stochastic Weight Averaging:原理同 EMA,但在训练末期使用较高的学习率,在损失平面的平坦区域上做更多的探索,最后平均模型
模型设计策略
-
Dropout:
为保证神经网路在训练时,各神经元之间由于**共适应现象(co-adaption)**出现高度关联导致过拟合,因此在训练时引入Dropout层,通过随机丢弃一些连接,破坏神经元之间的关联,使得神经元学习独立的特征。
但需要注意的时,该方法仅在训练时使用,推理时无须Dropout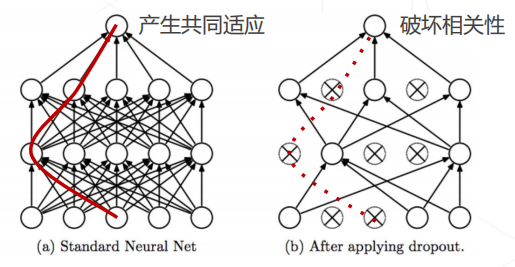
-
随机深度(Stochastic Depth)
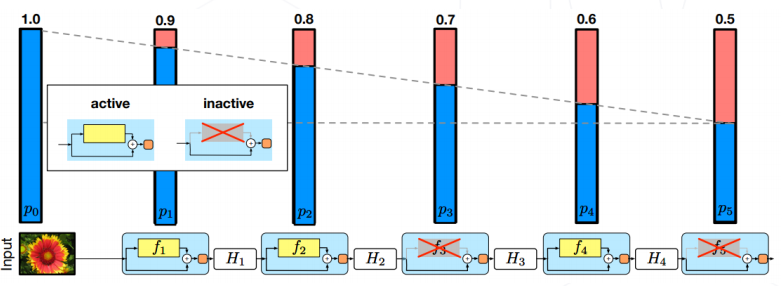
个人理解该方法有点类似Dropout,只不过将丢弃单位由神经元扩大到网络层,通过在训练时随机丢弃部分无用的网络层,最后利用不同的深度训练,相当于潜在地融合了多个不同深度的网络,达到对速度和性能优化的目的
 341


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


