


Binary Tree的遍历可分为preorder, inorder, postorder和in-level order四种。前3种可用递归或非递归(基于stack,后进先出),第4种通常用BFS,基于queue(先进先出),也可以用DFS,基于stack。注意这里是Binary Tree,不需要是Binary Search Tree。
preorder遍历非递归模板:
遍历顺序为根、左、右
思路:
- 如果根节点非空,将根节点加入到栈中。
- 如果栈不空,弹出栈顶节点,将其值加加入到数组中。
2.1 如果该节点的右子树不为空,将右子节点加入栈中。
2.2 如果左子节点不为空,将左子节点加入栈中。 - 重复第二步,直到栈空。
代码如下://最终参考版
/**
 * Definition of TreeNode:
 * class TreeNode {
 * public:
 *     int val;
 *     TreeNode *left, *right;
 *     TreeNode(int val) {
 *         this->val = val;
 *         this->left = this->right = NULL;
 *     }
 * }
 */

class Solution {
public:
    /**
     * @param root: A Tree
     * @return: Preorder in ArrayList which contains node values.
     */
    vector<int> preorderTraversal(TreeNode * root) {
        if (!root) return {};
        vector<int> result;
        stack<TreeNode*> s;
        s.push(root);
        while(!s.empty()) {
            TreeNode* temp = s.top();
            s.pop();
            result.push_back(temp->val);

            if (temp->right) s.push(temp->right);
            if (temp->left) s.push(temp->left);
        }
        return result;
    }
};
in-order非递归模板:(非常重要!!!)
遍历顺序为左、根、右
思路
1. 从根节点开始,开始把左节点挨个压栈,直至最左端的叶节点。
2. 若stack不为空,对node=stack.top(),存入结果。
若node无右节点,则pop,并看node在stack前一个位置(也就是新的stack.top)是不是node的父节点,并且node是它的右节点);若是,也将其pop()。
//注意:根据in-order的特点,如果某个节点无右节点,或者右节点已经访问过,说明这就是根了,应该pop。
若node有右节点,则将其压栈,并将其左节点挨个压栈,直至其左子树的最左端的叶节点。
//注意:根据in-order的特点,如果某个节点还有右节点没访问,那就要先访问右节点,即要先将其压栈。
3. 重复2,直到stack空。
举例如下:
第一个while循环沿着左节点压栈,s={6,5,3,2}, 2是栈顶。
第二个while循环
先将node=s.top()的存入结果(2),然后看node是否有右节点,这里没有,所以pop()。
然后新的node=s.top()存入结果(3),这里因为3有右节点4(这里3不能pop,否则4返回就找不到3了),所以将节点4压栈,s={6,5,3,4}。
然后新的node=s.top()存入结果(4),这里4没有右节点,所以4 pop,然后我们看到4是3的右节点,所以3 pop。然后后面的循环会处理5,6,…。
第三个while循环本质上和第一个while循环一样。
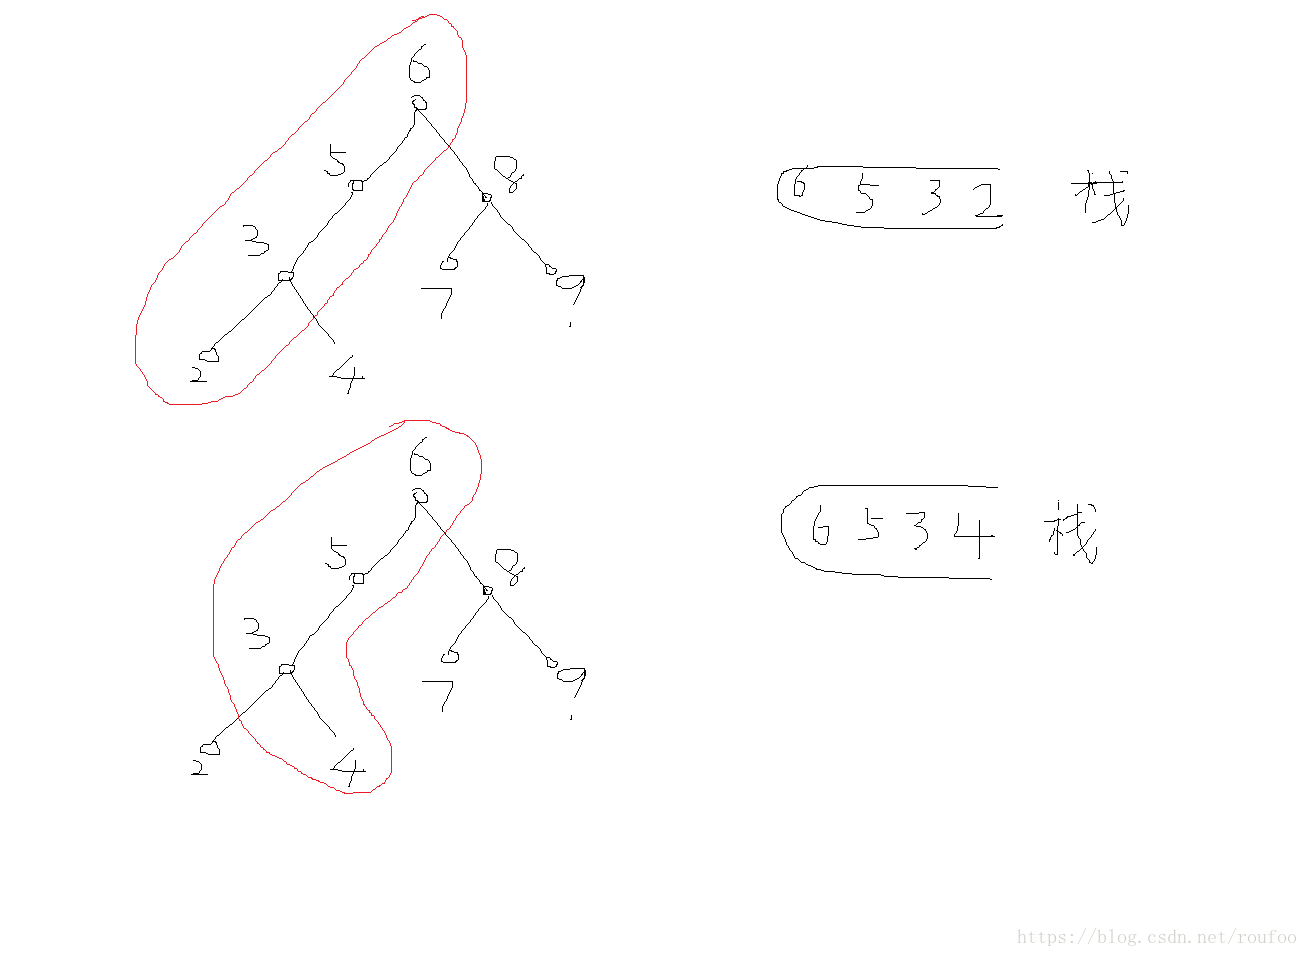
代码如下(参考自九章)://最终参考版
首先访问左子树,将左子树存入栈中,每次将栈顶元素存入结果,如果右子树为空,取出栈顶元素,如果当前元素为栈顶元素右子树,一直弹出至当前元素不为栈顶元素右子树(此处说明访问右子树,根节点已经被访问过,弹出即可)。如果节点右子树不为空,访问右子树,继续循环遍历左子树,存入栈中。
    vector<int> inorderTraversal(TreeNode * root) {

        vector<int> result;
        stack<TreeNode *> s;
        if (!root) return result;

        while(root) {
            s.push(root);
            root=root->left;
        }

        while(!s.empty()) {
            TreeNode* node=s.top();
            result.push_back(node->val);

            if (!node->right) {
                s.pop();
                while(!s.empty() && (s.top()->right==node)) {
                    node=s.top();
                    s.pop();
                }
            } else {
                node = node->right;
                while(node) {
                    s.push(node);
                    node=node->left;
                }
            }
        }

        return result;
    }
又看了一下代码,之前的解释不是很清楚。现在重新解释一下,上面的if(node->right)这个分支好理解,就是如果当前节点有右节点,那就找到右子树的最左边的节点,并沿途挨个压栈。
难点在于if(!node->right)这个分支,为什么有下面这行代码呢? 因为如果没有之前的if(node->right)处理,也就是s.top()没有右子树的话,那就直接s.pop()就可以了,但之前因为s.top()有右节点,进行了if(node->right)的处理,所以s.top()这个节点要推迟到现在才能s.pop()。为啥不能去掉(s.top()->right==node)呢?因为s.top()这个节点和node不一样,node没有右节点,s.top()不一定没有。如果把s.top()不管三七二十一都pop()掉,那么s.top()的右节点就断了,以后也找不到了。
                while(!s.empty() && (s.top()->right==node)) {
                    node=s.top();
                    s.pop();
                }
简化版:
事实上每次stack的top push到res里后就可以从stack里面删掉了,不需要留着。注意下面的这个代码可以用于求二叉树的next iterator,但是不能用于求previous iterator。因为栈里面有些信息已经被删掉了。而上面那个版本不光可以求next iterator,也可以求previous iterator(把代码里面的left 和right互换就可以)。
class Solution {
public:
    /**
     * @param root: A Tree
     * @return: Inorder in ArrayList which contains node values.
     */
    vector<int> inorderTraversal(TreeNode *root) {
        if (!root) return {};
        vector<int> res;
        stack<TreeNode *> stk;

        while (root) {
            stk.push(root);
            root = root->left;
        }

        while (!stk.empty()) {
            TreeNode *node = stk.top();
            res.push_back(node->val);
            stk.pop();
            if (node->right) {
                node = node->right;
                while (node) {
                    stk.push(node);
                    node = node->left;
                }

            }

        }
        return res;
    }
};
post-order非递归模板
遍历顺序为左、右、根
- 如果根节点非空,将根节点加入到栈中。
- 如果栈不空,取栈顶元素(暂时不弹出),
i. 如果(左子树已访问过或者左子树为空),且(右子树已访问过或右子树为空),则弹出栈顶节点,将其值加入数组,
ii. 如果左子树不为空,切未访问过,则将左子节点加入栈中,并标左子树已访问过。
iii. 如果右子树不为空,切未访问过,则将右子节点加入栈中,并标右子树已访问过。 - 重复2,直到栈空。
代码如下:
/**
 * Definition of TreeNode:
 * class TreeNode {
 * public:
 *     int val;
 *     TreeNode *left, *right;
 *     TreeNode(int val) {
 *         this->val = val;
 *         this->left = this->right = NULL;
 *     }
 * }
 */

class Solution {
public:
    /**
     * @param root: A Tree
     * @return: Postorder in ArrayList which contains node values.
     */
    vector<int> postorderTraversal(TreeNode * root) {
        vector<int> result;
        stack<TreeNode *> s;

        TreeNode * current = root, * lastVisited = NULL;

        if (!root) return vector<int>();

        s.push(root);

        while(!s.empty()) {
            current = s.top();
            if (!lastVisited || current == lastVisited->left || current == lastVisited->right) {
                if (current->left) {
                    s.push(current->left);
                } else if (current->right) { //note! the else is needed here!!!
                    s.push(current->right);
                }
            } else if (current->left == lastVisited) {
                if (current->right) {
                    s.push(current->right);
                }
            } else {
                result.push_back(current->val);
                s.pop();
            }

            lastVisited = current;
        }

        return result;
    }
};
下面这个版本更好。//最终参考版
使用栈进行二叉树后序遍历,首先对左子树进行遍历压入栈中,直至左子树为空,然后访问右子树。故每个节点会被访问两次,当节点被第二次访问时,即curr->right=lastvisit时,该节点出栈。
class Solution {
public:
    vector<int> postorderTraversal(TreeNode *root) {
        vector<int> result;
        stack<TreeNode *> myStack;

        TreeNode *current = root, *lastVisited = NULL;
        while (current != NULL || !myStack.empty()) {
            while (current != NULL) {
                myStack.push(current);
                current = current->left;
            }
            current = myStack.top();
            if (current->right == NULL || current->right == lastVisited) {
                myStack.pop();
                result.push_back(current->val);
                lastVisited = current;
                current = NULL;
            } else {
                current = current->right;
            }
        }
        return result;
    }
};
上面的几种解法还是没有统一风格,下面是链接
https://www.jianshu.com/p/49c8cfd07410
给出的更统一的模板。非常好。
//更简单的非递归前序遍历
void preorderTraversalNew(TreeNode *root, vector<int> &path)
{
    stack< pair<TreeNode *, bool> > s;
    s.push(make_pair(root, false));
    bool visited;
    while(!s.empty())
    {
        root = s.top().first;
        visited = s.top().second;
        s.pop();
        if(root == NULL)
            continue;
        if(visited)
        {
            path.push_back(root->val);
        }
        else
        {
            s.push(make_pair(root->right, false));
            s.push(make_pair(root->left, false));
            s.push(make_pair(root, true));
        }
    }
}
//更简单的非递归中序遍历
void inorderTraversalNew(TreeNode *root, vector<int> &path)
{
    stack< pair<TreeNode *, bool> > s;
    s.push(make_pair(root, false));
    bool visited;
    while(!s.empty())
    {
        root = s.top().first;
        visited = s.top().second;
        s.pop();
        if(root == NULL)
            continue;
        if(visited)
        {
            path.push_back(root->val);
        }
        else
        {
            s.push(make_pair(root->right, false));
            s.push(make_pair(root, true));
            s.push(make_pair(root->left, false));
        }
    }
}

//更简单的非递归后序遍历
void postorderTraversalNew(TreeNode *root, vector<int> &path)
{
    stack< pair<TreeNode *, bool> > s;
    s.push(make_pair(root, false));
    bool visited;
    while(!s.empty())
    {
        root = s.top().first;
        visited = s.top().second;
        s.pop();
        if(root == NULL)
            continue;
        if(visited)
        {
            path.push_back(root->val);
        }
        else
        {
            s.push(make_pair(root, true));
            s.push(make_pair(root->right, false));
            s.push(make_pair(root->left, false));
        }
    }
}
in-level order 非递归版
思路: 用queue。
一开始将root放入queue中,然后进入while(!queue.empty()),若queue不为空,则按queue中有多少元素(queue.size()),不断取queue.front(),将其值存入结果,再将其左右节点push进queue。周而往复,直到queue空。
代码如下:
/**
 * Definition of TreeNode:
 * class TreeNode {
 * public:
 *     int val;
 *     TreeNode *left, *right;
 *     TreeNode(int val) {
 *         this->val = val;
 *         this->left = this->right = NULL;
 *     }
 * }
 */

class Solution {
public:
    /**
     * @param root: A Tree
     * @return: Level order a list of lists of integer
     */
    vector<vector<int>> levelOrder(TreeNode * root) {
        vector<vector<int> > result;
        if (!root) return result;

        queue<TreeNode *> q;
        q.push(root);

        while(!q.empty()) {
            vector<int> vec;
            int size=q.size();
            for (int i=0; i<size; ++i) {
                TreeNode* node=q.front();
                q.pop();
                vec.push_back(node->val);
                if (node->left)
                    q.push(node->left);
                if (node->right)
                    q.push(node->right);

            }
            result.push_back(vec);
        }
        return result;
    }
};
另外还有二叉树Zigzag遍历,见
https://blog.youkuaiyun.com/roufoo/article/details/103946959
还有二叉树按vertical order遍历,见
https://blog.youkuaiyun.com/roufoo/article/details/103943335
还有二叉树Morris遍历
再来一个二叉树非递归模板,即直接用一个stack模拟系统调用,context存储系统调用中应该保留的信息。这里采用vector而不是stack做栈是因为希望修改stack.top()。
前序遍历
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     TreeNode *left;
 *     TreeNode *right;
 *     TreeNode() : val(0), left(nullptr), right(nullptr) {}
 *     TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
 *     TreeNode(int x, TreeNode *left, TreeNode *right) : val(x), left(left), right(right) {}
 * };
 */

struct Context {
    TreeNode* node;
    int step;
    Context(TreeNode* _node = NULL, int _step = 0) : node(_node), step(_step) {}
};

class Solution {
public:
    vector<int> preorderTraversal(TreeNode* root) {
        vector<Context> s;
        s.push_back(Context(root, 0));
        vector<int> res;
        while (!s.empty()) {
            if (s.back().node == NULL) {
                //root为空,直接返回
                s.pop_back();
            } else if (s.back().step == 0) {
                s.back().step = 1;
                res.push_back(s.back().node->val);
                //if (s.back().step == 0) s.pop_back();
            } else if (s.back().step == 1) {
                s.back().step = 2;
                s.push_back(Context(s.back().node->left, 0));
            } else if (s.back().step == 2) {
                s.back().step = 3;
                s.push_back(Context(s.back().node->right, 0));
            } else if (s.back().step == 3) {
                //表示当前栈顶的左右子节点都处理完了,这是为了跟step==0做区分,step==0是当前栈顶还没开始处理左右字节点的情况。
                s.pop_back();
            }
        }
        return res;
    }
};
中序遍历:
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     TreeNode *left;
 *     TreeNode *right;
 *     TreeNode() : val(0), left(nullptr), right(nullptr) {}
 *     TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
 *     TreeNode(int x, TreeNode *left, TreeNode *right) : val(x), left(left), right(right) {}
 * };
 */

struct Context {
    TreeNode* node;
    int step;
    Context(TreeNode* _node = NULL, int _step = 0) : node(_node), step(_step) {}
};

class Solution {
public:
    vector<int> inorderTraversal(TreeNode* root) {
     vector<Context> s;
        s.push_back(Context(root, 0));
        vector<int> res;
        while (!s.empty()) {
            if (s.back().node == NULL) {
                //root为空,直接返回
                s.pop_back();
            } else if (s.back().step == 0) {
                s.back().step = 1;
                s.push_back(Context(s.back().node->left, 0));
                //if (s.back().step == 0) s.pop_back();
            } else if (s.back().step == 1) {
                s.back().step = 2;
                res.push_back(s.back().node->val);
            } else if (s.back().step == 2) {
                s.back().step = 3;
                s.push_back(Context(s.back().node->right, 0));
            } else {
                //表示当前栈顶的左右子节点都处理完了,这是为了跟step==0做区分,step==0是当前栈顶还没开始处理左右字节点的情况。
                s.pop_back();
            }
        }
        return res;
    }
};
后序遍历:
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     TreeNode *left;
 *     TreeNode *right;
 *     TreeNode() : val(0), left(nullptr), right(nullptr) {}
 *     TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
 *     TreeNode(int x, TreeNode *left, TreeNode *right) : val(x), left(left), right(right) {}
 * };
 */

struct Context {
    TreeNode* node;
    int step;
    Context(TreeNode* _node = NULL, int _step = 0) : node(_node), step(_step) {}
};

class Solution {
public:
    vector<int> postorderTraversal(TreeNode* root) {
        vector<Context> s;
        s.push_back(Context(root, 0));
        vector<int> res;
        while (!s.empty()) {
            if (s.back().node == NULL) {
                //root为空,直接返回
                s.pop_back();
            } else if (s.back().step == 0) {
                s.back().step = 1;
                s.push_back(Context(s.back().node->left, 0));
            } else if (s.back().step == 1) {
                s.back().step = 2;
                s.push_back(Context(s.back().node->right, 0));
            } else {
                res.push_back(s.back().node->val);
                s.pop_back();
            }
        }
        return res;
    }
};
注意后序遍历中,根节点最后处理,可以顺便弹栈,所以它不用加step=3的情况。为了便于和前序和中序统一版本,也可以加step=3的情况,结果一样。
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     TreeNode *left;
 *     TreeNode *right;
 *     TreeNode() : val(0), left(nullptr), right(nullptr) {}
 *     TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
 *     TreeNode(int x, TreeNode *left, TreeNode *right) : val(x), left(left), right(right) {}
 * };
 */

struct Context {
    TreeNode* node;
    int step;
    Context(TreeNode* _node = NULL, int _step = 0) : node(_node), step(_step) {}
};

class Solution {
public:
    vector<int> postorderTraversal(TreeNode* root) {
        vector<Context> s;
        s.push_back(Context(root, 0));
        vector<int> res;
        while (!s.empty()) {
            if (s.back().node == NULL) {
                //root为空,直接返回
                s.pop_back();
            } else if (s.back().step == 0) {
                s.back().step = 1;
                s.push_back(Context(s.back().node->left, 0));
            } else if (s.back().step == 1) {
                s.back().step = 2;
                s.push_back(Context(s.back().node->right, 0));
            } else if (s.back().step == 2) {
                s.back().step = 3;
                res.push_back(s.back().node->val);
            } else {
                s.pop_back();
            }
        }
        return res;
    }
};
附加一个最好的中序遍历非递归模板,非常简洁。
class Solution {
public:
    /**
     * @param root: A Tree
     * @return: Inorder in ArrayList which contains node values.
     */
    vector<int> inorderTraversal(TreeNode *root) {
        stack<TreeNode *> stk;
        vector<int> res;
        while (root || !stk.empty()) {
            while (root) {
               stk.push(root);
               root = root->left;
            }
            root = stk.top();
            stk.pop();
            res.push_back(root->val);
            root = root->right;
        }
        return res;
    }
};
/////////
个人新总结:
- 前序遍历就是自上向下,后序遍历就是自下而上。
中序遍历其实用得不多,因为如果分叉数不是2的话就不好用中序。 - Quick Sort类似于前序遍历,Merge Sort 类似于后序遍历。
准备采用这个模板了。前中后序遍历都可以用。
前序遍历:
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     TreeNode *left;
 *     TreeNode *right;
 *     TreeNode() : val(0), left(nullptr), right(nullptr) {}
 *     TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
 *     TreeNode(int x, TreeNode *left, TreeNode *right) : val(x), left(left), right(right) {}
 * };
 */
class Solution {
public:
    vector<int> preorderTraversal(TreeNode* root) {
        if (!root) return {};
        visited = new TreeNode(-1);
        vector<int> res;
        goLeft(root, res);
        while (!stk.empty()) {
            TreeNode *topNode = stk.top();

            if ((!topNode->left || topNode->left == visited) && topNode->right != visited) {
                //inorder here
                goLeft(topNode->right, res);
            }

            if (!topNode->right || topNode->right == visited) {

                stk.pop();
                visited = topNode;
            }
        }
        return res;
    }
private:
    void goLeft(TreeNode *root, vector<int> &res) {
        while (root) {
            //preorder here
            res.push_back(root->val);
            stk.push(root);
            root = root->left;
        }
        return;
    }
    stack<TreeNode *> stk;
    TreeNode *visited;
};
中序遍历:
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     TreeNode *left;
 *     TreeNode *right;
 *     TreeNode() : val(0), left(nullptr), right(nullptr) {}
 *     TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
 *     TreeNode(int x, TreeNode *left, TreeNode *right) : val(x), left(left), right(right) {}
 * };
 */
class Solution {
public:
    vector<int> inorderTraversal(TreeNode* root) {
        vector<int> res;
        TreeNode *visited = new TreeNode(-1);  //注意:这里不能用visited = NULL,不然跟后面的topNode->left == visited 或 topNode->right == visited搞混。
        pushLeft(root);
        while (!stk.empty()) {
            TreeNode *topNode = stk.top();
            if ((!topNode->left || topNode->left == visited) && (topNode->right != visited)) {
                //左子树遍历完,右子树还没有遍历。中序代码放这里
                res.push_back(topNode->val);
                pushLeft(topNode->right);
          }
            if (!topNode->right || topNode->right == visited) {
                //左子树和右子树都遍历完了。后序代码放这里
                visited = topNode;
                stk.pop();
            }
        }
        return res;
    }
private:
    stack<TreeNode *> stk;
    void pushLeft(TreeNode *root) {
        while (root) {
        //左子树还没有遍历。前序代码放这里
            stk.push(root);
            root = root->left;
        }
    }
};
后续遍历:
/**
 * Definition for a binary tree node.
 * struct TreeNode {
 *     int val;
 *     TreeNode *left;
 *     TreeNode *right;
 *     TreeNode() : val(0), left(nullptr), right(nullptr) {}
 *     TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
 *     TreeNode(int x, TreeNode *left, TreeNode *right) : val(x), left(left), right(right) {}
 * };
 */

class Solution {
public:
    vector<int> postorderTraversal(TreeNode* root) {
        if (!root) return {};
        vector<int> res;
        visited = new TreeNode(-1);
        goLeft(root, res);
        while (!stk.empty()) {
            TreeNode *topNode = stk.top();

            if ((!topNode->left || topNode->left == visited) && topNode->right != visited) {
                //inorder here
                goLeft(topNode->right, res);
            }

            if (!topNode->right || topNode->right == visited) {
                //postorder here
                res.push_back(topNode->val);
                stk.pop();
                visited = topNode;
            }
        }
        return res;
    }
private:
    void goLeft(TreeNode *root, vector<int> &res) { //注意goLeft结束后,root值不变。goLeft的作用仅仅是把一系列left的节点压栈。
        while (root) {
            //preorder here
            stk.push(root);
            root = root->left;
        }
        return;
    }
    TreeNode *visited;
    stack<TreeNode *> stk;
};

 403


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


