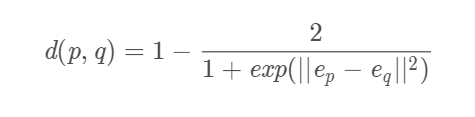视频对象分割论文解读系列【1】

视频对象分割(Video Object Segmentation)研究小记 文章目录任务定义与数据集任务定义数据集评价指标技术路线分类经典论文 写在前面的话,硕士研究生阶段从接触VOS到深入研究,差不多一共有两年时间。因为自己刚接触这个研究领域的时候,用深度学习做视频分割的还相对较少,嘿嘿,所以相对好发(水)论文,马上毕业了,简单写个总结吧,不针对某篇论文做具体的技术分析。以下任务的定义等主要参考DAVIS benchmark,这个数据集确实推动了这个研究方向。 任务... 阅读详情

此处最后粗略解读更新时间:2020-2-26

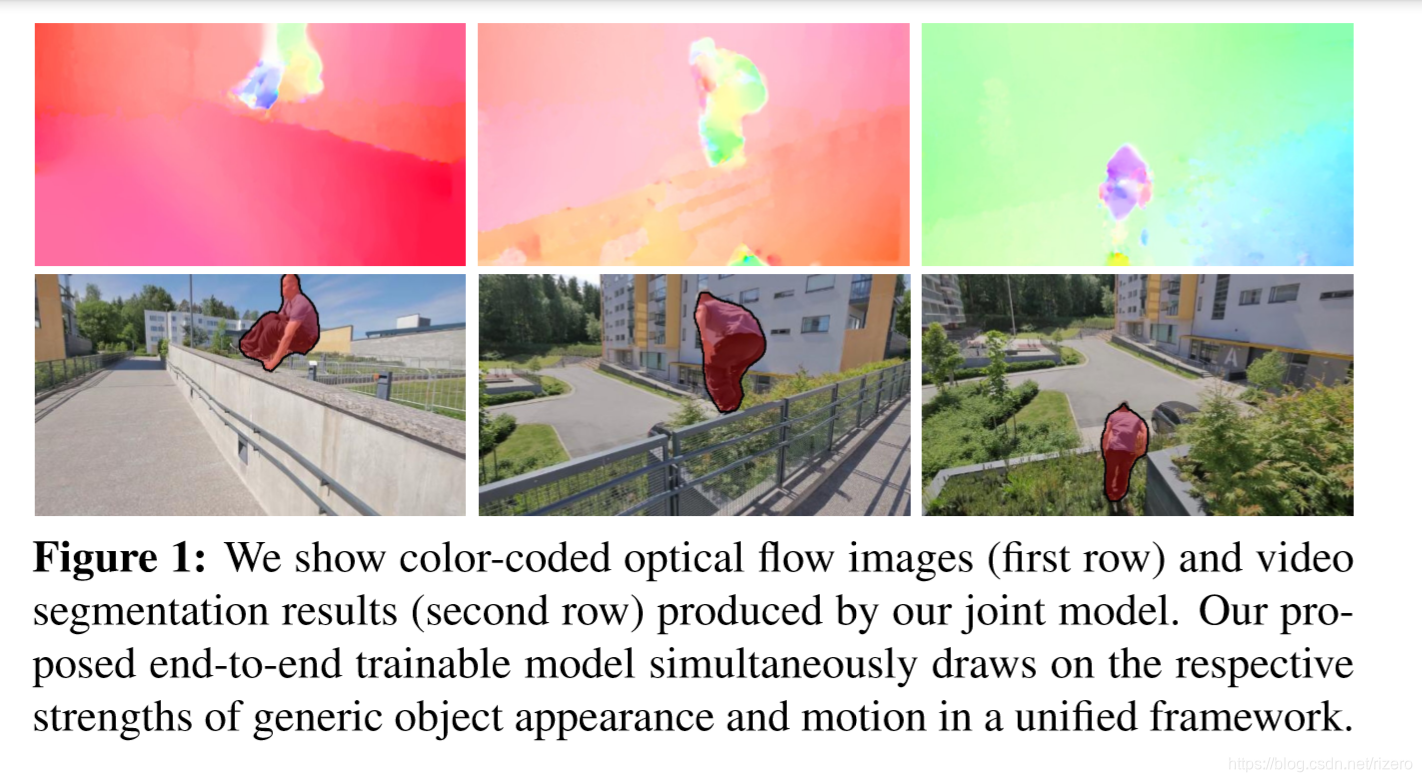
11. 论文:FusionSeg

我的印象:一个中规中矩的利用了光流图片的网络

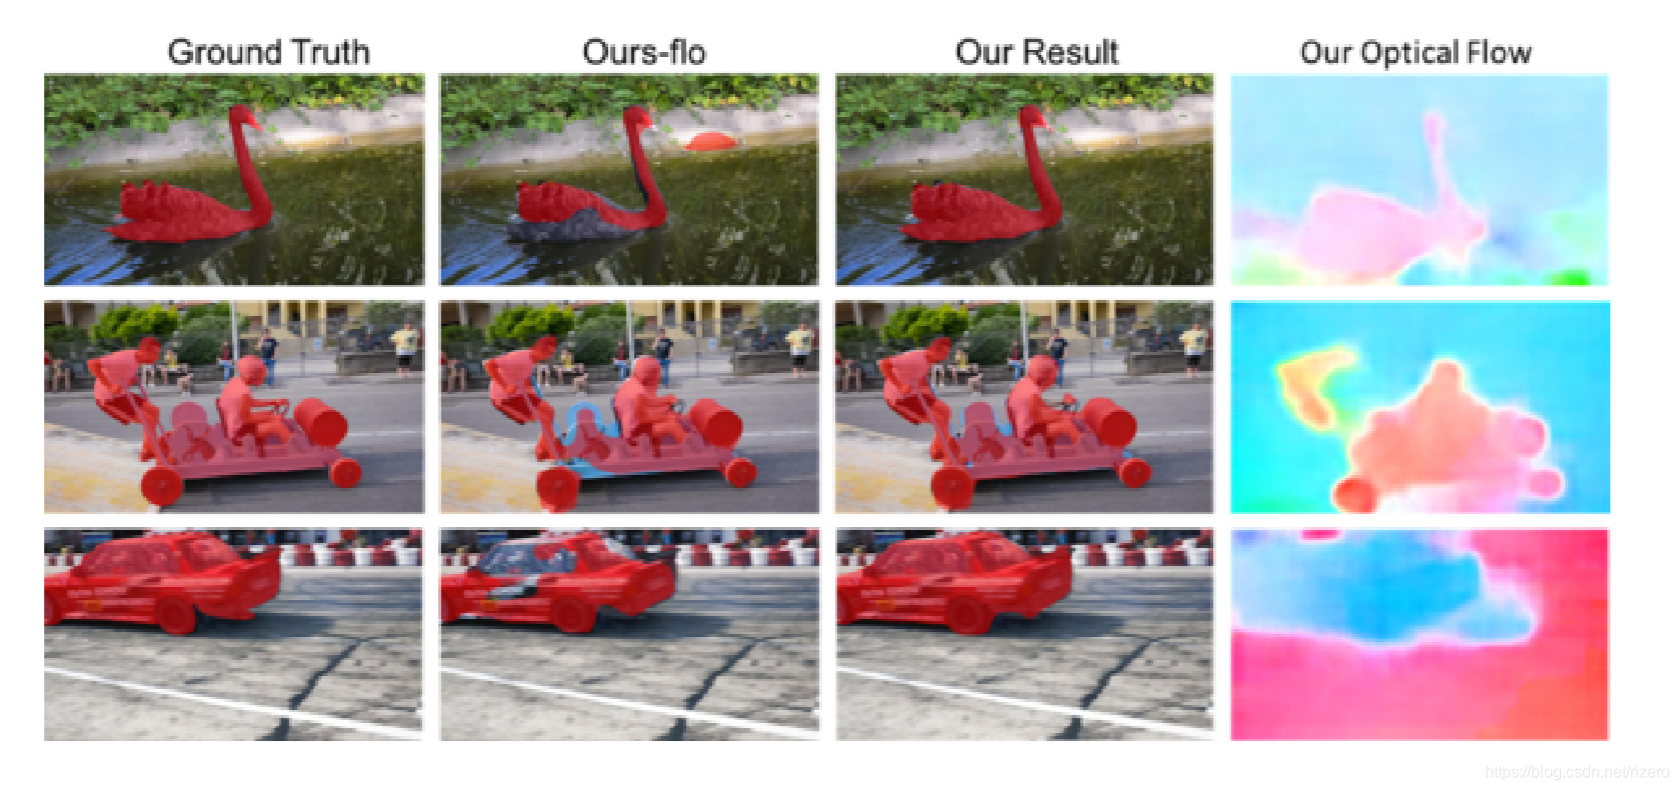
  • 效果:
    一般,让人感觉边缘分割相对粗糙
    效果
    在这里插入图片描述
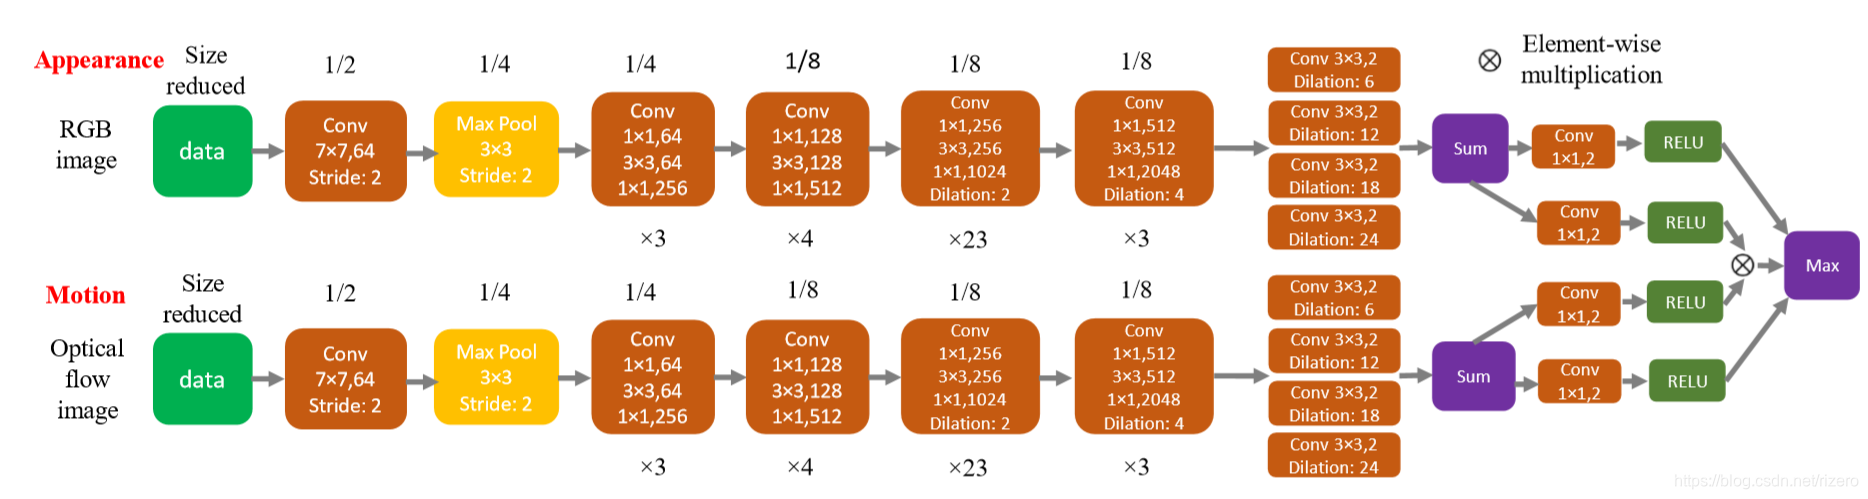
  • 网络结构:
    FusionSeg
  • 思想:
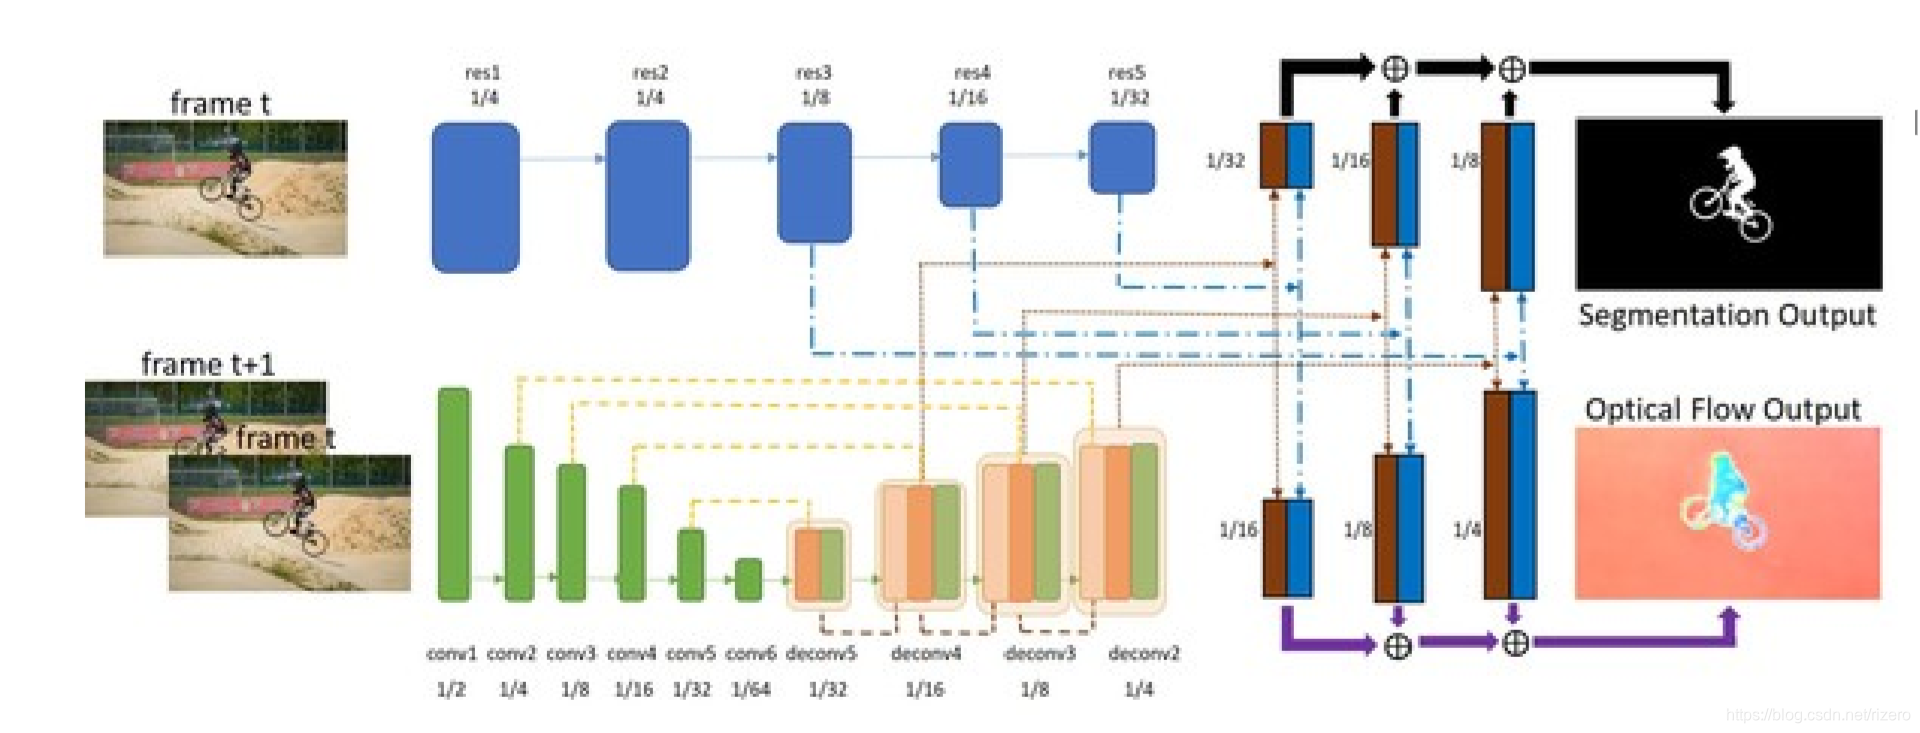
    网络包含两个分支(两个Resnet101,都是深层神经网络),一个学习RGB图片表观特征,一个学习光流特征(注意,光流特征输入的是光流图片,光流图片外部生成,用FlowNet),最后输出单个分割结果。
  • 成功原因:
    FSEG使用了深层神经网络进行图像特征学习,利用了光流图片(不是光流数据)给出运动物体产生的残影,这是一种比较初级的应用(我也有过直接利用光流图片的想法)。两个Resnet101的特征结合方法也是比较常规。相当于对每一帧都把网络跑一次进行分割,帧间关系只靠光流图片维持,这个方法中规中矩。靠深层网络学特征(这是静态分割的经典路线),然后加上了使用光流图片进行每帧辅助分割的部分。

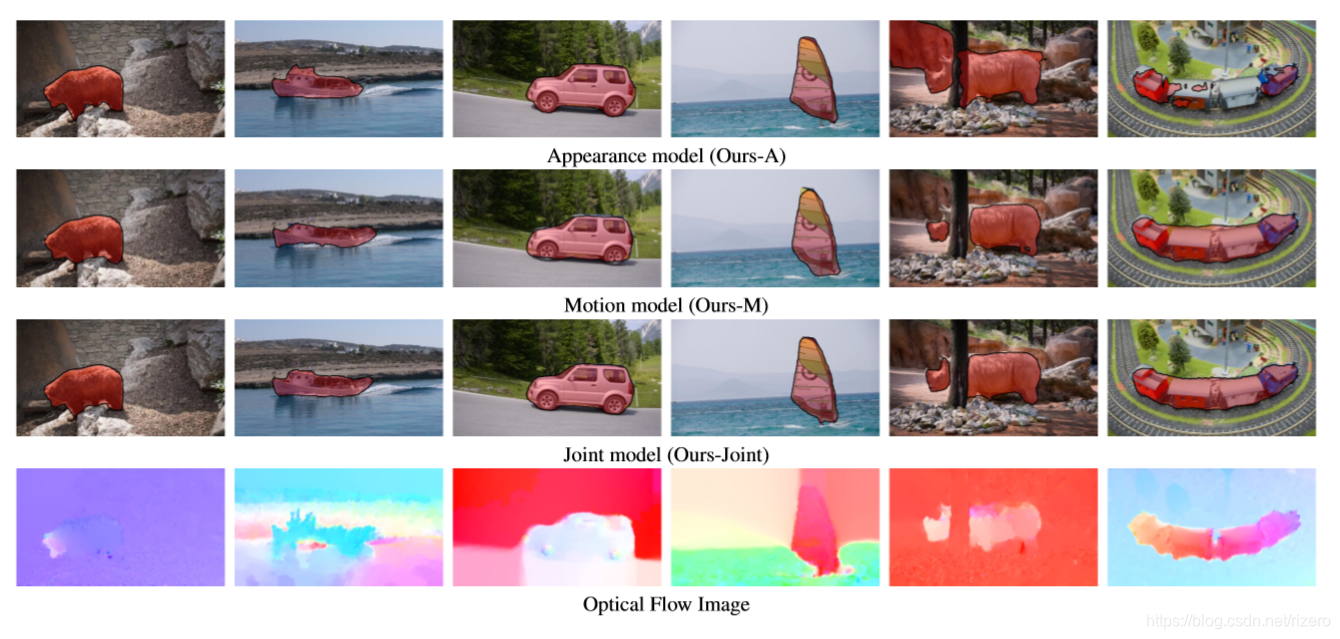
10. 论文:SegFlow

我的印象:充分利用帧间光流信息和静态分割的优秀分割网络

  • 效果:
    很好,主要看做右边那列和最左边那列的对比,明显对一些细节有注意
    在这里插入图片描述

  • 网络结构:
    在这里插入图片描述
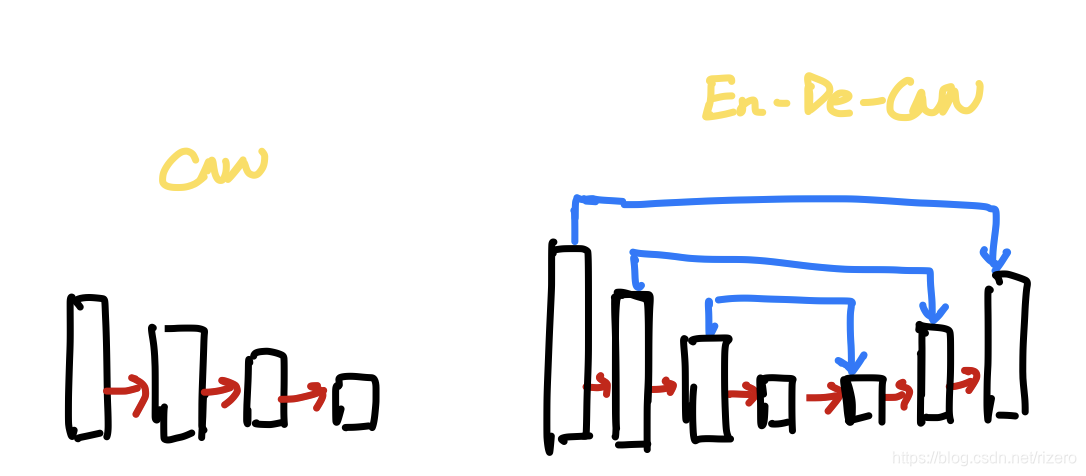
    首先,在光流计算的网络里面他用了编码器解码器的结构,就是我们之前看的Inet和Pnet那种结构。
    这种结构的好处在于能够把一些浅层丢失的信息找回来,由于像原生的Resnet101深层网络在直线传播的时候不断卷积难免会有信息丢失,使用编码解码的结构会帮助学习到更多特征信息。
    传统CNN和典型的编码器解码器套路示意图:
    在这里插入图片描述
    留意他的双层网络,上层使用单一的RGB特征蒙版学习,是直线传播过去的,没有用编码解码的结构,和《1.论文:FusionSeg》里面的RGB网络结构一致,估计这种方法对于RGB蒙版静态分割是有效的,所以大家才会有这个共通之处。
    最后看下他的特征聚合方法:
    聚合用到了共享特征的方法以此输出两个结果(一个蒙版结果,一个光流结果),后面特征聚合的棕色的各层数据来自于下层光流网络第二次之后每一层解码的数据,蓝色来自于上层RGB特征学习网络的每一层。这样一来,他的网络很好的把单帧的数据的特征和两帧之间的光流数据充分考虑了。

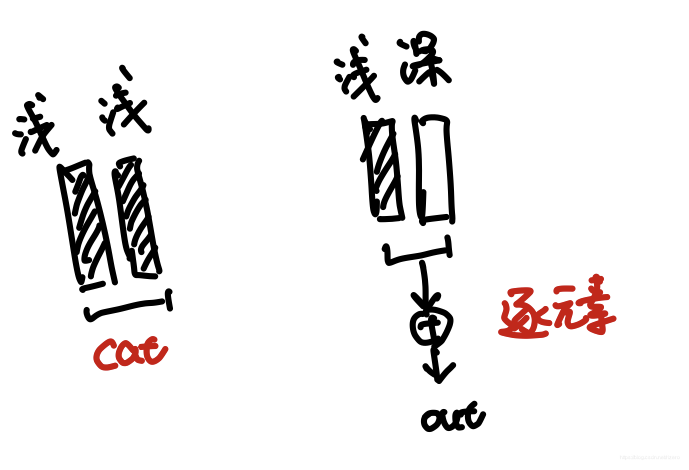
  • 学到的架构套路:
    (1)来自于基本同层次的数据使用cat拼接
    (2)来自不同层次的数据使用逐元素分权相加或者二次卷积
    在这里插入图片描述
    注:他在这篇文章使用的光流网络是FlownetS,来自于Flownet2.0那篇文章,输出的光流数据是非常好的,他在这里也提到为什么输出两个结果,论文说经过和蒙版配合训练得到的光流数据也得到了优化,结果两边都好,蒙版效果提升了,光流结果也提升了。

9. 论文:PointRend

我的印象:用于修复边缘的部件

  • 效果:
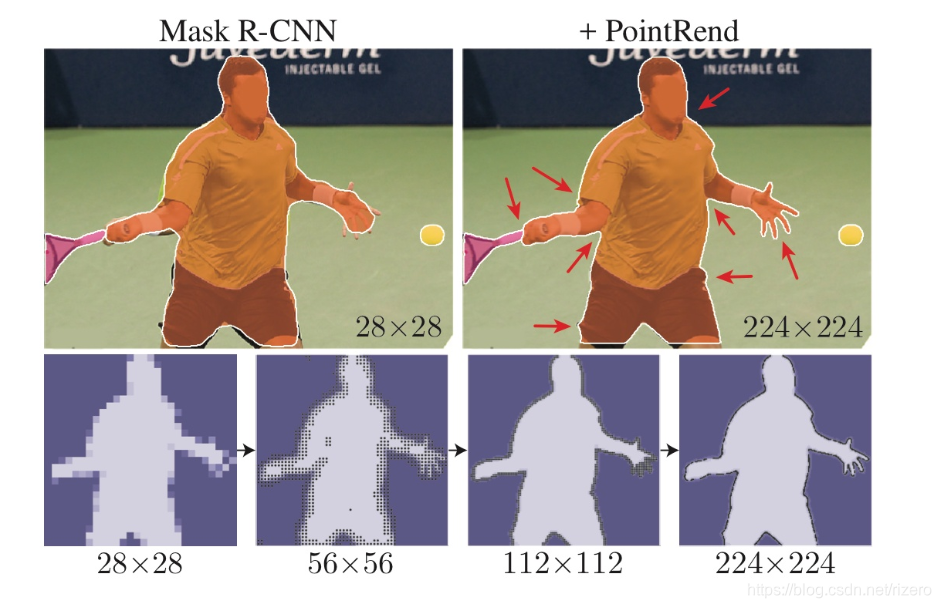
    对边缘的结果的修复看起来非常不错,分辨率越高的修复结果越好。
    PointRend
  • 核心算法解释(我个人看法)
    算法本质是提升上采样算法的质量。

背景前提:
因为在cnn的backbone降采样次数实在太多了,文中提到的Mask-R-cnn(也是何凯明的作品),预测出来的mask只有28x28,这是由resnet本身的结构决定的,网络越深就意味着你输出的分辨率越低。从28*28恢复到正常的图片大小边缘难免会出现偏差,一些细节就丢失了。

算法步骤:

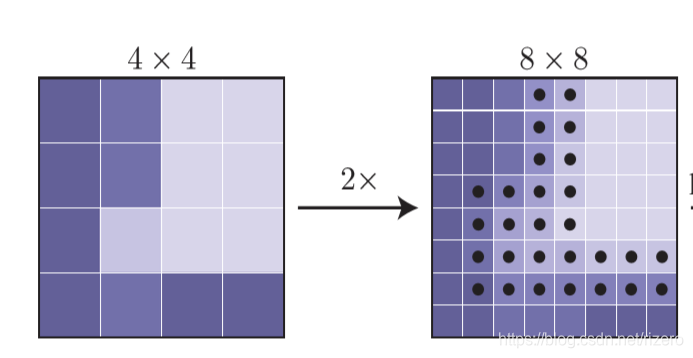
  1. 第一步:我们手上拿到了根据深层网络预测的蒙版,假设他只有4x4吧
  2. 第二步:我们首先对蒙版做一次2倍的双线性插值上采样得到8*8,说白了就是传统的图像resize的算法。
  3. 第三步:挑选出 N 个“黑点”,即结果很有可能和周围点不一样的点(比如边缘):
    如图(第二三步合在一起了):
    在这里插入图片描述
  4. 第四步:对于每个黑点,获取其“表征向量”,“表征向量”由两个部分组成,其一是低层特征,在进行双线性插值的特征,其二是高层特征,由步骤 1 获得,就是CNN-backbone深层细粒度的特征图。
  5. 第五步:给出预测,留下一些是边缘可能性大点,删掉可能性小的点,然后重复刚才的2-5步,逐渐从4x4→\rightarrow→ 8x8 →\rightarrow→ 16x16 →\rightarrow→ 32x32

现在,问题在于怎样选,留下和删掉的标准到底是什么,这时候我们利用ML来完成,文章提到说,开始更加偏向于随机采样的标准,我猜测这个训练的部分是可以放在网络训练里面,但是至于怎样放,文章并没有给出图。

8. 论文:FEELVOS

我的印象:提出新的描述两个像素相似的标准和充分利用了时序信息

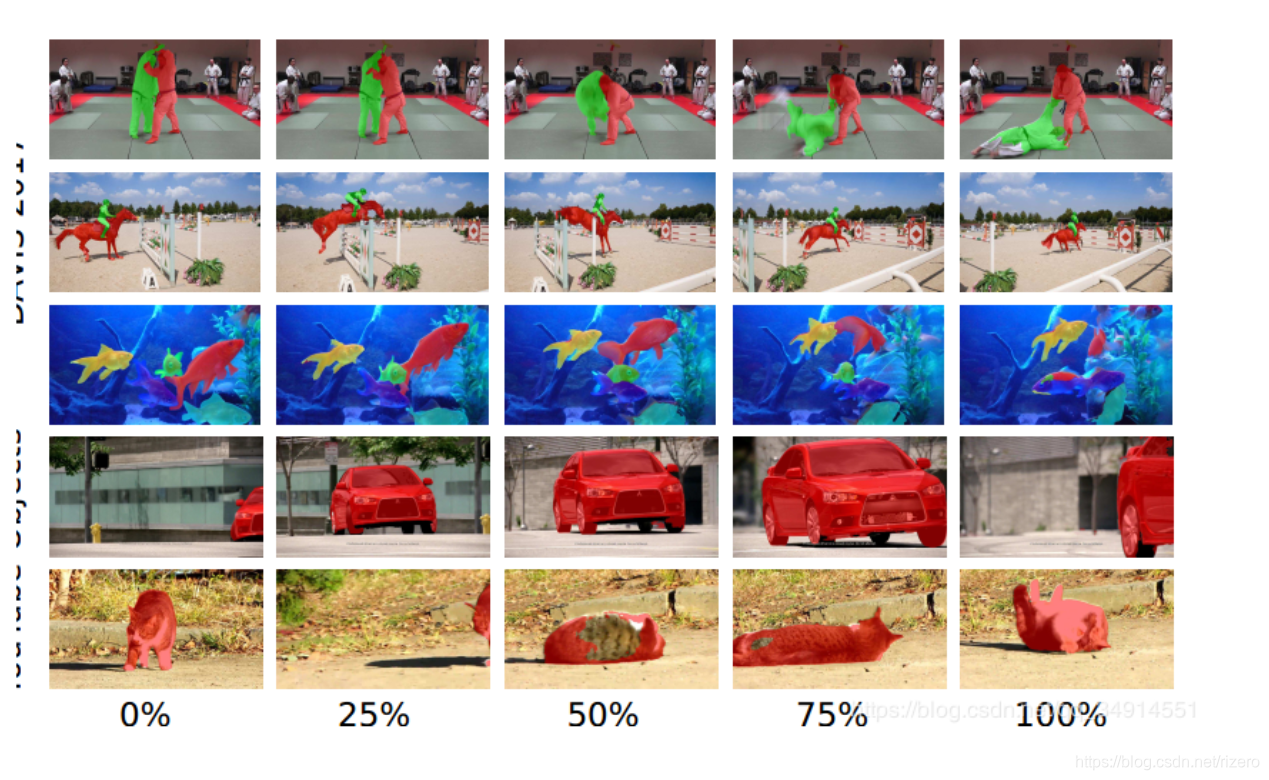
  • 效果:
    在这里插入图片描述
  • 算法步骤:
    这是多目标分割但仍然由值得我们借鉴的地方。
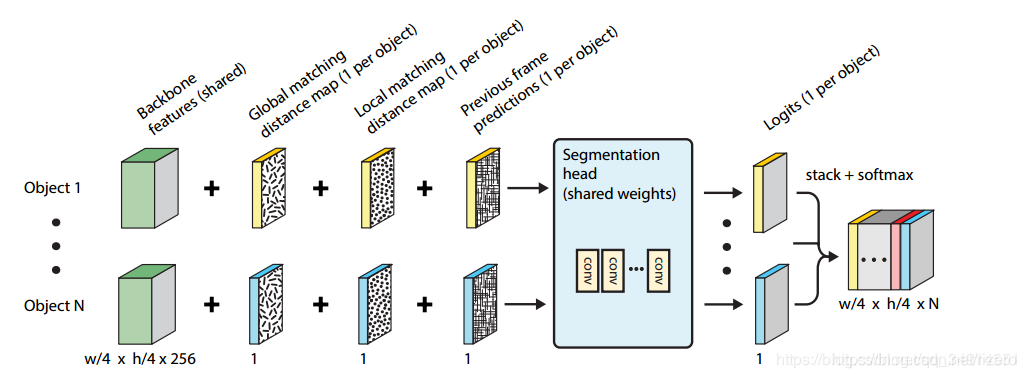
  1. 先用静态图像分割DeepLabv3+(去除最后的输出层)获得特征信息,在最顶层加上一个embeeding层用来提取embedding 向量。
  2. 根据embedding向量,通过global matching和 local matching得到两个distance map。
  3. 将两个distance map,DeepLabv3+提出的特征,前一帧的预测结果一共四个成分当做输入,送入到一个dynamic segmentation head中,这个头网络本质是4个深度分离卷积的stack。然后得到预测结果。
  4. 以上过程对帧中的每一个实例都进行一次,所以所用时间是随着实例的数目线性增加的。
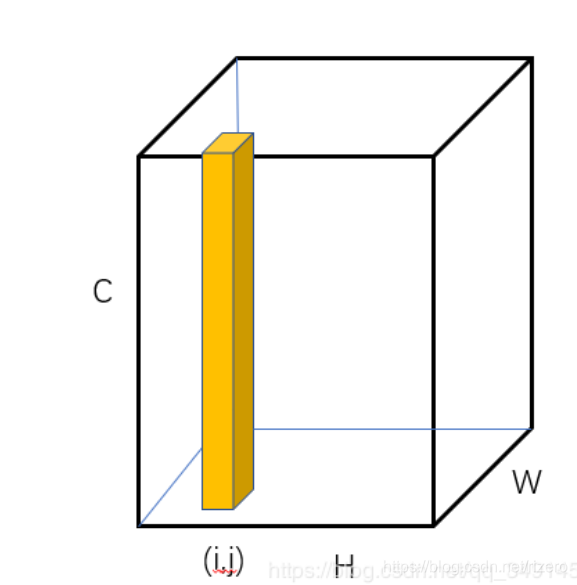
  • embedding向量

该向量是通过在DeepLabv3+(移除输出层)上再加了一个embedding层得到的。
这个层的向量用来描述像素的类别向量。
(1)如果两个像素是同一类的,那么这两个像素对应的embedding向量之间的距离会很接近。
(2)如果两个像素不属于同一类,那么这两个像素对应的embedding向量的距离很远。
在这里插入图片描述
然后我们设计标准描述两个像素的相似定义:
在这里插入图片描述
epe_pep​是对应于像素p的embedding向量,d(p,q)就是像素p到q在embedding空间的距离。距离越小,说明p和q是属于一类,反之亦然。
对于相同类别的像素,我们可以很轻松的求出d的值应该很接近0或者为0;对弈不同类别的像素,d接近1或者为1。

这里p和q来自不同的输入。其中一个像素,我们假设为q,q可能来自第一帧的embedding 像素,也可能来自前一帧的embedding像素;而另一个p,则是来自当前帧的embedding像素。根据q的不同,计算两种distance map:Global distance map和 Local distance map,分别用到global matching和local matching。

  • Global matching:(全局特征匹配)

第一帧送进网络仅仅是为了获得它的embedding向量,作为reference map,我们并不需要对第一帧做预测,因为第一帧的结果是已知的。
当前帧送进deeplabv3+得到embedding向量。我们先约定符号:

(1)PtP_tPt​ 记作第t帧的所有像素集合。
(2)Pt,oP_{t,o}Pt,o​记作,第t帧中属于类别O的像素集合。
(3)p 记作当前帧中的一个像素。
(4)Gt,o(p)G_{t,o}(p)Gt,o​(p) 记作p这个像素对应的global matching distance map的值
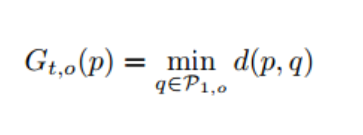
在这里插入图片描述
所以想要得到完整的global matching distance map,需要把当前帧所有的像素点的embedding向量,都和第一帧中属于同一类的embedding向量用之前定义的向量距离公式计算,然后取最小的距离值。
这个过程其实相当费时间。论文中网络输入大小为465x465,即便经过deeplabv3+得到减少4倍的特征图,计算量仍然很大,虽然最终能跑0.5秒一帧。

  • Local previous Frame Matching(局部特征匹配)

现在p属于前一帧的像素。计算公式仍然和全局匹配距离图的方法很相似
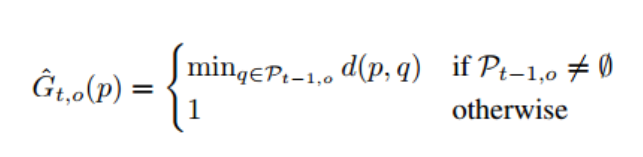
在这里插入图片描述
注意到前一帧可能没有目标的,所以有个otherwise选项。如果前一帧没有目标,那么得到的map都是1。
但是前一帧和当前帧中目标的移动一般是很小的,没有必要还去用当前embedding feature的一个向量对所有的第一帧的embedding向量计算距离。受到Flownet的启发,仅仅在一个k邻域的大小中计算距离。也就是用一个2*k+1的窗口约束q的位置。所以实际上使用的是下面的公式:
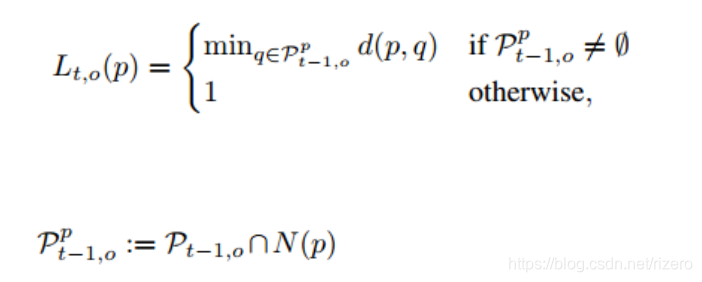
在这里插入图片描述
N是在p的x和y方向上至多k个像素距离的像素集合,q则是前一帧的像素。

  • 网络结构
    在这里插入图片描述
    网络输入有四样:两个distance map,前一帧的预测结果,当前帧的deeplabv3+的输出特征图(不含embedding layer)
    这个头网络结构简单,有四个深度分离卷积组成,产生一个一维的feature map用来预测类别,注意这个map仅仅为一个目标预测类别 logits,所有实例目标都要经过这样的网络流程。所以每个实例都会得到一个一维的feature map,将它们stack一起,使用softmax,用一个交叉熵和label训练。

文章关于利用时序信息和衡量像素相似的评价标准还是由值得学习的地方。

7. 论文:经典的 Mask R-CNN

我的印象:通过目标检测来降低整体难度

  • 效果
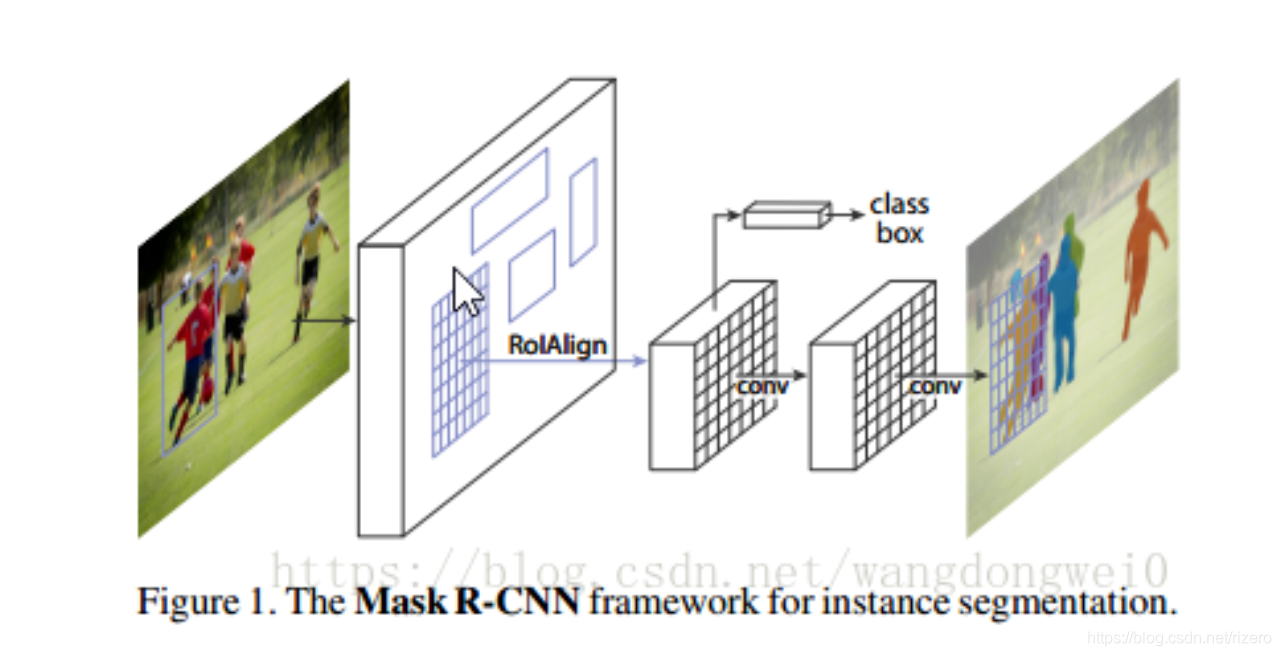
    虽然他是用来多对象实例分割的,但他的思想仍有值得学习的地方。因为多实例分割任务能完成,就意味着他也能完成单实例分割的任务。
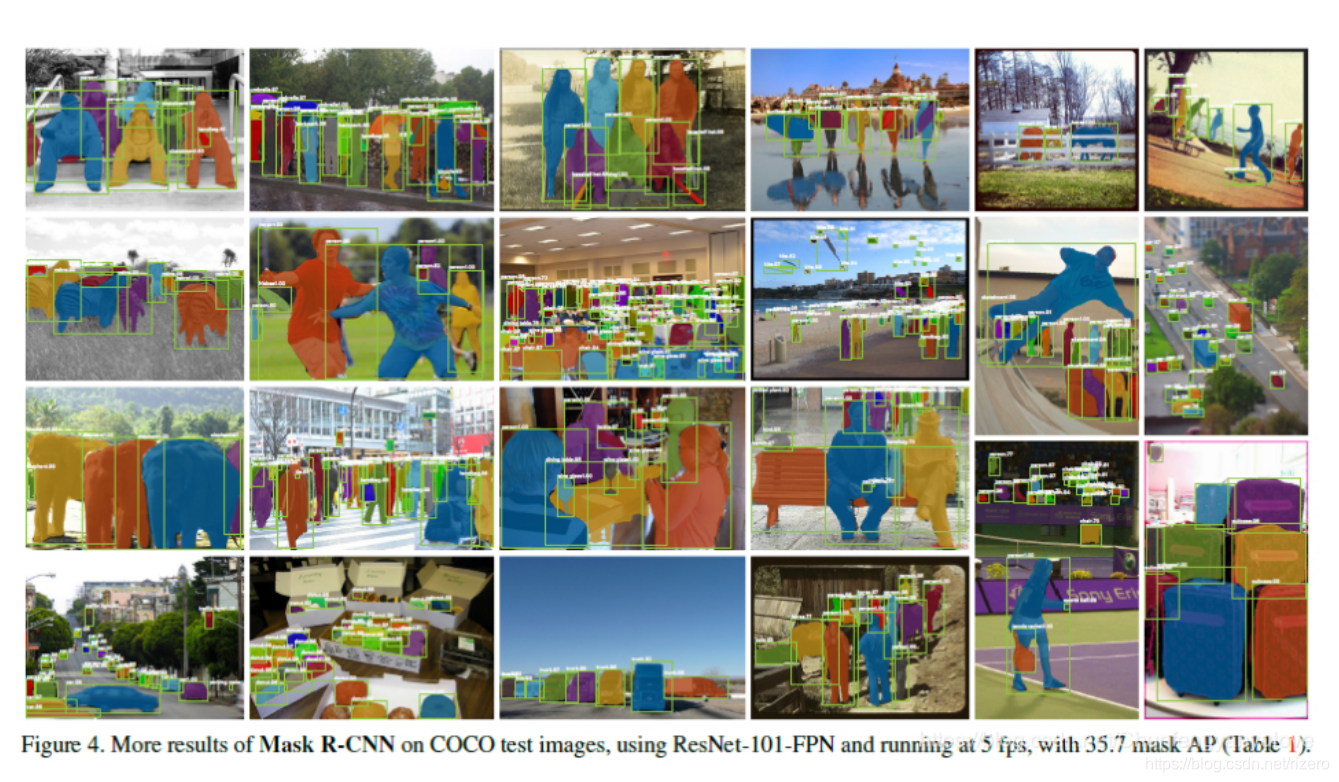
    在这里插入图片描述
    实例分割的难点在于:需要同时检测出目标的位置并且对目标进行分割,所以这就需要融合目标检测(框出目标的位置)以及语义分割(对像素进行分类,分割出目标)方法。在Mask R-CNN之前,Faster R-CNN在目标检测领域表现较好,同时FCN在语义分割领域表现较好。所以很自然的方法是将Faster R-CNN与FCN相结合。

  • 网络结构
    在这里插入图片描述
    实现步骤其实很简单,首先先用Faster-R-CNN目标检测出ROI Align,然后在ROI区域里面进行像素分类。
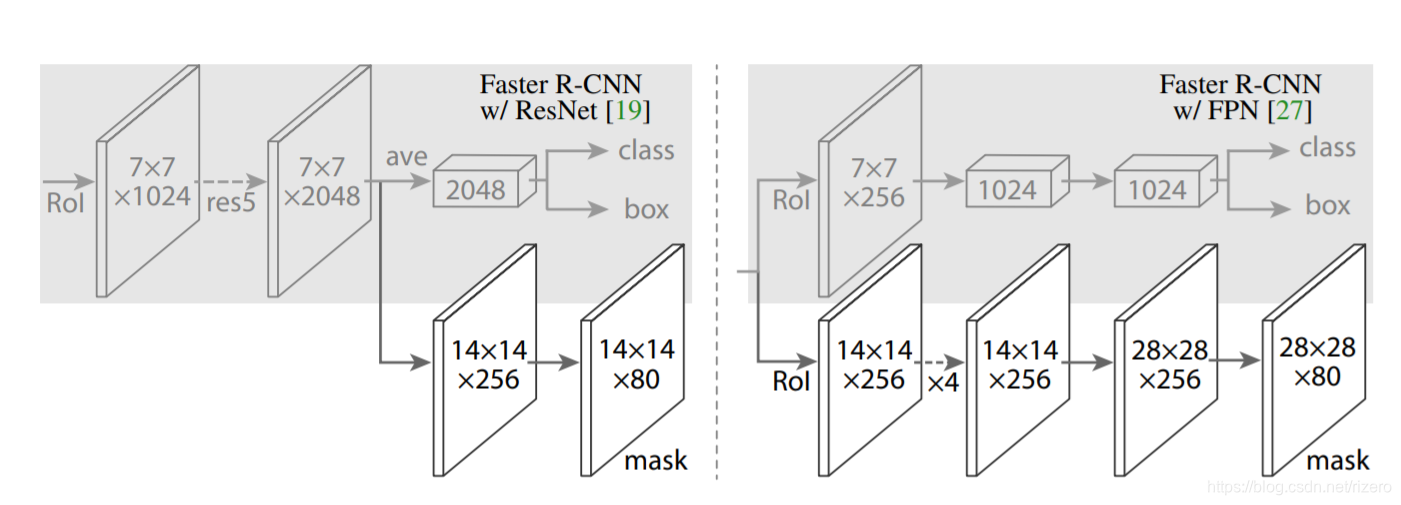
    在这里插入图片描述
    文中对使用resnet和FPN进行像素分割的效果做了比较,发现FPN更好。

6. 论文:Mask Scoring R-CNN(Mask-R-CNN的改进版)

我的印象:

  • 网络结构:
    在这里插入图片描述
  • 解释:
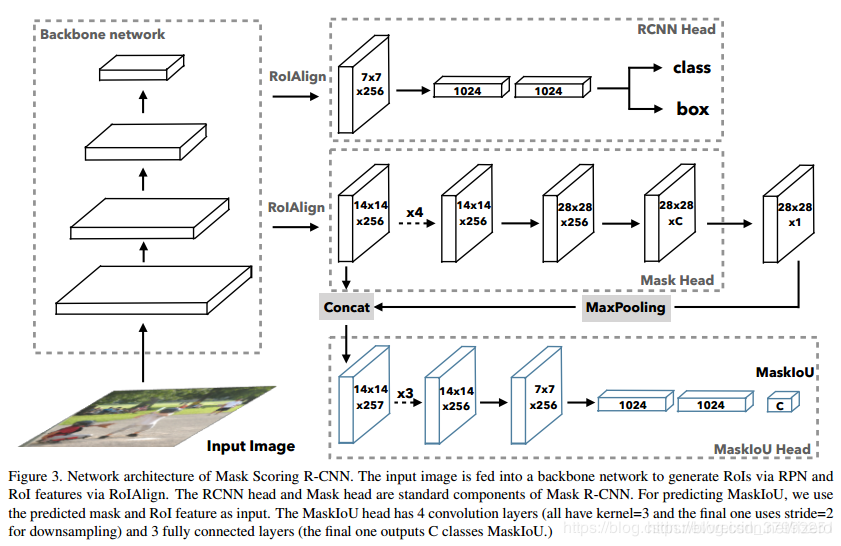
    上面整体上还是Mask-R-CNN的东西,下面把Iou也作为训练的对象,也就是说网络同时完成多了一个预测输出Mask和ground Truth的Iou值预测。

5. 论文:Hybrid Task Cascade

我的印象:引入了级联优化策略

方法用于静态图像分割
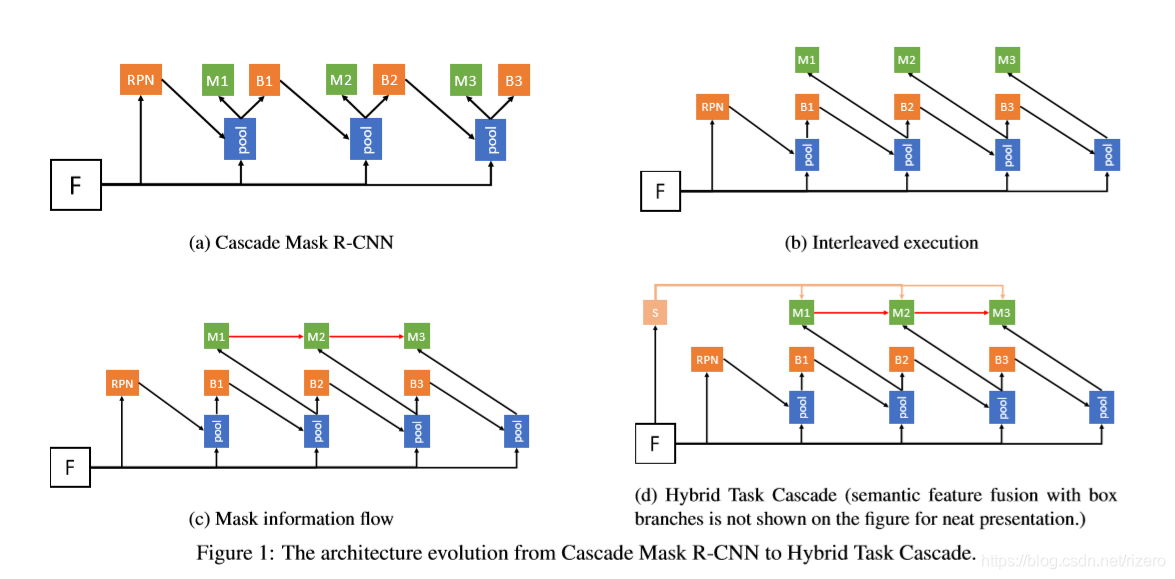
在这里插入图片描述
这个图看起来实在不舒服,B代表背景,F代表图像,M代表中间结果的蒙版。他不断通过级联筛选出背景信息以达到更好的分割效果。

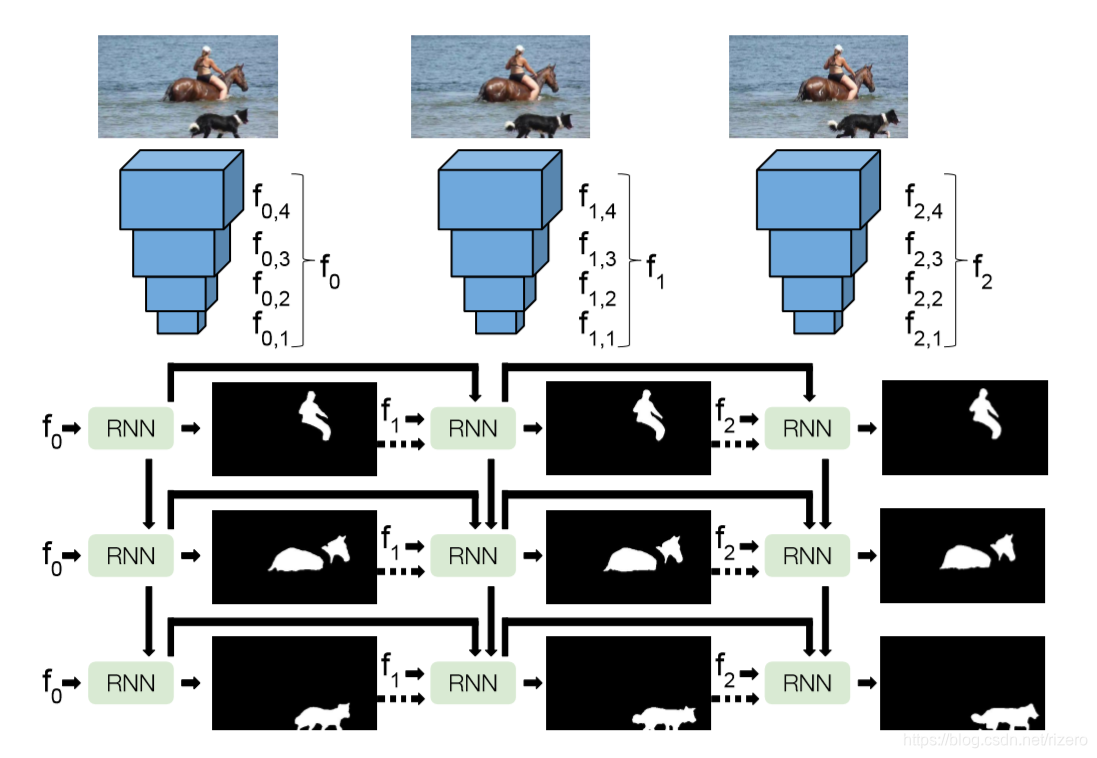
4. 论文:RVOS-Recurrent Network

我的印象:对每一帧都用一次静态分割,但他能完成多实例分割任务

  • 效果
    在这里插入图片描述
  • 网络结构:
    在这里插入图片描述
    思想:对每一帧都用用一次RNN静态分割,然后把上一帧的蒙版也作为网络输入。

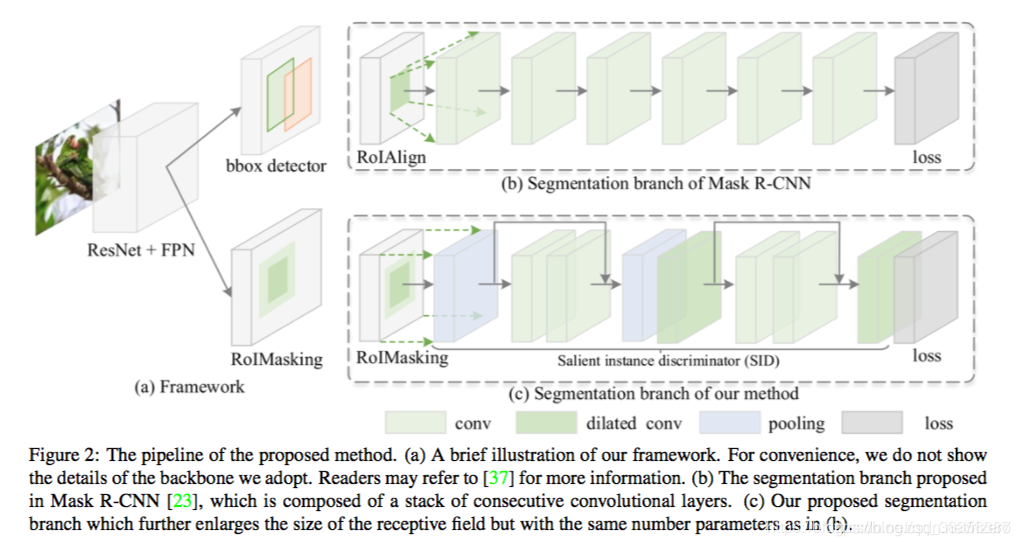
3. 论文:S4Net

我的印象:把负的背景信息保留在网络训练

属于单帧图像分割任务
-效果:
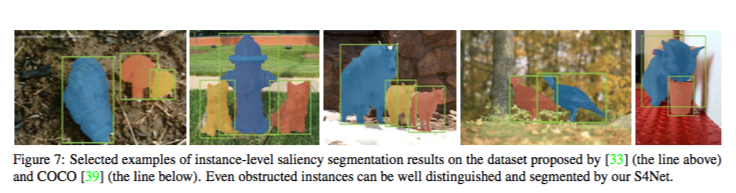
在这里插入图片描述

  • 网络结构:
    在这里插入图片描述
    上面是mask-r-cnn,下面是s4net,他的最大特点在于ROImasking,并没有像mask-R-cnn把背景信息删掉只留下ROI,而是把背景作为”负“影响继续留存在网络当中。

这种方法属于目标检测方向的实例分割的一种分支。

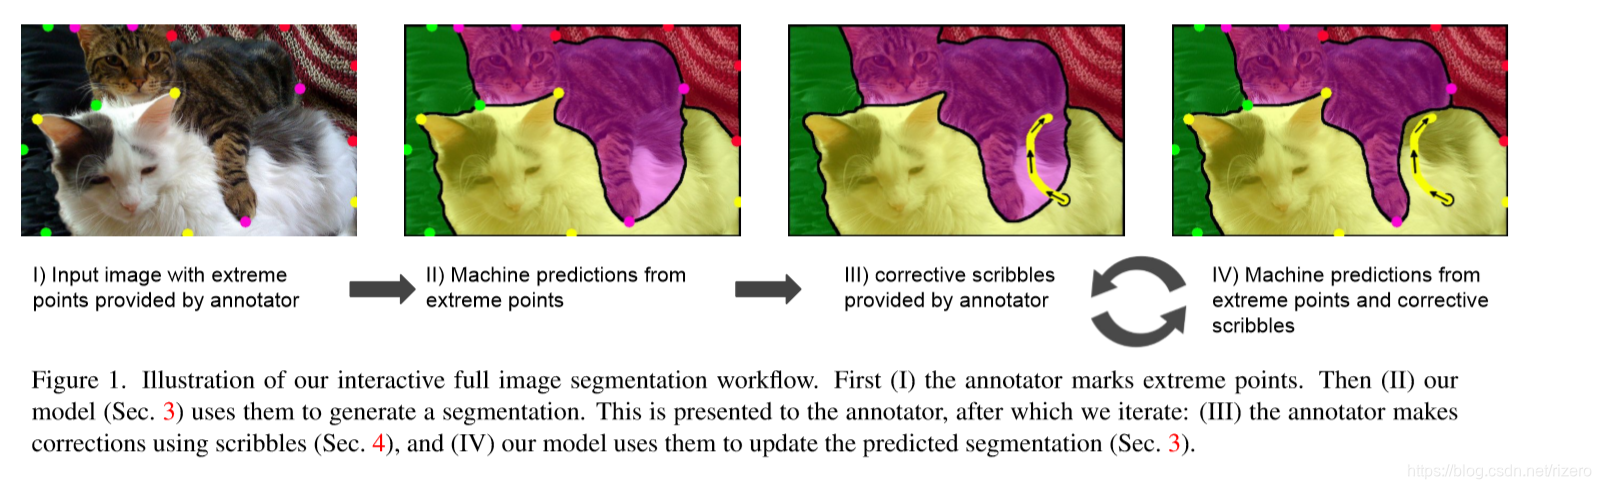
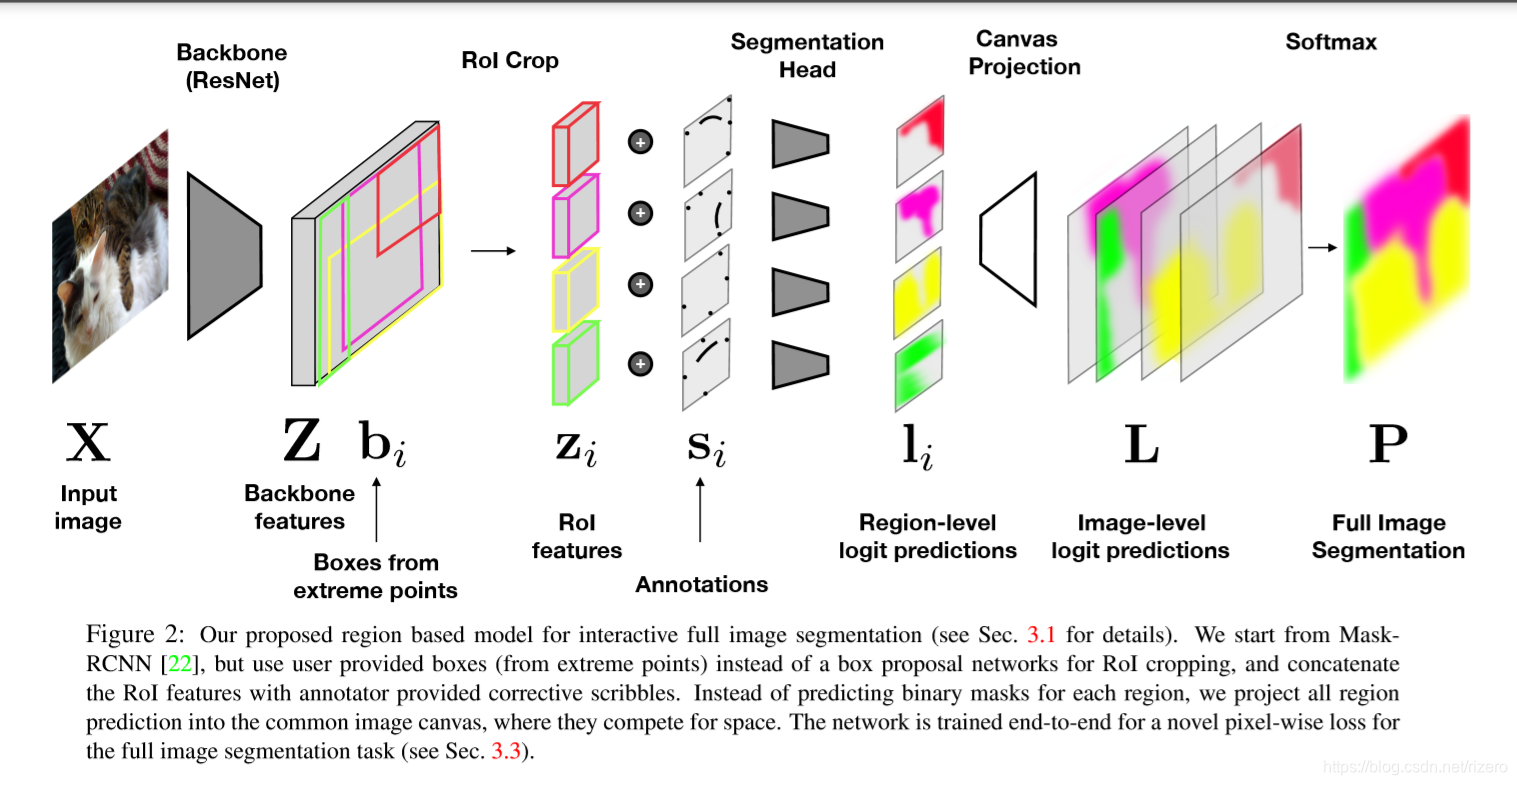
2. 论文:Interactive Full Image Segmentation

我的印象:把交互信息变成连点预测边缘

  • 效果:
    在这里插入图片描述
  • 网络结构
    在这里插入图片描述
    实际上,要求用户给出在边缘分割点的交互信息,就变成了一个连线预测问题。

1. 论文:Spatiotemporal CNN

我的印象:对细节表现非常不错

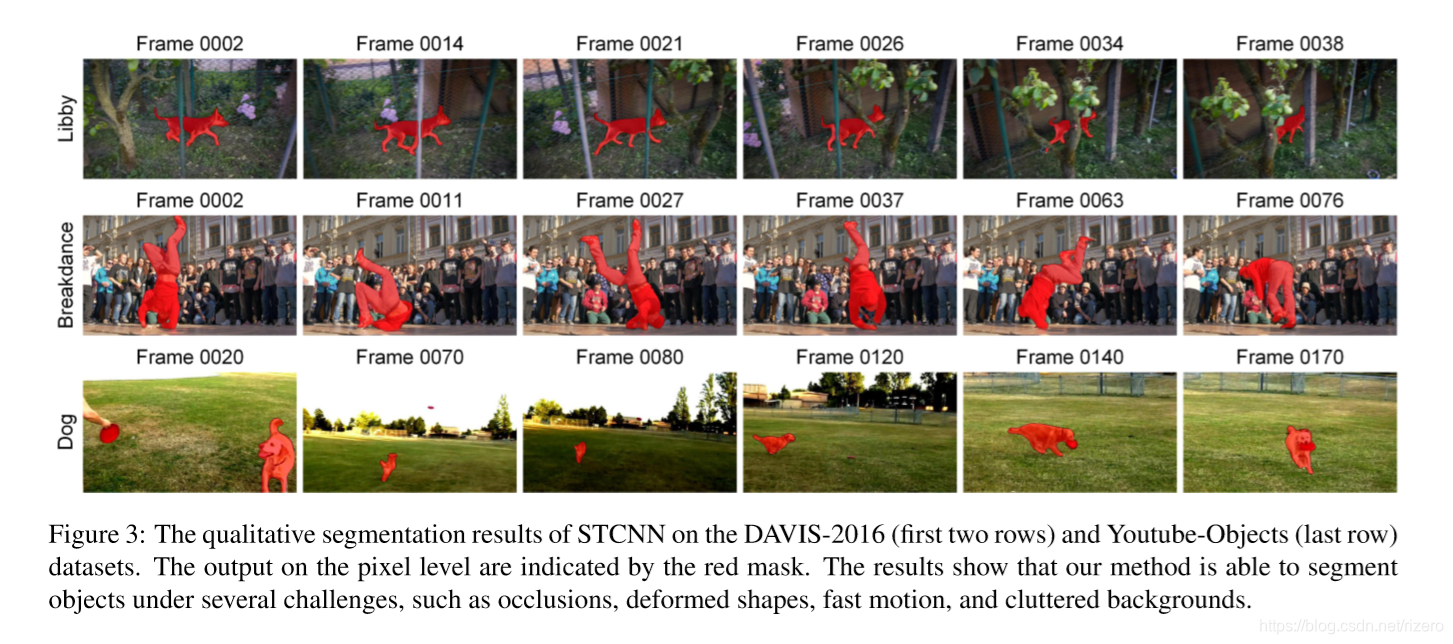
  • 效果:
    在这里插入图片描述
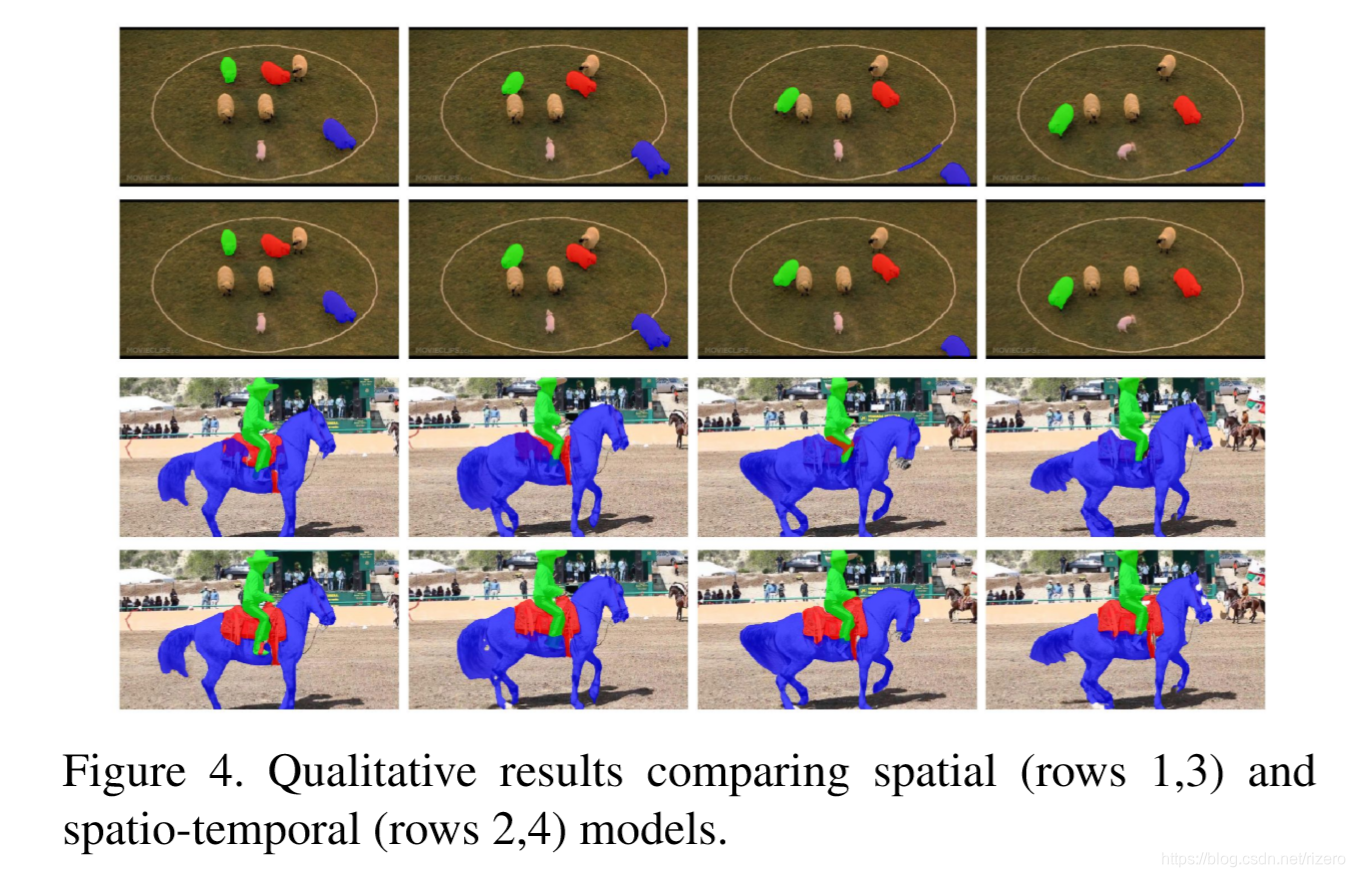
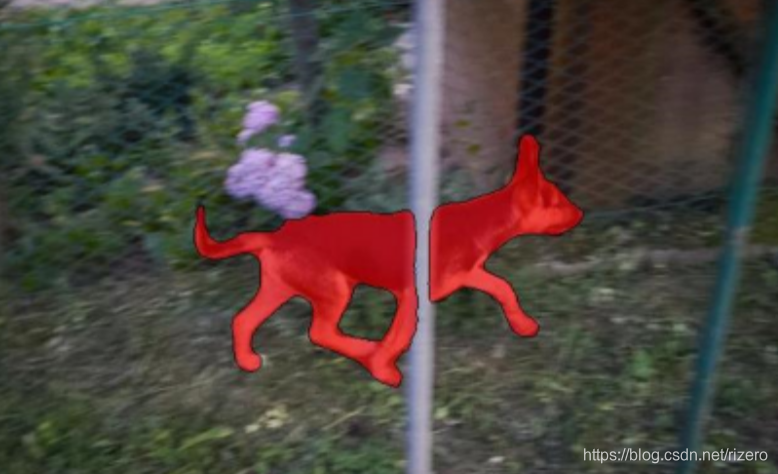
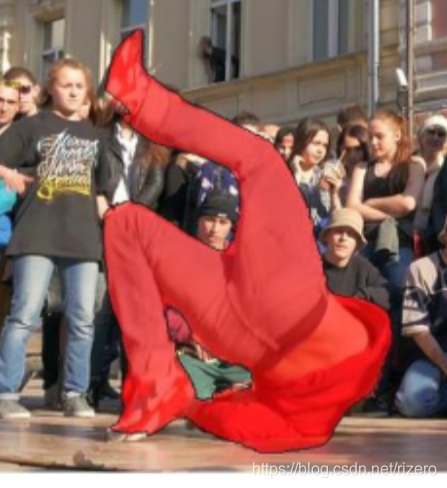
    注意这个效果:
    在这里插入图片描述
    在这里插入图片描述
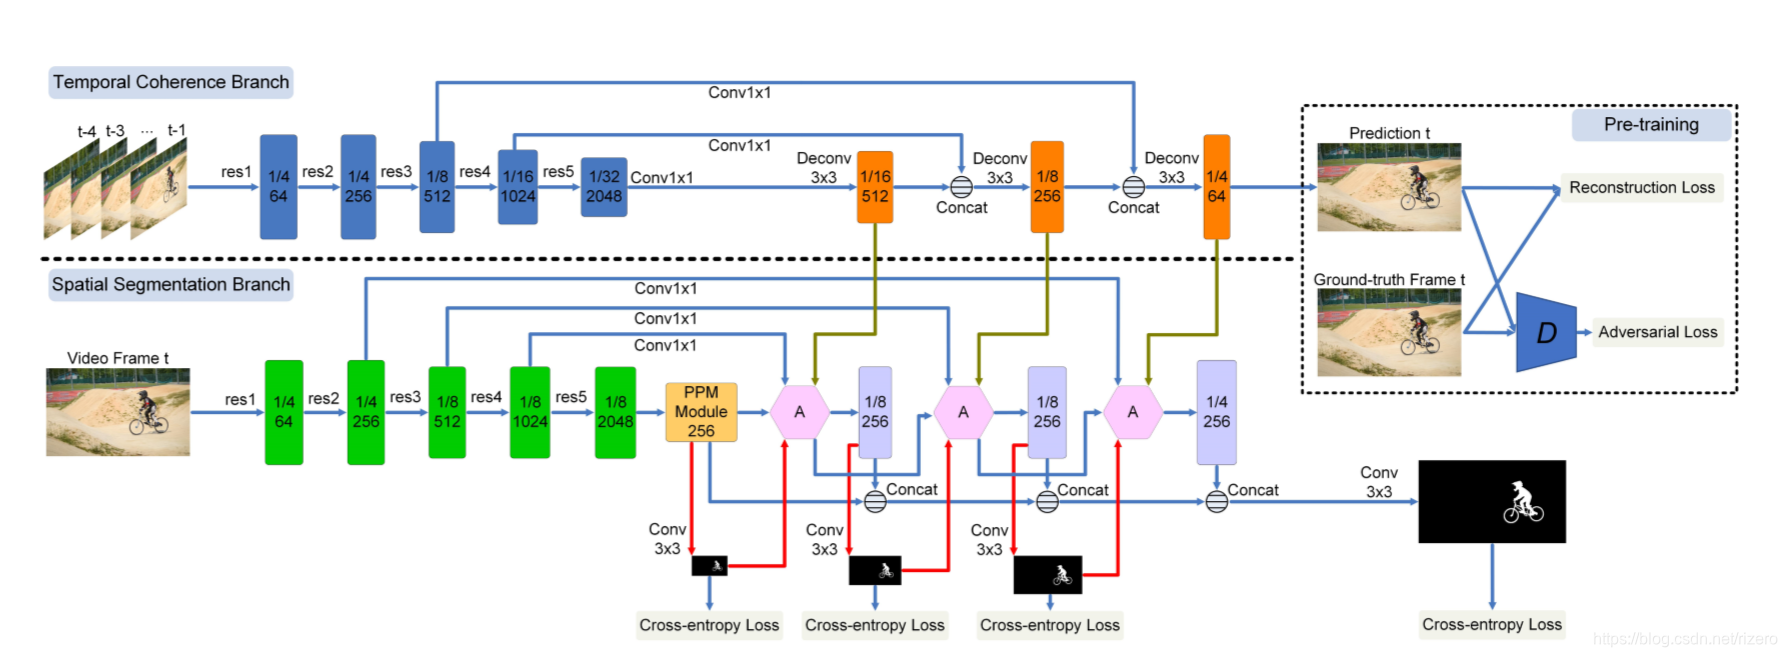
  • 网络结构:
    在这里插入图片描述
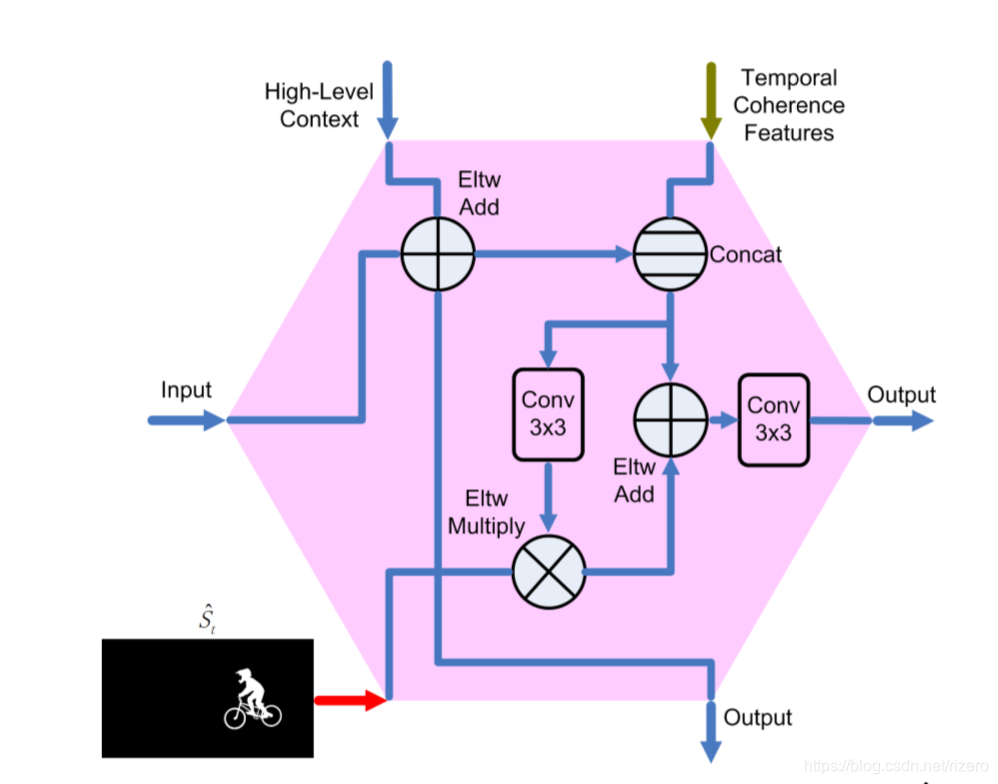
    虚线上方的部分是时间相干分支,虚线下方的部分是空间分割分支。 红线表示模型中使用的注意力机制,六边形表示注意力模块。 每个卷积层之后是批处理归一化层和ReLU层。
    …
    (未写完。。。。)
  • 六边形注意力模块
    在这里插入图片描述
    未完待续。。。
视频图像的处理(背景差分法、光流法、帧间差分法) 背景差分法 (一)BackgroundSubtractorMOG 这是一个以混合高斯模型为基础的前景/背景分割算法。2001年,P. KadewTraKuPong 和 R. Bowden在论文"An improved adaptive background mixture model for real-time tracking with shadow detection" 中进行了介绍。它使用 K(K=3 或 5)个高斯分布混合对背景像素进行建模。混合的权重表示这些颜色停留在场景中的时间比例,背景颜色是那 阅读详情

相关推荐

ICCV 2023|小红书 4 篇入选论文亮点解读,「开集视频目标分割」获得 Oral

近日,ICCV 正式揭晓 2023 年论文接收结果,小红书技术团队共有4篇论文入选,其中1篇为 Oral 论文(Oral 接收率仅为 1.88%),最新科研成果涵盖了视频目标分割、3D 数字人重建、人体运动预测、视频分析等领域。

REDtech_1024的博客 890

视频对象分割方法(可用作实验对比):FST,FSEG,SFL,LVO,ARP

视频对象分割方法(可用作实验对比):FST,FSEG,SFL,LVO,ARP 1、FST (ICCV2013: Fast object segmentation in unconstrained video) 两个主要阶段: (1)Efficient initial foreground estimation有效的初始前景估计 (2)Foreground-background labelling refinement前景-背景标签细化 官方代码链接:http://groups.inf.ed.ac.uk/ca

zero_ling 786

CVPR 2021 结果出炉!最全论文下载及分类汇总(更新中)

CVPR2021接受论文待更新~ 在2020年,目标检测与人脸方向热度经久不衰,目标跟踪、行人检测与重识别、图像分割等方向也占据大头,那么今年的热门方向将会有哪些?大家可以预测一波~ 极市一直非常关注CVPR,在每年都会进行CVPR相关的论文资源整理,包括论文解读、代码、技术直播、分方向盘点、最佳论文汇总等,也得到了许多开发者的支持。在Github上,极市的CVPR盘点已经收获了5.7K star。在今年,我们也会对CVPR2021进行实时跟进。 Github项目地址: https://github.

极市平台的技术博客 6万+

FusionSeg_Learning to combine motion and appearance for fully automatic 论文翻译

一、摘要我们提出了一个端到端的学习框架,在视频中分割一般对象。我们的方法是学习将外观和运动信息结合起来,为所有突出的物体生成像素级的分割掩码。我们将该任务作为一个结构化的预测问题,设计了一个双流全卷积神经网络,将运动和外观融合在一个统一的框架中。由于缺乏像素级分段的大型视频数据集,我们展示了如何将弱注释的视频与现有的图像识别数据集一起进行训练。通过对三种具有挑战性的视频分割基准的实验,我们的方法实...

Eternity的博客 1245

ECCV 2024 | 被注意力出卖:一种简单而有效的自监督视频对象分割方法

作者提出了一种简单而有效的自监督视频对象分割(VOS)方法。以往的自监督VOS技术主要依赖于辅助模态或利用迭代槽位注意力来协助对象发现,这限制了它们的通用性。为了应对这些挑战,作者开发了一种简化的架构,利用DINO预训练的Transformer模型中出现的物体性,绕过了额外模态或槽位注意力的需求。作者的关键洞见在于DINO预训练的Transformer中固有的结构依赖可以用来建立视频中稳健的时空对应关系。此外,简单的聚类就足以产生有竞争力的分割结果。

小白学视觉 243

光流法分割matlab代码-FusionSeg_optical_flow:光流

光流法分割matlab代码FusionSeg:学习结合运动和外观以全自动分割视频中的通用对象 以下存储库包含 FusionSeg 视频对象分割方法的预训练模型。 请访问我们的论文和视觉结果。 如果您在研究中使用它,请引用以下论文: @article{pixelobjectness, Author = {Jain, Suyog and Xiong, Bo and Grauman, Kristen}, Journal = {arXiv preprint arXiv:1701.05349}, Title = {Pixel Objectness}, Year = {2017} } @article{fusionseg, Author = {Jain, Suyog and Xiong, Bo and Grauman, Kristen}, Journal = {CVPR}, Title = {FusionSeg: Learning to combine motion and appearance for fully automatic segmention of generic objects i

视频对象分割论文解读系列【2】

此处最后解读数据库更新时间:2020-3-09 联系邮箱:jintuzheng@outlook.com 新增论文原文镜像链接 3. 论文:Learning Moving Objects 原题《Learning to Segment Moving Objects in Videos》 总印象: 4. 论文:Interactive VOS (Wild) 原题:《Interacti...

晋图的非正常人类胡言乱语集合 509

基于Qwen3-14B大模型的智能UI自动化测试实践

UI自动化测试是软件工程中保障产品质量的关键环节,其核心原理是通过脚本模拟用户操作,对软件界面进行功能验证。传统方法依赖于编写和维护基于元素定位的固定规则脚本,在面对复杂交互或频繁变化的界面时,维护成本高昂。大语言模型(LLM)的出现为这一领域带来了新的技术价值,其强大的自然语言理解和代码生成能力,使得测试脚本的编写从精确编码转向了任务描述。通过将大模型作为决策大脑,结合Playwright等自动化工具作为执行器,可以构建出能够理解界面、规划操作并验证结果的智能测试系统。这种方案特别适用于处理变化频繁、逻辑

weixin_42619742的博客 301

SAM2论文解读-既实现了视频的分割一切,又比图像的分割一切SAM更快更好

核心目标:给定输入视频,通过在任意视频帧上提供交互式提示(如点、框、掩码),分割并跟踪目标对象的时空掩码(masklet),即生成覆盖整个视频的时空一致分割结果。交互性:用户可在任意帧添加提示以迭代优化分割结果。例如,在某一帧纠正分割错误后,模型会将修正传播到整个视频,减少重复标注成本。对比半监督视频对象分割(VOS)VOS通常仅在第一帧提供掩码提示,且聚焦于完整物体跟踪;PVS支持多帧任意提示,并可分割物体部分(如“人的手臂”),覆盖更广泛的“任意物体”场景。

unique_zhao的博客 1978

E5071C 网络分析仪使用指南

E5071C 网络分析仪是 Keysight(原 Agilent)推出的一款高性能矢量网络分析仪,广泛应用于射频(RF)和微波(MW)电路设计、天线测试、滤波器优化等领域。它以高精度、宽频率范围(9 kHz–20 GHz)、出色的动态范围和灵活的测量功能著称。本文将详细介绍 E5071C 的基本操作方法,帮助用户快速上手并高效使用该设备。

2501_90901792的博客 4182

拆解人形机器人:核心硬件与驱动系统

本文深入解析人形机器人的核心硬件系统,将其类比为"骨骼+肌肉+神经"的集成体。重点介绍了三大关键组件:驱动单元(无框力矩电机和空心杯电机)、传动单元(谐波减速器和行星滚柱丝杠)以及感知单元(力矩传感器、编码器和IMU)。文章指出一体化关节模组正成为行业趋势,能够实现更紧凑的结构和更高的可靠性。同时分析了硬件价值量分布,强调丝杠、电机等部件是当前技术高地和成本重心。最后指出随着技术进步,机器人价值将更多向"大脑"和"神经"转移。

小明的博客 1528

论文解读 | CVPR2024:统一且通用的视频分割大模型

点击蓝字关注我们AI TIME欢迎每一位AI爱好者的加入!李明晗李明晗,香港理工大学博士生,博士生导师张磊。在这之前,她跟随孟德宇老师在西安交通大学数学院取得硕士学位。他的研究兴趣是视频复原,分割和生成任务。李明晗以第一作者在CVPR发表4篇文章,在TIP发表一篇文章。同时她也是很多CCF会议和期刊的审稿人,包括CVPR,ICCV,ECCV,AAAI和信号处理。内容简介 尽管统一图像分割取得了很...

AITIME_HY的博客 4364

巨某量引擎后台登录实战笔记 | Playwright自动化框架

自动化框架、Playwright、滑块、巨某量引擎、抖某音系

什么都会一点。 2076

论文解读 | ECCV2024 一个通用的视频分割框架

点击蓝字关注我们AI TIME欢迎每一位AI爱好者的加入!点击阅读原文观看作者讲解回放!作者简介陈牧,悉尼科技大学博士生,ReLER实验室成员,研究方向包括自动驾驶、机器感知等概述 我们提出了GvSeg,这是一个通用的视频分割框架,用于处理四种不同的视频分割任务(即实例、语义、全景和示例引导),同时保持一致的架构设计。目前,开发能够跨多个任务应用的通用视频分割解决方案的趋势正在增长。这简化了研...

AITIME_HY的博客 1491

bartender 10.1破解版|bartender条码打印10.1

点击下载出处:BarTender10.1破解版 bartender10.1破解版是一款专业的条码打印软件,在行业内广受好评,通过使用bartender我们可以将标签设计这个复杂的过程变得更简便,在设计中快速调整,即刻打印,非常迅速,BarTender10.1破解版不仅支持的标签类型包括EPC Class 1 、Gen2 、ISO 18000-6b 、ISO 15693 、Tag-It 、I-CO...

weixin_44924147的博客 6万+

鼎捷T100——二次开发:维护作业添加非实体字段

非实体字段添加

weixin_52342654的博客 1156

SAM多目标跟踪与分割TAM论文解读Track Anything: Segment Anything Meets Videos

SAM图像分割能力强,与不同提示的交互性高,但它在视频的一致性分割方面表现不佳。因此,作者提出了跟踪任何模型TAM,它实现了视频中的高性能交互式跟踪和分割。具体来说,给定一个视频序列,只需很少的人为参与,即几次点击,人们就可以跟踪他们感兴趣的任何东西,并在一次推理中获得满意的结果。无需额外的训练,这种交互设计在视频对象跟踪和分割方面表现令人印象深刻。与视频目标跟踪(VOT)类似,视频对象分割(VOS)的目的是将视频序列中的目标从背景中分离出来,可以看作是一种更细粒度的目标跟踪。

sunshineine的博客 2750

如何为 Claude Code 配置代理与网络环境

那么大概率不是软件问题,而是。因为 Claude Code 是运行在终端里的,不是浏览器。

sg_knight的专栏 3478

【图像分割】Segment Anything(Meta AI)论文解读

Segment Anything(SA)项目:一个图像分割新的任务、模型和数据集。建立了迄今为止最大的分割数据集,在11M许可和尊重隐私的图像上有超过1亿个mask。该模型的设计和训练是灵活的,因此它可以将zero-shot(零样本)转移到新的图像分布和任务。实验评估了它在许多任务上的能力,发现它的zero-shot性能令人印象深刻——通常与之前的完全监督结果竞争,甚至更好。

qq_45752541的博客 3万+

AutoGLM-Phone 实现“豆包 AI 手机”的自动化操作手机的实战方案教程 让普通手机秒变ai手机

是一个基于视觉语言模型(VLM)的 AI 手机智能助理框架。❌ 不依赖固定坐标❌ 不需要提前录制脚本✅ 能“看懂”手机屏幕✅ 能理解自然语言指令✅ 能自动规划操作路径并执行让 AI 像人一样看屏幕、想步骤、点手机。从工程角度看,AutoGLM-Phone 已经具备“AI 手机助理”的完整雏形能看能理解能规划能执行能跨 App所谓的「豆包 AI 手机」,本质上就是这类能力的产品化封装。而现在,这套能力已经可以被普通开发者亲手跑起来、改起来、甚至接入自己的业务场景。

代码简单说 Vue、JAVA、PHP、Node.js 熟练运用,接口、架构、性能全搞定。 589

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

BiseNetV1 语义分割论文解读

摘要 语义分割需要丰富的空间信息和相当大的感受野。然而,现代方法通常会损害空间分辨率,以实现实时推理速度,从而导致较差的性能。在本文中,我们用一种新的双边分割网络(BiSeNet)来解决这个困境。我们首先设计了一个小步幅的空间路径Spatial Path来保存空间信息和生成高分辨率的特征。同时,采用具有快速降采样策略的上下文路径Context Path来获得足够的接受域。在这两条路径的基础上,我们引入了一个新的特征融合模块Feature Fusion Module来有效地结合特征。该架构在城市景观、CamV

quency的博客 1419

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

SAM多目标跟踪与分割SAM-track论文解读Segment and Track Anything

作者提出了一种支持多模态交互的统一视频分割模型SAM-Track,SAM-Track具有出色的跟踪和分割能力以及两种用户友好的交互模式,以适应不同应用的不同需求。对于跟踪和分割能力,SAM-Track将交互式关键帧分割模型(SAM)与作者提出的基于AOT的跟踪模型(DeAOT)结合在一起,利用高效的DeAOT跟踪模式,SAM-Track可以快速跟踪多个目标速度。还集成了,这使得该框架能够支持基于文本的交互。对于交互模式。

sunshineine的博客 4161

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

SAM2:在图像和视频中分割任何内容

这篇论文探讨了视频对象分割(VOS)的任务。VOS是一种计算机视觉任务,旨在从视频中提取和跟踪特定的目标对象。传统方法通常需要大量的标注数据和计算资源来训练模型,但本文提出了一种高效的新方法,显著提升了分割的速度和精度。提出的模型是一个简单的转换器架构,具有用于实时视频处理的流式内存。视频分割中,有更高的准确性,交互更少。在图像分割方面,模型比 Segment Anything Model (SAM) 更准确,速度更快 6 倍。

qq_36553572的博客 2293

【论文解读】SiamMAE:用于从视频中学习视觉对应关系的 MAE 简单扩展

我们的目标是开发一种学习对应关系的自我监督方法。为此,我们研究了 MAE对视频数据的简单扩展(图 1)。在本节中,我们描述了连体蒙版自动编码器的关键组件。图 1:Siamese Masked 自动编码器。在预训练期间,我们随机采样一对视频帧并随机屏蔽未来帧的大部分 (95%) 块,同时保持过去帧不变。这两帧由 ViT [31] 参数化的连体编码器独立处理。解码器由一系列交叉注意层组成,并预测未来帧中丢失的补丁。

学姐带你玩AI的博客 2833

万字硬核解读SAM 3:不止分割一切,它开始理解世界了

Meta最新的SAM 3,让分割模型学会了理解你说的话,而不仅仅是你指的东西。计算机视觉里的Segment Anything Model (SAM,分割一切模型) 系列,一直在干一件事,就是把图像视频里你想要的东西给“抠”出来。2023年的老大SAM 1,像个刚学会指认东西的婴儿。你给它一张图,用鼠标点一下、画个框,它就把那个东西的轮廓给你描出来。它开创了一个时代,让模型学会了零样本泛化,不用提前训练就能分割没见过的东西。它的三段式架构,提示编码器、图像编码器、掩码解码器,成了后来者的基石。

SuaniCommunity的博客 4548
上一篇: 统计学从挂科到满分【笔记1】
下一篇: 视频对象分割论文解读系列【2】
JintuZheng
博客等级 码龄11年 1483粉丝 109原创
评论 2
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值