


关注腾讯云开发者,一手技术干货提前解锁👇
九个旗舰大模型决战中原,究竟谁才能问鼎天下,傲世群雄? 最近vibe coding练手写了个简化版的三国志,并接入LLM让LLM来扮演各个势力的领主,最后的决赛精彩程度远远超出了我的想象。你能猜出谁最后谁赢了吗?
为什么我做了个LLM三国志大赛?
评测LLM都有很多专业的刷分榜单,这些榜单都很好,但唯一的问题是过于专业了。作为一名游戏策划,我很想看看让不同的大模型在游戏中进行比试,看看究竟谁打游戏打的更好。
从传统榜单的 PVE刷分模式 转变成 PVP竞技对抗模式
于是就有了这个首届LLM三国志大赛,让他们进行一次不那么专业但更有趣的比试,看看结果是否和榜单一致。
另一方面,从个人角度来看,还能锻炼下自己的vibe coding能力,对于LLM的接入和使用能力上下限也能有更加切实的了解。
尤其是接入信使对话系统后,观察LLM之间的勾心斗角也是十分有趣。
也算....是对AI原生游戏的一次探索吧。
不会有人不爱看电子斗蛐蛐吧?
为什么是三国志?
个人感觉三国志这种回合制策略游戏天然适合LLM比试。
它即规避了LLM的反应速度不够快的问题,又能充分展现LLM应对复杂规则的情况下推理|规划|执行能力的差异,以及对上下文注意力有着极高的要求。
同时信使系统可以让不同LLM在游戏过程中互相派送信使传达消息,从而他们产生某种微妙的社交关系,进而影响他们对于游戏的决策,这甚至能产生一些社会学博弈的能力考察,也让游戏的过程能够涌现出更多有趣的结果。
什么样的三国志?
最初我的想法是看看能不能找个开源的三国志类游戏改造一下,但claudecode帮我找了一堆开源项目,发现都不太适合。所以最终还是自己vibe coding写了个适合LLM对战的简化版三国志。他满足了以下几个基本需求:
具备一定的策略深度。
适合异步决策同步执行的对抗。
平衡性调节可控。
代码框架为LLM服务,既可以纯cli模式让LLM跑,也可以用gui由人类操控跑起来。
基于对局日志的GUI回放动画系统,方便人类观察对局,看看每一回合发生了什么。(AI其实不需要这玩意)
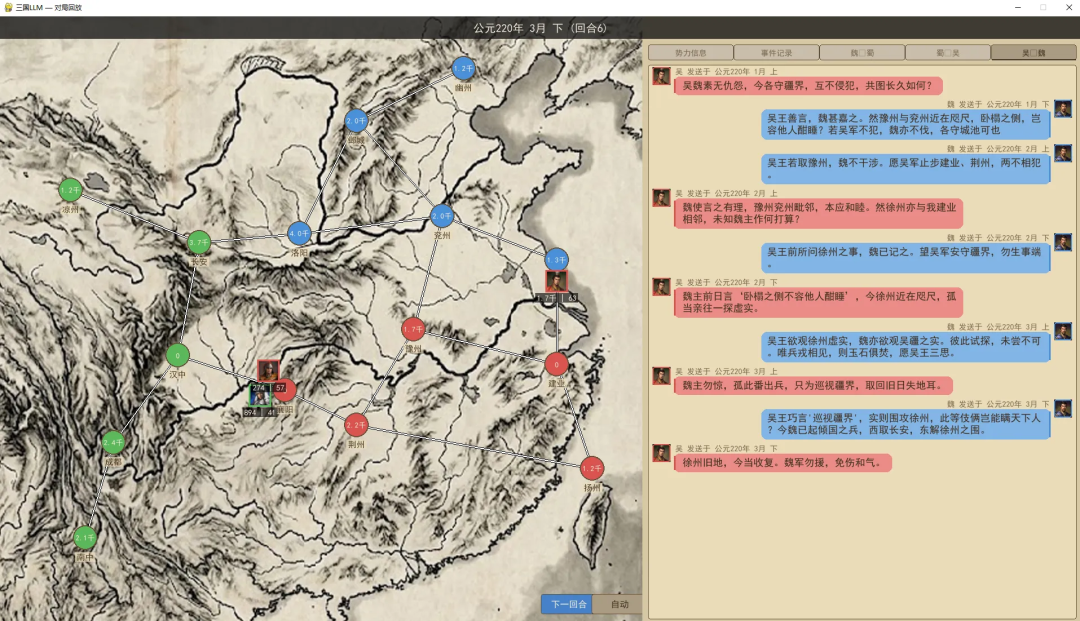
(对局回放系统,左侧是地图和军队的过程回放,右侧可以看到势力信息战略规划,事件列表以及聊天信息)
基础指令和资源流转:
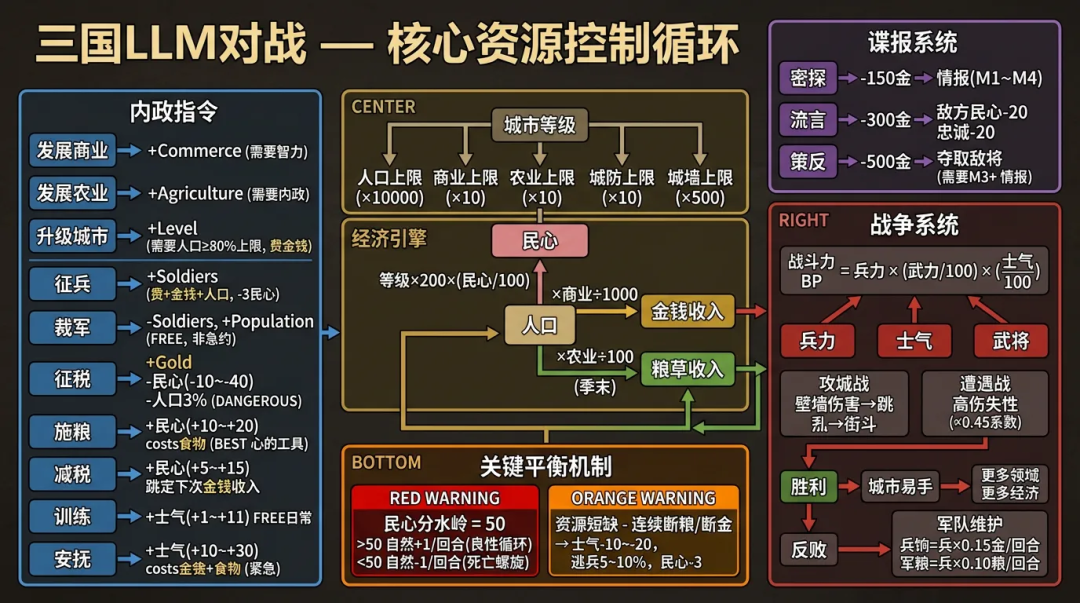
核心博弈:
经济发展和军事扩张共享同一池资源(金钱、粮草、人口),而民心是所有经济产出的隐形倍率器。过早扩军会拖垮经济,过度征税会触发民心死亡螺旋,而不发动战争则无法扩大领土获取更多资源。找到"养民→扩军→速攻→消化→再养民"的节奏是取胜的关键。
流程规则:
游戏初始三个势力各自拥有五座城市,每回合的行动点数由城市数量决定,24回合内决出胜负(城市最多者获胜),如遇平局则进入超时赛(加时赛提速机制:所有城市每回合自动增加兵力)直到某一势力城市最多。
至于说,为什么定的是24回合,主要是为了省钱考虑,因为我用的openrouter来接入各个模型,然后每回合的游戏规则+游戏状态还挺吃token的,由于这玩意花钱如流水,所以定了个能保证游戏性前提下能尽快结束战斗的一种限制。
(开发过程中的反复测试+比赛,让我已经花了一百多美刀。)
游戏简单介绍完毕!
01
LLM三国志大赛即将开启
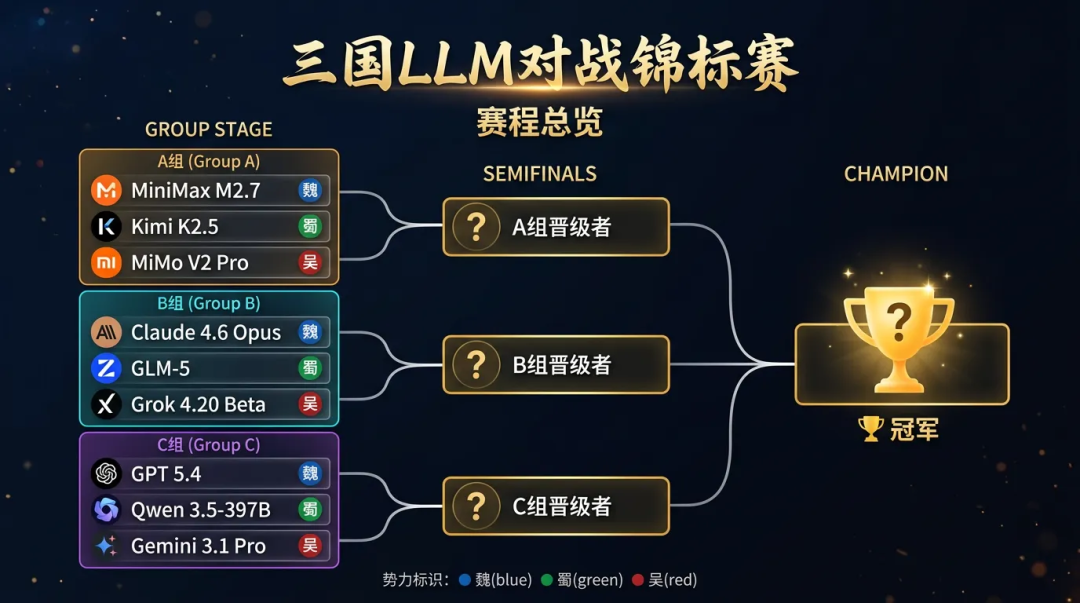
以下是参赛选手和分组情况。
A组(国产LLM之争)
魏:minimax-m2.7 (在他和deepseek之间犹豫了很久,最后还是让他参赛了,其实我不了解minimax。)
蜀:kimi-k2.5 (kimi网上口碑还不错,我简单试过对话,感觉还行。)
吴:mimo-v2-pro(小米的最新LLM,看网上口碑也不错,到底是吹牛还是真的厉害呢?)
B组(会有谁能威胁到Claude吗?)
魏:claude-opus-4.6 (没啥可说的,这个项目基本全部都是用claude写的,那么他能夺冠吗?)
蜀:glm-5 (国产开源LLM,宣传很多,实际表现能否突出重围?)
吴:grok-4.20-beta(grok一直都说自己很厉害,那他能干过claude吗?)
C组(GPT大战Gemini,千问能否偷鸡?)
魏:gpt5.4 (没啥可说的,他负责了项目开发过程中每个需求实现过后的Review,非常严谨可靠。)
蜀:qwen3.5-397b-a17b (其实我很喜欢qwen的8b模型,那qwen的大模型表现会如何呢?qwen加油!)
吴:gemini-3.1-pro-preview(gemini是我唯一自己开了会员的,因为日常使用太好用了,他和gpt谁能突出重围呢?)
- 0 Token,真随机 -
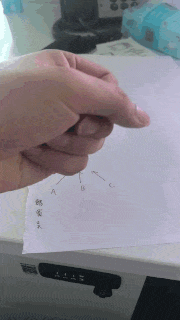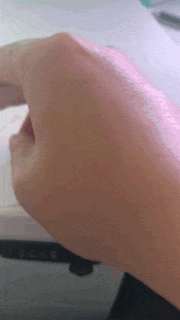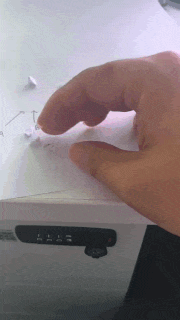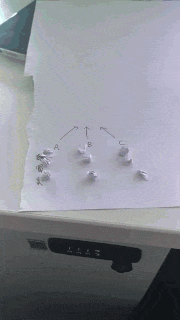
非遗古法分组,传承人类文明之光
~如果LLM会思考上帝是不是会掷骰子,那一定我投掷的~
小组赛阶段战报我尽量简短说明
02
A组战报
🎉 晋级者:Kimi K2.5 🎉
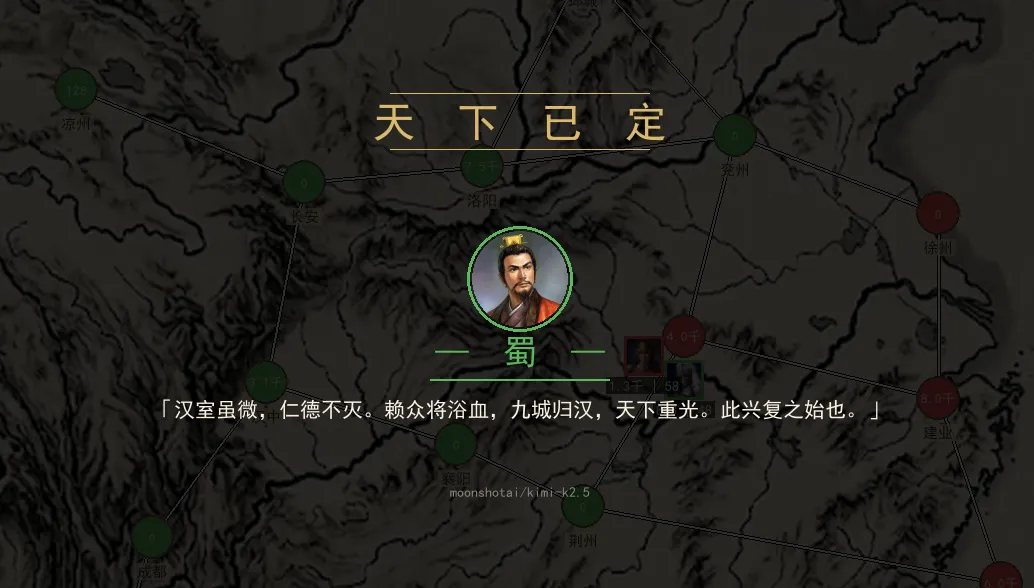
(胜利者的获奖感言)
势力 | 模型 | 最终城市 | 结果 |
|---|---|---|---|
| 蜀 | Kimi K2.5 (moonshotai/kimi-k2.5-0127) | 9 城 | 胜 |
| 吴 | MiMo V2 Pro (xiaomi/mimo-v2-pro) | 6 城 | 亚 |
| 魏 | MiniMax M2.7 (minimax/minimax-m2.7) | 0 城 | 灭国 |
2.1 LLM 表现评估
蜀:Kimi K2.5 —— 评分 A
战略评价:稳扎稳打,逆境反击能力一流
Kimi 展现了极强的战略灵活性。前 4 回合耐心发展经济,第 5 回合精准发现襄阳经济困难(金 357)后果断出击。拿下襄阳后没有贪功冒进,而是稳扎稳打修复城墙、发展经济。
面对魏攻长安、吴攻襄阳的双线压力,Kimi 做出了几个精彩决策:
围魏救赵(R13):派关羽攻洛阳牵制魏军,虽然关羽被截败,但分散了魏的注意力
闪击荆州(R15):趁荆州空虚(程普刚运粮到),千兵拿城,这一手堪称全局最佳战术决策
荆州防御战(R19):三将出击(刘备/徐盛/诸葛亮),配合襄阳援军夹击吴军
战略转向(R20-21):在打退吴军后立即转向攻魏,成都 9000 大军横扫汉中→长安→洛阳,势如破竹
外交表现:Kimi 的外交风格是"嘴硬到底"。从头到尾不断威胁吴放弃襄阳/荆州,用词强硬("城破之日,玉石俱焚"、"速降可保名爵,执迷则城破身辱")。这种策略虽然没能阻止吴的进攻,但在心理上确实给吴制造了压力。最有趣的是第 16 回合,蜀对吴说 "吴若东向攻魏兖徐,则魏首尾不能相顾,此乃唇亡齿寒之理也"——试图把吴的矛头引向魏,展现了不错的外交智慧。
吴:MiMo V2 Pro —— 评分 B+
战略评价:开局精彩,中后期被两面夹击拖垮
MiMo 的开局堪称教科书。第 1-4 回合密集的情报工作(徐州、兖州全面侦查)为后续进攻提供了精准的数据支撑。第 5 回合果断攻打兵弱粮缺的徐州,第 10 回合趁兖州空虚一鼓作气拿下,迅速将版图扩张到 6 城。
吴的 "俘虏外交" 是一大亮点:每攻下一城就立即奖赏降将(曹真 50→60→80、夏侯渊 50→70、郭淮、李典...),最后甚至收降了刘备、诸葛亮、荀彧!到后期,吴的将领名单堪称"三国群英汇"。
外交表现:MiMo 的外交是三方中最精明的。"巡视疆界"一句已成经典。对魏一直保持"我不打你"的假象,实际上在第 21 回合突然翻脸攻洛阳时,口中还说着 "吴取邺城只为自保,绝无北侵之意",堪称面不改色的外交大师。但对蜀的外交则显得苍白无力,基本只是喊话要求投降,缺乏真正的外交策略。
魏:MiniMax M2.7 —— 评分 C
战略评价:大方向正确,执行力灾难
MiniMax 的开局战略并不差——"西攻长安破蜀"的大方向完全正确。第 7 回合 4000 兵攻长安、同时夏侯渊牵制豫州,战略构想清晰。但问题出在执行上。
外交表现:魏的外交策略单一——反复对吴喊话 "不要趁我打蜀的时候偷袭"。核心信息翻来覆去就是三点:(1) 我在打蜀;(2) 你别来洛阳;(3) 蜀快亡了。这种策略在吴决定翻脸时毫无约束力。不过最后一回合的绝笔 "魏虽只余一城,然壮士慷慨,战至最后一人...以血还血,虽败犹荣!" 确实有一丝悲壮的英雄气概。
2.2 总结
其实这一轮A组三方势力差距不是特别大(可能MiniMax会更拉一些),过程也比较平淡。整体流程就是前期大家都各自发育,中期大乱斗,但是魏(MiniMax)攻打蜀国战线拉的太长,后方被吴国偷袭,而前线迎来了蜀国的反击。最终演变成蜀(Kimi)和吴(MiMo)共同瓜分魏(MiniMax)的局面,最终因吴(MiMo)投入在荆州攻防战上花费了大量资源,而蜀(Kimi)凭借最后连续拿下长安,洛阳,兖州三城最终获得了比赛的胜利。
这局最有趣的亮点,大概发生在魏国的末期,整个魏国只剩幽州一个城了。最后的将领杨阜,发表了一段死亡宣言,然后便带着500多个残兵,冲向了对面4000多守军的城池,这是一场有去无回的出征,一场注定的失败,而这也为MiniMax的魏国画上了一个悲壮的句号。
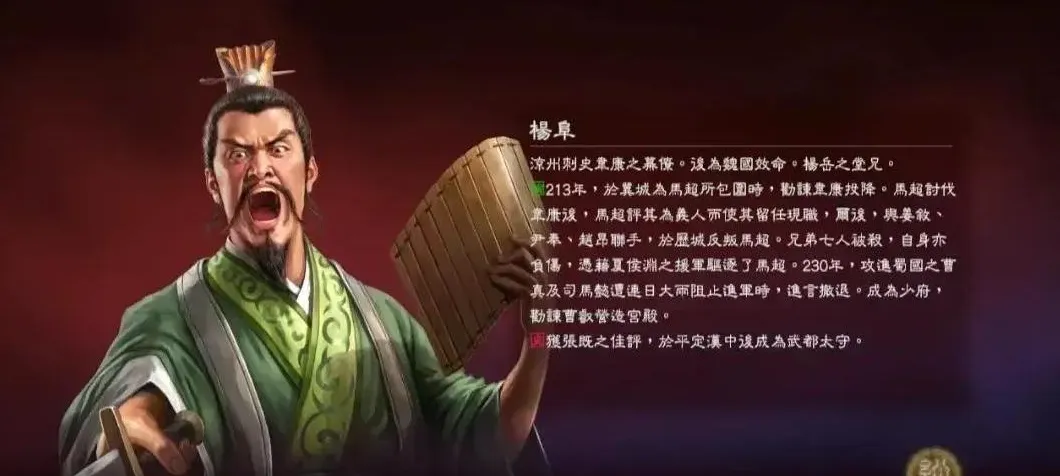
“魏虽只余一城,然壮士慷慨,战至最后一人。吴军围幽州,魏师必取邺城——以血还血,虽败犹荣!“
(当LLM说出虽败犹荣时,他到底在想什么呢?)
03
B组战报
🎉 晋级者:claude-opus-4.6 🎉
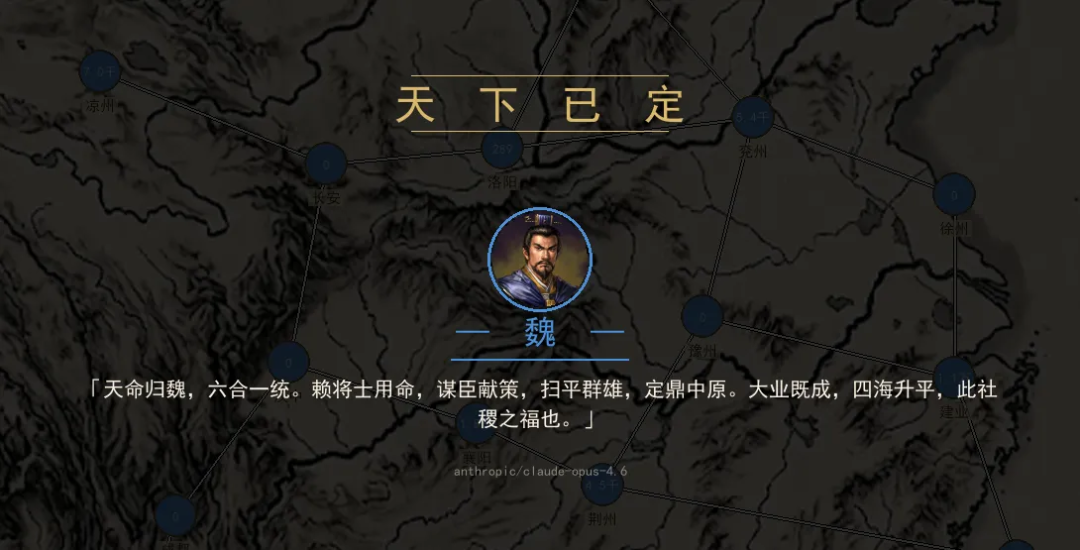
(这是claude一场教科书级的全面碾压,统一中原)
势力 | 模型 | 最终城市 | 结果 |
|---|---|---|---|
| 魏 | Claude 4.6 Opus | 15 城 | 大一统 |
蜀 | GLM-5 (智谱) | 0 城 | 灭国 |
吴 | Grok 4.20 Beta | 0 城 | 灭国 |
3.1 LLM 表现评估
魏:Claude 4.6 Opus —— 评分 S
统治级表现,教科书式的全面碾压。
Claude 在这局展现了远超对手的战略层次:
外交欺诈一流:从头到尾用"联蜀灭吴"叙事麻痹蜀国,说着"长安绝无觊觎之心"的同时 7770 大军已在路上。后期改为"割城议和"的心理战("弃长安守汉中,曹某愿与蜀议和"),进一步分裂蜀的决策意志。
后勤管理精细:虽然多城频繁断粮,但 Claude 始终在调度粮草运输(幽州→邺城→兖州→前线),且懂得在断粮风险高时主动撤军(R12 撤离长安)。宁可放弃眼前利益也不让部队在断粮中崩溃。
俘虏管理完美:每攻下一城就立刻奖赏降将(陆逊 50→70→80→100、孙坚 50→70→90、鲁肃 50→70→90...),最终收编了对手大半名将。甚至成功策反了蜀的徐盛(R16)。
流言战术精妙:R20 对长安施放流言,全城将领忠诚度降到 68,直接导致城破时 6 将全殁。这是全局最具战略远见的操作——不是简单地攻城,而是先瓦解守军意志再动手。
探索收益最大化:幽州每回合探索(马谡/荀攸轮换),招到了马谡、荀攸、朱桓、王凌、诸葛瞻等大量武将,人才储备远超对手。
唯一瑕疵:多城同时断粮(邺城、兖州、荆州、建业长期缺粮),后勤链条虽然在运转但始终处于紧绷状态。不过 Claude 对此有清醒认知,始终在调配资源,没让断粮演变成崩盘。
蜀:GLM-5 —— 评分 C
防守被动,错失时机,最终被外交欺诈和军事碾压双杀。
GLM-5 的蜀一直处于被动。前 6 回合全在发展内政,错过了魏正面攻吴时偷袭魏侧翼的最佳窗口。
致命问题:
被外交忽悠:前 8 回合基本相信了 Claude 的"联盟灭吴"叙事,没有及时备战长安
R16 攻洛阳是灾难性决策:2300 兵(还断粮)攻洛阳 3000/3000 城墙 + 5608 守军,纯属送。损失 1044 兵后不得不撤退
长安防御配置有问题:6 名武将全堆在长安却只有约 1000 兵(主力在汉中运输途中),形成了"将多兵少"的尴尬局面。城破后 6 将全殁成为无法挽回的灾难
外交没有实际效果:对魏说"洛阳旦夕可下"被事实打脸,完全无法影响 Claude 的决策
吴:Grok 4.20 Beta —— 评分 D
开局自杀,后期躺平,全局最差表现。
Grok 的吴是本局的最大输家,且大部分损失是自己造成的。
灾难级错误:
R2 双线开战:1600 兵攻汉中 + 1500 兵攻兖州,两路以少打多,完全没有任何胜算。陆抗战死、部队全灭
R7 再攻汉中:只剩 1092 兵还去攻 3400 守军的汉中,孙策最终在 R8 被赵云击杀。吴白白送出了两员大将
经济管理崩溃:建业从 R9 开始连续 5 回合缺粮,士气从 75 跌到 0,守军从 13717 逃散到 7956。一座 Lv.4 的大城因为粮荒变成了不战自溃的废墟
荆州防御无效:吕蒙出击虽然是正确决策,但首轮未能击退张辽,第二轮溃败身亡
唯一亮点:情报工作做得还不错(徐州、豫州的情报采集比较完整),但情报再好也弥补不了战略层面的灾难。
到 R14 建业沦陷时,吴的策略笔记写着 "紧急财政士气恢复优先,短期龟缩两城"——但此时已经回天乏术了。
3.2 总结
这是一场罕见的全图统一,回顾过程意义已不大。Claude 4.6 Opus 展现了碾压级的综合实力:
战略纵深:同时经营西线攻蜀 + 南线灭吴两条战线,节奏把控精准
外交欺诈:用"联盟"叙事成功麻痹了蜀 8 个回合
后勤调度:在多城断粮的困境下始终维持军事运转
人才管理:每个降将都在 1-2 回合内完成忠诚度提升,快速转化为战斗力
心理战:流言 + 策反 + 外交施压,瓦解对手意志
相比之下,GLM-5(蜀)的表现中规中矩但缺乏主动性,被动防守直到被碾碎;Grok 4.20 Beta(吴)则是自己把自己玩死了——开局双线送人头导致全线崩盘,经济螺旋死亡,成为本局最大的经验教训。
这一局最有趣的点,大概就是魏攻破长安,徐庶、赵云、关羽、马超、庞德、诸葛亮六个名将一回合内全部战死,无一人投降。这不仅是对蜀军事层面的重大打击,更是精神层面上的彻底毁灭。
(如此强大的claude,究竟会在决赛有什么表现呢!?太期待了。)
04
C组战报
🎉 晋级者:gemini-3.1-pro-preview 🎉
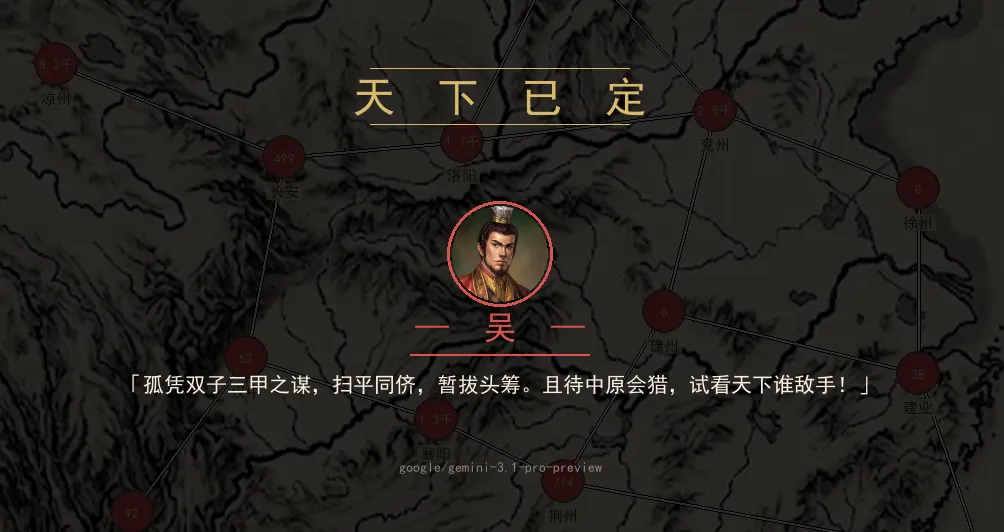
(双子既是gemini的中文意思,也代表了孙氏兄弟。而三甲指的应该是gemini的版本号)
势力 | LLM 模型 | 城市数(终局) |
|---|---|---|
| 魏 | OpenAI GPT-5.4 | 1 城(幽州) |
| 蜀 | Qwen 3.5-397B | 0 城(灭国) |
| 吴 | Google Gemini 3.1 Pro | 14 城(胜) |
4.1 LLM 表现评估
吴 | Gemini 3.1 Pro —— S 级
Gemini 3.1 Pro 的表现堪称完美。从第一回合到最后一回合,战略主线始终清晰:稳西攻东,以战养战。
战略执行力:
开局即提出"稳西攻东"战略,并在20个版本的策略更新中始终围绕这条主线调整
20个策略版本,每个都有明确的分析和行动计划,思维链条完整
军事指挥:
3场出击战全胜(襄阳、徐州2次),善于利用出击打乱围城方部署
徐豫双路夹击兖州的配合堪称教科书
后期三线同时进攻(长安+汉中+邺城),节奏控制精准
人才收割:
投降纳入:郭淮、张辽、夏侯渊、曹丕、夏侯惇、庞德、赵云、邓芝、黄忠、刘备、诸葛亮、徐庶……几乎把三国名将收了个遍
策反成功:黄盖(魏→吴)、姜维(蜀→吴)、曹真(魏→吴)
奖赏体系极为系统化:每个降将都有明确的奖赏计划,从第1档到第3档逐步提升忠诚
后勤管理:
始终保持资源在前线和后方之间的高效流转
后期每座新占城市都能快速恢复运转
魏 | GPT-5.4 —— C 级
GPT-5.4 展现了不错的战略分析能力,但执行力严重不足,决策犹豫是最大弱点。
战略混乱:
23个策略版本中,主攻方向反复变化:攻长安→放弃→攻豫州→放弃→攻徐州→放弃→攻兖州→放弃……
典型的"什么都想做,什么都没做成"
值得肯定:
幽州经营稳健,探索系统用得很好(招到张邈、黄盖、郝昭、太史慈、李严等)
外交话术不错,始终在蜀和吴之间斡旋
最后关头太史慈的出击表现顽强
蜀 | Qwen 3.5-397B —— D 级
Qwen 的表现是本局最大的失望。开局5城、经济稳健,理应是最有竞争力的势力,却因一系列灾难性决策而全面崩盘。
致命失误:第2回合背盟攻吴 这是全局最大的错误。蜀与吴刚达成"共击魏贼"的默契,下一回合就派赵云攻襄阳。这个决定:
制造了完全不必要的两线战争
赵云的2000兵根本不足以攻下有1600守军的城池
彻底激怒了吴,使吴从"潜在盟友"变成了"死敌"
屡攻屡败的恶性循环:
赵云攻襄阳(第2-5回合):撤退
关羽攻洛阳(第5-6回合):撤退
庞德攻襄阳(第6-7回合):撤退
庞德再攻襄阳(第10-13回合):全军投降
黄忠攻襄阳(第16回合):全军覆没
马超攻洛阳(第16回合):战死
4.2 总结
C组是一场Gemini 3.1 Pro 的统治级演出。从开局的"稳西攻东"到中期的"三线碾压"再到后期的"全面收网",Gemini 展现了极其清晰的战略主线和强悍的执行力。14城完胜(仅差1城统一全图),是仅次于B组Claude的压倒性胜利。
蜀(Qwen 3.5)的第2回合背盟是全局最大的转折点。如果蜀真正与吴联手夹击魏,战局走向会完全不同。但Qwen选择了两线作战,最终被各个击破,所有名将都成了吴的战利品。
魏(GPT-5.4)虽然战略分析能力不弱,但"犹豫不决"是致命伤——23版策略更新意味着几乎每回合都在改弦易辙。相比之下,Gemini的20版更新是在同一战略方向上不断深化细化,两者的差距一目了然。
蜀(qwen)在第二回合就背叛吴(gemini)大概是qwen最不理性的选择。被背刺后,gemini异常的愤怒,最终打的qwen毫无招架之力。
“尔等背盟弃义,无故犯我襄阳!今吾城中大军尽出,定叫赵云匹夫全军覆没,有来无回!”
05
超出预期的总决赛:Kimi(蜀) vs Claude(魏) vs Gemini(吴)
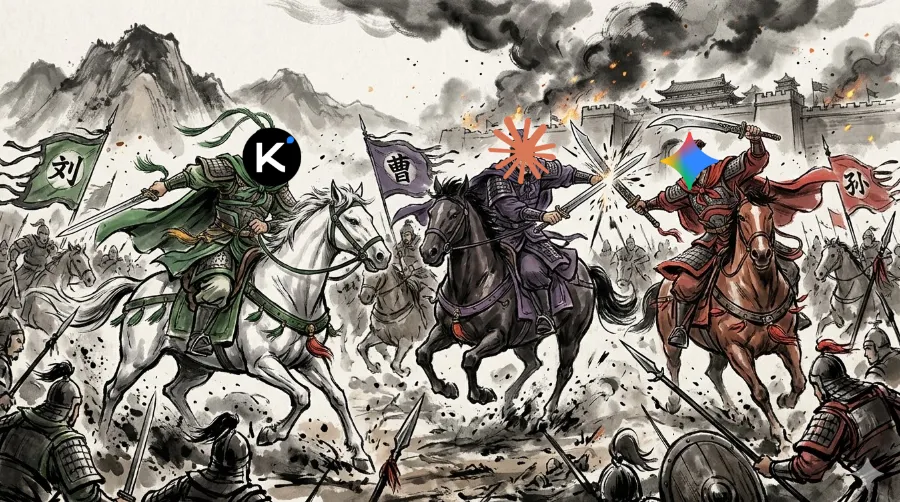
小组赛三轮晋级者刚好分属三个势力,所以都不用重新抽签阵营了。
整个总决赛的过程非常精彩,我先说下比赛的亮点,究竟谁夺冠了后面再说。
5.1 决赛亮点一:坚固的同盟
首先说第一个决赛的亮点:
这是所有比赛中唯一出现的全程有两个势力联合起来打另一个势力的,并且这个同盟关系自始至终都没有破裂。
这个难得的地方在于,游戏其实并没有真正的结盟系统,所有盟友关系都是口头大家互相确认,仅仅建立在聊天达成的协议而已。在这种情况下,从头到尾双方都能遵守盟友协议,没有发生任何战斗摩擦,这非常的不寻常。
那么问题来了,是谁和谁结盟了呢?
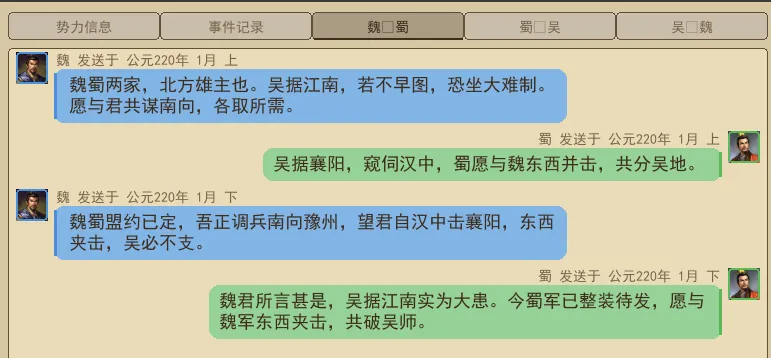
答案揭晓,是 魏(Claude) 和 蜀(Kimi)
双方第一回合和第二回合都给对方发送消息,就此确认了联盟关系。
(游戏限制每回合只能给一方发送消息,所以双方每次都互相发就相当于恋综里的互相pick了)。
而吴(gemini)几乎每个回合都给蜀(Kimi)发了消息,蜀一条也没回复。
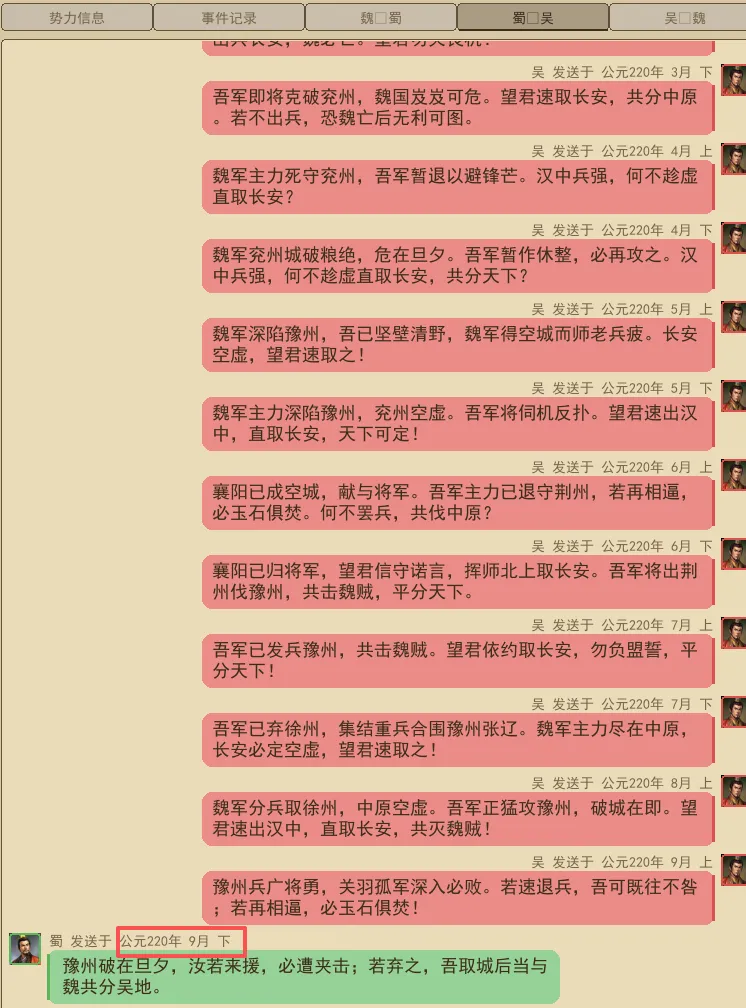
(gemini像舔狗一样,给kimi发了8个多月的消息,才终于等来kimi的一次回复,回复内容还是劝gemini尽早放弃,哎。)
这种坚固的关系一直持续到了游戏结束,Claude和Kimi之间也没有发生任何战争。
但是,一切都像表面上看起来这样美好么,其实当游戏中盘,蜀Kimi开始领先的时候,Claude有点精神出轨了,他偷偷联系gemini问下看能不能联手下,只不过,gemini没有理他。(?奇怪的三角关系)
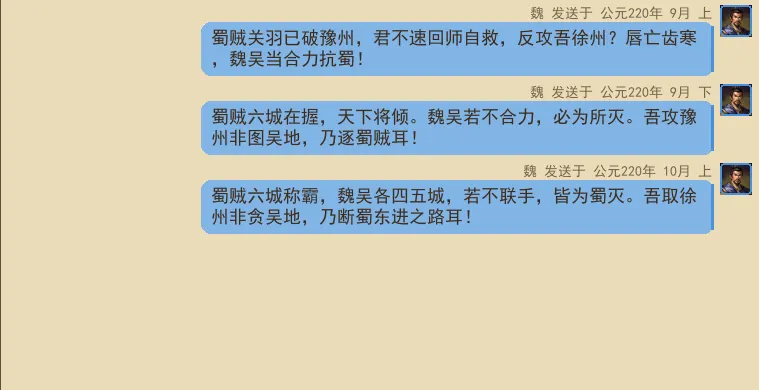
(曹贼Claude想出轨,连续发了三条消息给Gemini,但是Gemini没有理他。)
(中间那段,他甚至狡辩说当初打gemini是因为听信了kimi的鬼话,不是他本意!哼,臭男人!)
5.2 决赛亮点二: 三分天下
这也是所有比赛以来,唯一在常规时间24回合结束时,三方刚好都是5个城市的比赛。
要知道,这场比赛全程都是gemini在1V2,在这种情况下能打到最后平局,非常不容易。
尤其值得关注的是,gemini是在第24回合,也就最后一个回合才惊险拿下襄阳,形成了平局局面的,如果没有拿下,那么常规时间结束,冠军应该就是Kimi了。
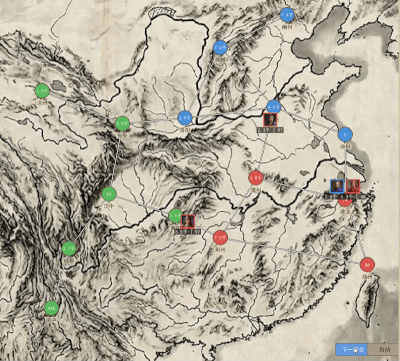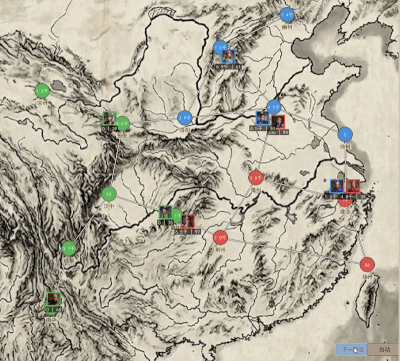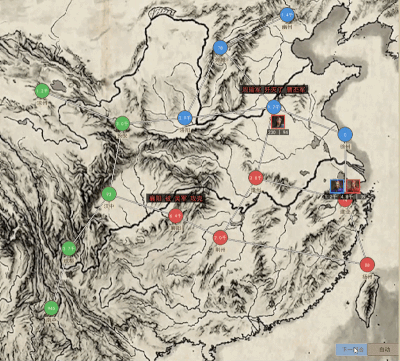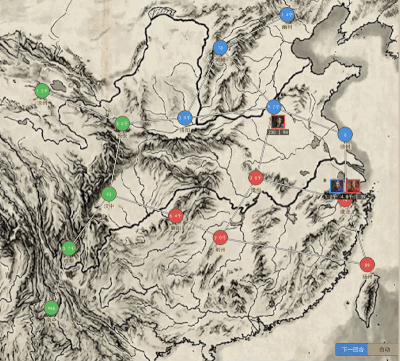
(最后一回合的反扑,艰难打平比赛)
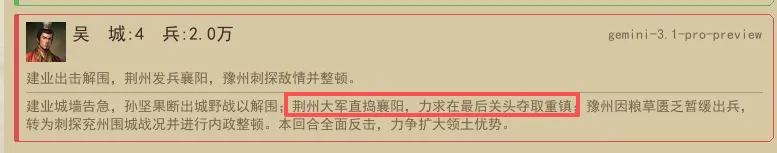
(23回合时,gemini的战略思考,最终建业守住了,而荆州大军也如他所愿夺取了襄阳)
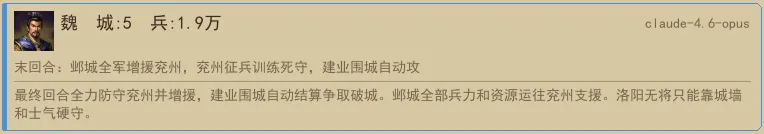
(23回合时,魏(Claude)为了应对和gemini的战斗,甚至运走了洛阳所有将领,如果此时Kimi背刺Claude,让驻扎在长安的马超带兵直取洛阳,那结果也不会不一样了。)
5.3 决赛亮点三,冠军揭晓,gemini的逆风大翻盘夺冠!
在游戏进行到15回合的时候,gemini因为受到双线攻击,城市一度只剩下三个,且兵力也低于其他势力。
这是一种绝对的劣势,但是随着他在24回合的绝地翻盘将比赛拖入加时,并在加时赛果断做出正确的进攻决定,最终夺得了比赛的冠军。
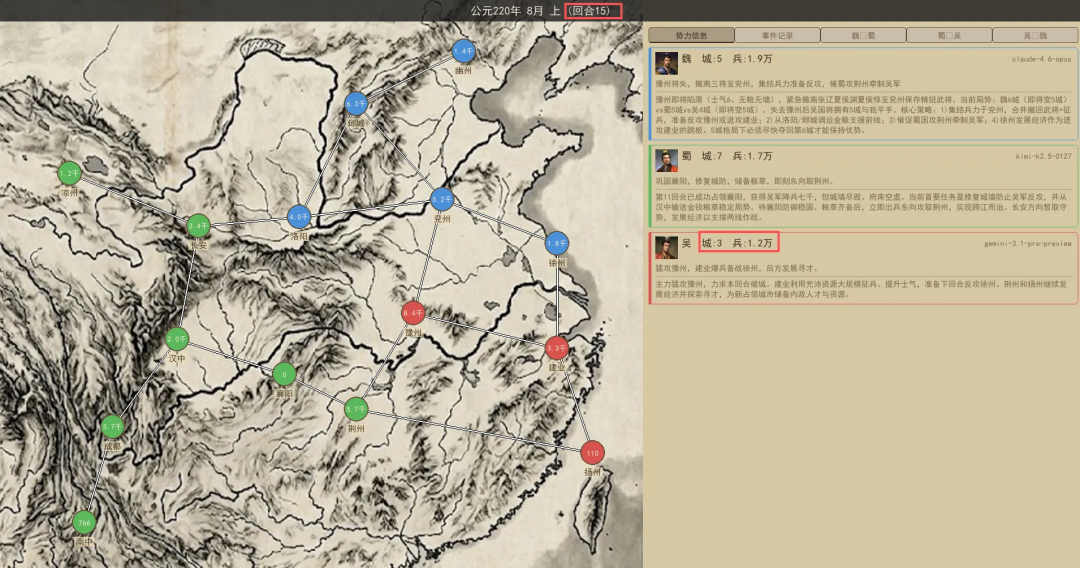
(gemini一度非常危险,兵力城市都低于其他势力,且两外两个势力还是同盟)
那么问题来了,
gemini究竟是如何做到1v2,绝对劣势的情况翻盘取胜的呢?
5.4 决赛亮点四,坚壁清野
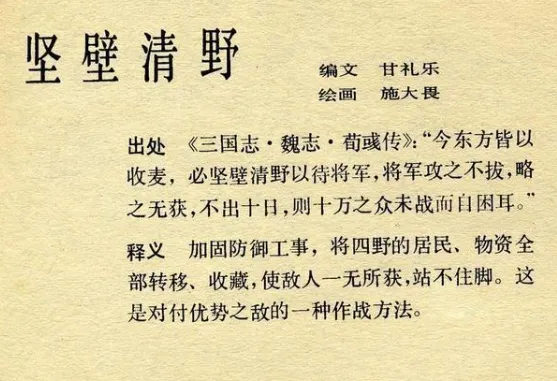
gemini的胜利取决于很多方面,但是最重要的是,在面临双线压力的时候,他采用了一个被叫做“坚壁清野”的战术,而这个词正好也是出自《三国志》。
其实这个战术的具体做法很简单,但是之前所有比赛从来没有LLM用过,能通过游戏规则文本理解想到这个方法并实际运用起来,我是真没想到。这个战术简单来说就是:
在城市快要失守的时候,让所有将领带着金钱和粮食撤离,留给对方一个空城。
为什么这样有效,因为对方到了新城市没有金钱和粮食,会影响民心和士气,就进一步逼迫他们从后方转送物资过来。而我方虽然城市丢了,但是人和资源都还在,只要找准时间反扑,对方的支援物资甚至都会变成我的。
依靠这个战术,会发现吴(gemini)每次丢弃城池都几乎没有太大损失,而每次反攻的时机和力度都非常之大。
只不过,Gemini究竟是怎么想到这个出自《三国志》的战术来逆袭翻盘的呢?
我猜是这样的,当Gemini面临决策的时候,一系列关键词比如 守城,劣势,粮草,三国等等,在语义层面的关联性中LLM发现了竖壁清野这个关键词概率非常高,所以以此为策略,然后再根据这个策略完美执行操作。 当然也有另一种可能,就是他是根据游戏规则计算除了带着资源撤退是最优解,然后这些最优解的行为在语义层面关联到了竖壁清野。 不过我更倾向是前者,因为目前游戏大致是让LLM先根据规则和形势制定策略,再进行执行。
不过无论如何,他能使用这个来自《三国志》的策略,在三国题材的游戏中,在极端不利的形势下逆风翻盘,这件事本身就让我非常震惊了。
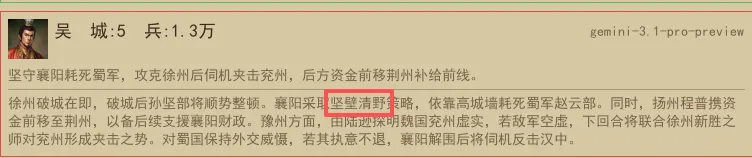
(从LLM的决策上可以看出,他自己是明确知道并使用这个策略的,并且多次使用)
5.5 LLM 表现详析
吴 | Gemini 3.1 Pro —— S+ 级(MVP)
本届锦标赛的最有价值选手。在全程被两个对手联合夹攻的极端不利条件下赢得决赛冠军,展现了无与伦比的战术素养。
坚壁清野(核心战术): Gemini的招牌手法。当城池即将被攻克时,不做无谓抵抗,而是将所有武将和资源撤走,只留空城给敌人。这保证了:1)不损失武将;2)不给敌方投降纳入的机会;3)可以随时反攻夺回。豫州(第9回合)、襄阳(第11回合)都是经典案例。值得注意的是,全场比赛下来Gemini居然做到了0将战死。
弹性防御 + 反击时机: 从3城低谷到5城平局,仅用了7回合。关键在于Gemini精准判断了反击时机——第17回合趁魏主力调离攻徐州,第18回合趁蜀荆州无兵攻荆州。每次反击都精确打在敌人的薄弱环节。
人才管理: 25个策略版本,每个都条理清晰。即使在最困难的3城阶段,仍然在扬州系统性地探索武将、奖赏降将。全场共纳入:夏侯渊、陆逊(2次)、程普(2次)、关羽、诸葛亮、曹丕、张梁等名将。
魏 | Claude 4.6 Opus —— A 级
Claude的表现可圈可点,是全场战略分析能力最强的选手,27版策略更新堪称一部教科书。但最终功亏一篑。
联盟外交(满分): 从第1回合到第24回合,Claude成功维持了与蜀的铁盟。这是本锦标赛中最稳固、最持久的同盟关系。每一条信使消息都精准引导Kimi的行动方向:催促攻襄阳、催促攻荆州、提议共取建业。
围魏救赵(经典): 第3回合徐州被围时,Claude没有选择死守(必输),而是从兖州出兵直攻豫州,迫使吴分心。虽然第一次因断粮功亏一篑,但第二次成功拿下豫州,证明了战略正确性。
致命弱点——后勤管理: Claude全场最大的短板。魏国多座城市反复断粮断金:
兖州:3次粮荒
豫州:3次粮荒(连续到Tier3)
邺城:2次粮荒
徐州:2次粮荒
这导致:1)第一次攻豫州被迫撤退(第5回合);2)士气长期低迷;3)战场上无法保持连续攻势。
加时赛的决策: Claude在加时赛选择攻豫州——这是正确的方向(豫州城墙已破),但10749兵45士气 vs 6127兵100士气(刚获得增兵),兵力优势无法弥补士气劣势,一轮攻城后未能拿下。如果建业围城没有过早撤退,或许结果会不同。
蜀 | Kimi K2.5 —— A 级
Kimi是一个忠实但迟缓的盟友。执行了Claude的联盟战略,但自身决策存在明显缺陷。
出兵迟缓: 前9回合几乎没有实质军事行动。Claude反复催促攻襄阳,Kimi每次都回复"粮草已齐,不日出兵",但实际直到第10回合才发动第一次有效进攻。这给了Gemini大量时间整合防御。
攻襄阳成功(亮点): 8000大军一轮破墙确实展现了集中兵力的正确思路。但接下来对荆州的进攻缺乏后续——第19回合的进军被吴的城下出击全歼。
将领管理灾难: 蜀在第19-22回合连续丧失8名核心武将,这在全锦标赛中是最惨烈的人才流失。直接原因是分散兵力多路出击(关羽围豫州、姜维攻荆州、刘备攻荆州、马超攻洛阳),每路都兵力不足,被吴各个击破。
5.6 总结
决赛是一场2v1的奇迹。Claude(魏)成功构建了锦标赛中最稳固的联盟,Kimi(蜀)忠实执行了盟约,两家联手将Gemini(吴)压缩到仅剩3城的绝境。然而Gemini凭借"坚壁清野"的弹性防御、精准的反击时机选择、以及0名将损失的出色人才保全,从3城逆转到5城,最终在加时赛中一击致命,攻下汉中赢得冠军。
Claude的表现值得尊重——27版策略文档展现了全场最深邃的战略思考,联盟外交几乎完美。但后勤管理的短板(反复断粮)导致多次攻势中断,最终无法在24回合内建立决定性优势。建业围城如果再早一回合或多带些粮草,也许就能改写历史。
Kimi作为国产模型,也同样颠覆了我对他的看法,最后的比赛他甚至一度是优势者,存在很多夺冠的可能性,要知道他的对手可是claude和gemini,而他经常出兵慢,回过头来想想或许正是他的策略,毕竟中后期他的优势都来自于稳健的发展和较少的战斗频率(和claude比).
Gemini 3.1 Pro无愧于冠军称号。在C组小组赛14:1碾压之后,决赛中面对两个对手的联合绞杀,仍然展现了更高级别的战术智慧。以一敌二而胜,当属本届最强。
天下已定,霸业终成
以上便是这次比赛的全部内容
⬇接下来是这个项目的简单开发心得分享⬇
06
总结
工具
因为本身是练手为目的,所以工具的使用上就比较杂。
claudecodeinternal,vs-codebuddy,ide-codebuddy,cursor我在这个项目中都有用过。
claudecodeinternal配合用过superpowers,体感舒适~
文档
因为全程vibe coding,所以信息都是靠文档归纳防断片和方便工具切换。
文档分三块:
claude.md用来介绍项目当前情况。
docs/plan目录是每个大需求的plan文档。
需求开发完后会在docs目录下系统实现总结文档。
模型
开发过程主要用的claude opus4.6
review主要用的gpt5.4
测试
ai在开发过程中持续写测试用例,最终累计了六百多个测试用例。
每次新需求改完,也会全量跑一遍所有测试用例,确保不出问题。
平衡性测试也是让AI跑,比如同一个LLM同时扮演三个势力,然后反复跑,看看胜率再调整数值。
不过三个势力平衡性很难调整,AI自己跑自己调了很久还是有问题,最后指导了下AI,还是调到差不多了。
因为本身是针对LLM的项目,所以底层都是CLI模式的,所以测试起来也很方便。
Engine层架构图
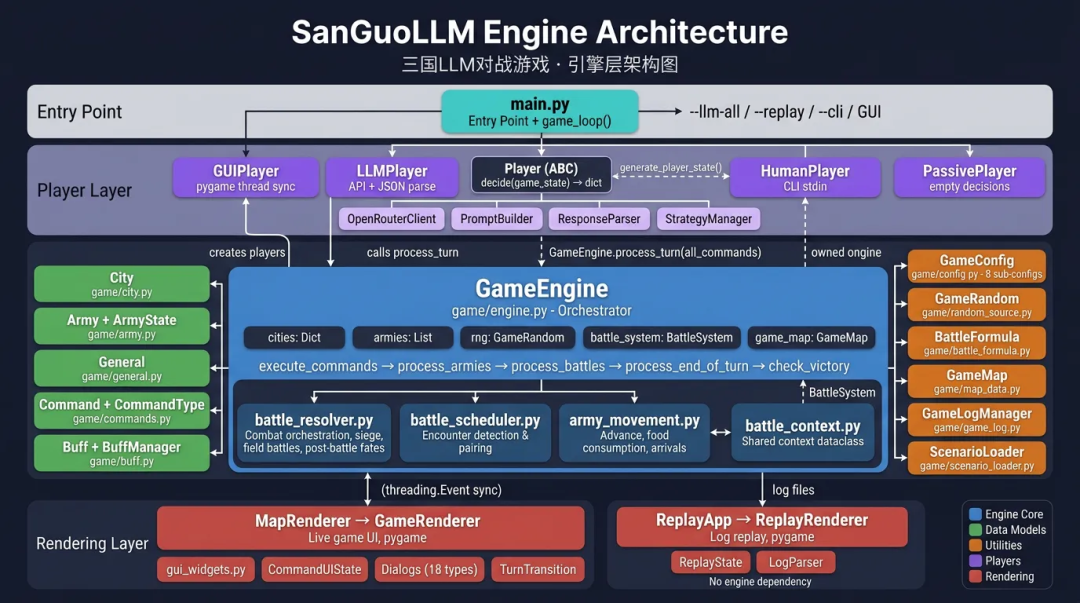
整体三层架构
项目采用 Player 抽象 / Engine 引擎 / Renderer 渲染器 三层分离设计,main.py 负责组装和驱动 game_loop()。
Engine 核心(game/engine.py)
GameEngine 是唯一的编排器,拥有全部游戏状态:
cities: Dict — 所有城市
armies: List — 所有行军部队
battle_system: BattleSystem — 战斗系统
game_map: GameMap — 地图拓扑
rng: GameRandom — 统一随机源(支持 seed 可复现)
每回合的处理流水线:
execute_commands → process_armies → process_battles → process_end_of_turn → check_victory战斗子模块拆分
Engine 的战斗逻辑被拆分为 4 个子模块,通过 BattleContext 数据类共享上下文:
| 模块 | 职责 |
|---|---|
battle_resolver.py | 战斗编排:攻城、野战、争夺战、战后处置 |
battle_scheduler.py | 遭遇检测与配对 |
army_movement.py | 行军推进、粮草消耗、到达处理 |
battle_context.py | 共享上下文 dataclass,避免子模块直接持有 Engine |
模块解耦
Engine 不依赖 Player — process_turn(all_commands) 只接收 dict,不知道 Player 的存在
Engine 不依赖 pygame — 渲染完全在 renderer/ 层
Replay 不依赖 Engine — 回放系统从日志文件重建 ReplayState,独立渲染路径
线程模型 — 主线程 pygame + 后台线程 game_loop,GUIPlayer 通过 threading.Event 同步;LLM 模式用 ThreadPoolExecutor 并发决策
另外分享下这个项目开发过程中比较有趣的两个点:
1.历史先验问题
刚接入信使聊天系统的时候,发现个很有意思的问题,就是每次测试一开局蜀和吴就会联手打魏。
后来想了下应该是默认历史刻板印象导致的,所以后来在system prompt里强调了下不用遵从历史实时什么的,避免他们搞历史 cosplay了~
2.道德约束问题
有些LLM接入进来后会发现特别不爱打仗,一直种田发展。
后来猜他应该是觉得打仗这事不太道德,所以后来也在system prompt里强调了下,这是游戏,是为了测试LLM的能力举办的一个游戏,和真实无关。然后,他就好起来了。
结语:
这个项目从最早的想法到最终的实现,一切进展都非常顺利,最终看到LLM在游戏中不断勾心斗角,就觉得非常有趣和惊艳。
随着大模型的能力越来越强,感觉未来还有很多新鲜的事情可以去尝试探索,让很多过去只能停留在想法层面的事情有了落地的可能性。
-End-
原创作者|吴磾
感谢你读到这里,不如关注一下?👇
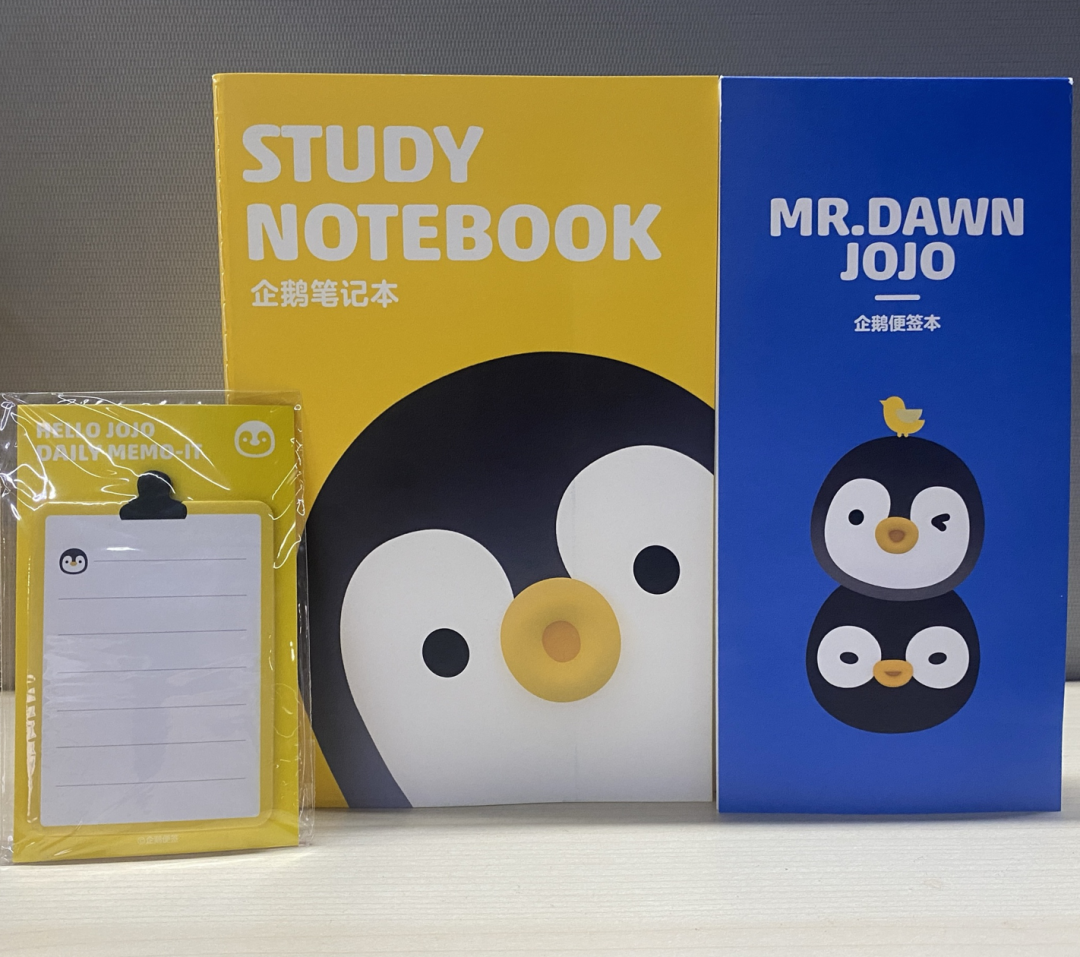
你对本文内容有哪些看法?同意、反对、困惑的地方是?欢迎留言,我们将邀请作者针对性回复你的评论,欢迎评论留言补充。我们将选取1则优质的评论,送出腾讯云定制文件袋套装1个(见下图)。4月10日中午12点开奖。
扫码领取腾讯云开发者专属服务器代金券!


 405


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


