


关注腾讯云开发者,一手技术干货提前解锁👇
你是否想过,Skill 其实也可以像神经元参数一样被训练。你总想着授它以鱼,像个训斥孩子的妈妈,一遍一遍对着它苦口婆心地说教——你给我记住!你不许这样!这样不对!但好的教育难道不应该试着授它渔,给他一本书、一个目标,让他自己实践、碰壁、改错么?于是,我做了一个 skill 自己训练自己——自己迭代,自己评测,自己回归,最后选出一个最棒的 checkpoint 给你。是不是还有点意思?
阅读导航
全文有效内容约 6000 字(不含导航与附录),通读约 15 分钟。前两章为主要思想,第三章为工程实践。
章 | 标题 | 一句话 | 属性 |
|---|---|---|---|
| 一 | Skill 其实并没有看上去那么百依百顺 | 从我对 skill 的几个误解写起,慢慢走到为什么后来会把它看成一个 harness | 法 |
| 二 | 这其实就是个「skill 的训练框架」 | 借用一点 深度学习 的类比,提出一种 skill 的训练循环、评测、门控和 trace方法 | 法 |
| 三 | 我把它做出来了,并且验证了可行性 | 19 轮自进化 + 真实业务 skill 实战,从自证到落地 | 术 |
| 后话 | 它不完美,但我还是试着相信它 | 局限、适用边界、如果你想试应该从哪里开始 | 反思 |
| 附录 | 技术支柱溯源 | 文中涉及的关键数据和相关技术来源 | - |
故事是这样的。
不久前的某个晚上,我做了一件看起来挺无聊,但其实异常上头的事,我让一个 skill 自己迭代去改它自己。
它一共跑了 19 轮,每一轮都揪出了至少一个我之前完全没看见的问题——有的是真 bug,有的是边界补全,有的是整块代码的职责重构。
其实这件事从技术上讲,并不复杂。
由于需要实现各个阶段的目标,我去检索了相关的paper和技术博客,吸收他们的思想。但让我最后决定把它记录下来的,不是这的个「吸收」过程,而是它真的在替我探索我不想费脑力触达的边界,这看起来更像是一个机器智能应该有的样子。于是,我把这些思路沉淀成了一个skill。
先从最开始说起吧。
01
Skill 并没有看上去那么百依百顺
1.1 它看起来像 prompt,其实更像 harness
你大概已经感受到了,skill 正在以一种「到处都是」的势头渗进你生活的各个角落。各个AI巨头或许互相不对付,但在 skill 这件事上出奇地一致。
一个 SKILL.md 加上一堆参考资料和脚本,就可以打包成一个可分发的能力单元(关于 skill 本身就不展开了,大家请直接移步互联网)。
但有一件事我想说清楚。
skill 最容易让人误会的一点,是它看起来像 prompt,实际上更像 harness。
写一个能跑的 skill 不难,你随手糊一个 SKILL.md,模型就能照着做事了。但你要让它稳定干活,那就是另一回事了。触发边界怎么定?安全规则怎么加?references 之间的一致性谁来管?脚本版本兼容谁来保证?这些东西加在一起,早就不是「写一段 prompt」了,是在搭一套系统。
然后你就开始加规则。MUST 不能这样,NEVER 不能那样,遇到 X 情况走 Y 分支。你觉得规则加够了,它终于不崩了。
但很快你会碰到几个让人崩溃的事情。
稳定性。 你加了一个看起来特别对的安全检查,比如「git 状态不干净就拒绝执行」。所有测试都过了。但用户那边一个全新的、还没 git init 的 skill 目录,直接报错退出。你自己测不出来,因为你的测试环境里所有 skill 都已经在 git 下面了。
边界。 你的 cleanup 函数用字符串排序,iteration-1 到 iteration-9 都好好的。直到第 10 轮,iteration-10 突然排到了 iteration-2 前面,cleanup 把最新的结果给删了。你之前一直没发现,因为你的测试从来没跑超过 9 轮。
规则之间打架。 你加了一条安全规则保护 A 场景,结果它把 B 场景的正常路径给封死了,而 B 场景就写在你自己的协议文档里。你自己写的规则把自己写的协议给违反了。
规则越多,模型的行为越不确定。这不是模型的问题,是规则本身的复杂度在爆炸。
1.2 更痛苦的是:skill 终于能跑了,但一点都不 match 你的数据
好不容易,你调了三天,它终于不崩了、不报错了、看起来能用了。
但它一点都不好用。
比如用户问「员工离职后邮箱还在不在」,skill 把它路由到邮箱分类,但正确答案在通讯录的「删除/禁用成员」章节。你知道这是问题,但你不知道有多少类似的问题,更不知道改了这个会不会弄坏别的。
这才是核心。一个「能跑」的 skill 和一个「真的好」的 skill 之间,有一条到西天取经那么具体的路。
「能跑」只是语法通过了、不崩了。「真的好」是它的行为 match 你的数据分布,在你定义的输入上,产出你期望的输出。就像训模型不是让代码编过,是让 loss 收敛。
写一版 SKILL.md → 手动测几个用例 → 觉得不对 → 改几行 → 再测 → 循环往复。质量完全取决于作者水平,有时候觉得我不是在写 skill,是在和自己过不去。
1.3 我怎么走到这一步
接着 3 月份 Karpathy 在 X 上发了一条博客,现在已经出圈到 Fortune 都发报道了(https://fortune.com/2026/03/17/andrej-karpathy-loop-autonomous-ai-agents-future/)。
他写了一个 630 行的 Python 脚本,叫 autoresearch(https://github.com/karpathy/autoresearch)。就干一件事,让一个 AI agent 去迭代一个 LLM 的训练代码,每次改一点,训练 5 分钟,看指标,好了留下,坏了回滚,不停往复。
两天里面,这个 AI agent 跑了 700 个实验。找出了 20 个能让训练变快的优化,性能提升了 19%。
我看到这条推的时候脑子里就一个念头,这不正是我想要的东西吗?
再过了几天,Udit Goenka(https://github.com/uditgoenka/autoresearch) 把 Karpathy 的思路从「优化 LLM 训练代码」泛化成了「优化任何可以测量的东西」,做成了一个 Claude Code skill。他提炼了 5 条原则,one metric、constrained scope、fast verification、automatic rollback、git as memory。
但 Udit 的版本要求用户自己说什么叫「好」什么叫「坏」。而 skill 评测是个非常特殊的问题,既不是跑单元测试那种纯确定性的东西,也不是跑 benchmark 那种纯数字的东西。它更像是语文老师批作文,带主观性,又要有一致性。
你说强巧不巧,Anthropic 自己的 skill-creator(https://github.com/anthropics/skills/tree/main/skills/skill-creator) 恰好提供了一整套 skill 评测和创建能力,quick_validate 做结构检查,grader 做逐条打分,comparator 做 A/B 盲审,还能自动生成 GT 测试用例。评测引擎的底座已经现成了。
接着,4 月初我又看到一篇Paper,斯坦福的 Meta-Harness(https://arxiv.org/abs/2603.28052)。
它说,你要让一个 AI 去优化另一个 AI,最关键的不是给它摘要,不是给它分数,而是给它完整的「原始执行轨迹」。论文的消融实验表示,当你只给LLM分数的相比于给它完整trace,效果差了 44%。
道理很朴素。你让一个医生看完整的病例、化验报告、影像,他能给出好诊断。你把这些压缩成一段 300 字的摘要喂给他,他只能靠猜。
于是我想,好像有什么东西要成了?
1.4 拼在一起
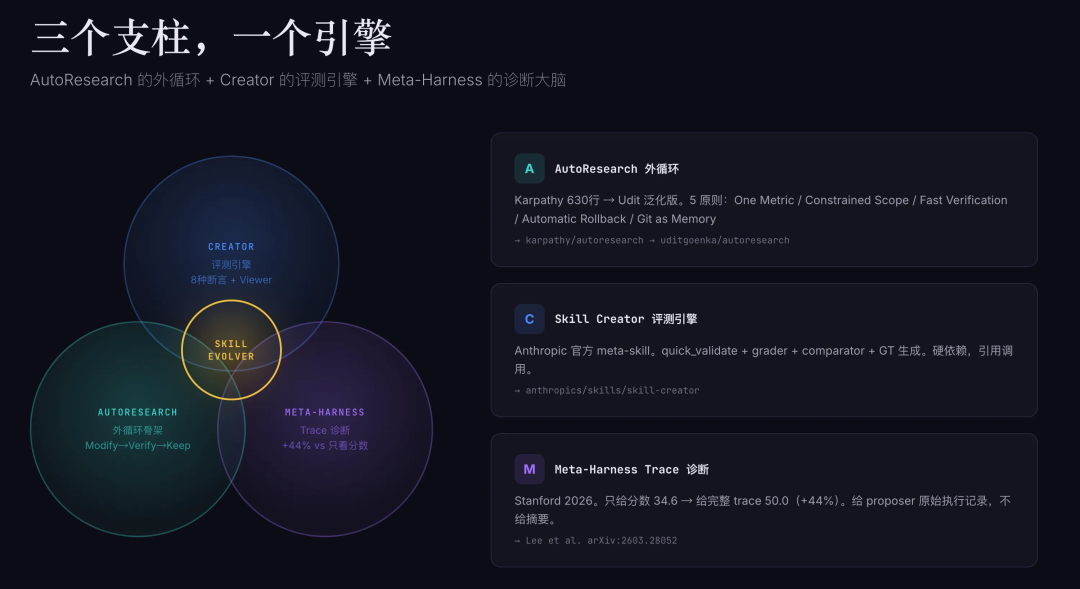
Karpathy 给了外循环的骨架,Meta-Harness 告诉我诊断必须喂原始 trace,skill-creator 提供了评测和创建的完整底座。
或者说,外层用 autoresearch 的方式不断试错、回滚、保留。内层用 creator 的评测把「好不好」这件事测清楚。再用 Meta-Harness 的 trace,把每一次失败变成可诊断的证据,而不是一个模糊的分数。
那我要做的事情其实很清楚了,蒸馏他们!把三种已经被证明有效的思想,在 skill 这个对象上接成了一条能真正跑起来的闭环,能评测,能诊断,能回滚,也能自己迭代自己。
我给它取了个名字,skill-evolver。
Skill-Evolver = AutoResearch 的 loop 骨架 + Creator 的评测引擎 + Meta-Harness 的诊断大脑。
02
这其实就是个「skill 的训练框架」——有点像Torch,但用对话驱动
好了,来源聊完了,说说这东西到底怎么设计的。
2.1 训模型 vs 训 Skill
如果你做过 ML,下面这张表应该一下就懂。没做过也没关系,不妨请接着往下读读:
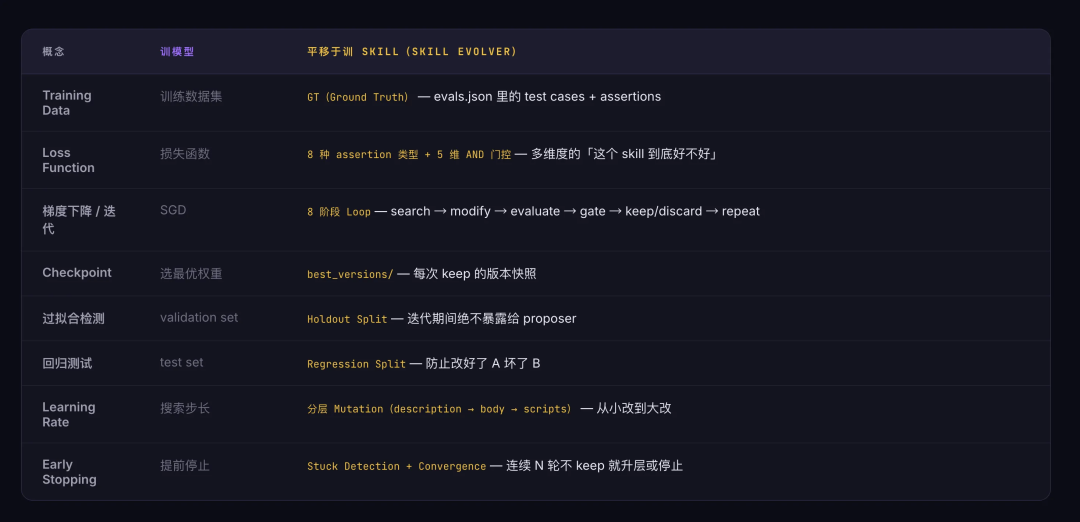
一下子名词有点多,没关系,我们来拆解一下:
GT(Ground Truth) 就是你给 skill 准备的「标准答案」。比如用户问「员工离职后邮箱还在不在」,GT 里写着正确答案应该引用「通讯录/功能介绍.md」这个文件。skill-evolver 每一轮都拿 GT 来测 skill,看它答对了多少。
8 种 assertion 是 GT 里的检查方式。最简单的是 contains(输出里有没有某段文字),复杂的有 script_check(跑一个脚本看返回值)和 fact_coverage(让 LLM 逐条判断知识点有没有被覆盖)。6 种是程序直接判的,2 种需要 LLM 做 YES/NO 分类。
holdout split 是你故意藏起来不给优化器看的测试数据。迭代过程中,优化器只能看 dev 集。等迭代结束,再拿 holdout 集来验证,看 skill 是不是真的变好了,还是只是在 dev 集上「背答案」。
分层 mutation 是改动的粒度控制。先从最便宜的地方开始改(Layer 1 改触发关键词),改不动了再升级到中等代价(Layer 2 改 SKILL.md 正文),还改不动才碰最贵的(Layer 3 改辅助脚本和 references)。不准跨层,每轮只改一层的东西。
关键的一点——这不是让 skill 的「语法检查」通过率更高,是让 skill 贴合你的数据。你的 GT 定义了「好的 skill 应该在什么输入下产出什么结果」,loop 让 skill 不断逼近那个目标,跟 SGD 逼近 loss 最小值是一回事。另外如果你没有GT?没关系,你有AI,你可以提要求让他做,你也可以使用skill creator的eval功能自己生成。
除去以上,接下来我想详细拆解四个核心机制:8 阶段 Loop(整个迭代是怎么转的)、三层评测(怎么判断一轮改动好不好)、5 维 AND 门控(怎么决定 keep 还是 discard)、Trace 诊断(出了问题怎么定位)。
2.2 8 阶段 Loop
Phase 0 做一次性 setup,之后的每一轮迭代都走 8 步:
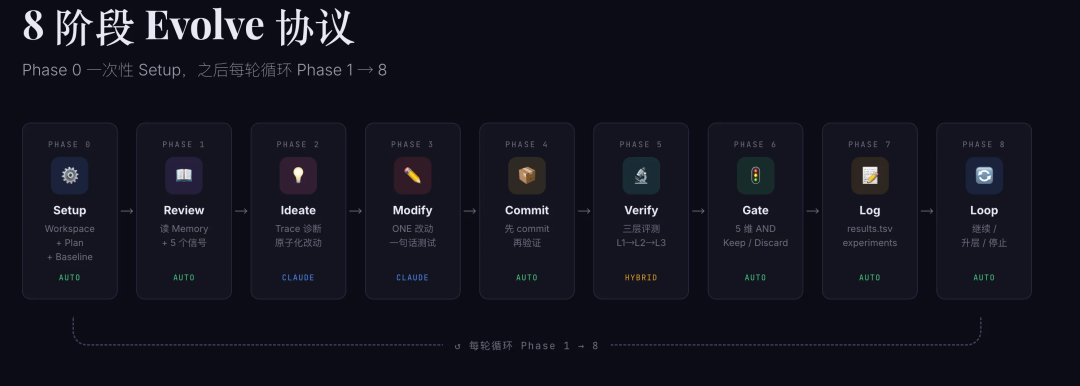
Phase 0: Setup → 创建 workspace + 生成评测计划 + 建立 baseline(一次性)---- 以下每轮循环 ----Phase 1: Review → 读 memory + 执行 tracePhase 2: Ideate → 从 trace 诊断失败原因,提出原子化改动Phase 3: Modify → 执行 ONE 个改动Phase 4: Commit → git commit(先 commit 再验证——保留审计轨迹)Phase 5: Verify → 三层评测流水线Phase 6: Gate → 5 维 AND 门控Phase 7: Log → 写 results.tsv + experiments.jsonl + per-case tracePhase 8: Loop → 继续 / 升层 / 停止其中:
Phase 0(Setup) 不是简单的「初始化」。它要检查 SKILL.md 是否存在、git 状态是否干净、GT 数据是否准备好。然后它会分析你的 skill 和 GT 数据,自动生成一份 evolve_plan.md,里面包含评测策略、门控阈值、起始 mutation 层。这份 plan 决定了后面所有轮次的行为。
Phase 1(Review) 是每一轮的起点。它会去读最近 20 条 git log、最近 20 行 results.tsv、最近 10 条 experiments.jsonl,接着扫描上一轮哪些 case 失败了。从这些记忆里提取 5 个信号:
1. 哪些改法成功过 → 利用它们
2. 哪些改法失败过 → 避免重复
3. 哪些 case 持续失败 → 优先攻克
4. 哪些 case 脆弱 → 当回归守卫
5. 是不是已经卡住了 → 切换激进策略
Phase 2(Ideate) 按 6 级优先级决定这一轮改什么:先修崩溃 → 利用成功模式 → 攻克持久失败 → 探索新方向 → 简化 → 激进变异。有一条硬规矩:提出任何改动之前,必须引用具体的 trace 证据做反事实诊断——「Case X 因为 Y 失败了,如果改 Z,输出就会变成 W」。没证据就不许动手。
Phase 3(Modify) 只允许做一个原子化改动。怎么判断是不是原子化?一句话测试——如果描述这个改动需要用到「和」字,就该拆成两轮。改完之后 git diff --stat 检查一下,超过 5 个文件大概率不是原子的。
Phase 8(Loop) 决定是继续还是停。连续 K 轮没有 keep → 当前层 exhausted,升到下一层。连续 5 次 discard → 切换激进策略。三层都试过都没改善 → 终止,输出最终报告。
2.3 三层评测——从硬规则到软判断,逐层递进
Phase 5 的评测不是一刀切的「跑一遍测试」,而是分三层,成本递增,便宜的每轮都跑,贵的条件触发:
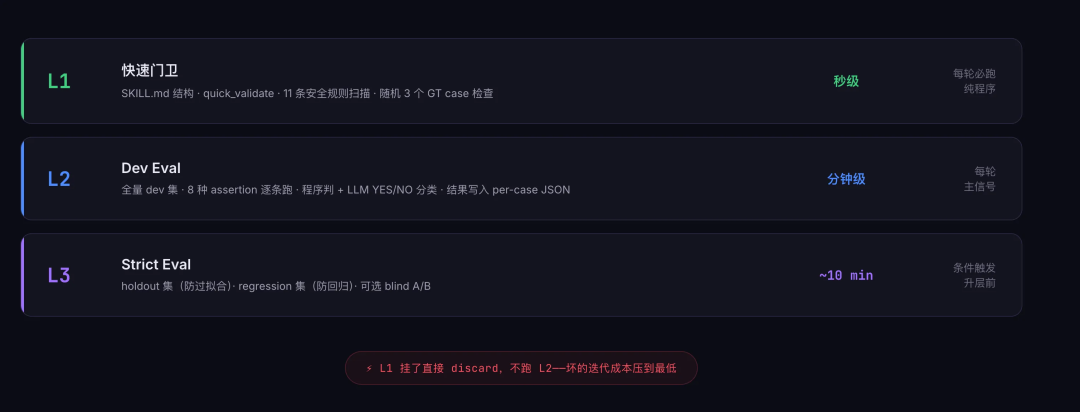
L1 快速门卫(秒级,每轮都跑)。纯程序检查,不需要 LLM。它做 4 件事:
1. 检查 SKILL.md 结构是否完整
2. 调用 skill-creator 的 quick_validate 做格式校验
3. 跑一轮安全规则扫描(检测危险删除命令、硬编码 API key、硬编码绝对路径等 11 条规则)
4. 随机抽 3 个 GT case 检查基本结构

其中 2 条 critical 规则(危险删除命令、硬编码密钥)不过直接阻断,其余 warning 记录下来给 Phase 2 参考。**L1 挂了直接 discard,不跑 L2——坏的迭代成本压到最低。**
L2 Dev Eval(分钟级,每轮都跑)。拿全量 dev 集的 GT case,逐条跑 8 种 assertion 评测。程序能判的(contains、regex、script_check 等)程序判,需要语义理解的(path_hit、fact_coverage)让 LLM 做 YES/NO 分类,程序数 YES 的数量算分。结果写入 per-case JSON,供下一轮 Phase 1 诊断用。
L3 Strict Eval(~10 分钟,条件触发)。只在三种情况下跑:
1. 每 N 次迭代自动触发
2. dev pass_rate 超过某个阈值时
3. 层晋升之前

它跑的是 **holdout 集**(优化器从来没见过的数据,防过拟合)和 **regression 集**(确保老 case 没坏),还可以做 blind A/B 对比。
2.4 5 维 AND 门控——每一轮改动的生死线
每一轮改动都要过一次「体检」。5 个问题全部回答 YES 才能保留,任何一个 NO 就 git revert,当这轮没发生过:
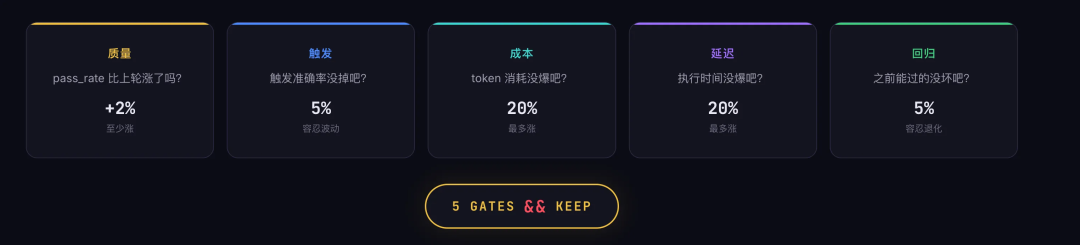
为什么是 AND 不是加权求和? 加权求和会让你在一个维度上拿高分来补另一个维度的低分。质量涨了 10% 但 token 消耗翻倍?加权求和可能给你 PASS。AND 逻辑不会。
2.5 Trace 诊断——用原始执行记录定位问题
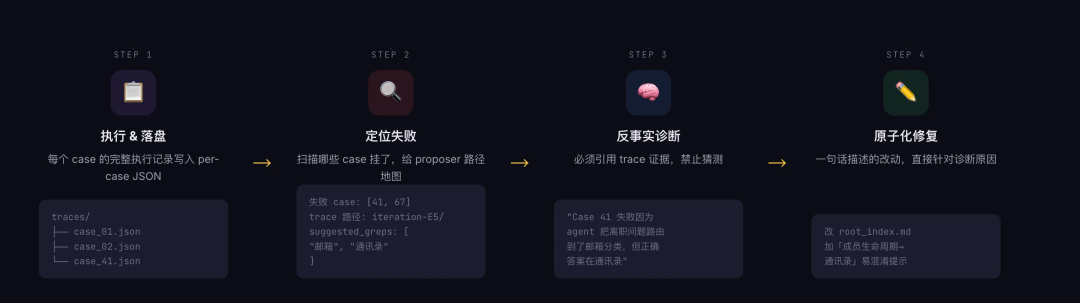
一般的优化工具告诉你「这轮得了 80 分」,然后你自己猜哪里出了问题。Skill Evolver 不是。
它把上一轮每个 case 的完整执行记录落盘成文件,下一轮诊断时直接告诉 proposer:这几个 case 挂了,trace 文件在这个路径,自己去看。不是把 10M token 的 trace 全塞进 prompt,而是给一张「地图」,让它自己去现场看。
proposer 的协议也很硬:先看 trace 再诊断再改,不准猜。 没有 trace 证据就不许动手。所以每一轮改动都是有据可查的,不是「感觉这里可以优化」,而是「Case 41 挂了,因为 agent 把离职问题路由到了邮箱分类,但正确答案在通讯录,所以我改 root_index.md 加个易混淆提示」。每一步都有 trace 背书,像写论文引文献一样。
好了,设计得差不多了。但设计好看没用,得跑起来才算数。
03
我把它做出来了,并且验证了可行性
Skill Evolver 本身也是一个 skill。那就让它优化自己呗。
这个动作的残酷之处在于——你的 SKILL.md 既是「菜谱」,告诉 AI 该怎么做菜,又是「被烤的蛋糕」,是被改的对象。任何一个协议上的缺陷,在执行过程中都会被自己暴露出来。
先看数字:
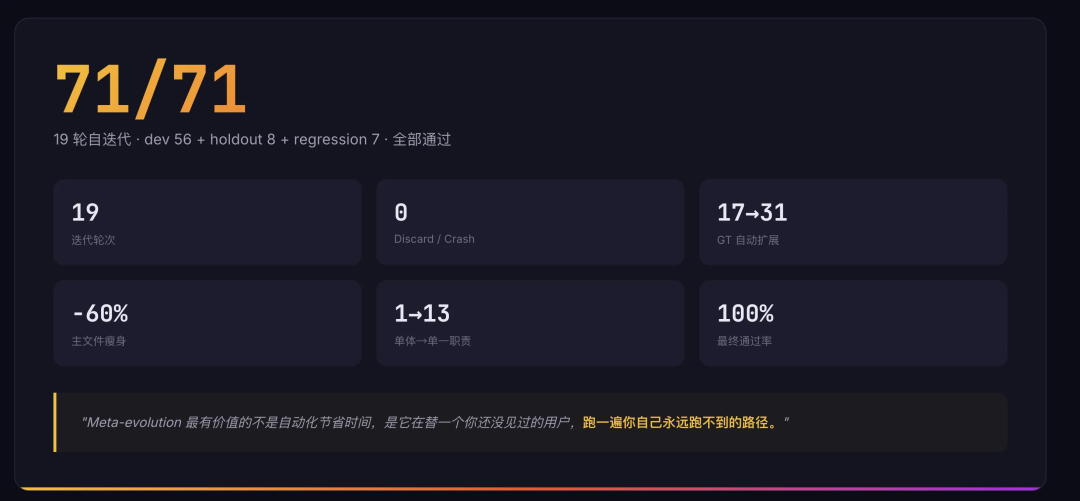
指标 | 数值 | 什么意思 |
|---|---|---|
迭代轮数 | 19 轮 | 10 轮修 bug 和文档、3 轮修安全漏洞、1 轮清理死代码、5 轮代码重构 |
被丢弃的轮次 | 0 | 每一轮都通过了 5 维门控,没有一轮被 revert |
崩溃 | 0 | 19 轮里一次都没崩 |
测试用例 | 17 → 31 | 从 17 个扩到 31 个,多出来的 14 个都是迭代过程中发现新问题AI自动补的 |
最终通过率 | 71/71 = 100% | 31 个用例共 71 个检查点(训练集 56 + 留出集 8 + 回归集 7),全绿 |
主文件行数 | 1411 → 557 行 | 减少 60%,从一个大文件拆成 13 个单一职责的小文件 |
19 轮全 keep、零回滚。听起来很丝滑对吧?但每一个 keep 背后都是一个我之前完全看不见的问题。
3.1 这 19 轮都在改什么
把 19 轮按类型拆开看,发现了一个有意思的分布:
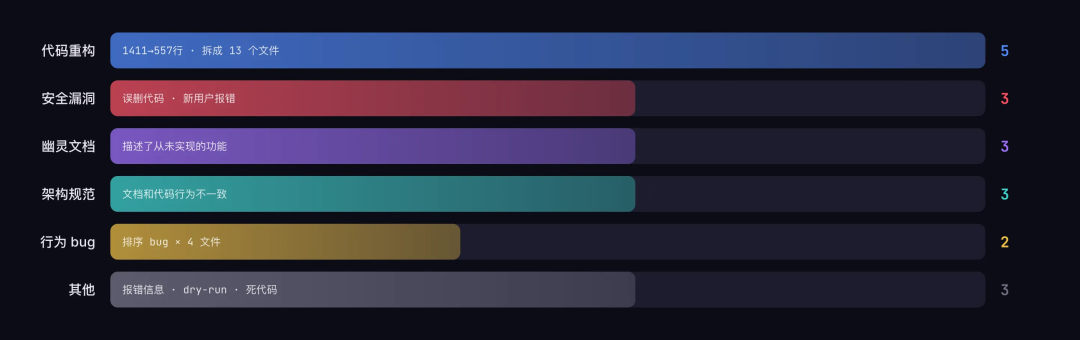
注意,不是全部都是「找 bug」。安全漏洞、幽灵文档、架构不一致这些,手工 review 很难系统性覆盖,但迭代体系会逼它一轮一轮往下挖。
实际跑下来,前 6 轮改的是文档和规范,第 7 轮开始进入代码层,第 15-19 轮连续做了 5 次重构。整个过程没有跨层,每轮只动一层的东西。
3.2 一个印象深刻的例子,以及 agent 架构的好处
举个例子:
轮次 | 发生了什么 |
|---|---|
| 第 7 轮 | 工具给自己加了安全检查,git 状态不干净就拒绝执行。测试全过。 |
| 问题 | 但用户的 skill 可能还没 |
| 第 12 轮 | 工具自己发现了这个回归,按协议重写了初始化逻辑 |
干净 git → 继续 脏 git → 报错 没有 git → 自动 init / git 没装 → 给安装指令 | |
| 验证 | 自己在一个全新空目录上跑了端到端测试,通过 |
从发现到修复到验证,全是它自己完成的。
第 15 到 19 轮,工具连续做了 5 次代码重构,主文件从 1411 行拆成 13 个小文件,每个不超过 600 行。每次拆完立刻跑全量测试验证不变,一次都没偷懒。
这里有一个很重要的点——因为整个过程是在对话中进行的(agent 架构),你可以随时在迭代过程中插入自己的新想法。比如跑到第 10 轮我觉得代码太臃肿了,直接说「帮我把 gate 逻辑提取成独立文件」,它下一轮就照做,做完照样跑门控。不像传统的自动化管道,一旦启动就是黑盒。这里更像是和一个搭档一起迭代,你随时给方向,它随时执行+验证。
3.3 我拿它去跑了一个真实业务
meta-evolution 是自己改自己。那拿去改别的 skill 呢?
比如最近我在优化一个客服问答 skill,从近千篇知识库文档里检索候选路径。这个 skill 手工调了好几轮,召回率已经到 96%。新需求是把候选数从 10 个压到 6 个,同时 recall 不能掉。91 条 GT,指标是 strict_full_recall。
压完候选数之后,召回率先掉到了 86%——75 个 case 里有大约 10 个开始 miss。然后交给 skill-evolver 迭代,修掉了 9 个,最后只剩 1 个 miss。
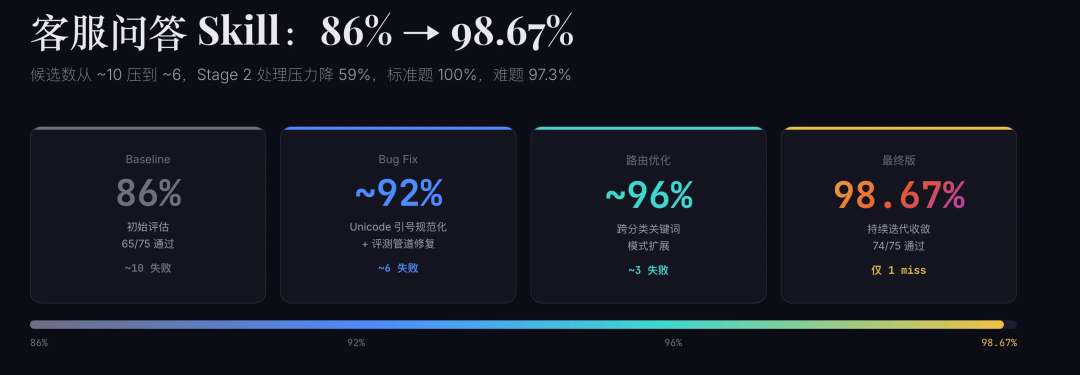
S1 路径召回从 86% 拉到了 98.67%,标准题 100%,难题 97.3%。候选数从 ~10 降到 ~6,Stage 2 处理压力降了 59%。
04
后话:它不完美,但我还是试着相信它
听起来很顺利对吧?坑确实也不少。
LLM 评测的噪声问题。 迭代中最让我头疼的不是 skill 本身——是评测。同一 skill 状态、同一份 GT,Claude 跑 4 次结果在 0.79~0.92 之间漂移。你改了一行规则文本,pass_rate 从 0.85 变成 0.87——这是你的功劳,还是 LLM 今天心情好?你分不清。解法是跑 3 次取均值,但评测成本也翻了 3 倍。天下没有免费的午餐。
GT 质量决定了天花板。 有个 case 48——「如何进入内部群」——GT 标注本身有争议。工具老老实实告诉你 case 48 没过,但无论怎么改 skill 都过不了,因为答案本身就没有共识。这个 case 最后标记为「不可修」,移到了回归集纯做防护用。这不是 bug,是 feature——当一个 case 在 5 轮迭代里都没被修复时,先怀疑你的数据而不是 skill。
自动也意味着昂贵。 meta-evolution 那 19 轮虽然是真正零人工干预,但跑完钱包里直接少了100刀也是真的(在这再一次感谢鹅给我们提供了充足的弹药)。
并且,坦率的讲,第一次用的时候别指望「丢进去睡一觉」就行。前 3-5 轮最好瞄一眼,帮它建立正确的迭代方向。之后它会越跑越准,因为 experiments.jsonl 积累了足够的 memory,proposer 不会重复犯同样的错。
做完这些后,我有两个特别深的感受。
第一:每一步都验证。
LLM 会偷懒(跳过验证步骤)、会过拟合(为了涨分硬编码 case)、会自作主张(并行你说了不能并行的 stage)。不是它坏,是它的概率本性决定了它不是一个好的状态机控制器。
与其写更长的 prompt 来「说服」它守规矩,不如把规矩写进代码——门控函数不通过就 git revert HEAD,没有商量余地。程序掌握控制流,LLM 只管单点生成。
第二个是认知层面的。
这 19 轮跑完之后,我坐了很久,发现:
Meta-evolution 最有价值的不是自动化节省时间,是它在替一个你还没见过的用户,跑一遍你自己永远跑不到的路径。
你自己测你的工具,只能在你熟悉的 regime 里测。你的 skill 全都在 git 下,你的迭代从来没超过 5 轮,你的工作区永远是干净的。你不知道你的工具在 regime 之外会怎样。
19 轮就是 19 个不同的 regime。每一次 rebaseline 都会暴露一类你之前想不到的失败。那 14 个新扩的 GT case,每一个都来自于「工具自己用的时候发现的问题」,不是来自于我脑子里想出来的测试。
我一直觉得 AI 时代最被误解的一件事,是人和 AI 的协作模式。很多人理解的协作是分工——你干一半我干一半。但我经过这 19 轮之后觉得,更准确的描述是互补——你在明处看着,AI 在暗处替你试错,你看不见的那一半就是 AI 能贡献的地方。
像 Karpathy 说的那样,spin up a swarm of agents to collaborate in tuning smaller models, promoting the most promising ideas to increasingly larger scales, with humans contributing on the edges optionally.
人在 edge 上 optionally 贡献。
回到最开头那个晚上,我在想,或许我那天一直想说但却一直没思考到关键的点是:skill 不该是你手工打磨的工艺品,它应该是一个可以被训练、被回滚、被选优的对象。 你只需要做好数据、定好指标,剩下的交给循环。
那一刻我感觉到的是一种特别奇怪的谦卑。
我意识到,在我写的每一行代码的背后,都藏着一整片我没有能力去观察的 regime。而那片 regime 里面,住着我真正的用户。
我没有办法一个一个跑遍所有的 regime。
但我可以做的事情是,写一个工具,让它替我跑。
让它替我,去那个我永远没法亲自到达的地方。
去看那个我永远没法亲眼看见的用户。
替我问一句,你还好吗?
这件事本身,可能比 skill-evolver 这个工具有意思 1000 倍。
附录
技术支柱溯源(其余参考资料暂未列出,包含多篇技术博客,不胜感激)
支柱 | 来源 | 借了什么 |
|---|---|---|
| 自主迭代外循环 | Karpathy autoresearch(https://github.com/karpathy/autoresearch) | 8 阶段骨架 + 5 原则 |
| 通用化 | uditgoenka/autoresearch(https://github.com/uditgoenka/autoresearch) | 泛化到 Claude Code 生态 |
| Trace 驱动诊断 | Stanford Meta-Harness(https://arxiv.org/abs/2603.28052) | 原始 trace 喂 proposer(+44%) |
| 评测引擎 + 创建能力 | skill-creator(https://github.com/anthropics/skills/tree/main/skills/skill-creator) | 硬依赖,quick_validate + grader + comparator + GT 生成 |
Skill Evolver 的增量贡献:5 维 AND 门控 + 分层 mutation + Meta-Harness trace 架构 + workspace git 隔离 + meta-evolution 自证。
-End-
原创作者|张思宇
感谢你读到这里,不如关注一下?👇
📢📢来抢开发者限席名额!点击下方图片直达👇
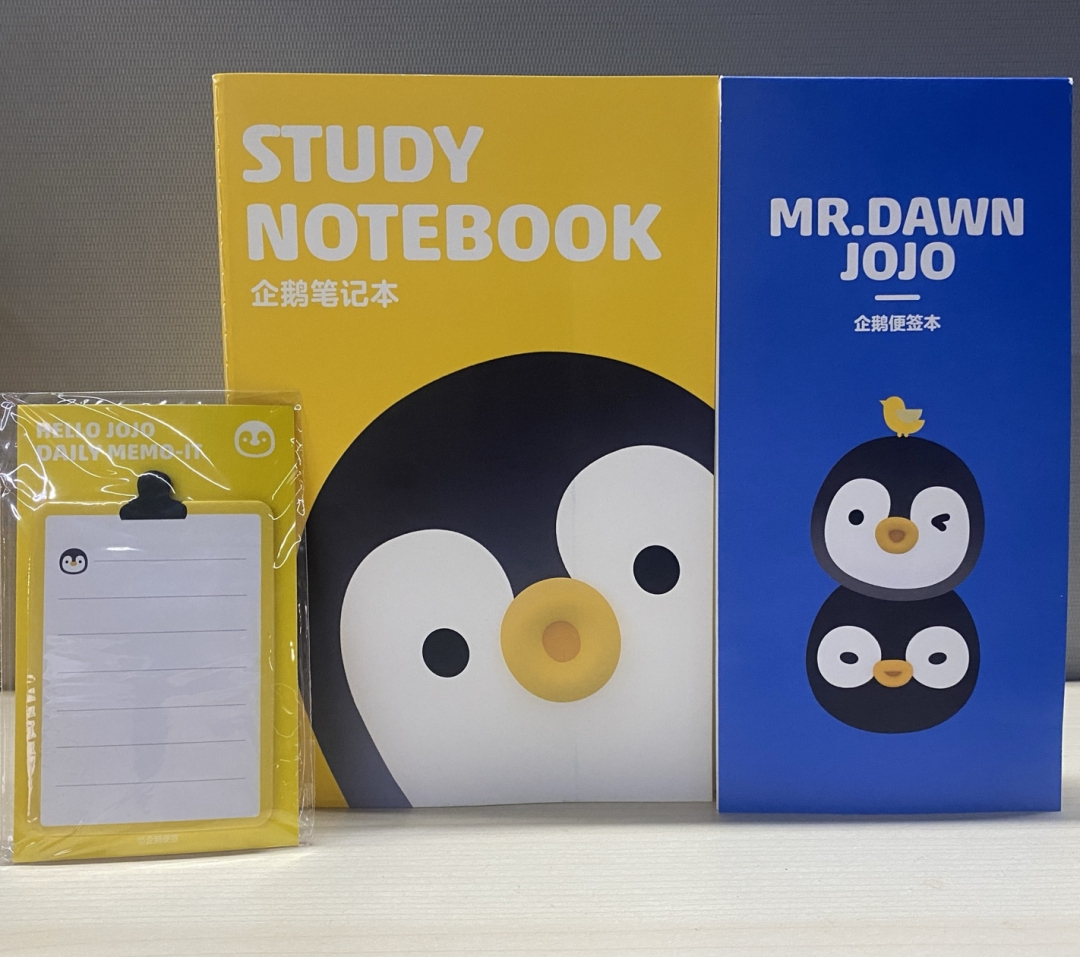
你对本文内容有哪些看法?同意、反对、困惑的地方是?欢迎留言,我们将邀请作者针对性回复你的评论,欢迎评论留言补充。我们将选取1则优质的评论,送出腾讯云定制文件袋套装1个(见下图)。5月26日中午12点开奖。
扫码领取腾讯云开发者专属服务器代金券!


 400


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


