python 爬取指定城市得近几年天气情况 并做可视化展示(附代码)

Python获取天气数据 并做可视化解读气象魅力 大家早好、午好、晚好吖 ❤ ~欢迎光临本文章前几天的长沙,白天大太阳,晚上下暴雨一点也琢磨不透天气老人家它的想法顺便哔哔一点生活小插曲:前几天的时候,我出门,家里的几扇窗户开着在透气等我十一点回到家,我的客厅和厨房进了一地的水太让人伤心了,好啦,话不多说!让我们进入正题吧用python对天气数据进行采集,并作可视化图表。 阅读详情

前言

需要准备环境

python 3.9
pycharm 2021

模块使用

re, csv – 内部模块,不需要安装
requests, bs4, pandas, matplotlib
– 第三方库,win + R 输入cmd 打开命令窗口 输入安装命令 pip install 模块名

分析网站

查看全国各地得历史天气

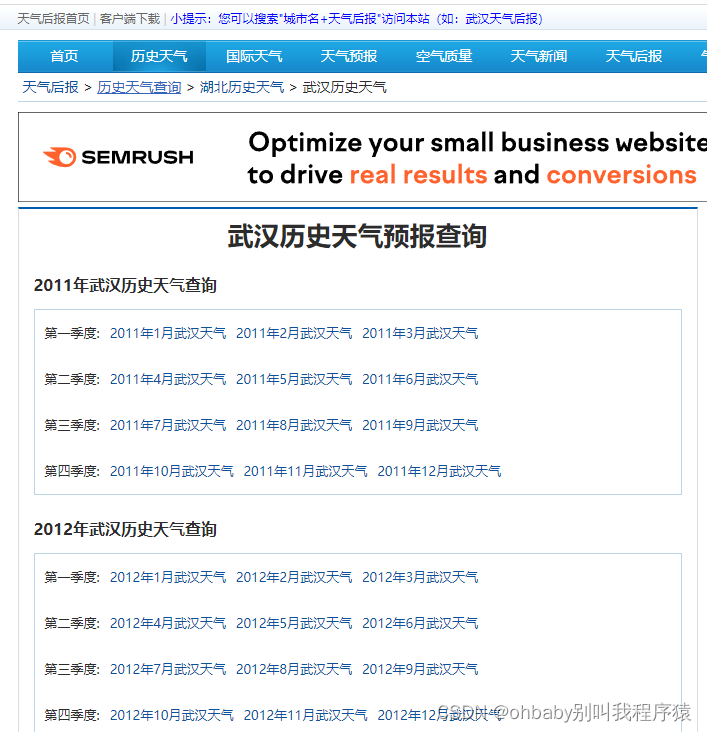
点击任意城市,因为我在武汉,这里以武汉举例,能够看到武汉每个月份的历史天气情况链接
在这里插入图片描述
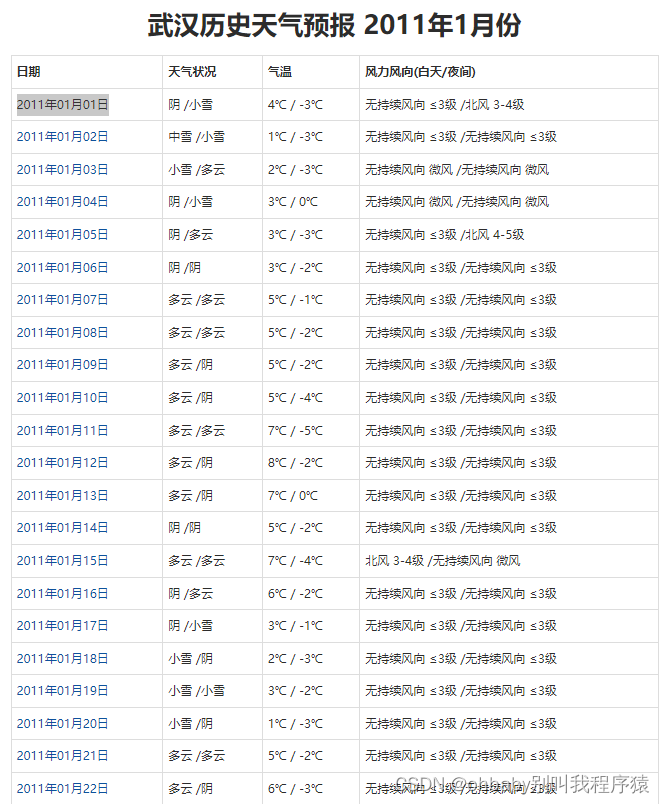
我们以2011年1月份举例,打开之后能够看到每天的天气情况
在这里插入图片描述
先确定我们要爬取的数据,对于每一天,我们爬取它的日期,以及最高温和最低温
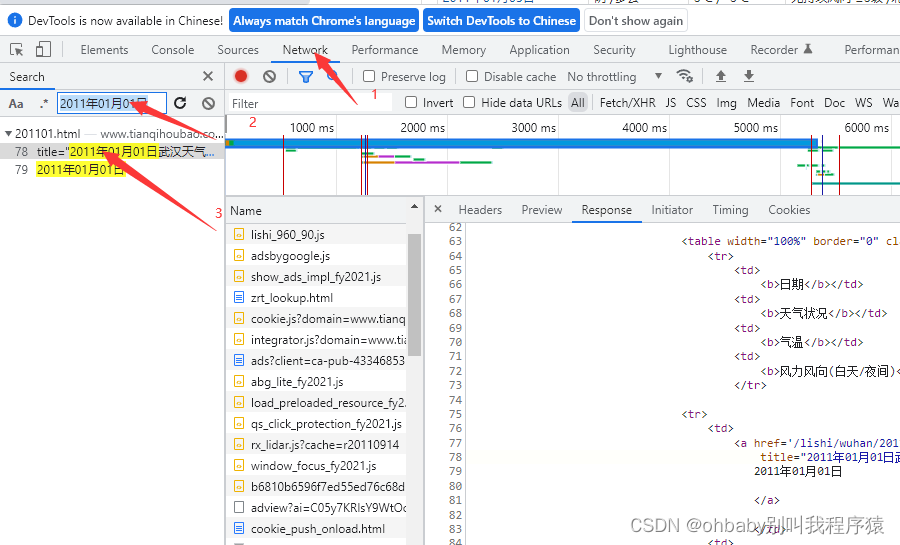
这时我们可以在当前页面通过
F12 或者 右键+检查 打开开发者工具
也就是下面这个东西,跟控制台一样的
在这里插入图片描述
按照图片中的步骤,先进入network模块,然后复制我们网页中的某一条数据搜索,能够找到我们的网页源码的资源位置
在这里插入图片描述
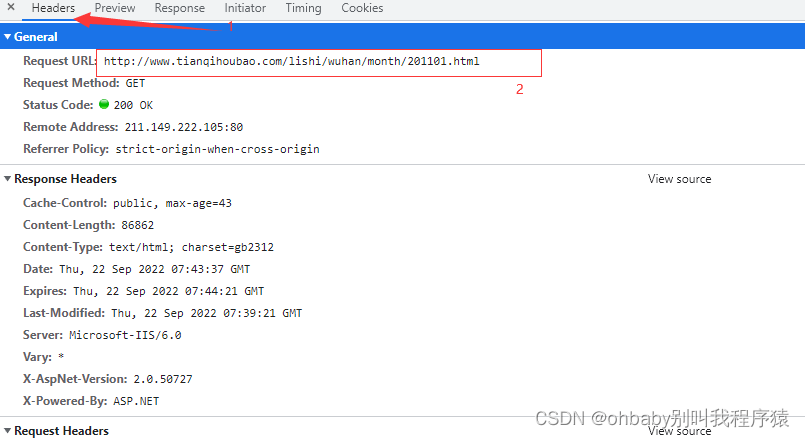
然后我们可以直接在headers里拿到我们需要的请求地址
下面可以开始编辑我们的源码

爬取数据

首先导入模块

import csv
import re
from bs4 import BeautifulSoup
import requests

然后打开文件,并创建一个csv的对象

f = open('data.csv', mode='a', encoding='utf-8', newline='')
csv_writer = csv.writer(f)

先写入表头

csv_writer.writerow([
    '日期',
    '最高气温',
    '最低气温'
])

然后去网页中拿取请求头
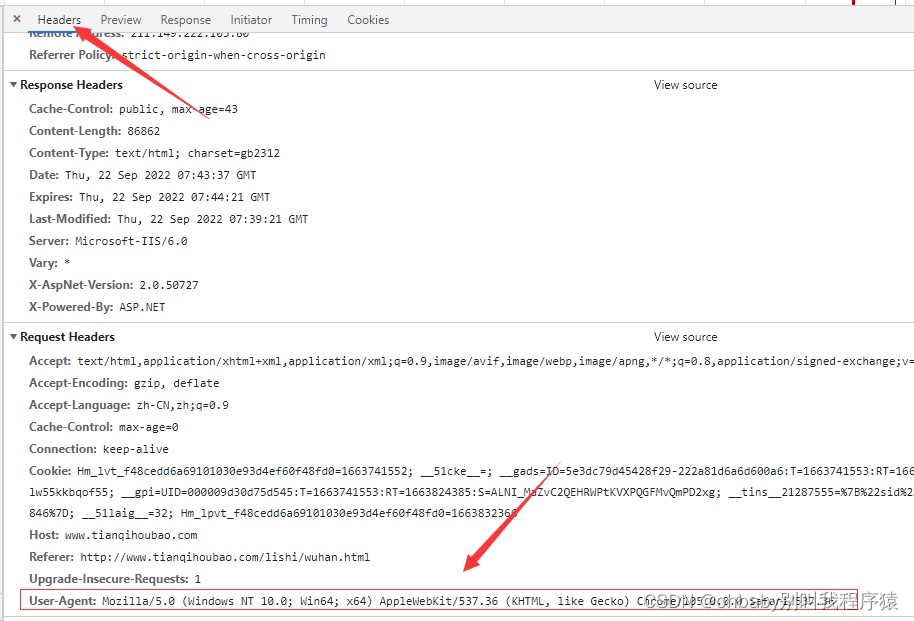
在这里插入图片描述
还是在之前的headers下面,还有我们拿取的请求地址

headers = {
    'User-Agent': '请求头信息'
}

url = 'http://www.tianqihoubao.com/lishi/wuhan/month/201101.html'

然后发送请求

response = requests.get(url=url, headers=headers)

使用bs4创建一个BeautifulSoup对象

soup = BeautifulSoup(response.text, 'lxml')

然后对拿取的网页源码做分析,我们发现每一条数据其实都是被tr标签包着的
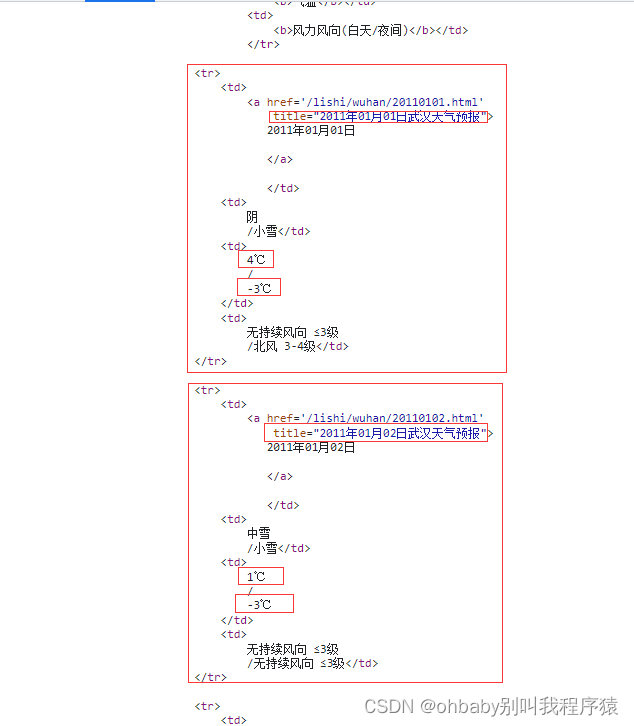
在这里插入图片描述
我们可以直接拿到所有tr标签信息,然后对每一条数据进行正则匹配拿到日期和温度数据

tr_list = soup.find_all('tr')

        for info in tr_list:
            info = str(info).replace(' ', '')
            # print(info)

            date = re.findall('title="(.*?)武汉天气预报', info)

            tem = re.findall('(.*?)℃', info)

            if len(date + tem) == 3:
                print(date + tem)
                csv_writer.writerow(date + tem)

当然最后别忘了,文件需要关闭

f.close()

然后我们可以拿到单页 也就是单个月的数据
现在我们需要拿取几年内的数据,我们对比多个月份的请求地址发现
http://www.tianqihoubao.com/lishi/wuhan/month/201101.html
对于后面的201101其实就是年份+月份,然后月份如果是个位数,前面需要加上0
这样能得出所有的月份的请求地址 然后分别进行爬取就好了

完整代码

import csv
import re

from bs4 import BeautifulSoup
import requests

f = open('data.csv', mode='a', encoding='utf-8', newline='')
csv_writer = csv.writer(f)

csv_writer.writerow([
    '日期',
    '最高气温',
    '最低气温'
])

headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/105.0.0.0 Safari/537.36'
}

for year in range(2011, 2021):
    for month in range(1, 13):
        year = str(year)
        if month < 10:
            month = '0' + str(month)
        month = str(month)

        url = 'http://www.tianqihoubao.com/lishi/wuhan/month/' + year + month + '.html'

        response = requests.get(url=url, headers=headers)
        # print(response.text)

        soup = BeautifulSoup(response.text, 'lxml')
        tr_list = soup.find_all('tr')

        for info in tr_list:
            info = str(info).replace(' ', '')
            # print(info)

            date = re.findall('title="(.*?)武汉天气预报', info)

            tem = re.findall('(.*?)℃', info)

            if len(date + tem) == 3:
                print(date + tem)
                csv_writer.writerow(date + tem)
f.close()

可视化

# 老规矩,先导入模块
import pandas as pd
from matplotlib import pyplot as plt

# 读取csv文件数据
data = pd.read_csv('data.csv', encoding='utf-8')

# 分别拿取日期和温度的数据,而且将温度数据转成int类型
date = data['日期']
h = [int(i) for i in data['最高气温']]
l = [int(i) for i in data['最低气温']]

# 使用pyplot 的figure方法创建一个自定义的图像对象
image = plt.figure(dpi=128, figsize=(20, 6))

# 设置中文字体可见
plt.rcParams['axes.unicode_minus'] = False
plt.rcParams['font.sans-serif'] = ['SimHei']

# 先画最高温的线条,再画最低温的线条
plt.plot(date, h, color='red', alpha=0.5)
plt.plot(date, l, color='blue', alpha=0.5)

# 将最高温和最低温两条线中间部分给填充
plt.fill_between(date, h, l, facecolor='blue', alpha=0.2)

# 设置标题和x y轴名称
plt.title('北京市近几年的气温变化')
plt.xlabel('日期')
plt.ylabel('气温')

# 选择显示x轴的日期名
plt.xticks(date[::300])
# 保存图片
plt.savefig('北京市过去几年的气温变化.jpg')
# 显示图像
plt.show()
python爬取某地十年天气数据 观察我们需要的数据发现其位于一个表格中html中td和table两个标签表示该数据是表格类型数据。如果要通过大量历史天气数据做分析,可以通过爬虫的方式获得。想要获得一个城市的历史天气,可以在天气后报网站上查询获得。由于是非静态网页,爬取的时候需要设置一些参数。上图就是我们要爬取的网页以及数据。 阅读详情

相关推荐

【python爬虫】爬取全国天气数据并存入数据库

提示:文章写完后,目录可以自动生成,如何生成可参考右边的帮助文档 文章目录前言一、导包二、代码1.连接数据库2.爬虫总结最后 前言 爬取的网站:http://www.weather.com.cn/textFC 采用BeautifulSoup库爬取数据和pymysql导入数据库 一、导包 import requests from bs4 import BeautifulSoup import pymysql 二、代码 1.连接数据库 代码如下(示例): conn = pymysql.connect(h.

qq_45707085的博客 4418

Python爬取城市天气数据,并作数据可视化

本文介绍了如何使用Python爬虫和数据可视化工具,爬取多个城市的天气数据并进行可视化分析。首先,使用Python爬虫从网站上获取多个城市的天气数据,并将数据存储到本地文件中。然后,使用Pandas库读取数据文件,并使用Matplotlib和Seaborn库进行数据可视化分析,包括线性图、热力图、散点图等。最后,根据分析结果进行总结和展望。 通过本文的学习,读者可以了解到如何使用Python进行数据爬取和可视化分析,从而掌握数据分析的基本技能,并应用到实际问题中。同时,也可以了解到如何使用Python库

m0_61981943的博客 1万+

手把手教你用Python爬取实时AQI数据并可视化(含代码示例)

本文提供了一份完整的Python实战指南,手把手教你如何从公开API(如aqicn.org)爬取全球城市的实时空气质量指数(AQI)数据。内容涵盖数据抓取、异常处理、清洗存储,并利用matplotlib、seaborn和Plotly等库进行多维度可视化分析,包括对比条形图、污染物雷达图和交互式仪表板,助你将环境数据转化为直观洞察。

weixin_29215391的博客 1271

Python爬取天气数据及可视化分析!

天气预报我们每天都会关注,我们可以根据未来的天气增减衣物、安排出行,每天的气温、风速风向、相对湿度、空气质量等成为关注的焦点。本次使用python中requests和BeautifulSoup库对中国天气网当天和未来14天的数据进行爬取,保存为csv文件,之后用matplotlib、numpy、pandas对数据进行可视化处理和分析,得到温湿度度变化曲线、空气质量图、风向雷达图等结果,为获得未来天气信息提供了有效方法。

Python84310366的博客 8867

python天气预测模型用arima,python天气预测模型

过去,不管是翻阅书籍,还是通过手机,电脑等从互联网上手动点击搜索信息,视野受限,信息面太过于狭窄,且数据量大而杂乱,爆炸式信息的更新速度是快速且不定时的。要想手动获取到海量的信息,并进行分析整理,都要耗费巨多的时间,精力,效率低下,但是通过网络爬虫,根据需求获取某地及多地天气数据,进行数据清洗,存表,数据可视化,把分析结果反馈给用户如何用python画不同大小的满天星。本课题的主要目的是设计面向定向系统的网络爬虫程序,同时需要满足不同的性能要求,详细涉及到定向网络爬虫的各个细节与应用环节。

2401_85306094的博客 1066

Python大数据招聘爬虫可视化系统开发实践

大数据分析技术正深度改变人力资源领域,其中招聘数据的采集与可视化分析成为关键技术方向。通过Python生态的Scrapy爬虫框架可高效获取招聘市场原始数据,结合Pandas进行数据清洗和预处理,再使用Pyecharts实现多维度的可视化展示。这种技术组合不仅能应对反爬机制、处理非结构化数据等工程挑战,更能为求职者和企业提供直观的数据洞察。在实际开发中,容器化部署和性能优化是确保系统稳定运行的关键,而合理的数据清洗流程和可视化设计原则则直接影响分析结果的准确性。

weixin_34292402的博客 427

毕业设计:基于大数据的城市天气数据爬取与可视化系统

深圳市天气数据的爬取与可视化系统利用Python编程语言和相关库实现对深圳市天气数据的自动化爬取与可视化展示。系统首先通过网络爬虫技术从气象网站获取实时天气数据,然后对数据进行清洗和整理,最后采用数据可视化技术生成图表与图形,直观展示天气变化趋势。对于计算机专业、人工智能专业、大数据专业、信息安全专业、软件工程专业的毕业生而言,尤其是对数据爬取、数据分析与可视化等领域感兴趣的同学,都能为您提供丰富的选题资源和灵感。

毕设帮助,疑难解答,欢迎打扰! 1756

python天气预测的开发工具,python天气预测重点内容

过去,不管是翻阅书籍,还是通过手机,电脑等从互联网上手动点击搜索信息,视野受限,信息面太过于狭窄,且数据量大而杂乱,爆炸式信息的更新速度是快速且不定时的。要想手动获取到海量的信息,并进行分析整理,都要耗费巨多的时间,精力,效率低下,但是通过网络爬虫,根据需求获取某地及多地天气数据,进行数据清洗,存表,数据可视化,把分析结果反馈给用户如何用python画不同大小的满天星。本课题的主要目的是设计面向定向系统的网络爬虫程序,同时需要满足不同的性能要求,详细涉及到定向网络爬虫的各个细节与应用环节。

a17348的博客 774

毕业设计:基于Python的城市天气数据分析与可视化系统

毕业设计:基于Python爬虫的天气数据分析与可视化方法。通过爬取多个天气数据源的实时数据,我们使用Python的数据处理和可视化库对数据进行分析和展示。通过折线图、散点图和热力图等可视化手段,我们展示了不同时间段和地区的气温、降雨量和风速等天气变量的变化趋势和关联性。此外,我们还通过交互式可视化工具,让用户能够自由地探索和筛选数据,对天气现象进行更深入的研究。这个基于Python爬虫的天气数据分析与可视化方法为计算机毕业设计提供了一个创新的方向。

Hai_Lang_IT的博客 3148

复合材料热压罐固化残余应力仿真与优化

复合材料在热压罐固化过程中产生的残余应力是影响构件性能的关键因素,尤其在航空航天和风电叶片等高端制造领域。通过多物理场耦合仿真技术,可以精确预测残余应力分布,优化工艺参数。顺序耦合方法分步求解热分析和结构分析,既保证了计算精度,又控制了成本。Abaqus等有限元工具在此过程中发挥重要作用,通过合理设置边界条件、材料属性和接触关系,能够有效模拟温度场和应力场的相互作用。工程实践中,这种仿真方法已成功应用于无人机机翼、卫星支架等实际项目,显著降低了固化变形和微裂纹风险。

weixin_33146151的博客 216

Cadence电路原理图全部变成黄色如何解决?

Cadence电路原理图全部变成黄色如何解决?现象:解决方法: 最近用cadence仿真锁相环,拷贝师哥的library后打开,发现schematic中全部变成了黄色,但可以正常修改元件参数,正常仿真。仅仅影响使用效果,看起来超级难受。 现象: 1.电路元件及连线全部变为黄色 2.可以正常修改参数,电路ADE仿真 如下图所示: 解决方法: 重新导入display.drf文件,步骤如下: tool——Display Resource Manager,截图如下 完成上述步骤,显示如下界面,选择Merge选项

virtuoso~晓晓 1万+

毕业设计:基于Python的济南市天气数据的爬取与可视化的实现

天气数据的爬取与可视化通过网络爬虫技术,从多个可靠的天气数据源自动获取实时天气信息,并利用Python的Requests和BeautifulSoup库进行数据抓取和解析。爬取的数据经过清洗与处理,以确保数据的准确性和一致性,随后进行探索性分析以识别数据中的趋势、季节性和异常值。采用时间序列分析方法对天气数据进行建模与预测,选择合适的模型,如ARIMA,进行训练与优化。通过可视化工具展示预测结果与真实数据对比,帮助用户直观理解天气变化趋势和模型的预测性能。

毕设帮助,疑难解答,欢迎打扰! 802

反激电源RCD尖峰吸收电路的原理以及调试

反激电源RCD尖峰吸收电路的原理以及调试

mnmmnmn的博客 9250

基于Hadoop的天气预报数据爬取与可视化分析

摘要 本项目基于Spring Boot框架开发了一个天气预报数据爬取与可视化分析系统,采用Java语言实现后端逻辑,MySQL 5.7存储气象数据。系统通过爬虫技术获取多源气象数据(如中国气象局、NOAA等),支持动态页面解析(Selenium)与数据清洗,并利用ECharts实现温度、降水等要素的可视化展示。管理员可通过后台(localhost:8080/admin)管理数据,系统提供折线图、热力图等交互式图表,辅助农业、能源等领域的决策分析。开发环境包括JDK1.8、Maven3.3.9及Tomcat7

G3259093417的博客 1044

AI驱动的iOS逆向工程自动化:14阶段工作流与Ghidra集成实践

逆向工程是软件安全分析的核心技术,通过反汇编、调试等手段解析程序内部逻辑与数据流。其原理在于将编译后的二进制代码还原为可理解的逻辑结构,从而发现潜在漏洞或理解软件行为。在移动安全领域,iOS逆向工程具有重要技术价值,能够用于安全审计、漏洞挖掘与恶意软件分析。传统iOS逆向依赖ipsw、class-dump、Frida等工具链组合,存在学习曲线陡峭与流程碎片化问题。本文介绍的ios-reverse-skills项目创新性地将14阶段逆向工程方法论封装为AI可调用的标准化脚本集,通过Ghidra脚本实现Swif

weixin_27268733的博客 434

基于 YOLOv26 的食品包装缺陷检测系统:智能视觉质检方案

本文提出了一种基于YOLOv26深度学习的食品包装缺陷智能检测系统。该系统能够自动识别多种常见包装缺陷,包括密封不良、破损、污染、标签错误等8类问题。相比传统人工检测方法,该系统具有高精度、多类别分类、实时推理等优势。文章详细介绍了系统架构,包含数据采集、预处理、YOLOv26检测模型和后处理四个核心模块,并提供了完整的环境配置和数据处理代码实现。该系统为食品包装行业提供了一种高效、准确的智能视觉质检解决方案。

一键难忘的博客 684

java爬取网页数据_利用Python做数据分析—对前程无忧数据类岗位进行分析

引言随着时代的发展,我国在各行各业都需要大量的人才引进,处于近几年最热门的行业也称“最火行业”:大数据、数据分析、数据挖掘、机器学习、人工智能,这五门行业各有不同又互有穿插。近几年在实现信息科技化的推动,大数据等行业迅速发展,本文探索大数据、数据分析、数据挖掘等与数据有关行业的招聘信息,分析其岗位、薪资、学历、技能等要求,研究其招聘特点,本文主要针对的用户为本科、研究生、博士生学历的在读生或毕业生...

weixin_39558521的博客 582

环境仿真软件:EcoPath with Ecosim_(4).Ecosim模型动态模拟

Ecosim 是 EcoPath with Ecosim (EwE) 软件中的动态模拟模块,用于模拟生态系统中各个组分的动态变化过程。Ecosim 模型通过时间序列数据和动态参数,可以预测生态系统在不同管理措施下的响应。时间序列数据的输入:用户可以输入历史数据,如捕捞努力、生物量、环境因子等,用于校准模型。动态参数的设置:用户可以设置被捕食率、生长率、捕捞死亡率等动态参数,以反映生态系统的变化。模拟结果的分析。

kkchenjj的博客 893

从天气预报到科研分析:手把手教你用Python爬取并处理气象数据(含完整代码)

本文提供了一套完整的Python气象数据处理实战指南,涵盖从数据源选择、多策略爬取(应对反爬与JSON解析)、数据清洗与质量评估,到基础可视化与探索性分析的全流程。文章包含详细代码示例,帮助读者高效获取并处理气象数据,应用于科研、农业、商业等多个领域。

tree8的博客 597

PyQt5简介和安装

在initUI方法中,设置了窗口的标题和大小,并创建了一个按钮。PyQt5是一个功能强大的Python界面开发框架,可以轻松创建跨平台的图形用户界面应用程序。本文介绍了PyQt5的简介和安装方法,并提供了一个简单的示例应用程序来演示PyQt5的基本用法。PyQt5是一个功能强大的Python界面开发框架,它提供了丰富的工具和组件,用于创建跨平台的图形用户界面(GUI)应用程序。信号是控件发出的事件,槽是与之关联的处理函数。接下来,我们将编写一个简单的PyQt5应用程序,以演示PyQt5的基本用法。

XdKwargs的博客 222

如何成为一名高级数字 IC 设计工程师(6-7)数字 IC 验证篇:DEBUG 技巧

不懂验证的设计不是好的设计;UVM 验证思维是指导缜密的芯片设计的导师;推荐书籍《芯片验证漫游指南》。

新芯设计的博客 1605

基于Python的招聘网站信息爬取-计算机毕业设计源码+LW文档

但是面对着大量的招聘信息,应聘者难以在很快的时间内找到适合自己的岗位,做出适合自己选择,也不能根据这些信息直观的看到应聘者比较关心的薪资状况分布,企业的主要招聘城市,公司福利和所要求的学历与经验等方面。首先使用Request爬取网页数据,分析网页,将内容进行解析后将招聘信息写入数据库,连接数据库,将信息查询后读取并写入字典,使用ECharts框架,将数据传输到前端网页,以饼状图,柱状图,折线图等形式展示,让用户直观的看到招聘信息的地域,薪资,待遇等分布,直观的展示和获取到最关心的招聘信息。

qq_375279829的博客 545

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

空气质量数据背后的秘密:教你用Python爬取PM2.5历史数据并可视化分析

本文详细介绍了如何使用Python爬取PM2.5历史数据并进行可视化分析,帮助读者构建空气质量监测工具。从数据获取、存储到多维分析,涵盖爬虫构建、SQLite数据库管理及matplotlib可视化技术,最终实现空气质量趋势预测和Web展示。

weixin_29306011的博客 871

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

旅游数据分析入门:从爬取去哪儿网景点数据到可视化展示

本文提供了一个完整的旅游数据分析实战教程,详细介绍了如何使用Python爬虫技术从去哪儿网采集景点数据,并利用pandas进行数据清洗与分析,最终通过可视化手段揭示景点热度、评分与区域分布等商业洞察。

sam99的博客 244

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

python爬虫广州城市租房需求数据分析系统 可视化大屏分析系统xumld.

租房者模块账户管理:注册、登录、个人信息编辑、密码更改、账户注销。房源浏览:查看不同类型和地区的房源,筛选、排序功能(如价格、面积、需要做定位功能!等)。租房申请:提交租房申请,包括填写租赁信息和上传必要文件。消息系统:接收系统通知和房产中介的回复,论坛交流。评价反馈:对看过的房源和交易过程进行评价和反馈。数据分析:1.价格图表(依据地区,房型不同)趋势走向图(增加需要有数据分析图)!2.人数(房间被租过的次数)或近几年此地区租房总人数。出租者模块。

专注分享bishe530的博客 1617

python基于天气预测的生活规划系统的设计与实现

过去,不管是翻阅书籍,还是通过手机,电脑等从互联网上手动点击搜索信息,视野受限,信息面太过于狭窄,且数据量大而杂乱,爆炸式信息的更新速度是快速且不定时的。要想手动获取到海量的信息,并进行分析整理,都要耗费巨多的时间,精力,效率低下,但是通过网络爬虫,根据需求获取某地及多地天气数据,进行数据清洗,存表,数据可视化,把分析结果反馈给用户。本课题的主要目的是设计面向定向系统的网络爬虫程序,同时需要满足不同的性能要求,详细涉及到定向网络爬虫的各个细节与应用环节。

weixin 346127357的博客 911
上一篇: python各种编辑器、APP、软件下载
下一篇: 工具ffmpeg下载安装及环境变量的配置
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值