Python爬虫练习 爬取网络小说保存到txt,这年头谁还付费看小说啊!

如何利用Python爬虫爬取小说网站并保存到txt文件 本人特别爱看网络小说,但是呢,有些小说网站的弹窗广告啊、悬浮广告太烦人,正好最近在研究Python,就来试试利用Python把小说站的小说爬下来,并保存到txt文件里。这样就可以直接使用手机打开txt来看了。并且呢,我也能熟悉利用python抓取文本数据的方法。 以爬取靠谱小说网的《伏天氏》这本小说的章节内容为例,目标url:http://www.kpxsw.com/0_479.html 第一步:选取文章列表其中某一章,检查网页,可以找到这本小说所有章节的链接和名称。 写出xpath表达式提取出hr 阅读详情

利用python爬虫爬取网络小说保存到txt,熟悉利用python抓取文本数据的方法。

以爬取《伏天氏》这本小说的章节内容为例,目标url:http://www.xbiquge.la/0/951/
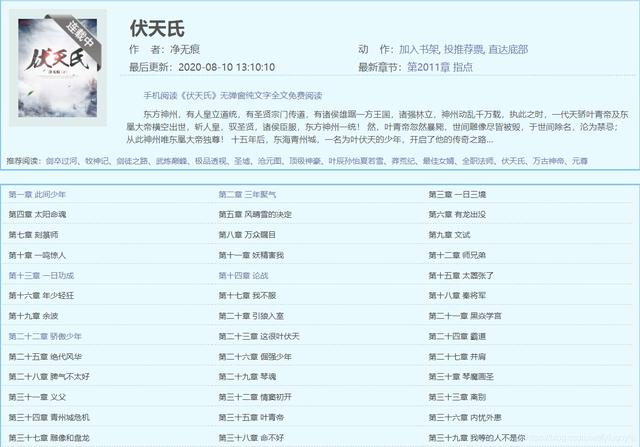
选取其中某一章,检查网页,可以找到这本小说所有章节的链接和名称。
写出xpath表达式提取出href里的内容://div[@id=“list”]/dl/dd/a/@href
分析网页可得,提取出来的内容里每个元素前面应加上 http://www.xbiquge.la 得到的才是是每个章节真正的链接
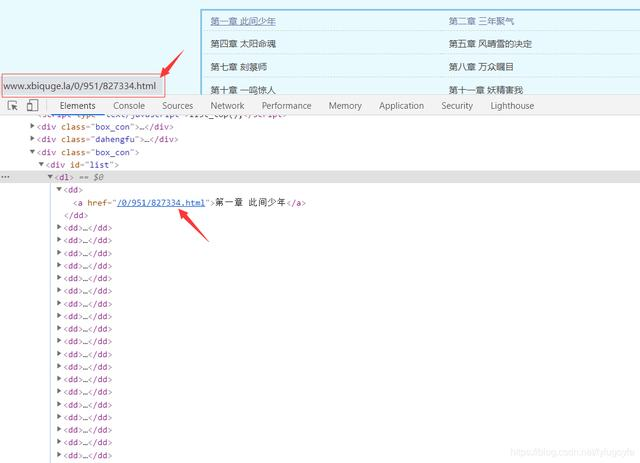

抓取所有章节的链接,代码如下:

def get_urls():
    url = "http://www.xbiquge.la/0/951/"
    response = requests.get(url, headers=headers)
    response.encoding = 'utf-8'
    html = etree.HTML(response.text)
    # 所有章节的url列表
    url_list = ['http://www.xbiquge.la' + x for x in html.xpath('//div[@id="list"]/dl/dd/a/@href')]
    return url_list
12345678
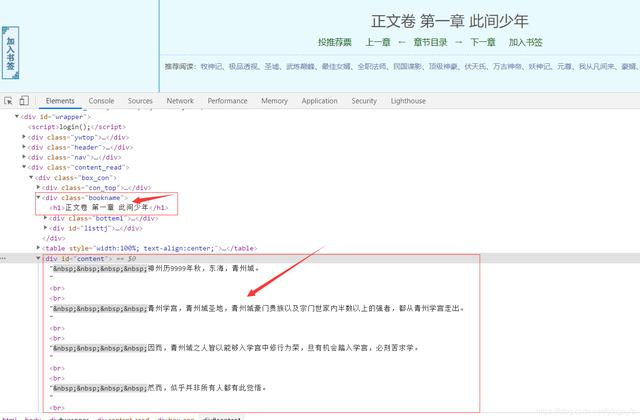
抓取每章的章节名称和内容保存到txt,代码如下:

def get_text(url):
    rep = requests.get(url, headers=headers)
    rep.encoding = 'utf-8'
    dom = etree.HTML(rep.text)
    name = dom.xpath('//div[@class="bookname"]/h1/text()')[0]
    text = dom.xpath('//div[@id="content"]/text()')
    with open(path + f'{name}.txt', 'w', encoding='utf-8') as f:
        for con in text:
            f.write(con)
    print(f'{name} 下载完成')
12345678910

完整代码如下:

import requests
from lxml import etree
import time
import random

path = r'D:\test\伏天氏\ '
headers = {
    "Referer": "http://www.xbiquge.la/0/951/",
    "User-Agent": "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.1 (KHTML, like Gecko) Chrome/21.0.1180.89 Safari/537.1"
}

def get_urls():
    url = "http://www.xbiquge.la/0/951/"
    response = requests.get(url, headers=headers)
    response.encoding = 'utf-8'
    html = etree.HTML(response.text)
    # 所有章节的url列表
    url_list = ['http://www.xbiquge.la' + x for x in html.xpath('//div[@id="list"]/dl/dd/a/@href')]
    return url_list

def get_text(url):
    rep = requests.get(url, headers=headers)
    rep.encoding = 'utf-8'
    dom = etree.HTML(rep.text)
    name = dom.xpath('//div[@class="bookname"]/h1/text()')[0]
    text = dom.xpath('//div[@id="content"]/text()')
    with open(path + f'{name}.txt', 'w', encoding='utf-8') as f:
        for con in text:
            f.write(con)
    print(f'{name} 下载完成')

def main():
    urls = get_urls()
    for url in urls:
        get_text(url)
        time.sleep(random.randint(1, 3))

if __name__ == '__main__':
    main()

运行效果如下:
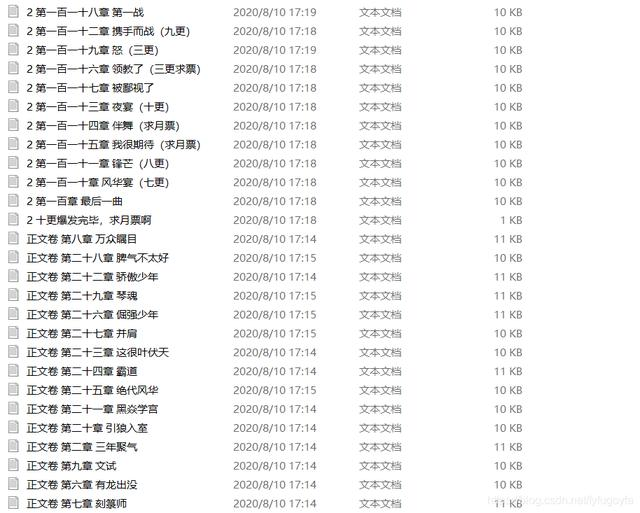

程序运行,小说保存到了txt里。

源码获取记得加群哦:1136192749

利用python爬虫爬取网络小说保存到txt,熟悉利用python抓取文本数据的方法。

以爬取《伏天氏》这本小说的章节内容为例,目标url:http://www.xbiquge.la/0/951/

选取其中某一章,检查网页,可以找到这本小说所有章节的链接和名称。
写出xpath表达式提取出href里的内容://div[@id=“list”]/dl/dd/a/@href
分析网页可得,提取出来的内容里每个元素前面应加上 http://www.xbiquge.la 得到的才是是每个章节真正的链接


抓取所有章节的链接,代码如下:

def get_urls():
    url = "http://www.xbiquge.la/0/951/"
    response = requests.get(url, headers=headers)
    response.encoding = 'utf-8'
    html = etree.HTML(response.text)
    # 所有章节的url列表
    url_list = ['http://www.xbiquge.la' + x for x in html.xpath('//div[@id="list"]/dl/dd/a/@href')]
    return url_list
12345678

抓取每章的章节名称和内容保存到txt,代码如下:

def get_text(url):
    rep = requests.get(url, headers=headers)
    rep.encoding = 'utf-8'
    dom = etree.HTML(rep.text)
    name = dom.xpath('//div[@class="bookname"]/h1/text()')[0]
    text = dom.xpath('//div[@id="content"]/text()')
    with open(path + f'{name}.txt', 'w', encoding='utf-8') as f:
        for con in text:
            f.write(con)
    print(f'{name} 下载完成')
12345678910

完整代码如下:

import requests
from lxml import etree
import time
import random

path = r'D:\test\伏天氏\ '
headers = {
    "Referer": "http://www.xbiquge.la/0/951/",
    "User-Agent": "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.1 (KHTML, like Gecko) Chrome/21.0.1180.89 Safari/537.1"
}

def get_urls():
    url = "http://www.xbiquge.la/0/951/"
    response = requests.get(url, headers=headers)
    response.encoding = 'utf-8'
    html = etree.HTML(response.text)
    # 所有章节的url列表
    url_list = ['http://www.xbiquge.la' + x for x in html.xpath('//div[@id="list"]/dl/dd/a/@href')]
    return url_list

def get_text(url):
    rep = requests.get(url, headers=headers)
    rep.encoding = 'utf-8'
    dom = etree.HTML(rep.text)
    name = dom.xpath('//div[@class="bookname"]/h1/text()')[0]
    text = dom.xpath('//div[@id="content"]/text()')
    with open(path + f'{name}.txt', 'w', encoding='utf-8') as f:
        for con in text:
            f.write(con)
    print(f'{name} 下载完成')

def main():
    urls = get_urls()
    for url in urls:
        get_text(url)
        time.sleep(random.randint(1, 3))

if __name__ == '__main__':
    main()

运行效果如下:


程序运行,小说保存到了txt里。

源码获取记得点击源码

 

Python爬取小说教程详解 免责声明:1、本项目爬取的网站数据仅用于学习交流目的,不用于任何商业用途。2、我们尊重原网站的版权和知识产权,不会对爬取的数据进行任何形式的篡改、传播或用于非法用途。3、爬取行为严格遵守我国相关法律法规,如有侵犯原网站权益,请及时与我们联系,我们将立即停止爬取行为并删除相关数据。4、本项目不对因使用爬取数据导致的任何损失或损害承担责任。5、请使用者遵守本免责声明,如有违反,后果自负。 阅读详情

相关推荐

Python爬虫练习 爬取网络小说保存到txt

利用python爬取网络小说,保存到txt。

叶庭云 成为自己的光 9843

某小说论坛网爬虫演示

如果带着一定的目的去做事,尤其这目的还特别有意思的话,做事效率都会高很多。笔者能说学习爬虫的初衷是是为了更愉快地看小说吗? 长佩是一个笔者特别喜欢逛的小说论坛,但时间久了发现有一些不太方便的地方,比如从目录页跳转到对应的正文后,并不会保留原来的目录页,如果后续看正文看到了20页,想回到刚刚的目录位置,我要不得一直返回,返回20次,要不就凭记忆从主页进去再次回去。再比如所有的文章在目录是动态排列的...

weixin_43850016的博客 5727

从“跳变”到“连续”:深入理解霍尔传感器插值与PLL角度估算的优劣与选择

本文深入解析霍尔传感器角度估算技术,对比线性插值法和锁相环(PLL)跟踪法的优劣,为电机控制领域的工程师提供实用指南。通过STM32F407和CubeMX的实例,详细探讨两种方法的实现细节、性能对比及优化策略,帮助在不同应用场景下做出最优选择。

weixin_30855761的博客 564

再也不用手写爬虫了!推荐5款自动爬取数据的神器!

在进行爬虫活动时,需要遵循伦理规范和法律法规,尊重网站的隐私权和信息所有权。未经授权的爬虫活动可能涉及侵犯隐私、盗取数据等问题,违反相关法律法规可能会面临法律责任。我整理了编程语言Python的学习资料,拿出来和大家分享,有需要的朋友可以扫描下方二维码进行领取哦。

m0_48891301的博客 1万+

ZEMAX学习 6.一个照相物镜的设计

曲线越平滑表示场曲越小,曲线越接近水平,系统边缘与中心对比度越接近,虚实越接近表示色差和色散越好;第1个面设计不合理,出现前后表面相交的情况,点击第1面厚度,选择边缘厚度,设置为0.1,第1面厚度被控制在0.1mm厚,系统根据这一设置始终保持第1面边缘厚度为0.1mm。要求:设计一个照相物镜,焦距f=9mm,F#为4,视场角40°;添加有效焦距操作数EFFL 9mm 权重为1,设置优化变量,如下图,ctrl+shift+o打开优化界面。报告中系统数据有效焦距为67.381mm,设计要求为9mm;

qq_24542783的博客 4715

ESP32+ST7789 LCD屏实战:5分钟搞定中文显示与图片渲染(附完整代码)

本文提供了一份详细的ESP32驱动ST7789 LCD屏幕的实战指南。通过清晰的SPI硬件连接说明、ESP-IDF框架下的初始化代码,以及图片渲染与中文字库构建的核心算法,帮助开发者快速实现中文显示与图片渲染功能,并附有完整的代码示例和性能优化技巧。

weixin_29189377的博客 440

爬取网络图片并保存到本地_Python爬虫练习 爬取网络小说保存到txt,这年头谁还付费看小说啊!...

利用python爬虫爬取网络小说保存到txt,熟悉利用python抓取文本数据的方法。以爬取《伏天氏》这本小说的章节内容为例,目标url:http://www.xbiquge.la/0/951/选取其中某一章,检查网页,可以找到这本小说所有章节的链接和名称。写出xpath表达式提取出href里的内容://div[@id=“list”]/dl/dd/a/@href分析网页可得,提取出来的内容里每个元...

weixin_39747630的博客 154

opencv实践项目-图片拼接之缝合线算法

opencv 图片缝合线算法

wyw0000的博客 2625

手把手爬取小说网站:Python 爬虫保存 txt 文件教程

本文介绍了使用Python爬虫抓取网络小说并保存为txt文件的方法。首先需要安装Python环境和requests、BeautifulSoup4库,选择目标小说网站并遵守版权规定。核心步骤包括:获取章节列表、提取章节内容、保存到本地文件。代码示例展示了如何实现这些功能,并提供了解决乱码、反爬等常见问题的方案。特别强调需遵守robots.txt协议,控制爬取速度,仅用于学习交流,避免爬取付费或受版权保护的内容。

weixin_41943766的博客 7170

实战:GMTSAR软件处理陆探一号SAR数据

摘要:陆探一号(LT-1)是我国首组L波段差分干涉SAR卫星星座,具备全天候多极化成像能力,主要服务于自然资源监测等领域。文章详细介绍了其轨道参数(607km太阳同步轨道)和传感器技术指标(5种成像模式)。同时阐述了开源InSAR处理软件GMTSAR的安装方法(基于Ubuntu系统)及实验流程,包括数据准备、DEM生成和干涉处理步骤,特别说明了轨道数据缺失时的MATLAB插值处理方法。该研究为国产SAR卫星数据处理提供了技术参考。

一个RSer的博客 1036

语音识别:PyAudio、SoundDevice、Vosk、openai-whisper、Argos-Translate、FunASR(Python)

本文介绍了Python中常用的音频处理库PyAudio,详细解析了其核心功能、核心概念和典型工作流程。PyAudio是一个跨平台的音频I/O库,支持音频录制、播放、实时流处理和低延迟操作。核心概念包括PyAudio类(管理音频设备和流)和Stream类(代表音频流)。文章重点讲解了open()方法的关键参数、回调函数的使用方式以及典型的工作流程,包括设备查询、流配置和资源释放。PyAudio适用于需要实时音频处理的场景,如语音识别和音频效果处理。

算法工程师 706

零基础也能玩转!Python爬虫抓取网络小说全攻略(附实战代码)

虽然技术无罪,但使用需谨慎!建议从学习角度出发,不要用于商业用途。遇到付费内容请支持正版,好的创作环境需要大家共同维护~(注:本文示例代码需替换真实网址后使用,仅供学习交流)

notion2025的博客 1453

国科大学习资料--机器人智能控制_袁如意老师PPT后习题答案(学长精心整理)

人工神经元激活函数的作用是什么? 答:激活函数是用来加入非线性因素的,提高神经网络对模型的表达能力,解决线性模型所不能解决的问题。 人工神经网络的学习规则有哪些?各有何特征? 答:大类可以分为无监督学习算法、有监督学习算法和强化学习。其中无监督学习算法指只有输入信息,没有期望的输出信息,如Hebb学习规则,神经元连接强度的变化与两个相互连接的神经元的激活水平成正比。竞争学习法则:网络各输出单元相互竞争,最后达到只有一个最强者激活。有监督学习算法指同时提供输入信息和对应的期望输出信息,如误差学习(Delta学

无名何许人的博客 1488

爬虫:阿里小说网所有小说的内容爬取并保存到本地文件

1.我的目的 爬取阿里小说网所有小说的内容,每本小说保存进不同的txt文件,txt文件以小说名命名 2.分析过程 1.书库的请求是一个普通get请求,我们解析页面可以得到每本书的id,而页码通过url的page=?来控制(https://www.aliwx.com.cn/store?spm=aliwx.list_store.0.0.345d34d4zMOmk9&page=) 2.有了小...

shwwns的博客 1741

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

使用python爬取斗破苍穹小说网

使用python爬取斗破苍穹小说网,学会了以后就不用去看付费的小说了不多bb直接上源码 import requests from bs4 import BeautifulSoup def file(): response=requests.get('http://www.tycqxs.com/57_57672/') response.encoding=response.apparent_encoding soup=BeautifulSoup(response.text,'html.

qinqi100233的博客 2812

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

Python多线程爬虫实战:批量下载网络小说并实现断点续传

网络爬虫技术是自动化获取互联网公开数据的核心方法,其基本原理是通过程序模拟浏览器行为向目标服务器发送HTTP请求,并解析返回的HTML文档以提取结构化信息。在数据采集场景中,面对海量页面抓取任务时,单线程串行请求往往效率低下,此时引入多线程并发技术能显著提升I/O密集型任务的执行速度。Python生态中的requests库提供了简洁的HTTP客户端接口,配合lxml或BeautifulSoup等HTML解析工具,可以快速构建网页内容提取逻辑。而concurrent.futures模块的ThreadPoolE

weixin_33997389的博客 431

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

AI 赋能的 Python 超强爬虫:crawl4ai 框架助力异步高并发与断点续传

本项目以“高效、健壮、易扩展”为核心原则,针对大规模网络小说分章节采集的实际需求,设计了一套异步驱动、分批并发、断点可续的爬虫架构。核心流程高度解耦:采集流程、异常处理、文件存储、进度管理均为独立函数和模块,利于维护与复用。并发与批量控制灵活:采用信号量与任务分组,有效兼顾性能与目标网站友好性。进度状态与正文数据分离存储:方便断点恢复和多任务管理。采集与输出顺序严格保证:保证章节数据一致性。│ 章节URL生成 │ ==> │ 异步采集任务池 │ ==> │ 批量写入输出 │▲ │。

不当牛马,每天进步一点点。 3052

Python小说爬虫实战:从架构设计到反爬应对的工程化指南

网络爬虫作为数据采集的核心技术,其原理是通过模拟浏览器行为自动抓取并解析网页数据。这项技术的价值在于能够高效、自动化地获取公开网络信息,广泛应用于搜索引擎、数据分析、价格监控和内容聚合等场景。在Python生态中,requests和BeautifulSoup4是构建基础爬虫的热门工具组合,它们简化了HTTP请求和HTML解析过程。然而,面对现代网站的反爬机制,一个健壮的爬虫项目需要从工程化角度进行架构设计,涵盖调度、去重、存储和异常处理等模块。本文以构建一个小说网站爬虫为例,深入探讨了如何利用异步并发提升效

weixin_33904756的博客 415

python采集文章_python学习基础之信息采集

今天在网上看了一部小说,明明是很早以前的小说,换个名字,居然要付费了,很不开心;通过强大的百度,我找到了原始版本,本来很开心了,奈何不能下载,眼睛很辛苦,我本意是下下来拿到手机上朗读的,没办法只能自己动手采集下来了;import urllib.requestimport re啥也不说,先把需要的包给列出来。我们的命名尽量用规范化操作,这样自己养成好习惯,别人看起来也容易理解;业内管这玩意叫驼峰命名...

weixin_39598135的博客 236

Python爬虫实战:动态网页数据抓取与反爬策略解析

网络爬虫作为数据采集的核心技术,其工作原理是通过模拟浏览器行为向服务器发送HTTP请求并解析响应内容,从而自动化获取网页信息。这项技术的价值在于能够高效处理大规模数据采集任务,广泛应用于市场分析、舆情监控和学术研究等领域。在实际工程实践中,动态网页渲染和反爬机制是常见挑战,需要结合具体工具和策略应对。例如,针对JavaScript动态加载的内容,开发者可以分析网络请求中的XHR接口或使用Selenium等浏览器自动化工具;对于反爬措施,则需要通过设置合理的请求头、控制访问频率和使用代理IP池等方式进行规避。

weixin_33861800的博客 432

技术人如何构建自主可控的小说阅读体系:数据主权与书源生态解析

在数字化阅读时代,数据主权与内容可控性成为技术型用户的核心关切。从技术原理上看,现代阅读应用通常基于客户端-服务器架构,通过本地数据库(如SQLite)与云端同步机制管理用户数据。其技术价值在于平衡用户体验与数据自主权,而开放的书源生态则通过解耦内容获取规则(如JSON/JS配置文件)与应用核心,实现了内容的可持续性。在应用场景上,这尤其适合需要管理本地书库、重视笔记导出、并追求跨设备同步灵活性的开发者与囤书党。本文聚焦于开源阅读等工具,深入探讨如何通过WebDAV同步与自定义书源配置,构建一个数据自主、生

weixin_34342992的博客 507

Python爬虫系列:爬取小说并写入txt文件

导语: 哈喽,哈喽~都说手机自带的浏览器是看小说最好的一个APP,不须要下载任何软件,直接百度就ok了。 但是小编还是想说,如果没有网,度娘还是度娘吗?能把小说下载成一个.txt文件看不是更香吗?这能难倒小编吗?坚决不能滴。于是乎,自己动手丰衣足食,Python就是万能的好吧。 概要: 程序语言:python 第三方库:requests,parsel 数据解析方式:css/xpath 爬取网站:笔趣阁(以天蚕土豆的《斗破苍穹》为例) 代码部分展示: # 导..

a55656aq的博客 1万+
上一篇: python爬取图片(根据用户需求输入想爬取的内容及页数)!
下一篇: Python描述数据结构之并查集实战篇
pythonlaodi
博客等级 码龄6年 286粉丝 244原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值