


做RAG(检索增强生成)的人,大多都经历过一个阶段:把文档丢进来,分块、嵌入、进向量库,然后就开始期待“只要检索到相关块,大模型就能答得很好”。
结果呢?同样一份资料,有时回答惊艳,有时又像没看见一样;你明明“建立了索引”,却总觉得“检索不出东西”。
这里面常见的一个误解是:
“建立索引”=“检索同一份文档”。
但事实是:索引 ≠ 检索。
索引是你为“更容易被找到”而设计出来的结构;检索只是用查询去触发这个结构,把最有价值的信息拉出来。
更关键的一点在于:索引里存的内容,和最终喂给大模型的内容,可以不是同一份东西。
你完全可以用“更适合匹配”的表示去建索引,然后在召回之后再把“更完整的原文上下文”送进大模型。
这也是RAG从“能跑”到“能用”、再到“好用”的分水岭:索引要开始变聪明。

一、索引为何需要“智能化”?
最原始的分块检索,本质上是在赌两件事:
1)你的切块刚好切在合适的位置
2)用户的提问刚好和块里的语义表达方式匹配
现实往往不这么配合,于是就会遇到三类典型问题:
- 文本噪声:块里夹杂了大量无关信息(背景、套话、例子、冗余描述),相似度看起来高,但真正答案只占一小段。
- 信息割裂:块切得太碎,关键上下文散落在多个块里,召回一个不够用,召回多个又容易超上下文或引入干扰。
- 语义匹配偏差:用户问法和原文表述差异很大,比如用户问“怎么申请补贴”,原文写“补助发放流程”,向量相似度未必能稳稳对上。
智能化索引想解决的核心目标只有一个:
在“召回率”与“上下文完整性”之间找到更好的平衡,让RAG整体效果更稳、更准、更可控。
二、四大智能索引方法详解
下面这四种方法,可以理解为从“直接存原文”到“设计索引结构”的四个台阶。它们并不互斥,很多场景甚至是组合拳更好用。
1)分块索引:经典,但不够精细

这是大家最熟的做法:
文档 → 分块 → 嵌入 → 向量存储
适用场景很明确:
结构清晰、内容连贯的通用文档,比如产品介绍、制度说明、操作手册的章节型内容。
它的问题也很典型:
- 块太大:噪声多,检索命中但答案不集中,模型容易“读错重点”。
- 块太小:信息碎片化,模型缺上下文容易答不完整,甚至出现看似合理但实际偏题的补全。
所以,分块索引是起点,但很难成为终点。只要你的内容稍微复杂一点,就会开始“靠调参续命”:调chunk大小、调overlap、调topK……效果仍然不稳定。
2)子块索引:细粒度召回,完整上下文返回
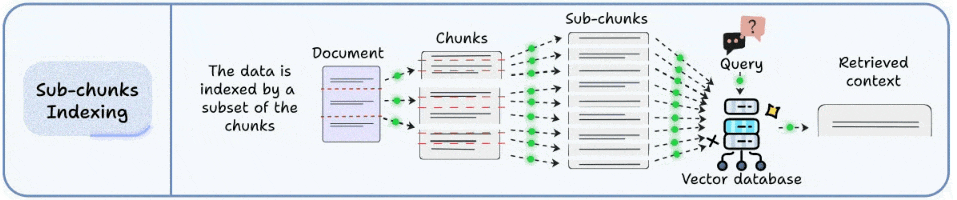
子块索引是对“切块两难”的一个很实用的解法:
让索引用更细的颗粒度去匹配,让返回给模型的上下文保持更完整。
做法可以概括为:
原始块(父块) → 进一步拆分成子块 → 对子块建索引 → 召回子块时返回父块
你可以把它想象成:
“用放大镜找位置,用整页纸给模型看。”
优势非常直接:
- 匹配更准:子块更聚焦,语义向量更干净。
- 上下文更完整:返回父块时,模型能看到必要的前因后果,不容易断章取义。
适用场景:
同一段落里包含多个主题、多个条件、多个例外情况的长文档(比如政策条款、流程说明、FAQ合集、技术设计文档的长段落)。
需要注意的点:
你要维护父子块映射关系;并且父块也别无限大,否则又把噪声带回来了。一般建议父块是“可读的一屏上下文”,子块是“可精准命中的句群/小段”。
3)查询索引:用“问题”代替“原文”匹配
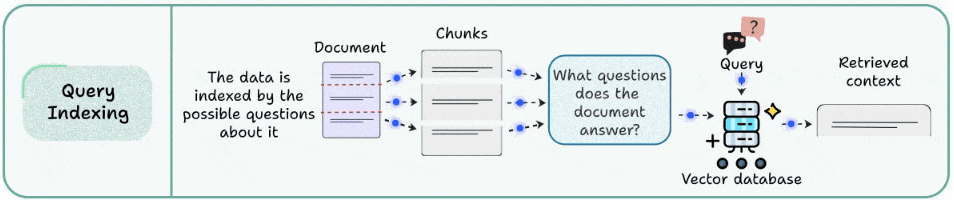
很多检索不准,不是内容没写,而是写法不一样。用户不会按文档语言去提问,他们更像在“说人话”。
查询索引的思路是:
别让用户的提问去硬碰原文,让原文先变成“可能被问到的问题”。
做法是:
为每个文本块生成若干“假设性问题” → 对这些问题建索引 → 用户查询匹配到问题 → 返回对应原文块
核心逻辑:
把检索空间从“文档表达”转成“用户提问表达”。这一步往往能显著改善问答类系统的召回。
它和HyDE(Hypothetical Document Embeddings)的区别也值得一提:
- 查询索引:你为每个块提前生成“问题”,索引存的是问题向量,查询时找最像的问题。
- HyDE:查询时先生成“假设答案/假设文档”,再用这个生成内容去向量检索原文,更像是在查询侧做增强。
两者都在解决“问法和写法不一致”的问题,只是一个是离线建索引,一个是在线增强查询。实际落地时,查询索引更适合稳定、可控的知识库(尤其客服/内部FAQ),HyDE更适合开放问题、查询多变的场景,但要注意成本与时延。
最佳场景:
问答系统、客服知识库、内部制度查询、IT支持台——凡是用户问题高度口语化、文档语言偏正式的地方,都值得试。
4)摘要索引:语义浓缩,增强表征
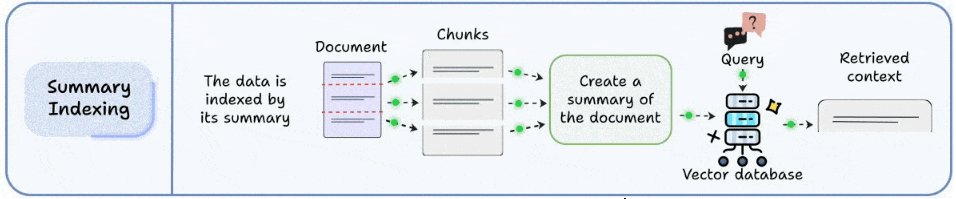
还有一种“检索老大难”是:内容非常密集或结构化,原文向量不好表示。
典型例子:表格、列表、报表、对照项、研究数据、指标说明……这些东西用原文做embedding,常常会出现“每行都像、又都不像”的尴尬。
摘要索引的做法是:
文本块 → 生成摘要 → 对摘要建索引 → 召回时返回原文
好处在于:
摘要把核心语义浓缩出来,向量表示更稳定、更可检索;而最终给模型的仍然是原文,这样不牺牲细节。
典型用例:
财务/经营报表检索、研究数据检索、结构化内容检索、长列表规则(例如权限清单、价格表、接口字段说明)等。
需要注意:
摘要必须保证语义准确,尤其是数字、条件、限制条款不能“总结丢了”。实践里建议摘要模板固定化(比如“适用范围/关键条件/结论/例外”),并对数字字段做保留策略。
三、方法对比与选择建议
为了方便你快速对号入座,这里给一个简单的选择表:
方法:分块索引
核心思路:原文直接分块建索引
适用场景:通用文档检索
注意事项:谨慎控制块大小与overlap,避免噪声或碎片化
方法:子块索引
核心思路:细粒度索引,粗粒度返回
适用场景:长文本、多主题段落
注意事项:维护父子映射;父块控制“可读”范围
方法:查询索引
核心思路:用“问题”表征原文
适用场景:问答系统、交互式检索、客服知识库
注意事项:依赖生成问题的质量;问题覆盖要足够全面
方法:摘要索引
核心思路:用“摘要”表征原文
适用场景:结构化/密集数据(表格、列表、报表)
注意事项:摘要要保真,特别是数字/条件/例外项
四、实战:怎么从0到1把索引做“聪明”?
如果你现在的RAG还在“分块→向量→topK”,建议别一下子把系统推倒重来。更现实的路径是循序渐进:
第一步:先把分块索引跑稳
把最基础的检索-生成链路跑通,确保评估方式清楚:你要衡量的是最终任务效果(回答准确率、引用正确率、可追溯性、时延、成本),而不是单纯的相似度分数。
第二步:内容一复杂就上子块
你一旦发现“命中不准但其实文档里有”,或者“模型回答总缺关键条件”,子块索引往往是性价比最高的增强手段:更准的召回 + 更完整的上下文,一般立竿见影。
第三步:问答类场景优先试查询索引
客服、制度、流程、IT支持这类问题,非常适合用“问题索引”把检索对齐到用户语言。很多团队做到这里,检索的“体感稳定性”会明显提升。
第四步:遇到表格/列表就考虑摘要索引
结构化内容别硬向量化原文,先做摘要再索引,召回更稳定,模型读原文时也更有抓手。
最后:允许混合索引
现实业务往往内容混杂,一套索引策略吃遍天下很难。常见组合包括:
- 摘要 + 子块:摘要负责“找得准”,子块负责“定位精”,返回再给父块保证上下文。
- 查询索引 + 分块索引双路召回:一条对齐用户问法,一条兜底原文语义,相互补位。
无论怎么玩,唯一的裁判永远是终端任务效果。索引策略不是“越复杂越高级”,而是“越贴合业务越有效”。
五、总结
索引不是“把文档直接存进去”,而是“为检索这件事专门设计出来的”。
在RAG里,索引阶段多走一步,检索效果往往就能前进一大步。
如果你还停留在“原文=索引”的定式思维,不妨从这四种进阶玩法里挑一个最贴近你业务痛点的开始试:
先让索引变聪明,再让生成变靠谱。
想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!
👇👇扫码免费领取全部内容👇👇

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势
想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:
1. 100+本大模型方向电子书

2. 26 份行业研究报告:覆盖多领域实践与趋势
报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

- 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
- 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
- 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
- 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。
3. 600+套技术大会 PPT:听行业大咖讲实战
PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

- 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
- 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
- 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
- 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。
二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走
想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位
面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点
针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题
专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:

三、路线必明: AI 大模型学习路线图,1 张图理清核心内容
刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

L5阶段:专题集丨特训篇 【录播课】

四、资料领取:全套内容免费抱走,学 AI 不用再找第二份
不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:
👇👇扫码免费领取全部内容👇👇
2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!
 506


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


