


很多人想象的AI知识库就是把所有的资料一键导入到AI客户端,比如Cherry Studio里面,然后AI就能把里面的内容全部认真地读一遍,最后生成一个完美的结论。然而,在实际体验以后,很多人会发现AI知识库的效果并没有想象中的那么好,还是会遇到各种奇怪的问题。那它的根源就在于我们误解了AI知识库的工作原理。我们将从以下四个角度出发,给大家深入剖析当前主流的AI系统的三大问题。
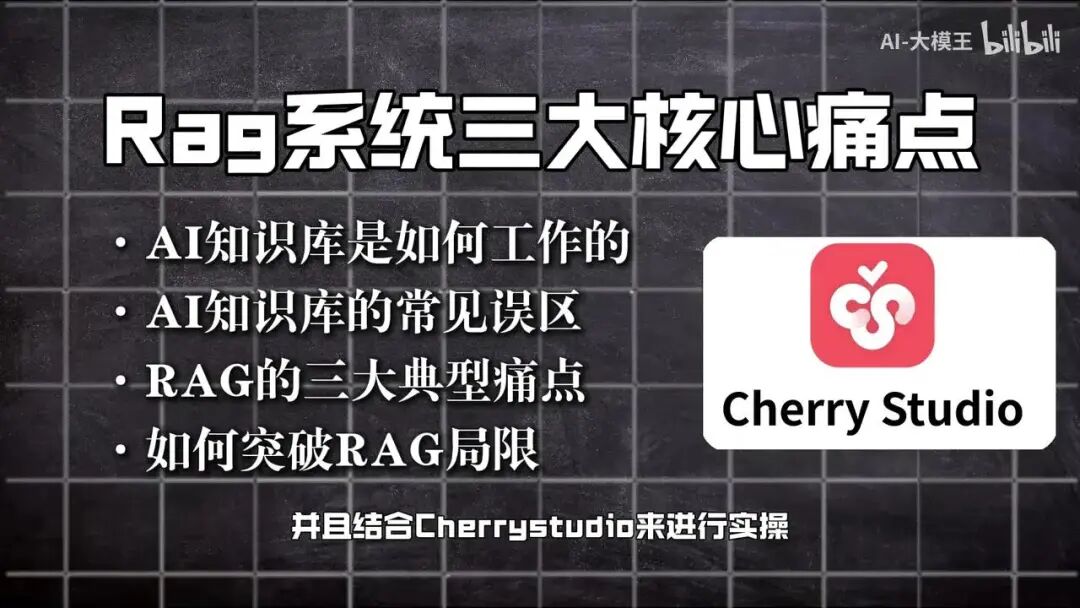
核心痛点,并且结合Cherry Studio来进行实操,给大家讲几种有效的进阶优化方案。
目前,大模型知识库最常用的方法就是我们的RAG,也叫做检索增强生成。RAG的核心内容其实只有两个部分:
第一个部分是我们先从资料库当中检索相关的内容,然后模型再基于这些内容生成答案。也就是先检索再生成,所以叫做检索增强生成。
当我们有一部分业务数据之后,需要把这些数据添加到知识库。通过程序将其进行文本块的拆分,然后通过嵌入模型把这些文本块向量化。向量化指的是把文本变成一堆数字,存储到向量数据库里。
接下来用户开始提问时,问题本身不会直接给到大模型,而是会经过向量转换。然后我们来到向量数据库,把问题和原始内容进行相似度匹配。这个匹配过程是基于向量的数学运算,比如可以用余弦相似度。
匹配完成后,我们就能得到一部分相关的原文片段。然后把这些片段结合用户的问题,构造一个prompt提示模板,一起发送给大模型。大模型最后针对这个问题进行总结,返回给用户。
从这个流程可以看出,在RAG流程当中,大模型仅仅起到归纳总结的作用。回答效果的好坏很大程度上取决于文本块的检索精度。事实上,RAG系统也存在三个典型问题:
第一个问题是我们的文本切片过于粗暴。
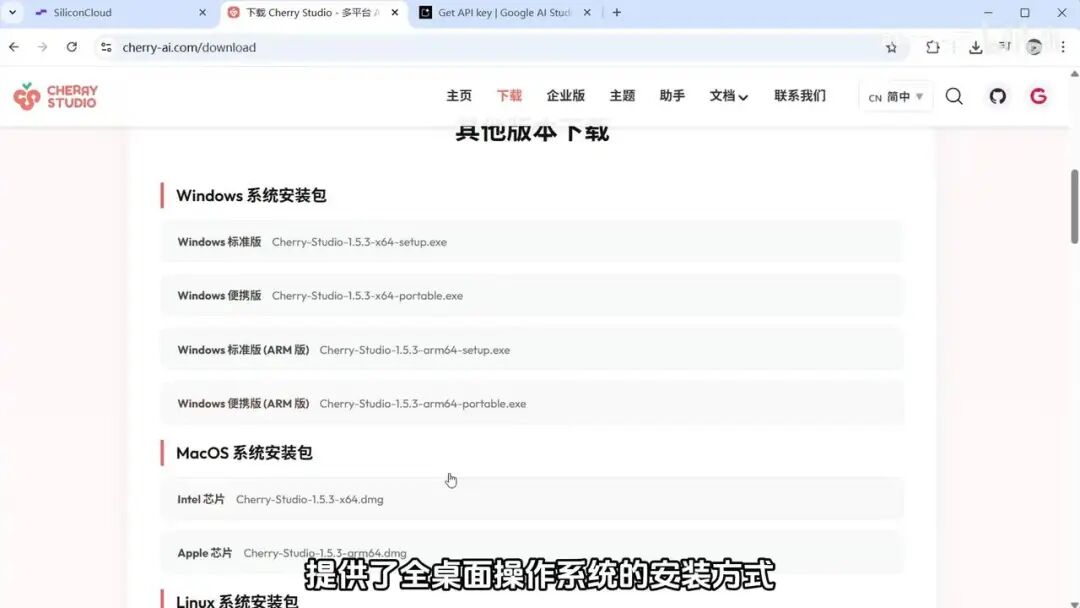
第二个检索不够精准,第三个没有大局观,缺乏全局的视角。接下来我们先用 Cherry Studio 搭建一个本地知识库,然后再分析这一套流程的局限性。好,下面我们来到 Cherry Studio 官网,先把软件下载并安装一下。
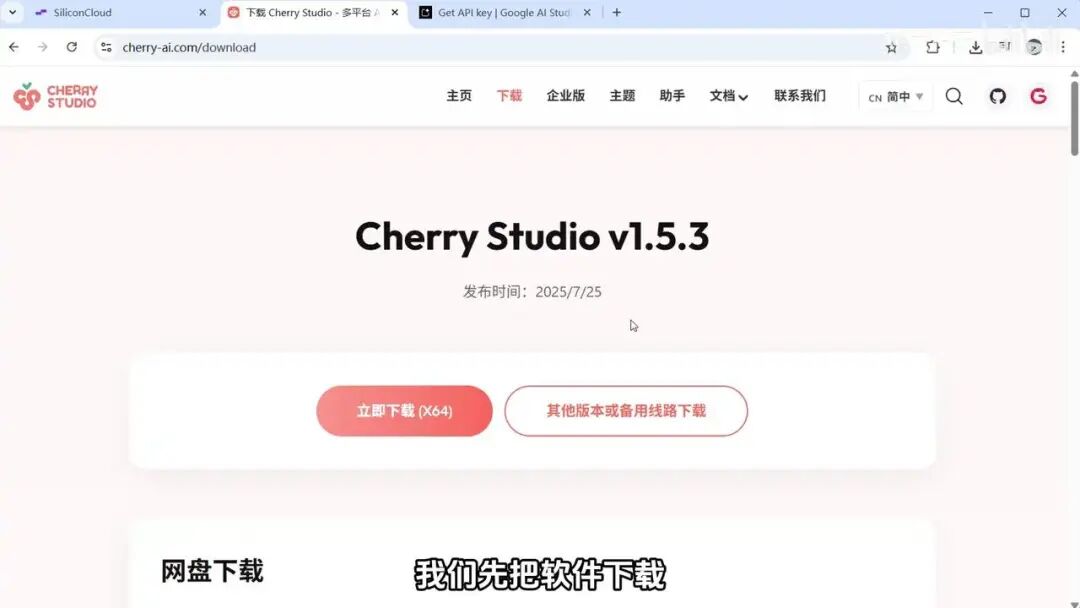
那Cherry Studio的话,它提供了全桌面操作系统的安装方式,安装过程也十分简单。下载安装包之后,一路点击下一步就可以了。
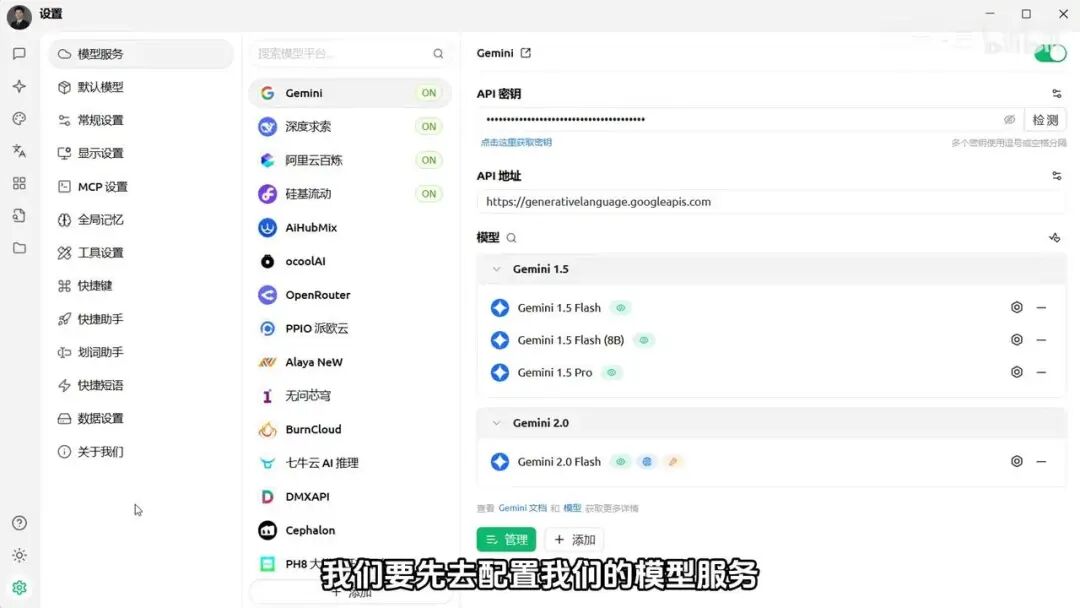
然后接下来我们打开软件,Cherry Studio。然后我们可以在左下角找到这个设置。
那第一步的话,我们要先去配置我们的模型服务,也就是我们的大模型,你要用哪一个。
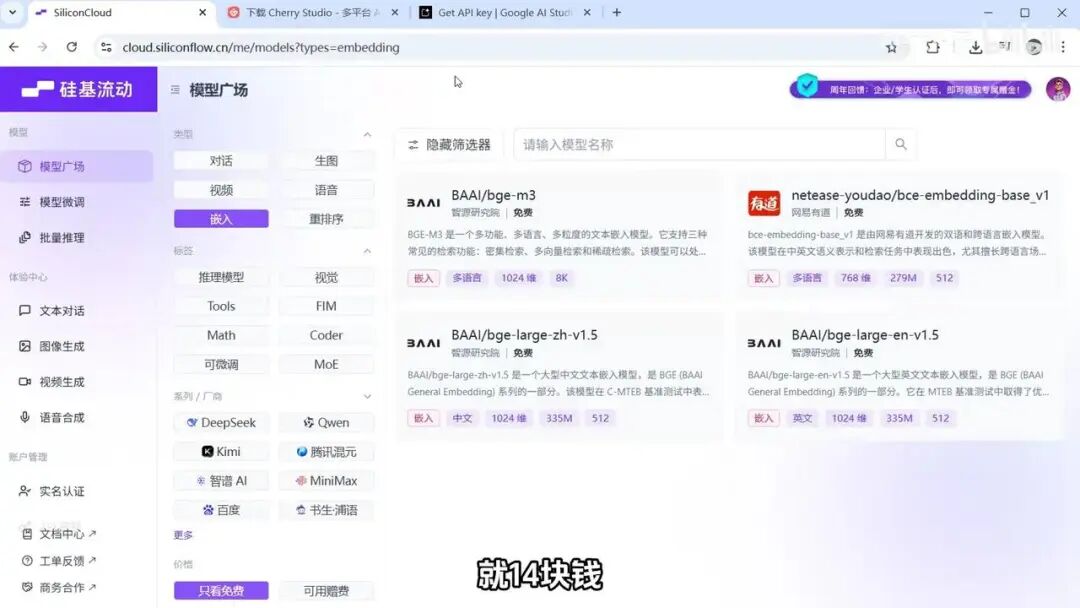
那么在这里,我们直接选择硅基流动。硅基流动需要我们有一个API密钥,所以我们可以来到硅基流动的官网。硅基流动给我们提供了一个免费额度,就是14块钱。
那你注册完之后,就能够去领取。然后我们可以看到这个余额。
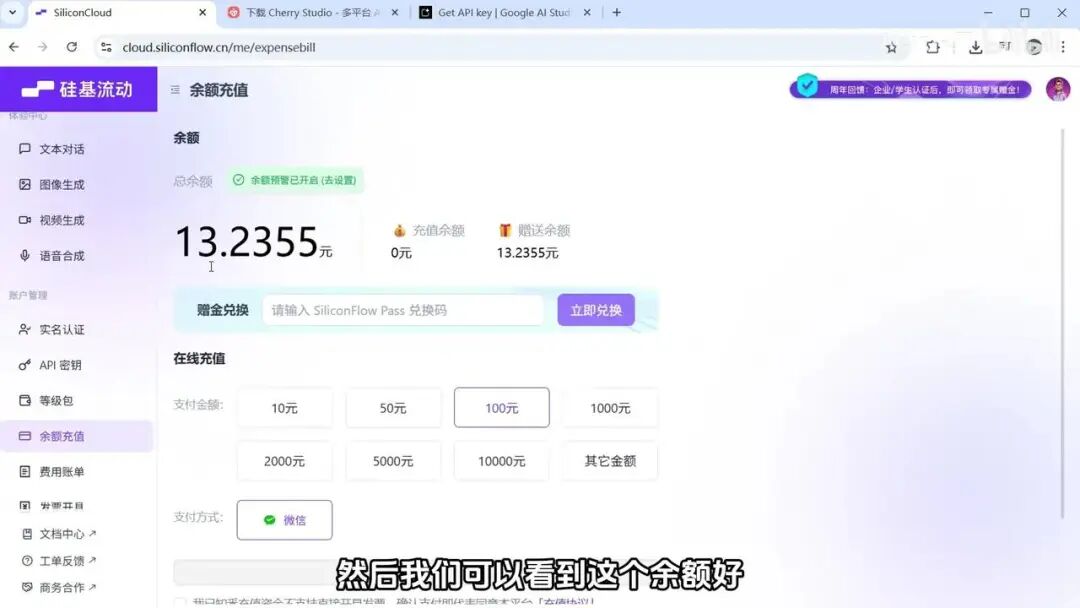
好,大概是14块钱的一个样子。来到硅基流动之后,我们首先先来做一个API的密钥。
那大家如果说没有的话,可以直接去新建一个,然后把API密钥复制到我们的窗口中来,填进去就可以了。
好,那么API的密钥设置好之后,接下来我们去选择要使用的模型。点击模型广场,在这里你就可以选择想要用的模型。
当然有很多都是付费的,我们也可以选择免费的模型。比如这里就有一些免费的模型,比如咱们的千问3-8B,这个我们可以去用。
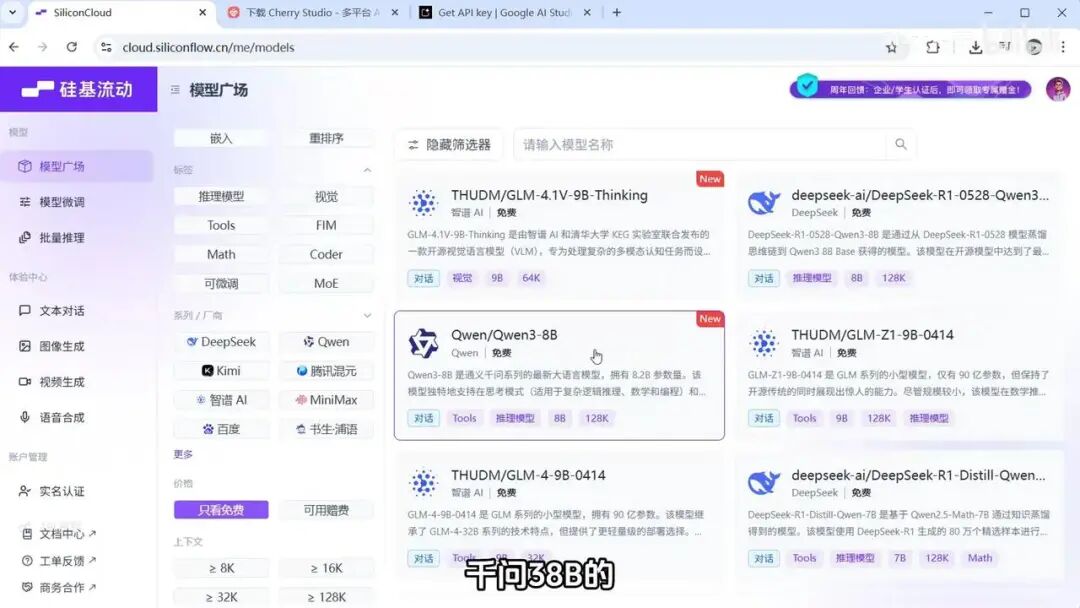
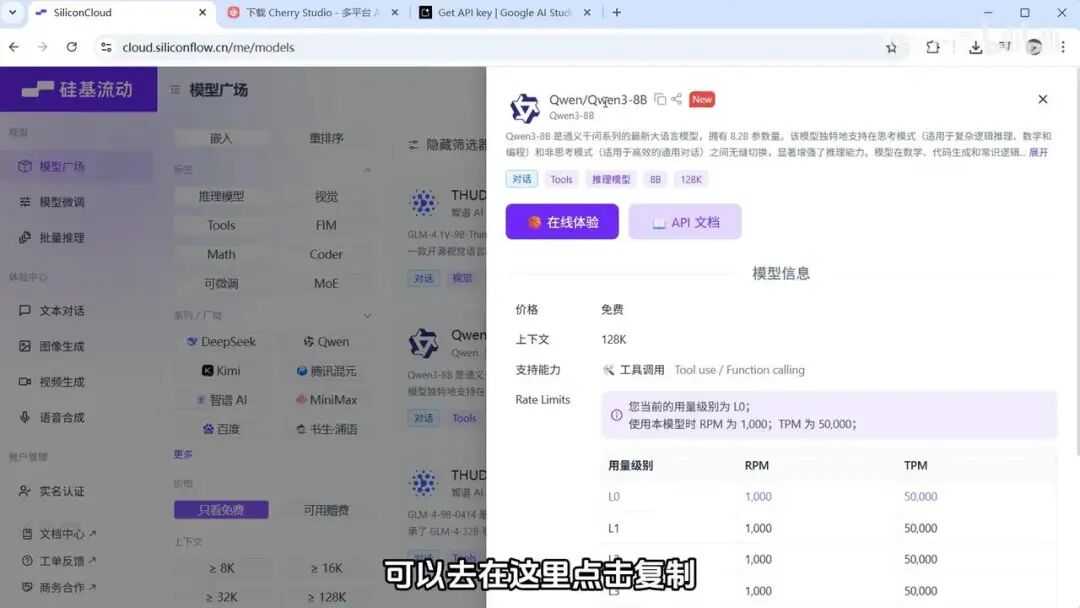
用这个怎么去添加呢?很简单,你点击一个模型之后,可以在这里点击复制它的名字。
然后我们在下面有一个添加按钮,点击添加,把复制的名字填进来,添加模型就可以了。
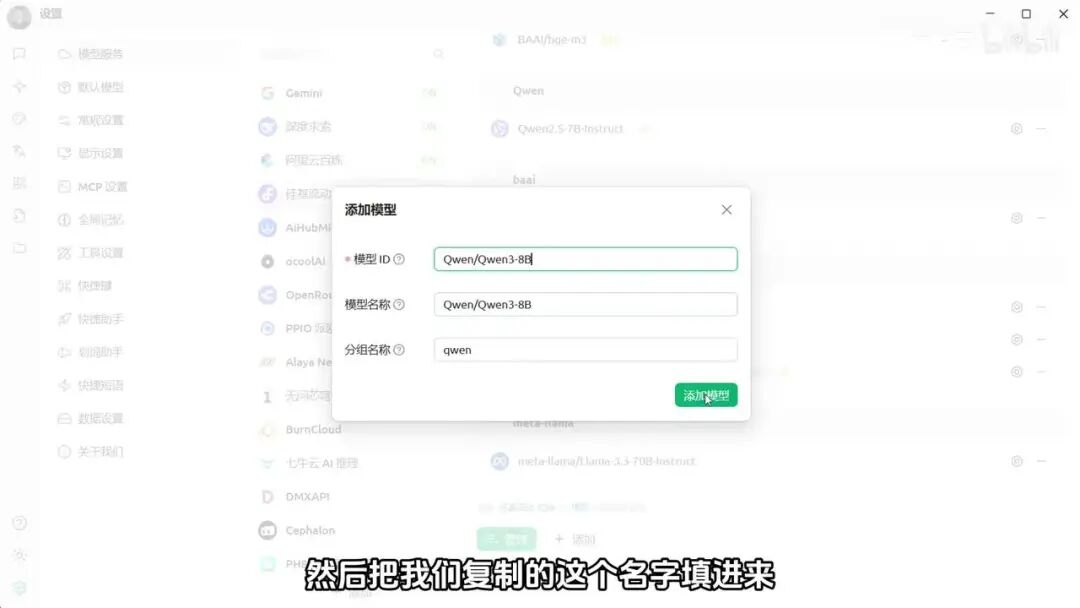
那这个模型。
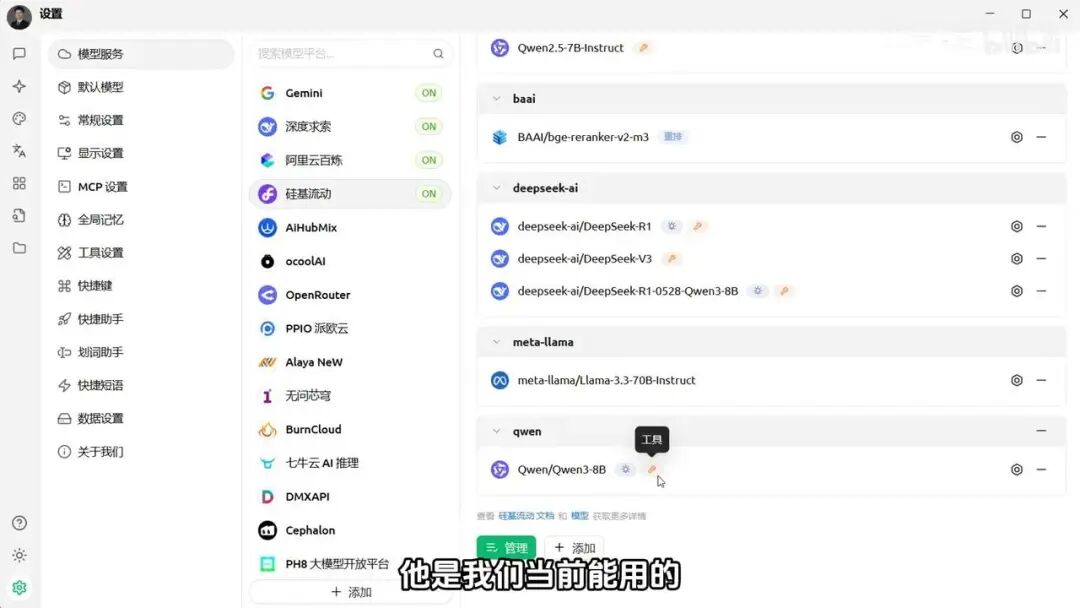
它表示当前可用的模型。如果你不确定,也可以进行检测。点击检测后,选择我们刚刚添加的Qwen3-8B模型,然后点击确定。
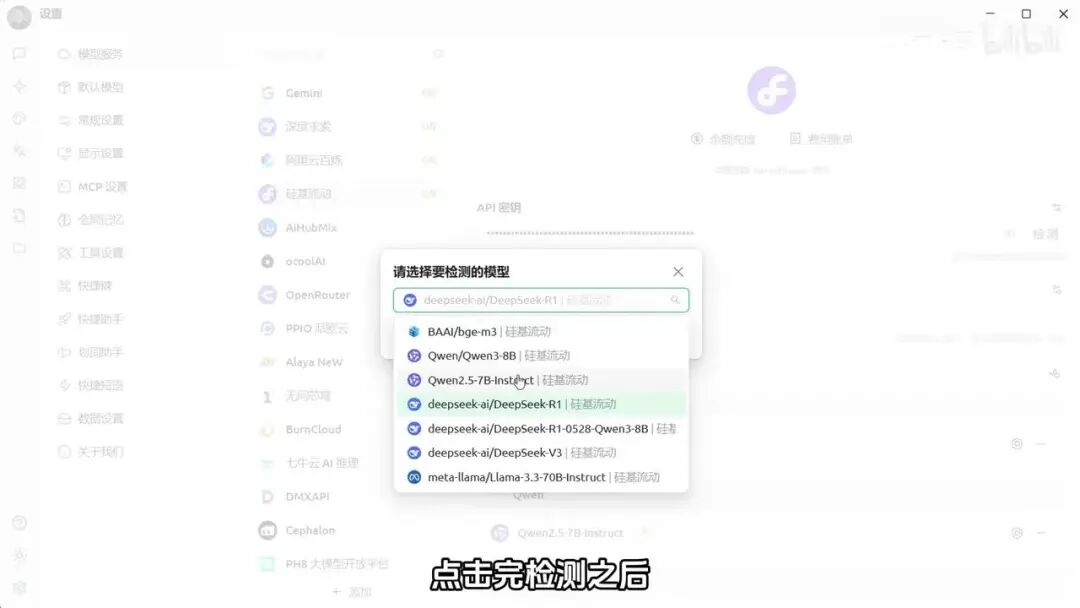
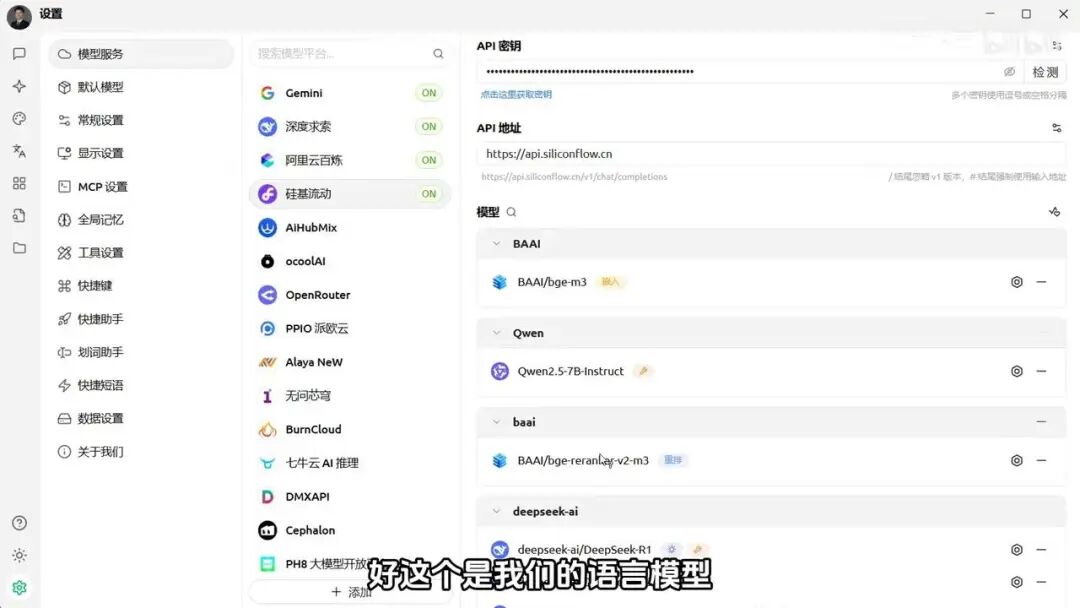
那么,他会告诉你连接成功,说明是没有问题的。好,这个是我们的语言模型。
那接下来我们还需要一个对于文本。
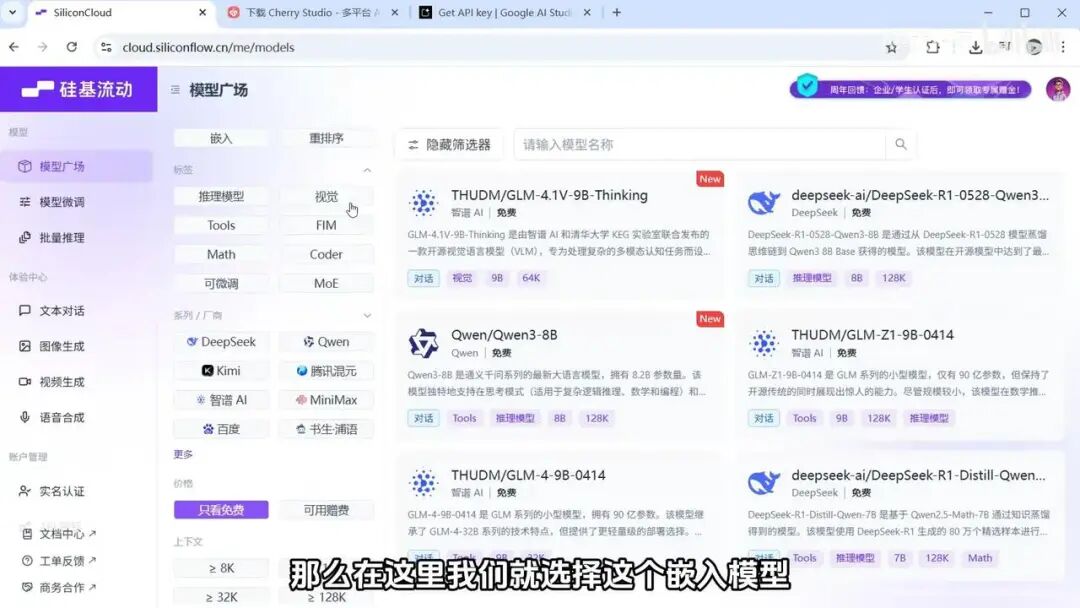
来进行这个嵌入,这个向量化的embedding模型。那么在这地方我们就选择这个嵌入模型,然后免费的,它会有一个GLM-3的。
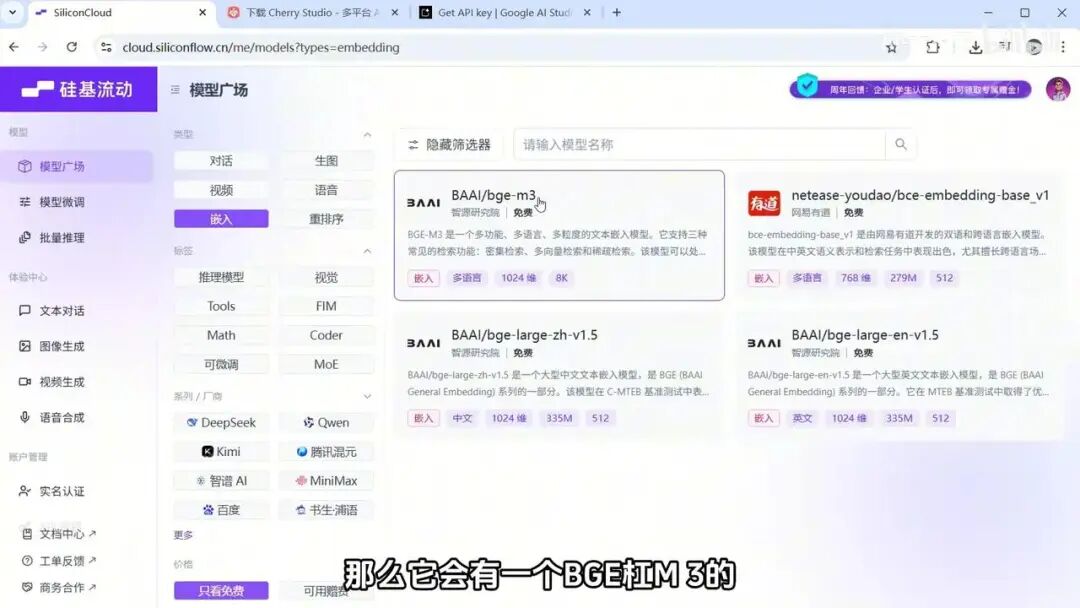
那么同样的也是复制它这个名字。
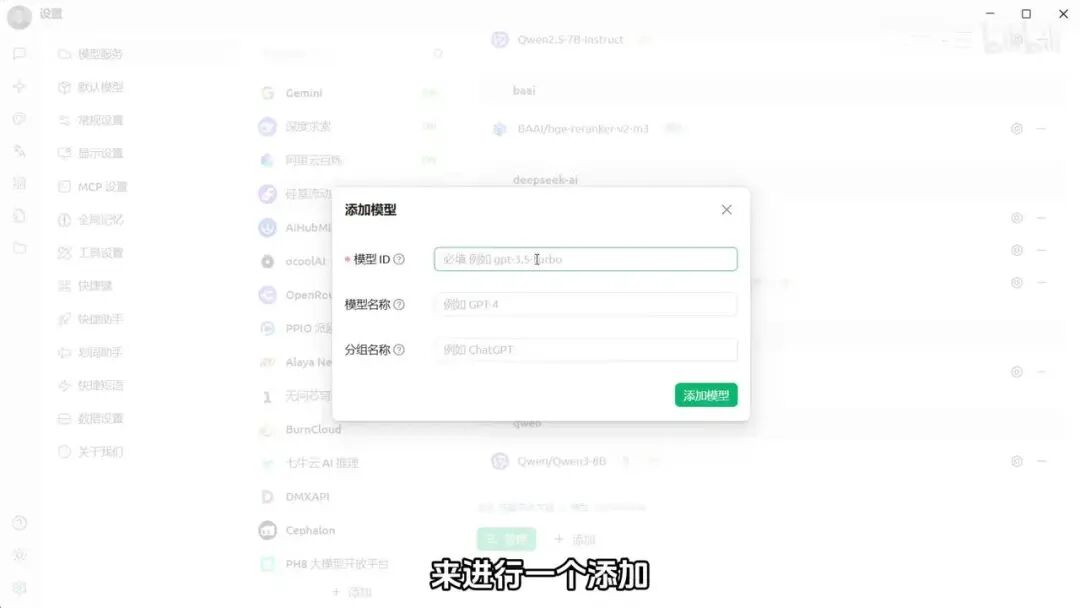
然后在这个地方按照同样的方法进行添加就可以了。这边我已经存在了,就不重复添加了。这就是我们关于模型的一些基本设置。
接下来我们开始配置知识库。点击知识库按钮后,可以选择添加,然后随便取一个名字。比如我要对一本小说进行测试,取名为凡人修仙传,然后选择嵌入模型BGE-M3,点击确定。
确定完成后,我们就可以把文件添加到知识库了。在这里我选择的文件其实就是我们的章节。
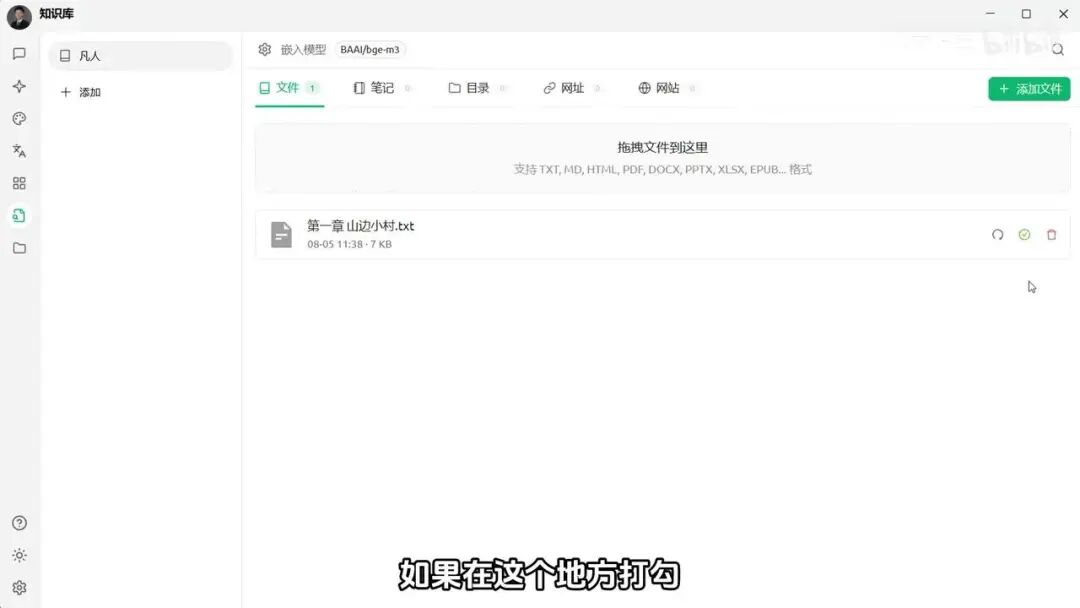
好,添加完成之后,如果在这地方打勾,说明它已经被成功分片并存入向量数据库。接下来我们可以点击搜索来查找对应内容。比如在这里,我可以搜索一个行例,那么它就会出现相对应的文本片段。
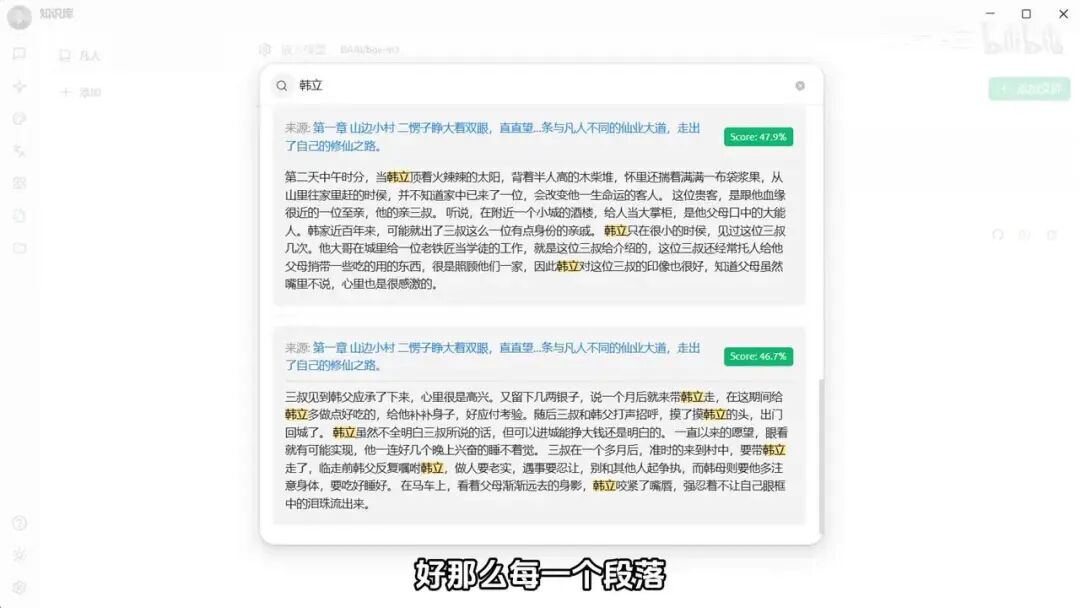
好,那么每一个段落大概在300个字左右。
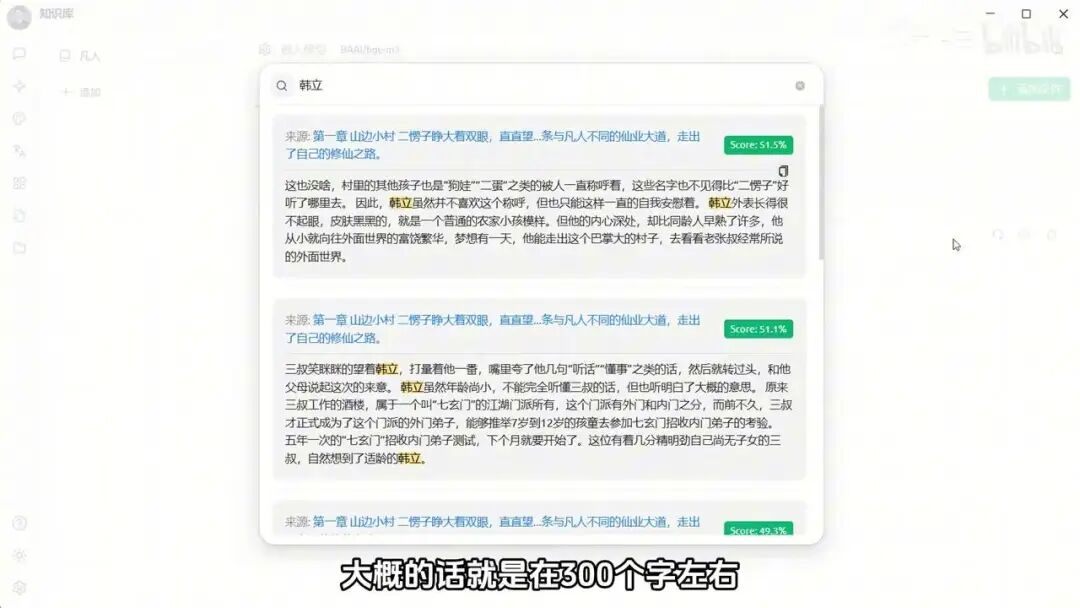
Cherry Studio这里使用的分块算法是LongChain的递归文本分割。这种分块方法比较简单粗暴,基本上等同于按照文章的段落来进行分块。如果段落过长,它会按照固定的字数进行分块。
所以很多句子可能会被拦腰截断,造成语义的割裂。在这个地方,我们其实也可以去设置,比如我们可以打开这个。
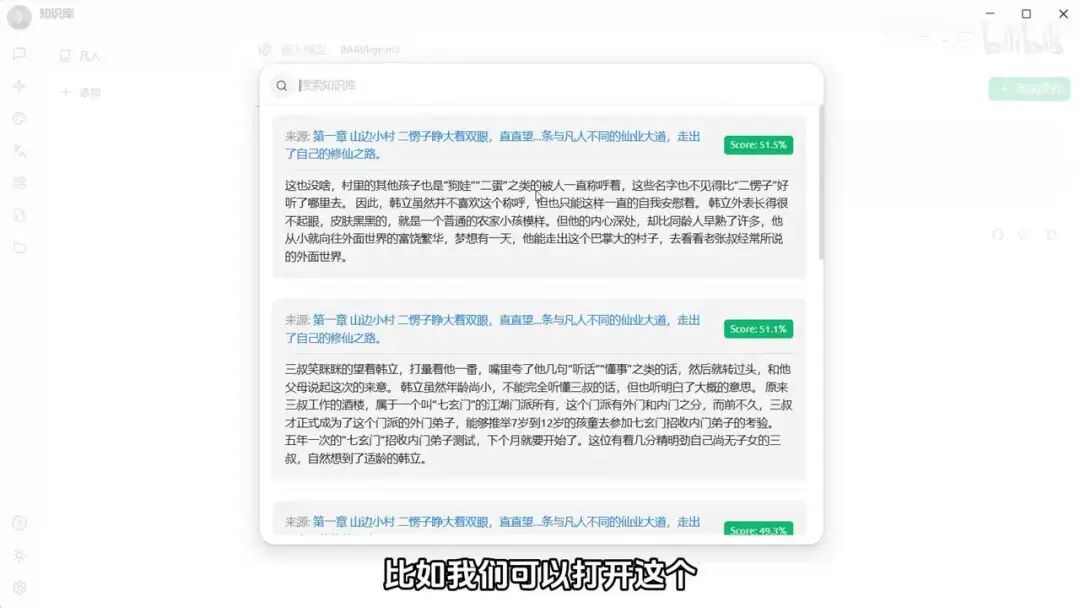
在我们的知识库高级设置当中,可以看到有一个分块的大小以及一个重叠的大小。
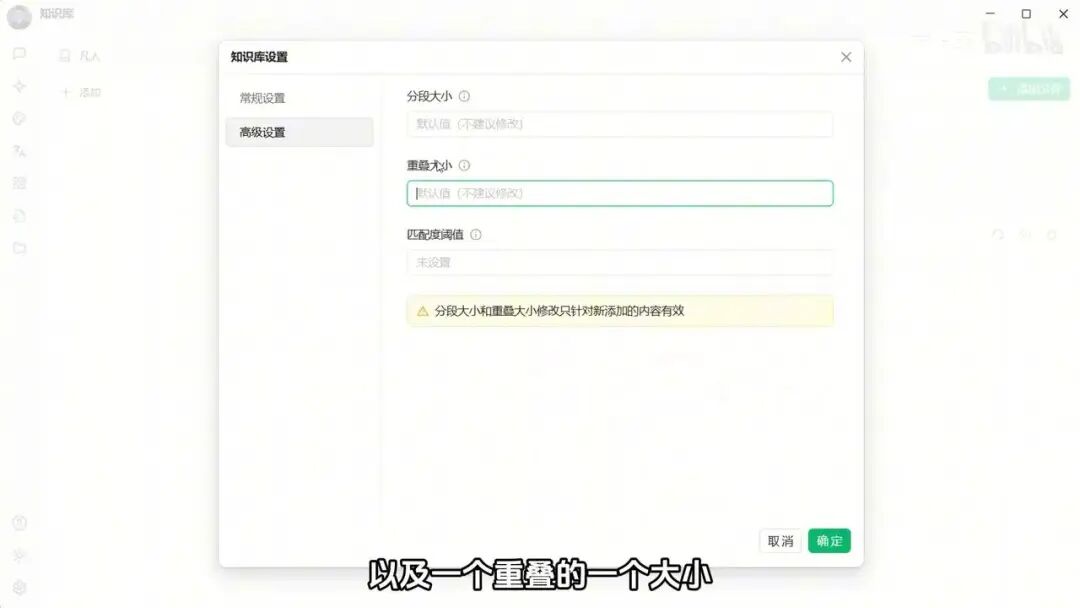
那这个我们可以自行去进行修改。当然修改之后,它会对新添加的内容生效。比如说你想要做这个分段,比如我是1000个字符做一段,然后允许有200个字符重叠,那也是OK的。当然这个分块的大小如果越大,它的语义可能就不会特别精准。所以这是我们的第一个问题,比如我们从前面的搜索其实就能够看得出来。
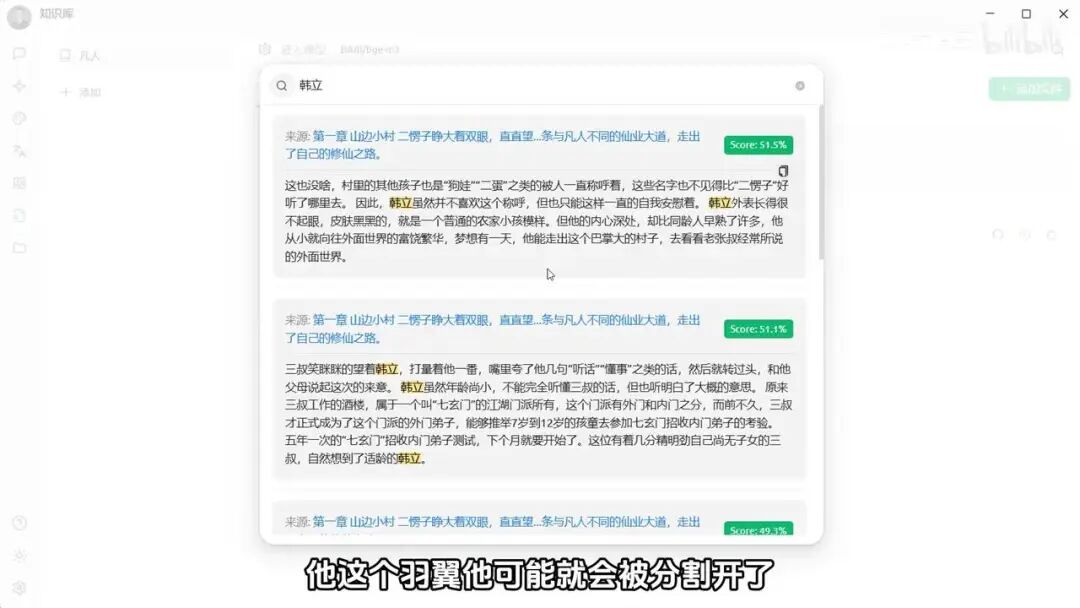
比如有些地方,这个语义可能就会被分割开了。
当然现在我们也有一些基于语义分析的分块算法,可能说我的这个分块不再是基于单纯的字数,而是通过语义的方法来进行分割。但目前这种方法还不太成熟,因为它是基于大模型来实现的,非常依赖模型本身的能力。所以有的时候它的效果甚至还不如简单的分割。
接下来我们再看传统方法的第二个问题,也就是检索不精准。检索不精准怎么看呢?比如我们可以搜索一个名字,比如说叫韩立,那这个韩立有没有出现呢?我们可以看到,现在得到的这几个片段里,其实是没有出现这个名字的。
但是它依然显示出来了,因为它是基于语义来进行匹配的。把用户的提问和向量数据库当中的片段进行纯数字的相似度计算,所以他筛选出来的资料片段可能相关,也可能不相关。它没有办法做到精准匹配。我们可以看到搜索出来的结果都有分数,有的分数高,有的分数低。
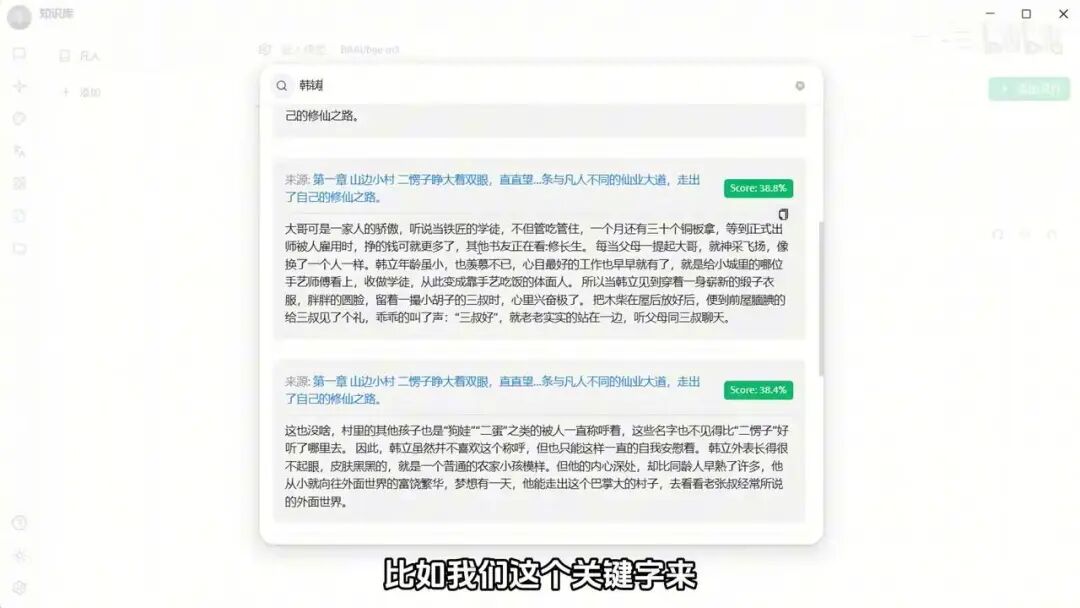
比如我们的这个关键字,我们可以看到。在这个片段当中,它其实是有这样的一个关键字的。
好吧,但它的评分比较低。如果说我们返回的片段数只有top3,那么可能这个片段就不会被返回。这就是我们可以看到的情况。
系统存在这样一个问题:向量数据库的匹配其实不够精准,或者说它匹配的前几条都不是我们想要的。针对这种问题,我们目前有一种比较好的改进方案——可以通过重排序模型(Rerank)来实现。对于向量检索出来的片段,我们可以再用重排序模型进行更深入的优化。
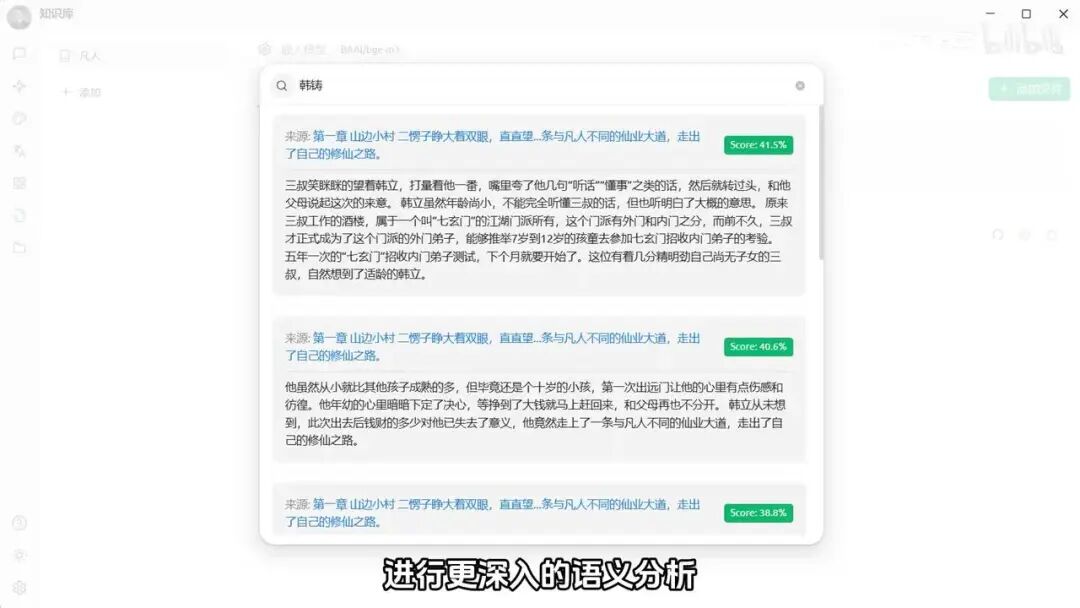
语例分析后,再进行重新排序,把相关性较大的排到前面。这相当于先通过embedding模型做一个粗略的检索,再用重排序模型做一个比较精准的排序,可以进一步提高检索的精度。接下来我们要先添加。
我们的重排序模型。
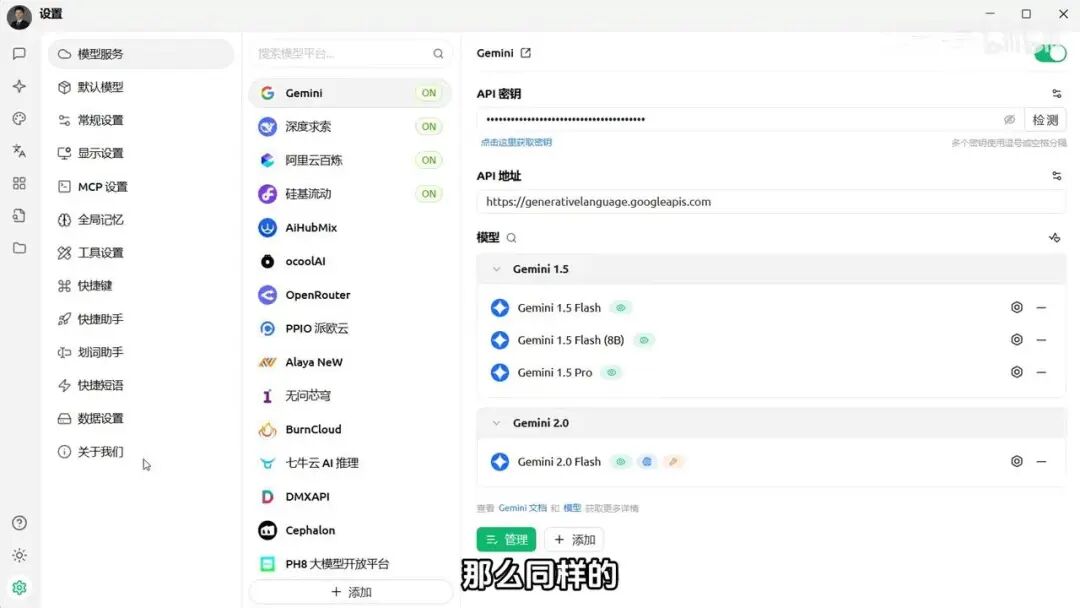
同样的,我们来到模型服务当中,点击硅基流动。
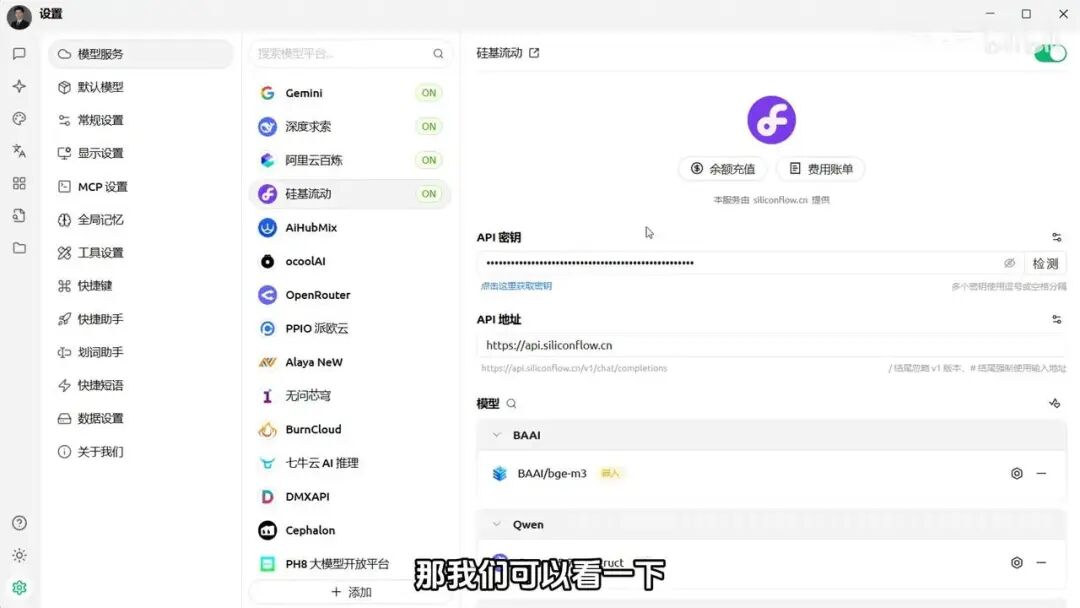
那我们可以看一下要用的这个重排序模型,在这里是 BGE-reranker-v2-M3。
那这个如果说我们想用其他的可不可以呢?也可以啊,这边也有一个重排序,我们可以自己去点击,然后把嵌入模型给它去掉。
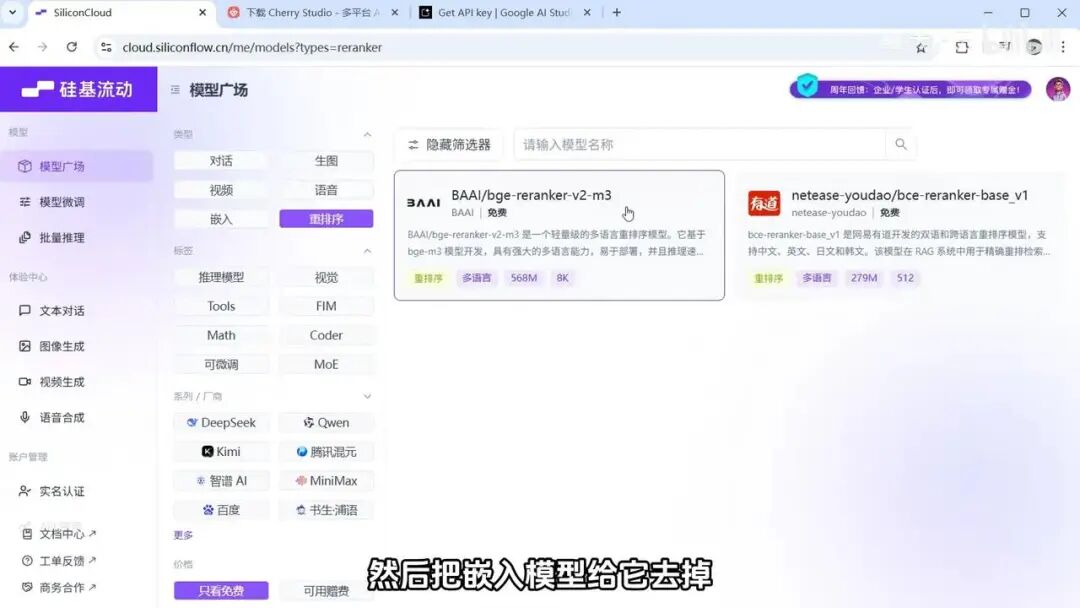
那这个就是我们能够去使用的重排序模型,它的安装方式也相同。
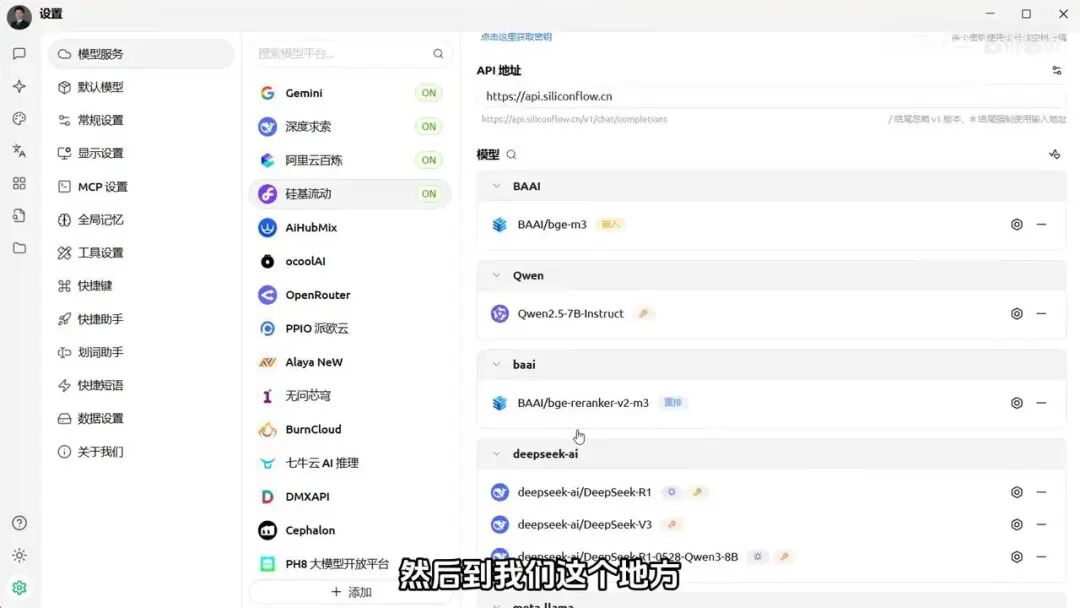
复制它的这个名字,然后到我们这个地方进行一次添加就可以了。
好,那么添加完成之后,我们就再回到咱们的知识库,然后对这个知识库进行一个简单的设置。我们把重排模型加上,原本是没有的。
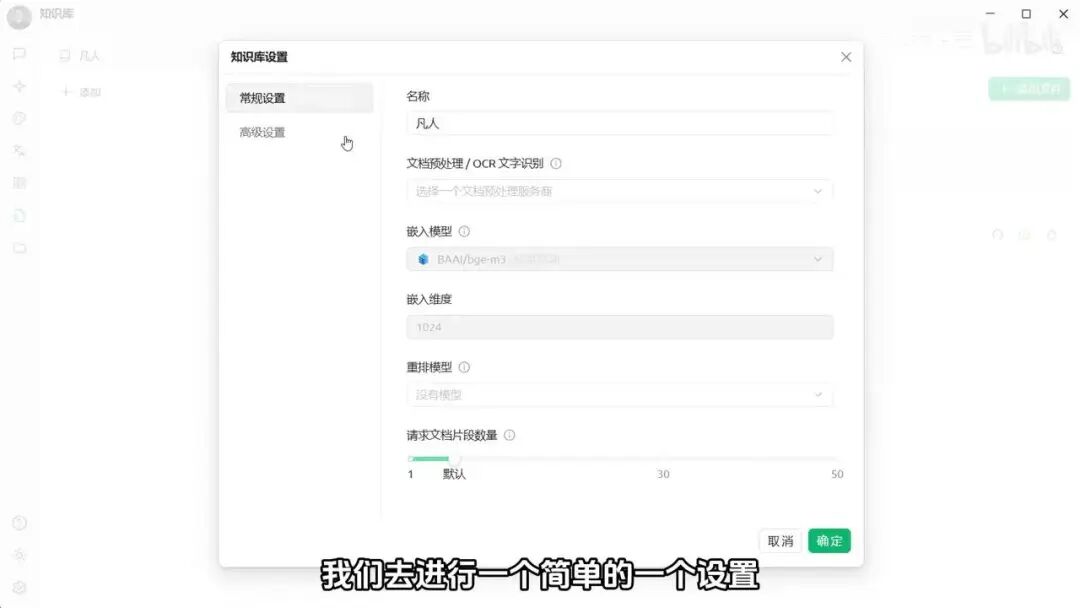
那么现在我们给它加上这个轨迹流动的,加进来之后我们确定。好,现在我们有了这个重排模型之后,再来重新搜索一下刚才的问题。比如我们继续搜索这个函注,看一下反馈的结果。我们想要的片段现在就已经变成了第一条。
而且它的评分非常高,剩下的片段评分都非常低。通过重排序模型,我们可以看到提高了re。
知识库的检索精度。下面我们再来看一下RAG系统中的第三个问题,也就是大局观的问题——它能否用全局视角来看待用户的问题。前面讲到过,RAG本身的逻辑其实比较清晰。
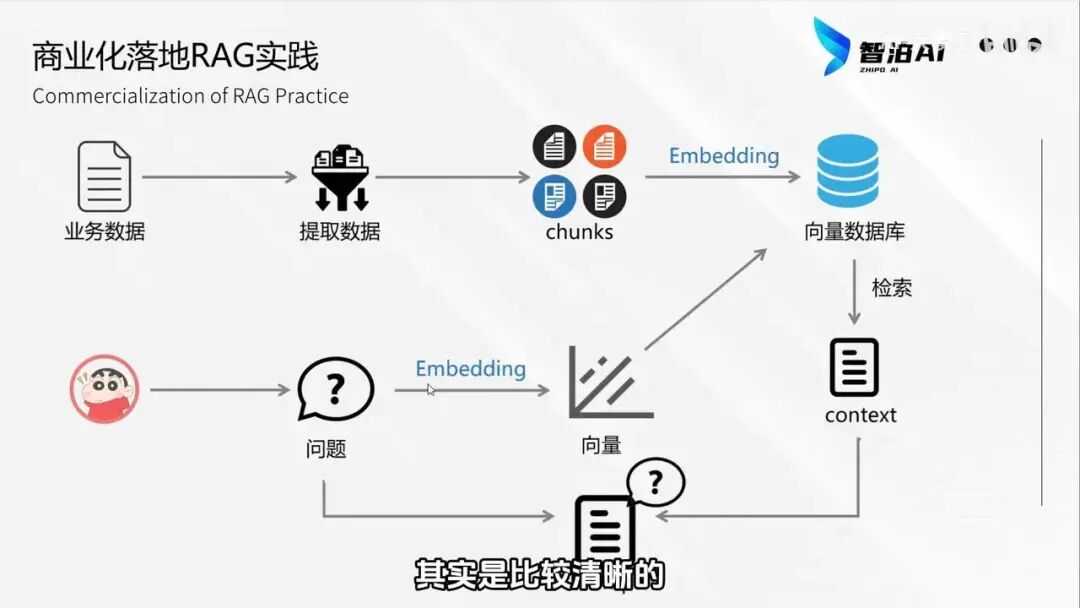
这个方案我给大家重新打开一看,其实就两步,对吧?
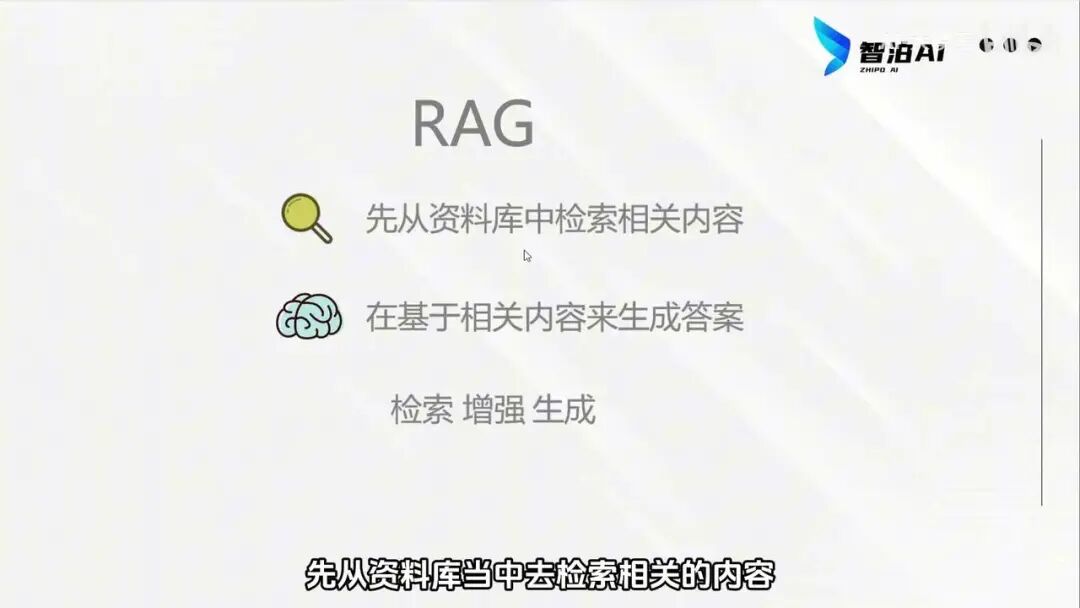
先从资料库当中去检索相关内容,然后再基于内容来生成答案。我们可以发现,这个检索相关的内容是不是完整的数据呢?答案很明显,肯定不是的。因此在这里,我们可以用一个Excel表格,比如这是AI生成的这样一个数据,可以给大家看一下。在这份数据当中,它其实就是什么?
它其实就是我们的一些片段。
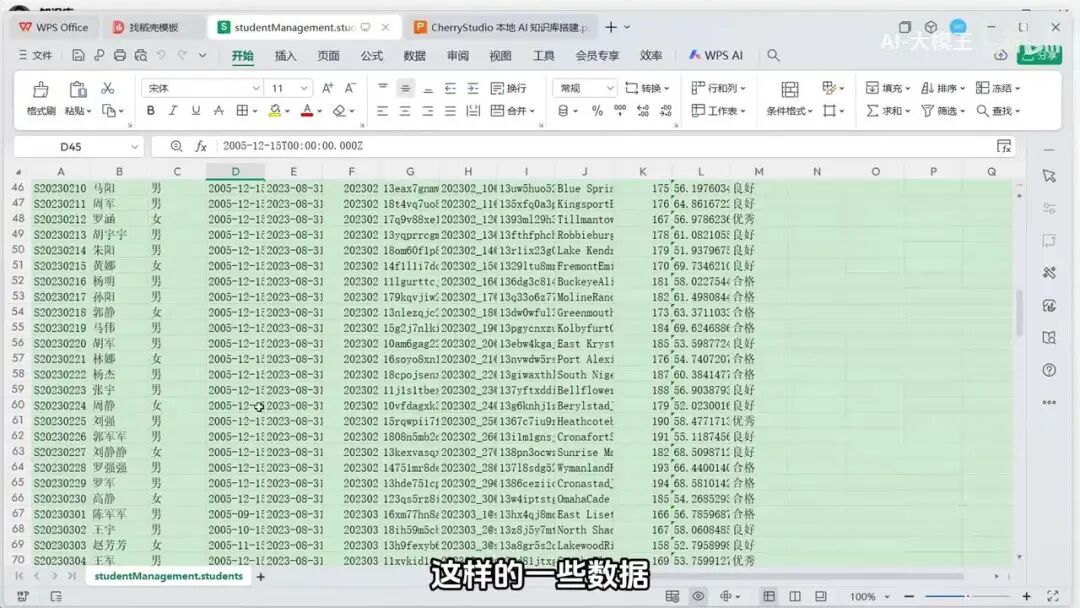
来看一下我们一些学生的数据。这里面的数据一共是180条。
那我们现在就有一个问题:如果我们直接把这样的一个表格给到谁呢?
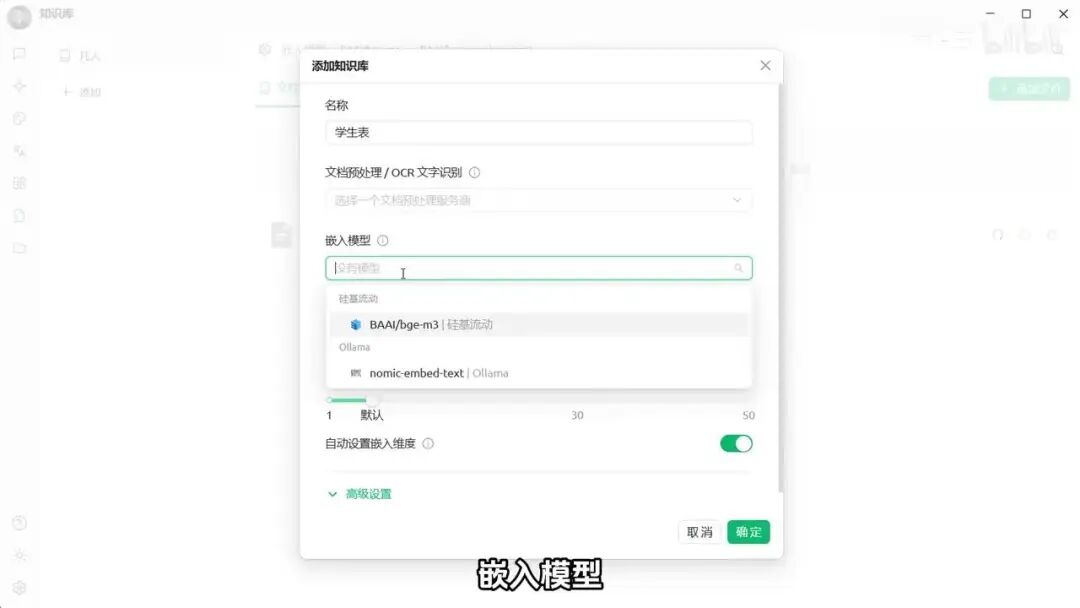
给到我们的这个知识库里面,比如现在我们去添加这样一个学生表。嵌入模型我们同样选择这个BAAI/bge-m3,然后确定。那么这时候的问题其实就在于:一个完整的Excel表格拖进来之后会被分块,每个片段都是不完整的。如果我想对这个表格中所有数据进行统计分析,比如一共有多少条学生信息,以及他们的最大最小值查询,向量检索基本上是做不到的。因为向量检索只是根据相似度匹配文本块,把相似度高的文本块交给大模型。这种情况下,大模型根本无法进行回答。所以现在问它也没用,把知识库拖进来问同样没有意义。
这两个要跟大家分享的重点,其实就是针对这类结构化数据或者说统计型数据的处理方法。
那你是用知识库,它是没有办法去完成的。最好的方法还是使用我们的数据库。因为我们有了这个CP之后,可以通过AI来使用CDserver操作我们的数据库,这是一个比较好的解决方案。
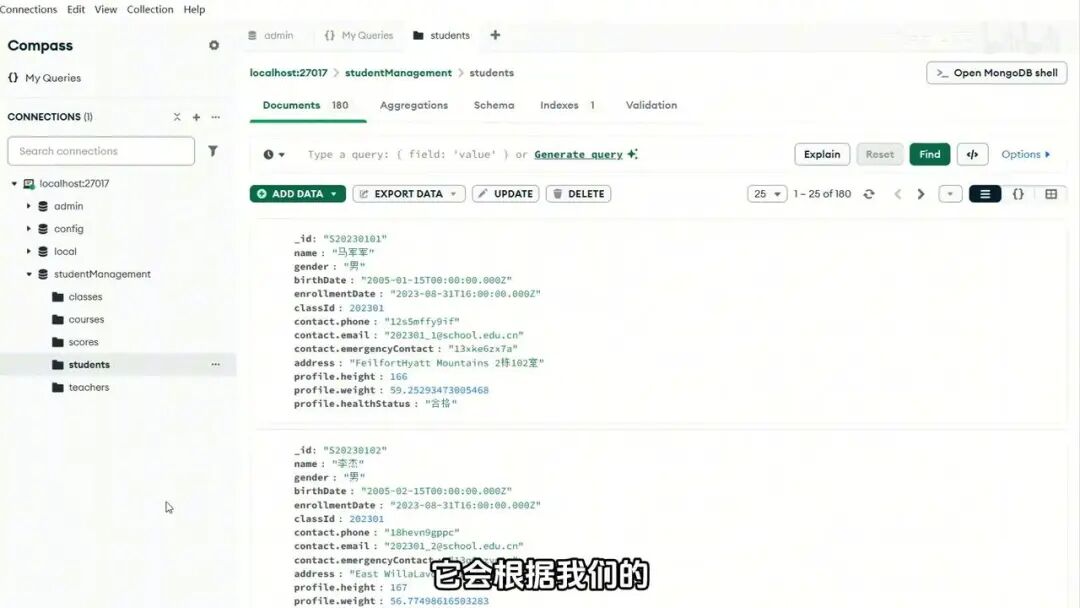
接下来我们就使用CBserver,把数据库接入到大模型当中。首先要把这个Excel表格里的所有数据存到我们的DB数据库当中,因为这部分我已经存储过了。
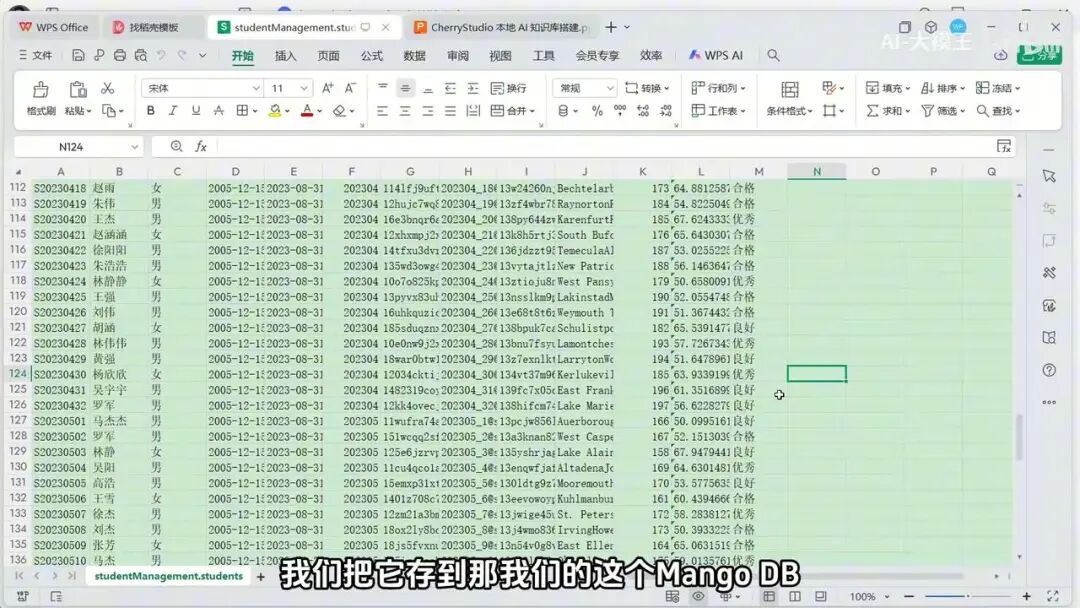
给大家看一下,好吧,所有的数据全部都在这里。
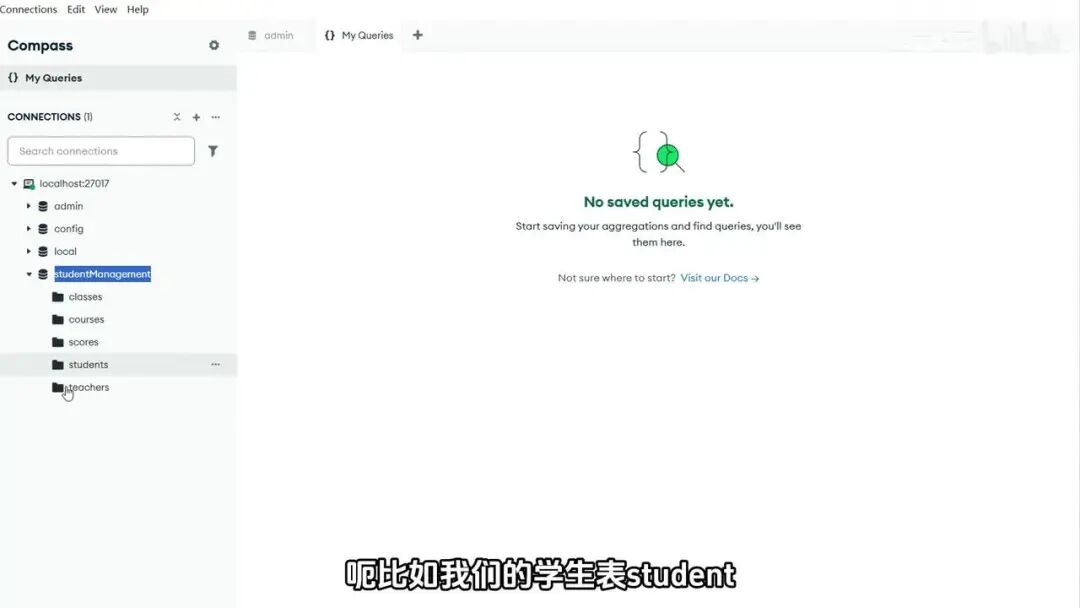
比如我们的学生表,tuud等等。我们可以看到数据都已经在这里了,但它到底是怎么去存的?
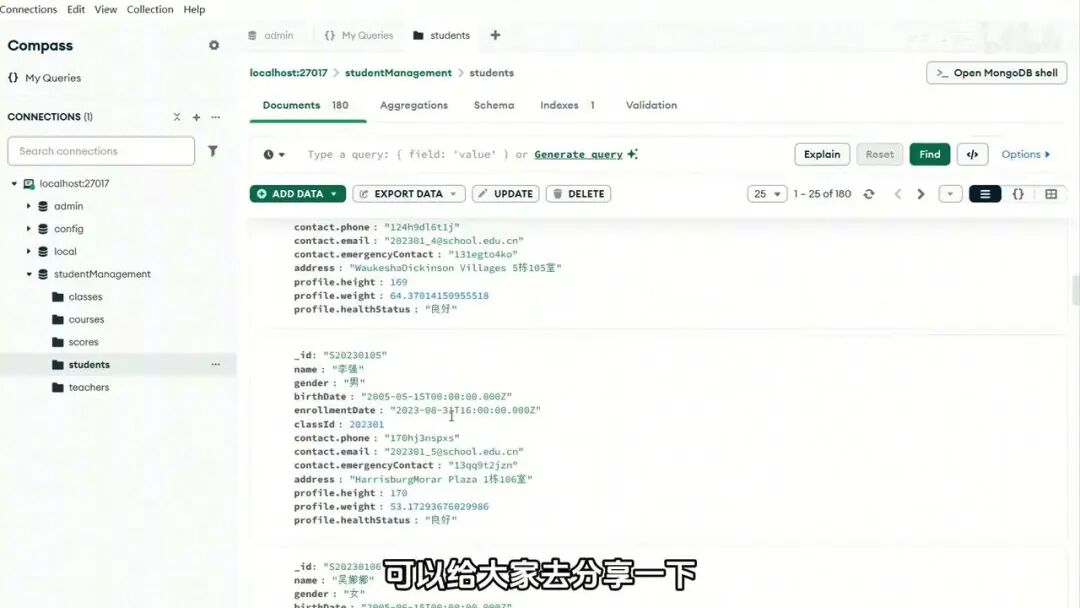
可以给大家分享一下。好,然后这个数据我们把它都处理好之后,接下来就可以在 Cherry Studio 当中配置我们的 CPserver,让我们的 AI大模型 可以连接到 MongoDB 数据库当中。所以接下来我们同样点击设置,然后需要点击 CP 的设置。那么在这点
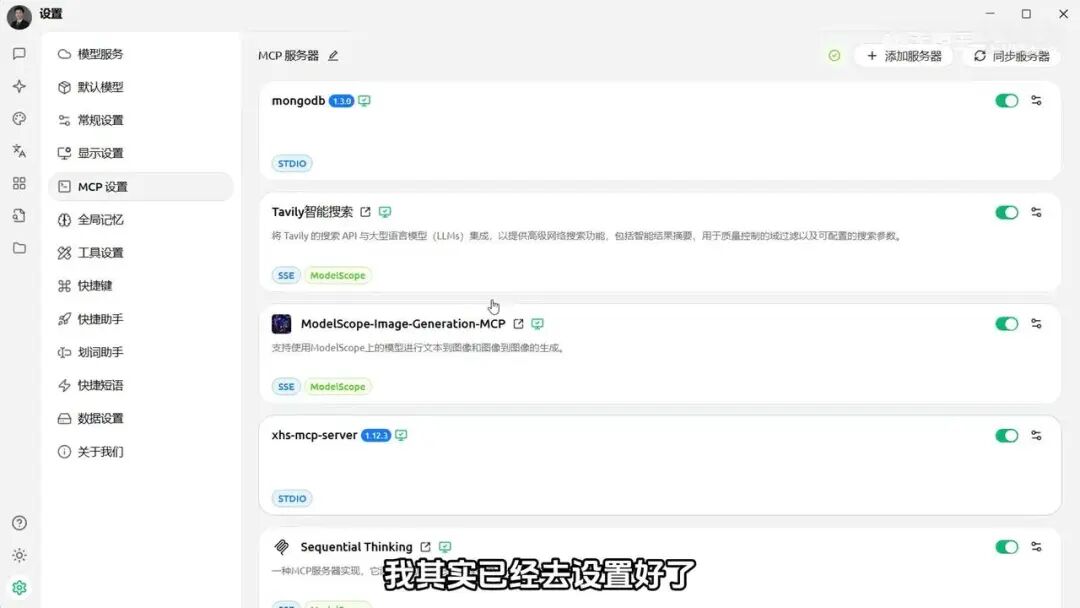
我其实已经去设置好了,比如这个MongoDB,那么它到底是怎么去设置的。
当然这个设置,我们是需要去添加我们的服务。那这个怎么去添加呢?我们是通过 JSON 来进行导入的。
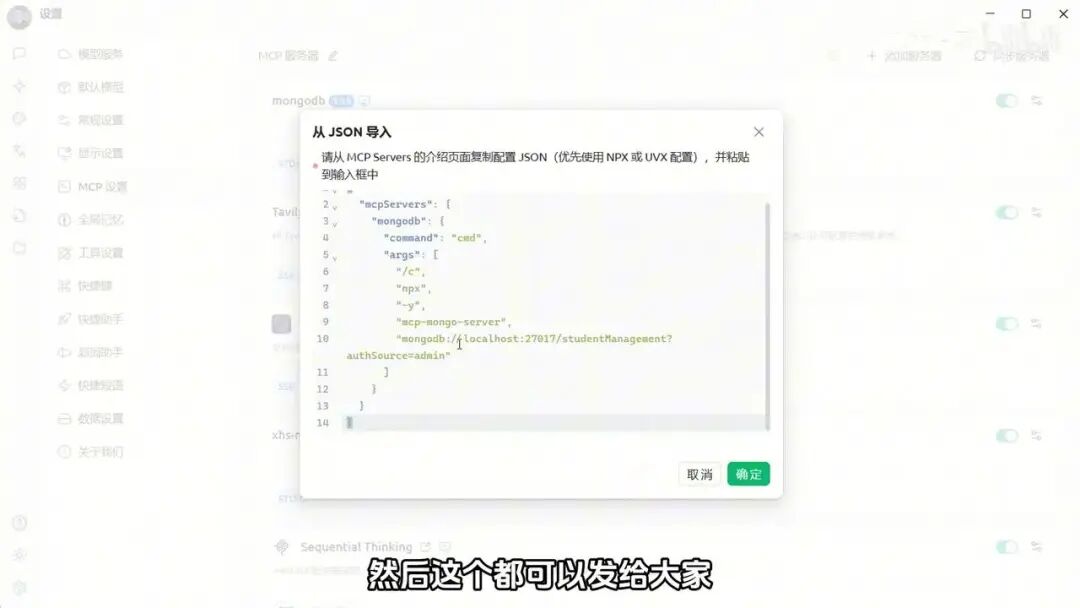
那么这个地方我们应该怎么去写?或者说我们要在这里添加什么样的配置信息?其实老师这边已经提前给大家写好了。如果大家有需要的话,可以在评论区留言,这个都可以发给大家并给大家讲解一下。
这个配置是什么意思呢?首先,这个goB是我们服务的名字。然后这个comd是我们要执行的命令,我们是通过MD来执行的。在MD当中执行时,我们有几个参数:一个是-C,然后是PX,再是-Y,再指定我们这个CP,然后mongo-就是我们这个CP服务的名字。下面这个是我们这个地址,这个地址是怎么来的?其实是在我们这个里面得到的,它会有这样的一个地址,我们就把这个…
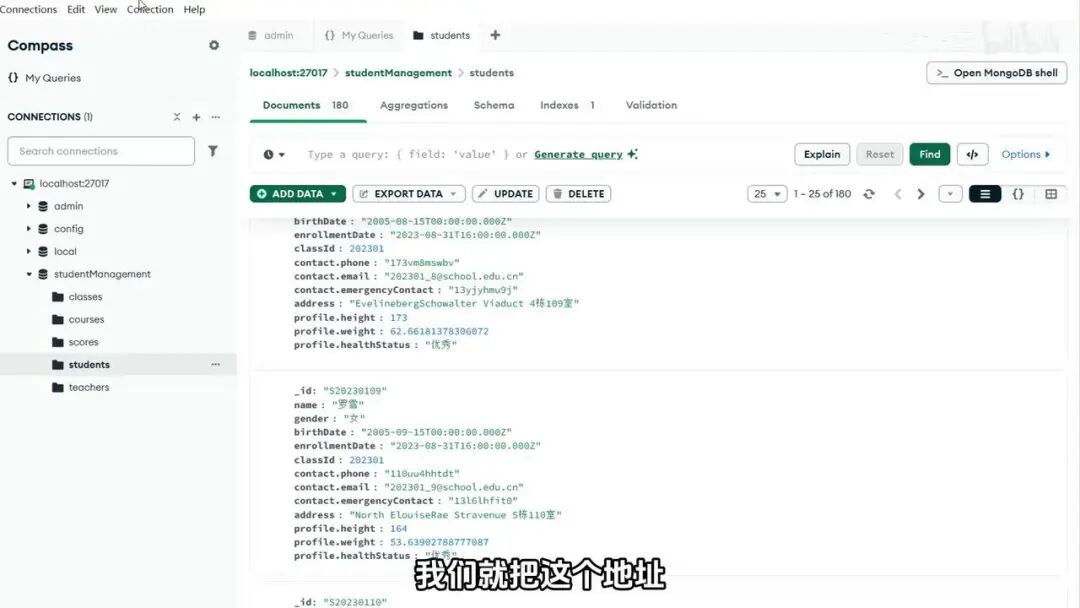
地址填成自己的就可以了。只要你自己电脑上面开启了MongoDB服务,它就会进行连接。然后你把这个配置点击确定,服务就会启动,就已经启动成功了。
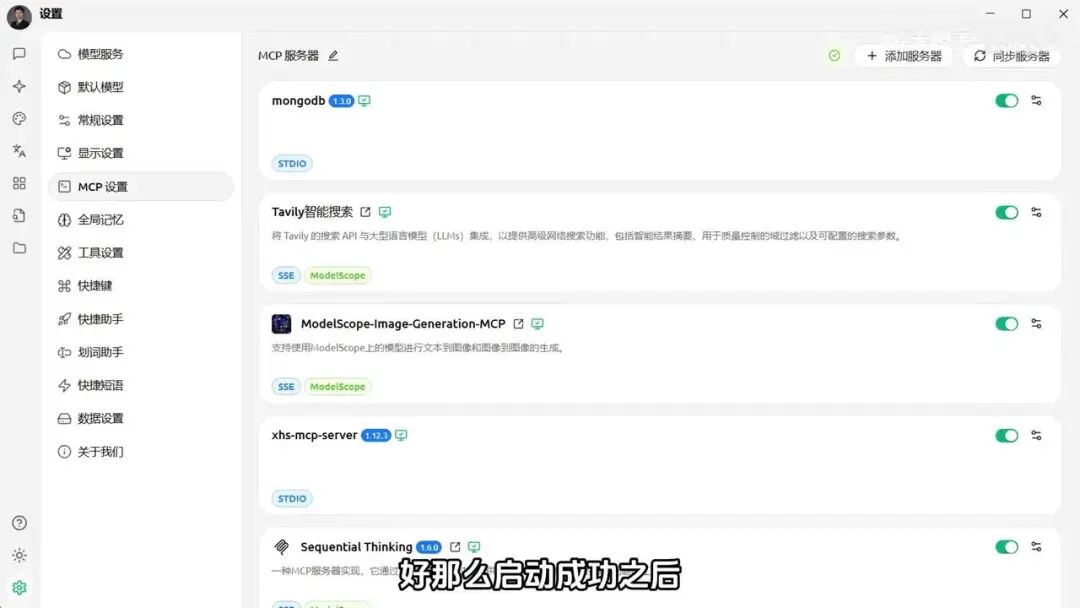
好,那么启动成功之后,接下来我们就回到聊天界面中。因为前面那个cell我们并没有实际进行测试,但结果其实是能够想象得到的。
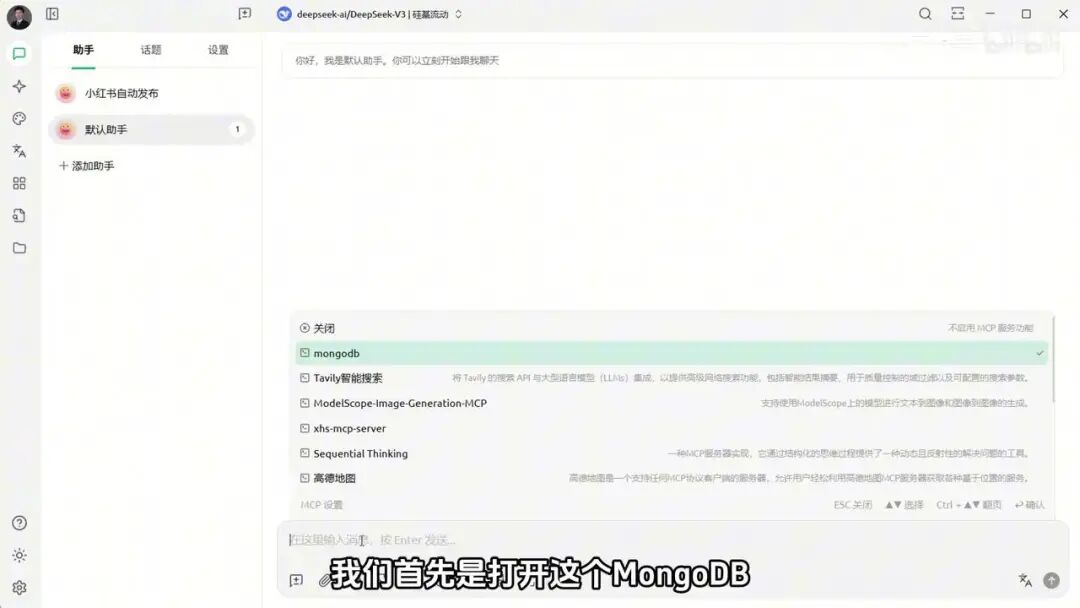
好吧,那么下面我们要做什么呢?我们用同样的问题去测试一下加入PServ之后返回的结果。
首先,我们打开DB服务。接下来,我们可以问他:“数据库当中一共有多少位学生?”当然,这里还有一个点可以做。
对于我们的数据,可以看到他的回答是不精准的,对不对?我们可以发现他没有去调用我们的服务,说明这是幻觉,是胡编乱造的。
所以接下来的问题是,我们要给他设定一些提示词,让他进行优化。比如,当用户的提问涉及某些内容时,我们可以给他一个提示词。好吧,这个表结构我先不给他。
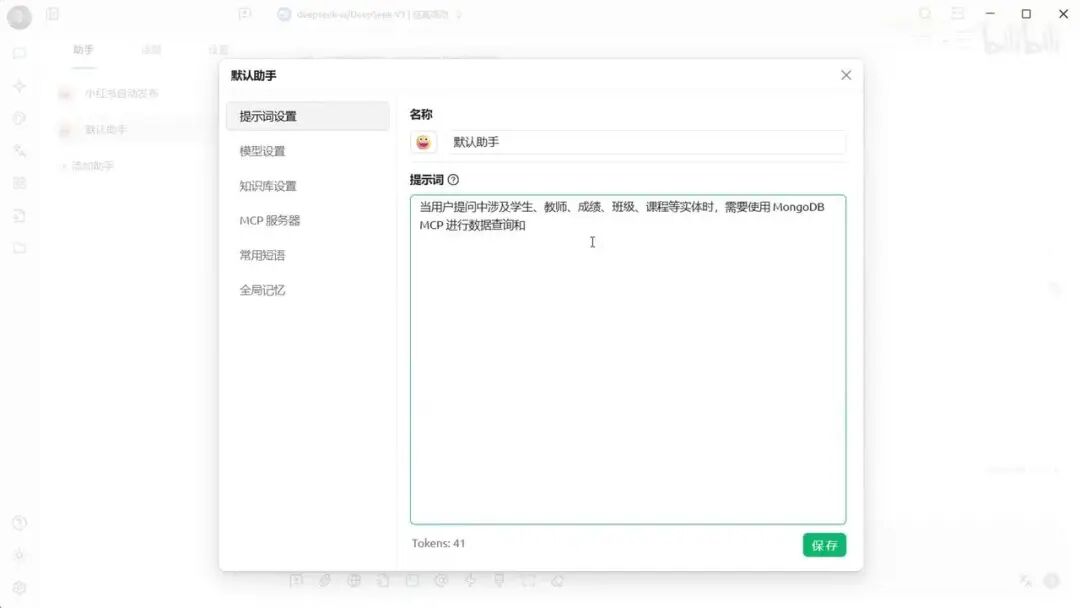
给我们一个提示词,告诉他一定要调用我们的工具。
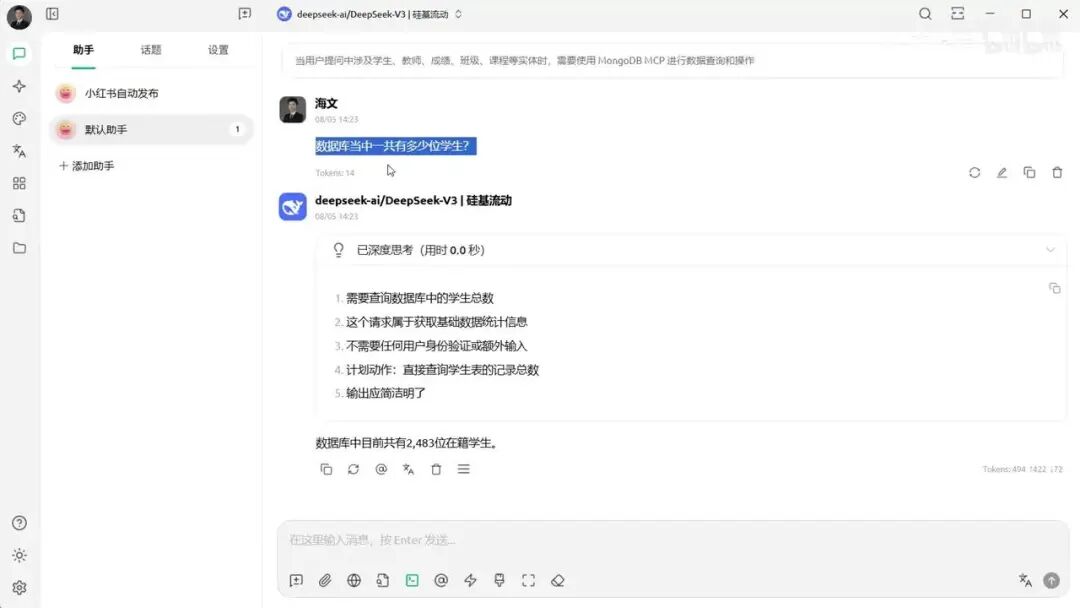
因为这块我们已经开启了。好,我们现在就等待它运行的结果。可以看到,现在它给我们返回了正确答案 180。它会根据用户的问题生成对应的SQL语句,然后再进行数据库查询。
那不光是你要去获取多少位学生,甚至包括他们平时的分数,对吧?
以及这样的一些更复杂条件,我们都可以基于CB Server来实现。在查询结构化数据时,通过CB Server对接数据库,会比普通知识库有更好的检索效果。
除了以上优化方案,还有一种一例降十会的方法:使用超长上下文模型,直接将所有资料拖进对话框让AI检索。比如Ji Mi 2.0,现在已支持2000万token上下文,你可以随意把四大名著全部塞进对话框。下面我们就用Ji Mi来测试一下。
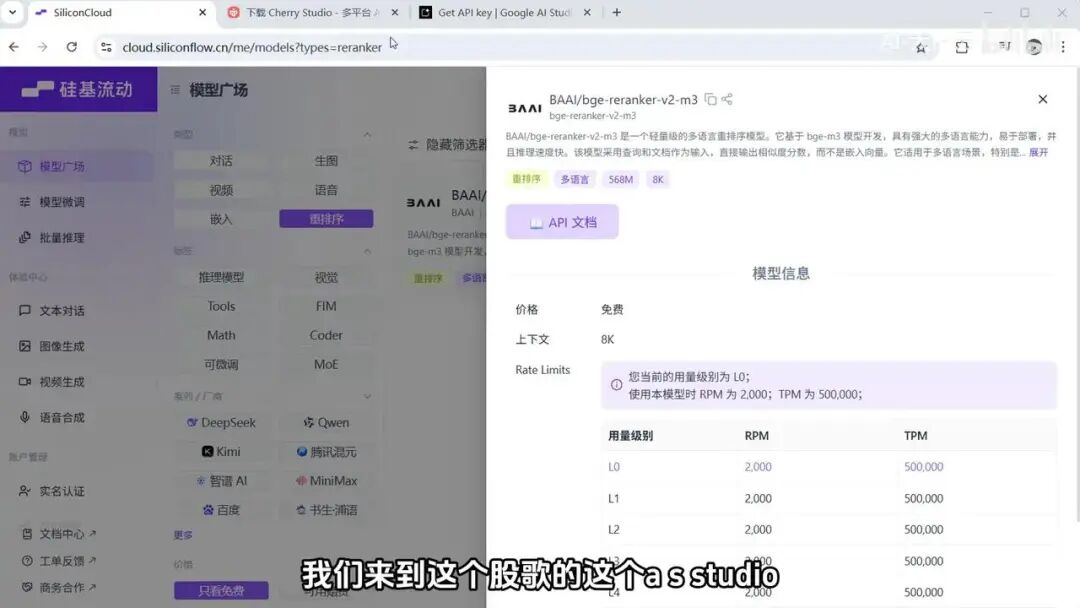
那首先我们来到这个Google Al Studx,然后我们来到这个网站之后,这里因为它需要国外的上网环境,所以大家需要自行去配置。然后我们可以来到右上角。
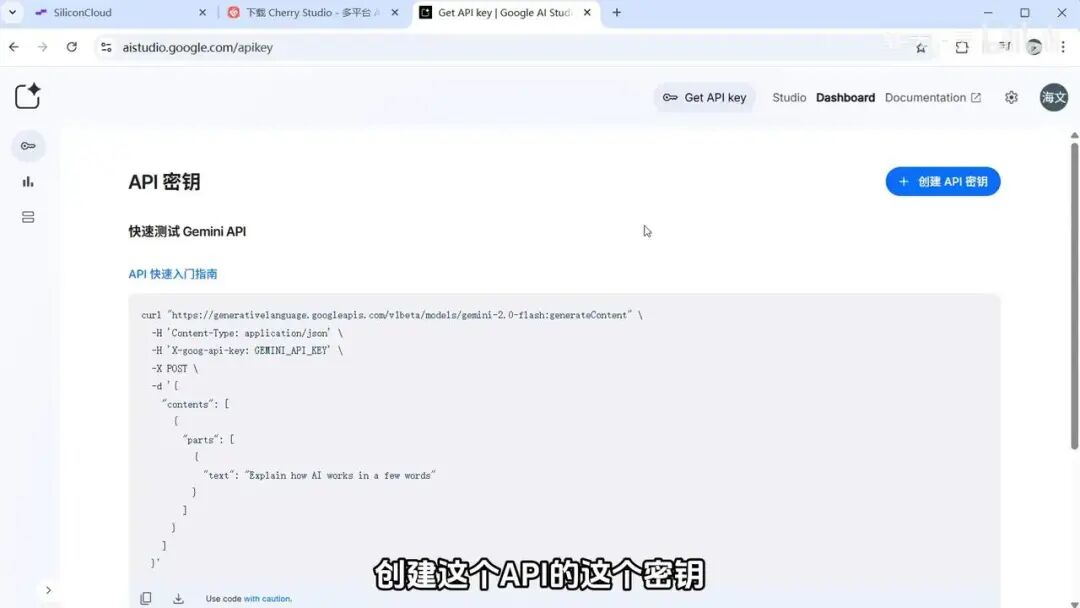
会有一个获取API key的选项,所以我们要点击这个。或者你也可以直接点击创建API密钥,点击一下。点击完之后,它会让你去选择一个项目。
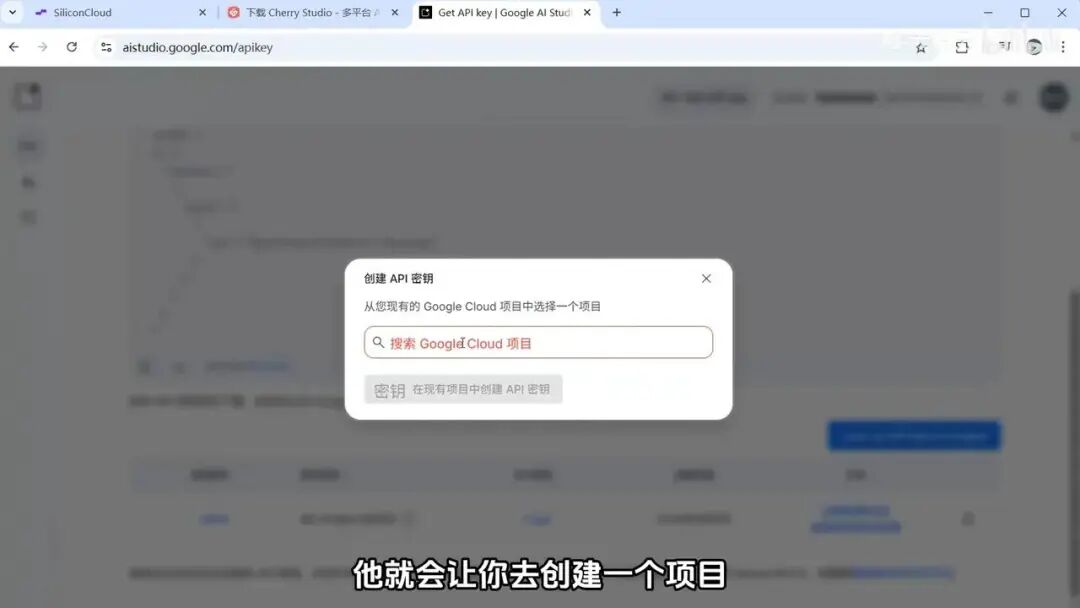
如果你没有项目的话,它默认会让你去创建一个项目,按照它的操作执行即可。
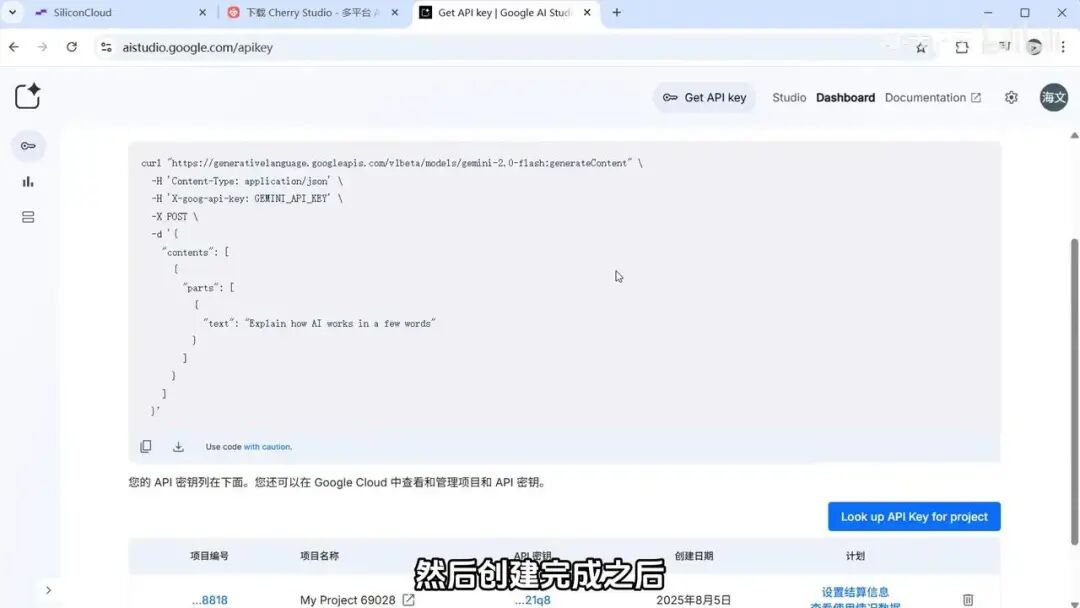
然后创建完成之后,在这个地方它就会给到你一个API key。
然后你可以把这个密钥复制下来。复制下来之后,我们就可以回到这个。
UD里面打开咱们的这个模型,然后我们就可以选择这个AI,把我们的密钥复制进来,可以去做一个检测。
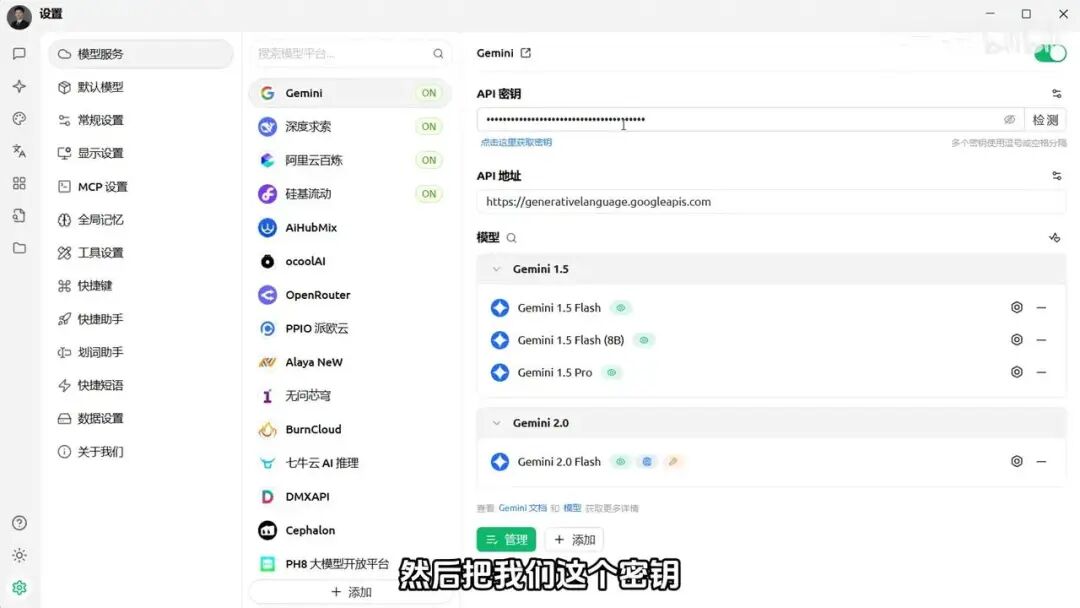
比如在这里,我们可以用这个ImmY2.0,点击确定去测试一下。
看一下它这个连接有没有问题,这里面有点慢,我们稍微等待一下。看到它现在已经连接成功了。
好,连接成功之后,接下来我们就可以回到聊天的窗口。比如我们再添加一个助手。
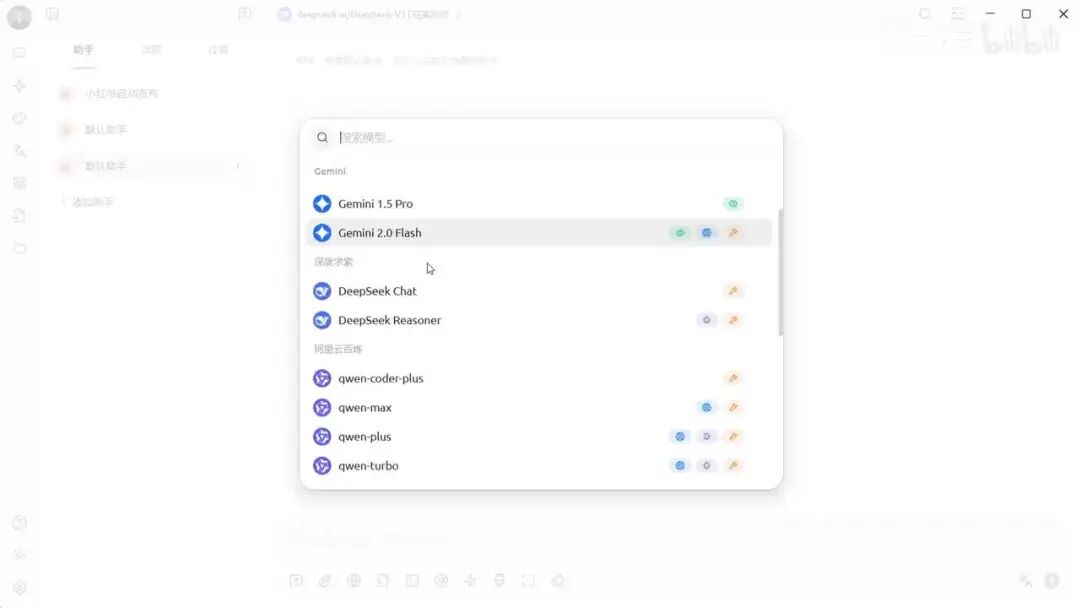
好,然后在这里我们把这个模型改一下,我们把它改成这个Gemini 2.0 Flash。改成这个之后,那其实我们就能够去上传这个文件了。比如你可以上传更复杂一点的文件。
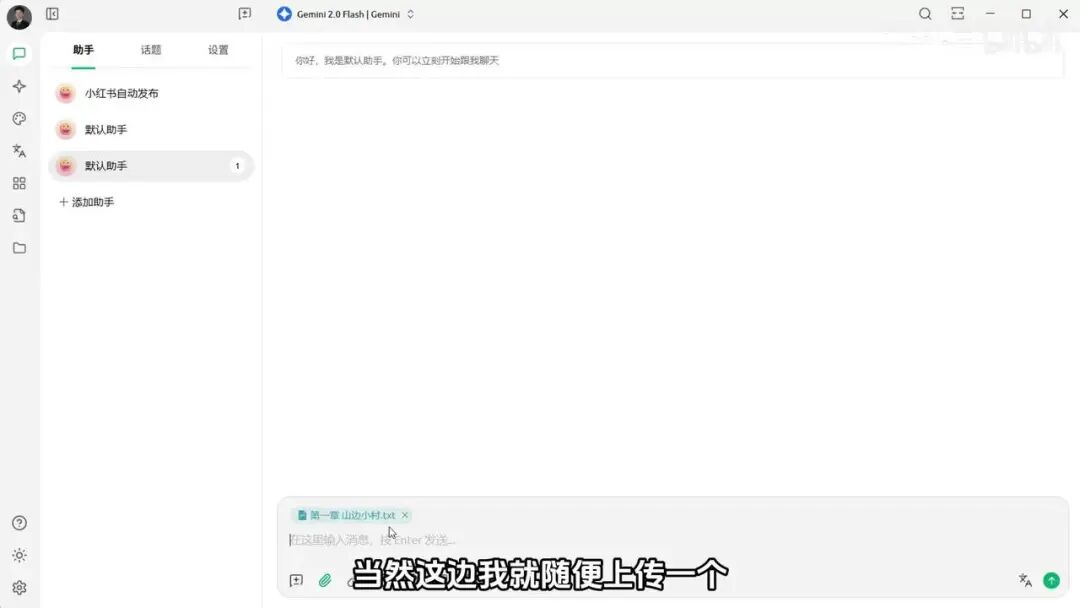
当然这样我就随便上传一个,因为它其实无所谓。那如果说你想要去测试的更复杂一点的,比如说你可以把一个全本的《三国演义》全部拖进去,看一下它能不能检索到你想要的答案。在这里,我们给他去…OK好,这种因为比较简单,我只是给大家简单的做这样一个测试,大概就是这样。
但因为如果说你的上下文越长,那么它消耗的token也就会越多。所以目前来讲,直接通过Gemini这种超大型上下文来做知识库的检索,其实也是一种不错的方案。
AI知识库经常被调侃为”demo5分钟,上线一整年”。它并不是一个简单的上传即用的工具,而是一个系统性的工程。它需要我们根据数据的类型、查询的需求,选择合适的技术路径。AI知识库潜力是巨大的,但是不能盲目依赖。只有真正去理解它的技术边界,才能够避开陷阱,真正发挥价值。
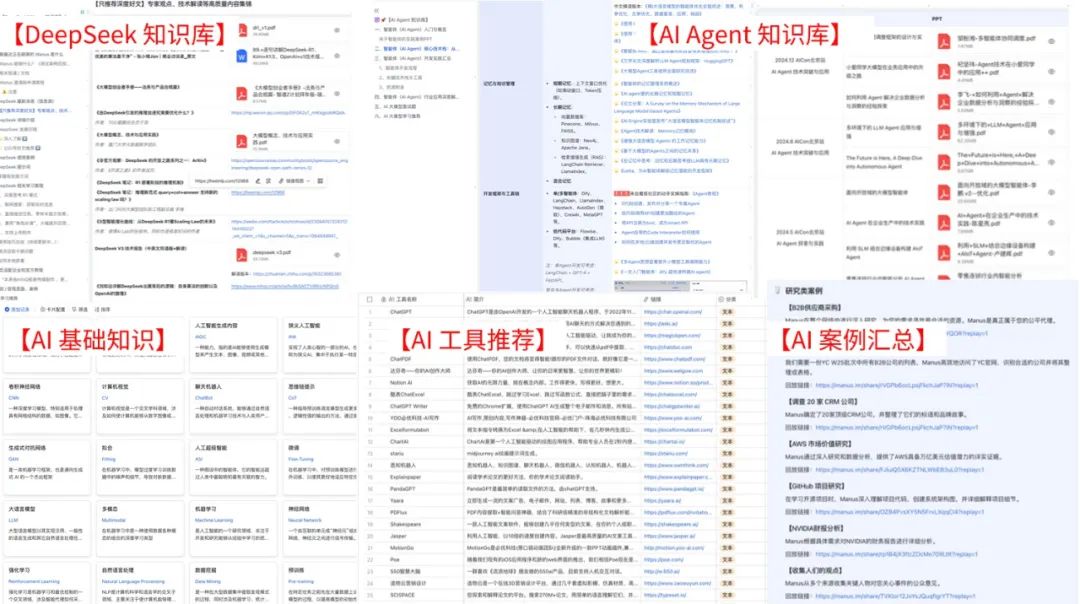
想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!
👇👇扫码免费领取全部内容👇👇
一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势
想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:
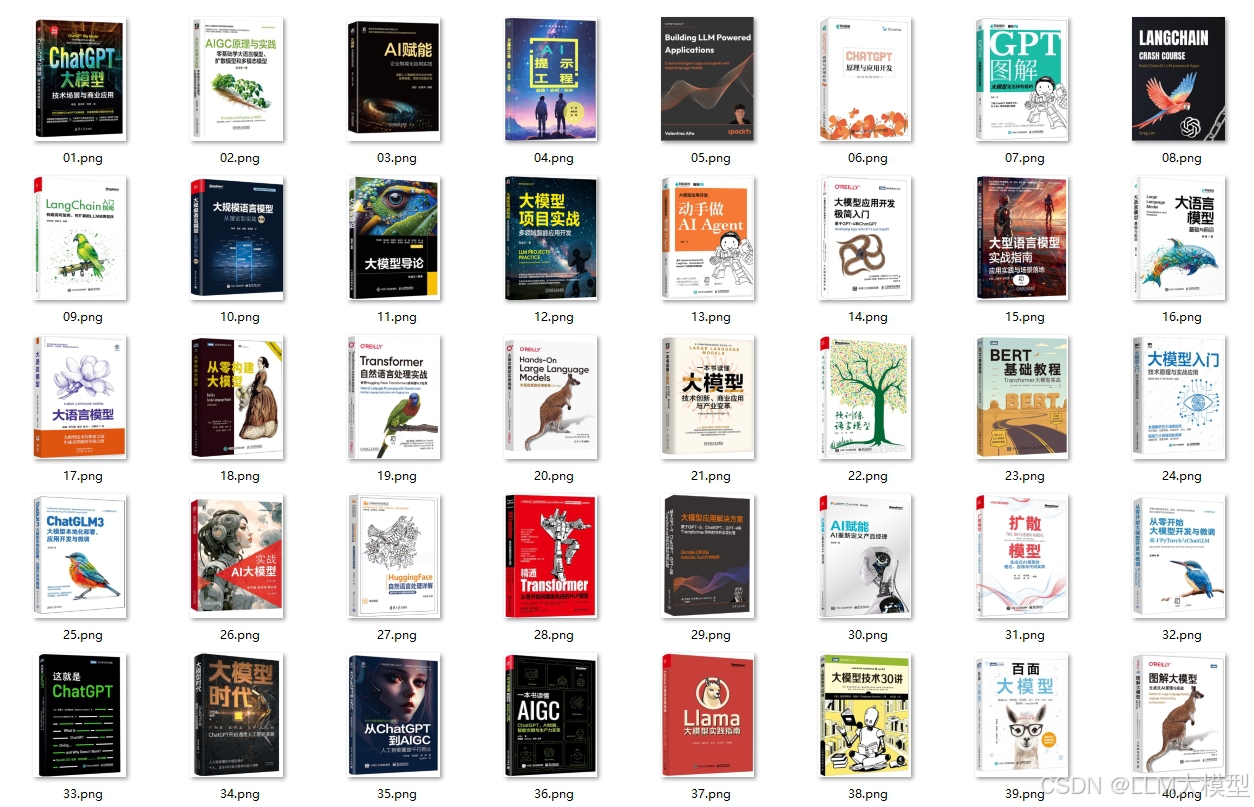
1. 100+本大模型方向电子书
2. 26 份行业研究报告:覆盖多领域实践与趋势
报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:
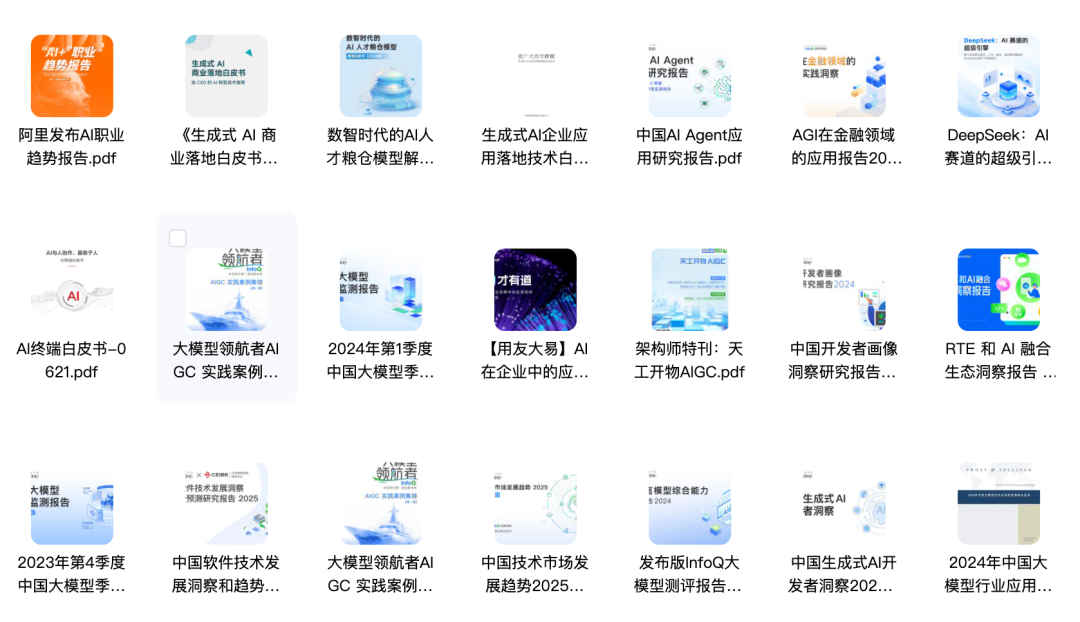
- 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
- 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
- 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
- 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。
3. 600+套技术大会 PPT:听行业大咖讲实战
PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

- 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
- 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
- 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
- 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。
二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走
想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!
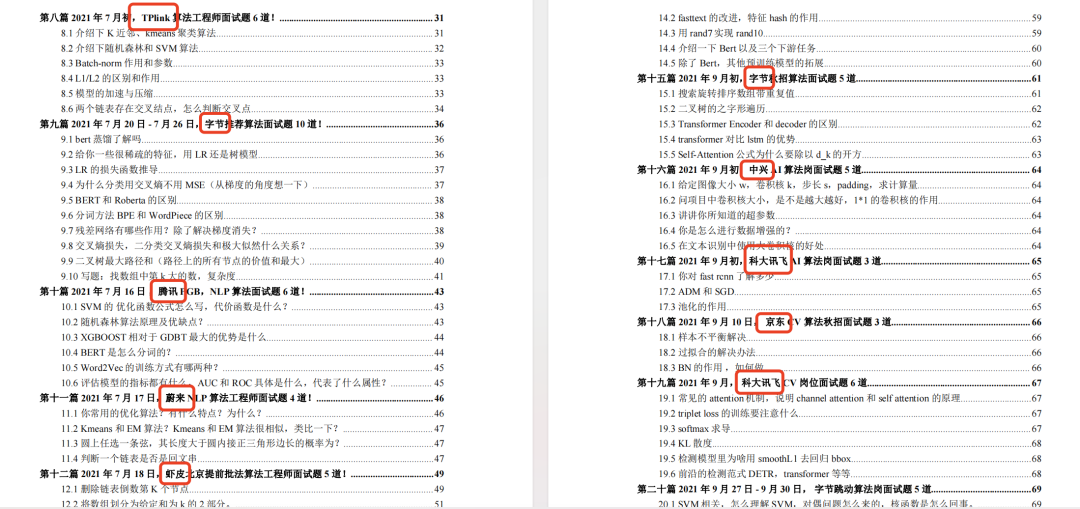
1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位
面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:
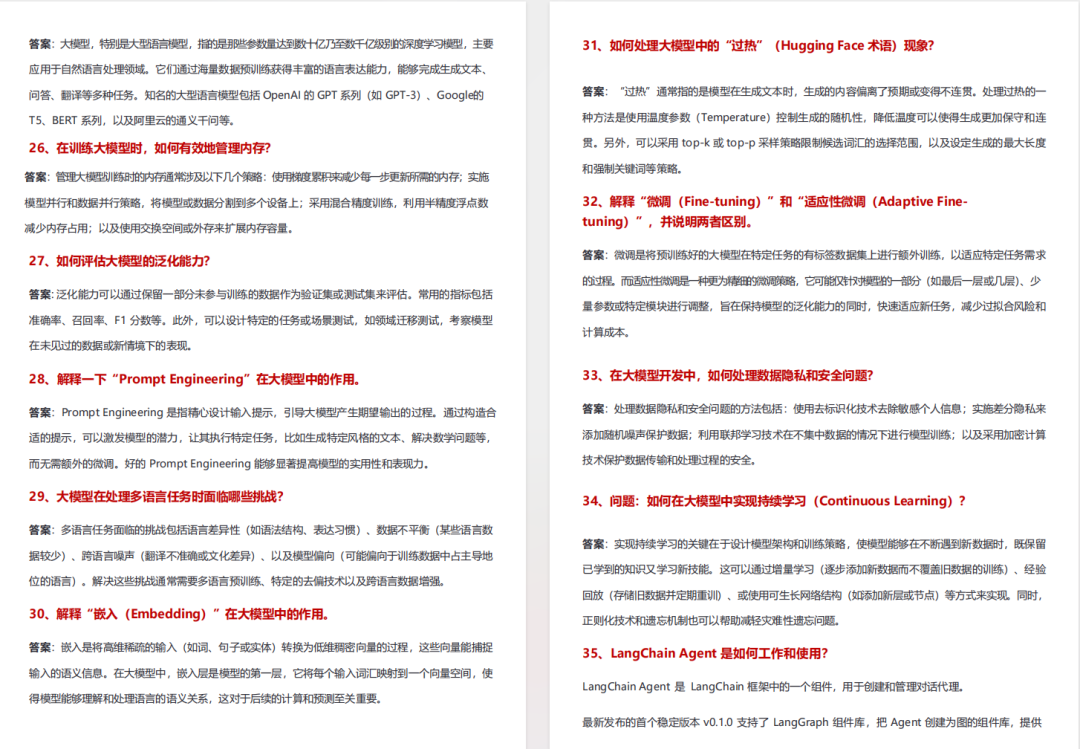
2. 102 道 AI 大模型真题:直击大模型核心考点
针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:
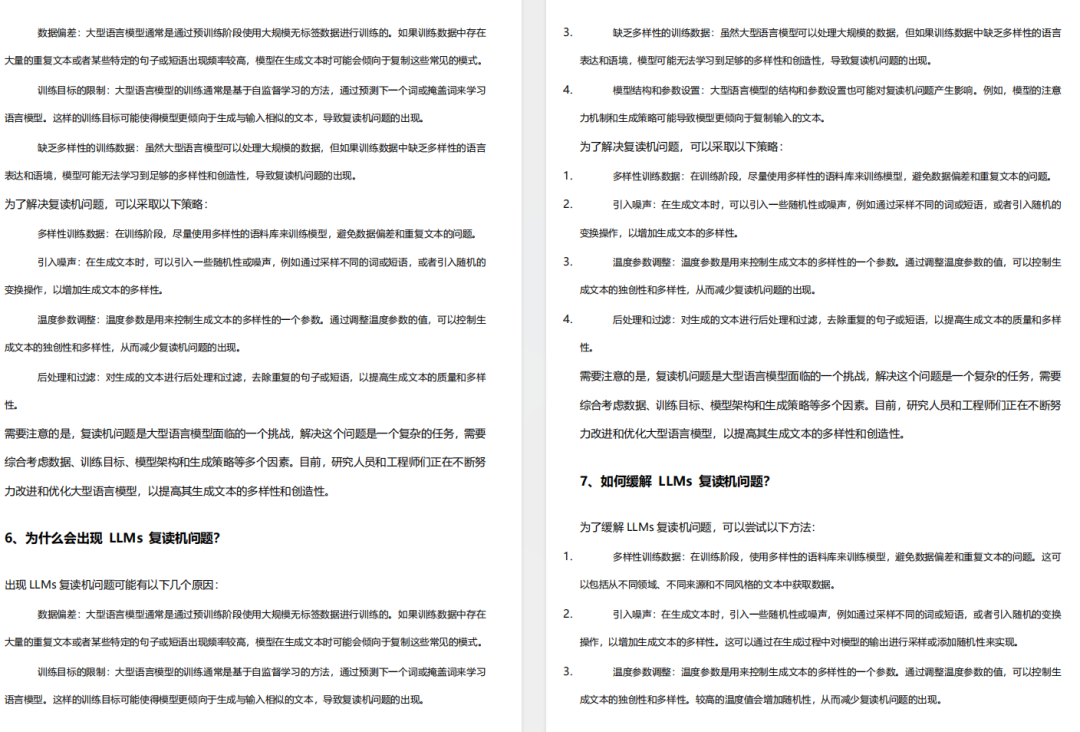
3. 97 道 LLMs 真题:聚焦大型语言模型高频问题
专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:
三、路线必明: AI 大模型学习路线图,1 张图理清核心内容
刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!
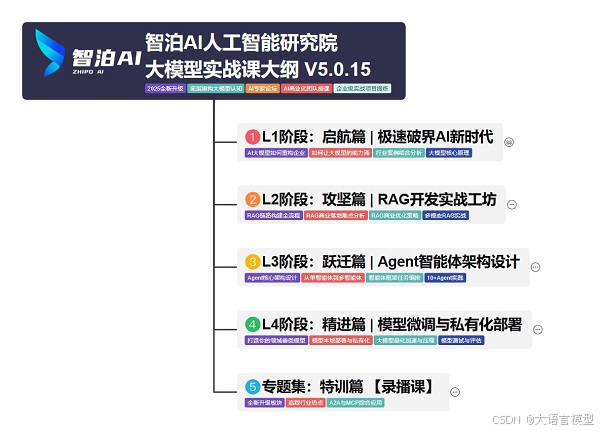
路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。
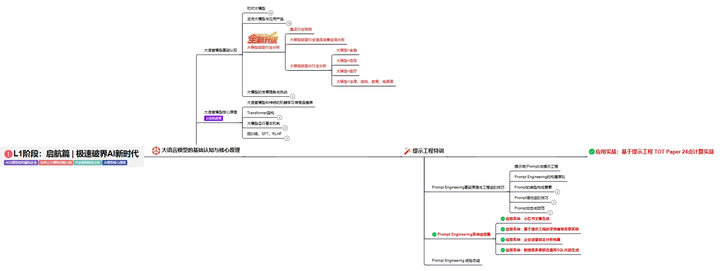
L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。
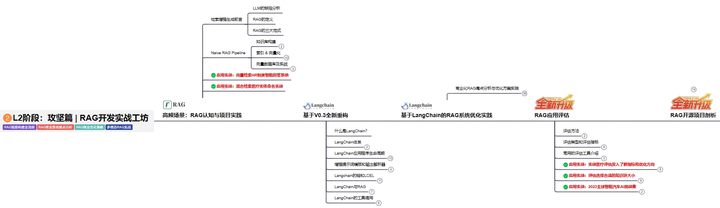
L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。
L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。
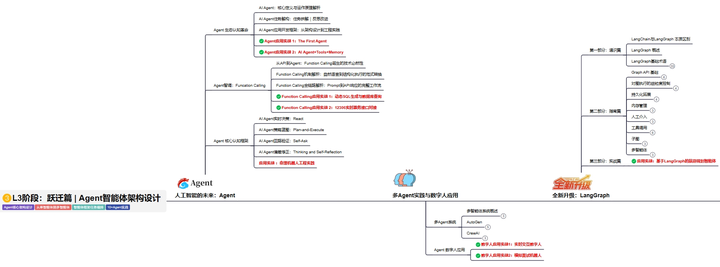
L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。
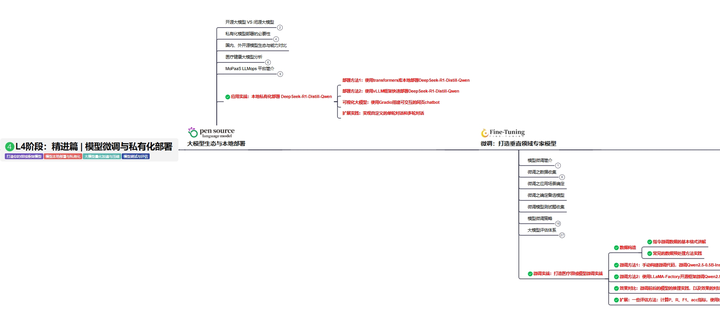
L5阶段:专题集丨特训篇 【录播课】
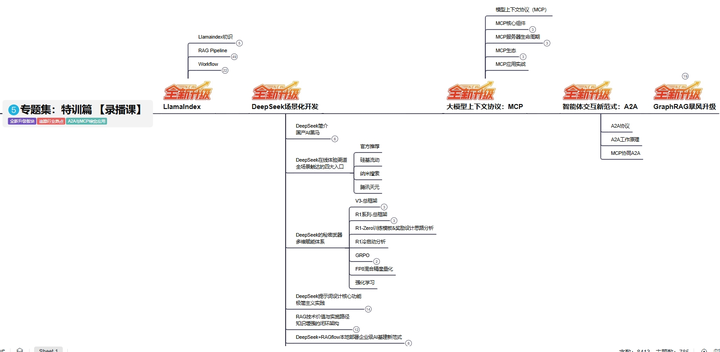
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份
不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:
👇👇扫码免费领取全部内容👇👇
2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!
 383


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


