


在AI时代,深度研究能力已经成为了许多专业人士的刚需。ChatGPT的研究功能虽然强大,但往往受限于网络访问和数据隐私的考量。今天,我将带你一步步构建一个完全本地化的深度研究工具,它不仅能够实现ChatGPT级别的研究能力,还能确保你的数据安全和隐私保护。
一、为什么选择本地化方案?
在实际工作中,我经常遇到这样的场景:需要对敏感话题进行深度研究,或者在网络环境受限的情况下仍需要高质量的信息检索和分析。传统的在线AI工具虽然便捷,但存在几个明显的痛点:
- 数据隐私担忧:你的查询内容会被上传到云端
- 网络依赖性:离线环境下无法使用
- 定制化限制:难以根据特定需求调整研究流程
基于这些考量,我决定构建一个基于MCP(Model Context Protocol)的本地化研究工具。
二、技术架构设计
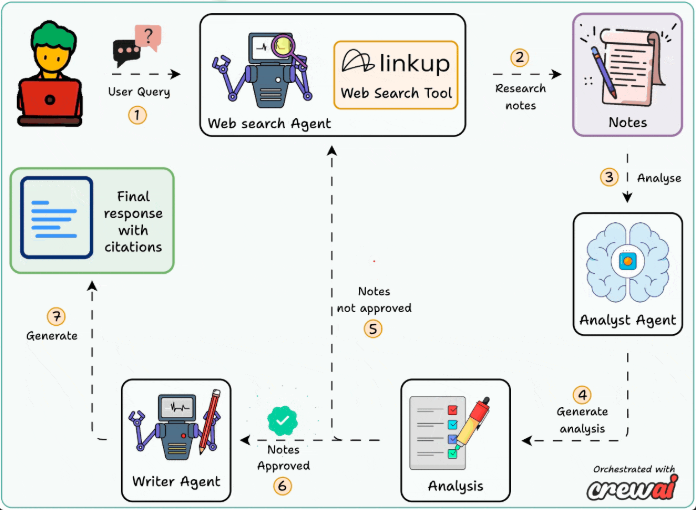
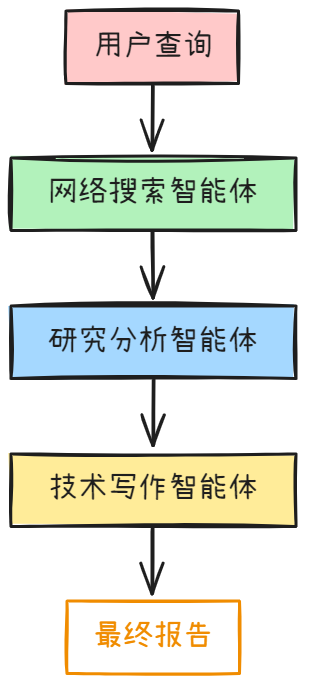
整个系统采用多智能体协作的架构,就像一个专业的研究团队:
核心技术栈包括:
- Linkup:提供企业级的网络搜索能力
- CrewAI:实现多智能体的协同工作
- Ollama + DeepSeek-R1:本地部署的大语言模型
- Cursor + MCP:作为统一的交互界面
三、动手实现:从代码到实战
第一步:环境准备
首先,我们需要安装必要的依赖包:
pip install crewai linkup-sdk ollama mcp
接下来部署DeepSeek-R1模型:
ollama pull deepseek-r1:latest
第二步:定义网络搜索工具
Linkup提供了媲美Perplexity和OpenAI的搜索能力。让我们先封装一个搜索工具:
import os
from linkup import LinkupClient
from crewai_tools import BaseTool
from typing import Type
from pydantic import BaseModel, Field
class SearchInput(BaseModel):
"""搜索输入模型"""
query: str = Field(..., description="搜索查询内容")
depth: str = Field(default="standard", description="搜索深度:basic, standard, deep")
class LinkupSearchTool(BaseTool):
name: str = "linkup_search"
description: str = "使用Linkup进行深度网络搜索,获取最新和最相关的信息"
args_schema: Type[BaseModel] = SearchInput
def __init__(self, **kwargs):
super().__init__(**kwargs)
# 初始化Linkup客户端
self.client = LinkupClient(api_key=os.getenv("LINKUP_API_KEY"))
def _run(self, query: str, depth: str = "standard") -> str:
"""执行搜索操作"""
try:
# 调用Linkup API进行搜索
response = self.client.search(
query=query,
depth=depth,
output_type="structured"
)
# 格式化搜索结果
results = []
for item in response.get('results', []):
result = {
'title': item.get('title', ''),
'url': item.get('url', ''),
'content': item.get('content', ''),
'published_date': item.get('published_date', ''),
'relevance_score': item.get('relevance_score', 0)
}
results.append(result)
return self._format_results(results)
except Exception as e:
return f"搜索过程中出现错误: {str(e)}"
def _format_results(self, results) -> str:
"""格式化搜索结果为可读文本"""
formatted = "=== 搜索结果 ===\n\n"
for i, result in enumerate(results[:10], 1):  # 限制为前10个结果
formatted += f"## 结果 {i}\n"
formatted += f"**标题**: {result['title']}\n"
formatted += f"**链接**: {result['url']}\n"
formatted += f"**发布日期**: {result['published_date']}\n"
formatted += f"**相关度**: {result['relevance_score']:.2f}\n"
formatted += f"**内容摘要**: {result['content'][:500]}...\n\n"
return formatted
第三步:构建智能体团队
现在让我们创建三个专业的智能体:
from crewai import Agent, Task, Crew, Process
# 配置本地LLM
def get_local_llm():
return {
"model": "ollama/deepseek-r1",
"base_url": "http://localhost:11434"
}
# 网络搜索智能体
search_agent = Agent(
role='网络搜索专家',
goal='根据用户查询从互联网获取最新、最相关的信息',
backstory='''你是一位经验丰富的信息检索专家,擅长使用各种搜索策略
找到最有价值的信息源。你深知如何构造有效的搜索查询,
并能够识别高质量的信息来源。''',
tools=[LinkupSearchTool()],
llm=get_local_llm(),
verbose=True,
allow_delegation=False
)
# 研究分析智能体
research_agent = Agent(
role='研究分析师',
goal='将原始搜索结果转化为结构化的分析报告',
backstory='''你是一位资深的研究分析师,具备强大的信息整合能力。
你能够识别信息的可靠性,去除重复内容,并将散乱的信息
整理成逻辑清晰的分析框架。''',
llm=get_local_llm(),
verbose=True,
allow_delegation=True  # 允许委托搜索智能体进行事实核查
)
# 技术写作智能体
writer_agent = Agent(
role='技术写作专家',
goal='将研究分析结果整合成专业、易读的报告',
backstory='''你是一位专业的技术写作专家,擅长将复杂的信息
转化为清晰、结构化的文档。你注重引用的准确性,
并能够以读者友好的方式呈现技术内容。''',
llm=get_local_llm(),
verbose=True,
allow_delegation=False
)
def create_research_crew(query: str):
"""创建研究团队并定义任务"""
# 搜索任务
search_task = Task(
description=f'''
对以下查询进行全面的网络搜索:"{query}"
要求:
1. 使用多个相关的搜索关键词
2. 寻找最新的信息(优先考虑近期发布的内容)
3. 收集来自不同来源的信息以确保全面性
4. 记录每个信息来源的URL和发布日期
输出格式:结构化的搜索结果列表,包含标题、链接、摘要和发布时间
''',
agent=search_agent,
expected_output="详细的搜索结果列表,包含至少5-10个高质量信息源"
)
# 分析任务
analysis_task = Task(
description=f'''
基于搜索结果,对查询"{query}"进行深度分析:
分析要求:
1. 验证信息的准确性和可靠性
2. 识别并去除重复或矛盾的信息
3. 按主题对信息进行分类整理
4. 标注信息来源和发布时间
5. 如需要,可以委托搜索智能体进行补充调研
输出格式:结构化的分析报告,包含关键发现、数据支撑和来源引用
''',
agent=research_agent,
expected_output="结构化的研究分析报告,包含关键洞察和完整的引用信息",
context=[search_task]  # 依赖搜索任务的结果
)
# 写作任务
writing_task = Task(
description=f'''
基于研究分析结果,撰写关于"{query}"的综合性报告:
报告要求:
1. 清晰的结构:摘要、主要发现、详细分析、结论
2. 每个关键观点都要有可靠的引用支撑
3. 使用专业但易懂的语言
4. 包含完整的参考文献列表
5. 总字数控制在2000-3000字
格式要求:使用Markdown格式,便于后续处理和展示
''',
agent=writer_agent,
expected_output="专业的Markdown格式研究报告,包含完整引用和参考文献",
context=[analysis_task],  # 依赖分析任务的结果
output_file=f"research_report_{query.replace(' ', '_')}.md"
)
# 创建研究团队
crew = Crew(
agents=[search_agent, research_agent, writer_agent],
tasks=[search_task, analysis_task, writing_task],
process=Process.sequential,  # 顺序执行任务
verbose=True
)
return crew
第四步:封装为MCP服务器
现在我们将整个研究系统封装为一个MCP服务器:
from mcp.server import Server
from mcp.server.models import InitializationOptions
import mcp.server.stdio
from mcp.types import Tool, TextContent
import asyncio
import json
class ResearchMCPServer:
def __init__(self):
self.server = Server("deep-research-tool")
self.setup_tools()
def setup_tools(self):
"""设置MCP工具"""
@self.server.list_tools()
async def handle_list_tools():
"""列出可用工具"""
return [
Tool(
name="deep_research",
description="使用多智能体系统进行深度网络研究",
inputSchema={
"type": "object",
"properties": {
"query": {
"type": "string",
"description": "研究查询内容"
},
"depth": {
"type": "string",
"enum": ["basic", "standard", "deep"],
"description": "研究深度级别",
"default": "standard"
}
},
"required": ["query"]
}
)
]
@self.server.call_tool()
async def handle_call_tool(name: str, arguments: dict):
"""处理工具调用"""
if name == "deep_research":
return await self.execute_research(
arguments.get("query", ""),
arguments.get("depth", "standard")
)
else:
raise ValueError(f"Unknown tool: {name}")
async def execute_research(self, query: str, depth: str):
"""执行深度研究"""
try:
# 设置搜索深度
os.environ["SEARCH_DEPTH"] = depth
# 创建研究团队
crew = create_research_crew(query)
# 执行研究任务
result = crew.kickoff()
# 返回结果
return [TextContent(
type="text",
text=f"""# 深度研究报告
## 查询内容
{query}
## 研究深度
{depth}
## 研究结果
{result}
---
*本报告由本地化多智能体研究系统生成*
"""
)]
except Exception as e:
return [TextContent(
type="text",
text=f"研究过程中出现错误: {str(e)}"
)]
async def run(self):
"""运行MCP服务器"""
async with mcp.server.stdio.stdio_server() as (read_stream, write_stream):
await self.server.run(
read_stream,
write_stream,
InitializationOptions(
server_name="deep-research-tool",
server_version="1.0.0"
)
)
# 启动MCP服务器
if __name__ == "__main__":
server = ResearchMCPServer()
asyncio.run(server.run())
第五步:集成到Cursor
最后一步是将我们的MCP服务器集成到Cursor中。创建一个配置文件 mcp_config.json:
{
"mcpServers": {
"deep-research-tool": {
"command": "python",
"args": ["path/to/your/research_server.py"],
"env": {
"LINKUP_API_KEY": "your_linkup_api_key_here"
}
}
}
}
在Cursor中的配置路径: File → Preferences → Cursor Settings → MCP → Add new global MCP server
将配置文件的内容添加到MCP设置中。
四、实战测试
现在让我们测试一下我们的研究工具。在Cursor中输入:
使用深度研究工具调研"2025年人工智能在医疗诊断领域的最新进展"
系统会自动:
- 通过网络搜索智能体收集相关信息
- 由研究分析智能体进行信息验证和整理
- 技术写作智能体生成最终的研究报告
五、优势与特色
与传统的在线研究工具相比,我们的本地化方案具有以下优势:
- 隐私保护:所有数据处理都在本地进行,确保敏感信息不会泄露。
- 可定制性:你可以根据具体需求调整搜索策略、分析维度和报告格式。
- 成本控制:除了Linkup的搜索费用外,其他所有计算都在本地完成,长期使用成本更低。
- 离线能力:一旦部署完成,除了网络搜索环节,其他分析和写作都可以在离线环境下进行。
六、扩展思路
这个基础框架还有很多扩展的可能:
- 专业化定制:针对不同领域(如法律、医疗、金融)创建专门的智能体
- 数据源集成:接入更多的数据源,如学术数据库、企业内部文档等
- 多语言支持:扩展为支持多语言的研究工具
- 结果可视化:增加图表和数据可视化功能
七、总结
通过这个项目,我们成功构建了一个功能完整的本地化深度研究工具。它不仅具备了与ChatGPT相媲美的研究能力,还在隐私保护和定制化方面具有明显优势。
整个系统的核心在于多智能体的协作:每个智能体都专注于自己擅长的领域,通过合理的任务分工和数据流转,最终产出高质量的研究报告。
如果你也在寻找一个可控、安全、可定制的研究工具,不妨试试这个方案。相信它会成为你研究工作中的得力助手。
想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!
👇👇扫码免费领取全部内容👇👇

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势
想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:
1. 100+本大模型方向电子书

2. 26 份行业研究报告:覆盖多领域实践与趋势
报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

- 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
- 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
- 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
- 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。
3. 600+套技术大会 PPT:听行业大咖讲实战
PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

- 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
- 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
- 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
- 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。
二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走
想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位
面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点
针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题
专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:

三、路线必明: AI 大模型学习路线图,1 张图理清核心内容
刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

L5阶段:专题集丨特训篇 【录播课】

四、资料领取:全套内容免费抱走,学 AI 不用再找第二份
不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:
👇👇扫码免费领取全部内容👇👇
2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!
 688


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


