


何为Adaptive Rag
大模型虽博闻强记,但其内部知识可能过时、不完整或包含错误,无法回答训练数据之外的最新或专业问题,而RAG可通过从外部知识库检索相关信息为其“补充资料”,使其能生成更准确、更及时、来源可追溯的回答,但随着传统Rag问题不足显现,开始传统rag进行不断升级优化,当然优化方法和策略有很多,本篇介绍一下自适应Adaptive Rag。
Adaptive RAG(Adaptive Retrieval-Augmented Generation,自适应检索增强生成)是传统 RAG 技术的优化升级版,核心是根据查询特征(问题类型)、文档属性、检索结果质量等动态调整流程策略(动态调整块大小、质量分重新检索),以解决传统 RAG 中 “一刀切” 模式的局限性(文档块是固定的,不会根据用户的问题,动态滑块大小,如面对复杂查询处理能力弱、检索精度不稳定等),流程图如下:
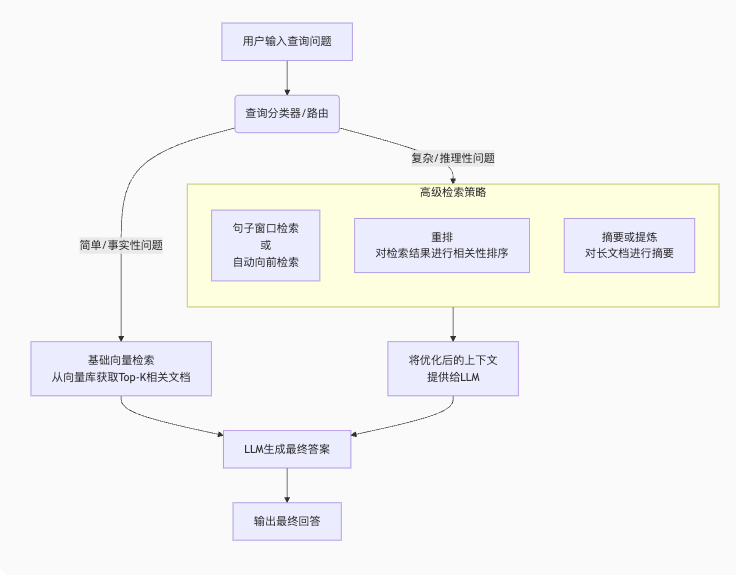
STEP1:问题输入与分类
根据用户提交一个自然语言问题。系统首先使用一个分类器 或路由来判断问题的复杂性。这个分类器使用LLM大模型根据提示词描述分类标签(总共分哪几类可以提示词来定义,如事实查询、推理查询、多意图查询等分类标签)。
STEP2:根据STEP1分类结果路由路径
采用标准的、成本较低的**向量检索(笔者这里使用Chroma向量数据库),**将用户查询转换为向量。在向量数据库中执行相似性搜索(一般使用的是余弦相似度),获取 Top-K(3-5 个)最相关的文档片段。
不熟悉rag原理的,笔者这里不再赘述,有笔者往期完整自行查阅
-
复杂问题处理路径
启动更高级、更“昂贵”的检索策略,可能包括以下一种或多种: -
细化检索:
-
句子窗口检索: 不只检索一个句子,而是检索一个中心句子及其周围上下文窗口,提供更多背景信息。
-
自动向前检索 : 让 LLM 判断是否需要以及如何进行后续检索。例如,LLM 可能发现首次检索结果不足,它会自动生成一个新的、更精确的搜索查询进行二次检索。
-
重排: 使用更精细的交叉编码器模型对初步检索到的所有文档片段进行相关性重排,筛选出最相关的几个,提高上下文质量。
-
提炼: 如果检索到的文档片段过长或过多,可以先让 LLM 对这些内容进行摘要或提炼,再将摘要作为上下文,而不是原始长文本。
STEP3:生成答案
将最终确定的最佳上下文和用户原始查询一起组合成一个精心设计的提示词(Prompt),提交给大型语言模型)。LLM 基于提供的上下文生成准确、可靠的答案,并注明引用来源(Source),将生成的最终答案返回给用户。
Adaptive Rag优点
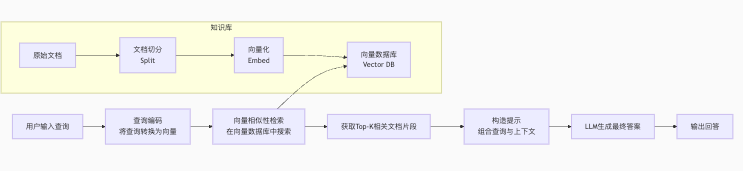
上述讲解了自适应Rag的原理,这里比较下传统Rag与Adaptive Rag自适应Rag优点,以下是两者处理流程对比,如下图:
传统Rag的处理流程:
Adaptive Rag的处理流程:
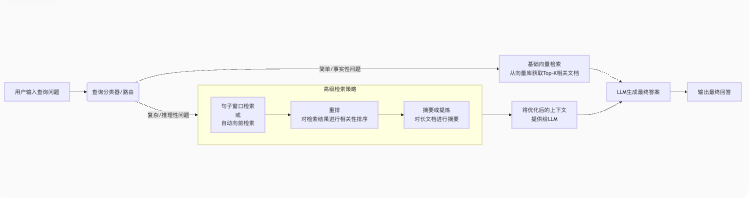
通过两者的流程图对比,Adaptive RAG多了很多处理模块,对问题归类,动态调整参数,做更精细化问题回答,其相比传统 RAG 的核心优点:
- 动态适配查询类型(事实 / 推理 / 多意图),对复杂查询的处理更精准;
- 可根据检索结果质量实时调整策略(如重写查询、扩大召回),减少漏检误检;
- 能结合文档特征(长度 / 结构)优化分块和检索逻辑,提升长文档理解能力;
- 通过 “感知 - 决策 - 执行” 闭环,解决传统 RAG “一刀切” 模式的局限性,整体回答质量更稳定。
其实Adaptive RAG还可以做得更精细化些,就是对知识库文档内容提炼,索引的编写,问题预判和整理,还有Rerank排名模型的使用。当然以上优化,相对于传统Rag精确度、动态性优化已经提升很多。
Adaptive Rag代码实现
代码实现部分,本篇使用的环境是conda、langchain框架、chroma向量数据库、ollama本地部署Deepseek-r1作为问题分类模型和最后生成模型。
介绍完环境准备,进入代码功能讲解(以下代码环境准备好是粘贴可运行的):
- 准备rag基础环境:文档准备、基础分块配置,加载数据、大模型定义等
- 准备分类器函数:用llm给用户问题进行标签分类(提示词可定义)
- 依据分类器标签类型,动态调整往向量数据库加载文档块大小参数
- 依据分类器标签类型,动态调整向量数据库检索策略参数
- 自适应模块编写:通过检索结果评分判断,再次调整提示词等,再次优化检索
- 模块组装运行并运行测试
step1: 准备rag基础环境
from langchain_community.document_loaders import TextLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_community.vectorstores import Chroma
from langchain_ollama import OllamaEmbeddings
from langchain_community.llms import Ollama
from langchain.chains import RetrievalQA
# 1. 加载文档
loader = TextLoader("/Users/houyi/rag/dify_introduce.txt")
docs = loader.load()
# 2. 基础分块(后续会动态调整)
text_splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
splits = text_splitter.split_documents(docs)
# 3. 向量存储
embeddings = OllamaEmbeddings(model="nomic-embed-text")
vectorstore = Chroma.from_documents(documents=splits, embedding=embeddings)
# 4. 基础检索+生成链
llm = Ollama(model="deepseek-r1")
basic_rag_chain = RetrievalQA.from_chain_type(
llm=llm,
chain_type="stuff",
retriever=vectorstore.as_retriever()
)
step2:准备分类器函数
def classify_query(query: str, llm) -> str:
"""写提示词:告诉llm将查询分为:事实查询(factual)、推理查询(inferential)、多意图查询(multi_intent)仅有这个返回值"""
prompt = f"""分析以下查询的类型,仅返回标签(factual/inferential/multi_intent):
查询:{query}
"""
return llm.predict(prompt).strip()  #大模型实例predict生产文本内容,strip()清洗。return llm.predict(prompt).strip()  #大模型实例predict生产文本内容,strip()清洗。
step3:依据分类器标签类型,动态调整往向量数据库加载文档块大小参数
def adaptive_chunking(docs, query_type):
# 动态分块逻辑
if query_type == "inferential" or any(len(doc.page_content) > 5000 for doc in docs):
text_splitter = RecursiveCharacterTextSplitter(chunk_size=300, chunk_overlap=100)
else:
text_splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
adapted_docs = text_splitter.split_documents(docs)    # 生成与文档对应的唯一ID(可基于原文档元数据+分块索引)
ids = [f"{doc.metadata.get('source')}_{i}" for i, doc in enumerate(adapted_docs)]    # 正确更新文档:同时传入ids和documents
vectorstore.update_documents(ids=ids, documents=adapted_docs)
return adapted_docs
step4:依据分类器标签类型,动态调整向量数据库检索策略参数
def adaptive_retrieval(query: str, query_type: str, vectorstore, llm):
if query_type == "factual":
# 事实查询:精准检索(小范围+高相似度)
retriever = vectorstore.as_retriever(
search_kwargs={"k": 3, "score_threshold": 0.8}  # 只取前3个高相关结果
}
return retriever.get_relevant_documents(query)
elif query_type == "inferential":
# 推理查询:扩大召回+LLM重排序
retriever = vectorstore.as_retriever(search_kwargs={"k": 10})  # 先取10个候选
candidates = retriever.get_relevant_documents(query)    # 用LLM对候选文档打分(1-5分),保留前5个高分文档
scored_docs = []
for doc in candidates:
score_prompt = f"文档:{doc.page_content}\n查询:{query}\n文档与查询的相关性(1-5分):"
score = int(llm.predict(score_prompt).strip())
scored_docs.append((doc, score))
return [doc for doc, score in sorted(scored_docs, key=lambda x: x[1], reverse=True)[:5]]
elif query_type == "multi_intent":
# 多意图查询:拆分子问题
split_prompt = f"将查询拆分为独立子问题,每行一个:{query}"
sub_queries = llm.predict(split_prompt).split("\n")
all_docs = []
for sub_q in sub_queries:
if sub_q.strip():
sub_docs = vectorstore.as_retriever(search_kwargs={"k": 2}).get_relevant_documents(sub_q)
all_docs.extend(sub_docs)
return all_docs
step5:生成阶段自适应,通过检索结果评分判断,再次调整提示词等,再次优化检索
def adaptive_generation(query, docs, llm):
# 评估检索结果质量(简化:计算平均相关性分数)
avg_score = sum(doc.metadata.get("score", 0) for doc in docs) / len(docs) if docs else 0
if avg_score < 0.6:
# 结果质量低:重写查询后再次检索
rewrite_prompt = f"优化查询使其更易检索相关信息:{query}→"
better_query = llm.predict(rewrite_prompt)
docs = vectorstore.as_retriever().get_relevant_documents(better_query)
# 生成回答(根据查询类型调整prompt)
if "inferential" in classify_query(query,llm):
prompt = f"基于以下文档推理回答(需说明逻辑):{docs}\n查询:{query}"
else:
prompt = f"基于以下文档直接回答:{docs}\n查询:{query}"
return llm.predict(prompt)
step6:把以上内容组装起来并运行测试
def adaptive_rag_pipeline(query: str):
# 1. 查询分类
query_type = classify_query(query, llm)
# 2. 动态分块(针对原始文档)
adaptive_chunking(docs, query_type)
# 3. 动态检索
relevant_docs = adaptive_retrieval(query, query_type, vectorstore, llm)
# 4. 自适应生成
answer = adaptive_generation(query, relevant_docs, llm)
return answer
# 测试
print(adaptive_rag_pipeline("dify用途是什么?"))
adaptive rag经过上述优化升级测试,效果确实比传统rag从回答问题的完整性和准确性都有很大的提升。当然adaptive rag还有优化空间的,如从文档内容提炼优化、再增加rerank模型、提示词等优化点。
写在最后
本篇对传统rag知识库进行升级介绍Adaptive Rag知识库,其增加内容提炼、问题分类、文本块大小根据问题类型进行动态调整,以及根据检索质量评分,依据评分结果高低再自动决策是否二次检索。自适应rag从回答问题完整性和准确性都很有大提升。
想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!
👇👇扫码免费领取全部内容👇👇

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势
想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:
1. 100+本大模型方向电子书

2. 26 份行业研究报告:覆盖多领域实践与趋势
报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

- 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
- 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
- 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
- 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。
3. 600+套技术大会 PPT:听行业大咖讲实战
PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

- 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
- 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
- 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
- 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。
二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走
想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位
面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点
针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题
专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:

三、路线必明: AI 大模型学习路线图,1 张图理清核心内容
刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

L5阶段:专题集丨特训篇 【录播课】

四、资料领取:全套内容免费抱走,学 AI 不用再找第二份
不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:
👇👇扫码免费领取全部内容👇👇
2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!
 909


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


