大模型 “失忆”?用 RAG 解决!核心技术细节 + 落地逻辑全揭秘,大模型入门到精通,收藏这篇就足够了!

Claude Code长期记忆:优雅的上下文管理 ClaudeCode的上下文管理系统采用三层架构设计,通过智能压缩和优化策略在记忆容量与性能间取得平衡。系统包含短期记忆(高速工作区)、中期记忆(智能蒸馏器)和长期记忆(持久化知识库)。当Token使用率达到92%阈值时启动wU2压缩器,采用8段式结构化摘要保留关键信息,并配合智能文件恢复和渐进式预警机制。该系统通过分层处理、优雅降级和透明化交互,为AI应用提供了高效可靠的上下文管理方案,展现了在有限资源下实现智能记忆的艺术。 阅读详情

Agent作为 “智能任务执行者”,需具备动态决策、多场景适配能力,但受限于大语言模型(LLM)的固有缺陷,常面临两大核心痛点:

  1. 知识固化:LLM 预训练知识有 “截止期”,无法实时获取新信息(如 Agent 难回答 “2025年最新行业政策”“昨日股市异动原因”);
  2. 推理无依据:复杂任务(如医疗诊断、法律分析)中,Agent 易 “拍脑袋决策”,生成无事实支撑的 “幻觉” 内容,难以满足专业场景需求。
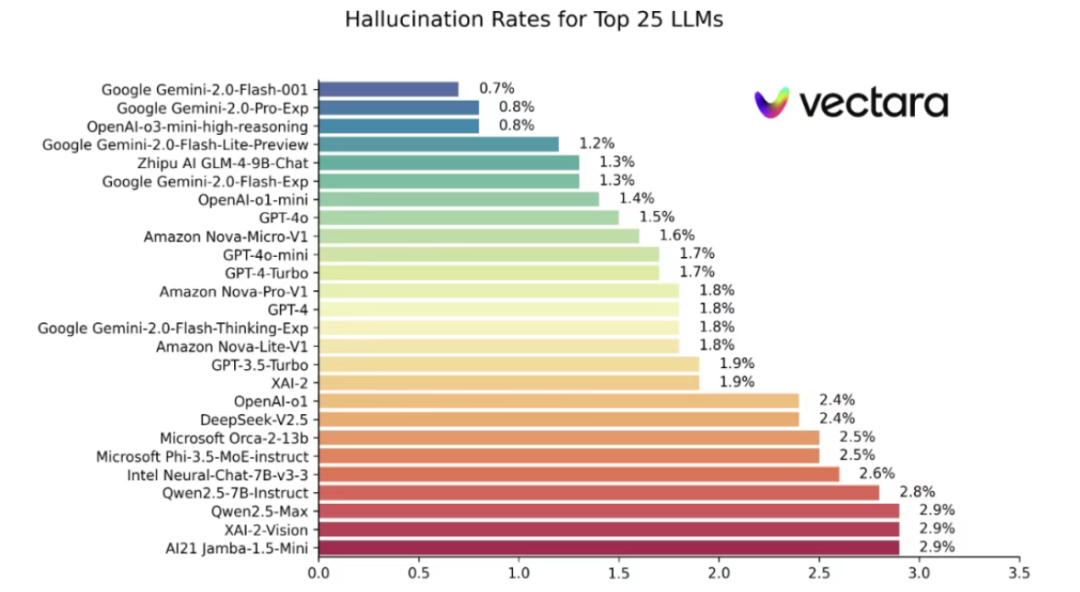
而RAG(Retrieval-Augmented Generation,检索增强生成) 正是解决这些痛点的关键技术 —— 它让 Agent 在决策前先从外部知识库 “检索” 精准、实时的信息,再结合这些信息生成有依据的结果,相当于为 Agent 配备了 “动态知识外挂”,广泛用于智能问答、企业知识库、Agent 系统等场景。

一、RAG技术实现一般流程

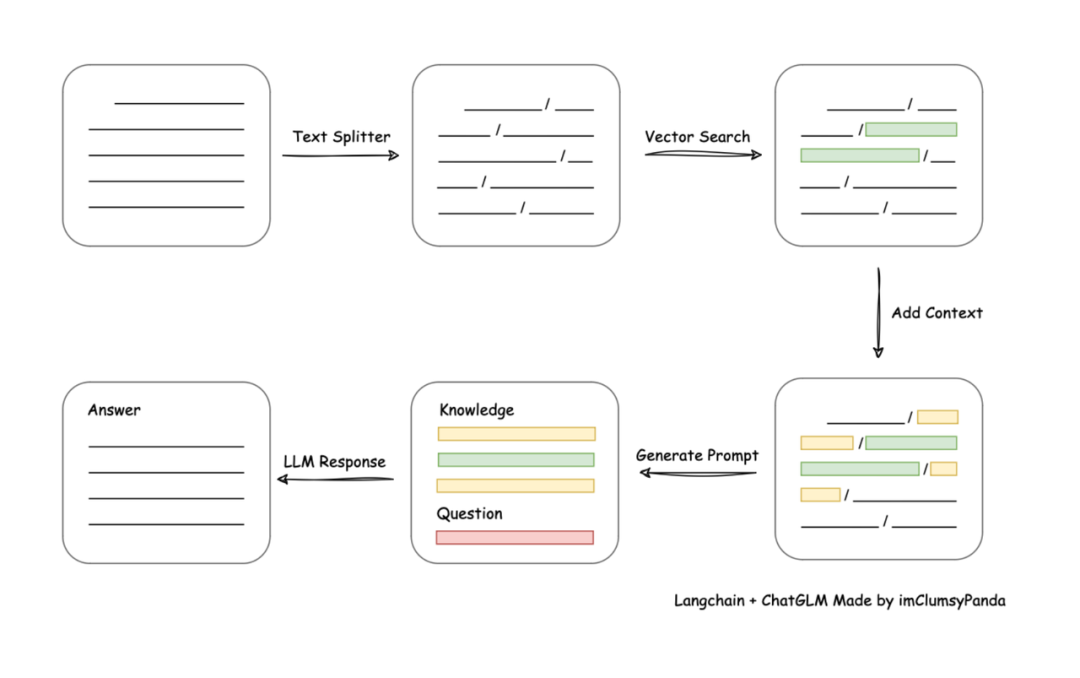
完整的文档检索增强问答流程(RAG)可拆解为四个核心步骤,具体如下:

1、文档预处理:拆分长文本

2、向量转化:统一数据格式

3、相似度匹配:定位相关片段

4、答案生成:结合大模型输出
二、关键技术细节

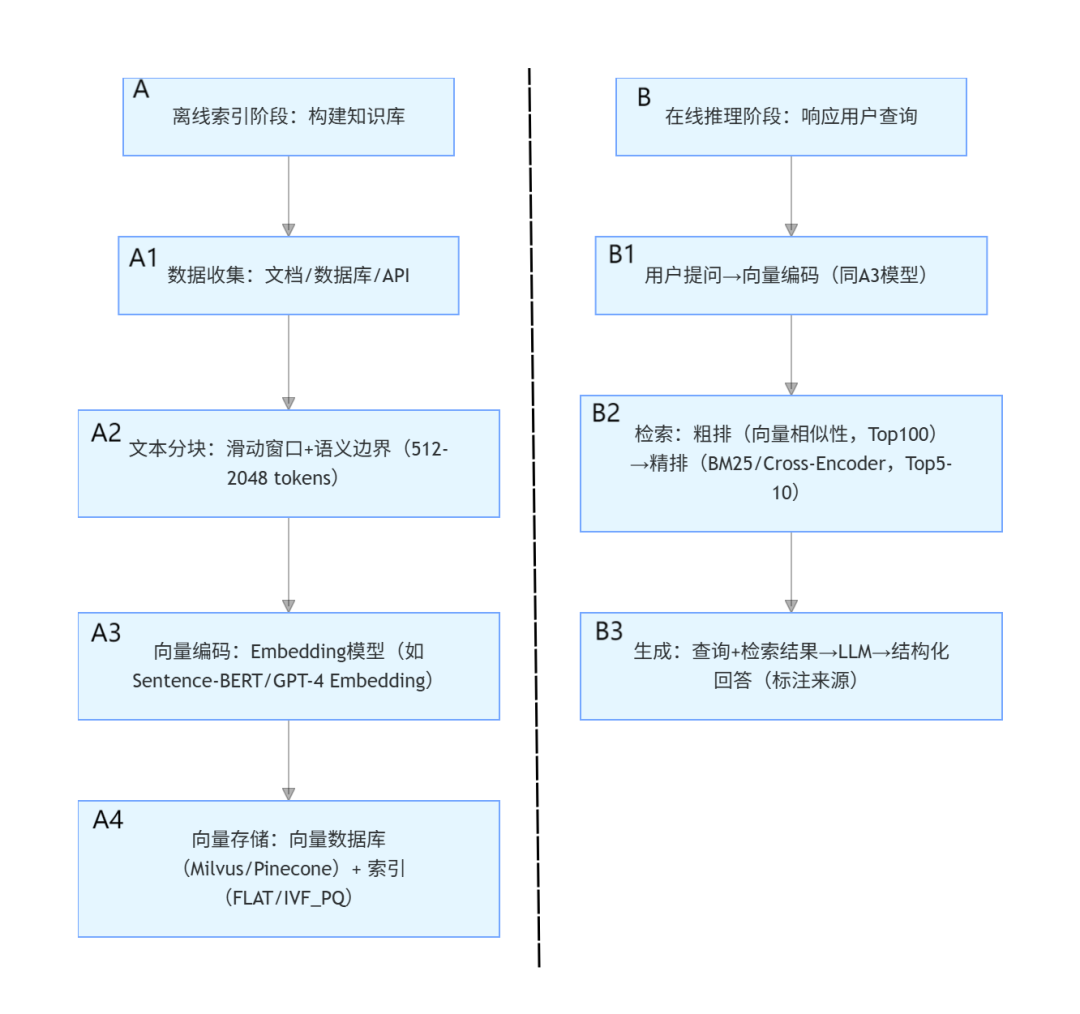
1. 离线索引:打好 “知识地基”

  • 文本分块:按语义拆分长文档,短文本(FAQ)用 512 tokens 窗口,长文档(技术手册)用 1024-2048 tokens,靠 spaCy 等工具保证句子完整。
  • 向量编码:轻量场景选 Sentence-BERT(速度快、显存 < 1GB),高精度场景用 GPT-4 Embedding(语义准但成本高),领域场景微调专用模型(如医疗用 BioBERT)。
  • 向量存储:选支持 ANN(近似最近邻)的数据库,数据量 <100 万条用 Milvus(开源)+FLAT 索引,>100 万条用 IVF_PQ 索引,快速上线选 Pinecone(托管式)。

2. 在线推理:精准 “检索 + 生成”

  • 检索策略:先粗排(余弦相似度 / 欧氏距离,50ms 内筛 Top100),再精排(轻量用 BM25 关键词匹配,高精度用 Cross-Encoder 细粒度计算),最终取 Top5-10 结果。
  • 生成控制:Prompt 格式为 “查询 + 检索结果(标来源)+ 指令”,严格控制长度(如 GPT-3.5 限 4k tokens),用领域数据微调 LLM(如医疗输出 “建议 + 文献”)。
三、向量算法选择指南

RAG 技术中,向量算法主要用于向量编码和向量检索两大环节,选择需结合数据量、精度需求、成本预算综合判断:

应用环节算法类型代表算法适用场景优缺点选型建议
向量编码通用 EmbeddingSentence-BERT(all-MiniLM)轻量场景(客服 FAQ、小型知识库)优点:速度快、显存占用低(<1GB)、免费;缺点:复杂语义捕捉弱数据量 < 100 万条、精度要求一般,优先选
向量编码大模型 EmbeddingGPT-4 Embedding、Claude Embedding高精度场景(医疗诊断、法律分析)优点:语义理解强、领域适配性好;缺点:调用成本高、依赖 API关键业务(如医疗决策)、预算充足,必选
向量编码领域 EmbeddingBioBERT(医疗)、FinBERT(金融)垂直领域(医疗文献、金融研报)优点:领域术语理解准、误差率低;缺点:需领域数据微调垂直领域场景,有标注数据时优先微调使用
向量检索精确检索算法FLAT(暴力搜索)小数据量(<10 万条)、高精度需求(如科研)优点:检索无误差、结果 100% 准确;缺点:速度慢(百万级数据超 1s)数据量小、追求绝对精度(如学术检索)
向量检索近似检索算法IVF_PQ(聚类 + 量化)大数据量(>100 万条)、实时性需求(如 Agent)优点:速度快(亿级数据 < 100ms)、内存占用低;缺点:精度损失 5%-10%数据量大、实时交互(如 Agent 响应 < 300ms)
向量检索混合检索算法向量 + BM25关键词 + 语义结合场景(如电商商品检索)优点:兼顾关键词匹配与语义理解;缺点:需额外维护关键词索引用户查询含明确关键词(如 “2024 款手机参数”)

选型核心依据:

  1. 数据量:<10 万条选精确算法(FLAT),>100 万条选近似算法(IVF_PQ);
  2. 精度优先级:核心业务(医疗 / 法律)用大模型 Embedding + 混合检索,非核心业务用通用 Embedding;
  3. 成本预算:免费 / 低成本场景用开源算法(Sentence-BERT+Milvus),高预算场景用托管服务(GPT-4 Embedding+Pinecone)。

四、向量数据库选择指南

向量数据库是 RAG 知识存储的核心载体,选择需围绕数据规模、部署方式、实时性、成本四大核心维度,主流数据库对比与选型逻辑如下:

1. 主流向量数据库核心参数对比

数据库名称部署模式数据量支持核心优势适用场景成本(参考)
Milvus开源(自部署)、云托管(Zilliz Cloud)亿级向量支持多索引(FLAT/IVF_PQ/HNSW)、多模态存储、高扩展性企业级场景(如医疗知识库、工业质检)、需私有化部署自部署:硬件成本 + 运维成本;云托管:按需付费(约 $0.1/GB/ 月)
Pinecone托管服务(无自部署)亿级向量开箱即用、自动扩缩容、低延迟(P99<100ms)快速上线场景(如创业公司客服、轻量 Agent)、无运维资源按向量数量 + 查询次数计费(约万向量月0.01/1000 查询)
Elasticsearch开源(自部署)、云托管(Elastic Cloud)千万级向量支持 “向量 + 关键词” 混合检索、全文检索能力强需关键词匹配的场景(如电商商品检索、文档搜索)自部署:中;云托管:约 $0.15/GB/ 月
Qdrant开源(自部署)、云托管(Qdrant Cloud)亿级向量轻量级部署、支持地理空间检索、API 友好中小规模场景(如个人项目、小型企业知识库)、需地理信息结合自部署:低;云托管:约 $0.08/GB/ 月
Weaviate开源(自部署)、云托管(Weaviate Cloud Services)亿级向量内置 Embedding 能力、支持知识图谱关联需知识图谱融合的场景(如法律案例关联、学术文献分析)自部署:中;云托管:约 $0.12/GB/ 月

2. 场景化选型指南

(1)按数据量选型
  • 小数据量(<100 万条向量):优先选 Qdrant(轻量易部署)、Elasticsearch(需混合检索);
  • 中大数据量(100 万 - 1 亿条):选 Milvus(开源灵活)、Pinecone(托管省心);
  • 超大规模(>1 亿条):必选 Milvus(分布式扩展能力强)、Pinecone(自动扩缩容)。
(2)按部署需求选型
  • 私有化部署(需数据本地化):仅选开源方案 ——Milvus(企业级)、Qdrant(中小规模)、Weaviate(知识图谱);
  • 无运维资源(纯托管):选 Pinecone(最快上线)、Zilliz Cloud(Milvus 托管版)、Weaviate Cloud。
(3)按核心需求选型
  • 实时性优先(Agent 交互、低延迟):Pinecone(P99<100ms)、Milvus(优化后 P99<200ms);
  • 混合检索(向量 + 关键词):Elasticsearch(原生支持)、Weaviate(内置混合检索);
  • 知识图谱融合:Weaviate(强关联能力)、Milvus(可对接外部知识图谱工具)。

3. 选型避坑点

  • 避免盲目追求 “亿级支持”:小数据量用 Qdrant 比 Milvus 更节省资源;
  • 托管服务注意成本陷阱:Pinecone 查询次数多会导致费用飙升,需评估查询量(如日均 < 10 万次可选,超 100 万次建议自部署 Milvus);
  • 多模态场景优先选 Milvus/Weaviate:Qdrant、Elasticsearch 在多模态(如文本 + 图像向量)支持上较弱。

五、RAG 优化策略

RAG 落地后需持续优化,核心围绕检索精度、性能效率、生成质量三大维度,具体方法如下:

1. 检索精度优化(核心目标:召回率 > 90%,准确率 > 85%)

  • 分块策略优化:

    长文档用 “动态分块” 替代固定窗口 —— 根据文档结构(如章节标题、段落逻辑)拆分,结合 “重叠窗口”(相邻分块重叠 20%-30% tokens),避免关键信息割裂(如技术手册中 “安装步骤” 分块不跨步骤拆分)。

  • Embedding 增强:

    对领域数据微调 Embedding 模型(如用医疗问答数据微调 BioBERT),或采用 “查询扩展”(将用户问题生成 3-5 个相似表述,再做向量编码取平均值),提升语义匹配精度。

  • 检索链路优化:

    引入 “多阶段检索”—— 先按向量粗排(Top200),再用 Cross-Encoder 精排(Top10),最后叠加 “知识过滤”(过滤与领域无关的检索结果,如医疗场景过滤非医学文献)。

2. 性能效率优化(核心目标:检索响应 < 300ms,成本降低 30%)

  • 缓存机制设计:

    用 Redis 缓存高频查询结果(如客服 FAQ 中 “退货政策”),缓存有效期按知识更新频率设置(静态知识 12 小时,动态知识 10 分钟),命中率目标 > 70%;

    对向量编码结果缓存(相同文本无需重复编码),降低 Embedding 调用成本。

  • 向量数据库优化:

    索引参数调优 ——IVF_PQ 索引的 “聚类数” 设为数据量的平方根(如 100 万条数据设 1000 个聚类),“量化位数” 选 8bit(平衡精度与速度);

    分片存储 —— 大数据量场景按 “时间 / 领域” 分片(如金融数据按季度分片),减少单分片检索压力。

  • 计算资源调度:

    非高峰时段(如凌晨)批量处理文档分块与向量编码,高峰时段(如客服早高峰)扩容向量数据库读节点,避免资源瓶颈。

3. 生成质量优化(核心目标:幻觉率 <5%,回答满意度> 90%)

  • Prompt 工程优化:

    生成阶段 Prompt 加入 “事实约束”(如 “仅基于检索到的文献回答,未提及的信息需说明‘未检索到相关内容’”),并标注检索结果来源(如 “来源:2024《罕见病诊疗指南》P128”),增强可解释性。

  • LLM 适配优化:

    用 RAG 相关数据(用户问题 + 检索结果 + 优质回答)微调 LLM(如用 LoRA 微调 Llama 2),让模型更擅长结合检索信息生成回答;

    复杂场景用 “多轮生成”—— 先让模型总结检索结果核心信息,再基于总结生成最终回答,避免信息冗余。

  • 反馈闭环建设:

    收集用户对回答的评分(1-5 星)与修正意见,对低评分案例(❤️ 星)分析原因(如检索结果不足、生成逻辑错误),反向优化检索策略与 Prompt 模板。

想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇

​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书

在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:


三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

ESP32设备驱动-AS5600磁性旋转位置传感器 AS5600 是一款可编程的 12 位高分辨率非接触式磁性旋转位置传感器。 AS5600可以作为磁性电位器或磁性编码器使用,具有出色的可靠性和耐用性。 与传统电位器/编码器相比,AS5600具有显着优势:高精度、非接触式、旋转角度无限制。 所有这些优点使其适用于非接触式角度测量应用,例如机器人手臂、云台、电机闭环控制、机床轴定位。 阅读详情

相关推荐

android+音乐节拍检测,科学网—音乐节拍跟踪或音乐节拍检测软件,LilyBeats alpha - 石自强的博文...

我们设计并实现了一种用于实时跟踪音乐节拍的软件。该软件可以用于智能灯方案提供商,为其提供灯光随音乐变化的核心解决方案。首先给出软件的下载链接:或者音乐节拍是乐曲中表示固定单位时值和强弱规律的组织形式,亦称拍子。它有两个特性:周期性和连续性。节拍周期性表现为节拍结构,是乐曲中周期性出现的节奏序列。节拍连续性表现为音乐的平均速度,其单位为bpm(beat per minute每分钟音乐节拍的个数)。音...

weixin_39571403的博客 1401

搭建RAG系统,主流向量数据库如何选择?如Milvus、Qdrant、Weaviate、FAISS、RediSearch等

在搭建RAG系统时,选择合适的向量数据库是至关重要的。向量数据库能够 高效地 存储和检索大规模的 向量数据,为RAG系统提供快速、准确的检索支持。今天针对当下主流的 Milvus、Qdrant、Weaviate、FAISS、RediSearch 等主流向量数据库,他们也都是 开源 的向量数据库,给大家简单介绍下,供您参考。Milvus支持多种高效的索引结构,如IVF、HNSW等,能够在 毫秒级响应 时间内完成相似性搜索。它采用 分布式架构,可以轻松应对大规模数据集的需求,支持水平扩展。

2401_85328934的博客 1840

从零到一:Qt与PCL的跨平台开发环境搭建全攻略

本文详细介绍了从零开始搭建Qt与PCL跨平台开发环境的完整流程,涵盖Windows、Linux和macOS三大平台。重点解析了Qt5与Qt6版本选择、PCL库安装配置、VTK集成等关键技术要点,并提供跨平台CMake项目模板和常见问题解决方案,助力开发者快速构建三维点云处理应用。

weixin_29280657的博客 384

向量数据库拥抱大模型

向量数据库的崛起与大模型时代的需求紧密相关,它为大模型提供了外部知识库的支持,增强了生成能力,支持向量嵌入,并解决了数据局限问题。

深数研究院 941

Android11 关于三方应用获取su权限

SELinux,全称Security-Enhanced Linux,是一种基于Linux内核的安全机制。它通过强制访问控制(MAC)来增强Linux系统的安全性,如果不禁用SELinux,完成下面的修改可能会导致设备进入Recovery界面!adb shell getenforce 为Permissive(宽容模式),查看报错日志,发现是客户apk想使用su命令提权,但是没有权限!对于保护系统资源和防止未经授权访问非常有帮助!系统这边做修改,让su权限下放到三方应用.客户的apk运行报错。

sinat_37429535的博客 1905

SQL注入:联合查询的三个绕过技巧

在SQL注入中,可以利用科学计数法来绕过对输入的限制。例如,可以使用科学计数法来绕过对字符串长度的限制,通过将字符串拆分成多个部分并使用科学计数法来表示。此外,还可以利用数据库的特定特性或语法来替代原始的查询语句,从而执行联合查询或其他恶意操作。另外,还可以尝试利用无列名注入的技巧,通过在原始查询中使用通配符或其他方式来绕过对列名的限制,从而执行恶意操作。

qq_68163788的博客 3795

一文解析大模型RAG技术(关键技术、向量数据库、RAG 优化策略)

RAG技术解决大模型Agent的知识固化与推理无依据痛点,通过文档预处理、向量转化、相似度匹配和答案生成四个步骤,结合离线索引和在线推理,使Agent获取最新准确信息。文章详解向量算法和数据库选择指南及优化策略,帮助开发者构建高效准确的RAG系统,提升大模型应用的专业性和可靠性。而。

star_nwe的博客 1514

电工识图入门:从电气符号到控制逻辑的完整指南

电工图纸是电气工程领域的通用语言,无论是设备安装、线路检修还是系统设计,看不懂图纸就像航海没有海图。很多初学者面对复杂的电气符号和线路走向感到无从下手,实际上只要掌握正确的识图方法,就能从简单的照明电路逐步过渡到复杂的自动化控制系统。 本文将从最基础的电气符号和图纸类型讲起,通过实际图纸案例解析,带你建立完整的识图逻辑。你将学会如何区分主回路和控制回路,如何追踪电流路径,以及如何结合图纸进行故障排查。无论你是电工新手、设备维护人员还是相关专业学生,这套方法都能帮你快速提升图纸理解能力。 1. 电气图纸基础:

chengyixian7877的博客 338

一篇详解当前流行的向量数据库,RAG系统中的向量数据库怎么选?

Pinecone 是一个全托管的云原生向量数据库,专为高性能向量搜索设计,支持实时数据处理和低延迟查询。Milvus 是一个开源向量数据库,基于 FAISS、Annoy 和 HNSW 等算法构建,专为高维向量搜索优化,支持多种索引类型。Weaviate 是一个开源向量数据库,支持混合搜索(向量搜索+传统关键字搜索),内置模块化架构,易于与AI模型集成。Elasticsearch 是一个基于 Lucene 的分布式搜索和分析引擎,通过插件支持向量搜索,适合需要结合结构化和非结构化数据的场景。

老皮的博客 1227

ECU-TEST笔记&使用技巧01

说明 1)所述均基于如下环境:ECU-TEST 8.0、Win10系统、NI Veristand 2018(HIL测试)。不排除因为版本及软件环境问题,所述方法不奏效或有更好的方法,欢迎交流,一起提高。 2)本博客以问答形式进行,所述问题均来自于实际测试(包括MIL、HIL测试)遇到的问题及需求,目的是提高测试效率和自动化测试序列的可维护性。 3)本博客尽量从测试方法及ECU-TEST原...

Eigrl的博客 1万+

C++设计模式之观察者模式

观察者模式(Observer Pattern)是一种行为设计模式,它定义了对象之间的一对多依赖关系,当一个对象状态发生变化时,所有依赖于它的对象都会得到通知并自动更新。这种模式通常用于实现分布式事件处理系统,当一个对象(称为“主题”或“发布者”)改变状态时,所有注册的观察者都会收到通知。

每天进步一点点。 602

企业级RAG的数据方案选择 - 向量数据库、图数据库和知识图谱

一个向量数据库以向量格式存储和维护数据。当数据准备存储时,它被分成100到200个字符的块。然后,通过一个嵌入模型,这些块被转换为可以存储在向量数据库中的向量嵌入。向量数据库有很多用例,但从定义上来说,并不是RAG的完整基础。大多数向量数据库并不提供嵌入模型,因此公司通常需要找到并集成一个嵌入模型,才能将向量数据库用作他们的基础。向量数据库的特性也因所使用的算法而异。向量数据库使用KNN(K最近邻)或ANN(近似最近邻)算法,每种算法对任何搜索和检索特性的最终结果都有不同的影响。

Python_cocola的博客 2656

ChangeMamba训练调试

此仓库的代码是在 Linux 系统下运行的。我们尚未测试是否能在其他操作系统下运行。 首先需要安装VMama仓库。以下安装顺序取自VMama仓库。克隆该版本库并导航至项目目录: 建议设置 conda 环境并通过 pip 安装依赖项。使用以下命令设置环境: 创建并激活新的 conda 环境 安装依赖项 检测和分割任务的依赖库(在 VMamba 中为可选项) 二、下载预训练权重 另外,请下载VMamba-Tiny, VMamba-Small, and VMamba-Base在ImageNet上的预训练权重并把它

hanfeng5268的博客 578

必收藏!OpenAI无向量化RAG新范式全解析 小白也能看懂的大模型实操指南

答案生成后,千万别直接返回给用户!LLM-as-Judge(模型当裁判):把“初步答案+用户问题+引用段落”,一起发给O4或O4-mini模型(选型理由:O系列模型的推理能力极强,擅长判断“答案是否贴合原文”),让它验证答案的准确性。信心评估:让验证模型输出“信心值”(高/中/低),比如“信心值高:答案完全基于引用段落,无遗漏、无错误”“信心值低:引用段落未明确覆盖用户问题,需重新筛选”。小白可设置规则:信心值“低”的答案,直接返回重新筛选;“中”的答案,人工简单核对;“高”的答案,直接输出。

大模型教程的博客 1508

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

从“失忆“到“过目不忘“:RAG技术如何给LLM装上“外挂大脑“?

RAG技术:让大模型摆脱"健忘症"的智能外挂 大语言模型虽强大却存在知识时效性差和无法处理新数据的缺陷。检索增强生成(RAG)技术通过外接知识库,赋予模型实时检索能力,成为LLM落地的关键组件。 技术演进: 基础RAG实现"检索-生成"闭环,解决80%简单问答 高级RAG引入智能分块、混合检索、查询路由等优化,处理复杂问题 代理机制让系统具备自主任务分解能力 优化关键: 领域微调提升专业场景准确率 严谨评估体系(相关性/忠实度)保障质量 未来趋势:轻量化模型、智能检索

炼丹上岸 1241

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

收藏!用“人话“秒懂大模型核心术语,小白也能轻松入门!

本文用通俗语言解释了AI大模型中常见的专业术语,包括提示词(Prompt)、词元(Token)、上下文(Context)、参数量(Parameters)、幻觉(Hallucination)、微调(Fine-tuning)、RAG、Prompt Caching、Agent和Multimodal等。文章通过比喻和实例,帮助读者理解这些术语的含义和作用,旨在让读者快速掌握AI大模型的底层逻辑,提升与AI对话的能力。

2401_84815887的博客 456

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

必收藏!大模型学习必备:Adaptive RAG详解,小白也能轻松上手

在大模型全面普及的当下,如何打造更精准、更高效的AI问答系统,成为每一位程序员(尤其是入门小白)和开发者都需要关注的核心课题。我们熟知的传统RAG(Retrieval-Augmented Generation,检索增强生成)技术,虽然有效解决了大模型“失忆”“ hallucination(幻觉)”的痛点,大幅提升了回答的事实准确性,但面对现实中千变万化的查询场景,往往显得不够灵活,难以兼顾效率与效果。

大模型研究中心 626

Java 工程师必看!Spring-AI 大模型集成从入门到落地(含 RAG + 智能体代码示例)

随着大模型技术的成熟,其应用场景已从 Web 在线对话延伸至传统业务领域。当前,大模型的 API 交互与业务集成模式逐渐标准化,Java 生态的核心框架 Spring 也顺势推出。

python12345_的博客 1061

为什么大模型一变长就失忆?RoPE才是关键

本文分析了AI产品经理面试中关于大模型长上下文处理的核心考察点。文章指出,长上下文失忆问题的本质并非算力或数据不足,而是传统绝对位置编码无法有效捕捉远距离token间的关系。通过对比传统绝对位置编码与RoPE相对位置编码的差异,阐释了RoPE通过旋转机制将位置信息转化为token间相对关系的创新设计,使其能稳定处理超长上下文。文章强调,RoPE的价值在于保障长文档问答、RAG和多轮对话等场景的语义一致性,而非简单增加记忆容量。最后提出,AI产品经理应具备从业务痛点反推技术原理的能力,

记录从 0 到 1 学习背面大模型岗位全过程,包括Transformer 架构、LoRA/QLoRA 微调、RAG 开发等等那个,分享踩坑经验与学习路线,助力求职者高效备考入门。 701

AI总“失忆”跑偏?掌握三大对话技巧,让它秒变你的最强大脑

【摘要】探究大语言模型在多轮对话中出现“失忆”与“跑偏”的底层技术根源,系统性地提出了三大核心对话技巧与多种进阶工程化策略。通过主题聚焦、任务拆分和主动锚定等方法,并结合RAG、话术模板等实践,帮助用户显著提升与AI的沟通效率,将其转化为真正可靠的“最强大脑”。

欢迎来到运通链达的官方博客!我们深度探讨人工智能技术与应用,贯彻科技向善理念,推动科技进步与社会福祉和谐共生。 2084

AI智能体为何“失忆”?构建持久记忆架构是关键

在AI智能体开发中,状态管理和知识持久化是核心挑战。传统方法依赖LLM的上下文窗口,但本质上只是短期工作内存,无法实现长期记忆。从技术原理看,真正的记忆系统需要具备持久性、连续性、累积性等特性,这要求将记忆作为独立的基础设施层来设计。在工程实践中,这涉及多层架构,包括记忆存储层(如向量数据库、图数据库)、智能检索层和更新逻辑。这种架构的价值在于实现跨会话连续性、知识累积和智能体间协作,从而让AI智能体从“演示玩具”转变为可靠的“生产伙伴”。当前,专用记忆基础设施(如MemoryLake)的兴起,正为解决AI

weixin_33674976的博客 595

小白程序员必看!火柴人小明带你轻松理解大模型“失忆”原理,附收藏技巧!

要理解这个概念,我们可以把 AI 想象成一个正在参加“开卷考试”的学生。考场规则是这样的:题目非常难,你必须参考书本资料才能回答。但是,考官(技术限制)只允许你在桌面上摊开固定页数的笔记。假设这个限制是 10 页,当你写到第 11 页笔记时,为了腾出地方,你必须把第 1 页的笔记塞进书包锁死,再也回看不了。这个“桌面大小”,就是上下文窗口。在 AI 世界里,计算单位不是“页”,而是 Token(我们在第 5 期讲过,可以简单理解为字或词的片段)。

weixin_56070008的博客 411

大模型入门到精通:Spring-AI框架实战指南(建议收藏)

近期科技圈传来重磅消息:行业巨头英特尔宣布大规模裁员2万人,传统技术岗位持续萎缩的同时,另一番景象却在AI领域上演——AI相关技术岗正开启“疯狂扩招”模式!据行业招聘数据显示,具备3-5年大模型相关经验的开发者,在大厂就能拿到50K×20薪的高薪待遇,薪资差距肉眼可见!业内资深HR预判:不出1年,“具备AI项目实战经验”将正式成为技术岗投递的硬性门槛。在行业迭代加速的当下,“温水煮青蛙”式的等待只会让自己逐渐被淘汰,与其被动应对,不如主动出击,抢先掌握AI大模型核心原理+落地应用技术+项目实操经验。

AI大模型的博客 1095

收藏!Java后端转AI大模型开发:8年后端亲测,2026转型避坑+落地指南

目前来看,RAG方向非常吃香,AI搜索领域各大厂都在布局,对Agent、RAG技术的需求很大。对于转型的后端同学来说,最核心的不是死记硬背AI概念,而是两点:一是保持对技术社区的敏感度,大模型技术更新太快,持续学习能力比什么都重要;二是培养产品思维,技术最终要落地到业务,能解决实际问题的技术,才具有价值。现在大家对AI都很焦虑,正是这种焦虑,让具备后端+AI能力的复合型人才有了市场溢价,现阶段虽然行业还没完全稳定,但正是转型的黄金期。

大模型教程的博客 671

目标导向RAG记忆系统:解决智能体对话中的“失忆”难题

在构建基于大语言模型的对话系统时,RAG(检索增强生成)技术常被用作智能体的“记忆”模块。其核心原理是通过向量化查询,从知识库中检索相关信息片段来增强生成质量。然而,传统RAG在应对多轮、目标导向的复杂对话时,常因缺乏对对话上下文和目标的显式建模,导致智能体出现“记忆碎片化”和“目标信息丢失”等问题,表现为前后回答矛盾或遗忘历史对话。这本质上是一种“内存管理”的挑战,类似于处理 `0xC0000005` 内存访问冲突或 `OutOfMemoryError`,即系统无法在庞大的、未经组织的“记忆空间”中精准定

weixin_34254848的博客 239

从“拆文档”到“通语义”:RAG+知识图谱如何破解大模型“失忆+幻觉”难题?

摘要 RAG技术正从简单分块检索向"智能分层+知识图谱"方向进化。传统RAG存在分块过大丢失细节或过小缺乏上下文的问题,而高级RAG采用1024 token动态分块、20-30%重叠分块等策略平衡精度与完整性。更创新的"父子分段"方法通过小块检索、大块生成既确保检索精准又保留上下文。文档层次结构(如Raptor框架)将知识组织为树状层级,通过摘要逐层筛选提升效率50%以上。知识图谱则构建实体关系网络,解决语义相似性检索的局限,使系统能理解"红袜队属于MLB&

炼丹上岸 1459
上一篇: Agent在银行业的落地实践,大模型入门到精通,收藏这篇就足够了!
下一篇: 用AI大模型制作培训课件接商单赚钱:普通人也能月入过万的副业新机遇
Llama-Turbo
博客等级 码龄4年 9901粉丝 2024原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
