RAG系列(九):解析优化 - 使用 Doc2X 将 PDF 高效转换为 Markdown

论文公式识别软件SimpleTex和Doc2X 论文公式识别软件SimpleTex 阅读详情

引言

在构建高质量的企业级的智能问答系统的过程中,如何高效精准地处理企业已有的海量文档是大部分开发者亟待解决的核心痛点。有了高效精准的文档解析能力,才能够构建高质量的知识库和高效的信息检索系统,这样 LLM 才能给用户更准确更全面的回答。
Doc2X 简介

Doc2X 是一款专为开发者设计的强大文档解析产品。

Doc2X 提供 RESTful API 与 SDK 工具包,支持多种开发语言与框架,让您轻松将文档处理功能嵌入现有系统,方便快捷地实现将 PDF、扫描件、图片等多种格式的文档精准转换为 Markdown、LaTeX、HTML、Word 等结构化或半结构化格式的能力。

官网:https://noedgeai.com/
强大的功能特性

  • • 市面上类似的文档解析产品,绝大部分公式识别做的不好(尤其是行内和复杂公式),而 Doc2X 则处于领先水平;
  • • Doc2X 对表格识别适配优秀,甚至支持识别表格里面的图片和合并跨页表格等;
  • • Doc2X 对于多栏识别的阅读顺序还原效果优异;
  • • Doc2X 适配范围广相当通用,涵盖财研报、论文、教辅、专利等等;
  • • 更具体的效果对比可以参考:Doc2x-v1 竞品分析(mathpix、庖丁PDFlux、pix2text、合合信息TextIn、腾讯云大模型知识引擎文档解析)[2]
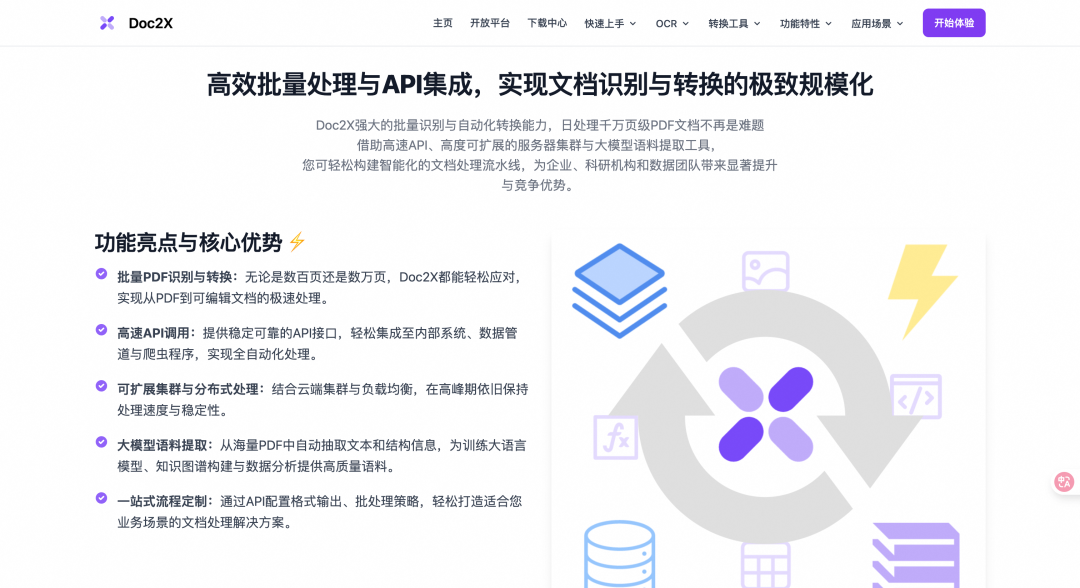
友好的操作界面

当然,除了提供了快速集成的 API 之外,Doc2X 还提供了友好的操作界面,可以让你在页面上快速完成文档解析,解析完成之后可以对照着原文档进行编辑,确保准确性。

无缝集成主流工具

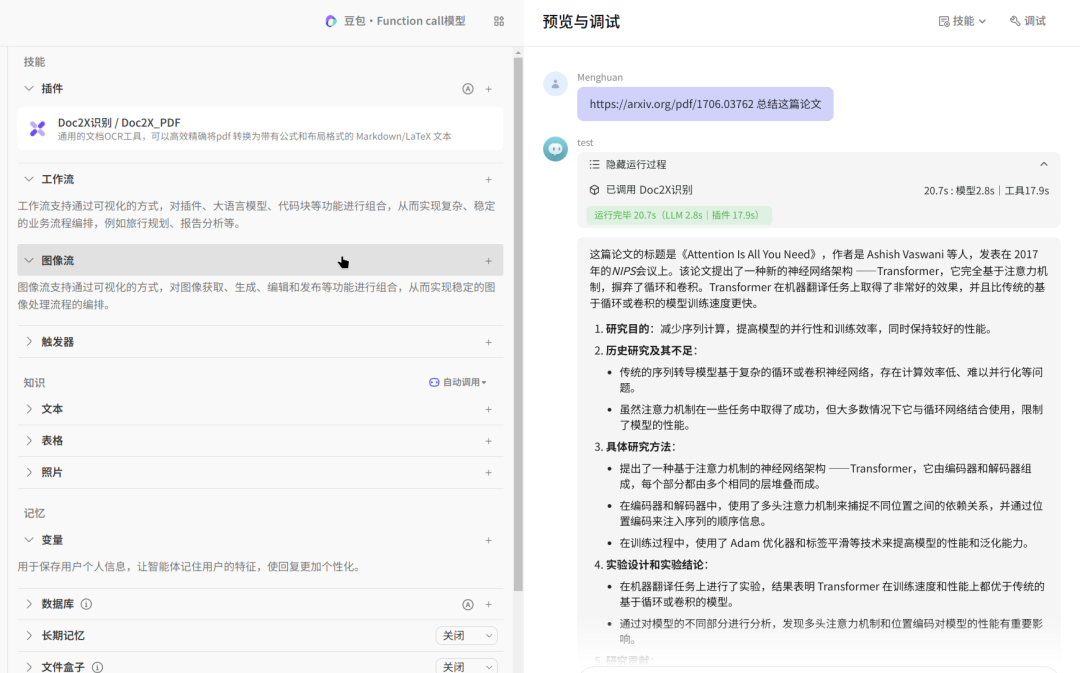
Doc2X 已成功接入 FastGPT、CherryStudio、扣子(国内版)等知名知识库和 AI 应用构建平台。开发者可以直接在这些平台中利用 Doc2X 的强大解析能力,快速搭建和优化自己的知识库应用。
Doc2X 解析效果

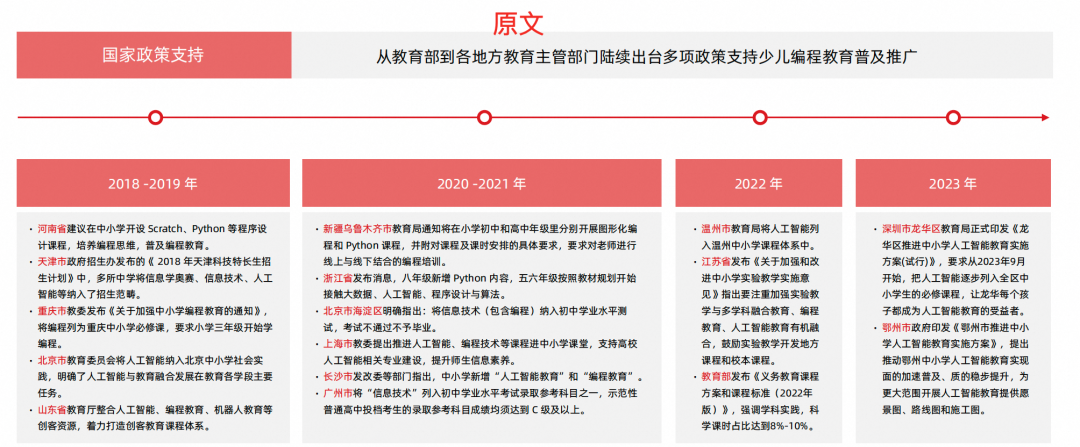
从 Doc2X 的解析结果来看,Doc2X PDF 转 Markdown 的整体效果是比较出色的,大家可以根据自己的文档情况去试用看看效果。

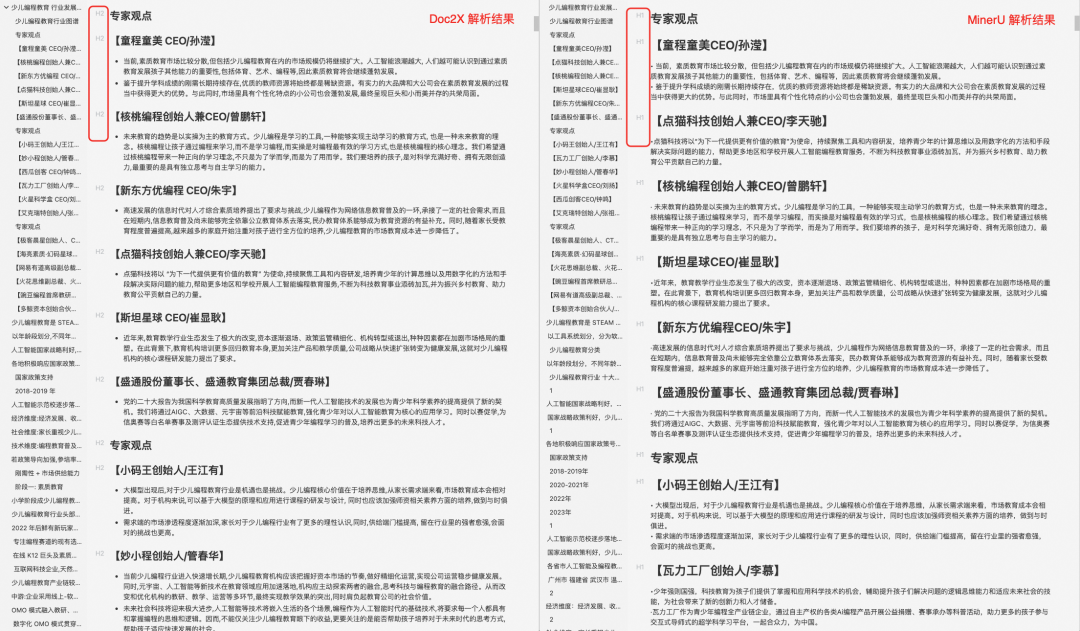
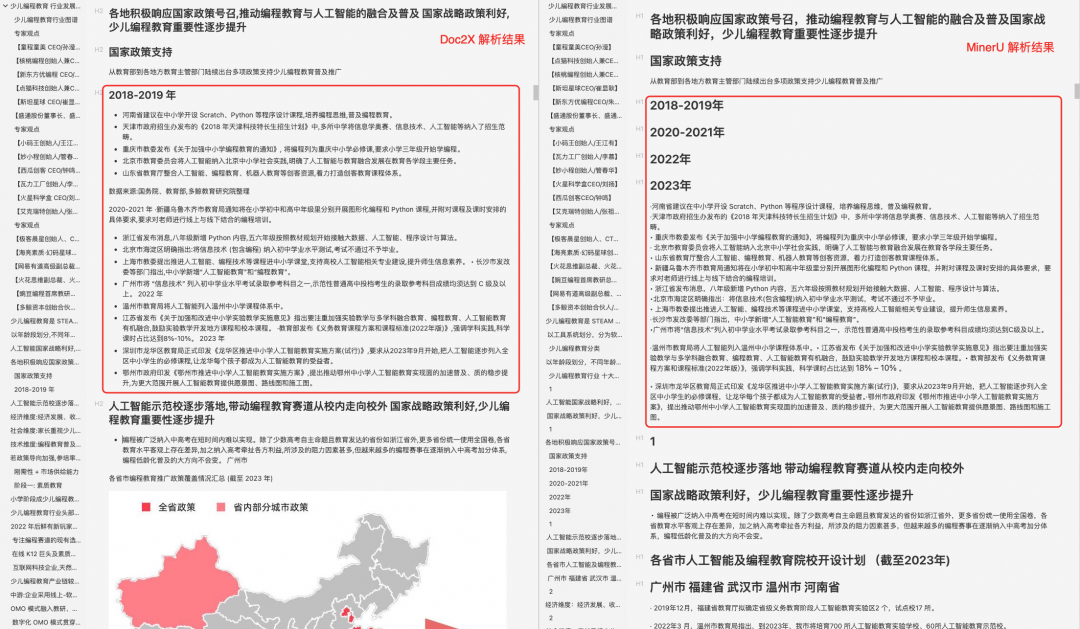
我还是拿《2024少儿编程教育行业发展趋势报告.pdf》这个文档进行解析,相比于 MinerU ,在以下几方面 Doc2X 做的更出色:

    1. 支持多级标题的解析(MinerU 只支持一级标题解析);

    1. 表格识别能力比较强,图片中的表格基本准确识别出来,而且基本没有错位(MinerU 存在无法识别或表格错位问题);
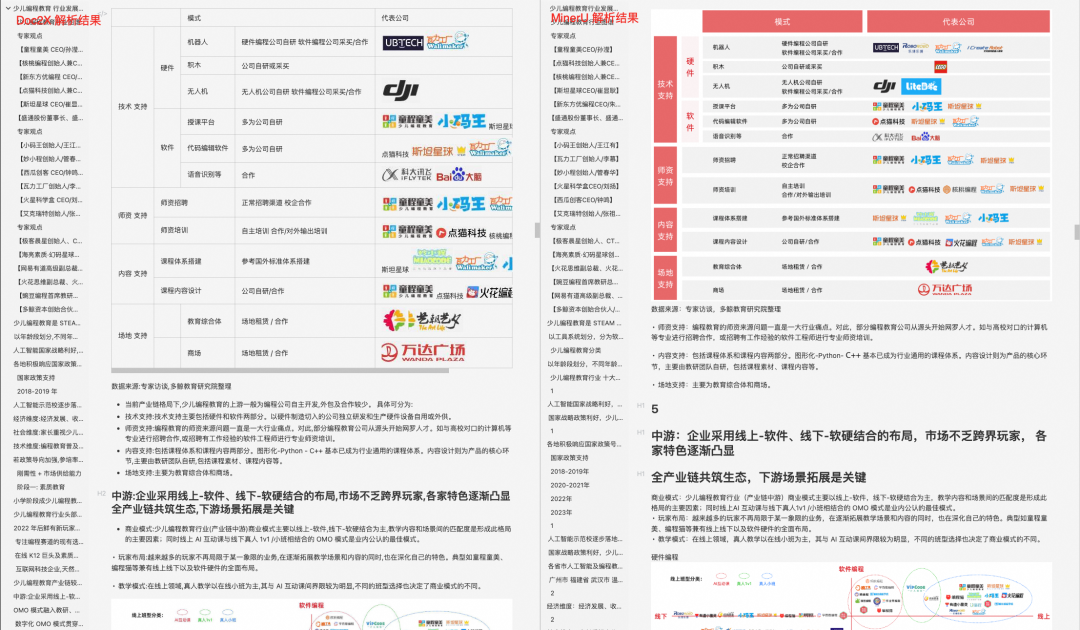
    1. 对于多栏识别的阅读顺序还原效果优异(MinerU 对于多栏识别出现了混乱)。
Doc2X API 集成

Doc2X RESTful API 的 Base URL 是 https://v2.doc2x.noedgeai.com,API 调用流程如下:
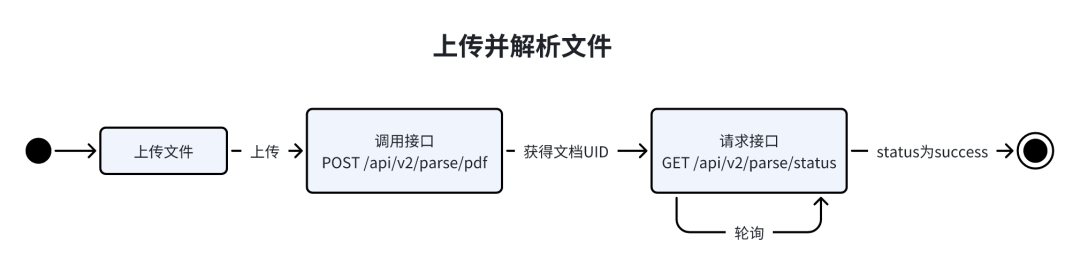
Doc2X API 文档[3]
https://noedgeai.feishu.cn/wiki/Q8QIw3PT7i4QghkhPoecsmSCnG1

接口鉴权

首先需要获取到 API Key(类似于sk-xxx),API Key 获取网址:https://open.noedgeai.com/。
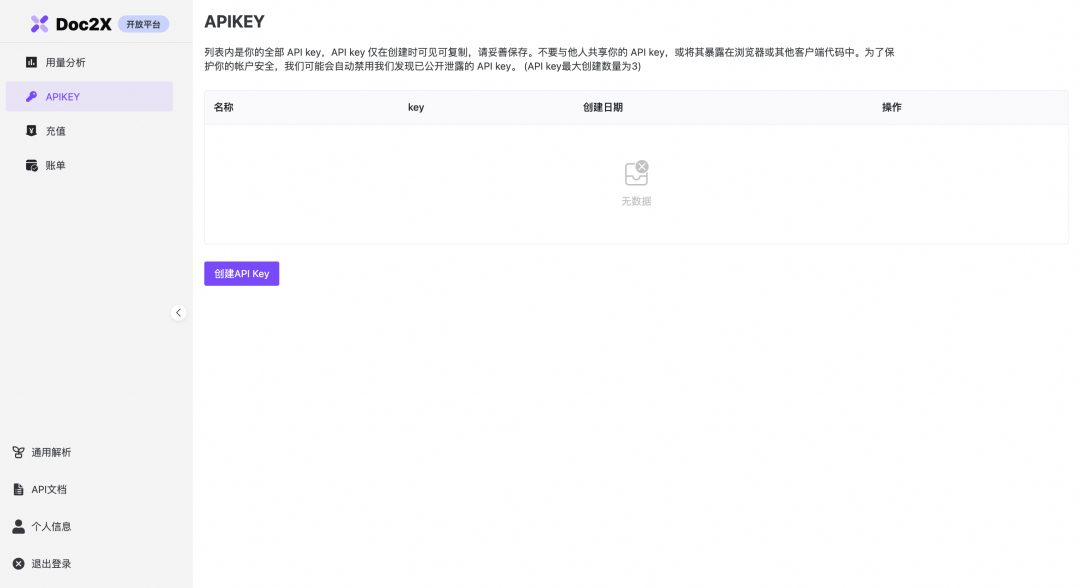
获取之后,在 HTTP 请求头加入:

Authorization: Bearer sk-xxx

文件预上传

推荐使用该接口, 有更快的上传速度,大文件上传接口,文件大小<=1GB。

请求示例:

import json
import time
import requests as rq

base_url = "https://v2.doc2x.noedgeai.com"
secret = "sk-xxx"

def preupload():
    url = f"{base_url}/api/v2/parse/preupload"
    headers = {
"Authorization": f"Bearer {secret}"
    }
    res = rq.post(url, headers=headers)
if res.status_code == 200:
        data = res.json()
if data["code"] == "success":
return data["data"]
else:
raise Exception(f"get preupload url failed: {data}")
else:
raise Exception(f"get preupload url failed: {res.text}")

upload_data = preupload()
print(upload_data)

返回示例:

{
"code":"success",
"data":{
"uid":"0192d745-5776-7261-abbd-814df3af3449",
"url":"https://doc2x-pdf.oss-cn-beijing.aliyuncs.com/tmp/0192d745-5776-7261-abbd-814df3af3449.pdf?X-Amz-Algorithm=AWS4-HMAC-SHA256&X-Amz-Credential=LTAI5tS7hV6uXXVzcpk3EGfX%2F20241029%2Fcn-beijing%2Fs3%2Faws4_request&X-Amz-Date=20241029T075458Z&X-Amz-Expires=600&X-Amz-SignedHeaders=host&X-Amz-Signature=f731ea8fe4efdd7c727c210034bdcf1a63436c74b295db68f9648efdce576a91"
}
}

获取到 url 之后,使用 HTTP PUT 方法上传文件到返回结果中的 url 字段,然后使用/api/v2/parse/status 接口轮询结果,使用的是阿里云的oss,具体速度取决于您的网速(海外用户速度可能上传失败)。

import json
import time
import requests as rq

base_url = "https://v2.doc2x.noedgeai.com"
secret = "sk-xxx"

def put_file(path: str, url: str):
withopen(path, "rb") as f:
        res = rq.put(url, data=f) # body为文件二进制流
if res.status_code != 200:
raise Exception(f"put file failed: {res.text}")

defget_status(uid: str):
    url = f"{base_url}/api/v2/parse/status?uid={uid}"
    headers = {
"Authorization": f"Bearer {secret}"
    }
    res = rq.get(url, headers=headers)
if res.status_code == 200:
        data = res.json()
if data["code"] == "success":
return data["data"]
else:
raise Exception(f"get status failed: {data}")
else:
raise Exception(f"get status failed: {res.text}")

url = upload_data["url"]
uid = upload_data["uid"]

put_file("test.pdf", url)

whileTrue:
    status_data = get_status(uid)
print(status_data)
if status_data["status"] == "success":
        result = status_data["result"]
withopen("result.json", "w") as f:
            json.dump(result, f)
break
elif status_data["status"] == "failed":
        detail = status_data["detail"]
raise Exception(f"parse failed: {detail}")
elif status_data["status"] == "processing":
# processing
        progress = status_data["progress"]
print(f"progress: {progress}")
        time.sleep(3)

文件预上传流程图如下:
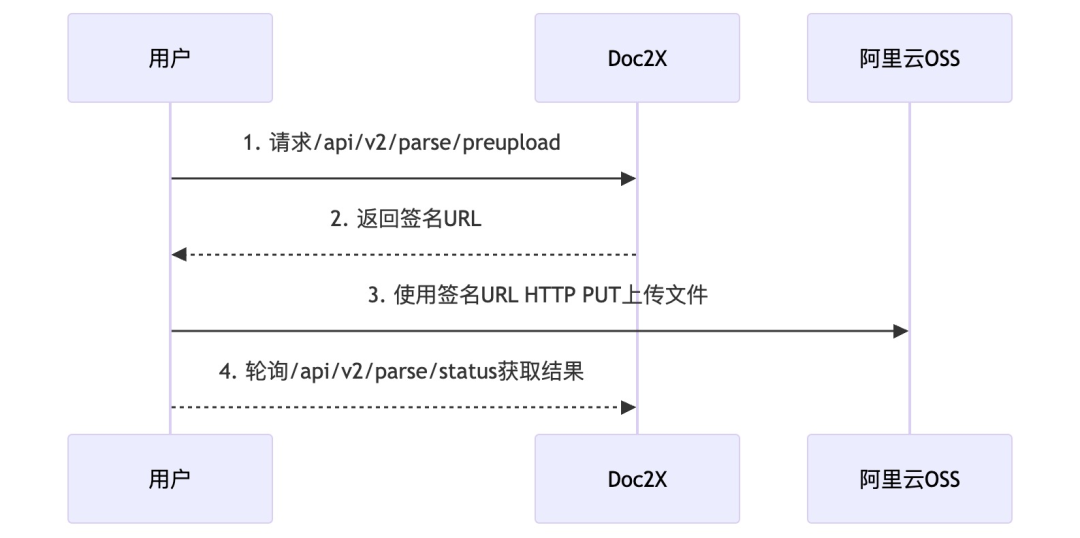
请求导出文件

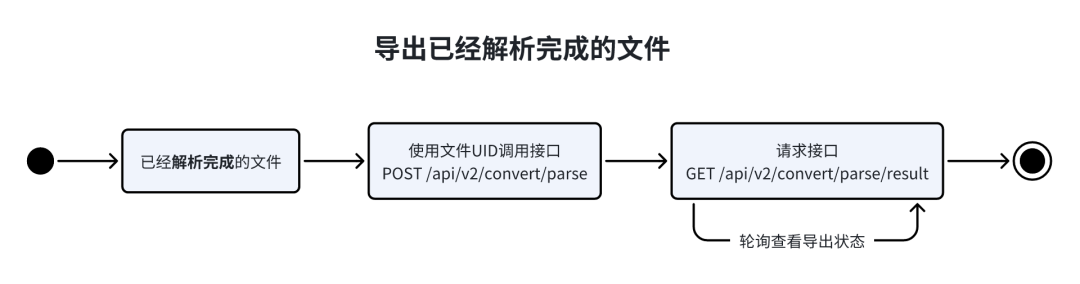
通过/api/v2/parse/status 接口轮询结果完成之后,需要通过 /api/v2/convert/parse接口触发导出文件任务。

请求示例:

import requests
import json

url = "https://v2.doc2x.noedgeai.com/api/v2/convert/parse"
headers = {
"Authorization": "Bearer sk-xxx",
"Content-Type": "application/json",
}

data = {
"uid": "01920000-0000-0000-0000-000000000000",
"to": "md",
"formula_mode": "normal",
"filename": "my_markdown.md",
}

response = requests.post(url, headers=headers, data=json.dumps(data))

print(response.text)

返回示例:

// 进行中
{
"code":"success",
"data":{
"status":"processing",
"url":""
}
}

导出获取结果

通过/api/v2/convert/parse接口触发导出文件任务后,需要通过/api/v2/convert/parse/result接口轮询导出文件任务状态,成功之后会返回文件 URL。

请求示例:

import requests

url = 'https://v2.doc2x.noedgeai.com/api/v2/convert/parse/result?uid=01920000-0000-0000-0000-000000000000'
headers = {'Authorization': 'Bearer sk-xxx'}

response = requests.get(url, headers=headers)

print(response.text)

返回示例:

{
"code":"success",
"data":{
"status":"success",
"url":"https://doc2x-backend.s3.cn-north-1.amazonaws.com.cn/objects/01927a3a-eeb0-74f6-a539-ca35916b772e5/convert_tex_none.zip?X-Amz-Algorithm=AWS4-HMACSHA256&X-Amz-Credential=AKIATKXFISLI52PK3HTP%2F20241011%2Fcn-north-1%2Fs3%2Faws4request&X-Amz-Date=20241011075617Z&X-Amz-Expires=300&X-Amz-SignedHeaders=host&&x-id=GetobjectX-Amz-Signature=05bdd04a668e9924c5fd361999728cee35aaefb2087334a403f6ebf5ba93f786f"
}
}

下载文件

从/api/v2/convert/parse/result接口获得文件 URL 后就可以通过 HTTP GET 方法请求 URL 来下载文件。

请求示例:

import requests

response = requests.get("https://doc2x-backend.s3.cn-north-1.amazonaws.com.cn/objects/01927a3a-eeb0-74f6-a539-ca35916b772e5/convert_tex_none.zip?X-Amz-Algorithm=AWS4-HMACSHA256&X-Amz-Credential=AKIATKXFISLI52PK3HTP%2F20241011%2Fcn-north-1%2Fs3%2Faws4request&X-Amz-Date=20241011075617Z&X-Amz-Expires=300&X-Amz-SignedHeaders=host&&x-id=GetobjectX-Amz-Signature=05bdd04a668e9924c5fd361999728cee35aaefb2087334a403f6ebf5ba93f786f")

withopen('downloaded_file.zip', 'wb') as f:
    f.write(response.content)

结语

本文给大家再介绍了一款优秀强大的文档解析产品 - Doc2X,通过实践表明 Doc2X 确实具有优秀的表现,可以作为大家在建设文档解析系统的候选工具,也期望通过我的介绍能给大家提供更多的选择和思路。

大模型算是目前当之无愧最火的一个方向了,算是新时代的风口!有小伙伴觉得,作为新领域、新方向人才需求必然相当大,与之相应的人才缺乏、人才竞争自然也会更少,那转行去做大模型是不是一个更好的选择呢?是不是更好就业呢?是不是就暂时能抵抗35岁中年危机呢?

答案当然是这样,大模型必然是新风口!

那如何学习大模型 ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。但是具体到个人,只能说是:

最先掌握AI的人,将会比较晚掌握AI的人有竞争优势。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

但现在很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习路线完善出来!

在这里插入图片描述

在这个版本当中:

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型路线+学习教程已经给大家整理并打包分享出来, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全咨料,放心领取)👈

​

一、大模型经典书籍(免费分享)

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套大模型报告(免费分享)

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、大模型系列视频教程(免费分享)

在这里插入图片描述

四、2025最新大模型学习路线(免费分享)

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全资料,放心领取)👈

​

MinerU:PDF转Markdown利器,打通LLM文档理解的关键桥梁 在人工智能和自然语言处理领域,文档解析与信息提取是连接非结构化数据与智能应用的基础技术。其核心原理在于通过光学字符识别(OCR)、版面分析和深度学习模型,将图像或PDF中的视觉元素转化为机器可读的结构化文本。这项技术的核心价值在于为下游的检索增强生成(RAG)和智能体(Agent)系统提供高质量、语义清晰的数据输入,从而显著提升大语言模型对文档内容的理解、总结和分析能力。其典型应用场景包括构建企业知识库、自动化处理合同与学术论文,以及开发智能问答助手。本文聚焦的MinerU项目,正是这一技术路径的杰出代表, 阅读详情

相关推荐

Doc2X:破解RAG文档解析难题的核心引擎

在构建生产级RAG系统时,文档解析质量直接决定系统上限。本文深入解析Doc2X如何通过跨页表格合并、LaTeX公式保留、图文关联抽取三大技术创新,解决传统方案中上下文割裂、语义丢失等痛点。结合金融、医疗等场景案例,通过架构图与性能对比,揭示其如何提升检索准确率30%+ 并降低幻觉风险50%。全文超5000字,含7张技术图解与4个API集成示例。

fudaihb的博客 1309

沉浸式翻译与Doc2X联合实现Zotero论文全文翻译

文中介绍免费翻译文献全文的方法,适合快速泛读,了解论文全貌与整体框架。不能完全依赖其翻译结果,对于感兴趣的地方以及重要的方法原理等部分还应进一步精读。

Lucky_云佳的博客 1万+

docbook2X-开源

docbook2X将DocBook文档转换为man和Texinfo格式。

PDF文件在线处理工具(侧重数理及论文)

可以解析排版、数学公式、表格、图片、图表等,对包含表格和公式的文档处理效果较好,国内的不少大模型厂商在使用,中英文档处理效果比mathpix好。支持Word、幻灯片、Excel、txt、图像、扫描件、结构化数据、网页等复杂的非结构化数据解析,包含各种不同场景模版,比如发票、简历、财报等。可以解析文本、数学、化学、手写识别、表格、外语和完整PDF文档,输出LaTeX 、Markdown、Word等格式。支持多语言,可以识别图片中的版面、表格、图片、文字、数学公式等,输出Markdown 格式。

bugsycrack的博客 1923

AI报告撰写实战指南:从提示词工程到全流程优化的底层逻辑与实践突破

传统AI写作常被诟病为“信息拼贴”——模型虽能生成文本,却常出现逻辑断裂、数据矛盾、风格不符等问题。而“全流程优化”则是通过系统化设计,将报告生成拆解为需求解析→数据对齐→提示词设计→初稿生成→迭代优化→格式适配六大环节,每个环节均通过技术手段提升输出质量。提示词工程:本质是通过结构化指令(如角色设定、任务分解、格式约束、示例引导)精准控制模型输出方向,是连接用户需求与模型能力的“翻译器”。全流程优化。

2501_92808811的博客 884

Zynq远程更新程序实战:从emmc到flash的完整方案解析

本文详细解析了Zynq远程更新程序的完整方案,重点探讨了从emmc到flash的实战操作。通过硬件连接限制破解、emmc配置技巧、flash擦写策略优化等关键技术点,提供了可靠的远程更新解决方案,特别适合需要频繁更新boot.bin的应用场景。

weixin_29163797的博客 179

RAG系列:解析优化 - 使用 Doc2X 将 PDF 高效转换为 Markdown

Doc2X 是一款专为开发者设计的强大文档解析产品。Doc2X 提供 RESTful API 与 SDK 工具包,支持多种开发语言与框架,让您轻松将文档处理功能嵌入现有系统,方便快捷地实现将 PDF、扫描件、图片等多种格式的文档精准转换为 Markdown、LaTeX、HTML、Word 等结构化或半结构化格式的能力。Doc2X文档图片公式识别/翻译/转换本文给大家再介绍了一款优秀强大的文档解析产品 -Doc2X。

jike007gt的博客 1041

树莓派4B串口舵机控制全攻略:从pigpio库安装到Python脚本调试

本文详细介绍了如何在树莓派4B上通过pigpio库和Python脚本实现串口舵机的精确控制。从硬件串口配置、pigpio库安装到舵机通信协议解析和Python脚本开发,提供了完整的解决方案和调试技巧,适用于机械臂控制等实际项目应用。

k8s6orchestrator的博客 430

Doc2X:为知识库RAG接上高精度文档解析的“智能引擎”

在数字化浪潮席卷各行业的今天,海量文档的智能处理与高效利用已成为开发者亟待解决的核心痛点。无论是构建智能知识库、优化信息检索,还是革新教育科技,精准、高效的文档解析能力都扮演着至关重要的角色。

Android23333的博客 610

一文看懂英伟达A100、H100、A800、H800、H20

想要Deepseek私有化部署吗?无论是训练大型AI模型,还是进行高性能计算(HPC),还是Deepseek私有化部署,都需要强大的GPU支持。而英伟达(NVIDIA)作为全球领先的AI芯片制造商,推出了一系列高性能GPU,包括等,广泛应用于AI训练、推理、科学计算等领域。如果想搭建一个属于自己的算力中心,该如何选择合适的GPU?本文将带你详细了解这些GPU的特性,并指导你如何搭建算力中心。一、英伟达算力GPU系列解析1. A100:数据中心AI计算的奠基石:Ampere:6912:432。

【可全包】本人程序员,不需要做任何吹嘘,只是实在写点程序,写点文档,熟悉各类主流框架,SSM,SpringBoot,Flask,Djiango,Mysql,Sqlite,VUE,Uniapp等,各类程序设计专家,优质作者 2万+

避坑指南:Python模拟抖音扫码登录时,那些你可能会遇到的‘Referer’和‘Token’校验问题

本文深入解析Python模拟抖音扫码登录时常见的Referer校验与Token失效问题,提供五大陷阱的解决方案。从动态fp参数生成到Referer校验策略,再到Token生命周期管理,手把手教你破解抖音登录接口的反爬机制,助力开发者高效完成自动化登录。

weixin_42573113的博客 782

RAG搭建个人LLM知识库助手,很多人第一步就走错了...

本文介绍了基于RAG技术搭建本地知识库时处理PDF文档的经验。作者推荐使用Doc2X工具精准提取PDF内容,它能将文档转换为结构化的Markdown格式,保留标题层级、表格和公式等元素,显著提升知识库质量。Doc2X支持API调用和多种平台集成,可实现自动化文档处理流程。相比普通PDF解析工具,它能解决文本粘连、格式丢失等问题;相比大模型内置解析功能,其提取结果更准确透明,便于人工干预。这种专业文档转换工具为构建高质量知识库提供了可靠保障。

Q2024107的博客 1788

Cesium.Ray 知识详解,示例代码

Cesium.Ray 是 CesiumJS 中用于表示三维空间中无限射线的核心类,广泛应用于地理信息系统(GIS)、三维可视化和碰撞检测等场景。射线由起点(origin)和方向向量(direction)定义,数学表达式为 ( P(t) = \text{origin} + t \times \text{direction} )。核心属性包括起点和方向向量,常用方法包括射线与平面的交点计算、根据距离获取射线上的点等。在 Cesium 中,Cesium.Ray 常用于地形碰撞检测、鼠标点选对象和雷达探测模拟等场景

大剑师兰特的GIS世界 425

5分钟上手MinerU:从PDF到结构化数据的高效文档解析终极指南

还在为PDF文档解析而烦恼吗?想要快速将复杂文档转换为AI可读的格式吗?今天我要为你介绍一个强大的开源文档解析工具——MinerU。这个工具能将PDF、DOCX、PPTX、XLSX等格式的文档,快速转换为适合LLM、RAG和Agent工作流的结构化Markdown或JSON数据。无论你是AI开发者、数据分析师还是文档处理工程师,MinerU都能大幅提升你的工作效率! ## 🎯 为什么选择Min

gitblog_00657的博客 1033

有限元之有限元空间的构造

主要介绍有限元的空间构造方法。

欢迎各位大佬光临“寒舍”!请多多指点,共同进步! 762

利用XGBoost实现短期电力负荷预测

本数据集为某地区2009年-2015年的用电负荷,时间片为每分钟这里我们定义了XGB模型作为实例,来进行模型训练,之后我们会对其使用网格搜索找到最优的参数。

优快云 精品推荐 4495

RAG知识库实战:PDF转Markdown工具选型与解析质量验证

在构建AI知识库与RAG系统时,文档解析是决定检索效果的上游基础工程。很多团队投入大量精力调优Embedding模型和向量检索参数,却忽略了最关键的PDF解析环节——尤其是当文档以扫描件、双栏论文或复杂表格形式存在时,低质量的文本提取会直接污染语料,导致召回结果充满页眉噪声或破碎表格。Markdown作为一种结构化文本格式,既能保留标题层级、表格和公式语义,又能为文本切分提供天然边界,因此成为知识库预处理的优选载体。本文从技术原理出发,解析了版面分析、OCR识别、表格保真度等核心概念,对比了PyMuPDF、

weixin_34372728的博客 301

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

MarkItDown 文档转 Markdown 转换指南:从安装到进阶配置的完整教程

手里有一批 PDF 报告和 Word 文档,想喂给大模型或者塞进知识库,却发现表格错乱、文字选不中,手动重排又耗时。MarkItDown 是微软开源的 Python 工具,能把各类办公文档和网络内容直接解析成结构清晰的 Markdown。读完这篇,你会用一条命令把它跑起来、按场景精准安装依赖,还能处理扫描件 OCR、音频转录这类进阶需求。 一句话概括:MarkItDown 是一个文件转 Mark

gitblog_00663的博客 788

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

markitdown 实测:一行命令把办公文档转成 Markdown,RAG 文档预处理省下一整天

源码仓库可以用下面命令拉下来,装成可编辑模式方便调试: ```bash git clone https://gitcode.com/GitHub_Trending/ma/markitdown cd markitdown pip install -e 'packages/markitdown[all]' ``` 官方文档就是仓库根目录的 README.md,安装、可选依赖、Azure 集成都有完

gitblog_00023的博客 1136

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

功能强到飞起!一款开源免费的全格式文件智能转换神器

内容提转换工具是一种用于文档内容智能解析与结构化输出的高效软件,可有效适用于日常知识提取,企业知识管理与智能问答系统建设。它能够自动读取各类非结构化或半结构化的文档资料(如PDF、Word、PPT、Excel、音频等),并将其中的有效信息提取为结构化的文本或Markdown格式,便于存储、检索和进一步利用。在日常工作生活中,有非常广泛的场景,常见的有:企业可利用该工具批量解析合同、培训材料、会议纪要等文档,快速沉淀为统一标准的知识条目,提升内部知识利用效率。

947

RAG搭建个人LLM知识库助手,很多人第一步就走错了...大模型入门到精通,收藏这篇就足够了!

基于RAG技术搭建本地知识库问答助手,已经是相当普遍的应用方案了。前一阵我在公司实践过,用我们过往积累的、对业务重要的内部知识构建知识库,开发了一个智能问答Agent,能减少团队一部分的答疑时间。

2301_81888214的博客 991

Paper2Slides多格式支持:PDF、Word、Excel、PPT、Markdown全兼容终极指南

Paper2Slides是一个革命性的AI演示文稿生成工具,能够将各种格式的文档一键转换为专业的幻灯片和海报。无论您是研究人员、学生还是职场人士,这款工具都能帮助您快速从文档中提取关键信息,生成视觉吸引力强的演示文稿。Paper2Slides的多格式兼容性让您无需担心文档格式问题,真正实现"从文档到演示"的无缝转换。 ## 📄 全面的文档格式支持 Paper2Slides支持广泛的文档格式,

gitblog_00853的博客 401

PaddleOCR 文档解析实战:5 步把复杂 PDF 变成 LLM 可用的 Markdown

PaddleOCR 文档解析(PP-StructureV3)解决的是一个很具体的问题:多栏论文、带表格的财报、混排公式的教材,喂给普通 OCR 只能得到一堆无顺序的文本,而喂给 RAG 或 Agent 之前,你需要的是带阅读顺序、带坐标的 Markdown 或 JSON。PaddleOCR 的 PP-StructureV3 产线正是为此设计:版面检测、表格结构识别、公式转 LaTeX、多栏阅读顺序

gitblog_01078的博客 309

X2Knowledge文档转换解决方案:解决企业知识库建设的格式兼容与智能提取难题

在数字化转型浪潮中,企业面临着一个普遍而棘手的挑战:如何将海量非结构化文档(PDF、Word、Excel、PPT等)高效转化为结构化知识,以支撑RAG应用和企业知识库建设?传统文档处理工具往往存在格式兼容性差、内容提取不完整、无法直接服务AI应用三大痛点,导致知识库建设效率低下、成本高昂。X2Knowledge作为一款开源免费的文档转换工具,通过创新的多引擎架构和智能内容提取技术,为企业提供了从文

gitblog_00058的博客 492

Markitdown 实践指南:一条命令把 PDF、Word、Excel 转成大模型能读的 Markdown

给大模型备料时,你大概率会碰到这样的文件夹:里面混着 PDF、Word、Excel、PPT,格式各不相容,模型却谁都不认识。Markitdown 就是一个专门干这件事的 Python 转换工具——把各类文档一次性转成保留标题层级、列表和表格结构的 Markdown,让 LLM 直接消费。下面从 30 秒跑通一路讲到按需配置,把它真正用起来。 ## 一句话说清它是什么 Markitdown 是一

gitblog_00452的博客 442
上一篇: RAG系列(八):切分优化 - 基于 Markdown 语法的文档切分
下一篇: RAG系列(十):切分优化 - 基于句子相似距离的语义切分
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值