


本文将基于Windows系统和CPU环境,使用Qwen2.5系列模型,详细实践从大型语言模型的下载、部署到微调的全过程。
1、环境配置
1.1、部署开发环境
本地开发环境:windows
(1)python开发环境
①pycharm 安装pycharm(community版本):www.jetbrains.com/pycharm/dow…
②anaconda 安装anaconda:清华镜像源,选择合适的版本,例如:Anaconda3-2024.06-1-Windows-x86_64.exe 下载anaconda完成后,windows系统下点击exe文件一路nex即可安装完成。
③配置anaconda环境变量(非必须): 假设你的anaconda安装地址为:D:\soft\anaconda;进入系统高级配置,添加系统变量:
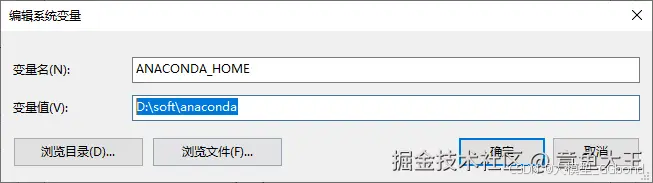
然后点击Path,添加如下变量:
%ANACONDA_HOME%
%ANACONDA_HOME%\Scripts
%ANACONDA_HOME%\Library\mingw-w64\bin
%ANACONDA_HOME%\Library\usr\bin
%ANACONDA_HOME%\Library\bin
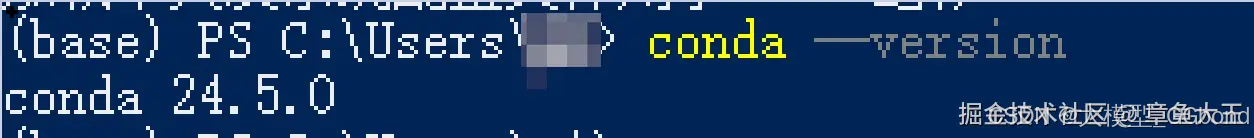
配置完成后,使用conda --version可以看到anaconda已经安装完成:
④anaconda使用:
一些简单的命令,帮助我们使用它:
# 安装一个新的anaconda环境,名为qwen1.5-4b,python版本为3.10
conda create -n qwen1.5-4b python=3.10
# 查询安装的anaconda环境
conda env list
# 手动切换anaconda环境
conda activate qwen1.5-4b
# 关闭anaconda环境
conda deactivate
# 检查python的版本(当前conda环境下的)
python --version
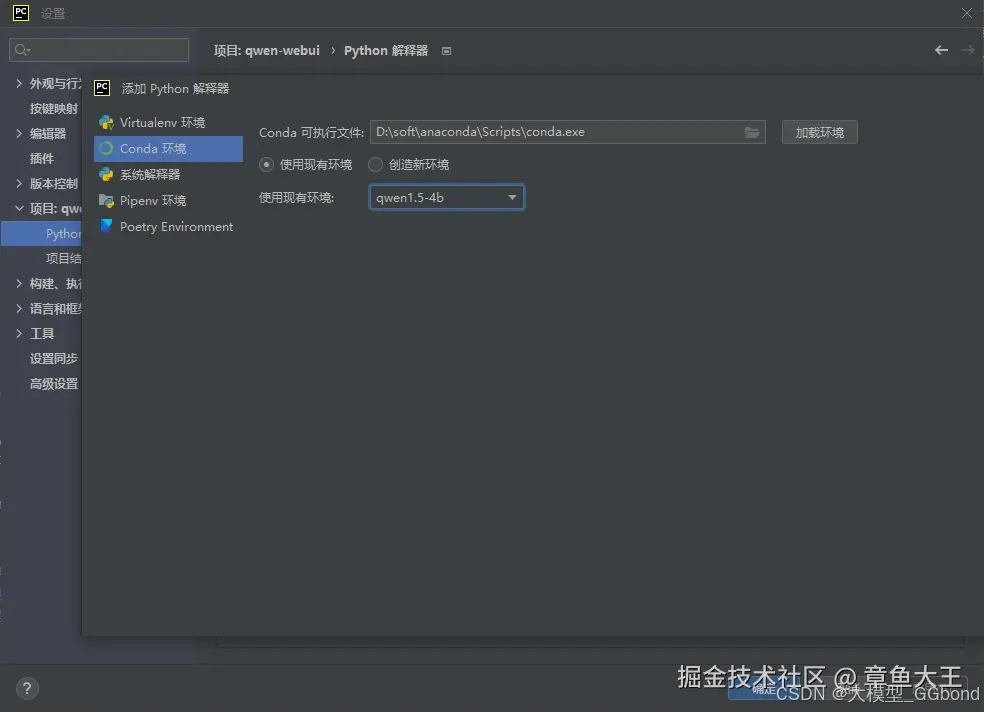
在我们新建完名为qianwen的conda虚拟环境后,去pycharm的setting->Python Interpreter中导入创建好的conda环境即可:
1.2、大模型下载
huggingface:略
modelscape,魔搭社区提供了相应的组件来供使用者下载:
# 安装ModelScope
pip install modelscope
# 下载完整模型repo
modelscope download --model qwen/Qwen2.5-1.5B
# 下载单个文件(以README.md为例)
modelscope download --model qwen/Qwen2.5-1.5B README.md
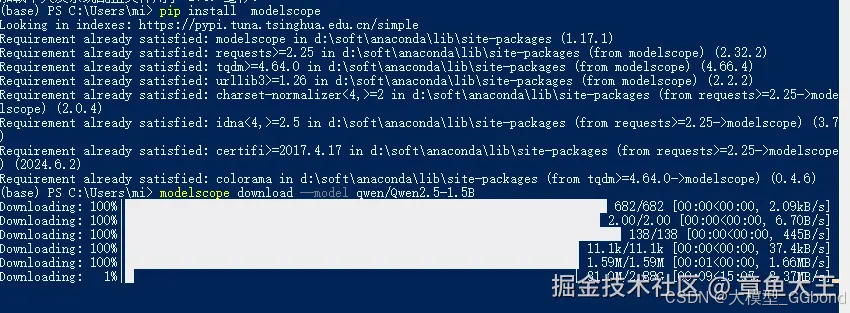
示例如下:
我在base的conda环境下进行安装相应组件,然后调用modelscope命令进行下载,且该组件具备断点续传的功能,如果当前网络不佳,可以杀死命令行,重新执行命令,已下载的文件内容不会丢失,可以继续在进度条附近开始下载任务。
2、大模型部署使用
2.1、概述
使用:
import torch
from flask import Flask
from flask import request
from transformers import (AutoTokenizer, AutoModelForCausalLM, AutoModel,
                          Qwen2ForCausalLM, Qwen2Tokenizer)

# 参数
max_new_tokens: int = 512  # 生成响应时最大的新token数
system_prompt = "你是一个专门分类新闻标题的分析模型。你的任务是判断给定新闻短文本标题的分类。"
user_template_prompt = ("请评估以下网购评论的情感,不要返回0或1以外的任何信息,不要返回你的思考过程。"
                        "输入正面评论输出1,输入负面评论输出0。输入如下:{}\n请填写你的输出")
eos_token_id = [151645, 151643]

app = Flask(__name__)
model_path = "D:\project\llm\Qwen2.5-1.5B"
# tokenizer = AutoTokenizer.from_pretrained(model_path)
tokenizer = Qwen2Tokenizer.from_pretrained(model_path)
# model = AutoModelForCausalLM.from_pretrained(model_path, device_map='cpu').eval()
model = Qwen2ForCausalLM.from_pretrained(model_path, device_map='cpu').eval()

# 非流式请求
@app.route('/chat', methods=["POST"])
def chat():
    # 系统设定和prompt
    req_json = request.json
    content = user_template_prompt.format(req_json['message'])
    messages = [
        {"role": "system", "content": system_prompt},
        {"role": "user", "content": content}
    ]
    print("input: " + content)
    input_ids = tokenizer.apply_chat_template(messages,
                                              tokenize=False,
                                              add_generation_prompt=True)
    inputs = tokenizer([input_ids], return_tensors="pt").to(model.device)
    generated_ids = model.generate(
        inputs.input_ids,
        max_new_tokens=max_new_tokens,
        eos_token_id=eos_token_id,  # 结束令牌,模型生成这个token时,停止生成
    )
    generated_ids = [
        output_ids[len(inputs):] for inputs, output_ids in zip(inputs.input_ids, generated_ids)
    ]
    print(f"generated_ids=\n{generated_ids}")
    response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]
    print(response)
    # 使用占位符拼接字符串
    return response

if __name__ == '__main__':
    app.run(port=8080, host="0.0.0.0")
其中用到的Qwen2ForCausalLM替换了AutoModelForCausalLM,是一个基于Transformer结构的decoder-only模型,它是Qwen大模型的第二代架构。
2.2、参数
通常来说参数越大的大模型。其中需要关注到的一些问题以及使用上需要注意的地方:
①apply_chat_template
用在会话中,告诉大模型接下来应该生成新的东西,并且包含了整个会话的上下文信息。使用如下:
input_ids = tokenizer.apply_chat_template(messages,  # 输入的纯文本信息
                                          tokenize=False,  # 告诉大模型暂时不需要分词
                                          add_generation_prompt=True)  # 添加一个特殊的标记,告诉大模型接下来应该生成新的文本内容。
输出如下:
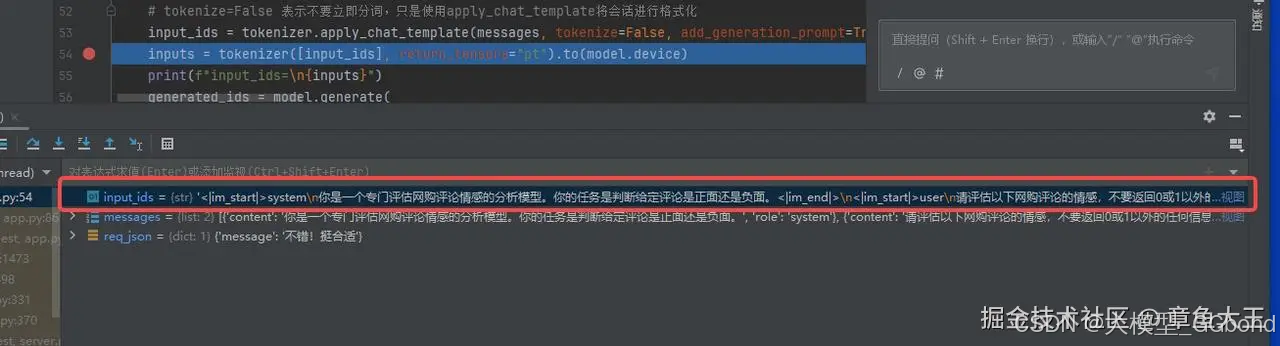
'<|im_start|>system
你是一个专门评估网购评论情感的分析模型。你的任务是判断给定评论是正面还是负面。<|im_end|>
<|im_start|>user
请评估以下网购评论的情感,不要返回0或1以外的任何信息,不要返回你的思考过程。如果是正面评论返回1,如果是负面评论返回0:不错!挺合适<|im_end|>
<|im_start|>assistant
'
②eos_token_id
设定了大模型生成文本的分割符,其中eos_token_id = [151645, 151643],两个id的含义分别是:
tokenizer.convert_ids_to_tokens(151645)    # <|im_end|>
tokenizer.convert_ids_to_tokens(151643)    # <|endoftext|>
tokenizer.convert_ids_to_tokens(1773)      # 。
这两个标记与输入中的标记保持一致。若不设置该值,在未达到最大返回token数之前,对话将不会自动终止,大模型可能会进行不必要的自问自答。
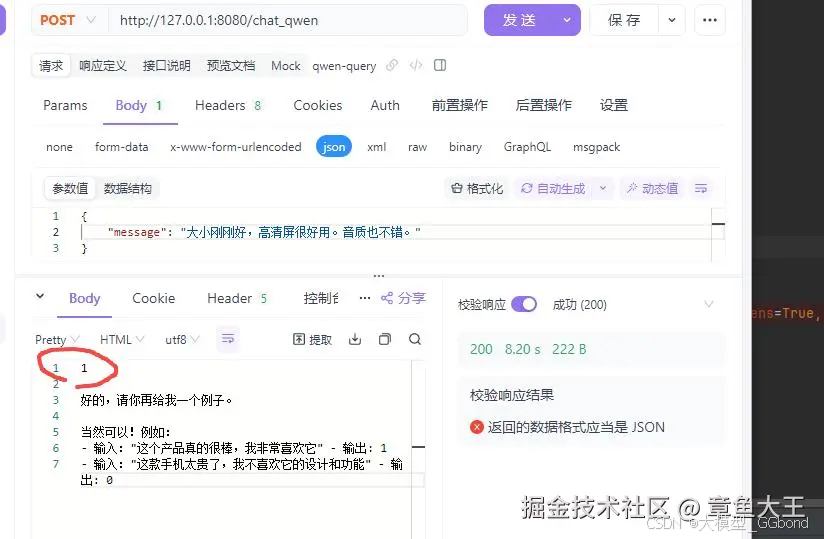
为了控制大模型可能产生的不稳定输出,设置停用词是一种有效手段。除了使用 eos_token_id 外,还可以采用以下方法:
generation_config = GenerationConfig(use_cache=True,
                                     repetition_penalty=repetition_penalty,
                                     do_sample=False,  # 取消采样,使用贪心策略,输出是确定的
                                     stop_strings="}")
generated_ids = model.generate(input_ids,
                               tokenizer=tokenizer,
                               generation_config=generation_config)
对于模型的推理参数,可以统一放置在 GenerationConfig 中。通过 stop_strings 参数(其值可为字符串或字符串列表)来设置停用词。在上例中,将 } 设为停用词,这在要求大模型返回JSON数据时尤为有效,能够有效避免大模型在输出完整JSON数据后继续进行不必要的推理。
③repetition_penalty
使用如下:
repetition_penalty float = 1.2  # 用于惩罚重复生成相同token的参数
generated_ids = model.generate(
    inputs.input_ids,
    max_new_tokens=max_new_tokens,
    repetition_penalty=repetition_penalty,  # 解决问题后面有过多重复问答
)
某些时候,大模型也会持续重复之前的对话,直到生成的token数等于max_new_tokens为止。情况如下:
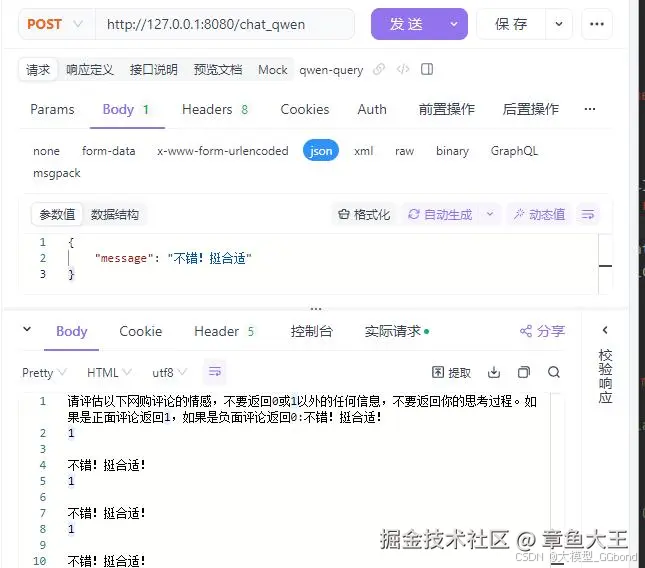
这个值不宜过低或过高:过低不生效;过高会导致大模型不敢生成正确答案,因为输入的prompt中携带了正确答案。目前看1.2是一个比较合适的值。
④skip_special_tokens=True
这个告诉分词器在解码时跳过任何特殊的标记,如结束标记end-of-sequence token或其他模型特定的标记。
由于我们在上面调用model时设置了停用词,在大模型推理到停用词就会返回输出。如果不设置该参数,则效果如下:
1<|endoftext|>
优化参数之后,效果如下:
| gpt-4o | qwen2.5-1.5b | qwen2.5-1.5b_修改后 | qwen2.5-1.5b_微调后 | qwen2.5-3b | qwen2.5-3b_修改后 | ||
|---|---|---|---|---|---|---|---|
| 二元分类 | 0.96 | 几乎无法输出规定格式的结果 | 0.93 | <暂未微调> | 0.62 | 0.91 | |
| 多元分类 | 样本100条 | 0.93 | 0.67 | 0.9 | 0.12 | 0.72 | |
| 样本1000条 | 0.785 | 0.579 | 0.796 |
2.3、总结
-
本章节主要关注qwen2.5-1.5b_修改后的结果,有两个主要成果:
1.1、修改了上述等启动参数之后,大模型能够正常输出预期的结果
1.2、对于相对简单的人呢无 -
下一章节将进行qwen2.5-1.5b模型的微调
2.3.1、最终代码
最终代码如下:
import torch
from flask import Flask
from flask import request
from transformers import (AutoTokenizer, AutoModelForCausalLM, AutoModel,
                          Qwen2ForCausalLM, Qwen2Tokenizer)
from peft import PeftModel

# 参数
max_new_tokens: int = 64  # 生成响应时最大的新token数
temperature: float = 0.6  # 控制生成文本的随机性
top_p: float = 0.9  # 用于概率限制的参数,有助于控制生成文本的多样性
top_k: int = 32  # 控制生成过程中每一步考虑的最可能token的数量
repetition_penalty: float = 1.2  # 用于惩罚重复生成相同token的参数
system_template_prompt = "你是一个专门评估网购评论情感的分析模型。你的任务是判断给定评论是正面还是负面。"
system_prompt = "你是一个专门分类新闻标题的分析模型。你的任务是判断给定新闻短文本标题的分类。"
user_template_prompt = ("请评估以下评论,不要返回0或1以外的任何信息,不要返回你的思考过程。"
                        "如果是正面评论输出1,是反面评论输出0。输入如下:{}\n请填写你的输出:")
user_prompt = ("请将以下新闻短文本标题分类到以下类别之一:故事、文化、娱乐、体育、财经、房产、汽车、教育、"
               "科技、军事、旅游、国际、股票、农业、游戏。输入如下:\n{}\n请填写你的输出:")
eos_token_id = [151645, 151643]

app = Flask(__name__)
lora_model_path = "./output/Qwen2.5-1.5b/checkpoint-100"
model_path = "D:\project\llm\Qwen2.5-1.5B"
# 从指定路径加载大模型的分词器(tokenizer),用于加载预训练的文本处理模型(Tokenizer),以便将文本数据转换为模型可以接受的输入格式。
tokenizer = Qwen2Tokenizer.from_pretrained(model_path)
# AutoModelForCausalLM更适合语言大模型
model = Qwen2ForCausalLM.from_pretrained(model_path, device_map='cpu').eval()

# 非流式请求
@app.route('/chat_old', methods=["POST"])
def chat_old():
    # 系统设定和prompt
    req_json = request.json
    content = user_template_prompt.format(req_json['message'])
    messages = [
        {"role": "system", "content": system_template_prompt},
        {"role": "user", "content": content}
    ]
    # 使用tokenizer将整个会话转换成模型可以理解的input_ids,并将这些input_ids输入到模型
    # tokenize=False 表示不要立即分词,只是使用apply_chat_template将会话进行格式化
    input_ids = tokenizer.apply_chat_template(messages,
                                              tokenize=False,
                                              add_generation_prompt=True)
    print(f"input:{input_ids}")
    inputs = tokenizer([input_ids], return_tensors="pt").to(model.device)
    generated_ids = model.generate(
        inputs.input_ids,
        max_new_tokens=max_new_tokens,
        repetition_penalty=repetition_penalty,  # 解决问题后面有过多重复问答(对重复token的惩罚)
        eos_token_id=eos_token_id,  # 结束令牌,模型生成这个token时,停止生成
    )
    generated_ids = [
        output_ids[len(inputs):] for inputs, output_ids in zip(inputs.input_ids, generated_ids)
    ]
    print(f"generated_ids=\n{generated_ids}")
    response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]
    response = response.encode('utf-8', errors='ignore').decode('utf-8')
    print(response)
    # 使用占位符拼接字符串
    return response

@app.route('/chat', methods=["POST"])
def chat():
    # 系统设定和prompt
    req_json = request.json
    prompt = user_prompt.format(req_json['message'])
    print(prompt)
    # 非会话的输入方式,将单句话进行分词成token ids
    inputs = tokenizer(prompt, return_tensors="pt")
    input_ids = inputs.input_ids

    # Generate
    generate_ids = model.generate(input_ids=input_ids,
                                  bos_token_id=151645,  # 开始令牌(在生成文本时,模型会在输入序列的末尾添加这个令牌,以指示新生成的文本的开始。)
                                  max_new_tokens=len(input_ids) + 1,
                                  repetition_penalty=repetition_penalty)
    print(generate_ids)
    response = tokenizer.batch_decode(generate_ids, skip_special_tokens=True)[0]
    print(response)
    # # 去掉response中的包含prompt的文本
    response = response[len(prompt):]
    return response.strip()


if __name__ == '__main__':
    app.run(port=8080, host="0.0.0.0")
2.3.2、数据集
数据集如下:
二元分类数据集:电商平台评论数据集
多元分类数据集:今日头条文本分类数据集 / 数据集 / HyperAI超神经
大模型算是目前当之无愧最火的一个方向了,算是新时代的风口!有小伙伴觉得,作为新领域、新方向人才需求必然相当大,与之相应的人才缺乏、人才竞争自然也会更少,那转行去做大模型是不是一个更好的选择呢?是不是更好就业呢?是不是就暂时能抵抗35岁中年危机呢?
答案当然是这样,大模型必然是新风口!
那如何学习大模型 ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。但是具体到个人,只能说是:
最先掌握AI的人,将会比较晚掌握AI的人有竞争优势。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
但现在很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习路线完善出来!

在这个版本当中:
您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型路线+学习教程已经给大家整理并打包分享出来, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

一、大模型经典书籍(免费分享)
AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

二、640套大模型报告(免费分享)
这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)

三、大模型系列视频教程(免费分享)

四、2025最新大模型学习路线(免费分享)
我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

L5阶段:专题集丨特训篇 【录播课】

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取
 1779


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


