大模型新书推荐丨《百面大模型》,大模型面试人最强解析!

大模型面试宝典.zip 大模型(LLMs)知识体系目录 P LLMs 激活函数篇 P 大模型(LLMs) RAG 版面分析——表... P LLMs 损失函数篇 P RAG (Retrieval-Augmented Generati... P 大模型(LLMs) RAG 版面分析——文... P Graph RAG 面——一种基于知识图谱的... P 大模型(LLMs) RAG 优化策略——RA... P 大模型(LLMs)推理面 P 检索增强生成(RAG)优化策略篇 进阶专题 P+ 大模型(LLMs) 强化学习面 P+ 大模型(LLMs) 强化学习——PPO面 P+ 大模型(LLMs)微调面 P+ 大模型(LLMs)评测面 P+ 大模型(LLMs) LLM生成SFT数据方法面 深度优化模块 P+ 大模型(LLMs) 增量预训练篇 P+ 大模型(LLMs) 参数高效微调(PEFT)面 P+ 大模型(LLMs) 易存问题面 P+ 大模型(LLMs) 许集面 P+ 大模型(LLMs) RAG—关键痛点及 P+ LLMs 推理性能面 P+ 大模型(LLMs) 强化学习——RLET ... ... 立即下载

“AI 大模型太卷了,我每天用 DeepSeek 却不知道怎么在面试里答题。”

“明明刷了很多题,可一到面试就慌得要死。”

——这是我最近听到最多的两句话。

如果你是正在准备秋招同学,或者是一位想转型大模型方向的工程师,下面这些内容,可能会让你少走很多弯路。

😖 面试到底靠“运气”还是靠“玄学”?

在这个技术快速迭代的时代,尤其是大模型领域,许多面试者会有一种强烈的挫败感:

  • 面试官一张口就是“MoE调度策略和稀疏激活”,瞬间大脑放空。
  • 明明自己在公司天天用大模型 API,结果一句“请你讲讲 RLHF 的实现细节”直接答不出来。
  • ChatGPT、DeepSeek、Kimi 用得顺手,但到了面试,不知道怎么从“用”切换到“懂”。

问题不是你不会,是你没准备对。

📘 100道高频真题,击穿面试玄学——《百面大模型》

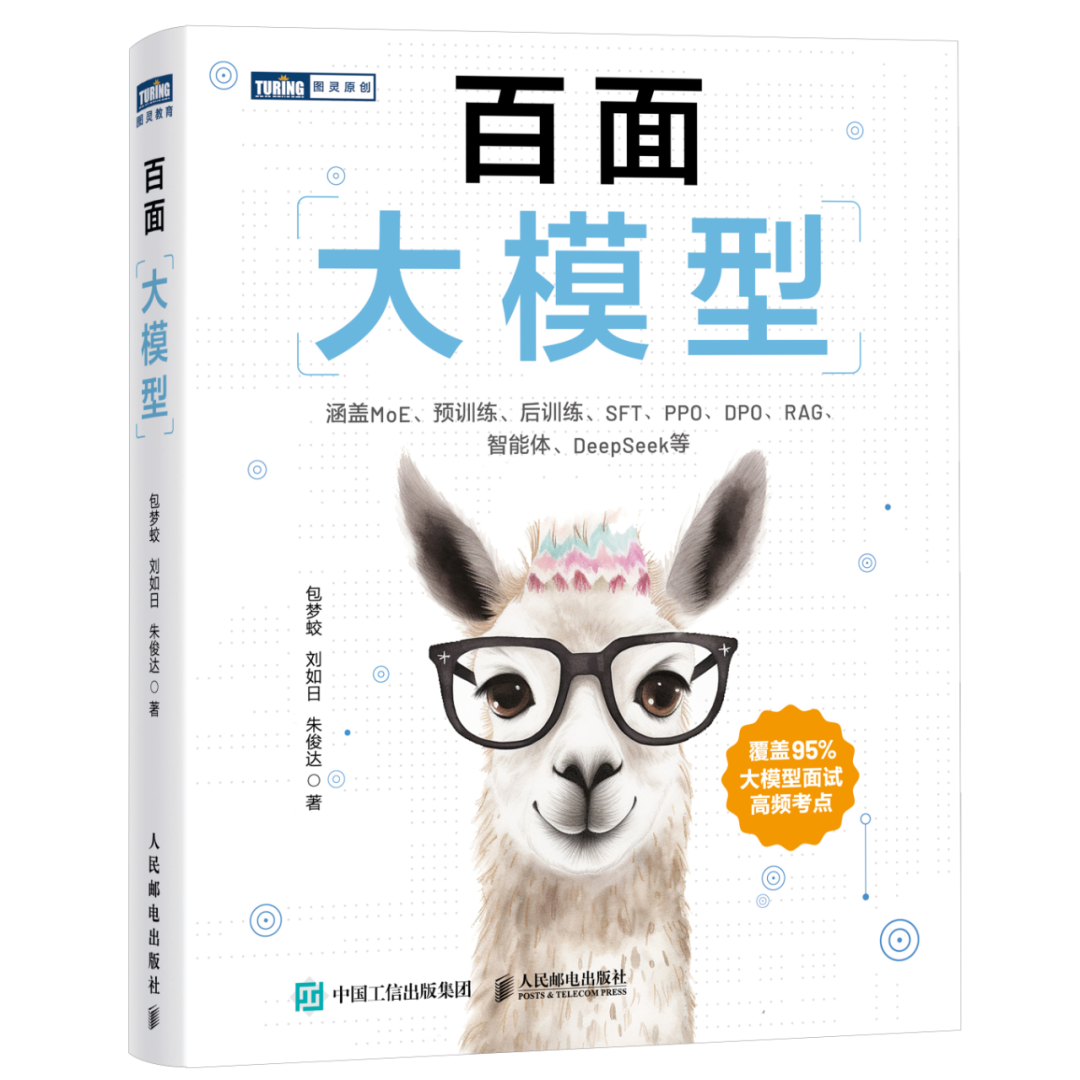
这就是我为什么要推荐这本书:《百面大模型》。
图片

本书已经整理并打包成PDF了,扫描即可拿到这本书

​

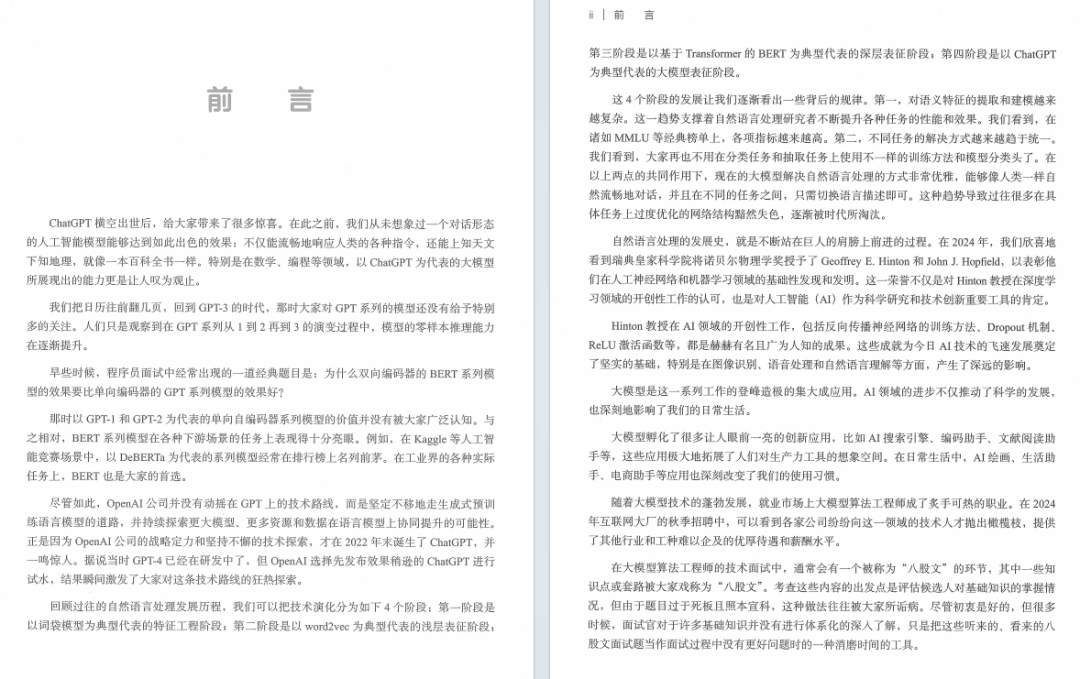
本书收录了约百道大模型工程师常见的面试题目和解答,系统、全面地介绍了与大模型相关的技术,涵盖语义表达、数据预处理、预训练、对齐、垂类微调、组件、评估、架构、检索增强生成(RAG)、智能体、PEFT(参数高效微调),以及训练与推理等内容。

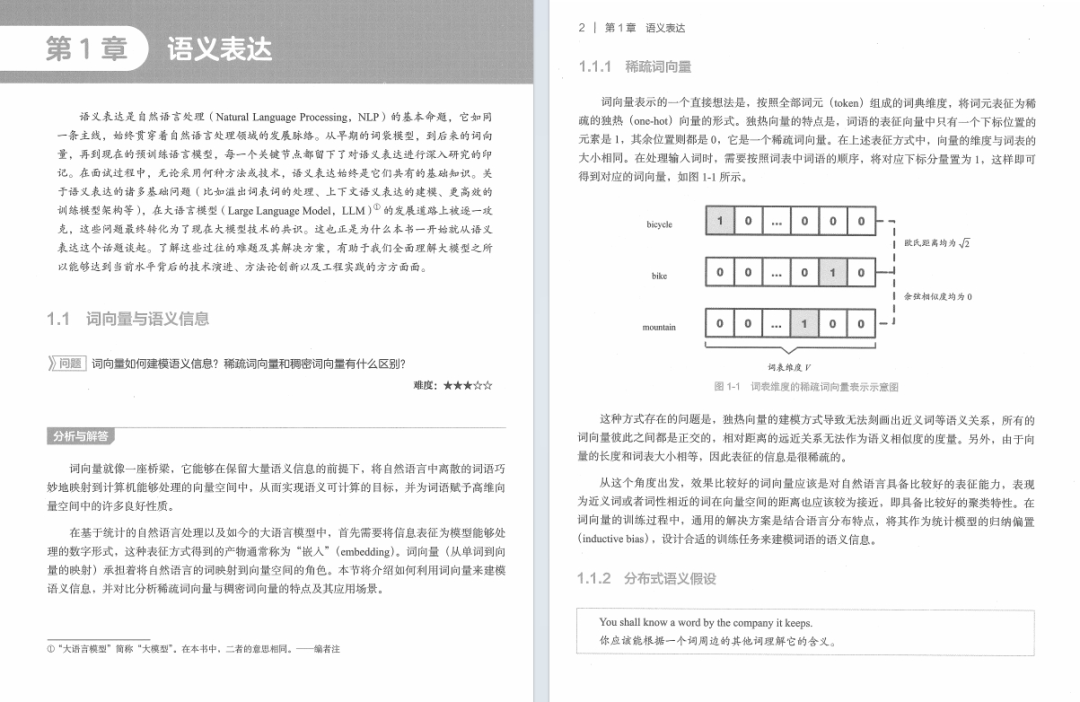
书中通过丰富的实例、图表及代码讲解,将复杂概念阐释得通俗易懂,是大模型领域的一本不可多得的实用指南。本书适合对大模型和Transformer等技术感兴趣的学生、研究者和工程师阅读和参考。

作者简介

包梦蛟,北京航空航天大学硕士,美团北斗计划高级算法专家,负责大众点评大模型应用落地开发,曾获得Kaggle Grandmaster称号、KDD CUP 2024冠军,业余时间撰写知乎专栏和公众号“包包算法笔记”,全网关注数5万+。

刘如日,北京航空航天大学硕士,研究兴趣为机器学习与自然语言处理。曾以第一作者身份发表顶会论文并多次在顶会竞赛中取得冠军等优异成绩。现于美团从事大模型相关技术研究与产业应用。

朱俊达,北京航空航天大学硕士,研究兴趣为大模型架构优化方向,有多家大厂实习经历,发表了多篇大模型相关论文。

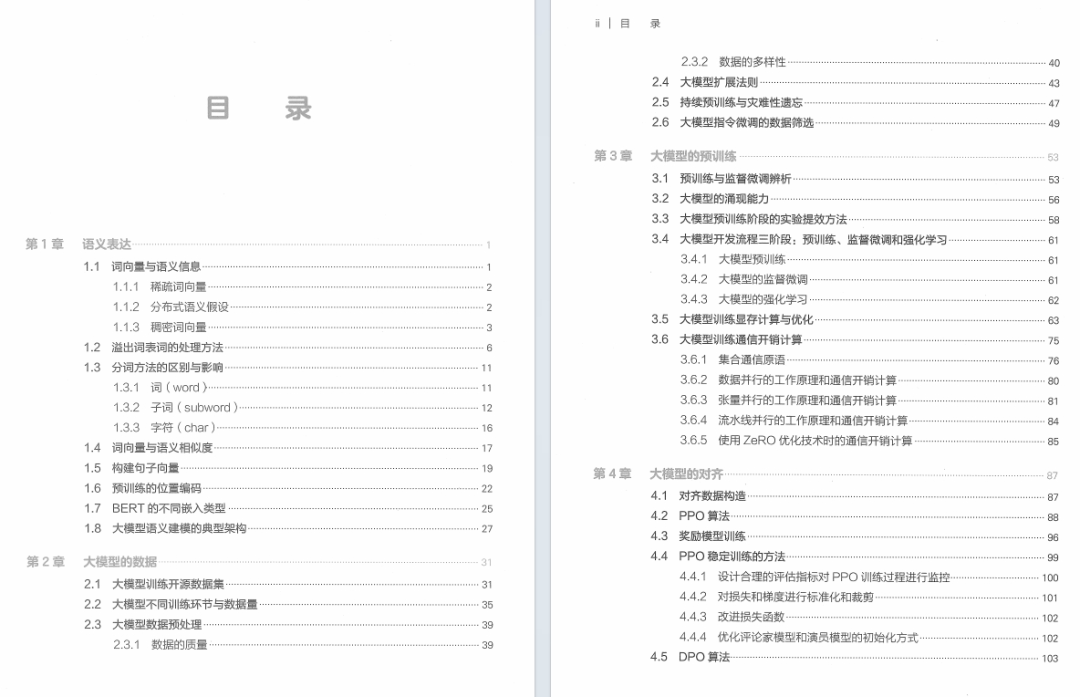
目录

第 1章 语义表达 1

  • 1.1 词向量与语义信息 1
  • 1.2 溢出词表词的处理方法 6
  • 1.3 分词方法的区别与影响 11
  • 1.4 词向量与语义相似度 17
  • 1.5 构建句子向量 19
  • 1.6 预训练的位置编码 22
  • 1.7 BERT的不同嵌入类型 25
  • 1.8 大模型语义建模的典型架构 27

第 2章 大模型的数据 31

  • 2.1 大模型训练开源数据集 31
  • 2.2 大模型不同训练环节与数据量 35
  • 2.3 大模型数据预处理 39
  • 2.4 大模型扩展法则 43
  • 2.5 持续预训练与灾难性遗忘 47
  • 2.6 大模型指令微调的数据筛选 49

第3章 大模型的预训练 53

  • 3.1 预训练与监督微调辨析 53
  • 3.2 大模型的涌现能力 56
  • 3.3 大模型预训练阶段的实验提效方法 58
  • 3.4 大模型开发流程三阶段:预训练、监督微调和强化学习 61
  • 3.5 大模型训练显存计算与优化 63
  • 3.6 大模型训练通信开销计算 75

第4章 大模型的对齐 87

  • 4.1 对齐数据构造 87
  • 4.2 PPO算法 88
  • 4.3 奖励模型训练 96
  • 4.4 PPO稳定训练的方法 99
  • 4.5 DPO算法 103
  • 4.6 DPO与PPO辨析 105
  • 4.7 其他偏好对齐方法综述 108
  • 4.8 对齐训练稳定性监测 119
  • 4.9 大模型后训练环节辨析 122

第5章 大模型的垂类微调 124

  • 5.1 (垂类)监督微调 124
  • 5.2 后训练的词表扩充 128
  • 5.3 有效的长度外推方法 130
  • 5.4 大模型微调的损失函数 140
  • 5.5 大模型知识注入方法 144

第6章 大模型的组件 147

  • 6.1 Transformer的架构 147
  • 6.2 注意力分数计算细节 153
  • 6.3 词元化算法的区别与特点 156
  • 6.4 RoPE 160
  • 6.5 ALiBi 165
  • 6.6 Sparse Attention 169
  • 6.7 Linear Attention 173
  • 6.8 多头注意力机制及其优化(MHA、MQA 和GQA) 175
  • 6.9 各种归一化方法 181
  • 6.10 归一化模块位置的影响——PostNorm和PreNorm 184
  • 6.11 Dropout机制 187
  • 6.12 模型训练参数初始化方法概述 190

第7章 大模型的评估 194

  • 7.1 大模型的评测榜单与内容 194
  • 7.2 大模型评测的原则 199
  • 7.3 大模型的修复方法 200
  • 7.4 生成式模型的评测指标 203
  • 7.5 大模型的自动化评估 209
  • 7.6 大模型的对抗性测试 211
  • 7.7 大模型的备案流程 212

第8章 大模型的架构 217

  • 8.1 因果解码器架构成为主流的原因 217
  • 8.2 大模型的集成融合方法 220
  • 8.3 MoE 226

第9章 检索增强生成 233

  • 9.1 RAG的组成与评估 233
  • 9.2 RAG中的召回方法 237
  • 9.3 RAG与重排 241
  • 9.4 RAG的工程化问题 244

第 10章 大模型智能体 248

  • 10.1 智能体的组成 248
  • 10.2 智能体的规划能力 251
  • 10.3 智能体的记忆模块 255
  • 10.4 智能体的工具调用 257
  • 10.5 XAgent框架 263
  • 10.6 AutoGen框架 266
  • 10.7 智能体框架实践 269

第 11章 大模型PEFT 273

  • 11.1 LoRA 273
  • 11.2 PEFT方法概述 279
  • 11.3 PEFT与全参数微调 286

第 12章 大模型的训练与推理 288

  • 12.1 大模型解码与采样方法综述 288
  • 12.2 大模型生成参数及其含义 292
  • 12.3 大模型训练与推理预填充阶段的加速方法——FlashAttention 297
  • 12.4 大模型专家并行训练 317
  • 12.5 大模型推理加速——PagedAttention 321
  • 12.6 大模型量化的细节 327
  • 12.7 大模型多维并行化训练策略 328

第 13章 DeepSeek 335

  • 13.1 DeepSeek系列模型架构创新 335
  • 13.2 DeepSeek-R1训练流程 353
  • 参考文献 357

《百面大模型》真正厉害的地方在于——它不是单纯的“背八股”,而是帮你建立起一套系统的知识框架和思维逻辑。

每道题都配有:

  • 🧠 背后的原理分析
  • 🧩 面试官意图解析
  • 🛠 答题思路拆解 + 延伸知识点

它像一个“你身边的面试指导专家”,告诉你:“这题不只是问概念,它其实在考你XXX底层机制是否理解。”

《百面大模型》不仅能助你拿下 Offer,也能成为你工作、学习过程中的「知识点速查手册」。

本书已经整理并打包成PDF了,扫描即可拿到这本书
​

我们该怎样系统的去转行学习大模型 ?

很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习门槛,降到了最低!

在这个版本当中:

第一您不需要具备任何算法和数学的基础
第二不要求准备高配置的电脑
第三不必懂Python等任何编程语言

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包分享出来, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全链接,放心点击)👈

​

​

一、大模型经典书籍(免费分享)

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套大模型报告(免费分享)

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、大模型系列视频教程(免费分享)

在这里插入图片描述

四、2025最新大模型学习路线(免费分享)

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

在这里插入图片描述

L1阶段:启航篇丨极速破界AI新时代
​​​​​​​L1阶段:我们会去了解大模型的基础知识,以及大模型在各个行业的应用和分析;学习理解大模型的
核心原理、关键技术以及大模型应用场景。

在这里插入图片描述

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段是我们的AI大模型RAG应用开发工程,我们会去学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

在这里插入图片描述

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,我们会去学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造我们自己的Agent智能体。

在这里插入图片描述

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,我们会更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调;并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

在这里插入图片描述

L5阶段:专题集丨特训篇 【录播课】

在这里插入图片描述
全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全链接,放心点击)👈

​

全面概述 大型语言模型.pdf 立即下载

相关推荐

《AI大模型应用》-该仓库主要记录 大模型(LLMs) 算法工程师相关的面试题.zip

个人深耕AI大模型应用领域积累的成果,希望对您有所帮助。有大模型账号、环境问题、AI大模型技术应用落地方案等相关问题,欢迎详聊,能为您解决问题是我的荣幸! 个人深耕AI大模型应用领域积累的成果,希望对您有所帮助。有大模型账号、环境问题、AI大模型技术应用落地方案等相关问题,欢迎详聊,能为您解决问题是我的荣幸! 个人深耕AI大模型应用领域积累的成果,希望对您有所帮助。有大模型账号、环境问题、AI大模型技术应用落地方案等相关问题,欢迎详聊,能为您解决问题是我的荣幸! 个人深耕AI大模型应用领域积累的成果,希望对您有所帮助。有大模型账号、环境问题、AI大模型技术应用落地方案等相关问题,欢迎详聊,能为您解决问题是我的荣幸! 个人深耕AI大模型应用领域积累的成果,希望对您有所帮助。有大模型账号、环境问题、AI大模型技术应用落地方案等相关问题,欢迎详聊,能为您解决问题是我的荣幸! 个人深耕AI大模型应用领域积累的成果,希望对您有所帮助。有大模型账号、环境问题、AI大模型技术应用落地方案等相关问题,欢迎详聊,能为您解决问题是我的荣幸!

大模型内容分享(十六):大模型最全八股(一)

LLM(Large Language Model,大型语言模型)是指基于大规模数据和参数量的语言模型。具体的架构可以有多种选择,以下是一种常见的大模型LLM的架构介绍:Transformer架构:大模型LLM常使用Transformer架构,它是一种基于自注意力机制的序列模型。Transformer架构由多个编码器层和解码器层组成,每个层都包含多头自注意力机制和前馈神经网络。这种架构可以捕捉长距离的依赖关系和语言结构,适用于处理大规模语言数据。

之乎者也·的博客 1067

AVM环视算法实战:从3D碗型投影到多场景模式切换的实现与优化

本文深入探讨了AVM环视算法在3D碗型投影和多场景模式切换中的实现与优化。通过分析3D碗型投影的核心原理和动态视角调节技术,展示了如何实现从超广角模式到转向模式的无缝切换。文章还分享了性能优化实战经验,包括实时性提升和图像拼接质量优化,为开发者提供了宝贵的AVM系统开发指南。

weixin_42573113的博客 170

《百面大模型》技术人都在看,大模型面试最强解析(PDF分享)

如果你是正在准备秋招同学,或者是一位想转型大模型方向的工程师,下面这些内容,可能会让你少走很多弯路。

2301_81940605的博客 1615

UWB灵犀遥控器方案介绍

UWB灵犀指向遥控器的技术原理和方案介绍

xiongdauwb的博客 3899

VL53L0X加盖玻片后精度暴跌?手把手教你完成串扰校准(CrossTalk Calibration)

本文详细解析了VL53L0X激光测距传感器加盖玻片后精度下降的原因,并提供了串扰校准(CrossTalk Calibration)的完整解决方案。通过分步指导和实用代码示例,帮助工程师恢复毫米级测距精度,适用于智能门锁、扫地机器人等应用场景。

weixin_33708432的博客 539

大模型新书推荐丨百面大模型:大模型百日攻坚战(PDF分享)

《百面大模型》作为2025年大模型领域的热门技术书籍,以“100道高频面试题+全栈知识体系”为核心特色,为大模型从业者提供了从理论到实战的系统化指南。

2301_81940605的博客 1427

多模态RAG实战:为LLM装上视觉之眼,实现图文混合文档智能问答

检索增强生成(RAG)技术通过结合外部知识库,有效缓解了大语言模型(LLM)的幻觉问题,并扩展了其知识边界。其核心原理是将文档切分、向量化后存入向量数据库,在问答时通过语义检索召回相关上下文,辅助LLM生成更精准的答案。这项技术的核心价值在于,它为大模型应用提供了一种低成本、高效率的知识注入与实时更新方案,广泛应用于智能客服、知识库问答、文档分析等场景。随着应用深入,纯文本RAG在处理产品手册、学术论文、设计图纸等富含视觉信息的文档时面临瓶颈。本文聚焦的**多模态RAG**和**视觉理解**技术,正是为了解

weixin_30698527的博客 722

普通人用豆包AI赚钱的四条可行路径实录

AI工具变现的本质,是将大模型的能力转化为可交付、可复制、可验证的数字服务。豆包作为深度适配中文场景的AI助手,凭借角色固化、本地化服务链路和合规稳定性,在信息加工、内容生产与流程提效等基础能力上展现出突出的落地确定性。相比追求技术参数的通用模型,它更擅长解决职场人真实存在的周报写作、小红书起号、简历优化、知识整理等高频刚需。本文基于三个月23,864元真实入账记录,系统拆解四条经过验证的变现路径,涵盖获客逻辑、模板化SOP、避坑细节与交付包装,为零基础用户降低试错成本,提供一条不依赖流量运营、无需专业资质

463

GoPro官方API实战:从蓝牙配对到Wi-Fi流媒体,构建跨平台控制应用

本文详细解析了GoPro官方API的开发实践,涵盖蓝牙配对、Wi-Fi流媒体控制等关键技术。通过实战案例,指导开发者如何构建跨平台控制应用,解决设备发现、指令解析、视频流传输等核心问题,并分享Android平台迁移经验与常见问题排查方法。

weixin_30727835的博客 397

MAPPO实战:从理论到代码的协作智能体训练指南

本文详细介绍了MAPPO算法在多智能体协作训练中的实战应用,从理论基础到代码实现全面解析。通过对比PPO与MAPPO的差异,深入讲解CTDE框架、网络架构设计、参数调优等关键环节,并提供实际项目中的调参经验和常见问题解决方案,帮助开发者快速掌握这一强化学习前沿技术。

weixin_42561040的博客 265

大模型书籍丨《百面大模型》,一书打通大模型求职与实战

最近书单更新得有点勤,除了自己买的,还收到不少编辑社寄来的书。我挑了一些确实不错的(大概十分之一),推荐给大家!

DEVELOPERAA的博客 1776

【Android逆向工程】第18章:Ollvm 混淆与对抗

本章介绍了Ollvm混淆技术及其对抗方法。Ollvm是基于LLVM的开源代码混淆工具,主要实现控制流平坦化、虚假控制流和指令替换三种混淆技术。控制流平坦化通过状态变量和switch-case结构隐藏真实控制流,将原本清晰的逻辑拆分为多个状态块。混淆后的代码在静态分析中难以理解,但可通过动态追踪执行路径、符号执行等方法来还原原始逻辑。本章还提供了混淆代码示例和对抗策略,帮助理解Ollvm的工作原理及其防御方法。

w987333120的博客 213

百面大模型PDF电子书:从面试真题到实战技巧,解锁大模型核心秘籍!

今天想和大家分享一本最近在技术圈爆火的“大模型红宝书”——《百面大模型》。这本书不仅是大模型求职者的“面试题库”,更是工程师、研究者的“实战手册”。

2301_81888214的博客 1780

【我的Android进阶之旅】异常: Problems reading data from Binary store in Local\Temp\gradlexxx.bin (exist: true)

一、异常描述 今天开个会议,电脑自动关机了,重启电脑之后,打开Android Studio,编译代码,就编译失败,如下所示:异常提示 : Caused by: java.lang.RuntimeException: Problems reading data from Binary store in C:\Users\000\AppData\Local\Temp\gradle6337489649031706149.bin (exist: true) Caused by: java.lang.Runtime

字节卷动 3822

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

大模型新书丨大模型面试全靠玄学?这本百面大模型助你查漏补缺

在大模型掀起的新一轮 AI 革命中,技术栈更新得飞快,岗位薪资一路走高,门槛也随之水涨船高。

DEVELOPERAA的博客 864

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

《百面大模型》打通大模型求职与实战的关键一书

《百面大模型》围绕 100 道核心面试题 精心编排,覆盖大模型学习与就业所需的全链路能力,内容共分为 五大部分:

EnjoyEDU的博客 1824

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

IDEA的使用指南

IDEA基于java的使用手册,可以最快速的上手,在使用中不断的丰富自己的使用技巧.

2024超全大模型算法岗面经|大模型算法岗常见面试题100道(PDF版含答案)

大模型LLM(Large Language Models) 通常采用基于Transformer的架构。Transformer模型由多个编码器或解码器层组成,每个层包含多头自注意力机制和前馈神经网络。这些层可以并行处理输入序列中的所有位置,捕获长距离依赖关系。大模型通常具有数十亿甚至数千亿个参数,可以处理大量的文本数据,并在各种NLP任务中表现出色。

2401_85328934的博客 1733

大模型面试题必背知识点:百面大模型

大模型是指参数量通常在数十亿到数万亿级别的深度学习模型,具有强大的泛化能力和涌现能力。典型代表有GPT系列、BERT、PaLM等。参数规模:通常>10亿参数涌现能力:在特定规模下出现的新能力预训练+微调的范式。

weixin_43632102的博客 1095

大模型电子书分享 | 这份必读书单清单请收好(附PDF)

本期书单精心整理了一份大模型领域的必读书籍,覆盖学习的各个阶段,帮你理清重点,精准锁定最核心、最实用的内容,助你快速突破认知和技术瓶颈。

2301_81940605的博客 985

这本免费电子书火了!这次为什么又是浙大?(附pdf)

这本《大模型基础》分为六大章节:语言模型基础、大语言模型架构、Prompt工程、参数高效微调、模型编辑和检索增强生成,共283页。软件学院副院长高云君教授为编撰总指导。截至目前,它在GitHub拥有7.8K Stars(星标),在这个开源社区里已是相当不错的评价。

瓦罗兰特顶级C位的博客 1447

大模型算法工程师面试题,(非常详细)收藏这一篇就够了!大模型面试题+答案!

本文详解RAG系统文档预处理技术,重点讲解PDF文档中文字、表格和图片的提取方法。深入解析MCP协议工作机制、与Function call的区别及适用场景,为构建大模型应用提供实用技术指导。

2401_85390073的博客 816

《百面大模型》补充60道大模型面试题,附答案!

我在面试候选人和参加业内研讨会时,常常发现很多人有大量实战经验,但对模型的基本原理知之甚少。为了帮助大家更好地理解本书,也为了方便部分有面试需求的朋友更有针对性地阅读本书,围绕本书各章主题,我系统梳理了大模型领域常见的面试题,其中的大多数问题可以在书中直接找到答案,部分进阶问题可以从本书的参考文献或网络上的最新论文中找到答案。希望所有的朋友都能够带着这些问题阅读本书。

m0_59164520的博客 978

AI大模型工程师面试宝典!300道常见问题及答案详解,从零基础到精通一篇搞定(有PDF版)!

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

m0_74942241的博客 1209

【NLP百面百过】史上最全大模型(LLMs)面试题系列:帮你彻底搞定Transformer-干货!

基于Sinusoidal的位置编码最初是由谷歌在论文Attention is All You Need中提出的方案,用于Transformer的位置编码。具体计算方式如下所示:其中pos是位置,i表示维度。具有相对位置表达能力:Sinusoidal可以学习到相对位置,对于固定位置距离的k,PE(i+k)可以表示成PE(i)的线性函数。两个位置向量的内积只和相对位置 k 有关。Sinusoidal编码具有对称性。,即,这表明Sinusoidal编码具有对称性。

一个程序猿的AI转型之路 2907

真正想搞懂大模型的人,都在啃这 5 本书!(附PDF)

手指一滑,一个“三分钟读懂Transformer”的视频;再一刷,一篇“五个提示词技巧让你秒变AI大师”的推文。每天,我们被这些快知识喂养着,以为自己正在学习、正在进步。

huang9604的博客 738
上一篇: 写给大模型新人的经验:入门大模型刷到少走三年弯路!大模型从入门到精通,收藏这篇就够了
下一篇: Docker 实战教程:应急救援案例大数据可视化平台,大模型入门到精通,收藏这篇就足够了!
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值