重磅发布 | 复旦533页《大规模语言模型:从理论到实践(第2版)》(免费下载)

大模型语言模型:从理论到实践 大规模语言模型(Large Language Models,LLM),也称大语言模型或大型语言模型,是一种由包含数百亿以上参数的深度神经网络构建的语言模型,通常使用自监督学习方法通过大量无标注文本进行训练。自2018年以来,Google、OpenAI、Meta、百度、华为等公司和研究机构都相继发布了包括BERT,GPT等在内多种模型,并在几乎所有自然语言处理任务中都表现出色。 阅读详情

在人工智能浪潮席卷全球的今天,大语言模型正以前所未有的速度推动着科技进步和产业变革。从 ChatGPT 到各类行业应用,LLM 不仅重塑了人机交互的方式,更成为推动学术研究与产业创新的关键技术。

面对这一飞速演进的技术体系,如何系统理解其理论基础、掌握核心算法与工程实践,已成为每一位 AI 从业者、研究者、高校学子的必修课。

这些发现促使本书的作者“复旦大学NLP团队”张奇、桂韬、郑锐、黄萱菁几位老师对本书第 1 版进行修订升级,补充最新的研究成果和技术内容。

《大规模语言模型:从理论到实践(第2版)》的出版上市,希望可以让读者快速掌握大语言模型的研究与应用,更好地应对相关技术挑战,为推动这一领域的进步贡献力量。

这本《大规模语言模型:从理论到实践(第2版)》书已整理并打包好PDF了

点击可拿↓↓↓

​

大规模语言模型:从理论到实践(第2版).jpg

目录:

第1章 绪论1

1.1 大语言模型的基本概念1

1.2 大语言模型的发展历程4

1.3 大语言模型的构建流程8

1.4 本书的内容安排10

第2章 大语言模型基础13

2.1 Transformer结构13

2.1.1 嵌入表示层14

2.1.2 注意力层15

2.1.3 前馈层18

2.1.4 残差连接与层归一化19

2.1.5 编码器和解码器结构20

2.2 生成式预训练语言模型GPT25

2.2.1 自监督预训练25

2.2.2 有监督下游任务微调26

2.2.3 预训练语言模型实践27

2.3 大语言模型的结构32

2.3.1 LLaMA的模型结构33

2.3.2 注意力机制优化39

2.4 混合专家模型46

2.4.1 稀疏混合专家模型47

2.4.2 稠密混合专家模型49

2.4.3 软混合专家模型50

2.5 实践思考51

第3章 大语言模型预训练数据52

3.1 数据来源52

3.1.1 通用数据53

3.1.2 领域数据55

3.2 数据处理56

3.2.1 质量过滤56

3.2.2 冗余去除57

3.2.3 隐私消除58

3.2.4 词元切分59

3.3 数据影响分析64

3.3.1 数据规模64

3.3.2 数据质量66

3.3.3 数据多样性69

3.4 开源数据集70

3.4.1 Pile 70

3.4.2 ROOTS73

3.4.3 RefinedWeb 75

3.4.4 CulturaX77

3.4.5 SlimPajama 78

3.5 实践思考82

第4章 分布式训练83

4.1 分布式训练概述83

4.2 分布式训练的并行策略85

4.2.1 数据并行86

4.2.2 模型并行90

4.2.3 混合并行98

4.2.4 计算设备内存优化99

4.3 分布式训练的集群架构103

4.3.1 高性能计算集群的典型硬件组成103

4.3.2 参数服务器架构104

4.3.3 去中心化架构105

4.4 DeepSpeed实践110

4.4.1 基础概念112

4.4.2 LLaMA分布式训练实践115

4.5 实践思考126

第5章 指令微调127

5.1 指令微调训练127

5.1.1 指令微调数据127

5.1.2 指令微调数据构建方法129

5.1.3 指令微调数据评估与影响135

5.1.4 指令微调训练策略141

5.1.5 开源指令数据集142

5.2 高效模型微调144

5.2.1 LoRA 144

5.2.2 LoRA的变体148

5.3 模型上下文窗口扩展150

5.3.1 具有外推能力的位置编码150

5.3.2 插值法151

5.4 DeepSpeed-Chat SFT实践153

5.4.1 代码结构155

5.4.2 数据预处理157

5.4.3 自定义模型159

5.4.4 模型训练161

5.4.5 模型推理162

5.5 实践思考162

第6章 强化学习164

6.1 强化学习概述164

6.1.1 强化学习基础概念165

6.1.2 强化学习与有监督学习的区别166

6.2 策略梯度方法168

6.2.1 策略梯度168

6.2.2 REINFORCE算法170

6.2.3 广义优势估计171

6.2.4 近端策略优化算法173

6.2.5 RLOO算法175

6.2.6 GRPO算法177

6.3 推理模型的强化学习179

6.3.1 DeepSeek-R1 179

6.3.2 Kimi k1.5 182

6.4 基于人类反馈的强化学习185

6.4.1 基于人类反馈的强化学习流程185

6.4.2 奖励模型186

6.5 verl实践191

6.6 实践思考199

第7章 多模态大语言模型200

7.1 多模态大语言模型基础200

7.1.1 典型的多模态大语言模型201

7.1.2 多模态大语言模型的挑战204

7.2 大语言模型与多模态融合架构205

7.2.1 视觉语言模型架构205

7.2.2 语音语言模型架构209

7.2.3 多模态大语言模型架构213

7.3 多模态大语言模型训练策略217

7.3.1 数据处理218

7.3.2 视觉语义关联219

7.3.3 多模态文本对齐220

7.4 MiniGPT-4实践222

7.4.1 MiniGPT-4模型架构222

7.4.2 MiniGPT-4训练策略225

7.5 实践思考229

第8章 大模型智能体231

8.1 智能体基础231

8.1.1 智能体发展历史231

8.1.2 大模型智能体应用范式232

8.2 大模型智能体架构235

8.2.1 感知模块236

8.2.2 规划模块237

8.2.3 记忆模块238

8.2.4 工具使用模块239

8.3 大模型智能体训练241

8.3.1 工具学习241

8.3.2 推理规划244

8.3.3 长期记忆250

8.4 大模型智能体实践252

8.4.1 手工编写代码252

8.4.2 LangChain框架259

8.4.3 智能体平台Coze实践276

8.5 实践思考279

第9章 检索增强生成280

9.1 检索增强生成基础280

9.1.1 RAG系统的框架281

9.1.2 RAG任务分级282

9.1.3 RAG系统的难点286

9.2 Modular RAG架构287

9.2.1 索引模块288

9.2.2 检索前优化模块291

9.2.3 检索模块293

9.2.4 检索后优化模块296

9.2.5 生成模块297

9.2.6 编排模块298

9.3 RAG系统设计模式301

9.3.1 线性模式301

9.3.2 条件模式302

9.3.3 分支模式303

9.3.4 循环模式304

9.4 RAG系统优化306

9.4.1 文本嵌入模型微调306

9.4.2 查询优化308

9.4.3 幻觉感知的生成模型优化311

9.4.4 重排模型优化312

9.4.5 检索与生成联合优化315

9.5 RAG系统评估316

9.5.1 RAG系统评估的挑战316

9.5.2 评估目标317

9.5.3 评估数据集319

9.5.4 评估指标320

9.6 RAG实践324

9.6.1 构建基础RAG系统324

9.6.2 查询分解与检索结果融合的RAG系统326

9.7 实践思考328

第10章 大语言模型效率优化330

10.1 效率优化基础330

10.2 模型优化334

10.2.1 Transformer代替架构334

10.2.2 模型量化336

10.2.3 模型稀疏化339

10.2.4 知识蒸馏342

10.3 低精度训练345

10.3.1 FP8编码345

10.3.2 FP8大语言模型训练346

10.4 高效推理351

10.4.1 算法级别的推理优化351

10.4.2 系统级别的推理优化356

10.5 vLLM推理框架实践358

10.6 实践思考361

第11章 大语言模型评估362

11.1 模型评估概述362

11.2 大语言模型评估体系364

11.2.1 知识与能力364

11.2.2 伦理与安全367

11.2.3 垂直领域371

11.3 大语言模型评估方法376

11.3.1 评估指标376

11.3.2 评估方法381

11.4 大语言模型评估实践386

11.4.1 基础模型评估387

11.4.2 SFT模型和RL模型评估389

11.5 实践思考399

第12章 大语言模型应用开发401

12.1 大语言模型典型应用场景401

12.1.1 内容创作与生成401

12.1.2 对话系统与聊天机器人402

12.1.3 翻译与多语言处理403

12.1.4 信息抽取与知识图谱404

12.1.5 代码生成与编程辅助404

12.1.6 智能搜索与推荐405

12.1.7 教育与培训406

12.1.8 企业管理与决策支持407

12.1.9 法律与合规407

12.2 大语言模型应用开发案例408

12.2.1 浏览器智能插件408

12.2.2 论文搜索助理412

12.3 大语言模型本地部署实践413

12.3.1 llama.cpp 414

12.3.2 Ollama 417

12.3.3 Open WebUI 419

12.4 实践思考420

参考文献422

索引451

第二版核心升级内容如下**:**

(1) 前沿技术聚焦:深度剖析MoE架构、多模态、智能体、RAG四大技术趋势

(2) 知识体系重构:覆盖预训练→微调→强化学习→应用开发→效率优化的全流程

(3) 实践价值提升:新增逾40%的前沿研究成果与技术案例,增设工程实践指南与评估体系模块

章节

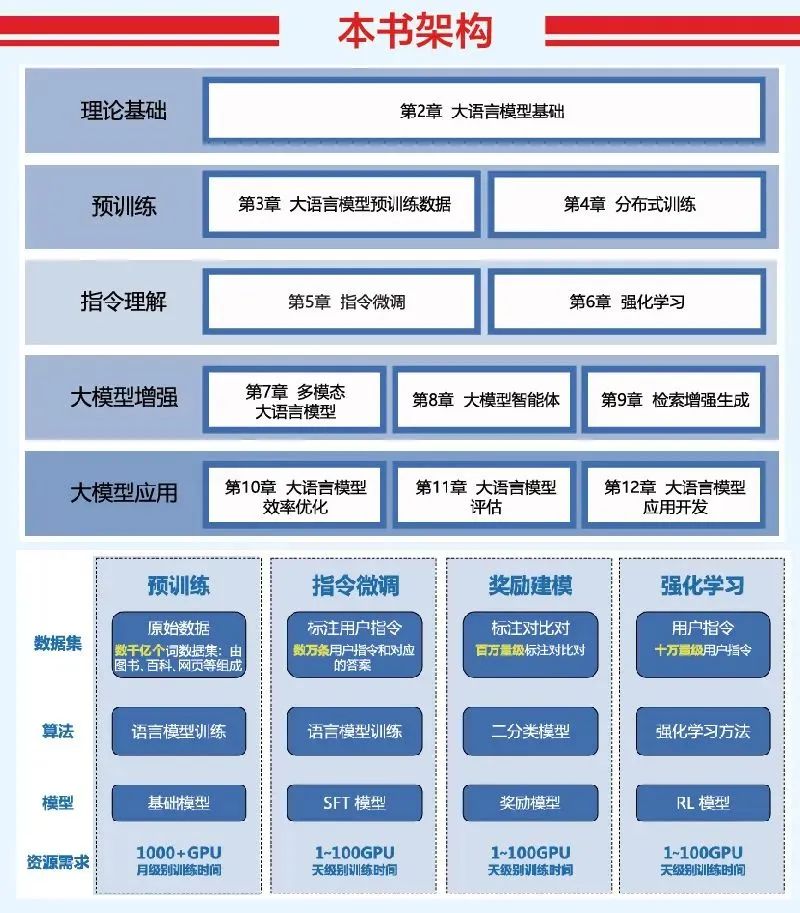
本书共分为12章,围绕大语言模型基础理论、预训练、指令理解、大模型增强和大模型应用五个部分展开。

第1章 绪论

简明介绍了大语言模型的基本概念、发展历史、构建流程,并说明了本书的结构安排,为读者建立起全局认知框架。

第2章 大语言模型基础

深入解析了 LLM 的核心结构——Transformer,包括嵌入、注意力、前馈网络等组成部分,并详解 GPT 模型、混合专家模型(MoE)等不同架构,帮助读者建立从基本结构到模型架构的技术认知。

第3章 预训练数据

介绍了预训练所需的大规模语料来源与数据处理方法(如清洗、去重、切词等),并探讨数据质量、规模、多样性对模型性能的影响。还列举了主流开源数据集,为实际预训练奠定数据基础。

第4章 分布式训练

详细讲解数据并行、模型并行、混合并行等策略及其内存优化技巧,结合实际框架(如 DeepSpeed)的实践,帮助读者理解如何高效训练大模型。

第5章 指令微调

系统介绍了指令微调的理念、数据构建与评估方法、LoRA 等高效微调技术,并辅以 DeepSpeed-Chat 的实践说明,面向实际应用强化模型指令理解与响应能力。

第6章 强化学习

聚焦于 RLHF(基于人类反馈的强化学习),介绍策略梯度、PPO 等算法在语言模型中的应用,结合 DeepSeek-R1、Kimi 等模型案例,展示 RL 在提升生成质量方面的重要作用。

第7章 多模态大语言模型

探讨语言模型与视觉、语音等模态融合的架构与挑战,并详细介绍 MiniGPT-4 的结构和训练方法,是理解 AI 从语言走向感知智能的关键章节。

第8章 大模型智能体

围绕“智能体”概念,讲述其模块化架构(感知、记忆、工具等),并以 LangChain 与 Coze 平台为实践例,说明如何基于 LLM 构建具备规划与行动能力的智能体系统。

第9章 检索增强生成(RAG)

系统介绍 RAG 的整体架构、模块化设计、优化策略与评估方法,适用于提升 LLM 在开放知识任务中的能力。也包括构建与优化 RAG 系统的工程实践。

第10章 效率优化

讨论 LLM 的训练与推理效率,包括模型压缩、低精度训练、稀疏化、知识蒸馏等方法,并以 vLLM 推理框架为实践案例,为部署与落地提供技术方案。

第11章 模型评估

构建了评估 LLM 的系统框架,涵盖知识能力、伦理安全与垂直领域,结合具体评估指标和数据集,为模型开发与应用提供反馈机制与质量保障。

第12章 应用开发

介绍 LLM 在多个场景的应用(如聊天、代码、搜索、教育等),并包含实际开发案例与本地部署实践(如 llama.cpp、Ollama),为开发者提供从原理到落地的全链路指南。

总结:

这本书构建了一个由理论基础 → 数据处理 → 模型训练 → 微调与强化 → 多模态 → 智能体 → 应用开发与部署组成的完整技术闭环,是面向工程实践和科研学习的全景式 LLM 教程。既适合新手入门,也适合有经验的开发者系统提升。

本书架构

围绕 LLM 理论基础、预训练、指令理解、大模型增强、大模型应用五大部分展开。

这本《大规模语言模型:从理论到实践(第2版)》书已整理并打包好PDF了

点击可拿↓↓↓
​

我们该怎样系统的去转行学习大模型 ?

很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习门槛,降到了最低!

在这个版本当中:

第一您不需要具备任何算法和数学的基础
第二不要求准备高配置的电脑
第三不必懂Python等任何编程语言

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包分享出来, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全链接,放心点击)👈

​

​

一、大模型经典书籍(免费分享)

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套大模型报告(免费分享)

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、大模型系列视频教程(免费分享)

在这里插入图片描述

四、2025最新大模型学习路线(免费分享)

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

在这里插入图片描述

L1阶段:启航篇丨极速破界AI新时代
​​​​​​​L1阶段:我们会去了解大模型的基础知识,以及大模型在各个行业的应用和分析;学习理解大模型的
核心原理、关键技术以及大模型应用场景。

在这里插入图片描述

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段是我们的AI大模型RAG应用开发工程,我们会去学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

在这里插入图片描述

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,我们会去学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造我们自己的Agent智能体。

在这里插入图片描述

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,我们会更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调;并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

在这里插入图片描述

L5阶段:专题集丨特训篇 【录播课】

在这里插入图片描述
全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

👉优快云大礼包🎁:全网最全《LLM大模型学习资源包》免费分享(安全链接,放心点击)👈

​

大规模语言模型从理论到实践 近年来,人工智能技术的迅猛发展在多个领域带来了革命性的变革,其中自然语言处理(NLP)技术是推动社会进步的重要驱动力。NLP技术的核心在于理解、生成和处理人类语言,涉及到文本分类、机器翻译、文本摘要、问答系统、对话系统等多个子领域。传统的NLP技术主要依赖于规则和手工设计的特征,但在处理自然语言的复杂性和多样性上存在诸多限制。随着深度学习和大规模预训练语言模型(Large Language Model, LLM)的崛起,NLP技术进入了一个新的时代。 阅读详情

相关推荐

大规模语言模型:从理论到实践

大规模语言模型(Large Language Models,LLM),也称大规模语言模型 或大型语言模型 ,是一种 由包含数百亿以上参数的深度神经网络构建的语言模型,使用自监督学习方法通过大量无标注文 本进行训练。自 2018 年以来,Google、OpenAI、Meta、百度、华为等公司和研究机构都相继发布 了包括 BERT[1],GPT[6] 等在内多种模型,并在几乎所有自然语言处理任务中都表现出色。2019 年 大模型呈现爆发式的增长,特别是 2022 年 11 月 ChatGPT(Chat Generative Pre-trained Transformer) 发布后,更是引起了全世界的广泛关注。用户可以使用自然语言与系统交互,从而实现包括问答、 分类、摘要、翻译、聊天等从理解到生成的各种任务。大型语言模型展现出了强大的对世界知识 掌握和对语言的理解。

复旦大学自然语言处理实验室《大规模语言模型·从理论到实践》网络初版发布

为了使得更多的自然语言处理研究人员和对大语言模型感兴趣的读者能够快速了解大语言模型和理论基础,并开展大语言模型实践,复旦大学自然语言处理实验室张奇教授、桂韬研究员、郑锐博士生以及黄萱菁教授结合之前在自然语言处理领域研究经验,以及分布式系统和并行计算的教学经验,通过在大语言模型实践和理论研究的过程中,历时 8 个月完成本书。这个阶段是从语言模型向对话模型转变的关键,其核心难点在于如何构建训练数据,包括训练数据内部多个任务之间的关系、训练数据与预训练之间的关系以及训练数据的规模。

一点人工一点智能的博客 3376

大规模语言模型:从理论到实践 (张奇,桂韬,郑锐,⻩萱菁) (Z-Library)

大规模语言模型:从理论到实践 (张奇,桂韬,郑锐,⻩萱菁) (Z-Library)

复旦NLP团队2025新书《大规模语言模型:从理论到实践(第2版)》重磅来袭!

各位读者朋友们,相信你一定还记得,在各大平台AI大模型图书推荐榜单中,《大规模语言模型:从理论到实践》一书始终位居排行榜前列,在2023年末那个时间点,这本书是少有的把大模型相关技术系统汇总整理,既有理论又有实践的。时隔不到两年,大语言模型领域的发展可谓突飞猛进,大语言模型的能力在多个方面实现了显著突破,在推理能力、上下文理解深度及多模态处理能力等方面取得了长足进步。特别是在 2024 年 12 月,DeepSeek-V3的发布,以及 2025 年 1 月 DeepSeek-R1 的问世,更是引发了国内外的

2401_85378759的博客 1337

信号转换为图像 时域频域分析

一维信号如何转化为图像?深度学习如何学习 1.当然,直接1d卷积也是可以的。 2. 以信号强度的数值作为纵坐标,以时间为横坐标绘制信号点就可以了。 周霖那个即是 要看看代码是如何做的, 即使是单导联 5000个点,怎么变成50005000的分辨率的 3. 直接把多通道的一维信号合并成二维图像,然后直接按图像卷积的方法去做~~ 2225000这样一个图 ~可以看看语音处理的相关Net,其中比较...

王不留行嘿呦嘿 2万+

SimNow模拟环境实战:用vnpy_ctp连接期货市场的5个关键配置步骤

本文提供了一份详细的量化交易实战指南,重点讲解如何使用vnpy_ctp插件连接SimNow期货模拟环境的5个关键配置步骤。内容涵盖SimNow环境选择、vnpy_ctp核心参数解析、实战连接脚本编写、深度排错技巧以及向实盘迁移的准备,旨在帮助量化交易开发者快速搭建可靠的测试环境,避免常见陷阱。

weixin_29063035的博客 1273

《大规模语言模型:从理论到实践(第 2 版)》PDF带你深入大模型世界

在人工智能领域,大语言模型(LLM)无疑是当下最炙手可热的话题之一。从改变人们交互方式的 ChatGPT,到各行各业基于大模型开发的创新应用,LLM 正以迅猛之势重塑科技生态与产业格局。

DEVELOPERAA的博客 1638

SQL注入绕过information_schema:实战技法与替代路径详解

SQL注入是Web安全领域的核心漏洞类型,其原理是通过构造恶意SQL语句,干扰应用程序与数据库的正常交互逻辑,从而窃取或篡改数据。在渗透测试与CTF竞赛中,绕过常见防护措施是提升技术能力的关键。当标准的信息收集方式受阻时,例如无法访问information_schema数据库,攻击者需要掌握替代的元数据获取方法。这些技术价值在于模拟真实环境中日益严密的防御体系,锻炼在受限条件下的系统性信息收集思维。典型的应用场景包括存在WAF过滤、权限限制或编码干扰的实战环境。本文将围绕SQL注入这一核心,深入探讨如何利用

weixin_33980459的博客 430

大规模语言模型从理论到实践:模型基础、数据、强化学习、应用、评估

“推荐张奇、桂韬、郑锐、⻩萱菁合著的一本讲述大模型从理论到实践的书。关注公众号,可领取电子版。”全书目录1 绪论1.1 大规模语言模型基本概念1.2 大规模语言模型发展历程1.3 大规模语言模型构建流程1.4 本书的内容安排2 大语言模型基础2.1 Transformer 模型2.2 生成式预训练语言模型 GPT2.3 大语言模型结构3 ...

1528

ml307 二次开发

中移物联网旗下4g模组官方网站官方教程id=514官方客户不知道啥时候上班 早上10点也说不在服务时间内 找不到官方的sdk下载路径。

myWorld001的博客 2882

TIA博途V15.1实战:用PLCSIM Advanced V2.0模拟Modbus TCP/IP通信(附完整DB块配置)

本文详细介绍了如何在TIA博途V15.1环境中,利用PLCSIM Advanced V2.0软件仿真S7-1500 PLC的Modbus TCP/IP通信功能。通过实战步骤,重点解析了MB_SERVER指令调用、连接参数(CONNECT)配置以及核心数据块(DB)的映射方法,并附上了完整的DB块配置示例,帮助工程师在无物理硬件条件下高效完成通信逻辑的验证与调试。

m2n3o4p5的博客 408

重磅!首本大模型中文新书发布,复旦最新《大规模语言模型·从理论到实践》,理论+代码

大规模语言模型·从理论到实践》旨在为对大语言模型感兴趣的读者提供一个入门指南,并可作为高年级本科生和研究生自然语言处理相关课程的大语言模型部分补充教材。在撰写本书时,我们力求全面展现大模型研究的各个方面,并避免给出没有广泛共识的观点和结论。复旦大学自然语言处理实验室张奇教授、桂韬研究员、郑锐博士生以及黄萱菁教授结合之前在自然语言处理领域研究经验,以及分布式系统和并行计算的教学经验,通过在大语言模型实践和理论研究的过程中,历时 8 个月完成本书《大规模语言模型·从理论到实践》不可错过!

python1234_的博客 1229

奔图M6700-M6800-M7100-M7200 系列打印机拆解教程?

奔图M6700-M6800-M7100-M7200 系列打印机拆解教程?

m0_58098052的博客 1595

复旦大学《大规模语言模型:从理论到实践》完整PDF和PPT课件下载

大语言模型(Large Language Models,LLM)是一种由包含数百亿以上权重的深度神经网络构建的语言模型,使用自监督学习方法通过大量无标记文本进行训练。自2018年以来,包含Google、OpenAI、Meta、百度、华为等公司和研究机构都纷纷发布了包括BERT, GPT等在内多种模型,并在几乎所有自然语言处理任务中都表现出色。2021年开始大模型呈现爆发式的增长,特别是2022年11月ChatGPT发布后,更是引起了全世界的广泛关注。

weixin_59191169的博客 1214

主题045:四足机器人的运动仿真

四足机器人(Quadruped Robot)是模仿哺乳动物四肢运动设计的机器人系统,具有优异的地形适应性和运动稳定性。与双足机器人相比,四足机器人在静态和动态稳定性方面具有天然优势,能够在复杂地形(如楼梯、斜坡、碎石地面)上稳定行走,因此在野外探索、救援任务、军事应用等领域具有广阔的应用前景。本教程将介绍四足机器人的运动学建模、步态规划、稳定性分析和控制策略,并通过Python仿真验证相关理论。典型的四足机器人每条腿包含3个关节:常见的腿部构型包括:对于单腿,足部位置 pfoot\mathbf{p}_{fo

kkchenjj的博客 682

全志V3S嵌入式驱动开发(解决kernel 5.2.y wifi驱动问题)

​【 声明:版权所有,欢迎转载,请勿用于商业用途。 联系信箱:feixiaoxing @163.com】 wifi模块,之前测试的时候,开发板上用的是esp8089,当时内核时4.14.y,测试也是通过的。链接地址在这里, https://blog.youkuaiyun.com/feixiaoxing/article/details/131178420?spm=1001.2014.3001.5501 那个时候测试的时候,我们就说过,wifi驱动可能是除了镜像制作之外,最复杂的一个

嵌入式-老费,一个分享专业嵌入式知识的blog 1158

大模型书籍推荐丨大规模语言模型:从理论到实践(第2版)pdf电子书

如果你正在学习大语言模型(LLM),复旦大学张奇教授团队的《大规模语言模型:从理论到实践(第2版)》绝对是你的必读书目!

pythonhy的博客 1372

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

大模型新书丨《大规模语言模型:从理论到实践》(附PDF)

大模型新书丨《大规模语言模型:从理论到实践》(附PDF)

2301_81940605的博客 1411

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

好书推荐 - 《大规模语言模型:从理论到实践》附PDF

预训练阶段:介绍了如何利用包含数千亿甚至数万亿单词的训练数据,并借助超级计算机进行深度神经网络参数的训练。同时,探讨了如何构建训练数据以及高效地进行分布式训练。有监督微调阶段:讲解了如何利用少量高质量的数据集,通过提示学习和语境学习等方法,将语言模型转变为对话模型。这一阶段的难点在于如何构建训练数据及其内部关系。奖励建模和强化学习阶段:介绍了如何根据用户提示词,利用奖励模型评估模型补全结果的质量,并通过强化学习进一步优化模型性能。该阶段需要解决强化学习方法稳定性不高、超参数众多及模型收敛困难等问题。

m0_70486148的博客 2698

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

【大模型书籍】复旦新出!大规模语言模型:从理论到实践(推荐)

今天给大家推荐一本大模型方面的书籍``,本书将介绍大语言模型的基础理论包括语言模型、分布式模型训练以及强化学习,并以Deepspeed-Chat框架为例介绍实现大语言模型和类ChatGPT系统的实践。

AAI666666的博客 1054

《大规模语言模型从理论到实践》---大模型原理及GPT LLAMA原理

尽管n 元语言模型能缓解句子概率为 0 的问题,但语言是由人和时代创造的,具备无尽的可能性,再庞大的训练语料也无法覆盖所有的 n-gram,而训练语料中的零频率并不代表零概率。强化学习(Reinforcement Learning)阶段根据数十万用户给出的提示词,利用在前一阶段训练的 RM 模型,给出 SFT 模型对用户提示词补全结果的质量评估,并与语言模型建模目标综合得到更好的效果。然而,在不加约束的情况下,模型有可能学到一些平凡解(如恒等映射),这对于下游的任务显然是没有用的。

weixin_42264784的博客 2414

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 224
上一篇: 30天快速入门AI大模型:从理论到实践的详细学习方案,大模型从入门到精通,收藏这篇就够了
下一篇: 拒绝“纸上谈兵”!这本《图解大模型:生成式 AI 原理与实战》太适合入门大模型了
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值