李沐老师也出手了,教你手搓语音大模型,代码全开源还能在线试玩!

HiggsAudio-V2: 融合语言与声音的下一代音频大模型 Boson AI推出的HiggsAudio-V2是一款创新性音频大模型,其核心突破在于基于Llama-3.2-3B语言模型,通过DualFFN音频适配器架构高效融合音频处理能力。该模型采用Higgs Audio Tokenizer技术,利用残差向量量化和delay pattern实现高质量流式音频生成。实验证明,DualFFN结构在保持91%训练速度的同时,显著提升了语音准确性(WER)和音色相似度(SIM)。这种"语言模型+领域适配器"的架构为多模态AI发展提供了高效范式,支持实时交互 阅读详情

李沐老师终于带着他的手搓语音大模型教程回归了,一千万小时音频数据训练的TTS,效果秒杀一众商业&开源的TTS。
图片

本期视频不讲论文,李沐老师来手把手教大家怎样玩转他们团队最新研发的Higgs Audio V2模型,不仅能处理文本,还能同时理解并生成语音。

视频教程:https://www.bilibili.com/video/BV1LGbozkEDY/?spm_id_from=333.337.search-card.all.click&vd_source=4075efdd29cbc7a407952a778f815fd3

模型代码:https://github.com/boson-ai/higgs-audio

除了一些常规语音任务外,这个模型还具备一些较为罕见的能力,比如生成多种语言的自然多说话人对话、旁白过程中的自动韵律调整、使用克隆声音进行旋律哼唱以及同时生成语音和背景音乐。

整个过程堪称“大力出奇迹”,直接将1000万小时的语音数据整合到LLM的文本训练,让它能听也能说。(当然还有亿点点细节)
图片

粗暴,但有效!

鬼畜视频?人力手搓已经OUT了,李沐老师直接用算力帮大伙搞定,效果be like:

沐导今日组会内容速记

传统的语音和文本模型之间相互独立,李沐老师就想,欸,能不能将两者结合起来,直接让LLM用语音进行沟通。

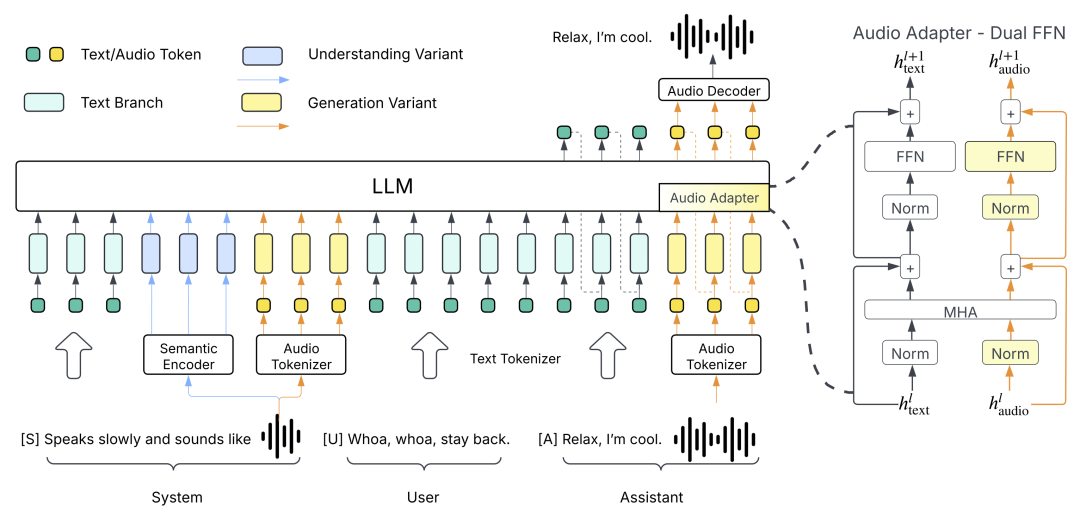
那么首先就要知道文本语言模型的本质是用给定的一段指令去生成预测结果,就是将任务先拆解为系统指令(system)、用户输入(user)、模型回复(assistant)三个部分。

system告诉模型,需要做什么事情,例如回答该问题、写一段文字或者其他,user就是告知事情的详细内容,例如问题具体是什么、文字要什么风格。

所以如果要让模型支持语音,就需要为模型增加一个系统命令,在user里输入要转录为语音的文字,让模型从system里输出对应语音数据。

这样语音任务就能转换成相同的处理格式,直接打通语音和文本之间的映射,通过追加更多的数据和算力,直接scaling law“大力出奇迹”。
图片

这就引出了新的问题,语音信号本质是连续的,要如何才能在离散的文本token中表示呢?

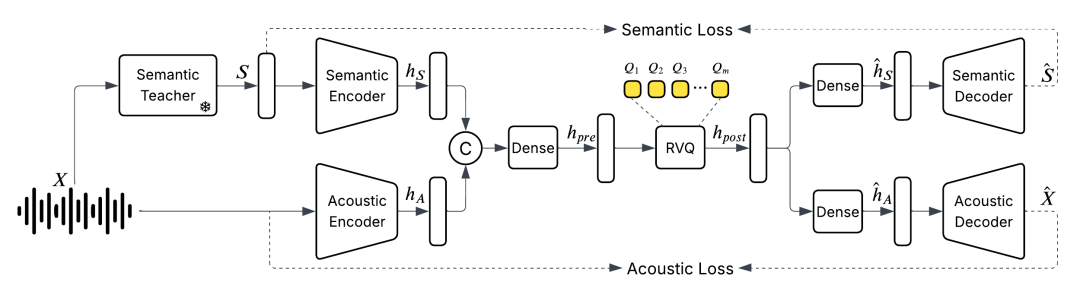
现有的方法是将一秒的语音信号裁切成多段(如100毫秒一段),为每一段匹配最相似的预定义模板(如45个模板),然后将其表示为长度为10的编号序列,也就是一个个token。

但这样做,虽然可以将一小时的音频从60兆压缩到0.16兆,但质量相当糟糕,所以需要优先保留语音的语义信息,而声学信号只保留少量部分,后续再通过其他手段还原。

于是他们训练了一个统一的离散化音频分词器,以每秒25帧的速度运行,同时保持甚至提高音频质量,以捕获语义和声学特征。
图片

然后要让模型很好地理解和生成声音,就需要利用模型的文本空间,将语音的语义尽量地映射回文本,当中需要大量的数据支持。

由于版权问题,沐导没有使用B站或YouTube这类公开视频网站数据,而是购买或从允许抓取的网站获取。

这样得到的数据质量参差不齐,需要删除其中的90%才能满足1000万小时的训练数据需求。

其次,将语音对话表示为相应的system(场景描述、声学特征、人物特征等)、user(对话文本)、assistant(对应音频输出)的形式。

由于OpenAI和谷歌一向禁止使用他们的模型输出再训练,且训练成本过高,为了实现这种标注,他们利用相同的模型架构额外训练出一个语音模型AudioVerse。

该模型接收用户语音输入,分析并输出场景、人物、情绪、内容等信息,再将输出反过来作为生成模型的system提示和user输入,实现模型的共同进步。

举个例子就是,如果想要教一个徒弟同时会拳脚功夫,但师傅一次又教不了,那就同时教两个徒弟,一个学打拳,一个学踢腿,然后让他们俩天天互相打,打着打着两个就都会拳脚功夫了。

最终,这个多模态模型就完成了,不仅可以完成简单的文本转语音,还能实现更复杂的任务,比如让它写一首歌并唱出来,再加上配乐。

还能根据语音分析场景、人物(性别、年龄、情绪状态)、环境音(室内外),并进行复杂的理解和推理。

在实时语音聊天上,还可实现低延迟、理解情绪并表达情绪的自然语音交互,而不仅仅是机械的问答。

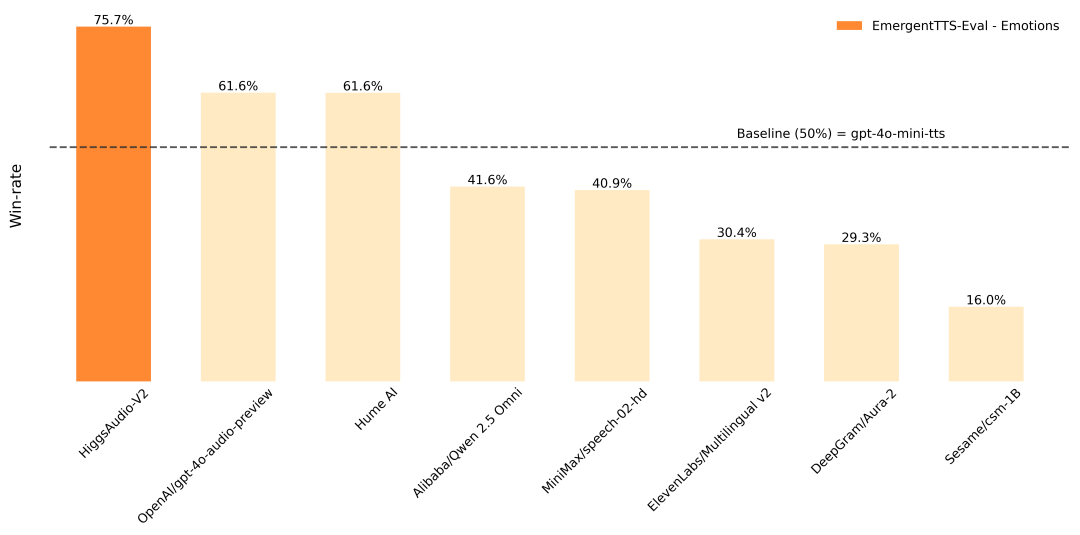
在EmergentTTS-Eval基准上,相较于其他模型,性能可以说是遥遥领先,尤其是在“情绪”和“问题”类别中,相比GPT-4o-mini-tts高出了75.7%和55.7%的胜率。

此外,它在Seed-TTS Eval和情感语音数据集 (ESD) 等传统TTS基准测试中也取得了最佳性能。
图片

那么,我们能玩吗?相信同学们都已经跃跃欲试了。

放心,沐导都包圆了,模型代码都已全部发布在GitHub上(可点击文末链接获取~),并提供了在线试玩平台和Hugging Face版本。
图片

想要安装在自己电脑上的同学,需要准备好GPU版Pytorch,或使用media驱动提供的Docker简化安装,readme里还有一些语音样例(包含文本和对应的音频),大家可以自行体验学习。

尤其是喜欢搞搞鬼畜视频、虚拟主播的同学们,这个模型一定要试试,它可以直接复制特定人物的声音。

不过温馨提醒,生成特定场景的文本时,最好提供类似场景中人物说话的语音信息(例如吵架、放松、大笑的语音),可以更好地进行声纹克隆嗷~

我们该怎样系统的去转行学习大模型 ?

很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此,我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习门槛,降到了最低!

在这个版本当中:

第一您不需要具备任何算法和数学的基础
第二不要求准备高配置的电脑
第三不必懂Python等任何编程语言

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包,现在将这份 LLM大模型资料 分享出来: 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

​

一、大模型经典书籍(免费分享)

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

二、640套大模型报告(免费分享)

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、大模型系列视频教程(免费分享)

在这里插入图片描述

四、2025最新大模型学习路线(免费分享)

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

L1阶段:启航篇丨极速破界AI新时代

L1阶段:我们会去了解大模型的基础知识,以及大模型在各个行业的应用和分析;学习理解大模型的核心原理、关键技术以及大模型应用场景。

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段是我们的AI大模型RAG应用开发工程,我们会去学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,我们会去学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造我们自己的Agent智能体。

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,我们会更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调。

L5阶段:专题集丨特训篇 【录播课】

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

​

【读代码】李沐团队开源音频大模型 Higgs Audio V2 是 Boson AI 团队开源的多模态音频大模型项目,致力于打造通用音频理解与生成的基础设施。Higgs-Audio 支持音频转文本(ASR)、文本转音频(TTS)、音频事件检测、音频检索、音频问答等多种任务,具备强大的多任务、多语言、多模态能力。支持音频理解(ASR、事件检测、音频问答等)与音频生成(TTS、音频合成等)多模态输入(音频、文本、图片等)与多模态输出基于 Transformer/LLM 架构,具备强泛化能力开放模型权重、推理代码与训练框架。 阅读详情

相关推荐

MT6816角度传感器SPI通信避坑指南:从数据手册到稳定读取的3个关键步骤

本文详细解析了MT6816角度传感器SPI通信中的常见问题与解决方案,包括寄存器地址计算、SPI时序配置和数据校验等关键步骤。通过实测波形和代码示例,帮助工程师避开数据手册中的隐藏陷阱,实现稳定可靠的角度数据读取,特别适用于高精度电机控制场景。

weixin_42520573的博客 517

Js_Study

文章目录JavaScriptjs资源初识JavaScript1. 历史2. JavaScript是什么3. JavaScript使用4. html/css/js关系5. 浏览器执行js介绍6. JS组成7. JS三种书写位置8. JS注释9. JS输入输出语句阻止链接跳转变量1. 什么是变量2. 变量在内存中的存储3. 变量的使用4. 变量语法扩展01-更新变量02-同时声明多个变量03-声明变量特殊情况5. 变量命名规范数据类型1. 数据类型简介2. 数字型number01-数值进制02-数字型范围03-

qq_53231262的博客 6590

LaTeX新手入门以及TeXlive和TeXstudio的安装使用

作为一个新手,LaTeX的了解和使用很是费了一番功夫,因此,在这里给找不到路的同志们稍微介绍一下。如有错误,敬请指正。本篇内容基于Win10系统,因此安装在Mac或者Linux上的同学可以再找找其他的介绍文章。 目录 LaTeX介绍 LaTeX环境配置 一、TeXlive下载 二、TeXlive安装 1. 安装main installer 2. 正式安装 三、TeXstudio安装...

zywhehe的博客 21万+

Higgs Audio:最佳多扬声器对话式人工智能就在这里

没有付费专区,没有等待名单,没有锁定在 API 后面的半生不熟的预览。您可以下载该模型,检查它,如果您便宜,可以在 Jetson Orin Nano 上运行它,或者如果您想要完整的 4090B 参数版本,则使用完整的 RTX 3。但是尝试生成一个 20 分钟的播客或一个完整的故事,你就会开始听到漂移,声音发生变化,节奏减弱,情绪变得平淡。像是有脉搏的东西 播客、语音代理、音频剧、语言学习工具,也许只是一个人工智能角色,可以开一个玩笑,就像它是认真的一样,这就是要搞砸的那个。它记得它是如何开始的。

m0_71688627的博客 226

三菱PLC通信库大比拼:手把手教你用C#实现最高效的McProtocol数据读写

本文深入比较了三菱PLC通信库的性能,重点介绍了如何使用C#高效实现McProtocol数据读写。通过实测数据对比HslCommunication、McProtocol-next和自定义方案的优劣,提供优化技巧和代码示例,帮助开发者在工业自动化场景中提升通信效率。

m0n1o2p的博客 255

【GNSS测试技术(一)】GNSS基础原理介绍

GNSS(全球卫星导航系统)是一种基于卫星信号的定位技术,通过使用分布在地球轨道上的卫星,为用户提供全球范围内的定位、导航和授时服务。

新猿异码的博客 5752

51c大模型~合集158

举个例子就是,如果想要教一个徒弟同时会拳脚功夫,但师傅一次又教不了,那就同时教两个徒弟,一个学打拳,一个学踢腿,然后让他们俩天天互相打,打着打着两个就都会拳脚功夫了。最终,这个多模态模型就完成了,不仅可以完成简单的文本转语音,还能实现更复杂的任务,比如让它写一首歌并唱出来,再加上配乐。然后要让模型很好地理解和生成声音,就需要利用模型的文本空间,将语音的语义尽量地映射回文本,当中需要大量的数据支持。传统的语音和文本模型之间相互独立,李沐老师就想,欸,能不能将两者结合起来,直接让LLM用语音进行沟通。

whaosoft~aiotの开发板商城 4527

comsol如何实现五厚度的单元模拟?

🏆本文收录于 《全栈 Bug 调优(实战版)》 专栏。专栏聚焦真实项目中的各类疑难 Bug,从成因剖析 → 排查路径 → 解决方案 → 预防优化全链路拆解,形成一套可复用、可沉淀的实战知识体系。无论你是初入职场的开发者,还是负责复杂项目的资深工程师,都可以在这里构建一套属于自己的「问题诊断与性能调优」方法论,助你稳步进阶、放大技术价值 。

**My Coding Family** 471

李沐B站更新了!教你手搓语音大模型,代码全开源还能在线试玩

举个例子就是,如果想要教一个徒弟同时会拳脚功夫,但师傅一次又教不了,那就同时教两个徒弟,一个学打拳,一个学踢腿,然后让他们俩天天互相打,打着打着两个就都会拳脚功夫了。最终,这个多模态模型就完成了,不仅可以完成简单的文本转语音,还能实现更复杂的任务,比如让它写一首歌并唱出来,再加上配乐。然后要让模型很好地理解和生成声音,就需要利用模型的文本空间,将语音的语义尽量地映射回文本,当中需要大量的数据支持。传统的语音和文本模型之间相互独立,李沐老师就想,欸,能不能将两者结合起来,直接让LLM用语音进行沟通。

量子位 424

使用Google Earth Engine下载JRC全球水体数据

通过Google Earth Engine平台和提供的源代码,研究人员和水资源管理者可以方便地获取和利用这一重要的水资源监测数据集,从而开展相关的研究和决策支持工作。要使用Google Earth Engine下载JRC全球水体数据,首先需要在Google Earth Engine平台上进行注册和登录。JRC全球水体数据是由欧洲联合研究中心开发的高分辨率全球水体分类数据集,覆盖了整个地球的陆地和水域。下载完成后,你可以使用各种遥感数据处理软件来打开和分析这些数据,以满足不同的研究和应用需求。

LrlDebug的博客 1158

Amazon Skills:51个AI技能赋能亚马逊运营,从选品到广告全链路分析

在电商运营领域,数据分析和自动化工具正成为提升效率的关键。其核心原理在于将专业经验转化为结构化指令,使AI能够执行标准化流程。这种技术价值体现在降低专业门槛、提升决策效率,尤其适用于亚马逊这类数据驱动的电商平台。通过将选品、关键词研究、FBA费用计算、PPC广告优化等运营框架编码为可执行指令,AI助手能够模拟专家思维进行市场分析。Amazon Skills项目正是这一理念的实践,它提供51个覆盖运营全链路的技能模块,让卖家在自然对话环境中获得专业分析支持,实现从市场研究到利润核算的自动化工作流。

weixin_27134143的博客 1304

李沐B站更新了!教你手搓大模型,代码全开源!还能在线试玩

举个例子就是,如果想要教一个徒弟同时会拳脚功夫,但师傅一次又教不了,那就同时教两个徒弟,一个学打拳,一个学踢腿,然后让他们俩天天互相打,打着打着两个就都会拳脚功夫了。最终,这个多模态模型就完成了,不仅可以完成简单的文本转语音,还能实现更复杂的任务,比如让它写一首歌并唱出来,再加上配乐。然后要让模型很好地理解和生成声音,就需要利用模型的文本空间,将语音的语义尽量地映射回文本,当中需要大量的数据支持。传统的语音和文本模型之间相互独立,李沐老师就想,欸,能不能将两者结合起来,直接让LLM用语音进行沟通。

阿木寺的博客 322

SAP B1中文培訓教材_SDK

公司内部培训资料,对开发工具 ,DIAPI, UIAPI,Add-ON有详细解说

沐神B站更新了,手搓语音大模型,代码全开源

举个例子就是,如果想要教一个徒弟同时会拳脚功夫,但师傅一次又教不了,那就同时教两个徒弟,一个学打拳,一个学踢腿,然后让他们俩天天互相打,打着打着两个就都会拳脚功夫了。最终,这个多模态模型就完成了,不仅可以完成简单的文本转语音,还能实现更复杂的任务,比如让它写一首歌并唱出来,再加上配乐。然后要让模型很好地理解和生成声音,就需要利用模型的文本空间,将语音的语义尽量地映射回文本,当中需要大量的数据支持。传统的语音和文本模型之间相互独立,李沐老师就想,欸,能不能将两者结合起来,直接让LLM用语音进行沟通。

深度学习技术前沿 176

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

全栈之路-前端篇 | 第三讲.基础前置知识【前端标准与研发工具】学习笔记

万维网联盟(外语缩写:W3C)创建于1994年,是Web技术领域最具权威和影响力的国际中立性技术标准机构, W3C标准定义了一个用于应用程序开发的开放式Web平台,该平台具有前所未有的潜力,使开发人员能够构建丰富的交互体验,由任何设备上都可以使用的海量数据存储提供支持,W3C制定这些技术规范和指南的过程旨在最大限度地达成对技术报告内容的共识,确保高技术和编辑质量,并获得W3C和更广泛社区的认可。官网地址: https://www.w3.org/standards/

全栈工程师修炼指南-IT知识分享 2723

温度PID控制PLC程序

温度PID稳定控制程序,适用于欧姆龙PLC,对其他PLC也具有很大参考价值

51-js整理

JavaScript简介 JavaScript是什么 JavaScript 编程语言 流程控制 Netscape在最初将其脚本语言命名为LiveScript,后来Netscape在与Sun合作之后将其改名为JavaScript。JavaScript最初受Java启发而开始设计的,目的之一就是“看上去像Java”,因此语法上有类似之处,一些名称和命名规范也借自Java。JavaScript与Java名称上的近似,是当时Netscape为了营销考虑与Sun微系统达成协议的结果。Java和JavaScript

weixin_41452476的博客 7040

【AI大模型前沿】Higgs Audio V2杀疯:Boson AI开源语音大模型(克隆声音、同步BGM、低延迟对话一键搞定)

Higgs Audio V2是由Boson AI团队开发的开源语音大模型,基于超过1000万小时的音频数据训练而成。它具备多语言对话生成、自动韵律调整、语音克隆和歌声合成等功能,能够模拟自然流畅的多人对话,并支持低延迟的实时语音交互。Higgs Audio V2不仅能够生成语音,还能同步生成背景音乐,为音频内容创作提供了强大的支持。这一模型的出现,为虚拟主播、实时语音助手、有声读物创作以及娱乐和创意领域带来了全新的可能性。

寻道AI,探索AI无限可能! 2049

【AI大模型实战】手把手教你在单卡4090上手搓一个Transformer预训练模型,零基础小白收藏这一篇就够了!!

作者基于原始Transformer论文,使用PyTorch手写了一个encoder-decoder架构的模型,用于将白话文翻译成唐诗。文章详细介绍了数据准备、Tokenizer训练、模型结构设计、训练过程和结果分析。模型在单卡4090上成功训练,能够生成具有一定韵律和意境的唐诗,但仍存在不足,未来可从Tokenizer优化、模型结构调整等方面进一步改进。

2401_85325557的博客 1134

手搓简易Qwen3:大模型实战从0到1,小白也能懂

本文通过Python代码实现了一个简易版Qwen3语言模型,帮助读者理解大模型的核心原理。文章首先拆解了Qwen3的两大关键技术:Transformer解码器和自回归语言建模,随后用不到200行代码实现了包含注意力机制、位置嵌入等核心模块的简化模型。作者还提供了完整的数据处理、训练流程和文本生成示例,在普通电脑上即可运行。最后对比了简易版与真实Qwen3的差异,并给出了FlashAttention、RoPE位置编码等进阶优化方案。全文采用"先理解核心原理,再逐步优化"的学习路径,强调通过

xiugou3365的博客 1033

手搓大模型--分词器训练并合并到LLM开源模型

摘要 本文详细介绍了使用SentencePiece训练分词器及将其合并到LLaMA模型的步骤。

日常分享模型调优、Data Agent 搭建实操案例与行业技术思考,记录从数据预处理到智能体迭代的完整实践。沉心打磨可落地的算法方案,输出干货向技术内容,与同好一同探索数据智能与大模型进阶路径。 2067

本科生60行代码教你手搓GPT大模型,技术介绍堪比教程

这一章节主要介绍了如何设置编码器、超参数以及参数。你要做的,首先是克隆代码库:然后安装依赖项:注意,如果你使用的是 M1 Macbook,在运行 pip install 之前,你需要在 requirements.txt 中将 tensorflow 更改为 tensorflow-macos。在这个项目下,文件包括 encoder.py、utils.py、gpt2.py、gpt2_pico.py:

qq_46094651的博客 1225

大模型的基本功

集百家之长,先去收集 modeling_llama.py、 modeling_qwen.py、 modeling_baichuan.py、 modeling_yi.py、 modeling_deepseek.py、modeling_glm.py 等所有的开源文件,再把各家公司实现的比较好用的 def 加入到自己的 modeling_XX.py 中。量化和推理加速技术?所以,我会给出一些我个人认为工作中很常用,但却“没有技术含量”的一些基本功(刷面经的同学可以不用看了哈,我推荐的基本功面试官不会考的)。

AIBigModel的博客 974

【大模型】从0到1训练一个大模型(四):Pretrain

  在大模型的训练过程中,预训练(Pretrain)是极为关键的一步。通过在大规模无监督数据上进行预训练,模型能够学习到通用的语言模式、语义表示和语法规则等,为后续针对特定任务的微调奠定坚实基础。这篇博客将深入探讨如何从模型搭建开始,逐步完成一个模型的预训练过程,代码基于transformers库,并结合自定义的模块和配置,实现一个完整的预训练模型训练流程。

Dong_ZH的博客 1266

从零预训练一个自己的大模型(完整代码)

本文从零开始训练一个大模型

IT从业者的成长历程 2604

从零预训练一个自己的大模型(附Github代码和免费H800使用方法)

从零预训练一个自己的大模型(附代码和在线训练日志)

weixin_39093355的博客 4035
上一篇: 字节跳动 Coze 正式开源:超详细本地部署指南,开启低代码 AI Agent 开发之旅!
下一篇: 大模型落地必备!20个开源工具让RAG开发效率翻倍(附场景化指南)
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值