Dify + OpenRouter + k8s:快速搭建准生产环境的LLM应用开发平台

使用 Helm 在 Kubernetes 上部署高可用的 Dify 系统 Dify 是一个功能强大的开源 LLMOps 平台,虽然官方提供了基于 `docker-compose` 的部署方式,但在生产环境中,我们通常需要具备可扩展性、高可用性和容错性,这些正是 Kubernetes 所擅长的,于是开源一个 dify-chart 项目,实现基于 `Helm` 在 Kubernetes 上的高可用部署。dify-chart 项目是基于 `Helm`,将 Dify 的 `docker-compose.yaml` 和 `.env` 配置转换成 Kubernetes 环境下脚本。 阅读详情
AI摘要

本文介绍利用Dify、OpenRouter和Kubernetes快速搭建准生产环境的LLM应用开发平台。Dify是开源LLM应用开发平台,OpenRouter是大模型API路由器。文中给出环境准备、部署Dify、配置OpenRouter的步骤及实践案例,还分享了LLM大模型学习资源和路线。

自 2022 年底 OpenAI 发布 GPT 3.5 以来,大模型市场风起云涌,已经是不可忽视的一种技术,而随着各大厂商的相互竞争,市面上大模型的价格越来越低,最近发布的 gpt-4o-mini 生成一本 2500 页的书籍,价格只需要 60 美分。在这种情况下,大模型的价格在可遇见的将来不会再成为大模型应用的瓶颈,而为了能够高效地开发和部署LLM应用,选择合适的平台和工具至关重要。本文将介绍如何利用Dify、OpenRouter和Kubernetes(k8s)快速搭建一个准生产环境的LLM应用开发平台,让你可以利用 Dify 快速构建出自定义的大模型智能体。

什么是 Dify?

Dify 是一款开源的大语言模型(LLM)应用开发平台,专为那些希望快速构建生产级生成式 AI 应用的开发者量身打造。它将后端即服务(Backend as Service)与 LLMOps 的理念完美结合,使得开发过程更加高效、流畅。

Dify 支持多种先进的大型语言模型,如 Claude3、OpenAI、Gemini,并与多个模型供应商紧密合作,为开发者提供灵活的选择,确保每个项目都能找到最适合的解决方案。平台还具备强大的数据集管理功能,不仅支持上传和管理文本及结构化数据,还通过直观的可视化工具简化 Prompt 编排和应用运营,让 AI 应用开发变得前所未有的简单。

Dify 技术架构
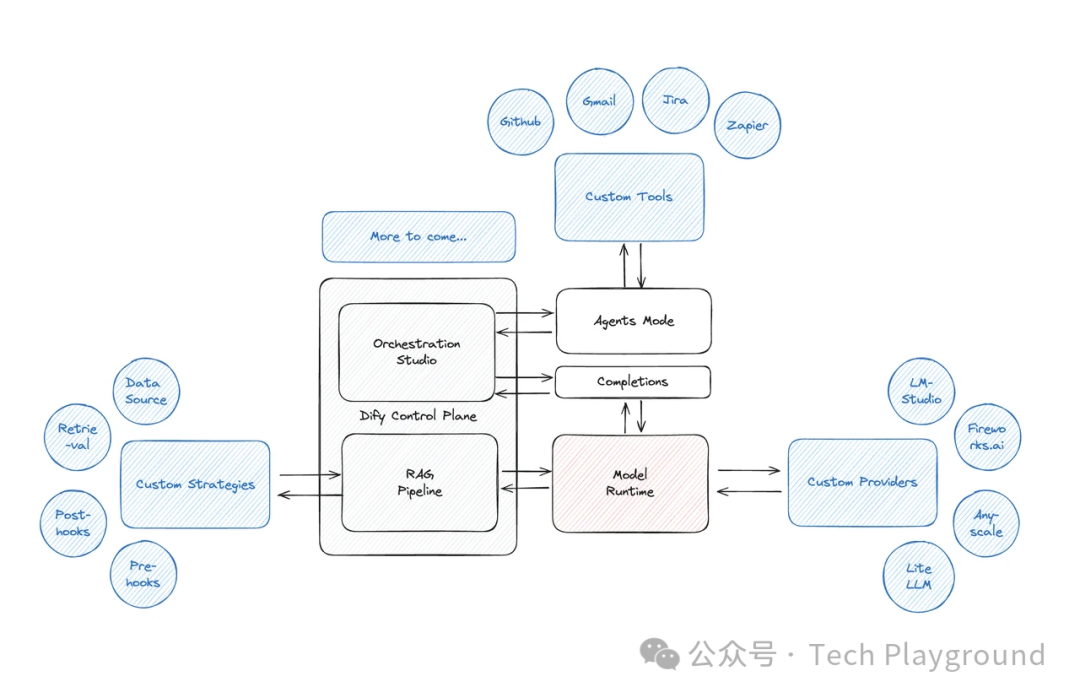
图片

Dify.AI 的技术架构包含以下几个关键部分,为开发者提供了一站式的解决方案:

  1. 1. 强大的技术栈支持:Dify 内置了构建 LLM 应用所需的顶尖技术栈,支持数百个模型,拥有直观的 Prompt 编排界面、高质量的 RAG(检索增强生成)引擎和灵活多变的 Agent 框架。

  2. 2. 可视化编排与运营管理:Dify 提供了可视化的 Prompt 编排、运营、数据集管理等功能,使得开发者能够在短短几天内完成 AI 应用开发,快速集成到现有系统中,并不断优化和改进。

  3. 3. 丰富的技术栈:AI 的核心技术栈包括 Python 编程语言、TensorFlow 和 Keras 深度学习框架,以及 NLP 领域常用库如 NLTK 和 spaCy 等。这些选择赋予了 Dify.AI 高度的灵活性和扩展性。

  4. 4. 开箱即用的应用模板和编排框架:Dify 提供了完善的应用模板和编排框架,让开发者能够基于这些资源快速构建大型语言模型驱动的生成式 AI 应用,并可以按需无缝扩展,推动业务增长。

  5. 5. Dify Orchestration Studio:这是一个专业级别的可视化编排工具,为生成式 AI 应用提供一体化工作环境,使开发者能够更加高效地构建和管理他们的 AI 项目。

通过这些强大的技术架构,Dify.AI 为开发者打造了一个全面、灵活且易于使用的平台,支持生成式 AI 应用从快速开发到稳定部署的一站式解决方案。

什么是 OpenRouter?

OpenRouter,顾名思义,是一个强大的大模型API路由器。它的设计初衷是将各种AI模型和服务无缝集成到一个统一的接口中。用户只需简单配置和调用,即可轻松访问多个预训练的大模型,无需自行部署和维护。这一创新理念大幅降低了AI技术的使用门槛,让更多人能够毫不费力地利用大模型来解决实际问题。

快速搭建准生产环境的LLM应用开发平台

环境准备

在开始之前,请确保你已经完成以下准备工作:

  1. 1. 安装 Kubernetes:确保你的机器上已经安装并配置好了 Kubernetes 集群。如果没有,请参考Kubernetes 官方文档进行安装。

  2. 2. 安装 kubectl:kubectl 是与 Kubernetes 集群交互的命令行工具。请参考kubectl 安装指南进行安装。

  3. 3. Docker 镜像:确保你已经构建并推送了 Ollama 的 Docker 镜像到你的容器镜像仓库(如 Docker Hub)。

如果是简单尝试的话,也可以使用 microk8s - https://microk8s.io/ 或者 k3s - https://k3s.io/ 进行安装。

步骤一:部署Dify

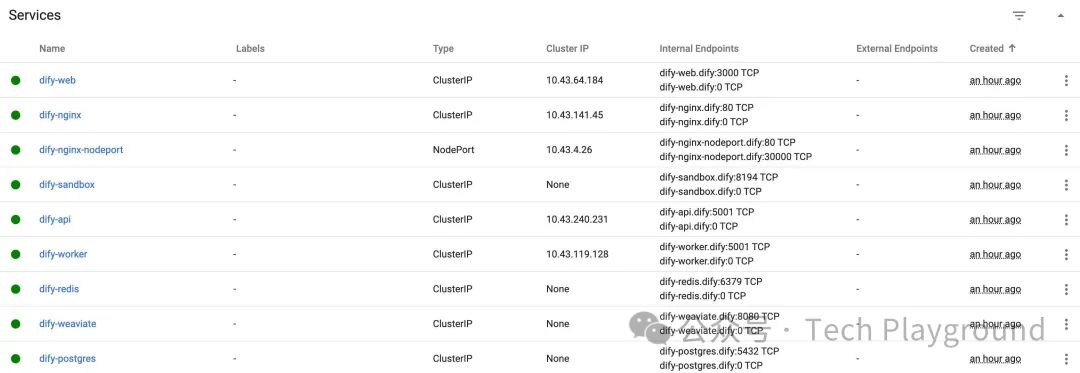
  1. 1. 使用 dify 开源的 k8s deployment 部署相关依赖。

kubectl apply -f https://raw.githubusercontent.com/Winson-030/dify-kubernetes/main/dify-deployment.yaml
图片

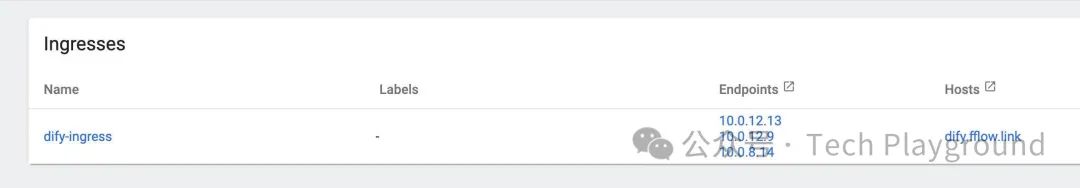
2. 在 k8s 中配置 ingress 暴露给外部 IP 访问。

kind: Ingress
apiVersion:networking.k8s.io/v1
metadata:
name:dify-ingress
namespace:dify
spec:
rules:
-host:dify.fflow.link
http:
paths:
-path:/
pathType:Prefix
backend:
service:
name:dify-nginx
port:
number:80
-path:/api
pathType:Prefix
backend:
service:
name:dify-nginx
port:
number:80
-path:/console/api
pathType:Prefix
backend:
service:
name:dify-nginx
port:
number:80
-path:/v1
pathType:Prefix
backend:
service:
name:dify-nginx
port:
number:80
-path:/files
pathType:Prefix
backend:
service:
name:dify-nginx
port:
number: 80
图片

3. 访问 dify.fflow.link(注意替换成实际的域名或者 IP) 验证安装。系统会提示需要输入一个初始密码,通过我们上面的 yaml 安装的 dify 初始密码是 password。
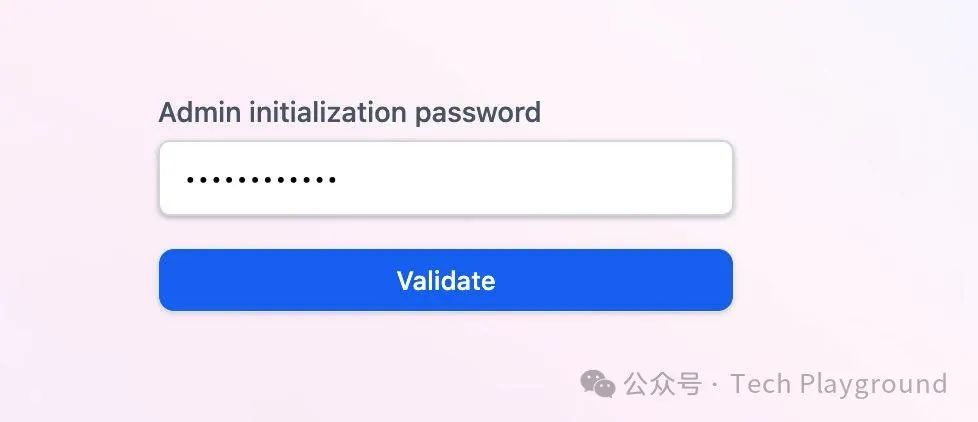
图片

步骤二:配置OpenRouter

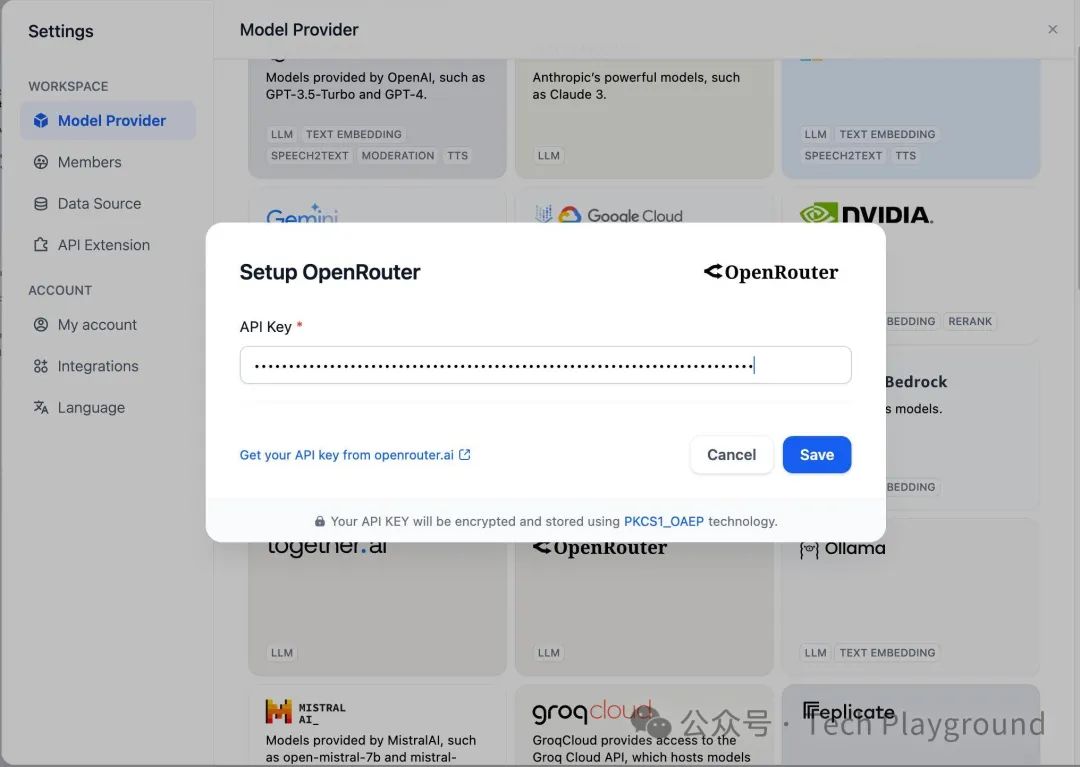
  1. 1. 打开 dify 的 Settings 配置,选择 Model Provider 为 OpenRouter。
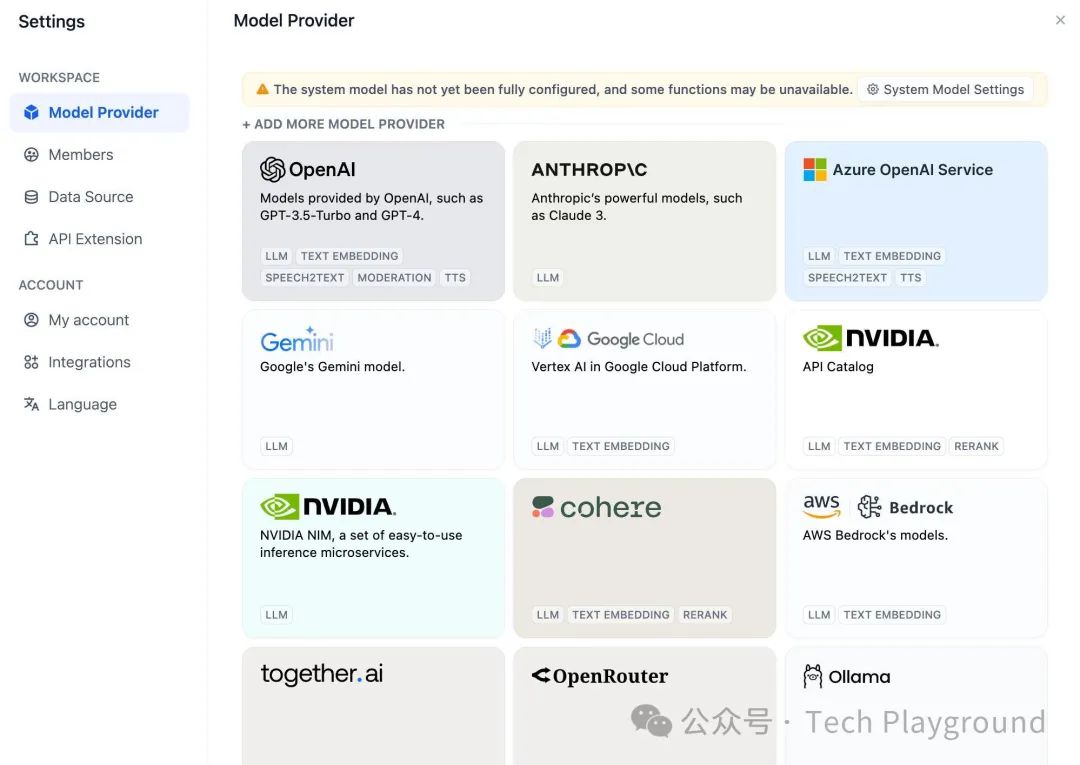
图片

  1. 2. 输入从 OpenRouter 中获取的 API Key。

图片

实践案例

假设我们需要基于 Dify 构建一个翻译的 API。以下是具体步骤:

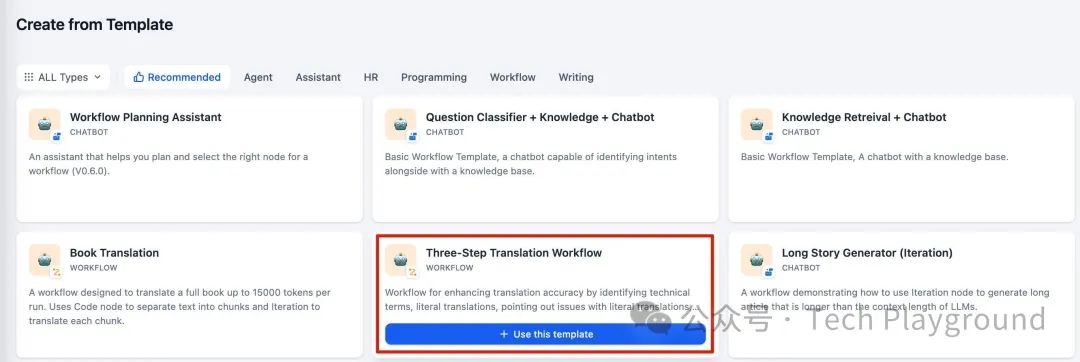
  1. 1. 选择模版:

    • • 从模版里面选择一个和我们的应用场景相近的 Workflow。

图片

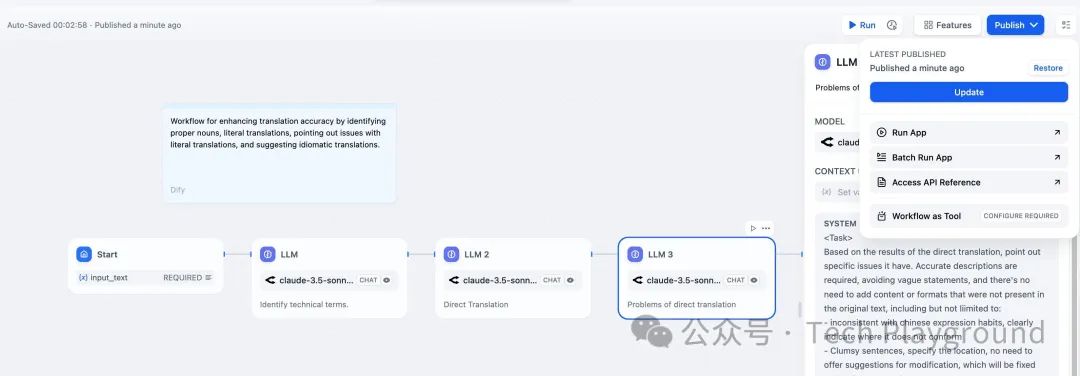
  1. 2. 步骤编排:

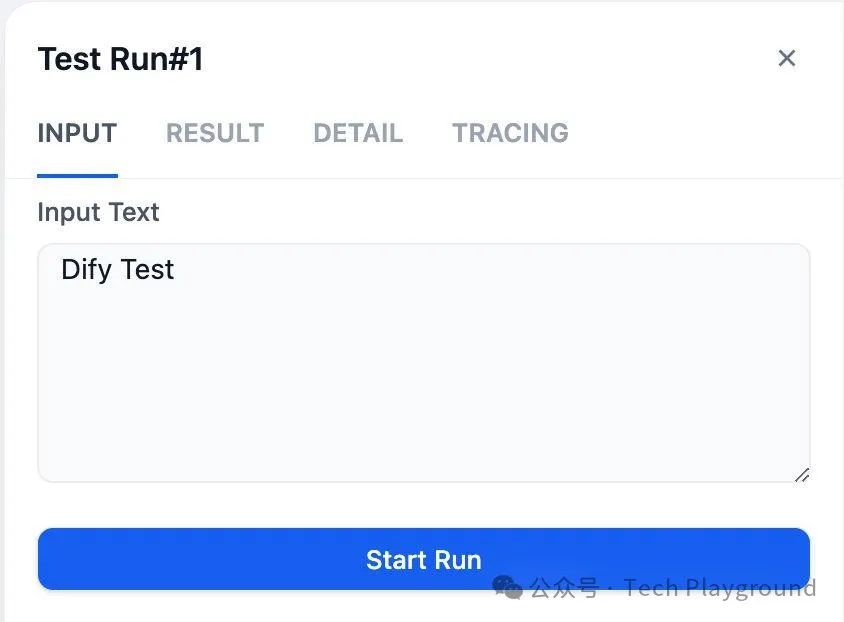
    • • 在 Dify 平台对整个翻译流程进行编排,过程中可以不断的测试,选择合适的模型。

图片

图片

图片

  1. 3. 发布API:

    • • 点击 Publish 即可让外部通过 API 和 API Key 访问模型。

FAQs

1. OpenRouter与OpenAI 等原生 API 相比有哪些优势?

OpenRouter 可以一次性提供更多的模型,而且可以在国内使用 Visa 卡支付,这样对于需要使用多种模型进行对比验证的应用开发平台来说很有优势。

总结

通过本文介绍的步骤,您可以快速搭建一个准生产环境的LLM应用开发平台。利用Dify进行应用开发和流程编排,OpenRouter用作模型接入,再结合k8s进行 dify 的容器编排和管理,可以大大简化开发和部署过程,提高效率和稳定性。希望本文对您有所帮助,祝您在LLM应用开发的道路上取得成功!

 如何系统的去学习大模型LLM ?

大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。

事实上,抢你饭碗的不是AI,而是会利用AI的人。

继科大讯飞、阿里、华为等巨头公司发布AI产品后,很多中小企业也陆续进场!超高年薪,挖掘AI大模型人才! 如今大厂老板们,也更倾向于会AI的人,普通程序员,还有应对的机会吗?

与其焦虑……

不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!

但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高。

基于此,我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近70次后,终于把整个AI大模型的学习门槛,降到了最低!

在这个版本当中:

第一您不需要具备任何算法和数学的基础
第二不要求准备高配置的电脑
第三不必懂Python等任何编程语言

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包,现在将这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

​

一、LLM大模型经典书籍

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套LLM大模型报告合集

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、LLM大模型系列视频教程

在这里插入图片描述

四、LLM大模型开源教程(LLaLA/Meta/chatglm/chatgpt)

在这里插入图片描述

五、AI产品经理大模型教程

在这里插入图片描述

LLM大模型学习路线 ↓

阶段1:AI大模型时代的基础理解

  • 目标:了解AI大模型的基本概念、发展历程和核心原理。

  • 内容:

    • L1.1 人工智能简述与大模型起源
    • L1.2 大模型与通用人工智能
    • L1.3 GPT模型的发展历程
    • L1.4 模型工程
    • L1.4.1 知识大模型
    • L1.4.2 生产大模型
    • L1.4.3 模型工程方法论
    • L1.4.4 模型工程实践
    • L1.5 GPT应用案例

阶段2:AI大模型API应用开发工程

  • 目标:掌握AI大模型API的使用和开发,以及相关的编程技能。

  • 内容:

    • L2.1 API接口
    • L2.1.1 OpenAI API接口
    • L2.1.2 Python接口接入
    • L2.1.3 BOT工具类框架
    • L2.1.4 代码示例
    • L2.2 Prompt框架
    • L2.3 流水线工程
    • L2.4 总结与展望

阶段3:AI大模型应用架构实践

  • 目标:深入理解AI大模型的应用架构,并能够进行私有化部署。

  • 内容:

    • L3.1 Agent模型框架
    • L3.2 MetaGPT
    • L3.3 ChatGLM
    • L3.4 LLAMA
    • L3.5 其他大模型介绍

阶段4:AI大模型私有化部署

  • 目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。

  • 内容:

    • L4.1 模型私有化部署概述
    • L4.2 模型私有化部署的关键技术
    • L4.3 模型私有化部署的实施步骤
    • L4.4 模型私有化部署的应用场景

这份 LLM大模型资料 包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

​

Kubernetes部署Dify:从架构拆解到生产就绪的完整指南 Kubernetes作为容器编排的事实标准,通过声明式配置和自动化管理,为复杂应用的部署、伸缩与运维提供了统一平台。其核心原理在于将应用组件抽象为Pod、Service、Ingress等资源对象,通过控制器模式确保实际状态与期望状态一致。在AI应用开发领域,这种云原生技术价值尤为突出,能够有效支撑大模型服务所需的高可用、弹性伸缩和持续交付能力。具体到Dify这类低代码AI应用开发平台,其多组件架构(API Server、前端、Celery Worker、数据库等)与Kubernetes的资源模型天然契合。通 阅读详情

相关推荐

EKS 部署高可用 Dify

生成式 AI(Generative AI)和大语言模型(LLM)不仅大大提升了个人的信息获取和工作效率,也正在重塑企业应用。很多企业正在探索基于 LLM、RAG 和 Agent 的 GenAI 应用,通过与私域数据和现有的应用结合,来打造更创新、更具价值和更个性化的用户体验。LangChain 是构建 GenAI 应用的非常流行的选择,它是一个非常流行的开源框架,提供了工具和组件,如数据加载、提示词模板、数据检索、RAG 引擎和 Agent 等,简化了构建基于 LLM 应用程序的过程。

大模型 3715

私有化部署 Dify 并快速搭建 AI 应用

Dify可以切换几乎所有主流的模型,通过模板可以快速创建应用,添加各种类型的文档作为知识库,添加后端API等,相较于LangChain需要通过 Python 代码进行开发,Dify 开箱即用,对于大部分人来说更加的友好,最重要的可以进行私有化部署。

m0_59235699的博客 9851

Dify 实战指南:从零构建企业级 AI 应用与 RAG 系统

如果你正在寻找一个能让你快速构建、部署和管理 AI 应用,同时又不想陷入复杂的代码和基础设施泥潭的平台,那么 Dify 很可能就是你一直在等的答案。它不是一个简单的“又一个 AI 工具”,而是一个旨在将 AI 应用开发“工程化”和“平民化”的生产级平台。简单来说,Dify 让你能用拖拽的方式,像搭积木一样构建复杂的 AI 工作流,无论是智能客服、内容生成、数据分析还是企业级 RAG 系统,都能在几分钟内搭建出原型,并一键部署到生产环境。 但问题来了:市面上低代码/无代码平台不少,为什么是 Dify?它和 L

weixin_33694172的博客 438

k8s部署dify1.1.3详细过程

dify官方提供的安装方式是docker-compose方式部署的,单机运行。但是在企业生产环境,单机没法提供冗余,一旦故障,就很麻烦了。如果有大量的APP用户,那么单机承受不住这么多并发,也会出现故障。很多小伙伴们,想在k8s中运行dify,解决冗余以及并发问题,直接扩容节点即可。注意:只有企业版会提供k8s部署,社区版是没有的。对于我们这种个人开发者来说,囊中羞涩,不愿意花费这笔钱。企业版还得联系商务,提供企业相关信息,特别麻烦。对于在k8s中部署dify,确实比较难。

weixin_36879547的博客 376

DeepSeek Harness桌面版:零代码构建AI助手,知识库与Skills实战指南

在AI应用开发领域,大语言模型(LLM)与检索增强生成(RAG)技术正成为降低开发门槛、实现知识智能化的核心。其原理在于,通过向量化技术将非结构化文档转换为可检索的知识,并结合预定义的功能模块(Skills),使AI能基于特定领域知识执行复杂任务。这一组合的技术价值在于,它让开发者无需深入底层框架,即可快速构建具备“长期记忆”和“扩展能力”的智能体,极大地加速了AI产品的工程化落地。应用场景广泛覆盖了智能客服、内部知识问答、自动化流程助手等。本文聚焦的DeepSeek Harness(DSH)及其桌面安装包

weixin_30753873的博客 456

OpenClaw本地部署指南:AI工作流引擎实战入门

AI工作流引擎是实现大模型能力工程化落地的核心基础设施,其本质是将LLM调用、工具集成与多步推理封装为可编排、可审计的执行单元。基于Rust构建的OpenClaw正代表了这一技术路径——它不内置模型,而是作为轻量级、模型中立的AI流水线调度器,通过YAML声明式编排Skill与Workflow,在本地或内网环境中提供全程可控的Agent运行时。相比Dify、Langflow等低代码平台,OpenClaw更强调命令行友好性、插件化扩展与离线合规能力,适用于金融审计、敏感文档处理、嵌入式系统集成等高确定性场景。

424

Dify 在 k8s 里接 OpenRouter,Base URL 改填 TaoToken 兼容地址

在 k8s 部署的 Dify 里接 OpenRouter 后模型入口容易分散,本文给出可跟做一步:在 Dify 新增 OpenAI-API-compatible 供应商,Base URL 填 TaoToken 兼容地址 https://taotoken.net/api,Key 用 TaoToken 控制台创建的 Key,k8s 侧无需改动。LLM 应用与 Workflow 统一走该通道,附 curl 验证与常见报错排查。

weixin_42604188的博客 56

Autoware1.14-摄像头目标检测YOLO-V3

在Autoware1.14中部署YOLOV3

weixin_43687753的博客 3139

从零部署Dify:可视化构建RAG与工作流驱动的AI应用

在实际 AI 应用开发中,一个常见的困境是:想法很美好,但落地很困难。从模型选型、API 调用、提示词工程,到前后端集成、数据管理、工作流编排,每一步都需要投入大量工程时间。对于希望快速验证 AI 想法或构建内部工具的中小团队和个人开发者而言,这个门槛尤其高。Dify 的出现,正是为了解决这个痛点。它是一个开源的 LLM 应用开发平台,其核心目标是让开发者能够像“搭积木”一样,通过可视化拖拽的方式,快速构建和部署基于大语言模型的 AI 应用,而无需从零开始编写大量胶水代码。 Dify 由中国团队开发并开源,

weixin_34226182的博客 653

Altium Designer学习---如何进行SI仿真

Altium designer 如何进行SI仿真。         1、仿真电路中需要至少一块集成电路;             2、器件的IBIS模型;              3、在规则中必须设定电源网络和地网络;              4、建立SI规则约束;              5、层堆栈必须设置正确,电源平面必须连续;     建立的文件必须是一个工程,并把相应的文件放在工程目...

weixin_34050519的博客 4902

分位数映射数据后处理-Quantile Mapping后处理 (R语言)

统计后处理器基本上是统计模型,将观察到的关注变量与从气象或水文模型的直接模型输出(DMO)导出的适当预测变量相关联。统计后处理的重要性早已在气象预报中得到认可。早期的工作包括完善的预测(perfect prognosis),模型输出统计(MOS)和模拟方法(analog method)等模型。 近年来,已经提出了许多其他后处理方法,包括秩直方图校准(rank histogram calibrati...

水滴石穿,绳锯木断 1万+

Dify不是低代码平台,而是AI智能体的工程化操作系统

AI智能体(Agent)是当前大模型落地的核心范式,其本质是将复杂任务分解为可编排、可审计、可回滚的自动化流程。实现这一目标需依托具备状态管理、异步流水线、向量化检索与分布式治理能力的底层平台。Dify正属于此类AI工程化操作系统,它超越传统低代码工具,深度整合RAG知识库、工作流状态机、Embedding模型适配与多租户治理等关键技术,支撑制造业故障诊断、法律合同审查、科研文献处理等垂直场景的规模化交付。本文聚焦Dify的系统级设计逻辑与生产级部署实践,解析其作为AI基础设施的技术内涵。

weixin_34269583的博客 395

拌合楼管理软件开发(十一) 海康威视车牌识别摄像头安装调试,总算是跑通了。

/保存的文件个数这里之所以需要用到委托,直接更新textbox文本中的内容,以及复制picturebox的image会提示不是从齐创建的线程调用。

morsth的博客 4816

Opik:Apache-2.0 开源 LLM 可观测性、评估与 AI Agent 追踪平台的完整上手指南

Opik 是 Comet 团队开源(Apache-2.0)的 LLM 可观测性与评估平台,覆盖 LLM 应用从开发期的首条 Trace 到生产监控的完整生命周期,为 AI Agent 追踪、LLM 评估、Prompt 管理与线上评估提供一站式能力。本文以仓库根目录的 [README.md](https://link.gitcode.com/i/6b4f17b0da65278c9ecd9dc7e79

gitblog_01047的博客 324

VisualSFM+MeshLab 三维重建全过程记录

VisualSFM+MeshLab 三维重建全过程记录,从下载到运行出结果,以及其中一些可能出现的小问题。通过这两个软件熟悉一下多目立体视觉重建的流程。

何似莫相逢 3万+

Unity 多线程编程笔记 _Task详解

士大夫

weixin_43405845的博客 4384

OpenClaw本地部署:AI Agent运行时基础设施实战指南

AI Agent运行时(Agent Runtime)是大模型应用落地的关键中间层,介于LLM推理服务与业务连接器之间,解决可调度、可观测、可扩展等生产级需求。其核心原理在于解耦模型调用、技能执行、状态管理与事件通信四大平面,技术价值体现在对数据主权、合规可控与系统稳定性的保障。典型应用场景包括金融私有化Agent、医疗知识助手、企业微信/飞书智能中枢等需数据不出域的高敏环境。本文聚焦OpenClaw这一高度解耦的开源Agent框架,深入剖析其本地部署中模型服务、技能沙箱、PostgreSQL状态协调与Kaf

weixin_34327761的博客 404

zemax 如何编译用户自定义DLL(含VS下载教程)

zemax 如何编译用户自定义DLL(含VS下载教程)

weixin_72050316的博客 492

Workbuddy本地AI工作流实战:Skill契约化与混合执行引擎

工作流自动化是现代AI工程的核心能力,其本质是将任务解耦为可复用、可验证的最小执行单元,并通过确定性数据流编排实现端到端协同。Skill作为智能原子单元,强调输入/输出契约化设计,支撑跨场景复用与精准调试;而本地模型+AI代理的混合执行引擎,则在保障数据隐私与低延迟的同时,兼顾复杂推理需求。该架构广泛适用于科研文献处理、金融合规分析、HR智能筛选等对可控性、可审计性和离线能力要求高的领域。本文聚焦Workbuddy这一轻量级开源框架,详解其YAML定义DAG、本地量化模型集成(如Qwen2-1.5B)、Sk

weixin_34413103的博客 362

利用R批量计算相关系数

批量求相关系数

weixin_52073820的博客 1458

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

AI Agent 技术栈梳理(Skill / 蒸馏 / MCP / Harness)

本文系统梳理了AI Agent(智能体)的核心技术栈,重点解释四个关键概念:蒸馏(模型压缩技术,将大模型能力迁移到小模型)、Harness(智能体运行时框架,管理模型执行和工具调用)、Skill(模块化能力包,按需加载)、MCP(标准化协议,连接外部工具和数据)。这些概念构成了Agent的基础架构,其中Harness作为核心容器,Skill和MCP用于能力扩展,而蒸馏独立影响模型选择。此外,文章还概述了AI Agent的完整9层技术栈,涵盖模型、框架、记忆、工具、多智能体协作等维度,为理解智能体技术提供了结

Java牛马的博客 604

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

【AI】给Dify 添加 OpenRouter 模型报错:Credentials validation failed with status code 400,竟是模型名称惹得祸

给Dify 添加 OpenRouter DeepSeek V3 0324 (free)模型,竟然报错: Credentials validation failed with status code 400 检查API keys是没问题的,最后发现时模型名称这里不可以随便命名,必须使用OpenRouter 给定的名称。其实很简单,复制一下即可。点击下图红色区域的复制按钮,就可以复制前面的模型名称,即:deepseek/deepseek-chat-v3-0324:free 之后粘贴在上图的模型名称里即可。

IT里的交易员-博客 4447

ssm框架搭建

这个是一个在idea上成功跑起来的ssm框架项目,保存在这里方便以后使用直接下载

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

k8s部署dify

以前部署过,最近重新部署发现还是存在很多问题,这里进行记录。

巴菲先生 1554

k8s部署dify1.1.3详细过程,大模型入门到精通,收藏这篇就足够了!

对于我们这种个人开发者来说,囊中羞涩,不愿意花费这笔钱。企业版还得联系商务,提供企业相关信息,特别麻烦。

Y525698136的博客 2646

Dify中接入GPT-4o mini模型

GPT-4o mini("o"代表"omni")是小型型号类别中最先进的型号,也是OpenAI迄今为止最便宜的型号。它是多模态的(接受文本或图像输入并输出文本),具有比 gpt-3.5-turbo 更高的智能,但速度同样快。它旨在用于较小的任务,包括视觉任务。建议在之前使用 gpt-3.5-turbo 的地方选择 gpt-4o-mini ,因为此模型功能更强大且更便宜。

NLP工程化 2766

有状态应用dify部署至华为云kubernetes集群

kubernetes部署有状态服务dify,使用云服务作为存储。

nangonghen的博客 1704
上一篇: 大模型 Agent 是不是就是各种 Prompt 的堆叠?
下一篇: Ollama + DeepSeek + Dify,专属私人 AI 助手?
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值