《大模型白盒子构建指南》毕业,仅需2G显存,手搓关于LLM的一切(附PDF)

2024十大AI落地论文实战指南:Vision Mamba、KAN与CLAW-LM工程化详解 State-Space Model(SSM)和Kernel Arnold Networks(KAN)正从理论概念演变为可部署的工业级AI组件,其核心价值在于以线性计算复杂度替代Transformer的O(n²)开销,并通过微分方程建模赋予模型物理可解释性。这类技术不再追求参数规模,而是聚焦边缘设备兼容性、实时推理延迟、显存压缩比等工程硬指标,广泛应用于制造业视觉质检、风电故障预测、法律长文档分析等高价值场景。Vision Mamba已在Jetson Orin实现1080p视频流47fps处理,KAN在金融风 阅读详情

前 言

《大模型白盒子构建指南》是一个从原理出发、以“白盒”为导向、围绕大模型全链路的“手搓”大模型指南,旨在帮助有传统深度学习基础的读者从底层原理出发,“纯手搓”搭建一个清晰、可用的大模型系统,包括大模型架构、大模型预训练、RAG 框架、Agent 系统及大模型评估体系等。本项目将从基础原理出发,深入剖析每一个技术点并附以完整的从零代码实现,以细致讲解和代码注释帮助读者独立复现大模型核心部分,并在复现中实现对大模型的深入理解与掌握。

本项目旨在为广大学习者搭建一个清晰的、可用的、可复现的大模型世界,帮助每一位有兴趣的学习者纯手工独立搭建自己的 Tiny LLM Universe。

项目的主要内容包括:

  • 深入剖析大模型原理——Qwen Blog

  • 逐步预训练一个手搓大模型——Tiny Llama3

  • 如何评估你的大模型——Tiny Eval

  • 纯手工搭建 RAG 框架——Tiny RAG

  • 手搓一个最小的 Agent 系统——Tiny Agent

  • 深入理解大模型基础——Tiny Transformer

开源地址:
https://github.com/datawhalechina/tiny-universe/tree/main
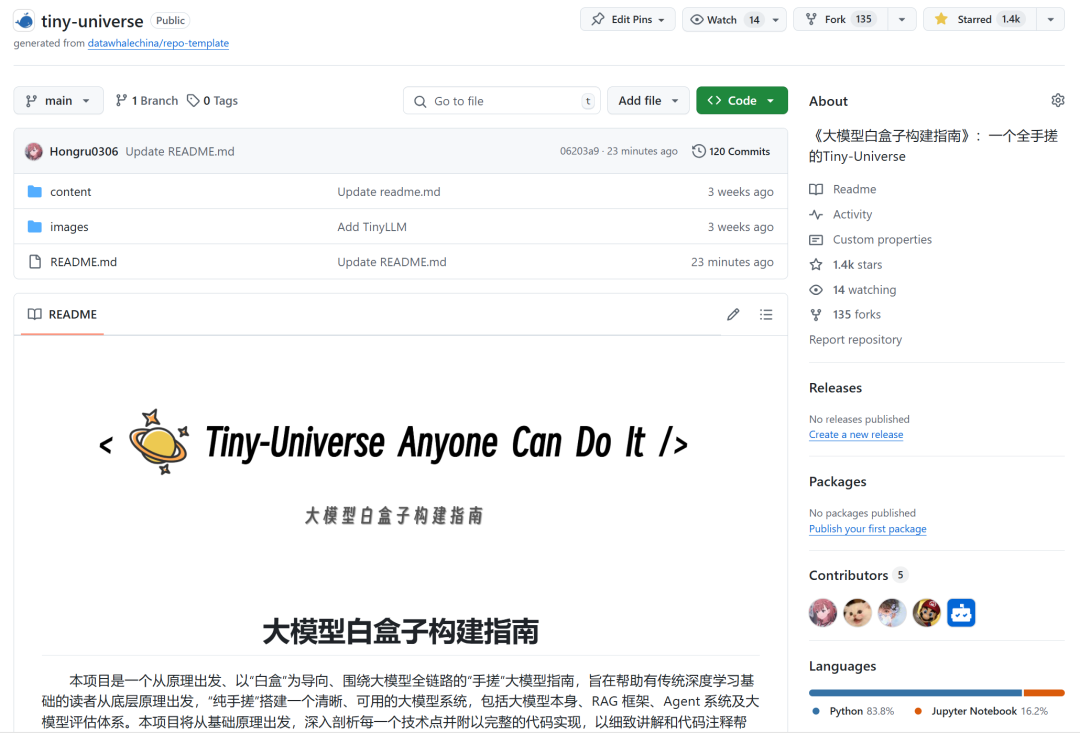
图1.项目主页

开源初心

什么是大模型?

大模型(LLM)狭义上指基于深度学习算法进行训练的自然语言处理(NLP)模型,主要应用于自然语言理解和生成等领域,广义上还包括机器视觉(CV)大模型、多模态大模型和科学计算大模型等。

随着百模大战的经久不衰,开源或是闭源的大模型正不断刷新着模型能力上限,逼近 AGI 的宏伟未来。随着大模型能力的不断增强,基于大模型进行二次微调、应用开发的门槛也不断降低,大模型正在不断深入各行各业,为生产生活赋予智能力量。

然而, 大部分教程目标在于指导开发者如何基于高度封装的 API, 开源框架实现便捷、快速的开发和训练,有利于初学者入门,却忽视了掌握模型原理、框架内部细节的重要性。不管是大模型本身,还是基于大模型的赋能系统 RAG, Agent,又或者是开发应用大模型的必备组件评估体系,都有丰富的基于工具包的使用教程,使很多学习者**“知其然而不知其所以然”,只能机械地使用工具包而无法从原理出发进行自由的魔改。本项目旨在抛弃高度封装的工具包与 API,从底层(Pytorch 层)出发,“纯手搓”**一个大模型系统,完成大模型的 RAG 、 Agent 、Eval 任务,帮助具备一定的大模型基础的学习者进一步掌握大模型原理,拥抱更自由、更丰富也更精彩的大模型世界。

我们希望本项目能为广大学习者提供一个可以看得见、够得着、跟得上的大模型实践机会。让大家在实践中学习,不断提升自己的技术水平。

我们希望为更多学习者打开 LLM 的神奇世界,以“知其然更知其所以然”的心态,搭建属于自己的“Tiny LLM Universe”。

项目受众

本项目适合以下学习者:

  • 掌握了大模型的基本应用,想要学习原理,但不知从何开始;

  • 好奇心旺盛、求知欲强的同学,具备一定的学习热情的同学;

  • 对大模型的RAG、Agent、Eval任务感兴趣,并想要从原理层面了解;

  • 喜欢动手实践写代码,想要从零开始手写大模型的 RAG、Agent、Eval 任务;

  • 想要了解大模型的底层原理,提升自己的大模型技术水平。

项目亮点

  • 本项目旨在全流程 从零手搓;

  • 本项目目前包含 LLM 全流程,从 Model, 到 pretrain,RAG,Agent,Eval,打造 LLM 全栈教程;

  • 区别于大型的算法包,我们的项目代码对初级开发者更 简洁清晰,更“白盒子”;

  • 欢迎大家参与贡献哦,一起打造一个更好的 LLM 生态!

学习指南

本教程目的在于为 LLM 学习者提供一份全链路最简实现框架,帮助大模型学习者更好掌握内部原理。因此,本教程更适合具有一定 NLP, 深度学习经验的学习者食用。如果是初学者小白,建议首先看查下“Qwen-blog”章节的直播内容是否能理解,如果首节课程理解有困难,建议先移步本课程的姊妹项目“self-llm”进行探索。

本教程摒弃使用高度封装的 API, 旨在进行全流程手搓,解析大模型的细节。基本没有显存与硬件等设备的需求, 拥有一张大于 2G 显存的显卡,即可玩遍本项目~~

文章最后

为什么要做这样一个项目?作为一名学习者,我在初尝深度学习的时候,就喜欢 line-by-line 研读代码。从踏上研究这条道路时,深感能得到一份优质的开源代码有多么的不容易,基本每一行都不舍得掠过,研读完每一处细节才肯放下…这种对于优质材料打破沙锅问到底的方式是我的学习习惯,我和项目的伙伴们也一直受益于此学习方式。基于此,伙伴们和我决心为 LLM 系列开创一个从零手搓的教程,帮助更多学习这门深入了解 LLM 的每一处细节,让“黑箱”从此消失!!

最后,由于贡献者团队时间仓促、精力有限,教程难免有些疏漏甚至错误,我们期望学习者在学习的同时,也能积极给我们建议,或者直接对项目进行贡献,让我们共同打磨教程,为后面的学习者提供更好的内容。

补充

为什么要叫“tiny-universe”?

虽然本项目聚焦于 LLM,但绝不仅志只在 LLM。

在未来,项目将持续更新,tiny-rl,tiny-rlhf,tiny-diffusion…等更多优质手搓项目正在火热开发中,也欢迎大家在 issue 中提出你想学习的 Model,更欢迎大佬前来莅临指导!共同为开源宇宙添砖 java!

如何系统的去学习大模型LLM ?

大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。

事实上,抢你饭碗的不是AI,而是会利用AI的人。

继科大讯飞、阿里、华为等巨头公司发布AI产品后,很多中小企业也陆续进场!超高年薪,挖掘AI大模型人才! 如今大厂老板们,也更倾向于会AI的人,普通程序员,还有应对的机会吗?

与其焦虑……

不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!

但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高。

基于此,我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近70次后,终于把整个AI大模型的学习门槛,降到了最低!

在这个版本当中:

第一您不需要具备任何算法和数学的基础
第二不要求准备高配置的电脑
第三不必懂Python等任何编程语言

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包,现在将这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型入门+进阶学习资源包》免费分享(安全链接,放心点击)👈

​

一、LLM大模型经典书籍

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套LLM大模型报告合集

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、LLM大模型系列视频教程

在这里插入图片描述

四、LLM大模型开源教程(LLaLA/Meta/chatglm/chatgpt)

在这里插入图片描述

五、AI产品经理大模型教程

在这里插入图片描述

LLM大模型学习路线 ↓

阶段1:AI大模型时代的基础理解

  • 目标:了解AI大模型的基本概念、发展历程和核心原理。

  • 内容:

    • L1.1 人工智能简述与大模型起源
    • L1.2 大模型与通用人工智能
    • L1.3 GPT模型的发展历程
    • L1.4 模型工程
    • L1.4.1 知识大模型
    • L1.4.2 生产大模型
    • L1.4.3 模型工程方法论
    • L1.4.4 模型工程实践
    • L1.5 GPT应用案例

阶段2:AI大模型API应用开发工程

  • 目标:掌握AI大模型API的使用和开发,以及相关的编程技能。

  • 内容:

    • L2.1 API接口
    • L2.1.1 OpenAI API接口
    • L2.1.2 Python接口接入
    • L2.1.3 BOT工具类框架
    • L2.1.4 代码示例
    • L2.2 Prompt框架
    • L2.3 流水线工程
    • L2.4 总结与展望

阶段3:AI大模型应用架构实践

  • 目标:深入理解AI大模型的应用架构,并能够进行私有化部署。

  • 内容:

    • L3.1 Agent模型框架
    • L3.2 MetaGPT
    • L3.3 ChatGLM
    • L3.4 LLAMA
    • L3.5 其他大模型介绍

阶段4:AI大模型私有化部署

  • 目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。

  • 内容:

    • L4.1 模型私有化部署概述
    • L4.2 模型私有化部署的关键技术
    • L4.3 模型私有化部署的实施步骤
    • L4.4 模型私有化部署的应用场景

这份 LLM大模型资料 包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型入门+进阶学习资源包》免费分享(安全链接,放心点击)👈

​

从零手搓大模型:白盒化构建Transformer、RAG与Agent的完整技术栈 在深度学习领域,Transformer架构已成为现代大语言模型的基石,其核心的自注意力机制通过计算查询、键、值之间的关联,实现了对序列数据的强大建模能力。理解其底层原理,如缩放点积注意力、多头注意力以及位置编码,是掌握大模型技术的关键。这种深刻理解不仅能优化模型性能,更能为后续的创新应用奠定基础。基于Transformer构建的检索增强生成(RAG)技术,通过结合外部知识库,有效缓解了大模型的幻觉问题,提升了回答的准确性与时效性。而智能体(Agent)技术则赋予大模型规划与使用工具的能力,使其能完成更复杂的 阅读详情

相关推荐

保姆级教程:用NodeMediaClient在Android实现RTMP拉流播放(附避坑指南)

本文提供了一份详尽的Android平台RTMP拉流播放实现与深度调优指南。重点介绍了如何使用NodeMediaClient库进行集成,并针对视频卡顿、花屏等常见问题,从渲染引擎选择(SurfaceView与TextureView)、解码策略、缓冲区优化到高级网络自适应等方面提供了实战解决方案与避坑技巧。

weixin_29261711的博客 440

AI大模型企业应用实战:Prompt让LLM理解知识

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;

2401_84204413的博客 3212

CMakeTestCCompiler.cmake错误解决

CMakeTestCCompiler.cmake错误解决欢迎使用Markdown编辑器新的改变功能快捷键合理的创建标题,有助于目录的生成如何改变文本的样式插入链接与图片如何插入一段漂亮的代码片生成一个适合你的列表创建一个表格设定内容居中、居左、居右SmartyPants创建一个自定义列表如何创建一个注脚注释也是必不可少的KaTeX数学公式新的甘特图功能,丰富你的文章UML 图表FLowchart流程图导出与导入导出导入 最近编译项目的时候,遇到一个cmake的错误,具体错误信息如下: /path-to-pr

昨夜星辰的博客 2万+

深入理解大模型之手搓大模型训练(附源码,深入理解)

coeff = 0.5 * (1.0 + math.cos(math.pi * decay_ratio)) # 余弦函数计算衰减系数,范围为0到1。batch_iter = iter_batches(split=split) # 获取对应数据集的批次迭代器。说白了,大模型就像一个“超级学霸”,它“博览群书”(海量数据训练),“过目不忘”(超强记忆力),“举一反三”(生成能力)。tokens_per_iter = batch_size * max_seq_len # 每次迭代处理的token数。

lizhijianwill的博客 1389

创意视觉项目实战:用ESP32-S3+OV5640构建智能图像流系统

本文详细介绍了如何使用ESP32-S3开发板与OV5640摄像头模块构建智能图像流系统。从硬件连接到软件配置,涵盖Arduino环境搭建、图像采集优化、WiFi视频流传输及外设集成,为开发者提供完整的实战指南,助力智能家居和机器人视觉项目开发。

tech5的博客 1292

LaTex的下载与安装(2024小白+windows系统)

本文主要介绍了Latex的下载与安装,还包括安装过程中遇到的小问题的解决。

m0_53096519的博客 2万+

【RAG提升技巧】查询改写HyDE

提高 RAG 推理能力的一个好方法是添加查询理解层 ——在实际查询向量存储之前添加查询转换。

2301_81888214的博客 1125

卡尔曼滤波与目标追踪

卡尔曼滤波与目标追踪为什么要学卡尔曼滤波?卡尔曼滤波是什么?一些概率论的知识基础卡尔曼滤波完整推导状态估计计算卡尔曼增益预测和更新 卡尔曼滤波部分我打算分三节(三次博客的内容): 卡尔曼滤波与行人状态估计 扩展卡尔曼滤波(EKF)与传感器融合 过程模型,无损卡尔曼滤波(UKF)与车辆状态轨迹 为什么要学卡尔曼滤波? 卡尔曼滤波以及其扩展算法能够应用于目标状态估计,如果这个目标是行人,那么就是行人状态估计(或者说行人追踪),如果这个目标是自身,那么就是车辆自身的追踪(结合一些地图的先验,GPS等数据的话就

qq_43232556的博客 4172

《大模型白盒子构建指南》毕业,仅需2G显存,手搓关于LLM的一切!

《大模型白盒子构建指南》是一个从原理出发、以“白盒”为导向、围绕大模型全链路的“手搓”大模型指南,旨在帮助有传统深度学习基础的读者从底层原理出发,“纯手搓”搭建一个清晰、可用的大模型系统,包括大模型架构、大模型预训练、RAG 框架、Agent 系统及大模型评估体系等。

pythonhy的博客 1062

Python学习(一)

快速入门 1.Linux系统中是可以直接使用Python进行编程,具体如下: 进入Python:在linux的Terminal中输入 Python ,进入Python的命令行; 退出Python:在linux的Terminal中输入quit() 或 exit() 或 ctrl +d ,再回车,退出Python的命令行。 2.python的源程序就是一个特殊格式的文本文件,可以使用任意文本编辑软件做Python的开发。 3.Python程序的文件扩展名通常都是 .py。 4.执行Python程序的方式:在

SummerXRT的博客 1280

【SABRE 3D, SABRE 3DxT,LAM设备】2025年9月12日-生产期间维护用的双重隔离

生产期间维护用的双重隔离。该程序用于准备将一个或多个双工位设置为维护状态,同时SABRE 3D/3DxT/3D Scimitar保持生产运行。其目的是在不中断生产的情况下将双工位与运行中的设备隔离。

weixin_46735260的博客 574

手搓LLM大模型:从零开始构建大语言模型

在人工智能的世界里,大型语言模型(LLMs)无疑是最引人注目的明星之一。这些深度神经网络模型的出现,为自然语言处理(NLP)领域带来了前所未有的变革。那么,这些模型究竟是如何工作的?它们又是如何从简单的语言处理任务进化到能够理解和生成复杂文本的呢?

2301_81887304的博客 1844

RT-DETR改进策略【注意力机制篇】| 2024 PPA 并行补丁感知注意模块,提高小目标关注度

本文记录的是利用改进检测精度,详细说明了优化原因,注意事项等。原论文在红外小目标检测任务中,小目标在多次下采样操作中容易丢失关键信息。通过替代编码器和解码器基本组件中的传统卷积操作,更好地保留小目标的重要信息。HCF-Net: Hierarchical Context Fusion Network for Infrared Small Object Detection采用多分支特征提取策略,通过不同分支提取不同尺度和层次的特征。利用局部、全局和串行卷积分支,对输入特征张量进行处理。通过控制 patch si

Limiiiing的博客 1647

大模型开源教程:《大模型白盒子构建指南》毕业,仅需2G显存,手搓关于LLM的一切(附PDF)

本项目旨在为广大学习者搭建一个清晰的、可用的、可复现的大模型世界,帮助每一位有兴趣的学习者纯手工独立搭建自己的 Tiny LLM Universe。

huang9604的博客 1217

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

Thinking with Visual Primitives:以视觉基元进行思考

仅供参考,未经实验验证。基元类型格式用途边界框 (Box)∣ref∣TARGET∣ref∣∣box∣x1y1x2y2∣box∣∣ref∣TARGET∣/ref∣><∣box∣[[x1y1x2y2...∣/box∣精确定位物体位置和尺度点 (Point)∣point∣x1y1∣point∣∣point∣[[x1y。

shimingwang的博客 465

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

手搓智能体的这一年

????目录1 前言2 初捏智能体3 大模型结合业务-langchain 的来临4RAG 与 autogpt 的尝试5AI 智能体 Demo 实践6 结尾,路上过去的一年多,大模型风起云涌,不断迭代,作为一个多年 NLP 产品方向的从业者,可以说是享受其中,惊喜连连。记得22年底,那时疫情放开,身边的人全部病倒,在身体冷热交加中看到了 ChatGPT 的发布,马上在病榻上完成了注册,那时的感觉就仿佛...

QcloudCommunity的博客 1729

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

大模型基础模型--手搓代码(Transformer和FA)

【代码】大模型基础模型--手搓代码(Transformer和FA)

xN的博客 198

手搓大模型——qwen2原理解析

限于能力、篇幅暂时没把数学部分写上来,后续会补上但是对于qwen的原理梳理成功的将先前的有关于gpt类似的transformers模型的知识串联起来,颇有意思。

m0_75212156的博客 2648

从零手搓大模型之路(二、手搓一个RAG)

第二堂是动手构建一个Tiny-RAG,也就是RAG的简化版本,只包含RAG的核心功能Retrieval和Generation。整体看完源码,并听完相应的视频讲解,内容感觉还算是很容易明白,本博文记录下自己感觉相对重要的以及一些思考(持续补充)。Tiny-RAG构建检索增强生成技术(Retrieval-Augmented Generation,RAG),它的出现主要是解决大模型的“幻觉”问题,即当询问者询问一些大模型训练数据不包含的数据(如询问一些时效性比较强的或者是专业性比较强的问题),大模型可能会。

不负韶华不负己 1490

【硬核】纯手搓大语言模型(LLM)从0到1全指南:技术、资源、金钱与血泪

摘要: 本文详细拆解了从零手搓大语言模型(LLM)的全流程,涵盖技术、硬件、成本与实战挑战。核心内容包括: 技术栈:需精通Transformer理论、分布式训练(ZeRO/TP/PP)、PyTorch底层实现及Linux/Docker环境。 硬件需求:玩具级(100M参数)可用单卡(如RTX 4090),7B模型需4张4090或A100,显存占用超56GB,成本达10万+人民币。 隐形成本:电费、噪音、数据清洗与存储(TB级SSD)是烧钱关键。 数据与训练:数据质量决定80%效果,需定制Tokenizer;

lzx618的博客 568

从零开始,一步步教你构建小型大语言模型(LLM):理解底层原理,打破大模型神秘感!

本文是一篇从零开始构建小型大语言模型的实践教程,通过分步详解Tokenizer设计、Embedding表示、Attention机制实现、Transformer结构搭建等关键环节,帮助读者理解大模型底层原理。文章以代码为主线,从简单的字符替换到完整的概率模型构建,展示了如何通过训练使模型从输出乱码到学会说话,最终实现一个具备基本对话能力的LLM,帮助开发者打破对大模型的神秘感。

bugyinyin的博客 774

程序员手“搓”大模型!大模型新书强势来袭:从零构建大模型

如今,像 DeepSeek 、ChatGPT 这样的 LLM 已经展现出令人惊叹的能力:从流畅自然的对话,到复杂的代码(视频)生成,这些模型正在重塑人机交互的方式,重塑数字化生产力。学习完这一章后,我对如何搭建一个能生成连贯文本的模型已经有了较清晰的理解。书中涵盖从数据预处理到模型优化的完整流程,还涉及强化学习、多模态模型等进阶话题,特别适合想“从零开始”构建、优化、应用大模型的读者。书中包含 ChatGLM、BERT、GPT 等模型的部署、微调等实践内容,可以快速迁移到自己的业务中,具有很高的参考价值。

DEVELOPERAA的博客 841

本科生60行代码教你手搓GPT大模型,技术介绍堪比教程

这一章节主要介绍了如何设置编码器、超参数以及参数。你要做的,首先是克隆代码库:然后安装依赖项:注意,如果你使用的是 M1 Macbook,在运行 pip install 之前,你需要在 requirements.txt 中将 tensorflow 更改为 tensorflow-macos。在这个项目下,文件包括 encoder.py、utils.py、gpt2.py、gpt2_pico.py:

qq_46094651的博客 1225

“真男人就应该用 C 编程”!用 1000 行 C 代码手搓了一个大模型,Mac 即可运行,特斯拉前AI总监爆火科普 LLM

徒手用 1000 行 C 语言实现,不依赖庞大的外部库,Mac 即可运行。如今这年头,徒手写神经网络代码已经不算事儿了,现在流行手搓大模型训练代码了!这不,今天,特斯拉前 AI 总监、OpenAI 创始团队成员 Andrej Karpathy 仅用 1000 行简洁的 C 代码,就完成了 GPT-2 大模型训练过程。

IT界那些事儿 1155

视频隐私脱敏工程化:CSRT/KCF追踪算法在本地推理中的实现与边界

在短视频内容合规审查中,动态遮挡(Dynamic Masking)是高频且高耗时的环节。传统手动关键帧打码不仅效率低下,且在目标快速移动或遮挡时极易出现遮罩漂移。本文从计算机视觉工程角度,解析基于CSRT与KCF算法的目标追踪方案在视频隐私处理中的技术路径、性能权衡及落地实践。

Mysssone的博客 224
上一篇: 面向小白开发者开源教程丨动手学大模型应用开发教程(附教程)
下一篇: 有手就行的大模型教程:如何在个人电脑上部署盘古大模型(附教程)
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值