基于 Qwen2.5-Coder 模型和 CrewAI 多智能体框架,实现智能编程系统实战教程

如何使用 CrewAI 构建协作型 AI Agents 语言模型在翻译、总结和推理方面表现出色。但它们的潜力远不止于此。让大语言模型 (LLM) 具备代理性是充分挖掘其推理潜力的一种方法。AI 智能体就是被赋予适当工具和指令的 LLM,能够自动完成网页浏览、网络抓取、执行 SQL 查询、文件操作等任务。利用 LLM 的推理能力,这些智能体能够根据当前需求选择合适的工具。而且,我们还可以将多个智能体组合起来,共同完成更复杂的任务。当我们谈论如何构建 AI Agents时,首先想到的工具就是 LangChain。 阅读详情
AI摘要

本文围绕大模型展开,先介绍阿里开源的Qwen2.5系列大模型,重点讲述Qwen2.5-Coder本地部署,借助Ollama完成。接着基于CrewAI多智能体框架,结合该模型实现编写程序代码系统。最后提供LLM大模型学习资源,包括书籍、报告等,并给出详细学习路线。

9 月 19 日,阿里开源了 Qwen2.5 系列大模型全家桶:除常规的语言模型 Qwen2.5 之外,还发布了专门针对编程的Qwen2.5-Coder模型和数学的 Qwen2.5-Math 模型,并且针对每个模型都提供了不同规模参数版本,包括:

  • Qwen2.5 语音模型: 0.5B, 1.5B, 3B, 7B, 14B, 32B 和 72B
  • Qwen2.5-Coder 编程模型: 1.5B, 7B, 以及即将推出的 32B
  • Qwen2.5-Math 数学模型: 1.5B, 7B 和 72B

Qwen2.5 系列模型性能和推理能力对比,这里不在赘述,我们可以到 Qwen 官网博客查看详细介绍:https://qwenlm.github.io/zh/blog/qwen2.5/

在国内开源大模型中,作者用遥遥领先做为 Qwen2.5 模型系列总结一点也不为过,国内开源大模型能真打的实在是太少了!

最近对Qwen2.5-Coder比较感兴趣,可能是专业的原因,非常期待能有一个智能编程的模型或应用,真所谓:码无止境,学无止境!
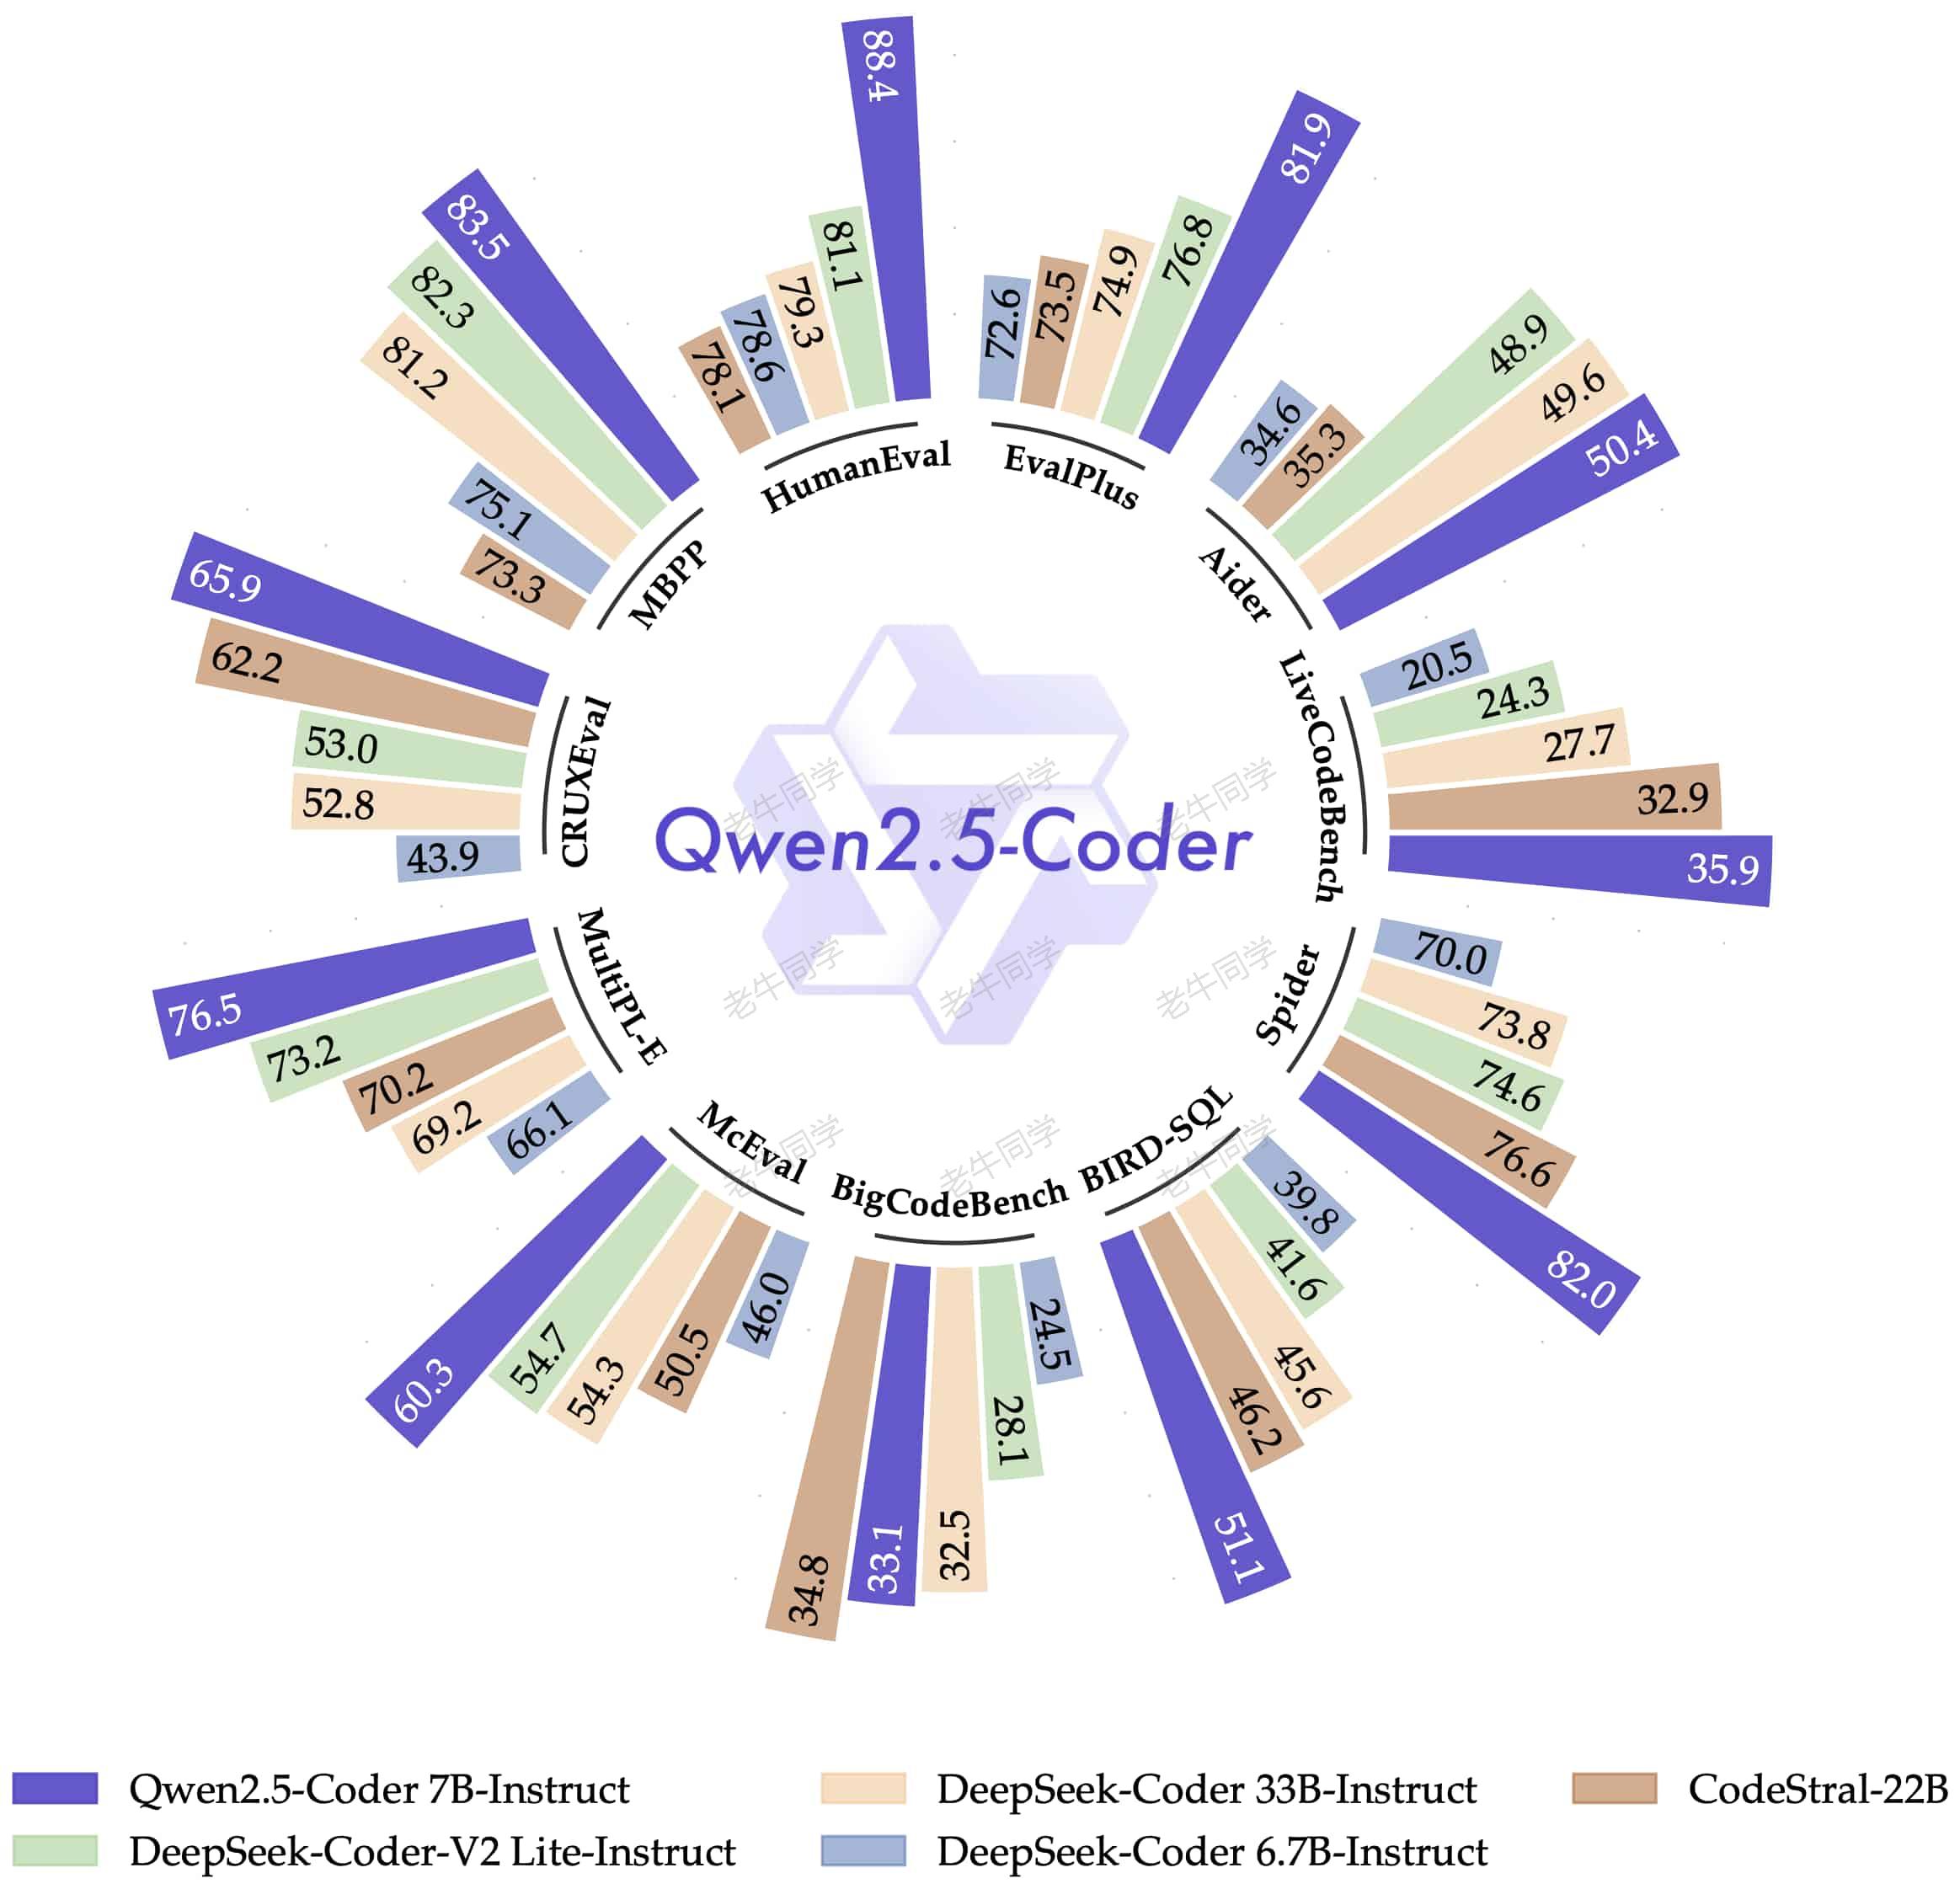
模型能力比对

今天,就基于Qwen2.5-Coder模型,结合CrewAI多智能体框架,实现一个能根据软件需求编写程序代码的系统,同时感受一下Qwen2.5-Coder的能力。因此本文大致分为以下三部分:

  • Qwen2.5-Coder本地部署和简单验证
  • CrewAI多智能体设计、和基于Qwen2.5-Coder的实现代码
  • 最终,验证CrewAI智能体编写的程序

Qwen2.5-Coder 本地部署

通过前面的文章可以看到,我们至少有 3 种方式在本地部署和推理大模型,本文就是不在详细介绍其过程了。

为了尽快实现我们的目标,我们将使用Ollama快速在本地部署Qwen2.5-Coder模型;关于 Ollama 的详细介绍和使用教程,可以参考之前文章:Ollama 完整教程:本地 LLM 管理、WebUI 对话、Python/Java 客户端 API 应用

我们安装好Ollama程序之后,通过以下一条命令,即可完成大模型的下载和部署:

ollama run qwen2.5-coder:7b

下载和部署成功之后,Ollama默认自带了一个终端对话窗口:

Ollama下载和部署

至此,Qwen2.5-Coder模型本地部署就成功了,接下来我们来实现多智能体代码逻辑~

CrewAI 多智能体设计和实现

CrewAI是一个多智能体框架

工欲善其事,必先利其器,我们先准备一下CrewAI的研发环境,我们通过Miniconda管理 Python 虚拟环境

# Python虚拟环境名:CrewAI,版本号:3.10
conda create -n CrewAI python=3.10 -y

# 激活虚拟环境
conda activate CrewAI

# 安装 CrewAI 框架依赖
pip install crewai

我们的编程智能体为游戏智能编程团队(姑且就叫这个名吧),这个团队由3 个角色组成(即:3 个智能体),他们的工作职责设定如下:

  • 软件工程师:负责根据需求编写程序代码
  • 质量工程师:发现并修复软件工程师的代码 Bug 和错误
  • 首席质量工程师:检测程序完整性,并检测是否符合软件需求

我们通过以下步骤,完成游戏智能编程团队整体逻辑(Python 文件:CrewAI-Game.py),首先我们需要导入程序的均依赖类:

import os
from textwrap import dedent
from crewai import Agent, Task, Crew

【第一步:配置Qwen2.5-Coder大模型】

# 配置模型(qwen2.5-coder:7b)
os.environ["OPENAI_API_BASE"] = 'http://127.0.0.1:11434/v1'
os.environ["OPENAI_MODEL_NAME"] = 'qwen2.5-coder:7b',
os.environ["OPENAI_API_KEY"] = 'EMPTY'

【第二步:定义3 个角色(即:3 个智能体)】

3 个智能体分别是:高级软件工程师、高级质量工程师和首席质量工程师

#
# 3个智能体逻辑
#

def senior_engineer_agent():
	"""高级软件工程师智能体"""
	return Agent(
		role='高级软件工程师',
		goal='根据需求完成软件编程',
		backstory=dedent('''你是一位国际领先的科技公司的高级软件工程师。
			你非常擅长Python编程,并尽自己的最大努力编写功能齐全、运行良好的完美代码。
			'''),
		allow_delegation=False,
		verbose=True
	)

def qa_engineer_agent():
	"""高级软件质量工程师智能体"""
	return Agent(
		role='高级软件质量工程师',
		goal='分析程序代码,找出其中的错误,并修复这些错误代码',
		backstory=dedent('''你是一位检测代码的高级工程师。
			你对代码细节很敏锐,非常擅长找出代码中的Bug,包括检查是否缺少导入、变量声明、不匹配括号和语法错误等。
			您还能检查出代码的安全漏洞和逻辑错误。
			'''),
		allow_delegation=False,
		verbose=True
	)

def chief_qa_engineer_agent():
	"""首席软件质量工程师智能体"""
	return Agent(
		role='首席软件质量工程师',
		goal='确保代码实现了需求',
		backstory='''你怀疑程序员没有按照需求编写软件,你特别专注于编写高质量的代码。''',
		allow_delegation=True,
		verbose=True
	)

【第三步:定义3 个任务(即:3 个智能体的任务)】

与 3 个智能体对应,每个智能体均对应有 1 个任务:

#
# 3个任务逻辑
#

def code_task(agent, game):
	return Task(description=dedent(f'''你将按照软件需求,使用Python编写程序:

		软件需求
		------------
		{game}
		'''),
		expected_output='你的输出是完整的Python代码, 特别注意只需要输出Python代码,不要输出其他任何内容!',
		agent=agent
	)

def review_task(agent, game):
	return Task(description=dedent(f'''你将按照软件需求,进一步使用Python完善给定的程序:

		软件需求
		------------
		{game}

		根据给定的Python程序代码,检查其中的错误。包括检查逻辑错误语法错误、缺少导入、变量声明、括号不匹配,以及安全漏洞。
		'''),
		expected_output='你的输出是完整的Python代码, 特别注意只需要输出Python代码,不要输出其他任何内容!',
		agent=agent
	)

def evaluate_task(agent, game):
	return Task(description=dedent(f'''你将按照软件需求,进一步使用Python完善给定的程序:

		软件需求
		------------
		{game}

		查看给定的Python程序代码,确保程序代码完整,并且符合软件需求。
		'''),
		expected_output='你的输出是完整的Python代码, 特别注意只需要输出Python代码,不要输出其他任何内容!',
		agent=agent
	)

【第四步:定义团队,组织智能体协同执行任务】

CrewAI中,Crew代表团队,它有agents和tasks这 2 个核心属性,最终通过kickoff()方法触发执行整个流程:

#
# 团队逻辑
#

print('')
game = input('# 您好,我们是游戏智能编程团队,请输入游戏的详细描述:\n\n')
print('')

# 智能体
senior_engineer_agent = senior_engineer_agent()
qa_engineer_agent = qa_engineer_agent()
chief_qa_engineer_agent = chief_qa_engineer_agent()

# 任务
code_game = code_task(senior_engineer_agent, game)
review_game = review_task(qa_engineer_agent, game)
approve_game = evaluate_task(chief_qa_engineer_agent, game)

# 团队
crew = Crew(
	agents=[
		senior_engineer_agent,
		qa_engineer_agent,
		chief_qa_engineer_agent
	],
	tasks=[
		code_game,
		review_game,
		approve_game
	],
	verbose=True
)

# 执行
game_code = crew.kickoff()

最后,我们拿到 Python 代码之后,希望能保存到本地文件(Python 文件:Game.py):

# 输出
print("\n\n########################")
print("## 游戏代码结果")
print("########################\n")
print(game_code)

# 存储代码
filename = 'Game.py'

print("\n\n########################\n")
with open(filename, 'w', encoding='utf-8') as file:
    file.write(game_code)

print(f"游戏代码已经存储到文件: {filename}")
print(f'你可以运行游戏:python {filename}')

以上步骤即完成了我们只能编程团队代码,接下就可以执行了:python CrewAI-Game.py

CrewAI 执行过程中,我们看到 3 个智能体执行详细信息:

  • 软件工程师执行过程信息

  • 质量工程师执行过程信息

  • 首席工程师执行过程信息

最后,我们运行本地存储的小游戏程序:python Game.py

因为程序使用到了Pygame包,如果虚拟环境没有的话,需要安装一下:pip install pygame

最终我们运行起来了贪吃蛇游戏:

贪吃蛇游戏

至此,本次我们需求基本完成了,我们通过定义的 3 个智能体和对应的任务,最终智能体与Qwen2.5-Coder交互完成软件需求程序的编写。

程序最终还能跑起来,这也进一步体现了Qwen2.5-Coder模型的语音和代码推理能力!

如何系统的去学习大模型LLM ?

大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。

事实上,抢你饭碗的不是AI,而是会利用AI的人。

继科大讯飞、阿里、华为等巨头公司发布AI产品后,很多中小企业也陆续进场!超高年薪,挖掘AI大模型人才! 如今大厂老板们,也更倾向于会AI的人,普通程序员,还有应对的机会吗?

与其焦虑……

不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!

但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高。

针对所有自学遇到困难的同学们,我帮大家系统梳理大模型学习脉络,将这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型入门+进阶学习资源包》免费分享(安全链接,放心点击)👈

​

一、LLM大模型经典书籍

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套LLM大模型报告合集

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)

在这里插入图片描述

三、LLM大模型系列视频教程

在这里插入图片描述

四、LLM大模型开源教程(LLaLA/Meta/chatglm/chatgpt)

在这里插入图片描述

LLM大模型学习路线 ↓

阶段1:AI大模型时代的基础理解

  • 目标:了解AI大模型的基本概念、发展历程和核心原理。

  • 内容:

    • L1.1 人工智能简述与大模型起源
    • L1.2 大模型与通用人工智能
    • L1.3 GPT模型的发展历程
    • L1.4 模型工程
    • L1.4.1 知识大模型
    • L1.4.2 生产大模型
    • L1.4.3 模型工程方法论
    • L1.4.4 模型工程实践
    • L1.5 GPT应用案例

阶段2:AI大模型API应用开发工程

  • 目标:掌握AI大模型API的使用和开发,以及相关的编程技能。

  • 内容:

    • L2.1 API接口
    • L2.1.1 OpenAI API接口
    • L2.1.2 Python接口接入
    • L2.1.3 BOT工具类框架
    • L2.1.4 代码示例
    • L2.2 Prompt框架
    • L2.3 流水线工程
    • L2.4 总结与展望

阶段3:AI大模型应用架构实践

  • 目标:深入理解AI大模型的应用架构,并能够进行私有化部署。

  • 内容:

    • L3.1 Agent模型框架
    • L3.2 MetaGPT
    • L3.3 ChatGLM
    • L3.4 LLAMA
    • L3.5 其他大模型介绍

阶段4:AI大模型私有化部署

  • 目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。

  • 内容:

    • L4.1 模型私有化部署概述
    • L4.2 模型私有化部署的关键技术
    • L4.3 模型私有化部署的实施步骤
    • L4.4 模型私有化部署的应用场景

这份 LLM大模型资料 包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型入门+进阶学习资源包》免费分享(安全链接,放心点击)👈

​

如何使用Ollama部署qwen2.5-coder,进行本地代码生成 如何部署大模型,自动生成代码。 阅读详情

相关推荐

vLLM+CrewAI构建AI自主编程闭环:从需求到PR的工程实践

AI Agent正从概念验证迈向真实软件工程——其核心是让大语言模型具备可复现、低延迟、可编排的工程能力。vLLM通过PagedAttention与前缀缓存解决Agent推理的实时性与确定性瓶颈,CrewAI则以角色化Agent、结构化Task和分层Process实现多智能体协同。这种组合不再局限于代码补全,而是支撑完整开发闭环:理解需求、检索上下文、生成/测试/审查代码,并自动提交PR。它已在金融风控、SaaS接口开发等场景落地,将中等复杂度需求交付周期压缩至小时级,同时提升测试覆盖率与文档一致性。本文聚

weixin_33937778的博客 432

自适应多智能体脚手架:构建高效AI协作系统解决复杂工程问题

多智能体系统(Multi-Agent System)是人工智能领域的重要范式,其核心原理是通过多个具备特定功能的智能体(Agent)进行分工协作,以解决单一模型难以处理的复杂任务。该技术通过模拟人类团队的专业分工与协同机制,将宏观任务分解并由不同智能体负责分析、规划、执行与验证等环节,从而显著提升问题解决的效率与成功率。其技术价值在于能够整合异构模型的优势,实现动态任务调度与负载均衡,特别适用于需要多步骤推理和动态决策的场景,如软件工程中的自动化Bug修复、代码审查与系统设计。在实际应用中,结合Claude

weixin_30338497的博客 304

10大开源AI Agent平台实战测评:从Dify到LangChain的选型指南

AI Agent 这个概念火了快两年,从最初的“自动写代码”到“模拟公司协作”,再到“自主完成任务”,听起来无所不能。但很多开发者,包括我自己,都踩过这样的坑:兴致勃勃地选了一个明星平台,照着教程跑通了Demo,结果一到要接入自己的业务逻辑、处理真实数据、或者需要稳定运行在生产环境时,就发现处处是“雷”——要么是学习曲线陡峭,写胶水代码写到怀疑人生;要么是平台太重,私有化部署成本高得吓人;要么是灵活性太差,稍微偏离标准流程就玩不转。 我们真正需要的,不是一个听起来很酷的“AI大脑”,而是一个能让业务逻辑真正

weixin_34239169的博客 422

基于 Qwen2.5-Coder 模型和 CrewAI 多智能体框架,实现智能编程系统的实战教程

Qwen2.5 开源的系列模型中,Qwen2.5-Coder 模型的推理能力技压群雄,本文集合 CrewAI 框架,让多智能体自己编写符合我们需求的程序……

老牛啊 2051

10大开源AI Agent平台深度评测:从部署到实战全指南

这次我们来看一个关于开源 AI Agent 开发平台的深度盘点。如果你正在寻找一个能让业务真正跑起来的 AI Agent 方案,无论是想快速搭建一个智能客服,还是想实现一个能自主完成复杂任务的多智能体系统,这篇文章会给你一个清晰的答案。市面上各种平台眼花缭乱,但真正能落地、能部署、能根据自己需求深度定制的,往往还是那些活跃在 GitHub 上的开源项目。 本文不会空谈概念,而是直接聚焦于 10 个顶级的开源 AI Agent 平台,从它们的核心能力、部署门槛、适用场景到实际选型,为你提供一份可以直接上手操作

weixin_30376509的博客 667

从AI基础交互到智能体系统构建:五级能力模型全解析

提示工程(Prompt Engineering)作为与大语言模型交互的核心技术,通过结构化指令引导模型生成更精准、可控的输出,其原理在于将自然语言需求转化为模型可理解的格式化约束。这项技术的价值在于显著提升AI协作的效率与质量,广泛应用于内容创作、代码生成、数据分析等场景。检索增强生成(RAG)进一步扩展了其能力边界,通过结合外部知识库,使模型能够基于特定领域信息生成专业回答。本文基于提示工程和RAG等关键技术,系统构建了从基础交互到生态构建的五级AI能力模型,为不同阶段的实践者提供了清晰的进阶路径和实操指

weixin_30918633的博客 405

基于CrewAI&Qwen3_vl_plus实现高速违规检测,发送违规检测邮件

三个agent:高速拍摄的图像识别、图像分析是否存在违规开车、分析内容和图像作为附件发送到QQ邮箱。

qq_52557074的博客 342

CrewAI智能体开发:CrewAI概述

CrewAI 是一个精简、闪电般快速的 Python 框架,完全从零开始构建,独立于 LangChain 或其他代理框架。

王国平的博客 830

多智能体系统实战:Agent编排与生产级落地指南

多智能体系统(Multi-Agent Systems)是大模型从单点能力迈向复杂任务协同的关键范式,其核心在于通过角色解耦、任务编排与跨Agent验证,突破单一大模型的认知瓶颈与幻觉风险。Agent编排(Agent Orchestration)并非简单串联API,而是构建具备职责边界、记忆隔离、工具校验与反思修正能力的协作协议。它在金融风控、电商选品、IT运维等需多源融合、高容错、可审计的生产场景中展现出显著工程价值——错误率下降超70%,问题定位精度提升至环节级。本文聚焦真实项目中的架构选型逻辑、七项硬性

weixin_30443075的博客 369

01-FreeSWITCH 的安装、部署、配置以及可能遇到的问题和解决方法

一文让您了解从FreeSWITCH 的安装、部署、配置、可能遇到的问题及解决方法。一切从实际项目出发,以工程应用为目的。

秋风的博客 2127

在 Ubuntu 上安装和配置 PostgreSQL 实录

本文介绍了在Ubuntu系统上安装和配置PostgreSQL数据库的完整步骤。主要内容包括:1)通过官方源或PPA源安装最新版本;2)修改配置文件(postgresql.conf和pg_hba.conf)以允许远程访问;3)设置postgres用户密码;4)创建新用户并配置权限;5)防火墙设置和重启服务;6)验证安装和远程连接方法。文章提供了详细的命令行操作指导,帮助用户完成从安装到远程访问的全部配置过程。

qq_58168857的博客 1207

基于LLM多智能体与RAG的代码安全审查系统构建指南

在软件开发生命周期中,代码安全审查是保障应用安全的关键环节。传统静态分析工具(SAST)依赖规则库,虽覆盖广泛但误报率高,难以适应现代敏捷开发节奏。其原理是通过预定义模式匹配代码中的潜在风险点,但缺乏对代码语义和上下文的理解。随着大语言模型(LLM)技术的发展,结合检索增强生成(RAG)和多智能体(Multi-Agent)协作,为自动化代码审计带来了新范式。这项技术的核心价值在于,通过模拟专家团队的协同推理过程,将代码变更理解、历史漏洞知识关联、多角度逻辑推演等任务分解给专业化智能体,显著提升了漏洞检测的准

weixin_34088583的博客 299

【UE5】虚幻引擎Gameplay框架

游戏实例(UGameInstance)会在引擎启动时实例化,并保持活跃直至引擎关闭。这是一种管理器类,在游戏中不存在实体,但会追踪数据和运行代码。在联网多人游戏中,游戏实例不会被复制,而是独立存在于服务器以及所有互联的客户端上。所有你希望在关卡加载间保持的内容都应存于游戏实例中。例如,游戏实例是管理游戏保存系统的到地方。游戏实例还可以充当任意数量的 游戏实例子系统 的管理器,这些子系统由游戏实例创建和销毁,并且与游戏实例本身具有相同的生命周期。在线子系统就属于这类子系统。

一个写程序的 1795

8G显存本地跑大模型的黄金法则:Q4_K_M量化与qwen2.5:7b实战指南

大语言模型本地部署的核心瓶颈在于显存容量与模型体积的刚性匹配。当GPU显存为8GB时,未经量化的7B模型(约14GB)远超承载极限,必须依赖量化技术压缩权重——Q4_K_M作为兼顾精度与体积的主流方案,可将qwen2.5:7b压缩至约3.8GB,精准适配8G可用显存(扣除系统开销后约6.5–7GB),同时保留FlashAttention-2等关键优化支持。该配置不仅满足基础推理,更在中文理解、长上下文稳定性及Agent工作流中展现出工程级可靠性,成为消费级显卡(如RTX 4060)落地RAG、自动化客服、合

weixin_34184158的博客 451

STM32G474使用HRTIM触发多路ADC采样,通过DMA传输,通过串口打印显示,实现PWM中间时刻采样,避免开关噪声

本章工程使用HRTIM定时器进行ADC的触发,打开主定时器,子定时器A,B,C。(本工程未使用到A与C定时器,配置时可无需打开)主定时器配置:设置主定时器的频率为100KHz,并且设置自动更新以及自动重装载值。子定时器B设置:设置子定时器B为100KHz,并且每九次计数完成后产生一次中断。配置如上:1.打开自动预装载值2.打开自动复位3.设置死区时间以及互补PWM4.定时器复位触发更新寄存器5.定时器翻转重置更新6.重置触发源(定时器计数器在发生更新事件时重置)

weixin_41407439的博客 4909

esp32s3 spi camera gc6133调试

gc6133 spi只有master模式,同时需要esp32提供主时钟,需要有主时钟然后才能通过i2c进行初始化.测试了几种方式,记录如下。

hclydao的专栏 1564

大模型工具调用与智能体构建:从原理到本地部署实践

语言模型工具调用(Tool Calling)是扩展大语言模型能力边界的关键技术,其核心原理是让模型能够识别用户意图,并调用预设的外部函数或API来执行其无法直接完成的任务。这项技术通过将模型的自然语言理解能力与外部系统的精确执行能力相结合,解决了模型“知识截止”、无法进行精确计算和实时交互等固有局限。在工程实践中,开发者可以利用LangChain、LlamaIndex等框架,为本地部署的Llama、Qwen等开源模型快速集成天气查询、数据计算、信息搜索等工具,从而构建出能够自主规划、执行多步骤复杂任务的智能

weixin_34342207的博客 428

【电机应用控制】——直流有刷电机&驱动板/编码器介绍&PID算法&实操代码思路

声明:学习笔记来自正点原子B站教程,仅供学习交流!!玩具车、平衡车、无人机、印刷机、打印机、手机振动马达等电机即电动机(motor),也叫作马达,电能转化为机械能。按电源:直流、交流按用途:驱动用、控制用按运转速度:高速、低速、恒速、调速直流电机(有刷、无刷)、舵机、步进电机、伺服电机1、直流有刷电机(Brushed DC Motor,简称BDC)是内含电刷装置的将直流电能转化为机械能的电动机。例如四驱赛车四个马达操控方便、成本低、维护时换电刷即可;

weixin_51658186的博客 2万+

私有化AI秘书部署实战:从架构设计到安全落地的完整指南

大语言模型(LLM)作为当前人工智能的核心技术,通过其强大的自然语言理解和生成能力,正在深刻改变人机交互方式。其工作原理基于Transformer架构,通过海量数据预训练和指令微调,使其能够完成对话、摘要、代码生成等复杂任务。这项技术的核心价值在于将非结构化信息转化为可操作的智能,从而在多个层面提升效率与自动化水平。在应用场景上,企业级用户对数据安全、隐私保护和定制化流程的需求日益增长,这催生了对私有化部署方案的强烈需求。私有化部署不仅能确保敏感数据不出域,还能实现与内部系统的深度集成和定制化工作流。本文聚

weixin_30399155的博客 405

2026年沐曦集成电路数字IC笔试试卷带答案

本文摘要: 这是一份数字IC设计笔试模拟题,包含单选题、波形分析、多选题和代码设计题。重点考察ASIC设计流程(如逻辑综合将RTL转为门级网表)、时序分析(建立时间余量计算)、跨时钟域处理(格雷码应用)、复位机制、状态机设计等核心知识点。涉及沐曦特色考点如GPU架构(SIMT模型)、国产GPU芯片(曦云C系列)及MXMACA软件栈。代码题要求实现50%占空比三分频电路,综合考察Verilog设计能力。试题强调PPA优化、低功耗技术等工程实践要点,覆盖数字IC前端设计全流程核心内容。(149字)

Open 259

计算机组成原理(第三版)唐朔飞-第十章控制单元的设计-课后习题

计算机组成原理(第三版)唐朔飞-第十章控制单元的设计-课后习题

weixin_45735391的博客 3万+

多智能体系统涌现行为测试:从原理到本地复现实践

多智能体系统(Multi-Agent Systems, MAS)是分布式人工智能的核心领域,其核心原理在于多个自主智能体在共享环境中通过感知、决策与交互,共同完成复杂任务。该技术的核心价值在于能够模拟现实世界中群体协作、竞争与博弈等复杂社会行为,为自动化决策、资源优化和复杂系统仿真提供了强大工具。在AI安全与系统可靠性日益重要的今天,理解智能体间的涌现行为(如自发协作或对抗)成为关键课题。通过结合开源智能体框架(如AutoGen、LangChain)与大模型后端(如GPT-4、Llama 3),开发者可在本

weixin_30701575的博客 391

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

在 Win11 环境下搭建Docker + Dify + Ollama 本地 AI Agent

我的配置 RTX 4060 Laptop + 8GB 显存 + 16GB 内存PID。

zrlll2023的博客 1528

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

本地大模型部署实战:从工具链选型到硬件配置的完整指南

大语言模型(LLM)作为人工智能领域的核心技术,通过海量数据训练获得强大的语言理解和生成能力。其工作原理基于Transformer架构,通过自注意力机制处理序列数据,实现上下文感知的文本生成。这项技术的核心价值在于为开发者提供了可私有化部署的智能基础,有效解决了数据隐私、网络延迟和API调用成本等问题。在实际应用场景中,本地化部署的LLM可广泛应用于智能对话、代码生成、文档分析与内容创作等多个领域。本文聚焦于开源生态中的推理引擎与模型管理平台,深入解析如何利用Ollama和llama.cpp等工具搭建高效可

weixin_33747129的博客 486

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

上一篇: 最强开源大模型教程:llm-action,让天下人没有难学的大模型(附教程)
下一篇: LangChain 入门与避坑指北:基本概念、问题及学习方法
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值