


1. Ollama 部署的本地模型(🔺)
Ollama 是一个开源框架,专为在本地机器上便捷部署和运行大型语言模型(LLM)而设计。这是 Ollama 的官网地址:https://ollama.com/
- 以下是其主要特点和功能概述:
- 简化部署:Ollama 目标在于简化在 Docker 容器中部署大型语言模型的过程,使得非专业用户也能方便地管理和运行这些复杂的模型。
- 轻量级与可扩展:作为轻量级框架,Ollama 保持了较小的资源占用,同时具备良好的可扩展性,允许用户根据需要调整配置以适应不同规模的项目和硬件条件。
- API支持:提供了一个简洁的 API,使得开发者能够轻松创建、运行和管理大型语言模型实例,降低了与模型交互的技术门槛。
- 预构建模型库:包含一系列预先训练好的大型语言模型,用户可以直接选用这些模型应用于自己的应用程序,无需从头训练或自行寻找模型源
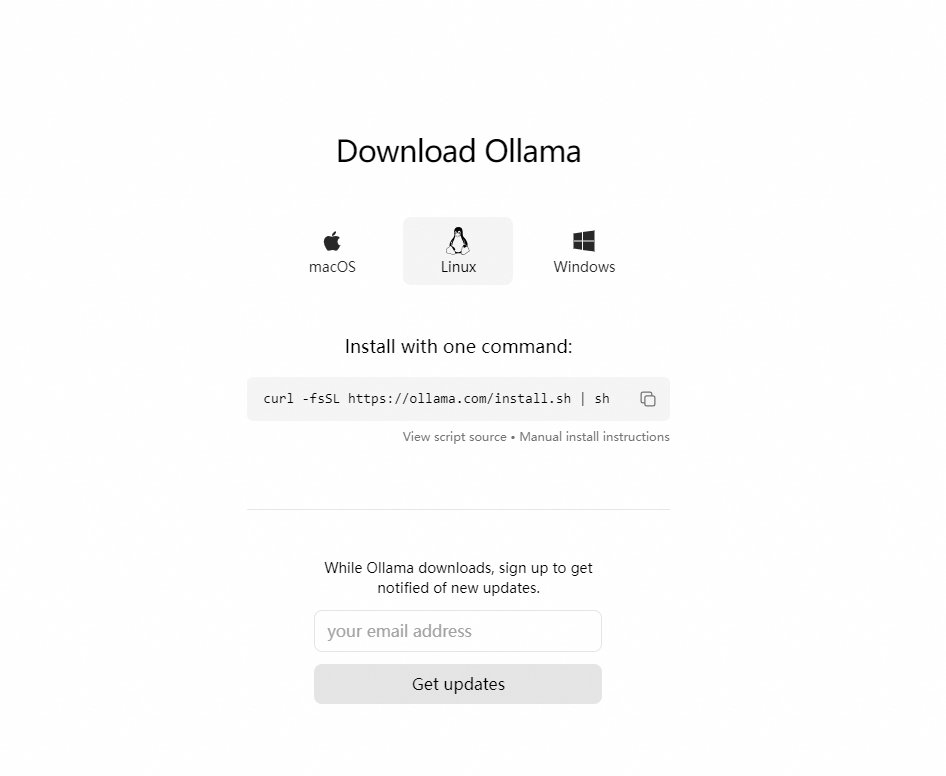
1.1 一键安装
curl: (77) error setting certificate verify locations:CAfile: /data/usr/local/anaconda/ssl/cacert.pemCApath: none 报错原因: cacert.pem 的寻址路径 CAfile 不对,也就是在该路径下找不到文件。
- 解决方法:
- 找到你的 cacert.pem 文件所在位置 /path/to/cacert.pem。如果你没有该证书,可以先在 https://curl.se/ca/cacert.pem 下载,保存在某个目录中。
- 设置环境变量
代码语言:javascript
复制
export CURL_CA_BUNDLE=/path/to/cacert.pem
#将"/path/to/cacert.pem"替换为你的证书文件的实际路径。
export CURL_CA_BUNDLE=/www/anaconda3/anaconda3/ssl/cacert.pem
- 执行下载
代码语言:javascript
复制
curl -fsSL https://ollama.com/install.sh | sh
1.2 手动安装
ollama中文网:https://ollama.fan/getting-started/linux/
- 下载 ollama 二进制文件:Ollama 以自包含的二进制文件形式分发。将其下载到您的 PATH 中的目录:
代码语言:javascript
复制
sudo curl -L https://ollama.com/download/ollama-linux-amd64 -o /usr/bin/ollama

sudo chmod +x /usr/bin/ollama
- 将 Ollama 添加为启动服务(推荐):为 Ollama 创建一个用户:
代码语言:javascript
复制
sudo useradd -r -s /bin/false -m -d /usr/share/ollama ollama
3.在 /etc/systemd/system/ollama.service 中创建一个服务文件:
代码语言:javascript
复制
#vim ollama.service

[Unit]

Description=Ollama Service
After=network-online.target

[Service]
ExecStart=/usr/bin/ollama serve
User=ollama
Group=ollama
Restart=always
RestartSec=3

[Install]
WantedBy=default.target
- 然后启动服务:
代码语言:javascript
复制
sudo systemctl daemon-reload
sudo systemctl enable ollama
- 启动 Ollama¶ 使用 systemd 启动 Ollama:
代码语言:javascript
复制
sudo systemctl start ollama
- 更新,查看日志
代码语言:javascript
复制
#再次运行
sudo curl -L https://ollama.com/download/ollama-linux-amd64 -o /usr/bin/ollama
sudo chmod +x /usr/bin/ollama

#要查看作为启动服务运行的 Ollama 的日志,请运行:
journalctl -u ollama
- 步骤7:关闭 Ollama 服务
代码语言:javascript
复制
#关闭ollama服务
service ollama stop
1.3 Linux内网离线安装Ollama
- 查看服务器CPU的型号
代码语言:javascript
复制
##查看Linux系统CPU型号命令,我的服务器cpu型号是x86_64
lscpu
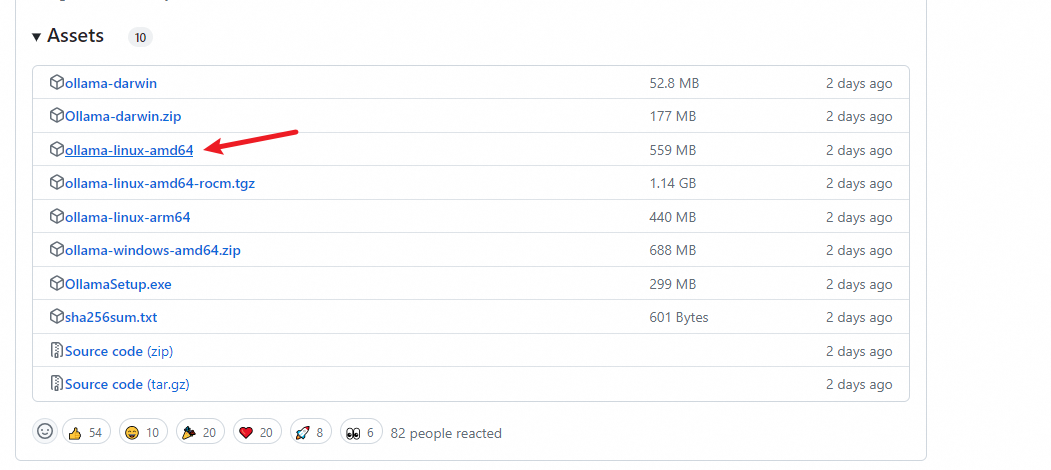
- 步骤2:根据CPU型号下载Ollama安装包,并保存到目录
下载地址: https://github.com/ollama/ollama/releases/
代码语言:javascript
复制
#x86_64 CPU选择下载ollama-linux-amd64
#aarch64|arm64 CPU选择下载ollama-linux-arm64
代码语言:javascript
复制
#有网机器下载过来也一样
wget https://ollama.com/download/ollama-linux-amd64
下载到离线服务器上:/usr/bin/ollama ollama就是你下载的ollama-linux-amd64 改名了(mv),其他步骤一致
1.4 修改存储路径
Ollama模型默认存储在:
- macOS: ~/.ollama/models
- Linux: /usr/share/ollama/.ollama/models
- Windows: C:\Users.ollama\models
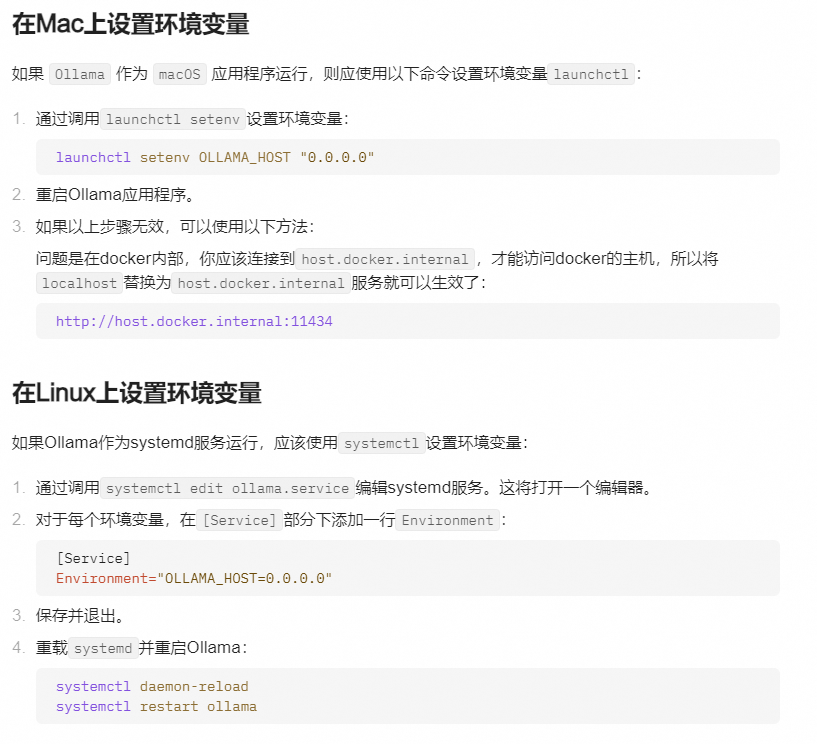
如果 Ollama 作为 systemd 服务运行,则应使用以下命令设置环境变量systemctl:
- 通过调用 来编辑 systemd 服务systemctl edit ollama.service。这将打开一个编辑器。
- Environment对于每个环境变量,在部分下添加一行Service:
直接在“/etc/systemd/system/ollama.service”增了2行:
代码语言:javascript
复制
[Service]
Environment="OLLAMA_HOST=0.0.0.0:7861"
Environment="OLLAMA_MODELS=/www/algorithm/LLM_model/models"
- 保存并退出。
- 重新加载systemd并重新启动 Ollama:
代码语言:javascript
复制
systemctl daemon-reload
systemctl restart ollama
参考链接:https://github.com/ollama/ollama/blob/main/docs/faq.md
- 使用 systemd 启动 Ollama:
代码语言:javascript
复制
sudo systemctl start ollama
- 终止
终止(ollama加载的大模型将会停止占用显存,此时ollama属于失联状态,部署和运行操作失效,会报错:
Error: could not connect to ollama app, is it running?需要启动后,才可以进行部署和运行操作
代码语言:javascript
复制
systemctl stop ollama.service
- 终止后启动(启动后,可以接着使用ollama 部署和运行大模型)
代码语言:javascript
复制
systemctl start ollama.service
1.5 启动LLM
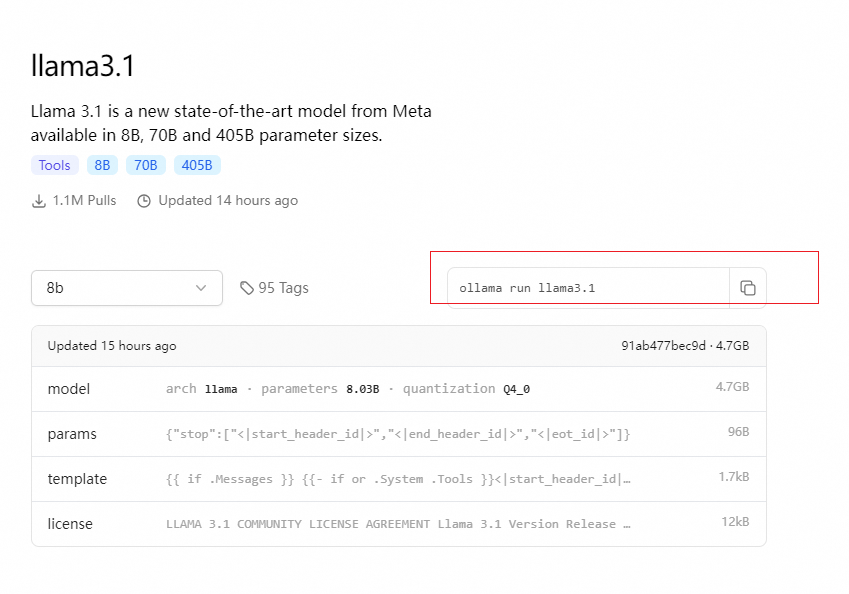
- 下载模型
代码语言:javascript
复制
ollama pull llama3.1
ollama pull qwen2
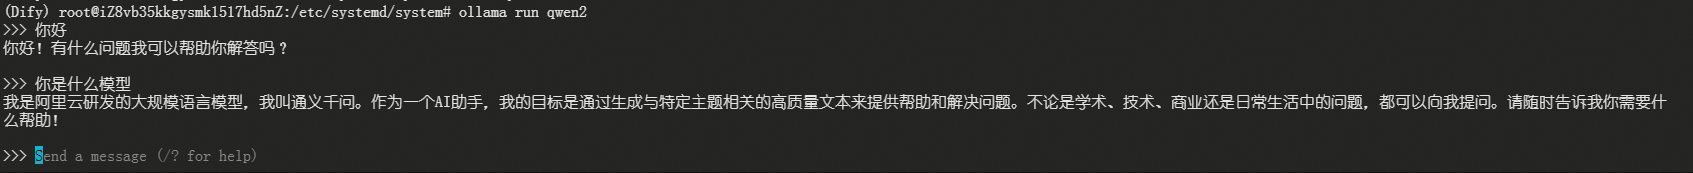
- 运行大模型
代码语言:javascript
复制
ollama run llama3.1
ollama run qwen2
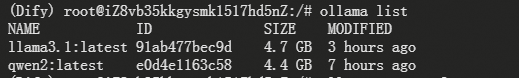
- 查看是否识别到大模型:
ollama list, 如果成功, 则会看到大模型
代码语言:javascript
复制
ollama list
NAME            ID              SIZE    MODIFIED
qwen2:latest    e0d4e1163c58    4.4 GB  3 hours ago
- 使用该
ollama ps命令查看当前已加载到内存中的模型。
代码语言:javascript
复制
NAME            ID              SIZE    PROCESSOR       UNTIL
qwen2:latest    e0d4e1163c58    5.7 GB  100% GPU        3 minutes from now
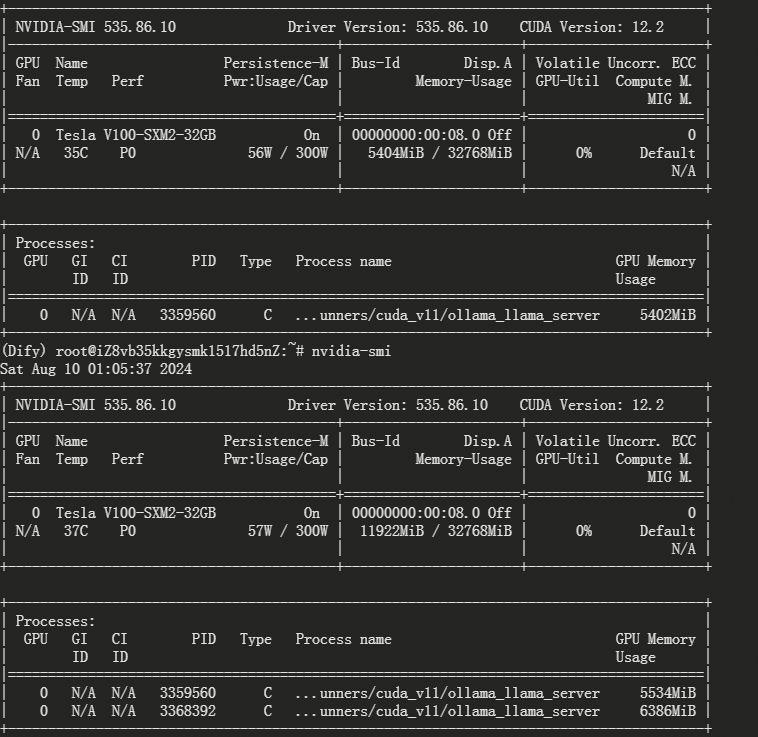
- nvidia-smi查看
代码语言:javascript
复制
+---------------------------------------------------------------------------------------+
| NVIDIA-SMI 535.86.10              Driver Version: 535.86.10    CUDA Version: 12.2     |
|-----------------------------------------+----------------------+----------------------+
| GPU  Name                 Persistence-M | Bus-Id        Disp.A | Volatile Uncorr. ECC |
| Fan  Temp   Perf          Pwr:Usage/Cap |         Memory-Usage | GPU-Util  Compute M. |
|                                         |                      |               MIG M. |
|=========================================+======================+======================|
|   0  Tesla V100-SXM2-32GB           On  | 00000000:00:08.0 Off |                    0 |
| N/A   35C    P0              56W / 300W |   5404MiB / 32768MiB |      0%      Default |
|                                         |                      |                  N/A |
+-----------------------------------------+----------------------+----------------------+

+---------------------------------------------------------------------------------------+
| Processes:                                                                            |
|  GPU   GI   CI        PID   Type   Process name                            GPU Memory |
|        ID   ID                                                             Usage      |
|=======================================================================================|
|    0   N/A  N/A   3062036      C   ...unners/cuda_v11/ollama_llama_server     5402MiB |
+---------------------------------------------------------------------------------------+
- 启动后,我们可验证是否可用:
代码语言:javascript
复制
curl http://10.80.2.195:7861/api/chat -d '{
  "model": "llama3.1",
  "messages": [
    { "role": "user", "content": "why is the sky blue?" }
  ]
}'
1.6 更多其他配置
Ollama 可以设置的环境变量:
OLLAMA_HOST:这个变量定义了Ollama监听的网络接口。通过设置OLLAMA_HOST=0.0.0.0,我们可以让Ollama监听所有可用的网络接口,从而允许外部网络访问。OLLAMA_MODELS:这个变量指定了模型镜像的存储路径。通过设置OLLAMA_MODELS=F:\OllamaCache,我们可以将模型镜像存储在E盘,避免C盘空间不足的问题。OLLAMA_KEEP_ALIVE:这个变量控制模型在内存中的存活时间。设置OLLAMA_KEEP_ALIVE=24h可以让模型在内存中保持24小时,提高访问速度。OLLAMA_PORT:这个变量允许我们更改Ollama的默认端口。例如,设置OLLAMA_PORT=8080可以将服务端口从默认的11434更改为8080。OLLAMA_NUM_PARALLEL:这个变量决定了Ollama可以同时处理的用户请求数量。设置OLLAMA_NUM_PARALLEL=4可以让Ollama同时处理两个并发请求。OLLAMA_MAX_LOADED_MODELS:这个变量限制了Ollama可以同时加载的模型数量。设置OLLAMA_MAX_LOADED_MODELS=4可以确保系统资源得到合理分配。
Environment=“OLLAMA_PORT=9380” 没有用
- 这样指定:
Environment="OLLAMA_HOST=0.0.0.0:7861" - 指定 GPU 本地有多张 GPU,如何用指定的 GPU 来运行 Ollama? 在Linux上创建如下配置文件,并配置环境变量 CUDA_VISIBLE_DEVICES 来指定运行 Ollama 的 GPU,再重启 Ollama 服务即可【测试序号从0还是1开始,应是从0开始】。
代码语言:javascript
复制
vim /etc/systemd/system/ollama.service
[Service]
Environment="CUDA_VISIBLE_DEVICES=0,1"
1.7 Ollama常见命令
- 重启 ollama
代码语言:javascript
复制
systemctl daemon-reload
systemctl restart ollama
- 重启 ollama 服务
ubuntu/debian
代码语言:javascript
复制
sudo apt update
sudo apt install lsof
stop ollama
lsof -i :11434
kill <PID>
ollama serve
- Ubuntu
代码语言:javascript
复制
sudo apt update
sudo apt install lsof
stop ollama
lsof -i :11434
kill <PID>
ollama serve
- 确认服务端口状态:
代码语言:javascript
复制
netstat -tulpn | grep 11434
- 配置服务
为使外网环境能够访问到服务,需要对 HOST 进行配置。
打开配置文件:
代码语言:javascript
复制
vim /etc/systemd/system/ollama.service
根据情况修改变量 Environment:
服务器环境下:
代码语言:javascript
复制
Environment="OLLAMA_HOST=0.0.0.0:11434"
虚拟机环境下:
代码语言:javascript
复制
Environment="OLLAMA_HOST=服务器内网IP地址:11434"
1.8 卸载Ollama
如果决定不再使用Ollama,可以通过以下步骤将其完全从系统中移除:
(1)停止并禁用服务:
代码语言:javascript
复制
sudo systemctl stop ollama
sudo systemctl disable ollama
(2)删除服务文件和Ollama二进制文件:
代码语言:javascript
复制
sudo rm /etc/systemd/system/ollama.service
sudo rm $(which ollama)
(3)清理Ollama用户和组:
代码语言:javascript
复制
sudo rm -r /usr/share/ollama
sudo userdel ollama
sudo groupdel ollama
通过以上步骤,不仅能够在Linux平台上成功安装和配置Ollama,还能够灵活地进行更新和卸载。
1.9 Ollama 中运行 Embedding 模型
- 选择 Embedding 模型:
代码语言:javascript
复制
ollama run mofanke/acge_text_embedding
ollama run shaw/dmeta-embedding-zh
ollama run herald/dmeta-embedding-zh
- Ollama 中 Embedding 模型的使用
可以在向量数据库应用中,通过如下方式使用 Ollama 中 Embedding 模型。主要代码如下,主要是 URL 的设置。
代码语言:javascript
复制
ollama_ef = embedding_functions.OllamaEmbeddingFunction(
                url="http://192.2.22.55:11434/api/embeddings",
                model_
)
应用示例代码:
代码语言:javascript
复制
# 不同嵌入模型及函数示例
from chromadb.utils import embedding_functions

#默认使用all-MiniLM-L6-v2,维度为384
default_ef = embedding_functions.DefaultEmbeddingFunction()
embedding1 = default_ef("this is test")

#Ollama 部署的embedding模型
ollama_ef = embedding_functions.OllamaEmbeddingFunction(
                url="http://192.2.22.55:11434/api/embeddings",
                model_
)

embedding2 = ollama_ef("this is test")
#OpenAI
openai_ef = embedding_functions.OpenAIEmbeddingFunction(
                api_key="sk-fastgpt",
                model_
                api_base="http://192.2.22.55:3001/v1"
            )
embedding3 = openai_ef("this is test")
1.10 指定GPU
在Linux上创建如下配置文件,并配置环境变量 CUDA_VISIBLE_DEVICES 来指定运行 Ollama 的 GPU,再重启 Ollama 服务即可
代码语言:javascript
复制
vim /etc/systemd/system/ollama.service
[Service]
Environment="CUDA_VISIBLE_DEVICES=0,1"
2.OpenLLM 部署
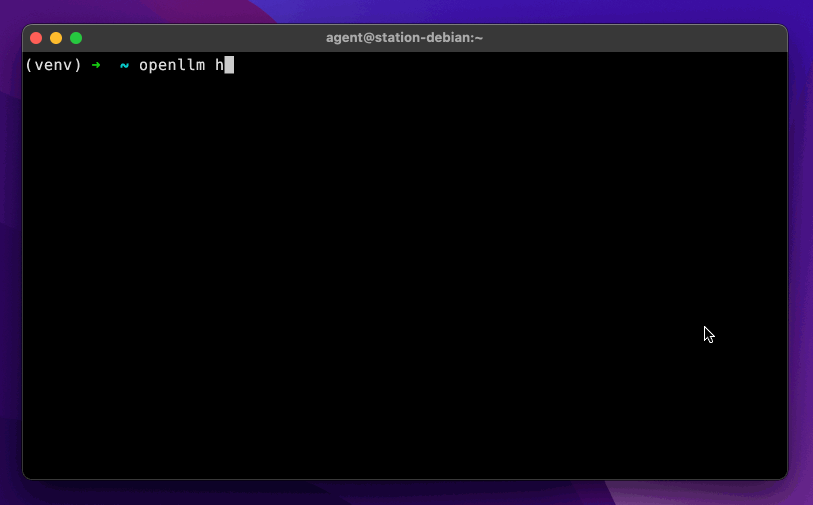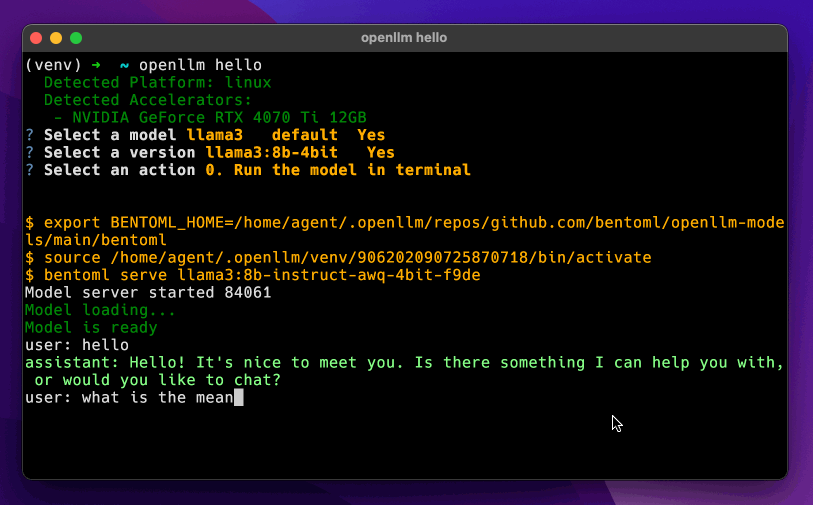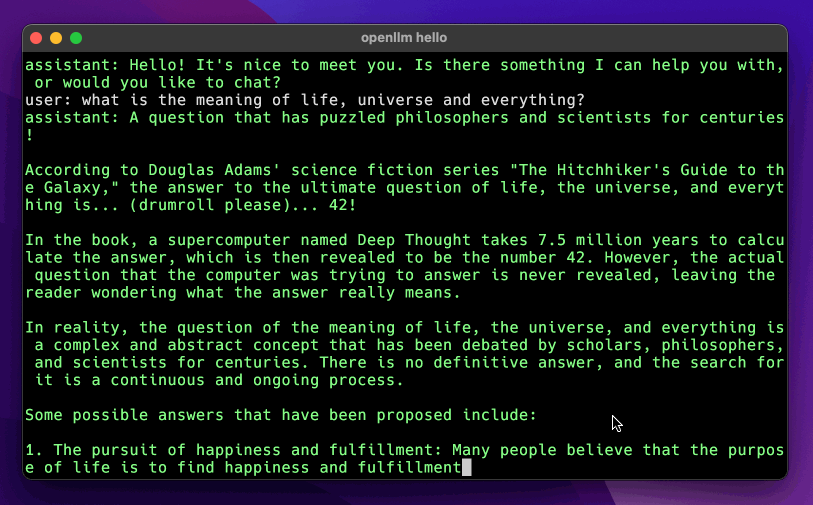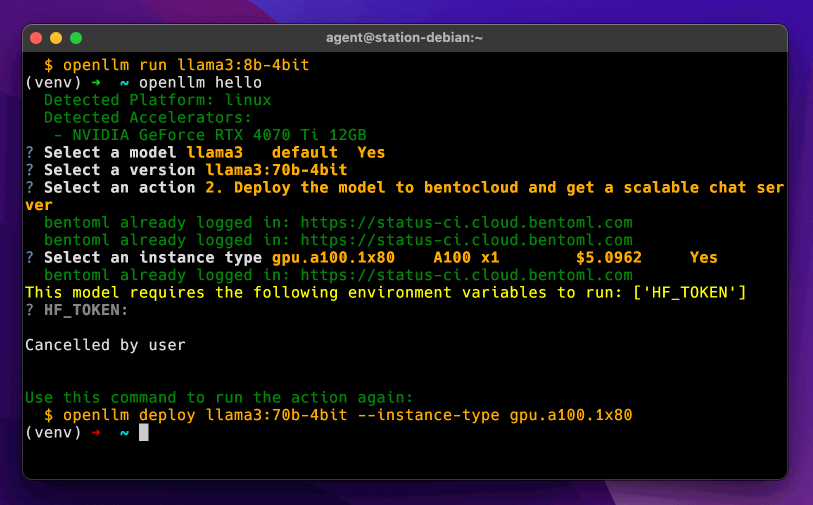
OpenLLM 于 2023 年 6 月开源,是一个用于部署大语言模型的框架。目前,该项目在 GitHub 上已经获得了 9.6K星标。其最初的口号是通过一行代码或相对轻松地在不同的大语言模型之间切换,为个人用户提供方便。OpenLLM是一个用于在生产环境中操作大型语言模型(LLM)的开放平台,它可以轻松地微调、服务、部署和监控任何LLM。
- 安装
代码语言:javascript
复制
pip install openllm  # or pip3 install openllm
openllm hello
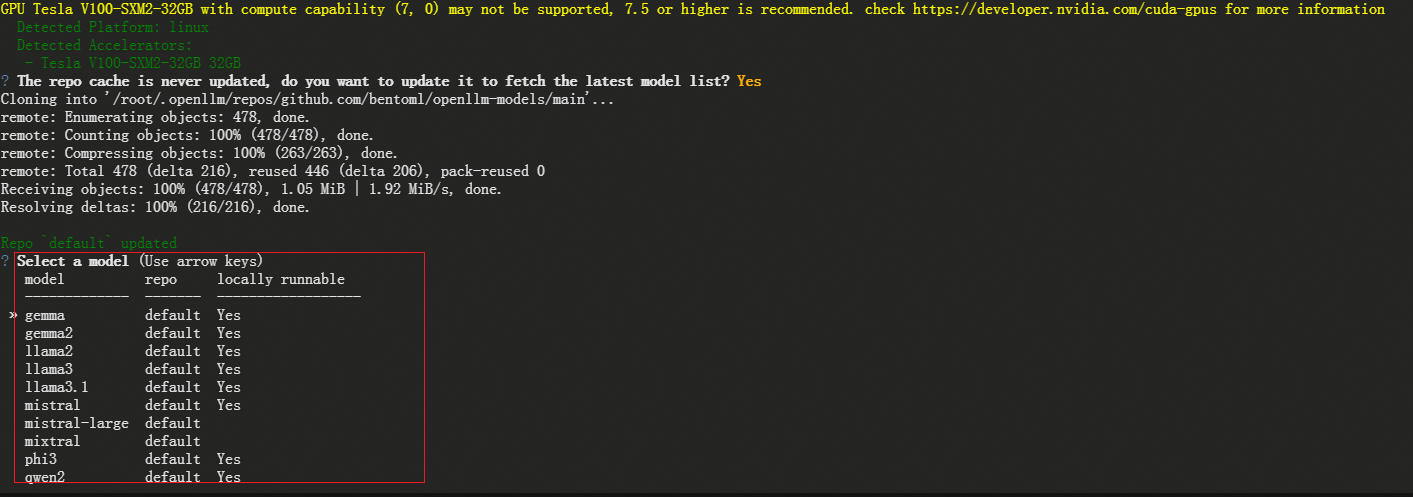
- 支持模型
- Llama-3.1
- Llama-3
- Phi-3
- Mistral
- Gemma-2
- Qwen-2
- Gemma
- Llama-2
- Mixtral
- 在 设置 > 模型供应商 > OpenLLM 中填入:
代码语言:txt
复制
- 模型名称:
代码语言:txt
复制
- 服务器 URL:http://<Machine\_IP>:3333 替换成您的机器 IP 地址 “保存” 后即可在应用中使用该模型。
OpenLLM 提供了一个内置的 Python 客户端,允许您与模型进行交互。在不同的终端窗口或 Jupyter notebook 中,创建一个客户端以开始与模型交互:
代码语言:javascript
复制
import openllm
client = openllm.client.HTTPClient('http://localhost:3000')
client.query('Explain to me the difference between "further" and "farther"')
- 可以使用 openllm query 命令从终端查询模型:
代码语言:javascript
复制
export OPENLLM_ENDPOINT=http://localhost:3000
openllm query 'Explain to me the difference between "further" and "farther"'
使用 openllm models 命令查看 OpenLLM 支持的模型及其变体列表。
3.LocalAI 部署
LocalAI 是一个本地推理框架,提供了 RESTFul API,与 OpenAI API 规范兼容。它允许你在消费级硬件上本地或者在自有服务器上运行 LLM(和其他模型),支持与 ggml 格式兼容的多种模型家族。不需要 GPU。 Dify 支持以本地部署的方式接入 LocalAI 部署的大型语言模型推理和 embedding 能力。
- giuhub:https://github.com/mudler/LocalAI/tree/master
- 官网手册:https://localai.io/docs/getting-started/models/
- 官方快速部署手册案例:https://localai.io/docs/getting-started/models/
- 首先拉取 LocalAI 代码仓库,并进入指定目录
代码语言:javascript
复制
git clone https://github.com/go-skynet/LocalAI
cd LocalAI/examples/langchain-chroma
- 下载demo LLM 和 Embedding 模型(仅供参考)
代码语言:javascript
复制
wget https://huggingface.co/skeskinen/ggml/resolve/main/all-MiniLM-L6-v2/ggml-model-q4_0.bin -O models/bert
wget https://gpt4all.io/models/ggml-gpt4all-j.bin -O models/ggml-gpt4all-j
- 参考文章:告别Hugging Face模型下载难题
- 配置 .env 文件
代码语言:javascript
复制
mv .env.example .env
NOTE:请确保 .env 中的 THREADS 变量值不超过您本机的 CPU 核心数。
- 启动 LocalAI
代码语言:javascript
复制
#start with docker-compose
$docker-compose up -d --build

#tail the logs & wait until the build completes
docker logs -f langchain-chroma-api-1
7:16AM INF Starting LocalAI using 4 threads, with models path: /models
7:16AM INF LocalAI version: v1.24.1 (9cc8d9086580bd2a96f5c96a6b873242879c70bc)

 ┌───────────────────────────────────────────────────┐
 │                   Fiber v2.48.0                   │
 │               http://127.0.0.1:8080               │
 │       (bound on host 0.0.0.0 and port 8080)       │
 │                                                   │
 │ Handlers ............ 55  Processes ........... 1 │
 │ Prefork ....... Disabled  PID ................ 14 │
 └───────────────────────────────────────────────────┘
开放了本机 http://127.0.0.1:8080 作为 LocalAI 请求 API 的端点。
并提供了两个模型,分别为:
- LLM 模型:ggml-gpt4all-j 对外访问名称:gpt-3.5-turbo(该名称可自定义,在 models/gpt-3.5-turbo.yaml 中配置。
- Embedding 模型:all-MiniLM-L6-v2 对外访问名称:text-embedding-ada-002(该名称可自定义,在 models/embeddings.yaml 中配置。
使用 Dify Docker 部署方式的需要注意网络配置,确保 Dify 容器可以访问到localAI 的端点,Dify 容器内部无法访问到 localhost,需要使用宿主机 IP 地址。
- LocalAI API 服务部署完毕,在 Dify 中使用接入模型
在 设置 > 模型供应商 > LocalAI 中填入:
- 模型 1:ggml-gpt4all-j
代码语言:txt
复制
- 模型类型:文本生成
- 模型名称:gpt-3.5-turbo
- 服务器 URL:http://127.0.0.1:8080
- 若 Dify 为 docker 部署,请填入 host 域名:http://your-LocalAI-endpoint-domain:8080,可填写局域网 IP 地址,如:http://192.168.1.100:8080模型 2:all-MiniLM-L6-v2
代码语言:txt
复制
- 模型类型:Embeddings
- 模型名称:text-embedding-ada-002
- 服务器 URL:http://127.0.0.1:8080
- 若 Dify 为 docker 部署,请填入 host 域名:http://your-LocalAI-endpoint-domain:8080,可填写局域网 IP 地址,如:http://192.168.1.100:8080
如需获取 LocalAI 更多信息,请参考:https://github.com/go-skynet/LocalAI
4.配置LLM+Dify(ollama 🔺)
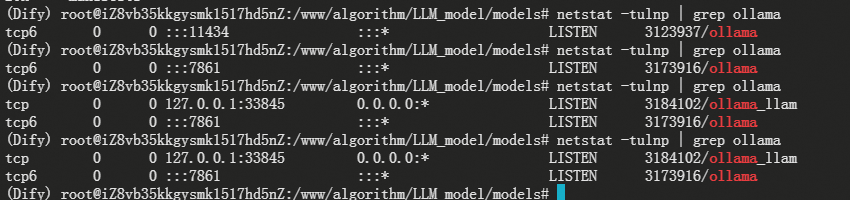
- 确认服务端口状态:
代码语言:javascript
复制
netstat -tulnp | grep ollama
#netstat -tulpn | grep 11434
- 报错: “Error: could not connect to ollama app, is it running?”
/etc/systemd/system/ollama.service文件是:
代码语言:javascript
复制
[Service]
ExecStart=/usr/local/bin/ollama serve
Environment="OLLAMA_HOST=0.0.0.0:7861"
Environment="OLLAMA_KEEP_ALIVE=-1"
- 运行指令
代码语言:javascript
复制
export OLLAMA_HOST=0.0.0.0:7861
ollama list
ollama run llama3.1

#直接添加到环境变量也可以
vim ~/.bashrc
source ~/.bashrc
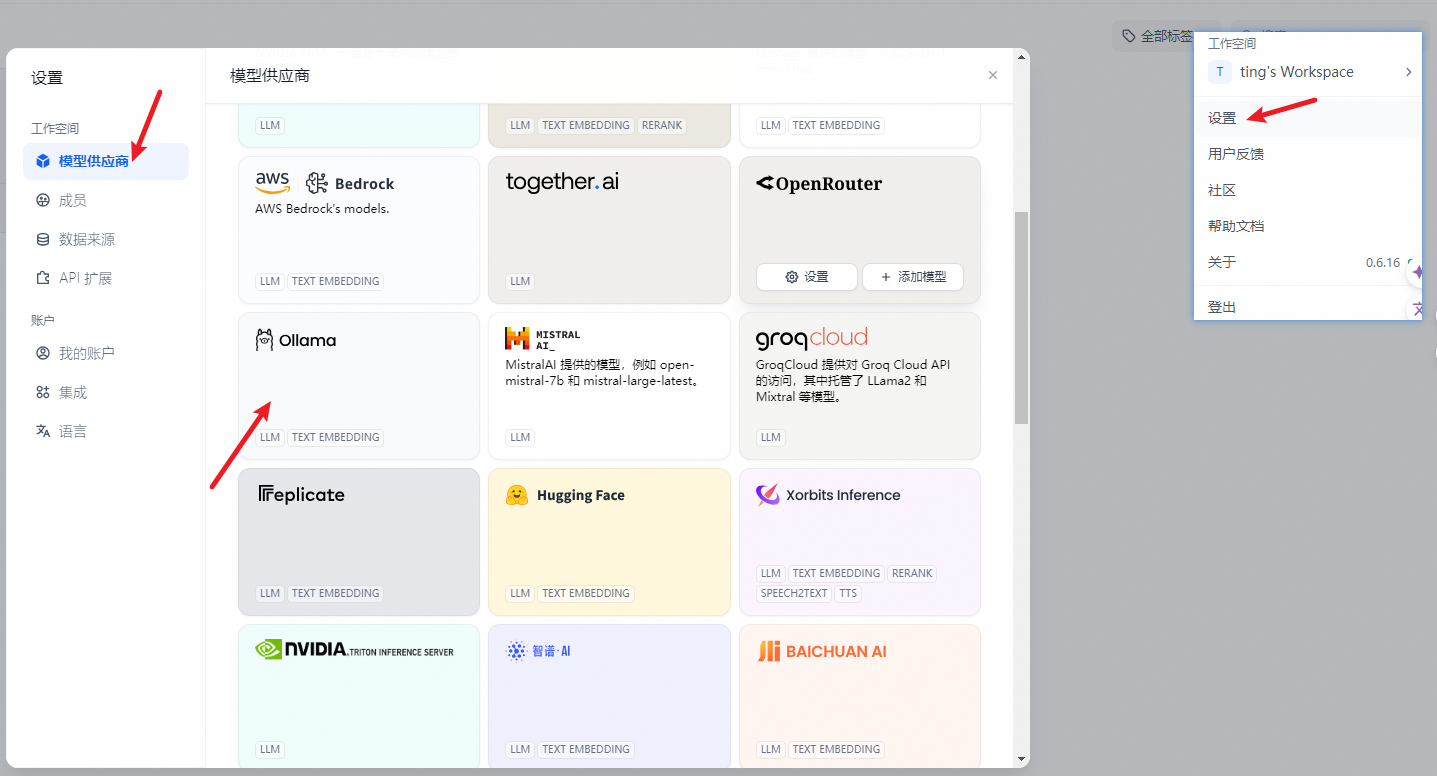
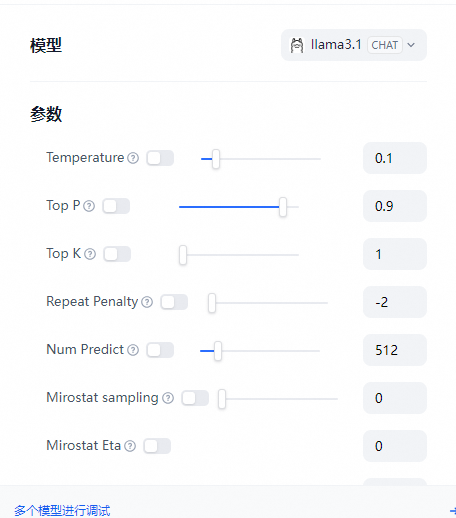
在 设置 > 模型供应商 > Ollama 中填入:
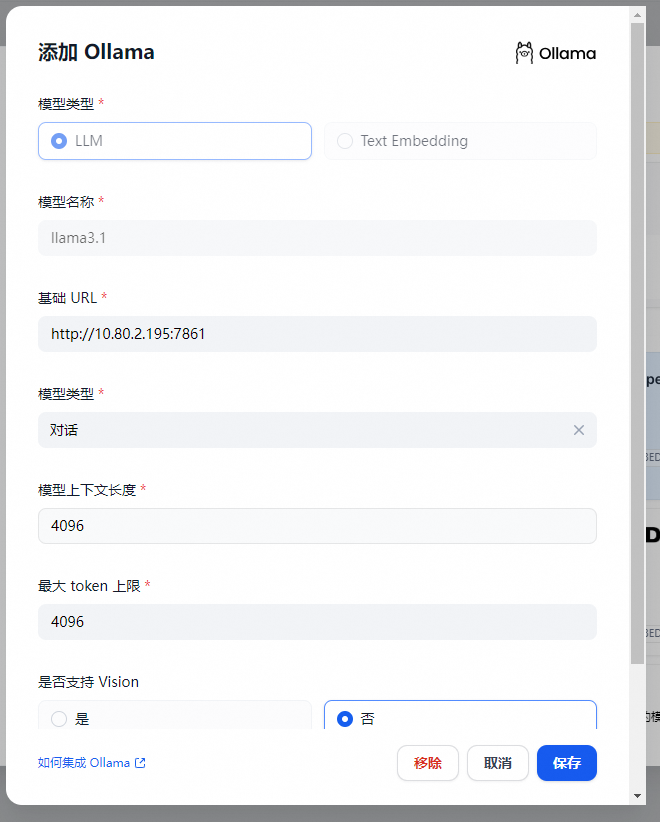
- 模型名称:llama3.1
- 基础 URL:
http://<your-ollama-endpoint-domain>:11434
代码语言:txt
复制
- 此处需填写可访问到的 Ollama 服务地址。
- 若 Dify 为 docker 部署,建议填写局域网 IP 地址,如:`http://10.80.2.195:11434` 或 docker 宿主机 IP 地址,如:`http://172.17.0.1:11434`。
- 若为本地源码部署,可填写 `http://localhost:11434`。模型类型:对话
- 模型上下文长度:4096
代码语言:txt
复制
- 模型的最大上下文长度,若不清楚可填写默认值 4096。最大 token 上限:4096
代码语言:txt
复制
- 模型返回内容的最大 token 数量,若模型无特别说明,则可与模型上下文长度保持一致。是否支持 Vision:是
代码语言:txt
复制
- 当模型支持图片理解(多模态)勾选此项,如 llava。点击 “保存” 校验无误后即可在应用中使用该模型。
- Embedding 模型接入方式与 LLM 类似,只需将模型类型改为 Text Embedding 即可。
- 如果您使用Docker部署Dify和Ollama,您可能会遇到以下错误:
代码语言:javascript
复制
httpconnectionpool(host=127.0.0.1, port=11434): max retries exceeded with url:/cpi/chat (Caused by NewConnectionError('<urllib3.connection.HTTPConnection object at 0x7f8562812c20>: fail to establish a new connection:[Errno 111] Connection refused'))

httpconnectionpool(host=localhost, port=11434): max retries exceeded with url:/cpi/chat (Caused by NewConnectionError('<urllib3.connection.HTTPConnection object at 0x7f8562812c20>: fail to establish a new connection:[Errno 111] Connection refused'))
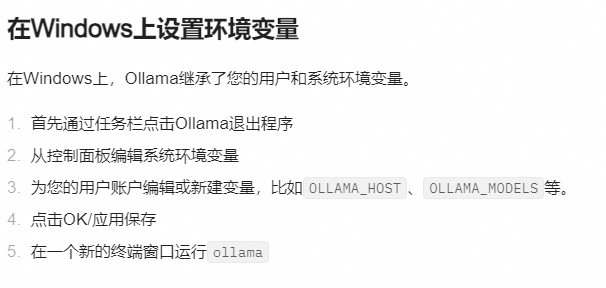
这个错误是因为 Docker 容器无法访问 Ollama 服务。localhost 通常指的是容器本身,而不是主机或其他容器。要解决此问题,您需要将 Ollama 服务暴露给网络。
4.1.多模型对比
参考单个模型部署一样,进行再一次配置添加即可
- 需要注意的是添加完新的模型配置后,需要刷新dify网页,直接网页端刷新就好,新添加的模型就会加载进来
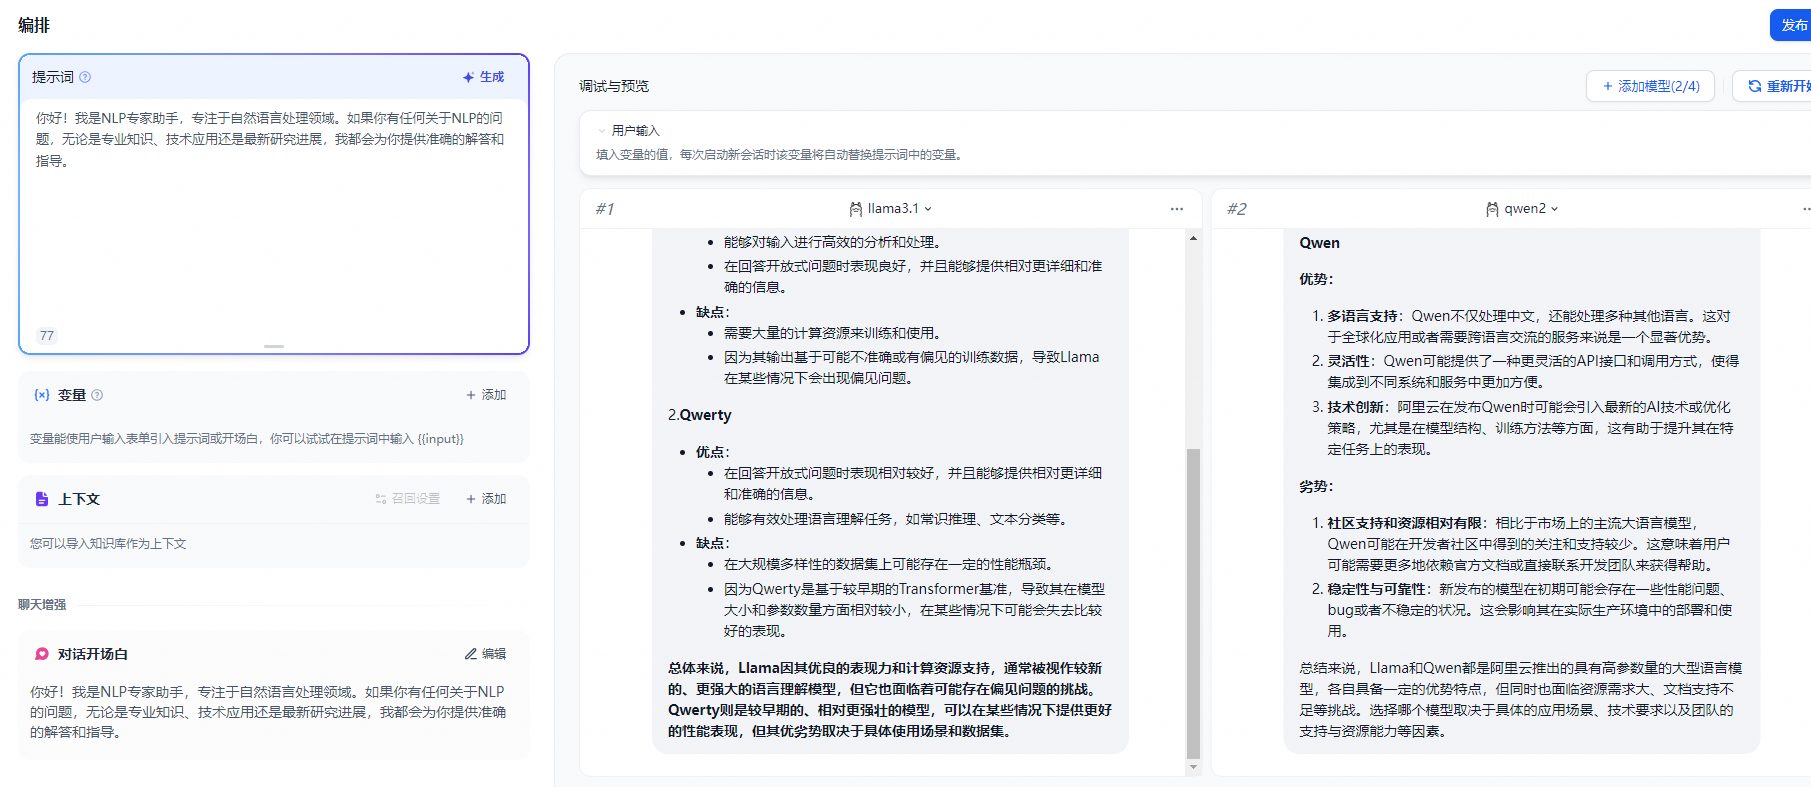
- 可以看到调用后模型资源消耗情况
程序员为什么要学大模型?
大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。
事实上,抢你饭碗的不是AI,而是会利用AI的人。
继科大讯飞、阿里、华为等巨头公司发布AI产品后,很多中小企业也陆续进场!超高年薪,挖掘AI大模型人才! 如今大厂老板们,也更倾向于会AI的人,普通程序员,还有应对的机会吗?
与其焦虑……
不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!
但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高。
针对所有自学遇到困难的同学们,我帮大家系统梳理大模型学习脉络,将这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓
一、LLM大模型经典书籍
AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

二、640套LLM大模型报告合集
这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)

三、LLM大模型系列视频教程

四、LLM大模型开源教程(LLaLA/Meta/chatglm/chatgpt)

LLM大模型学习路线 ↓
阶段1:AI大模型时代的基础理解
-
目标:了解AI大模型的基本概念、发展历程和核心原理。
-
内容:
- L1.1 人工智能简述与大模型起源
- L1.2 大模型与通用人工智能
- L1.3 GPT模型的发展历程
- L1.4 模型工程
- L1.4.1 知识大模型
- L1.4.2 生产大模型
- L1.4.3 模型工程方法论
- L1.4.4 模型工程实践
- L1.5 GPT应用案例
阶段2:AI大模型API应用开发工程
-
目标:掌握AI大模型API的使用和开发,以及相关的编程技能。
-
内容:
- L2.1 API接口
- L2.1.1 OpenAI API接口
- L2.1.2 Python接口接入
- L2.1.3 BOT工具类框架
- L2.1.4 代码示例
- L2.2 Prompt框架
- L2.3 流水线工程
- L2.4 总结与展望
阶段3:AI大模型应用架构实践
-
目标:深入理解AI大模型的应用架构,并能够进行私有化部署。
-
内容:
- L3.1 Agent模型框架
- L3.2 MetaGPT
- L3.3 ChatGLM
- L3.4 LLAMA
- L3.5 其他大模型介绍
阶段4:AI大模型私有化部署
-
目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。
-
内容:
- L4.1 模型私有化部署概述
- L4.2 模型私有化部署的关键技术
- L4.3 模型私有化部署的实施步骤
- L4.4 模型私有化部署的应用场景
这份 LLM大模型资料 包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓
 1万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


