场景图生成网络——RelTR(TPAMI2023)

场景图生成——RelTR训练自己的数据集 最近在做关于视觉关系检测的任务,找文章的过程中发现了一篇使用transformer进行视觉关系检测(场景图生成)的文章——RelTR,于是想用这篇文章的模型来跑一下自己的数据集。因为当前用的数据集不是最终版本的数据集,所以先写个文章记录一下模型使用数据集的格式,方便后面处理数据集,避免大量重复的工作,所以就有了这篇文章。 阅读详情
AI摘要

RelTR是一种创新的场景图生成方法,采用一阶段端到端的集合预测,基于DETR,能直接从视觉外观预测场景图,无需先检测对象。此方法减少了参数,加快了推理速度,实现了高性能。论文在多个数据集上验证了模型的优越性和快速推理能力。

一、ReITR概述

  场景图是一种图结构,其节点代表图像中的实体,边代表实体间的关系。这项技术超越了传统的对象检测,与视觉关系检测紧密相关,对图像检索、图像字幕、视觉问答(VQA)和图像生成等多种视觉-语言任务具有潜在的应用价值。

在这里插入图片描述

  不同于传统的两阶段方法(先检测对象再分类关系),RelTR 采用一种一阶段方法,直接基于视觉外观预测场景图,无需合并实体或标记所有可能的谓词。这种方法基于DETR(Detection Transformer)的启发,将对象检测视为一种端到端的集合预测任务,并提出了一种基于二分匹配的集合预测损失函数。

RelTR 的主要贡献如下:

  • 相比大多数现有方法使用的对象检测骨架分类密集关系,RelTR 能够通过解码视觉外观及从数据中学习的主体和客体查询来生成稀疏场景图。

  • RelTR 仅基于视觉外观生成场景图,具有较少的参数和更快的推理速度,同时达到了最先进的性能。

  • 设计了一种集合预测损失来执行真实三元组和预测三元组之间的匹配,采用基于IoU的分配策略。

  • 通过解耦实体注意力,RelTR 的三元组解码器能够改进主体和客体的定位和分类。

  论文还对在 Visual Genome、Open Images V6 和 VRD 数据集上的实验结果进行了详细讨论,证明了模型的优越性能和快速推理能力。RelTR 的源代码和预训练模型已公开提供,以便研究人员和开发者使用和进一步开发。

二、ReITR安装使用

  1. 安装

  下载 RelTR 仓库:

git clone https://github.com/yrcong/RelTR.git
cd RelTR

  如果您想对一张图片进行推断,只需要 python=3.6, PyTorch=1.6 和 matplotlib!您可以按照以下方式配置环境:

# 创建一个 conda 环境
conda create -n reltr python=3.6
conda activate reltr

# 安装包
conda install pytorch==1.6.0 torchvision==0.7.0 cudatoolkit=10.1 -c pytorch
conda install matplotlib

  如果您想在 Visual Genome 上训练/评估 RelTR,您需要更多的准备:

  a) 需要 Scipy(我们使用的是 1.5.2)和 pycocotools。

conda install scipy
pip install -U 'git+https://github.com/cocodataset/cocoapi.git#subdirectory=PythonAPI'

  b) 按照 data 目录中的 README 准备数据集。

  c) 一些常用的评估代码(IoU)需要编译… 我们将用 Pytorch 代码替换它。

# 编译计算盒交集的代码
cd lib/fpn
sh make.sh

  目录结构如下:

RelTR
| 
│
└───data
│   └───vg
│       │   rel.json
│       │   test.json
│       │   train.json
|       │   val.json
|       │   images
│   └───oi
│       │   rel.json
│       │   test.json
│       │   train.json
|       │   val.json
|       │   images
└───datasets    
... 
  1. 使用方法

推理

  a) 下载我们在 Visual Genome 数据集上预训练的 RelTR 模型,并将其放在

ckpt/checkpoint0149.pth

  b) 使用以下命令推断图片中的关系:

python inference.py --img_path $IMAGE_PATH --resume $MODEL_PATH

  我们附带了 VG 数据集的 5 张图片和 1 张互联网图片。您也可以用您自定义的图片进行测试。结果应该如下所示:
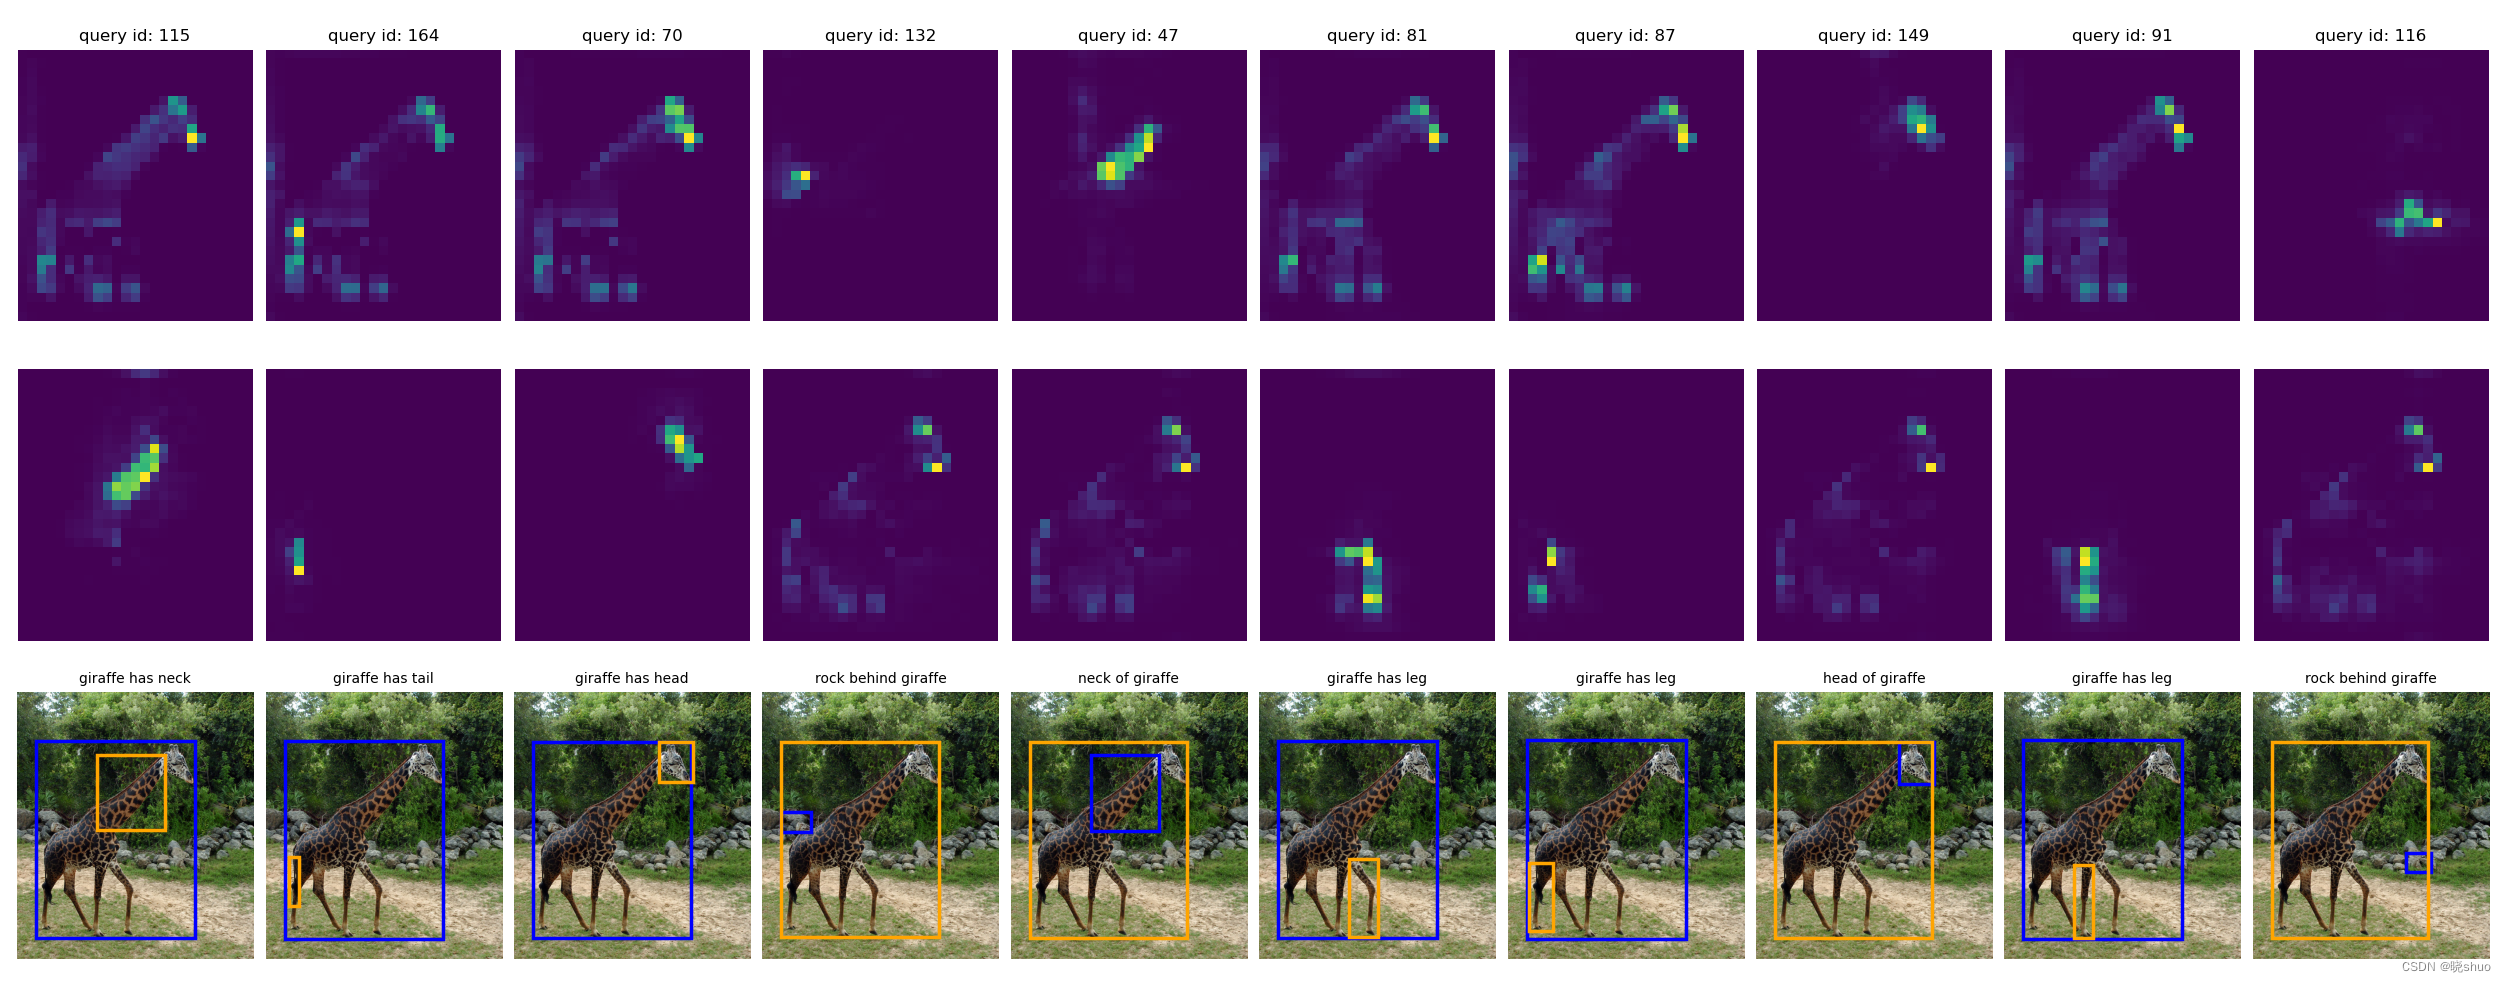
在这里插入图片描述

训练

  a) 在单节点上使用 8 个 GPU 在 Visual Genome 上训练 RelTR(每个 GPU 2 张图片):

python -m torch.distributed.launch --nproc_per_node=8 --use_env main.py --dataset vg --img_folder data/vg/images/ --ann_path data/vg/ --batch_size 2 --output_dir ckpt

  b) 在单节点上使用 8 个 GPU 在 Open Images V6 上训练 RelTR(每个 GPU 2 张图片):

python -m torch.distributed.launch --nproc_per_node=8 --use_env main.py --dataset oi --img_folder data/oi/images/ --ann_path data/oi/ --batch_size 2 --output_dir ckpt

评估

  a) 使用单个 GPU 评估 Visual Genome 上的预训练 RelTR(每个 GPU 1 张图片):

python main.py --dataset vg --img_folder data/vg/images/ --ann_path data/vg/ --eval --batch_size 1 --resume ckpt/checkpoint0149.pth

  b) 使用单个 GPU 评估 Open Images V6 上的预训练 RelTR(每个 GPU 1 张图片):

python main.py --dataset oi --img_folder data/oi/images/ --ann_path data/oi/ --eval --batch_size 1 --resume ckpt/checkpoint0149_oi.pth
场景图生成综述 场景图是对场景的结构化表示,可以清晰地表达场景中的对象、属性和对象之间的关系。随着计算机视觉技术的不断发展,人们不再满足于简单地检测和识别图像中的物体;相反,人们期待对视觉场景有更高层次的理解和推理。例如,给定一张图像,我们不仅要检测和识别图像中的物体,还要了解物体之间的关系(视觉关系检测),并根据图像内容生成文本描述(图像字幕)。或者,我们可能希望机器告诉我们图像中的小女孩在做什么(视觉问答(VQA)),甚至从图像中删除狗并找到类似的图像(图像编辑和检索),等等。 阅读详情

相关推荐

场景图生成(scene graph generation),github/yrcong/RelTR 代码运行

这周为了跑通yrcong/RelTR: RelTR: Relation Transformer for Scene Graph Generation (github.com)配置环境花了好长时间。 从github下载项目,按照网站要求: git clone https://github.com/yrcong/RelTR.git cd RelTR 之后下载anaconda配置新的环境,记住一定要按照网站要求设置python=3.6,我一开始运行python=3.7一直无法成功。下载需要的包。

tt1724369779的博客 2986

RelTR复现记录

在安装pip install -U 'git+https://github.com/cocodataset/cocoapi.git#subdirectory=PythonAPI' 过程中出现note: This error originates from a subprocess, and is likely not a problem with pip.环境配置成功且能成功运行Inference。关于traning还没有跑通先记到这里。

qq_57459857的博客 418

【场景图生成】Unbiased Scene Graph Generation from Biased Training

【场景图生成】Unbiased Scene Graph Generation from Biased Training

weixin_44574941的博客 2349

哈工大SCIR | 场景图生成简述

原创作者:梁家锋 郑子豪 王禹鑫 孙一恒 刘铭出处:哈工大SCIR进NLP群—>加入NLP交流群1引言 场景图是一种结构表示,它将图片中的对象表示为节点,并将它们的关系表示为边。最近,场景图已成功应用于不同的视觉任务,例如图像检索[3]、目标检测、语义分割、图像合成[4]和高级视觉-语言任务(如图像字幕[1]或视觉问答[2]等)。它是一种具有丰富信息量的整体场景理解方法,可以连...

zenRRan的博客 6139

2023 | RetNet:全新大模型基础架构,Transformer的继任者

文章引入了一种创新的网络结构,即RetNet。相对于传统的Transformer架构和多种变体,RetNet架构的优势是同时具备三个特点:训练可并行、推理成本低、具备良好的性能。

weixin_45378275的博客 2193

RetNet 深度解析:Transformer 的终极进化形态——并行训练闪电速度+循环推理零内存增长的革命

RetNet (Retentive Network) 是微软2023年提出的​​下一代序列建模架构​​,完美继承Transformer优势的同时,实现​​训练时并行加速+推理时内存零增长​​。其核心是​​"保留机制(Retention)"​​:像人类记忆一样动态保留关键信息,丢弃冗余内容。RetNet 通过​​双模保留机制+分块优化​​​效率革命​​:训练速度提升近2倍,推理内存降低90%​​模式灵活​​:同一模型无缝切换并行/循环推理​​部署友好​​:首次让LLM在手机端实时运行成为可能​。

qq_43664407的博客 2158

RelTR模型论文解读,并基于MindSpore NLP推理复现

RelTR是一种基于Transformer架构的单阶段端到端场景图生成方法,通过引入固定数量的主语/宾语查询和多种注意力机制(CSA、DVA、DEA),直接预测关系三元组。相比传统两阶段方法,RelTR具有参数少、计算复杂度低(O(n))的优势。其创新点包括:1)稀疏三元组预测机制;2)基于IoU的集合预测损失函数;3)利用实体解码结果优化主客体定位。实验在Visual Genome数据集上验证了有效性,MindSpore实现版本已开源。迁移过程中发现了参数加载和计算精度问题,通过在启智平台运行解决了推理异

Kenji_Shinji的博客 742

图神经网络实战(16)——经典图生成算法

图生成算法是指用于创建模拟图或网络结构的算法,这些算法可以根据特定的规则和概率分布生成具有特定属性的图,用于模拟各种复杂系统,如社交网络、生物网络、交通网络等。传统图生成技术已有数十年历史,并可用作各种应用的基准,但这些技术在生成的图类型上存在限制。这些方法大多数都专注于输出特定的拓扑结构,因此不能简单地模仿给定网络。在本节中,我们将介绍两种经典图生成技术:Erdős–Rényi 模型和小世界 (small-world) 模型。

盼小辉丶的博客 1万+

2023Retnet论文解读

简介 微软亚洲研究院上线了大模型新架构的论文“Retentive Network: A Successor to Transformer for Large Language Models”,该基础架构采用了新的 Retention 机制来代替 Attention,向 Transformer 发起挑战!相对于 Transformer 架构的优势是同时具备:训练可并行、推理成本低和良好的性能,不可能三角。 论文中给出一个很形象的示意图,RetNet 在正中间表示同时具备三个优点,而其他的架构 Linear

Zob_z的博客 3674

NeRF必读:Mip-NeRF总结与公式推导

由于远景近景的分辨率不同,导致经典NeRF对于多尺度场景的表达存在明显瑕疵:NeRF对于近景的重建比较模糊而对于远景的重建出现锯齿。简单粗暴的策略是supersampling,但是费时费力。相较于NeRF使用的位置编码(PE)方式,Mip-NeRF提出了积分位置编码的方式(IPE).这种编码方式可以多尺度地描述空间中的信息分布,make sense.

i_head_no_back的博客 6079

【AUCell打分】:评估一个基因集在单细胞转录组的每个细胞中特定的活性程度

AUCell使用曲线下面积来计算输入基因集的一个有意义的基因子集是否在每个细胞的表达基因中富集。AUC 分数在所有细胞中的分布允许探索特征的相对表达。由于评分方法是基于排名的,因此 AUCell 与基因表达单位和归一化程序无关。此外,由于细胞是单独评估的,因此可以很容易地应用于更大的数据集。

weixin_40695088的博客 1万+

​下一代Transformer:RetNet结构可视化及Vision RetNet展望

©PaperWeekly 原创 ·作者 |岳廷微软和清华大学的研究人员在论文《Retentive Network: A Successor to Transformer for Large Language Models》中提出了一种新的模型架构 RetNet,同时实现 Transformer 模型的高效并行训练、低延迟高吞吐量的推理以及良好的建模性能,被誉为“打破不可能三角形”。论文链接:h...

Paper weekly 2893

eMMC数据擦除的方式

接下来主要是讲解erase、trim、discard的差异,涉及的command有CMD35、CMD36、CMD38。一般用来擦除整卡或者某些分区,如果只想擦除一个。以下是device status的部分解释。eMMC的数据擦除方式有6种,分别是。将会跳过写保护,只执行其他的范围。Discard的命令序列是。Erase的命令序列是。的范围有包含写保护,Trim的命令序列是。

DPJimmy的博客 1772

一文理解RetNet

作者:梁德澎 | 来源:GiantPandaCV前言微软研究院最近提出了一个新的 LLM 自回归基础架构 Retentive Networks (RetNet)[1,4],该架构相对于 Transformer 架构的优势是同时具备:训练可并行、推理成本低和良好的性能,不可能三角。论文中给出一个很形象的示意图,RetNet 在正中间表示同时具备三个优点,而其他的架构 Linear Transfor...

3D视觉工坊 1163

UNITE真菌数据库使用避坑指南:从下载到注释的完整流程

本文提供了UNITE真菌数据库从下载到注释的完整实战指南。针对真菌ITS序列分析,重点解析了数据库版本选择、格式转换的常见陷阱,并详细介绍了如何训练优化的sklearn分类器以提升物种注释的精度和可靠性,帮助用户构建高效稳定的本地工作流。

weixin_29240343的博客 199

YOLOv5改进 | 低照度检测 | 2024最新改进CPA-Enhancer链式思考网络(适用低照度、图像去雾、雨天、雪天)

本文给大家带来的2024.3月份最新改进机制,由CPA-Enhancer: Chain-of-Thought Prompted Adaptive Enhancer for Object Detection under Unknown Degradations论文提出的CPA-Enhancer链式思考网络CPA-Enhancer通过引入链式思考提示机制,实现了对未知退化条件下图像的自适应增强。该方法的核心在于能够利用CoT提示对图像退化进行动态分析和适应,从而显著提升物体检测性能。

Snu77的博客 2222

图神经网络的分类

图卷积神经网络 GCN、GraphSage都属于图卷积神经网络,都是利用节点与节点周围的邻居信息不断的聚合,以学习到节点的高层表示。 PATCH-SAN:因为GCN和GraphSage聚合邻居信息时具有排列不变性,而PATCH-SAN是真正利用卷积操作,去完成节点的深层次的学习。 Graph Attention NetWork GAT利用节点之间的attention,求出节点与周围邻居节点的attention系数,然后通过聚合邻居节点得到下一层的特征表示。 Graph Auto-encoder 输入一张

vincent_duan的专栏 6684

C#对接EtherNet/IP协议 完整版|罗克韦尔AB PLC通信+CIP核心概念全解析

你做罗克韦尔(AB) PLC工业上位机开发,是唯一的首选协议,没有之一!EtherNet/IP(Ethernet Industrial Protocol)是基于标准以太网的工业级通信协议,由罗克韦尔自动化主导开发,是ODVA(开放设备网络供应商协会)主推的工业以太网标准,也是目前全球应用最广泛的工业以太网协议之一。原生适配罗克韦尔AB PLC:Micro800、CompactLogix、ControlLogix、Micro850等全系AB PLC原生标配EtherNet/IP,无需额外配置,开箱即用;

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 892

AI绘画Stable Diffusion 生成模特产品场景图,AI赋能电商真的太酷了!

大家好,我是画画的小强,今天教大家怎么用AI绘画工具 Stable Diffusion 制作 AI虚拟模特产品海报图。话不多说,先看下效果,还不错吧?!

A1353192296的博客 2064

YOLOv11涨点改进| SCI一区2026 |独家创新首发、特征融合改进篇|引入FAFM特征对齐融合模块,通过特征对齐和融合两个阶段,助力多模态融合小目标检测,小目标检测,SAR图像目标检测高效涨点

🔥本文提出了一种改进YOLOv11网络模型的方法,通过引入FAFM(特征对齐融合模块)来解决多模态目标检测中的特征空间错位问题。FAFM模块采用可变形卷积和内容引导注意力机制,有效实现了跨模态特征对齐与融合,充分利用了不同模态间的互补信息。该方法在保持模型轻量化的同时,显著提升了目标检测精度和鲁棒性,特别是在复杂背景和模态差异较大的场景下表现突出。文章详细介绍了FAFM模块的结构、原理、优势,并提供了完整的代码实现和模型配置方案,为多模态目标检测任务提供了实用的技术参考。

Ai缝合怪、助力小伙伴高效发论文 268

【Docker】一招解决超时镜像超时报错:`ERROR: Get https://registry-1.docker.io/v2/`

Docker 镜像拉取超时或失败并不是 Docker 本身的缺陷,而是网络环境和默认配置在特定场景下的限制所导致的结果。通过本文的分析可以看到,问题的核心往往集中在三个方面:网络访问延迟、DNS 解析速度以及客户端默认超时时间。针对这些问题,最直接、有效的做法是使用国内镜像加速器,这不仅能够显著提升拉取速度,还能保证在企业内网或家庭网络中更加稳定

博客 1027

总结:图像生成网络

那么简笔画猫转成真猫到底是一个什么原理腻,可以这样理解:你可以获取很多真猫的图片,用opencv的边缘提取,把每一张图片的边缘都给提取出来,构建一个像素到像素的映射数据集,也就是数据集包含两类图片,一类是边缘轮廓简笔画,另一类是真猫的图片,它们俩是一一对应的关系,所以pix2pix解决的是一个像素配对的图像转译问题,那么我们上次介绍的cyclegan呢解决的是一个非配对的图像转译问题。我们的目的是,既要让输出的图片真实,也要让输出的图片符合条件c的描述。下面右图是侧面的火车,它们也统统都是正确的火车。

qimo601的专栏 1664

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

AI与艺术——图像生成网络经典算法

生成模型是一种训练模型进行无监督学习的模型,即,给模型一组数据,希望从数据中学习到信息后的模型能够生成一组和训练集尽可能相近的数据。图像生成(Image generation,IG)则是指从现有数据集生成新的图像的任务。图像生成模型包括无条件生成和条件性生成两类,其中,无条件生成是指从数据集中无条件地生成样本,即p(y);条件性图像生成是指根据标签有条件地从数据集中生成样本,即p(y|x)。

知来者逆的博客 8185

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

【GNN综述2】 2019 A Comprehensive Survey on Graph Neural Networks

转载苏一 本篇文章知乎大佬对论文“Wu, Zonghan , et al. "A Comprehensive Survey on Graph Neural Networks." (2019).“”后的翻译与笔记,本文章主要是将图神经网络分成了五大类(图卷积网络图注意力网络图时空网络图生成网络图自编码器),并讲述了一些应用。 目录 一、什么是图神经网络? 二、有哪些图神经网络? ...

图挖掘领域,新晋砖家 ☞ 未来可期,欢迎和静静一起学习交流吖 2849

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

AI绘图的场景应用:文生图、图生图

AIGC技术的未来发展前景广阔,随着人工智能技术的不断发展,AIGC技术也将不断提高。未来,AIGC技术将在游戏和计算领域得到更广泛的应用,使游戏和计算系统具有更高效、更智能、更灵活的特性。同时,AIGC技术也将与人工智能技术紧密结合,在更多的领域得到广泛应用,对程序员来说影响至关重要。未来,AIGC技术将继续得到提高,同时也将与人工智能技术紧密结合,在更多的领域得到广泛应用。感兴趣的小伙伴,赠送全套AIGC学习资料和安装工具,包含AI绘画、AI人工智能等前沿科技教程,模型插件,具体看下方。

qq_41314882的博客 7654

GiantPandaCV | 一文理解RetNet(内含公式详解!)

微软研究院最近提出了一个新的 LLM 自回归基础架构 Retentive Networks (RetNet)[1,4],该架构相对于 Transformer 架构的优势是同时具备:训练可并行、推理成本低和良好的性能,不可能三角。论文中给出一个很形象的示意图,RetNet 在正中间表示同时具备三个优点,而其他的架构 Linear Transformer、Recurrent Network 和 Transformer 都只能同时具备其中两个。接下来看一下论文的细节。

csdn_xmj的博客 2801
上一篇: LLM的物理推理与规划方法E2WM
下一篇: CLIP计算图片与文本相似度(多幅图片与一个文本)
晓shuo
晓shuo 优质创作者: 人工智能技术领域 优质创作者: 人工智能技术领域
博客等级 码龄6年 4万+粉丝 113原创
评论 2
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包

打赏作者

晓shuo

你的鼓励将是我创作的最大动力

¥1 ¥2 ¥4 ¥6 ¥10 ¥20
扫码支付:¥1
获取中
扫码支付

您的余额不足,请更换扫码支付或充值

打赏作者

实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值