基于自注意力机制LSTM的虚假新闻检测

(一篇Blog证明还在地球)论文精读:基于CLIP引导学习的多模态虚假新闻检测 对于多模态 FND,我们重点关注同时包含文本和图像的样本。设每个样本为XXTxtXImagXXTxt​XImag​。将真实标签表示为yyy。当y0y=0y0时,xxx为真新闻,否则为假新闻。首先从$ x_{Txt}$ 和xImgx_{Img}xImg​中提取丰富的特征集。然后将这些特征融合并投影为y\hat{y}y​​的单个值,即real或者fake。该过程如(1)所示,其中FTxtF_{Txt}FTxt。 阅读详情

摘要

本文介绍了一种创新的虚假新闻检测模型,该模型集成了长短期记忆网络(LSTM)与自注意力机制。鉴于信息传播速度不断加快,虚假新闻的广泛传播已对社会造成了诸多负面影响,尤其在疫情期间。因此开发高效的虚假新闻检测技术显得尤为关键。传统文本分类方法在处理新闻内容时存在一定的局限性,而本研究提出的模型通过结合LSTM的序列建模能力和自注意力机制的特征聚焦优势,旨在提升对新闻文本语义信息的理解及特征提取效能。本文的数据集来源多样,涵盖了疫情期间从多个平台收集的新闻数据、澎湃新闻网的真实新闻数据、从中国互联网平台爬取的辟谣新闻数据以及微信公众号发布的谣言数据。数据整合后,构建基于自注意力机制的LSTM模型(DoubleCheck),用于虚假新闻的分类与预测。为保证模型具备一定的通用性和鲁棒性,实验开始前,通过计算新闻样本之间的余弦相似度来去除冗余数据。实验结果显示,该模型在多个评估指标上表现出色,特别是在准确性、召回率及F1分数方面均有显著提高。这一结果不仅验证了自注意力机制结合LSTM架构在识别虚假信息方面的有效性,同时也为未来相关研究开辟了新路径,有助于更好地应对日益复杂的虚假新闻传播挑战,从而维护信息安全与社会稳定。

关键词:数据爬取,虚假新闻检测,DoubleCheck,自注意力机制,LSTM,信息安全。


研究意义

谣言会对人们的行为和态度产生重大影响,尤其是在社交媒体时代,虚假新闻可以迅速传播并误导公众舆论。疫情期间,COVID-19 大流行只会加剧这一问题,如下表所示,“吸烟可以预防非典,因为烟油可以阻挡病毒进入肺细胞”、“喝高度白酒、蒸桑拿,可以抵抗新型冠状病毒”等谣言新闻标题,很容易造成群众的认知误导,因此,识别并应对社交媒体平台上的谣言已成为一个亟待解决的重要问题。在本文中,我们重点关注跨多个社交媒体平台的数据分析,以确保所构建模型的鲁棒性和有效性。
新闻来源新闻标题
COVID-19-rumors吸烟可以预防非典,因为烟油可以阻挡病毒进入肺细胞
COVID-19-rumors喝高度白酒、蒸桑拿,可以抵抗新型冠状病毒
微信公众号安踏,你代表不了中国体育精神风貌

数据获取

爬虫

在数据集准备期间,首先考虑到的数据获取方法是爬取网页的新闻数据,在本文中,爬取了中国互联网联合辟谣平台的联动要闻数据和部分微信公众号谣言发文。

中国互联网联合辟谣平台

通过遍历联动要闻下新闻标题对应的url进入对应新闻的正文信息页面,在遍历过程中需要进行动态翻页,保证数据爬取的完整性,进入正文信息页后,逐段爬取新闻的正文内容,最后整合为中国互联网新闻文件(见附件)。由于平台本身的辟谣属性,标记列全部设置为“真”。
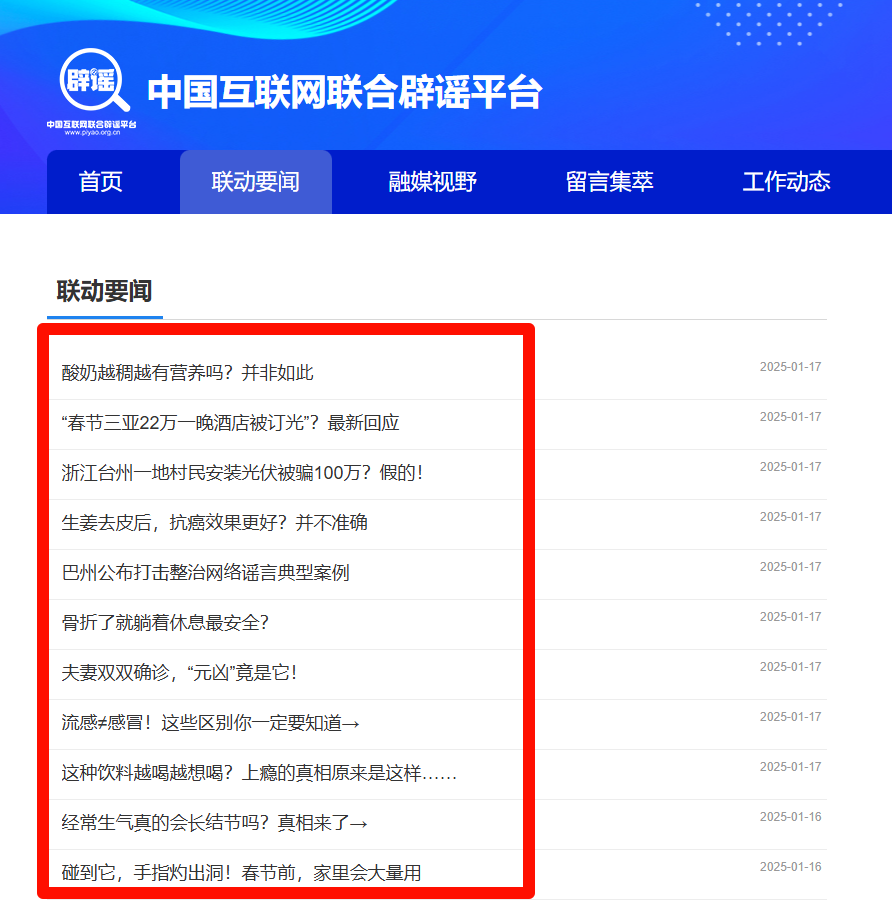
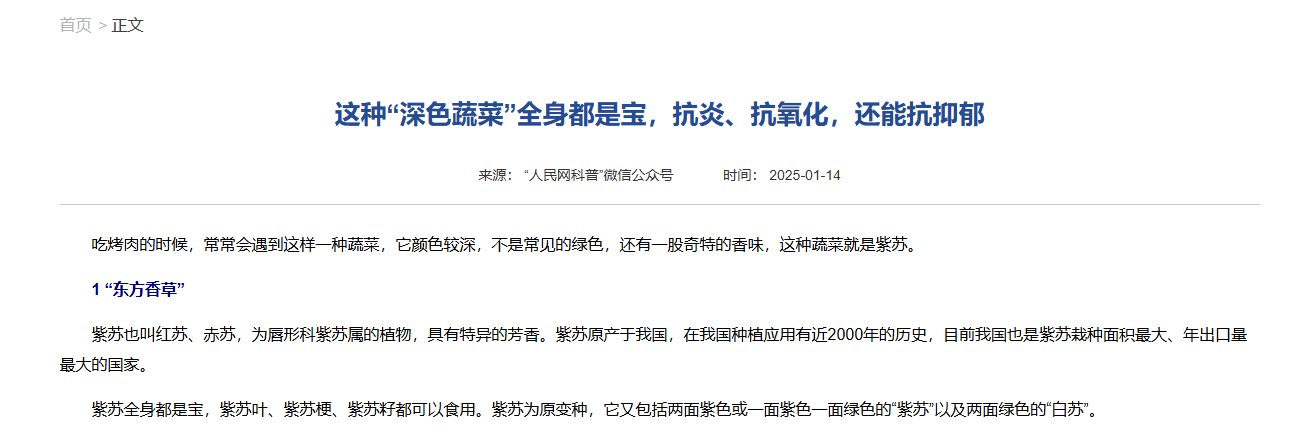
图1 新闻标题列表

图2 新闻正文

微信公众号谣言发文

对微信公众号中涉及谣言的文章URL进行了全面遍历,并对这些文章的正文内容进行了爬取,以收集相关谣言文章的具体信息。值得注意的是,由于部分文章因被平台识别为谣言而遭到处理,或是由原作者自行删除,导致部分URL已失效,无法成功获取其正文内容。经过筛选与验证后,最终成功收集到超过2000篇可访问的公众号文章正文(见附件)。
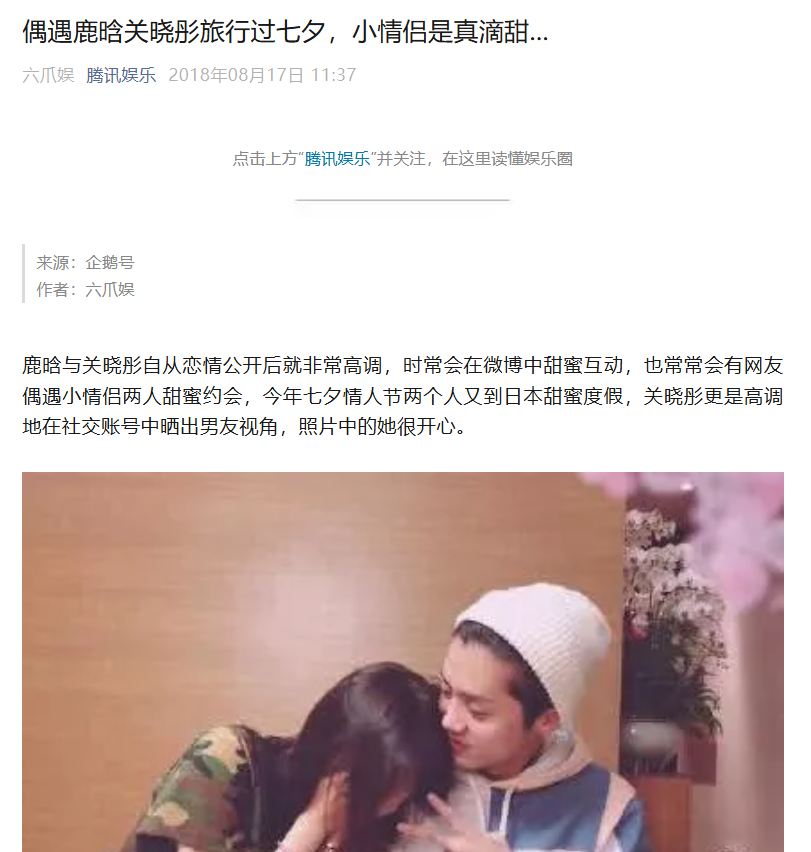
图3 微信公众号发文

开放数据集

除了通过网络爬虫获取新闻数据之外,另一种可行的数据获取方法是从开放数据平台上直接下载由用户或机构发布的数据集。常见的开放数据平台包括优快云、Kaggle 和 GitHub 等。本文从 GitHub 平台上收集了与 COVID-19 相关的谣言新闻数据,并从澎湃新闻网站获取了真实新闻数据(见附件)。这些数据来源的多样化有助于增加数据样本的数量和多样性,从而提升模型预测结果的普适性和准确性。

将收集到的数据整合至单一文件中,并设定一套标准化的规则,确保文件仅包含以下关键信息:新闻来源、标题、内容、发布时间及验证标识。具体而言,若某条新闻被标记为0,则表示该新闻被判定为虚假信息;反之,若其标识为1,则意味着该新闻被认为是真实可信的。

For example:


sourcetitlecontentlabeltime
COVID-19-rumors吸烟可以预防非典,因为烟油可以阻挡病毒进入肺细胞网上流传的“烟油保护层”的理论称:烟油可以覆盖在肺细胞表面,相当于一个紧密的防护层;病毒进了…02020-01-21

最终整理得到数据共11480条,其中假新闻占比为22.5%,长度大于100的新闻占比为96.8%。

# 加载数据
data = pd.read_excel(r'D:\\大数据应用实践\\news\\news_data_all.xlsx')
# 数据验证
print(f'数据集大小: {data.shape}')
print(f'数据集列名: {data.columns}')
print(f'假新闻占比: {data[data["label"] == 0].shape[0] / data.shape[0]}')
print(f'长度大于100的新闻占比: {data[data["content"].str.len() > 100].shape[0] / data.shape[0]}')

运行结果:

数据集大小: (11480, 5)
数据集列名: Index(['source', 'title', 'content', 'label', 'time'], dtype='object')
假新闻占比: 0.22534843205574914
长度大于100的新闻占比: 0.9680313588850175

数据预处理

短文本剔除

针对已整理的新闻数据,对篇幅较短的新闻进行筛除。此举旨在防止在后续处理中,当输入固定长度的索引序列时,出现某些序列包含大量零值填充的情况,从而可能对模型的学习性能产生不利影响。
# 数据预处理-1 删除长度小于100的新闻
data = data[data['content'].str.len() > 100]

谣言标志样本剔除

针对已经整理的新闻数据,发现某些新闻在其标题或正文中包含显著的谣言特征,则应将此类新闻明确标记为谣言,并予以排除。这是因为,在经过分词处理及注意力机制计算后,这些谣言特征往往会被赋予过高的重要性权重。为了避免这些异常值对模型训练产生不利影响,确保分词结果中词汇的重要性分布更加接近理想的高斯分布,在预处理阶段即移除上述含有明显谣言标志的新闻数据。

谣言标志

近期有谣言称、据不实消息称、网传、有消息称、流传、谣言


余弦相似度去重

余弦相似度

cos⁡(A,B)=A⋅B∥A∥⋅∥B∥\cos(A,B) = \frac{A \cdot B}{\|A\| \cdot \|B\|}cos(A,B)=∥A∥⋅∥B∥A⋅B​

余弦相似度是一种常用的衡量两个向量在空间中方向相似度的指标,通常用于文本分析、信息检索和推荐系统中,特别是在处理文本数据时。其核心思想是计算两个向量之间夹角的余弦值,夹角越小,余弦值越接近 1,表示它们的方向越相似;夹角越大,余弦值越接近 -1 ,表示它们的方向越不相似。 对于两个余弦相似度过高的新闻样本,考虑去除重复的新闻样本以保证新闻数据样本的质量。

文本分词与向量化

在对每个新闻样本进行两两余弦相似度计算之前,需首先对其标题与内容进行文本分词处理,以生成适用于后续词向量化模型的输入数据。本文采用jieba库执行中文分词任务,该库在中文自然语言处理领域内广受认可,其功能在于将连续的汉字序列精准地切分为独立词汇,从而促进后续分析流程的有效开展。

在文本分词后,使用TF-IDF将新闻向量化,两两计算新闻之间的余弦相似度,并对余弦相似度过高的重复新闻进行标记,被标记为重复新闻的新闻将被剔除。本文选定的相似度剔除标准为余弦相似度超过0.8即认为该新闻与过去的新闻重复。

词云图

完成数据预处理后检查分词后的新闻内容词云,词云图是一种通过视觉化的方式展示文本数据中词语频率的图形。每个词语的大小与其在文本中出现的频率成正比,频率较高的词语显示得较大,而频率较低的词语则较小。词云图通过这种方式使得文本数据的关键信息更加直观。
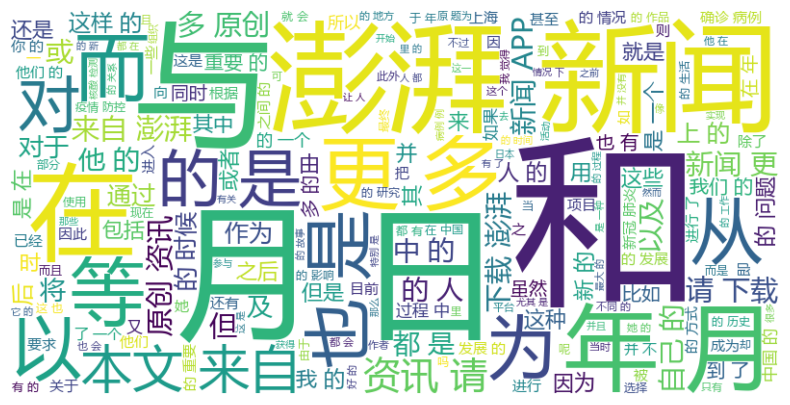
图4 内容词云图

深度学习模型

LSTM

LSTM是一种特殊的循环神经网络,用于处理和预测序列数据中的长期依赖关系。与传统的RNN相比,LSTM能够有效地解决传统RNN在训练中遇到的梯度消失和梯度爆炸问题,因此在处理长序列数据时表现更好。

LSTM通过门控机制来控制信息的流动,这使得它能够“记住”序列中的长远信息,同时避免丢失或过早忘记不重要的信息。LSTM有三个主要的门:输入门、遗忘门、和输出门。
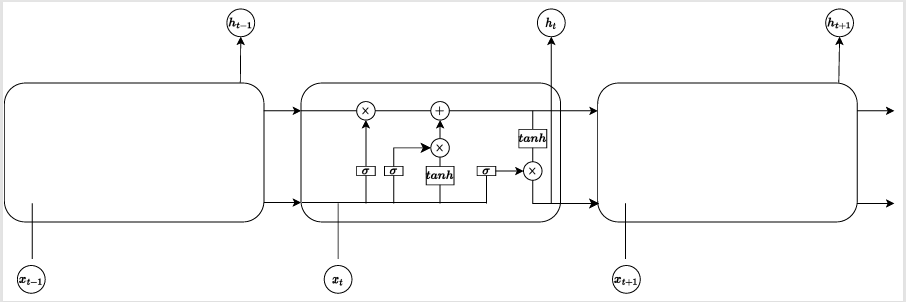
图5 LSTM工作流程

自注意力机制

自注意力机制,也称为内部注意力机制,是一种将单个序列的不同位置关联起来以计算同一序列的表示的注意力机制。它允许模型在处理序列数据时,通过计算序列中不同位置元素之间的相关性得分,动态地调整对每个元素的关注程度,从而捕捉序列内部的复杂依赖关系。

自注意力机制的核心在于,它不依赖于外部信息,而是在序列内部元素之间进行信息的交互和整合。具体来说,对于序列中的每个元素,自注意力机制会计算该元素与序列中所有其他元素的相关性,生成一个加权的表示,其中权重反映了元素间的相互关系。

自注意力机制能够使模型更好地理解序列中的上下文信息,从而更准确地处理序列数据。例如在语言模型中,它可以考虑到序列中每个词与其他所有词的关系,从而理解词与词之间的语义关联度。


工作原理:

给定一个输入序列X=[x1,x2,...,xn]X = [x_1, x_2, ..., x_n]X=[x1​,x2​,...,xn​],每个输入向量xix_ixi​会生成三个向量:

  • Query:表示当前元素的查询向量。
  • Key:表示当前元素的键向量。
  • Value:表示当前元素的值向量。

自注意力机制的目标是通过对输入序列的每个元素计算和其他元素的关系来更新每个元素的表示。计算步骤如下:

计算注意力权重: 计算 Query 和 Key 的点积来衡量不同位置之间的相似性:

Attention Scores=Q⋅KT \text{Attention Scores} = Q \cdot K^T Attention Scores=Q⋅KT

结果会通过一个 softmax 函数进行归一化,得到每个位置之间的注意力权重。

加权和: 使用得到的注意力权重来对 Value 进行加权求和:

Output=softmax(Q⋅KT)⋅V \text{Output} = \text{softmax}(Q \cdot K^T) \cdot V Output=softmax(Q⋅KT)⋅V


DoubleCheck

DoubleCheck模型旨在识别长文本中的虚假信息,尤其适用于中文文本的处理。该模型的关键创新点在于采用了双层长短期记忆网络(LSTM)结构以及一种基于自注意力机制的输入重加权,这些设计共同增强了模型对于虚假新闻内容的辨识能力。在构建DoubleCheck模型之前,需先将新闻文本经过分词处理后转换成索引序列形式,作为模型训练的基础输入。此外,还需对生成的索引序列长度执行描述性统计分析,以此为基础决定模型最终采用的一致化序列长度标准。

索引序列的描述性统计:


count10090
mean994.24
std1251.14
min56
25%205.25
50%582.00
75%1290.00
max12337

根据索引序列的描述性统计,可以发现不同的新闻篇幅差距明显,最短的新闻仅含56个分词,最长的新闻含有12337个分词,过长或过短的序列长度设置均会对于模型的训练造成影响,设定的序列长度过短,可能会导致信息丢失,无法完整捕捉较长文章的内容;反之,如果序列长度过长,则可能引入大量不必要的填充数据,增加计算负担,并且可能降低模型的训练效率和效果。为了平衡这些因素,本文经过综合考虑后决定将输入序列的长度设定为512。

为了进一步提升模型训练的准确性,本文在训练过程中引入了验证集,以便对每次迭代后的训练结果进行评估。此外,为避免过拟合现象的发生,在每次训练迭代中,通过Dropout层随机地禁用部分神经元的激活值。这一策略能够有效阻止神经元间形成过于复杂的相互依赖关系,进而增强模型的泛化性能。

在损失函数和模型优化器的选择上,本文选择的损失函数为二元交叉熵损失函数BCEWithLogitsLoss ,这是一种结合了sigmoid激活函数和二元交叉熵损失的计算。这种设计使得它在数值上更加稳定,同时减少了计算量。

计算公式如下:

Loss=−1N∑i=1N[yilog(σ(xi))+(1−yi)log(1−σ(xi))] Loss=-\frac{1}{N}\sum_{i=1}^N[y_ilog(\sigma(x_i))+(1-y_i)log(1-\sigma(x_i))] Loss=−N1​i=1∑N​[yi​log(σ(xi​))+(1−yi​)log(1−σ(xi​))]

其中:

  • xix_ixi​是模型的输出。
  • σ(xi)\sigma(x_i)σ(xi​) 是sigmoid激活函数,σ(x)=11+e−x\sigma(x) = \frac{1}{1 + e^{-x}}σ(x)=1+e−x1​。
  • yiy_iyi​是实际的标签,0 或 1。
  • NNN是样本的数量。

模型优化器选择Adam优化器,这是一种基于梯度的优化算法,它结合了Momentum动量和RMSProp自适应学习率的有限,在处理稀疏梯度问题时效果显著,适用于大规模数据集和高维参数空间。

训练模型过程中,设置迭代次数10次,每次迭代后在验证集上对模型训练结果进行评估,计算其准确率、精确率、召回率和F1分数,同时在训练过程中记录损失函数值,绘制Loss曲线。

Loss曲线:
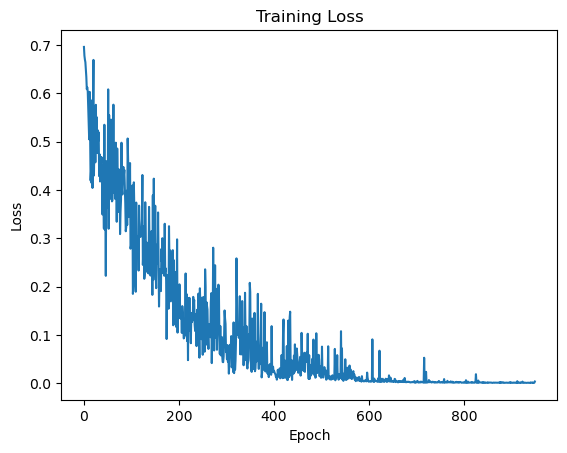
图6 Loss曲线

依据最终的预测结果,绘制混淆矩阵并生成分类报告,以评估模型在测试集上的性能。评估结果显示,该模型在正例上的表现尤为突出。此外,模型在检测虚假新闻方面也取得了一定成效,其召回率达到0.70,表明模型已具备初步的假新闻识别能力。然而,为了进一步提升其准确性和可靠性,仍需进行优化与改进。

混淆矩阵如下图所示:
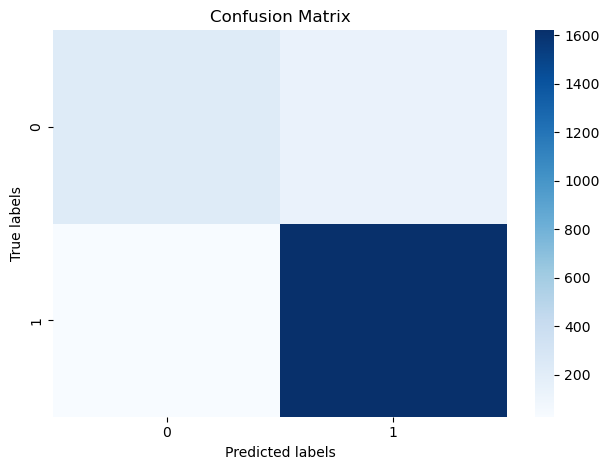
图7 混淆矩阵

分类报告如下表所示:


precisionrecallf1-scoresupport
00.870.700.77370
10.930.980.961648
accuracy0.932018
macro avg0.900.840.862018
weighted avg0.920.930.922018

思考总结

针对模型的整体预测性能,观察结果显示,DoubleCheck模型在正例预测方面表现出色,几乎达到了理想状态。这意味着该模型能够非常准确地识别出实际为正例的样本,从而减少了误报的情况。然而,在负例预测方面,由于可用的负例样本数量有限,模型的表现略显不足。这表明在处理负例时,模型可能会出现一些误判或漏判的情况。 尽管存在这一局限性,DoubleCheck模型在召回率和F1分数上依然展现出了显著的优势。召回率高意味着模型能够有效地找出大部分实际为正例的样本,而F1分数则是精确率和召回率的调和平均值,反映了模型在平衡这两者之间的能力。因此,DoubleCheck模型在这两个关键指标上的优异表现,使其在实际应用中具备了较高的实用性和可靠性。 基于以上分析,对这种复合模型的研究对于未来文本挖掘领域的进一步探索具有重要的学术价值与实践意义。LSTM是一种特殊的递归神经网络,它能够有效地处理和学习长期依赖性问题,这对于理解文本中的上下文信息非常关键。然而,尽管LSTM擅长捕捉序列数据中的时间动态变化,但它在处理非常长的序列时可能会遇到效率上的挑战,并且难以明确地表示不同部分之间的关系。 相比之下,自注意力机制提供了一种新的方法来解决这些问题。通过计算输入序列中每个位置与其他所有位置的相关性得分,自注意力机制能够让模型更加灵活地关注到整个输入序列中任意两个点之间的联系,从而更好地理解和利用全局信息。这种机制不仅提高了处理长距离依赖的能力,还增强了模型对输入序列内部结构的理解。 将LSTM与自注意力机制结合起来使用,则可以充分发挥两者的优势:一方面利用LSTM强大的顺序建模能力;另一方面借助自注意力机制来增强模型对文本整体结构的认识。这样的组合不仅有助于提高各种文本挖掘任务的表现,如情感分析、命名实体识别等,同时也为开发更高效、更准确的新一代自然语言处理系统开辟了道路。因此,在当前快速发展的AI领域内,探索LSTM与自注意力机制相结合的应用成为了许多研究人员关注的重点方向之一。
LSTM假新闻识别器:从语义锚点到上下文门控的实战设计 假新闻检测本质上是识别文本中局部逻辑矛盾与可信度失衡的语言模式,其核心挑战在于建模标题与正文间的时间错位、信源漂移、情感突变等非连续性线索。LSTM凭借门控机制对短时可疑信号的敏感性,相比全局注意力模型更契合该任务的‘局部破绽驱动’特性。通过语义锚点嵌入(融合词向量、情感得分与媒体可信度)、上下文门控Bi-LSTM及Attention+CNN多粒度融合,可将人工难以量化的‘可疑感’转化为稳定可训的数字特征。该方案适用于轻量部署、数据噪声强、需可解释输出的真实业务场景,尤其适合缺乏BERT微调资源但追求落地实 阅读详情

相关推荐

基于BiLSTM与自注意力机制的短文本讽刺检测模型BiSAT设计与实现

自然语言处理中的文本分类是理解语义的基础任务,其核心原理在于通过算法模型从文本中提取特征并进行模式识别。在情感分析、舆情监控等应用场景中,准确识别文本的隐含意图具有重要技术价值。讽刺检测作为文本分类的一个细分领域,尤其挑战模型对上下文和语义矛盾的理解能力。本文聚焦于短文本讽刺检测,针对其信息密度高、语境线索少的特点,设计并实现了BiSAT模型。该模型融合了双向长短期记忆网络(BiLSTM)以捕获序列的上下文依赖,并引入自注意力机制动态聚焦关键信息。同时,模型结合了情感极性、标点使用、夸张词统计等13维语言学

weixin_31062533的博客 385

虚假新闻检测概述

社交网络的新闻往往包括,,以及。其中新闻内容指的是文章中所包含的文本信息以及图片视频等多模态信息。社交上下文信息指的是新闻的发布者,新闻的传播网络,以及其他用户对新闻的评论和转发。外部知识指客观事实知识,通常由知识图谱表示外部知识。的定义是给定新闻文章的新闻内容,社交上下文内容,以及外部知识,去判断新闻文章的真假。

m0_51474171的博客 9690

多头自注意力机制原理与PyTorch工程实践

注意力机制是现代深度学习模型的核心组件,本质是一种基于查询-键-值(QKV)动态加权聚合的序列建模方法。其原理突破了RNN的串行限制与固定上下文瓶颈,通过可导、可并行的相似度计算实现长程依赖建模。技术价值体现在模型表达能力提升、硬件利用率优化及任务适配灵活性增强。典型应用场景涵盖NLP机器翻译、CV目标检测中的CBAM模块、时序预测及多模态对齐等。本文聚焦多头自注意力机制原理的底层实现逻辑,结合PyTorch手写代码、mask处理细节与FlashAttention-2显存优化,系统解析从理论公式到GPU落地

anmishi2025的博客 750

论文阅读-虚假信息检测综述 - Fake News Detection on Social Media: A Data Mining Perspective

论文阅读-虚假信息检测综述 - Fake News Detection on Social Media: A Data Mining Perspective

qq_40671063的博客 1万+

10个实战RNN变体深度解析:从LSTM门控原理到边缘部署

循环神经网络(RNN)是处理时间序列、语音、传感器数据等时序任务的基础架构,其核心在于通过隐藏状态显式建模历史依赖。理解LSTM的遗忘门机制、GRU的更新门设计、Bi-RNN的双向拼接逻辑,是掌握时序建模能力的关键。相比Transformer的全局注意力,RNN凭借线性计算复杂度、低内存占用和强归纳偏置,在嵌入式部署、实时流处理与小样本场景中仍具不可替代的技术价值。本文聚焦真实工业项目中的10种RNN变体选型决策——涵盖Elman RNN梯度衰减瓶颈、QRNN卷积加速实践、IndRNN独立循环抗消失特性,以

cuanwei9356的博客 485

虚假新闻检测:基于深度学习的实战解析与模型优化指南

本文介绍了如何使用深度学习技术构建一个虚假新闻检测模型,并使用Python和TensorFlow实现相关代码。我们还探讨了模型优化方法,以提高模型在实际场景中的表现。希望本文能帮助读者。

斌擎科技 1444

毕业设计选题:基于机器学习的虚假新闻识别系统 人工智能 python

毕业设计选题-基于深度学习的虚假新闻识别系统 该模型能够学习虚假新闻与真实新闻之间的语义和结构差异,从而精准地识别虚假新闻。无论您对深度学习技术感兴趣,还是希望在机器学习、算法或人工智能领域探索,抑或对深度学习和虚假新闻识别技术充满好奇,都将为您提供宝贵的灵感和研究方向。该虚假新闻识别系统在新闻媒体、社交媒体平台、信息验证等领域具有广泛的应用前景。对于计算机科学、自然语言处理、数据科学等专业的毕业生而言,掌握数据处理、模型构建和性能评估等关键技能,为您的毕业设计奠定坚实的基础。

2301_79555157的博客 3490

文本生成中的伦理问题与解决方案

生成式文本AI的核心是基于统计学习的内容创造规则驱动期(1960s-2000s):以ELIZA、ALICE为代表,通过预定义规则生成固定格式文本,伦理问题因生成能力有限未受关注;统计模型期(2000s-2017):以n-gram、RNN/LSTM为代表,依托概率模型生成连续文本,但易出现语法错误与逻辑混乱,伦理风险初步显现(如生成低质量广告);Transformer革命期(2017至今)

AI开发架构师 983

基于双层注意力重加权 LSTM 的中文长文本谣言检测模型

本文提出一种基于双层注意力重加权的长文本谣言检测模型。模型采用双层双向 LSTM 架构,通过第一层 LSTM 提取基础语义特征并结合 Tanh 非线性变换与线性层计算词级注意力权重定位关键区域;第二层 LSTM 以 Sigmoid 门控网络生成的动态特征权重与第一层注意力权重重加权后的特征为输入,进一步强化深层语义关联;最终拼接两层注意力的全局池化特征,经多层全连接网络完成分类。在 LTCR 长文本中文谣言数据集(含 1,729 条真实新闻与 561 条假新闻)上,模型表现优异:整体准确率达 96.29%。

mailangduoduo的博客 1587

虚假新闻识别检测数据集news.csv

虚假新闻识别检测数据集news.csv

Cadence OrCAD: 层次化设计 Hierarchical Design

详细介绍OrCAD的原理图层次化设计方法。

Fantasy237的博客 1万+

面向社交媒体的假新闻检测方法研究卷积神经网络模型Flask框架LSTM

摘要:本研究提出基于深度学习的社交媒体假新闻检测方法,集成LSTM、CNN和Transformer三种模型,通过TensorFlow框架实现文本特征提取与分类。系统采用Flask搭建后端服务,HTML/CSS/JavaScript开发前端界面,实现文本输入检测、模型性能对比及数据可视化功能。实验表明,该系统能有效识别虚假信息,三种模型各具优势:LSTM处理序列依赖、CNN提取局部特征、Transformer捕捉全局关联。系统支持实时检测与批量分析,为净化网络环境提供技术支撑。关键词:假新闻检测;深度学习;L

312

vue使用 APlayer+Meting实现音乐播放,支持多平台音乐:网易云、腾讯、虾米、酷狗、百度

  我之前写过一篇博客:使用 APlayer 实现音乐播放器,虽然 APlayer 让我实现了想要的音乐播放器效果,但是音频列表 audio 的音频链接、音频封面、歌词等,是需要自己去补充的。   那么这些数据从哪里来呢?   我昨天有发愁一会儿会儿,也去搜了获取音乐列表的接口,可以发请求去获取数据嘛。   也有瞅见MetingJS,A powerful plugin connect APlayer and Meting,一个连接APlayer和Meting的功能强大的插件,附上GitHub地址:https

小R.的博客 4798

计算机毕设答辩|大数据深度学习|计算机毕设项目|Flask面向社交媒体的假新闻检测方法研究

卷积神经网络(Convolutional Neural Network,简称CNN)是一种专门用于处理具有类似网格结构的数据的深度学习模型,图像、时间序列数据等。它通过模拟人脑视觉皮层的机制,采用局部连接、权值共享和池化等策略,有效地降低了模型的复杂度,同时增强了特征提取的能力。CNN的核心组件包括卷积层、池化层和全连接层:卷积层负责从输入数据中提取局部特征;池化层则对特征进行降维,保留最重要的信息,同时增加模型对输入数据的平移、缩放和扭曲等变化的鲁棒性;

2401_89210028的博客 635

高通SDX55平台:5G速率问题排查分析方法

和大家分享一下高通5G平台5G速率问题排查分析方法。

四儿家的小祖宗的博客 5219

内模控制(IMC)——理论、应用与实践

内模控制方法的核心思想是利用被控对象的数学模型(即内模)构建控制器,使得控制器可以“预知”被控系统的动态响应,从而在控制输入中提前补偿模型的固有特性和扰动影响。常见的内模控制结构中,将系统分为无延迟部分和扰动部分,并利用内部模型预测输出值,再通过反馈回路进行误差修正。utuimctufbtutui​mctuf​bt其中,uimctu_imc(t)ui​mct为内模预测得到的预补偿控制量,ufbtu_fb(t)uf​bt。

闲人编程的博客 2633

大数据深度学习|计算机毕设项目|计算机毕设答辩|Flask面向社交媒体的假新闻检测方法研究

研究背景随着社交媒体的迅猛发展,信息传播的速度和广度达到了前所未有的程度。然而,这一便利性也伴随着假新闻泛滥的问题,虚假信息在网络上迅速传播,严重影响了公众对信息的判断和信任。假新闻不仅误导公众,还可能引发社会恐慌、影响政治稳定,甚至威胁国家安全。因此,如何有效地检测和识别假新闻,成为了一个亟待解决的重要问题。本研究旨在利用TensorFlow框架和深度学习技术,通过LSTM、CNN和Transformer模型,对社交媒体上的假新闻进行检测,以维护网络环境的健康和可信。

2201_75937987的博客 1062

windows下宝塔安装教程

windows下宝塔安装教程 目录宝塔是什么?宝塔安装流程1.下载2.配置3.登录4.安装的环境套件小结 宝塔是什么? 宝塔是管理服务器的免费的软件,宝塔上面可以进行对你的服务器批量进行管理,对于运维人员来说还是必不可少的一个软件,值得使用。 宝塔安装流程 1.下载 链接: https://download.bt.cn/win/panel/BtSoft.zip 下载后安装买最好自定义目录,方便找 2.配置 下载完成后会出现这个页面,对着页面进行配置 点击默认密码复制进来,这里注意一点就是一定要查看

你在看屏幕的同时,屏幕也在注视着你 4423

基于LSTM模型的面向社交媒体的假新闻检测方法研究机器学习数据集python毕业设计

面向社交媒体的假新闻检测方法研究旨在利用深度学习技术识别和过滤虚假信息,维护网络环境的健康与可信。通过TensorFlow框架,本研究采用LSTM、CNN和Transformer三种模型构建假新闻检测系统。LSTM模型擅长捕捉文本中的长距离依赖关系,能够有效处理时间序列数据;CNN模型通过卷积操作提取局部特征,对文本的局部信息敏感;Transformer模型则利用自注意力机制,全面捕捉文本的全局特征。这三种模型各具优势,通过实验对比分析,可确定不同场景下的最优模型。在数据处理方面,对社交媒体文本进行分词、向

itszkt的博客 201

英伟达DeepStream学习笔记7——DeepStream接入USB相机并实现广角摄像头的畸变矫正

deepstream官方提供了一个畸变矫正的例子,包含了鱼眼和普通广角的矫正。我目前准备做一个广角的畸变矫正,我已经使用opencv实现功能,目前增加到deepstream框架中。示例代码在\opt\nvidia\deepstream\deepstream-5.0\sources\apps\sample_apps\deepstream-dewarper-test 中,鱼眼矫正——deepstream官方版 https://developer.nvidia.com/blog/calibration-trans

耶律大石的博客 1602

YOLOv8的二次创新 | 结合iRMB与EMA打造全新的iEMA机制,提升动态检测性能【附保姆级代码】

YOLOv8继承了YOLO系列的轻量化和高效检测特性,同时通过改进的架构设计使得其在实时场景下具有更高的检测精度。然而,随着检测需求的增加,尤其是在动态目标检测和长时间序列检测中,YOLOv8的鲁棒性依然可以提升。通过iEMA机制的引入,我们将在这些方面进行进一步优化。iRMB模块是我们对传统Residual Block的进一步改进。通过多层特征提取,iRMB能够捕捉更多层次的特征信息,并通过引入轻量化的残差结构,提升计算效率。

一键难忘的博客 3085

Flask--面向社交媒体的假新闻检测方法研究

面向社交媒体的假新闻检测方法研究 摘要 面向社交媒体的假新闻检测方法研究旨在利用深度学习技术识别和过滤虚假信息,维护网络环境的健康与可信。通过TensorFlow框架,本研究采用LSTM、CNN和Transformer三种模型构建假新闻检测系统。LSTM模型擅长捕捉文本中的长距离依赖关系,能够有效处理时间序列数据;CNN模型通过卷积操作提取局部特征,对文本的局部信息敏感;Transformer模型则利用自注意力机制,全面捕捉文本的全局特征。这三种模型各具优势,通过实验对比分析,可确定不同场景下的最优模型。在

weixin_41915110的博客 362

手把手实现STM32+ESP8266+原子云服务器+手机APP应用——第三节-编写STM32程序实现STM32+ESP8266+原子云服务器+手机APP互相通信—远程数据传输及控制灯

接上一篇,本节使用原子云服务器。编写STM32程序实现STM32+ESP8266+原子云服务器+手机APP互相通信—远程数据传输及控制灯。使用的硬件包括:STM32F103(任意其他款系列也可以的)、正点原子ATK-ESP8266、LED灯。实现编写STM32程序代码来传输单片机数据到原子云服务器和手机APP进行显示,同时通过手机APP和原子云服务器可以远程控制单片机,例如本节实现远程点/灭灯,以此可以扩展开发更多的功能。本专栏本系列的相关文章可查看下面链接:

嵌入式阿齐Archie 8414

大数据深度学习|计算机毕设项目|计算机毕设答辩|Flask--面向社交媒体的假新闻检测方法研究-Devil

卷积神经网络(Convolutional Neural Network,简称CNN)是一种专门用于处理具有类似网格结构的数据的深度学习模型,图像、时间序列数据等。它通过模拟人脑视觉皮层的机制,采用局部连接、权值共享和池化等策略,有效地降低了模型的复杂度,同时增强了特征提取的能力。CNN的核心组件包括卷积层、池化层和全连接层:卷积层负责从输入数据中提取局部特征;池化层则对特征进行降维,保留最重要的信息,同时增加模型对输入数据的平移、缩放和扭曲等变化的鲁棒性;

2201_75937987的博客 186

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

基于LSTM的智慧交通预测:从公交ETA到路况优化

时序预测是机器学习中极具工程价值的分支,它通过对历史序列的建模来推断未来状态,在交通、气象、金融等领域均有广泛应用。传统方法往往依赖简单平均或线性外推,难以捕捉复杂动态变化;而长短期记忆网络(LSTM)凭借对长期依赖和短期波动的建模能力,成为序列预测的常用技术。在实际智慧交通场景中,LSTM可用于预测路段未来速度、估算公交到站时间,进而为用户提供出行建议。数据清洗、特征构造与严格的时间切分是保证模型有效性的前提。本文从数据预处理、模型选型到Web应用落地,完整展示了一个AI智慧交通项目的实现路径,为相关工程

weixin_33834137的博客 292

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

解析 ‘Toxic Content Detection’:在多模态 Agent 中如何同时审核生成的图片、文字与音频?

在深入技术细节之前,我们首先需要明确“毒性内容”的范畴。它远不止于粗俗或冒犯性言论,更涵盖一切可能对用户、社会造成潜在危害、误导或歧视的内容。在多模态语境下,毒性内容的表现形式更加复杂,可能存在于单一模态中,也可能通过模态间的组合产生隐蔽的危害。文本模态毒性内容:针对特定群体(种族、性别、宗教、性取向等)的歧视、侮辱、威胁或煽动暴力。针对个人或群体的反复、恶意攻击、恐吓或贬低。直接或间接鼓励、教唆他人实施暴力行为。露骨的性描述、性骚扰言论,或未成年人色情内容。鼓励、美化自残或自杀行为的内容。

weixin_41455464的博客 1160

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

上一篇: 实习1 线性表及其应用
等我不困
博客等级 码龄4年 239粉丝 8原创
评论 3
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值