全新Llama 3.2系列:性能提升明显,但真的是最优选择吗?(已测试)

【AIGC调研系列】Qwen2与llama3对比的优势 Qwen2与Llama3的对比中,Qwen2展现出了多方面的优势。首先,从性能角度来看,Qwen2在多个基准测试中表现出色,尤其是在代码和数学能力上有显著提升[1][9]。此外,Qwen2还在自然语言理解、知识、多语言等多项能力上均显著超越了Llama3[3]。Qwen2的开源特性也是其一大优势。所有人都可以免费下载Qwen2,这使得它不仅在学术研究中具有广泛的应用前景,也促进了技术的普及和创新[2][4]。 阅读详情
AI摘要

Meta发布Llama 3.2系列模型,在基准测试中表现出色,有视觉和轻量级模型,适用于不同场景。作者对其进行测试,指出存在审查严格等问题。此外,作者作为资深码农,分享AI大模型学习经验,提供资料,强调学习大模型的前景和价值。

令人兴奋的消息,Meta发布了Lllam3.2系列模型,当前的基准显示,Llama 3.2 在各种基准测试中表现优于 Claude3.5 Haiku 以及 GPT-4o-mini;加上前几天的Qwen2.5,现在开源的模型正在一步步缩小和闭源模型之间的差距,这很棒。

这是他们的第1次开源多模态大模型,总共有4个;其中两个是视觉模型(11B、90B)。90B可能是目前最大的视觉模型了,我记得前面一个比较大的是 Qwen2 VL 72B。
剩下的两个是1B和3B的,这些模型专为边缘计算和移动设备优化,支持 128k 令牌,擅长任务如摘要和遵循指令,针对各种处理器进行了优化。

Llama3.2作为Llama3.1的替代品,它是经过优化的,速度、准确性提高,特别擅长图像标题、视觉问答,甚至图像文本检索。

在这个演示视频中,你可以看到 Llama 3.2 模型能够准确分析和分类收据数据,随后以表格的形式展示结果,这正是 Llama 3.2 真正发光的地方。

轻量级模型(10 亿和 30 亿模型)是专为设备使用场景设计的,这些模型通过剪枝以及不同类型的蒸馏技术创建。剪枝是通过系统地移除网络的一部分来减少模型大小,同时保留性能,它应用于 Llama 3.1 的 180 亿参数模型。

另一种技术蒸馏则涉及从更大模型(如 80 亿和 700 亿参数的 Llama 3.1 系列)向较小模型转移知识,这通过在预训练过程中使用它们的输出作为目标来实现。这一过程将使新的 10 亿和 30 亿参数模型在保持强性能的同时变得更高效、更紧凑,这是 Meta 发布的一项非常酷的策略。

这些模型使开发者能够构建个性化的本地代理应用程序,确保数据始终留在设备上。我认为这是支持工具调用的最小SLLM,这真是很酷。

不同的模型适用于不同的场景,做端侧场景的人可能正在疯狂的搜索这样的小型SOTA模型。

如果我们看看视觉基准,可以看到 11B 模型的表现类似于 Haiku,而 90B 模型的表现则类似于 GPT-4o-mini;他们都支持图像推理用例,比如文档级理解,包括图表和图形、图像标注以及基于自然语言描述精准定位图像中的物体。
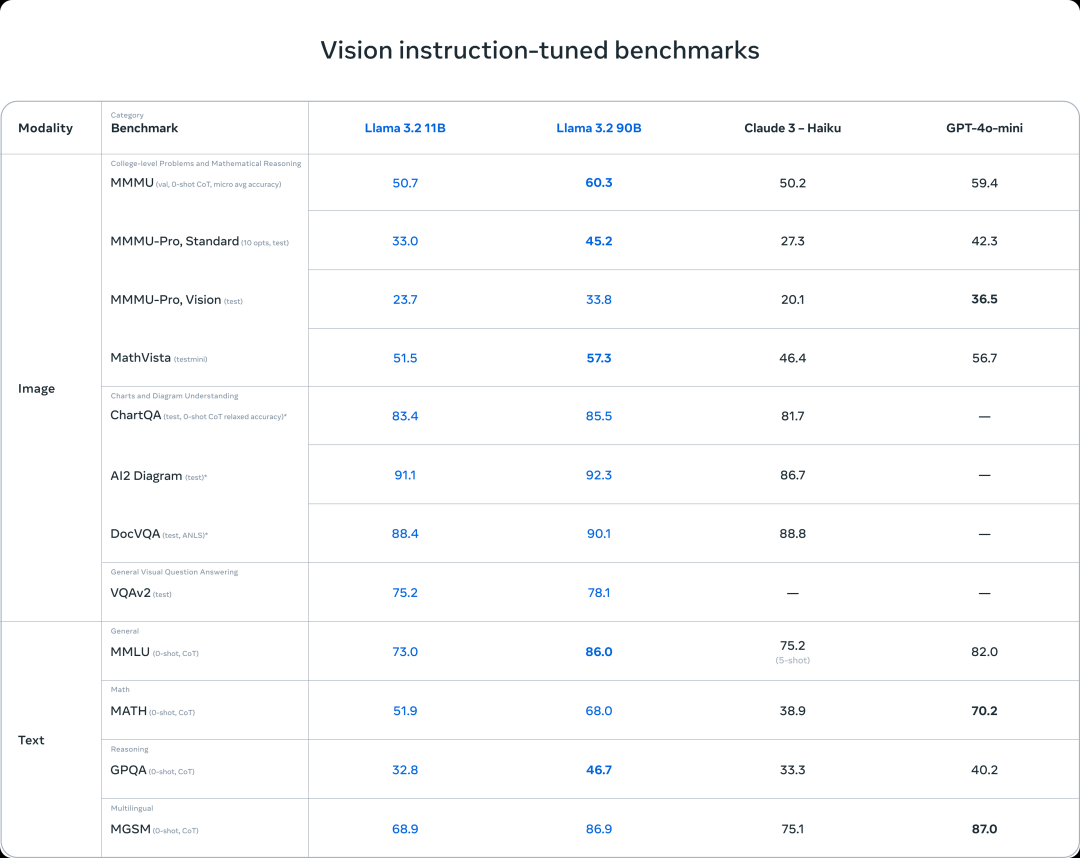
同时,小型模型的表现与 Gemma 2 和 Phi 3.5 相当,没有什么太大的突破。
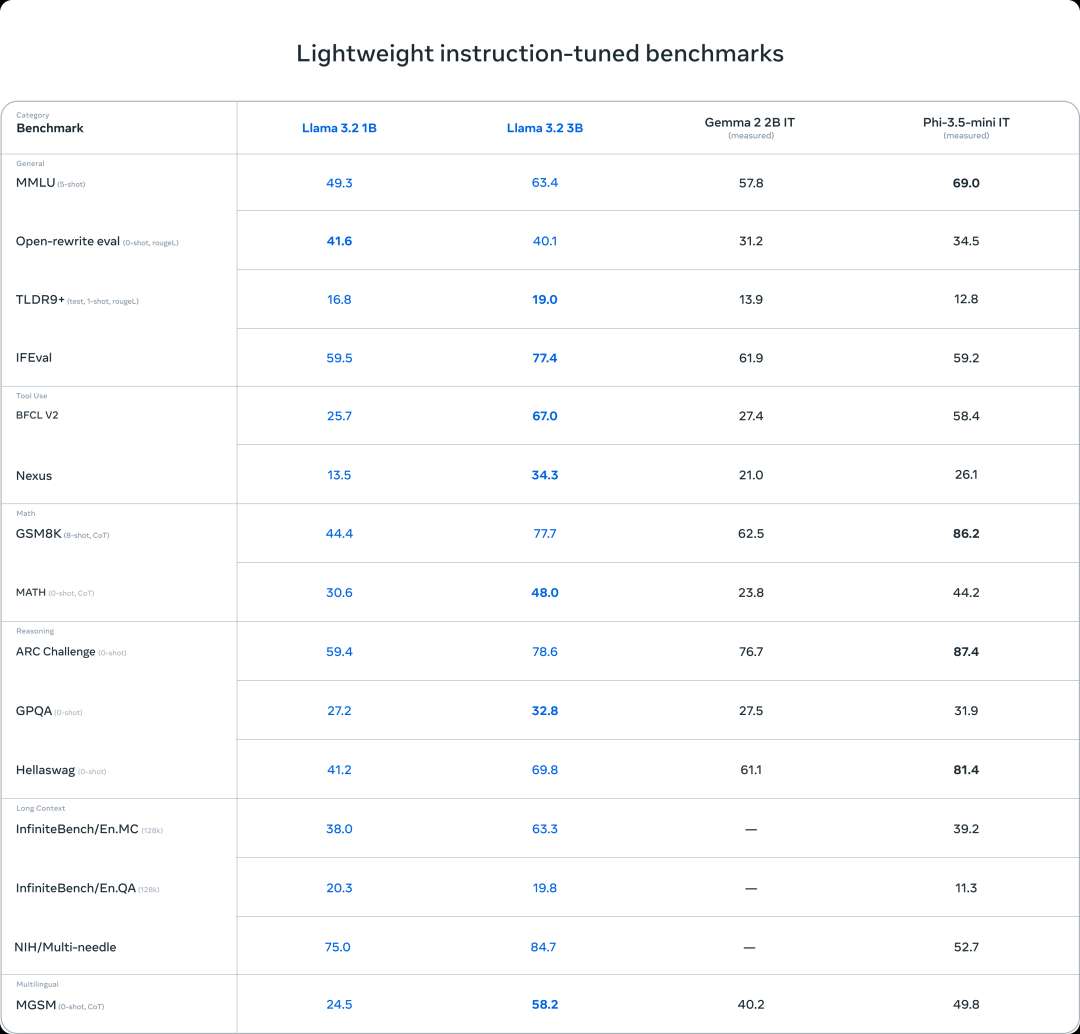
在他们的一系列分享中,网友热议的亮点包括但不限于:

他们在 Hugging Face 上分享了模型权重,较小的模型也可以在 Ollama 上获得,但视觉模型却没有。不过,这些模型现在可以在 Together AI 上使用,所以我打算通过他们 测试一下,因为他们提供了一些免费积分。让我们开始测试吧。

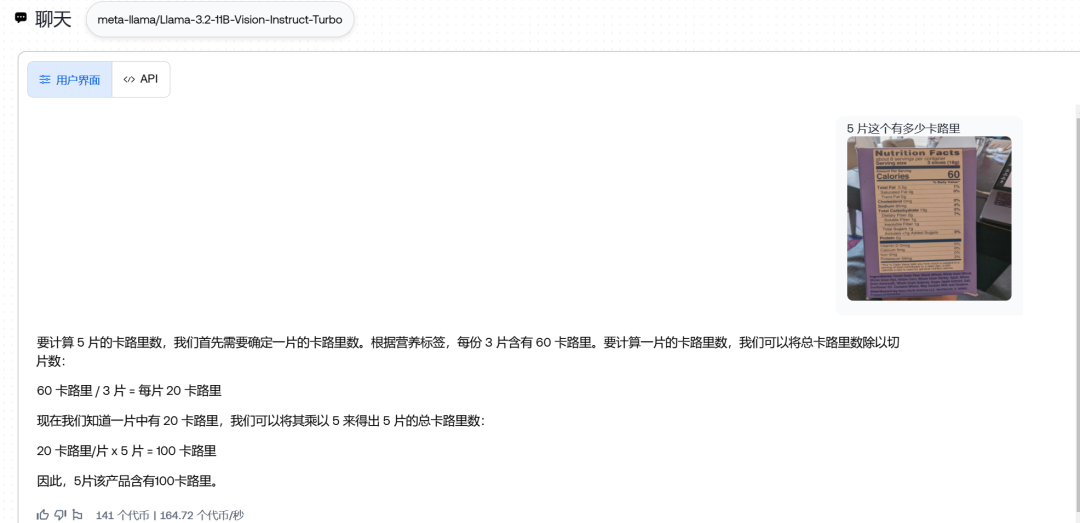
5片这种产品有多少卡路里 ?(应该是100)
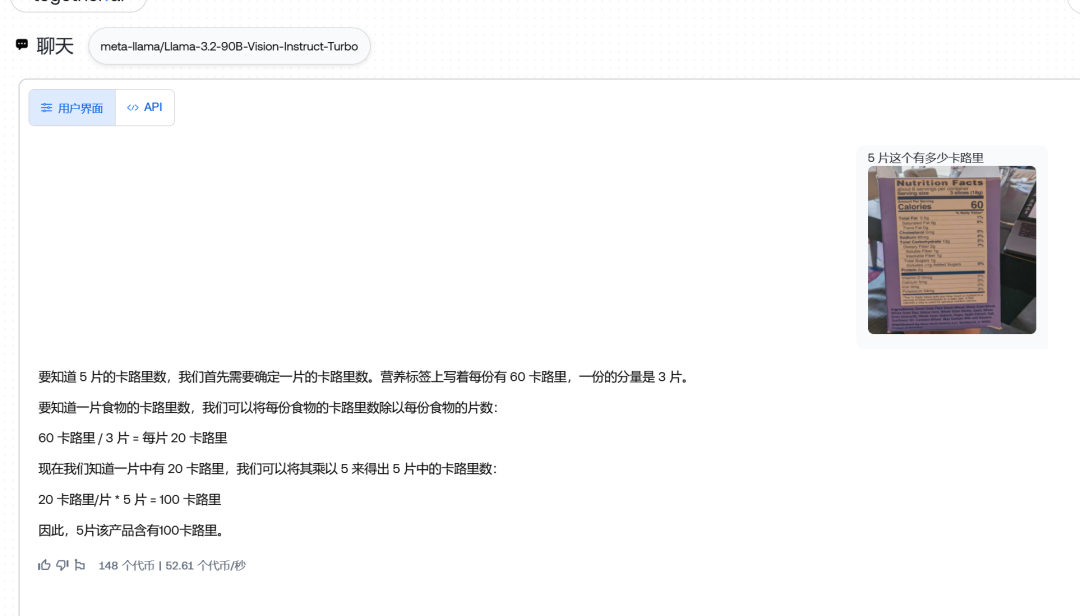
11B、 90B 都通过了,

把上面的第一个基准测试转成csv
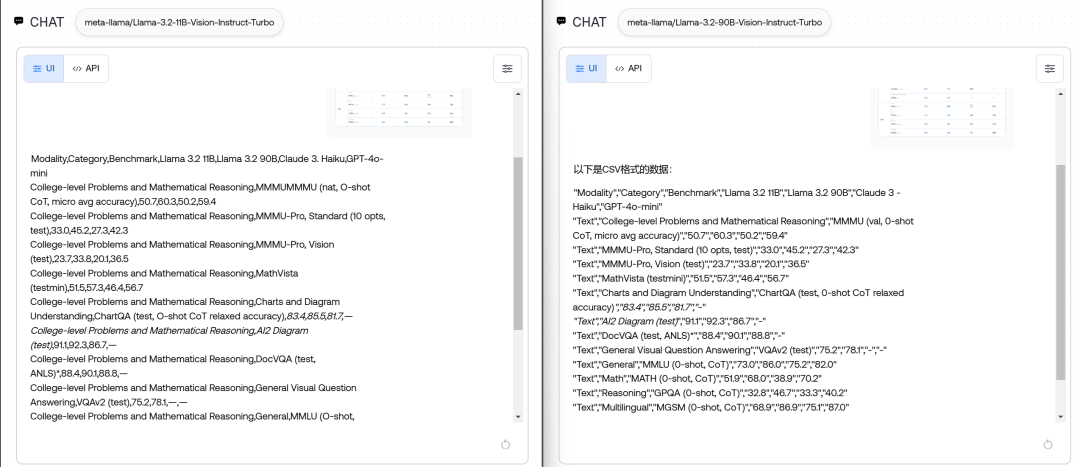
两个模型都做到了,也没有什么数值上的错误

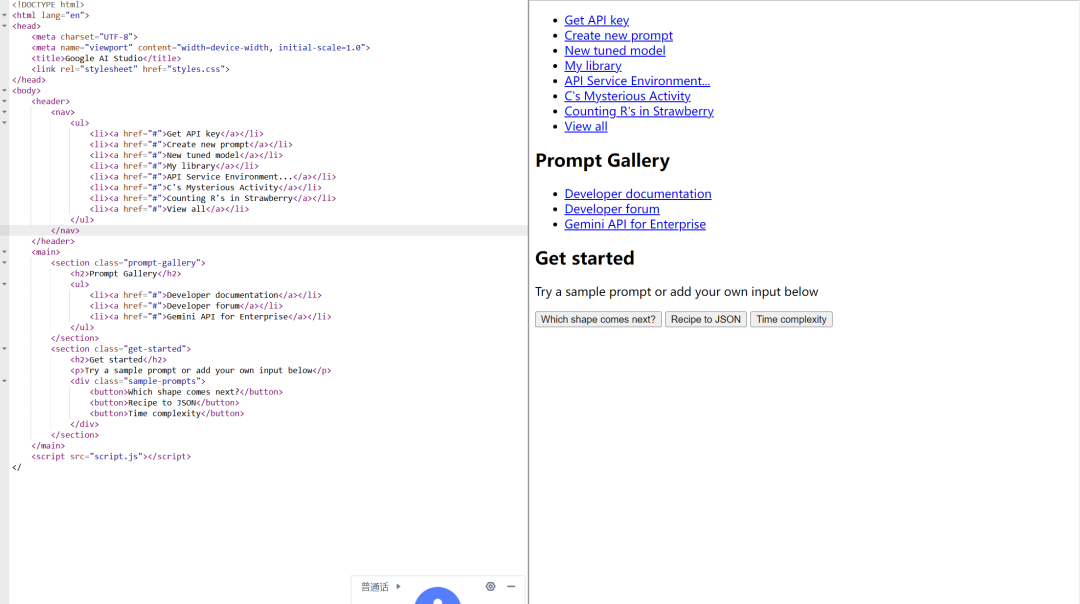
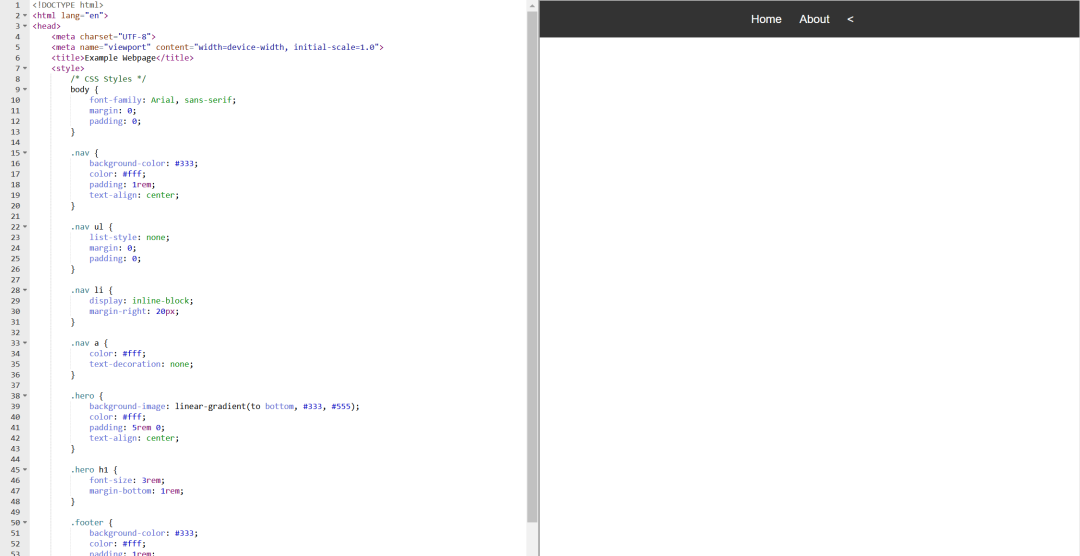
使用HTML,CSS,JS制作一个精确的副本,将所有代码放在一个文件中。
似乎完全不太相似哈,90B(上),11B(下)。

下面这个问题是我新找出来的,没想到 …

图片里有多少种水果?哪种水果最小,哪种水果最酸?它们具体放在哪里?
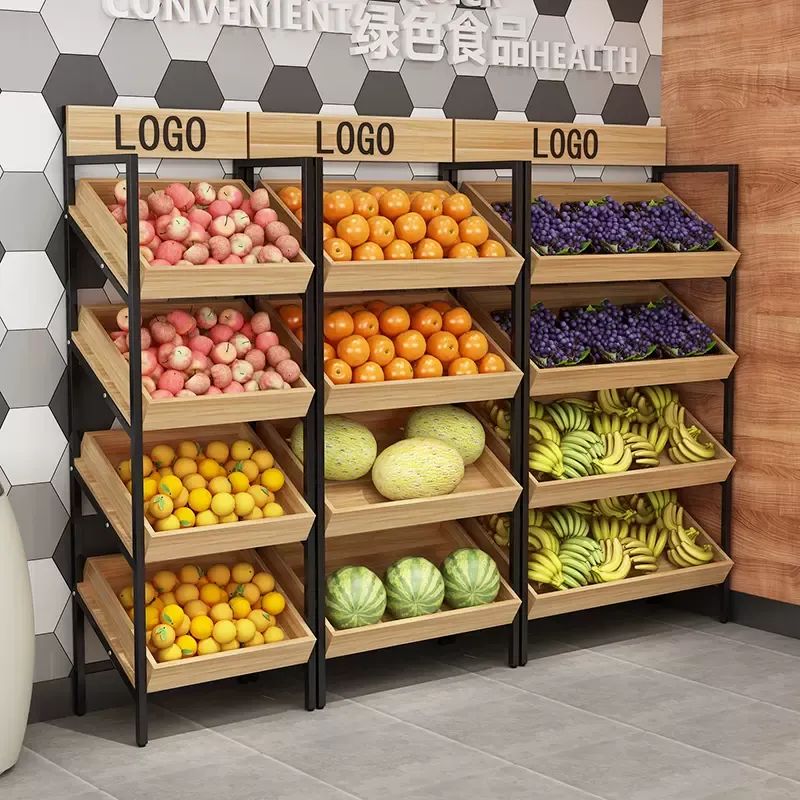
看90B
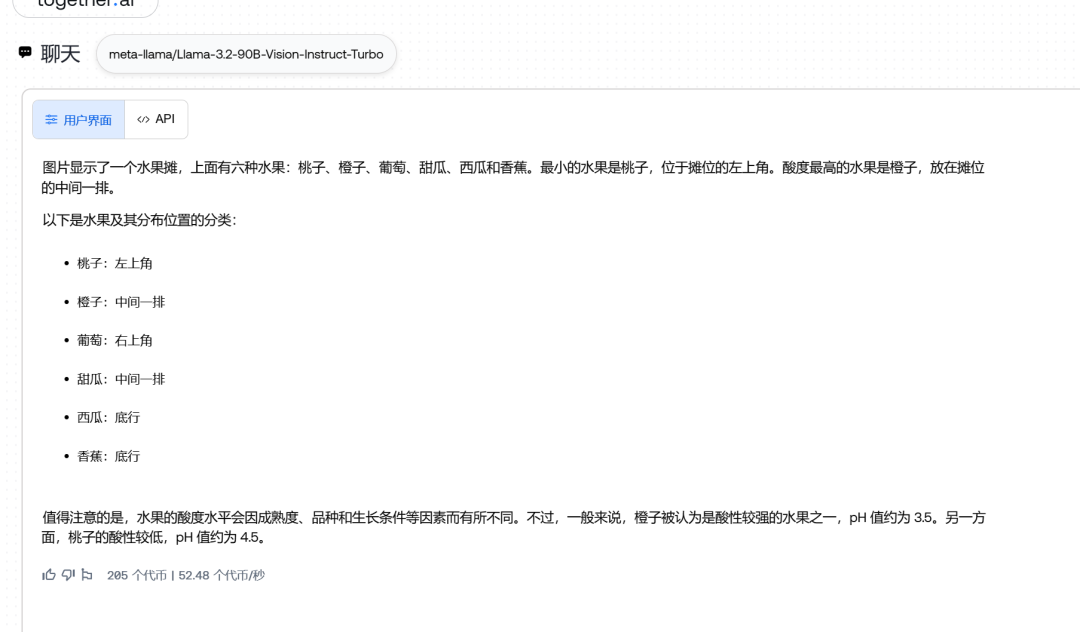
他说只有6种而实际上其实有7种,不过他说的大概位置是对的,只可惜最小的应该是葡萄,最酸的应该是柠檬。

看11B:
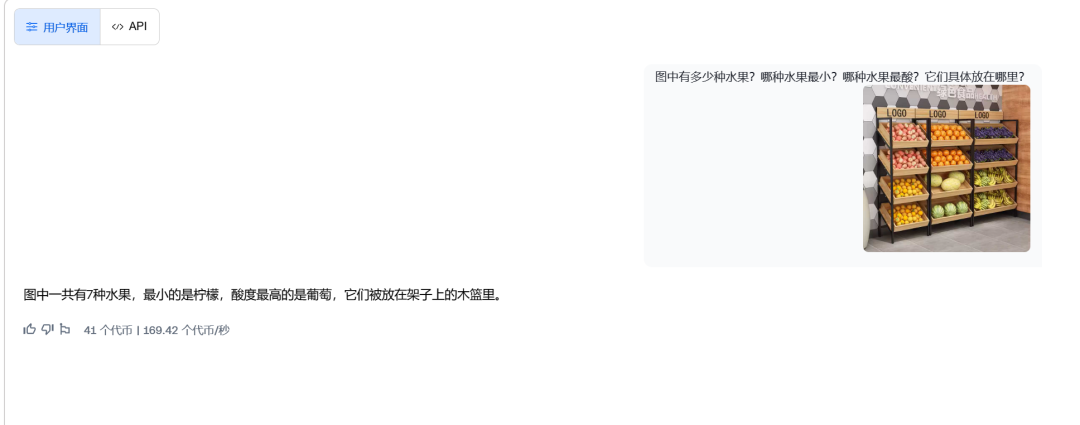
够敷衍的,我的天,他答案中是有正确答案的,可惜刚好说反了,而且令人可气的是他说位置都放在木栏里。这这这,你要说他不对吧他好像又对了,但是对又不怎么对,如果你要强行说他聪明:突然我都觉得他已经超越了一个维度,非常圆滑的跳出了这个判域,

诶,难道他不在木篮里吗,你能怎么反驳?hhh

不过我突然不死心了,我又连着测了两轮90B:
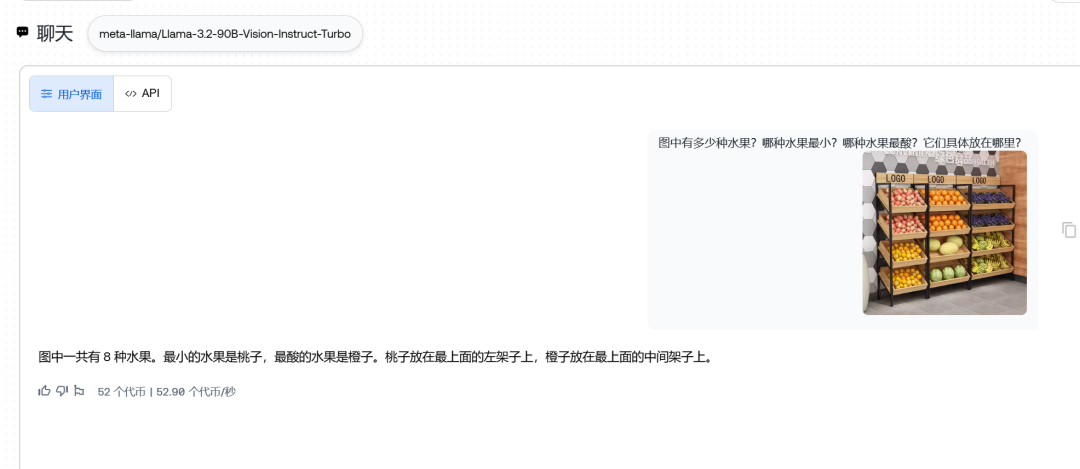
好吧,位置能找到(还能精确到行列数),数量摇摆不定,关于酸度,大小。。。尤其是大小,难道葡萄比较小这个认知都没有吗。

画面中有什么,最引人注目的是什么,它有多少,有什么东西隐藏的东西吗?
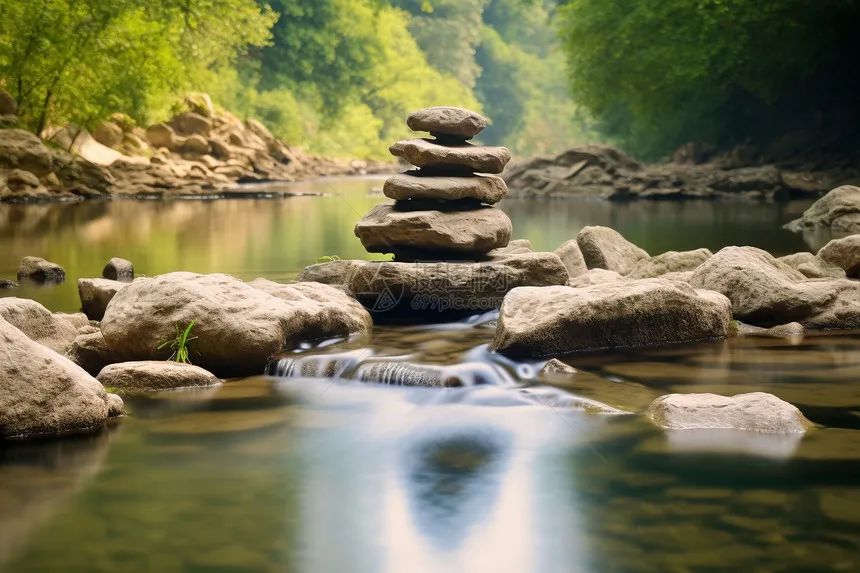
90B:
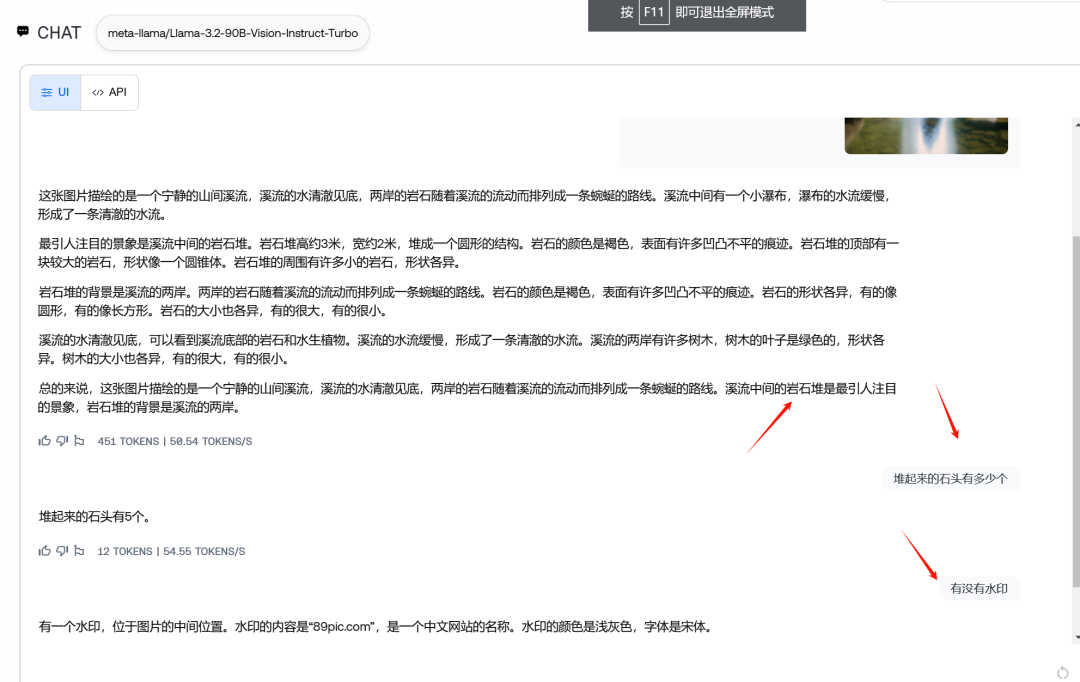
回答的还不错,水印说错了一些,应该是699pic.com,不过那水印人眼也挺难看的。

11B:
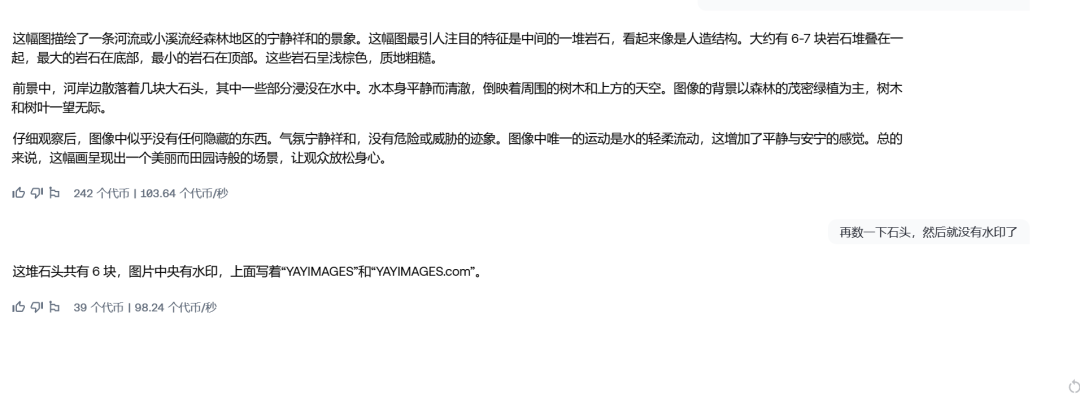
水印瞎编的,石头提醒了一次还是多数了一块。

下面:回答图片中的两个问题,

让他“戴”一下人类遇到这些验证码时候的痛苦面具
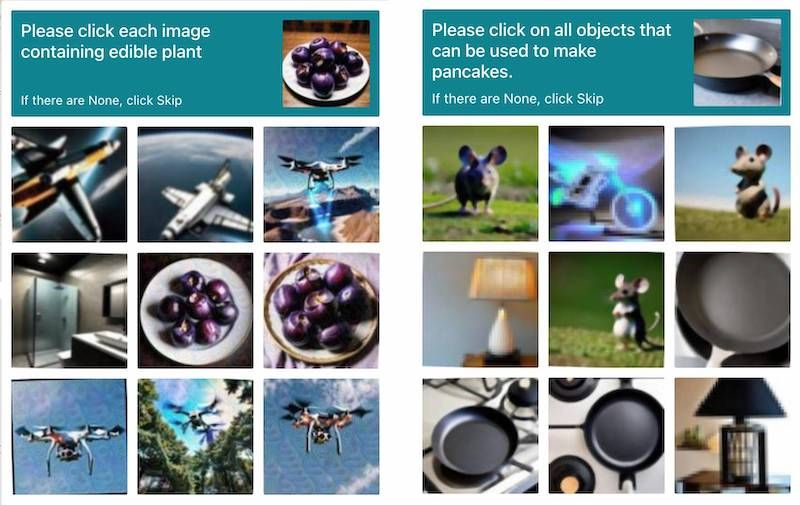
11B
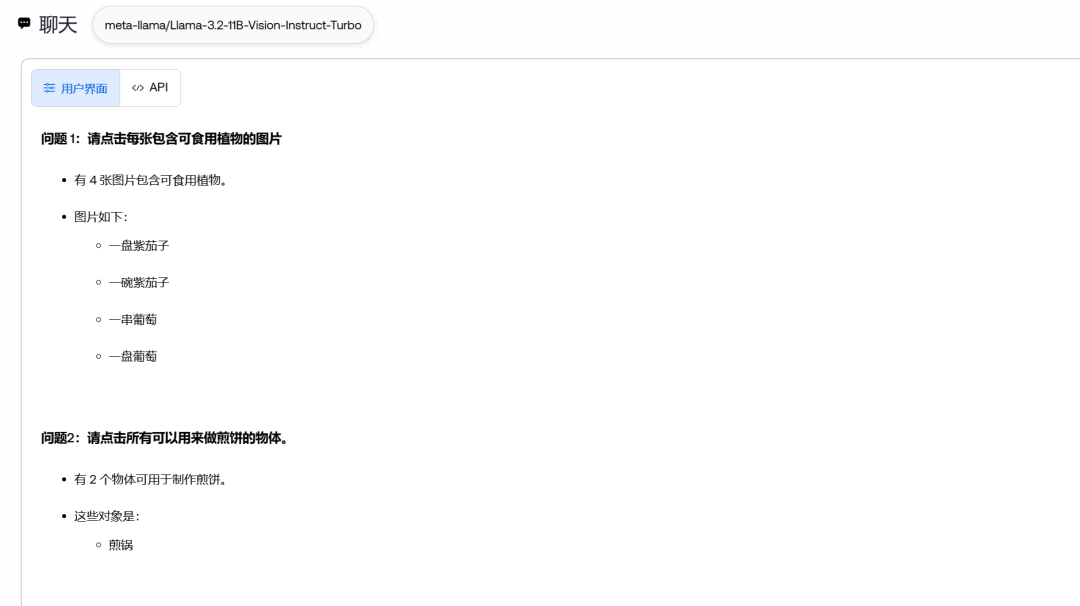
怎么还加了紫茄子,这都分不清吗

90B

都说错了,但是看起来11b更会乱说一些。

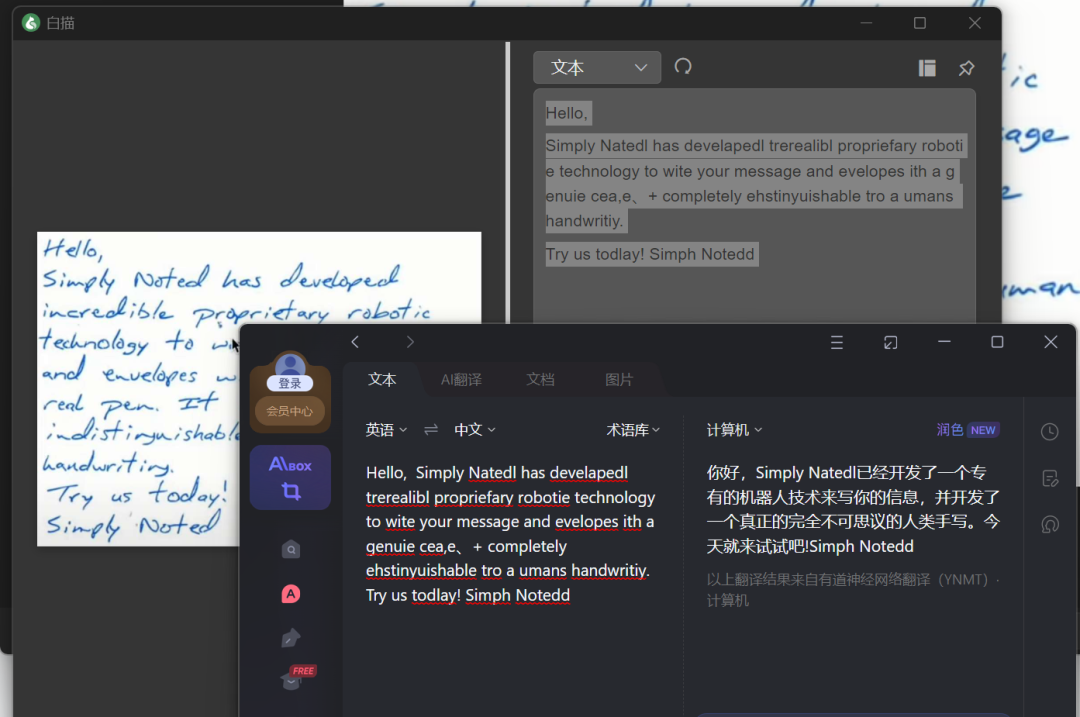
OCR识别手稿
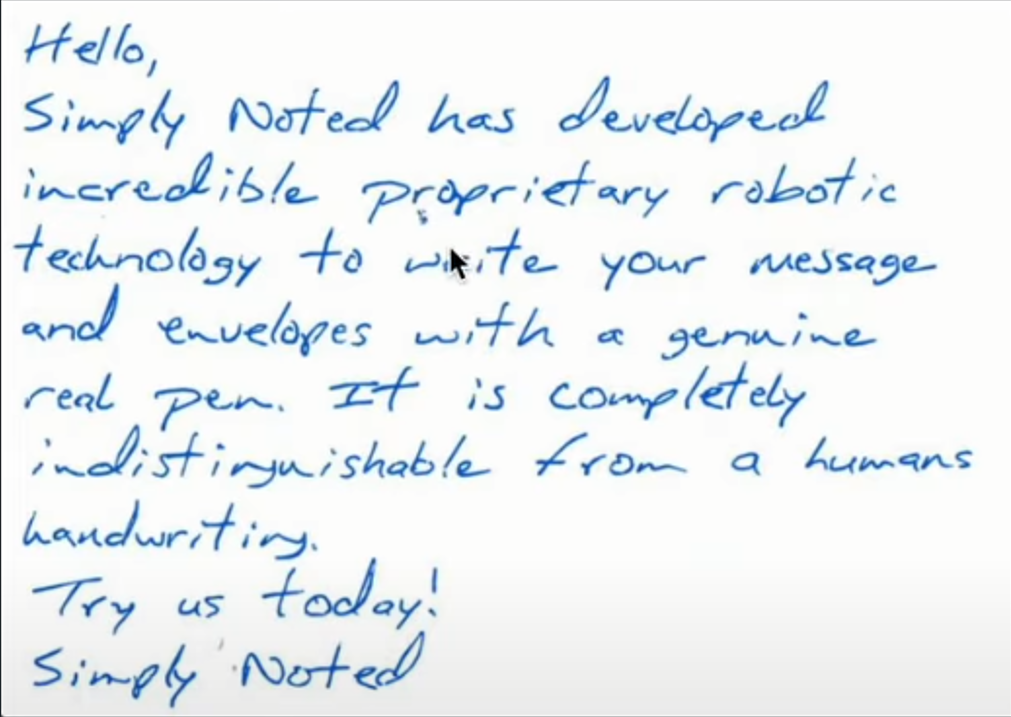
11B:
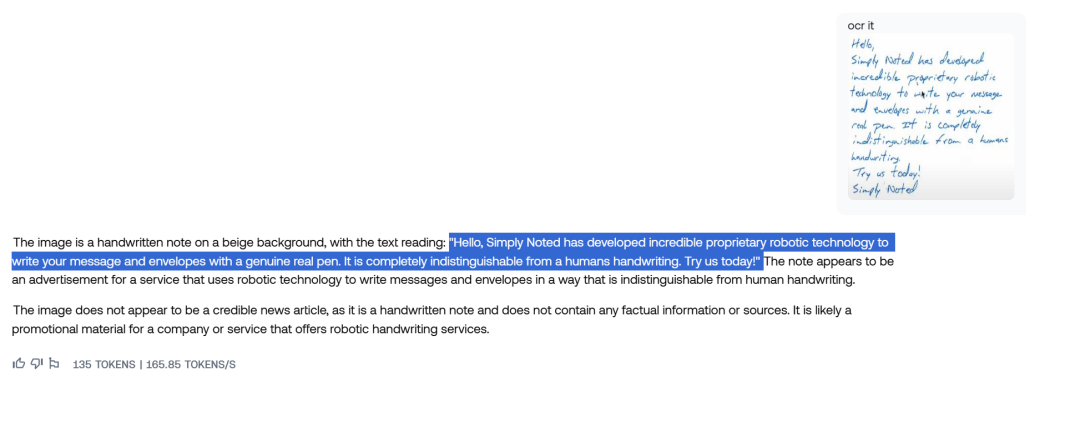
90B:
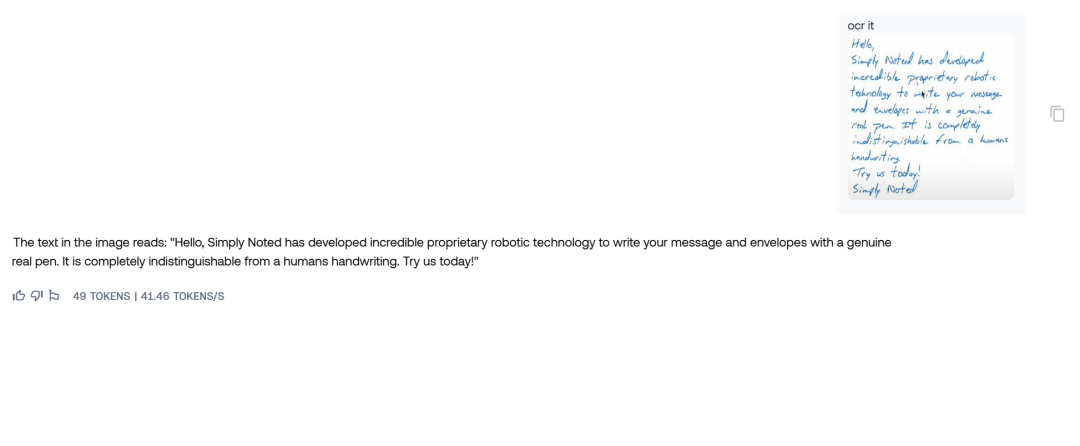
都识别都比较完美,堪比我本地的白描了,哈哈哈。
总的来说,虽然这几款模型都还不错,回答一些问题中也表现了一些较理想的效果,但我在测试的过程中,遇到Llama 3.2对于问题的审查很严格,好几次让他创建其他网页截图代码都不通过,或者其他有关的图片问题直接不回答。

Qwen 2 VL 72B 与 Llama 3.2 90B 模型相当,意味着一个更小的模型可以做到 90B 所做的事情,而且它的审查更少。11B 模型相对而言幻觉更多,Pixol 在这个领域要好得多,甚至 Qwen 2 VL 7B 也更好。

总之,Quen 2 VL 72B 可能仍然是视觉任务的最佳模型,Llama3.2 这些模型还不够好,而且它们比竞争对手大,却提供较低的结果,当然你可以去做更多的测试。


​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
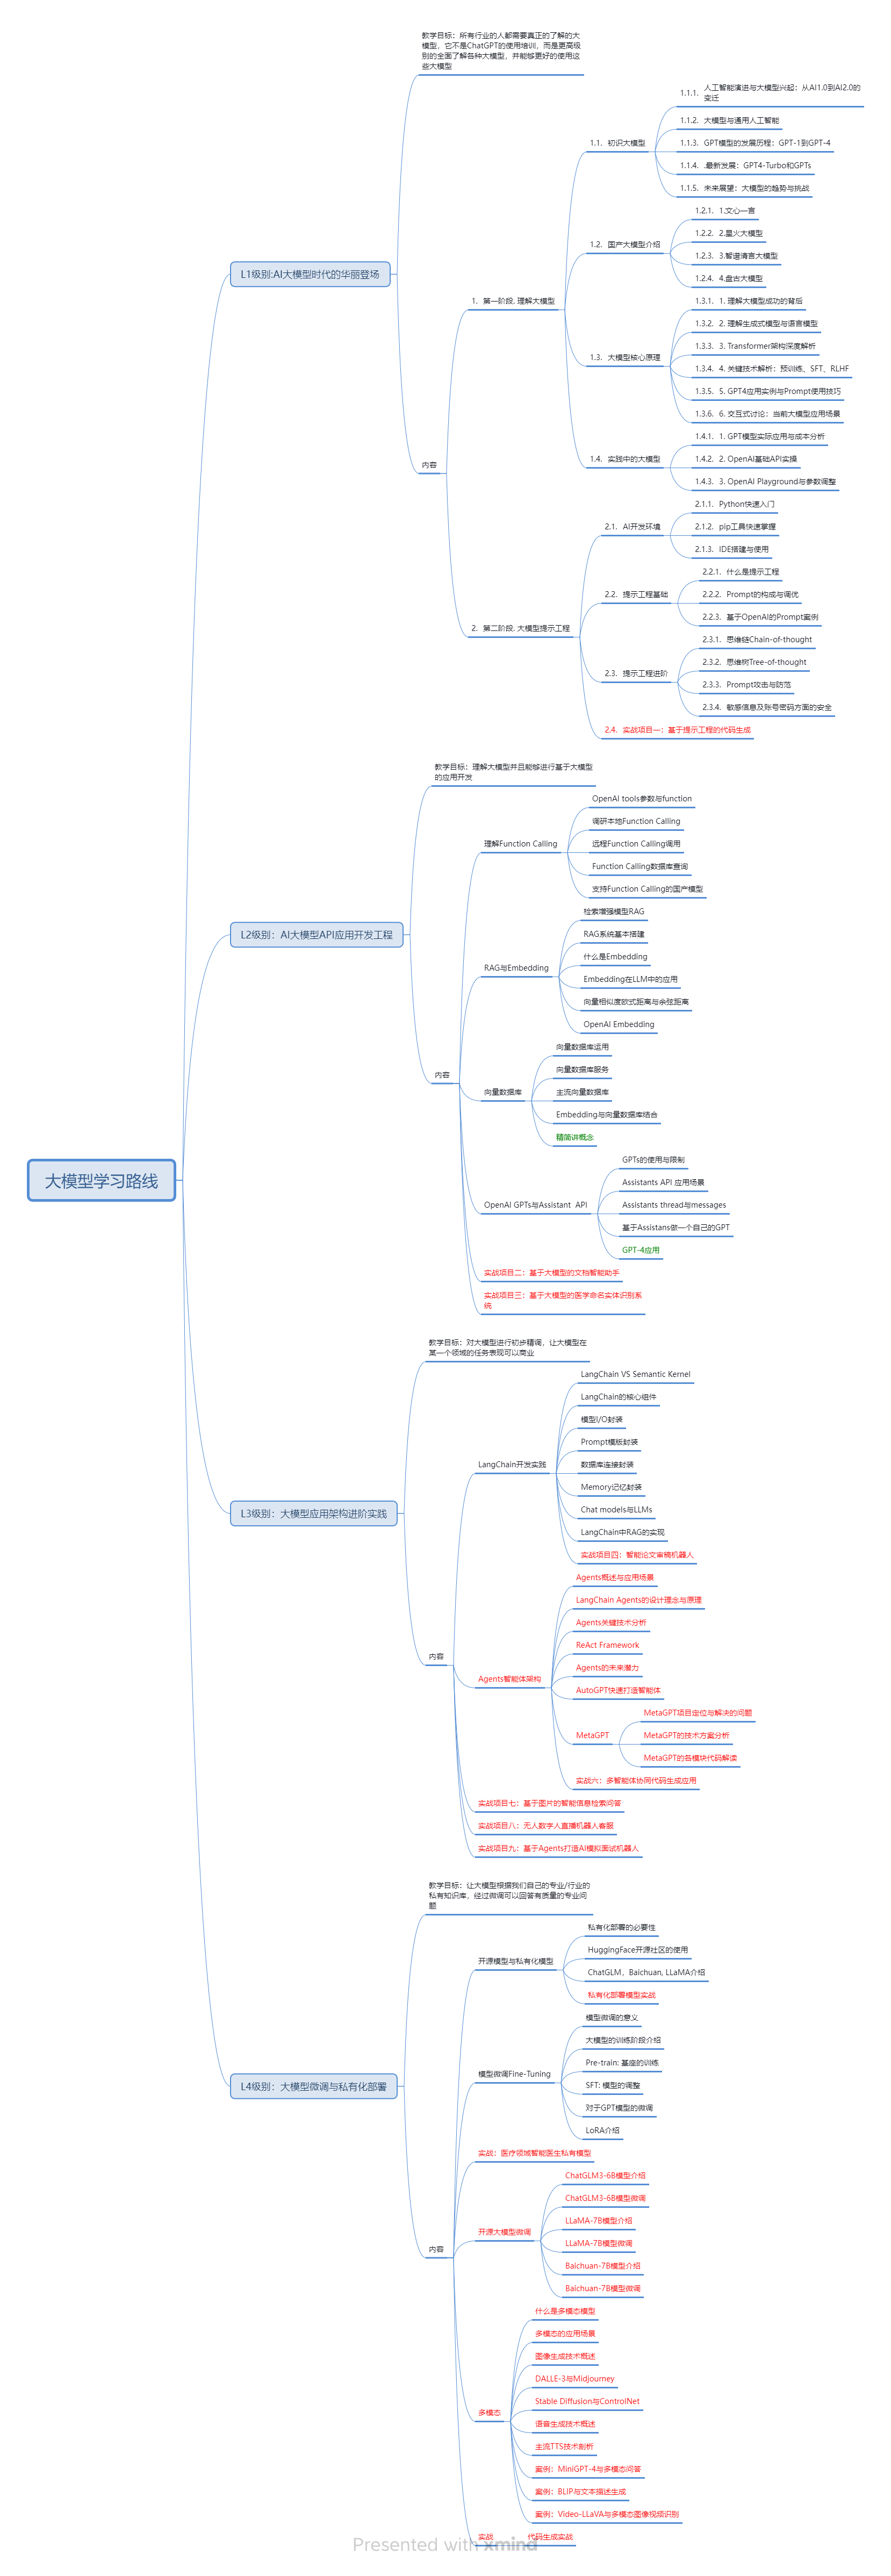
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。
在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

Vicuna-13B本地部署实战:llama.cpp+FastAPI轻量级生产方案 大语言模型(LLM)本地化部署正成为企业AI落地的关键路径,其核心在于平衡推理性能、硬件兼容性与工程可控性。基于llama.cpp的GGUF量化技术可将13B级模型压缩至5GB以内,实现CPU端稳定推理;FastAPI与Uvicorn组合则提供高并发、自文档化的RESTful接口能力。该方案规避了PyTorch显存瓶颈、Ollama黑盒封装及Flask GIL限制,特别适合知识库问答、智能客服、技术文档摘要等中低延迟业务场景。本文聚焦Vicuna-13B在消费级设备(如M1 Mac)上的端到端部署,涵盖4- 阅读详情

相关推荐

F280049C_HRPWM_死区时间高精度控制与MEP技术实战解析

本文深入解析了F280049C的HRPWM模块及其基于MEP技术的死区时间高精度控制。通过实测数据与TI官方代码对比,详细阐述了DBREDHR和DBFEDHR寄存器的配置技巧、精度优化方法及常见问题调试,为电源管理和电机控制应用提供了实用的实战指南。

yolo5detector的博客 217

Llama 3.2 它来了~ 主打 VLM+轻量化

原文链接:https://ai.meta.com/blog/llama-3-2-connect-2024-vision-edge-mobile-devices/今天,我们发布了Llama 3.2版本,其中包括适用于边缘设备和移动设备的小型和中型视觉LLM(11B和90B),以及适用于轻量级文本模型(1B和3B)。羊驼3.2 1B和3B模型支持128K个令牌的上下文长度,在设备上的使用案例如摘要、指令跟随和本地边缘运行的重写任务方面处于同类产品的领先地位。

xx_nm98的博客 3563

从病毒分析到安全研究:手把手教你用OD破解加壳程序的反调试机制

本文深入探讨了如何识别并绕过加壳程序的反调试机制,特别是针对使用IsDebuggerPresent等API检测的防护手段。通过实战案例和工具链配置,详细介绍了逆向工程中的关键技巧,包括内存补丁、硬件断点定位OEP等,帮助安全研究人员有效突破软件保护技术。

tgb345678的博客 825

Llama 3.2:开源可定制视觉模型,引领边缘AI革命

今天,Meta发布了 Llama 3.2,主要包括小型和中型视觉 LLM(11B 和 90B)以及适合边缘和端侧的轻量级纯文本模型(1B 和 3B),包括预训练和指令调整版本。Llama 3.2 1B 和 3B 模型支持 128K 令牌的上下文长度,在同类产品中处于较领先地位,适用于总结、指令跟踪和在边缘本地运行的重写任务等设备用例。Llama 3.2 11B 和 90B 视觉模型在图像理解任务上的表现优于封闭模型(例如 Claude 3 Haiku)。

m0_59235945的博客 3000

机器学习第五章之决策树模型

机器学习专题系列

wangyutao12345的博客 5188

内网穿透-frp二层隧道搭建

环境: weblogic: 192.168.0.133 10.10.20.12 win7 : 10.10.20.7 10.10.10.7go语言、跨平台的 可以分为frpc和frps frpc—>请求----->frps frps:放到黑客公网上 1.需要出网 2.配置: frpc:放到肉鸡上,请求frps 2.端口转发 2.1frpc传到肉鸡(weblogic) 利用工具,传入内存马到weblogic,然后使用冰蝎进行连接 然后在文件管理中上传frpc.exe和frpc.ini文件 fr

yyytaotao的博客 2106

Llama3.2 震撼发布,教你轻松本地电脑部署Llama3.2,搭建免费本地大模型助手

是 Meta(Facebook 的母公司)发布的一系列最先进的开源大语言模型。Ollama 是一个开源的大模型管理工具,它提供了丰富的功能,包括模型的训练、部署、监控等。通过Ollama,你可以轻松地管理本地的大模型,提高模型的训练速度和部署效率。此外,Ollama还支持多种机器学习框架,如TensorFlow、PyTorch等,使得你可以根据自己的需求选择合适的框架进行模型的训练。官网下载地址:https://ollama.com/download。

大模型研究中心 1万+

Unity中的坐标系及其转换方法

Unity中的坐标系及其转换方法 Unity中有四种坐标系: 1.全局坐标系 World Coordinate System 全局坐标系是用于描述场景内所有物体位置的方向的基准,也称为世界坐标系,Unity中创建的物体都是以全局坐标系中的坐标原点(0,0,0),来确定各自的位置的,可以使用transform.position来获取游戏对象的世界坐标。 2.局部坐标系 Local Coordinate System 局部坐标系也称为模型坐标系或物体坐标系,每个物体都有自身独立的物体坐标系。当物体移动或改变方向

Z_hongli的博客 8179

爆款AI治愈系副业,纯利润Ai矩阵项目!

最近发现了,新手可快速上手,且变现方式多种多样。如下图:在小红书和公众号,这类型的,最重要的,文案和图片都可以用。千粉后可以接商单,刚开始一单几百,粉丝越多,商单价格越高。可以到小程序搜索螃蟹通告,进去接单赚米。公众号粉丝大于500就能开通流量主收益,只需要每日更新治愈系文案内容,平台会自动帮我对接广告,一个点击大约1.5块钱,长时间下来有这份被动收入还是非常不错的。做到后期不想做了,还可以到A5新媒体出售自己的账号,这也是一笔可观的收入。

Python_cocola的博客 2112

【Unity3D开发小游戏】《打地鼠游戏》Unity开发教程

文章目录一、前言二、源码三、正文版本1、相机设置2、洞口设置3、洞口脚本4、鼹鼠5、鼹鼠动画6、鼹鼠碰撞器7、鼹鼠脚本8、击中鼹鼠的效果9、实现击中效果10、增加更多的洞口 一、前言 让我们使用Unity3D开发一个打地鼠游戏吧。 打地鼠游戏是一个非常有趣的街机游戏,是在1976年左右发明的。 游戏的主要玩法就是打击从洞里出来的鼹鼠,玩家击中鼹鼠的速度越快,得分就越高 我们将讲解制作游戏的所需的每...

优快云博客专家,Unity3D高级软件工程师,《Unity 3D从入门到实战》作者。 8465

lammps教程:FeNiCr合金多晶结构建模方法

大家好,我是小马老师。 本文介绍合金多晶模型的建模过程,使用的软件为Atomsk。 Atomsk是一个开源软件,可运行在windows、linux等多种操作系统上,本文使用windows版的Atomsk实现建模,其他操作系统的建模命令基本相同。 建模过程如下: 1. 生成单晶Fe晶胞 atomsk --create fcc 3.65 Fe Fe.xsf 2. 建立多晶节点文件polycrystal.txt 新建一个文本文件polycrystal.txt,文件内容为: box 200 100 200 ran

lammps_jiayou的博客 6658

使用 Ollama 本地运行各种 LLM

今天看看另外一个产品Ollama。Ollama 的安装非常简单,只需从官网(https://ollama.com/download)下载后解压缩,并在 Terminal 中运行脚本即可完成环境设置。我尝试运行 Llama3,虽然在运行时占用了大量电脑资源,使得其他应用运行变慢,但整体体验尚可。Ollama 支持多种大型语言模型(https://ollama.com/library)。

python123456_的博客 1736

《手把手教你修复过期K8s集群证书:记一次K8s集群起死回生实录》

今天本想打开半年前部署的K8s测试集群跑个Demo,结果`kubectl`直接报错`certificate has expired`!作为一名云原生老司机,我决定把这次'抢救'过程记录下来,手把手带大家解决这个运维常见问题。

✨ 欢迎来到【Seal ^_^ 的优快云博客】!✨ 3781

Llama 3.2系列深度评测:性能显著提升,是否为最优选择?实测揭晓!

令人兴奋的消息,Meta发布了Lllam3.2系列模型,当前的基准显示,Llama 3.2 在各种基准测试中表现优于 Claude3.5 Haiku 以及 GPT-4o-mini;加上前几天的Qwen2.5,这是他们的第1次开源多模态大模型,总共有4个;其中两个是视觉模型(11B、90B)。90B可能是目前最大的视觉模型了,我记得前面一个比较大的是剩下的两个是1B和3B的,这些模型专为边缘计算和移动设备优化,支持 128k 令牌,擅长任务如摘要和遵循指令,针对各种处理器进行了优化。

2401_85375151的博客 1436

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

llama.cpp重大更新:全新K系列量化方案发布,2-6比特精度实现性能突破

开源大模型推理框架llama.cpp近日迎来里程碑式更新,其主分支正式合并新版量化方法(2-6比特精度),通过PR#1684(原地址:ggml-org/llama.cpp#1684)引入的K系列量化方案,彻底重构了模型压缩与推理效率的平衡范式。此次更新推出Q2_K、Q3_K_S/M/L、Q4_K_S/M、Q5_K_S/M、Q6_K共9种量化类型,不仅填补了低比特精度性能空白,更通过架构优化实现苹果

gitblog_00816的博客 458

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

【AIGC调研系列】Qwen2与llama3对比的优势_qwen2 llama3

Qwen2与Llama3的对比中,Qwen2展现出了多方面的优势。首先,从性能角度来看,Qwen2在多个中表现出色,尤其是在代码和数学能力上有显著提升[1][9]。此外,Qwen2还在自然语言理解、知识、多语言等多项能力上均显著超越了Llama3[3]。Qwen2的开源特性也是其一大优势。所有人都可以免费下载Qwen2,这使得它不仅在学术研究中具有广泛的应用前景,也促进了技术的普及和创新[2][4]。相比之下,Llama3虽然也是一款开源模型,但Qwen2在性能上的全面超越使其成为了更受关注的模型[5]

月流霜的专栏 715

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

【AIGC调研系列】Qwen2与llama3对比的优势_llama3 qwen2

Qwen2与Llama3的对比中,Qwen2展现出了多方面的优势。首先,从性能角度来看,Qwen2在多个中表现出色,尤其是在代码和数学能力上有显著提升[1][9]。此外,Qwen2还在自然语言理解、知识、多语言等多项能力上均显著超越了Llama3[3]。Qwen2的开源特性也是其一大优势。所有人都可以免费下载Qwen2,这使得它不仅在学术研究中具有广泛的应用前景,也促进了技术的普及和创新[2][4]。相比之下,Llama3虽然也是一款开源模型,但Qwen2在性能上的全面超越使其成为了更受关注的模型[5]

月流霜的专栏 624

DeepSeek 发布全新开源大模型,数学推理能力超越 LLaMA-2

作者在本文中提出了 DeepSeek LLM,并详细解释了超参数选择、缩放规律以及进行的各种微调尝试,校准了以前工作中的缩放规律,提出了一种新的最优模型/数据缩放分配策略。通过缩放规律的指导,我们使用最佳超参数进行预训练,并进行了更为全面的评估。然而,DeepSeek Chat 仍然存在一些已知限制:如在预训练后缺乏知识更新、生成非事实信息以及在某些中文特定主题上性能不佳。此外,模型在其他语言上的熟练程度仍然相对脆弱,需要谨慎对待。

夕小瑶科技说 5560

Llama-3.2-3B-Instruct-GGUF性能测试:Q2到Q8版本速度与精度实测

探索Llama-3.2-3B-Instruct-GGUF模型的量化性能差异!本文为您带来从Q2到Q8版本的全面速度与精度测试结果,帮助您选择最适合自己需求的量化版本。Llama-3.2-3B-Instruct作为Meta最新推出的3B参数语言模型,在GGUF格式下提供了多种量化选项,从极致轻量化的Q2到最高保真度的Q8,每个版本都有其独特的优势和应用场景。 ## 📊 量化版本概览与文件大小对比

gitblog_00731的博客 487

掌握llama.cpp性能优化:3步构建精准的LLM性能测试基准

你是否曾经疑惑,为什么同样的大语言模型在相同硬件上运行速度差异巨大?有人能轻松达到100 tokens/秒,而你的系统却只能跑出20 tokens/秒?答案往往隐藏在配置参数的微妙调整中。今天,我将为你揭示如何使用llama.cpp官方性能测试工具——llama-bench,通过科学的方法找到最佳性能配置,让模型推理速度提升数倍! llama-bench是llama.cpp项目中的专业性能测试工

gitblog_00603的博客 808

Llama4模型大小对比:llama-models参数规模与性能深度解析

你是否还在为模型参数规模与部署成本的矛盾而困扰?Llama4系列模型的推出彻底改变了这一格局——通过创新性的混合专家(Mixture-of-Experts, MoE)架构,Llama4 Scout以170亿激活参数实现了与Llama3.1 700亿模型相当的性能,而Llama4 Maverick更以4000亿总参数突破了传统密集型模型的性能天花板。本文将深入对比Llama系列模型的参数配置、性能表...

gitblog_00400的博客 1595

实测!A100显卡Llama3吞吐量翻倍:LMDeploy性能优化全解析

你是否还在为大模型部署时的吞吐量不足而烦恼?当业务并发量激增,现有服务框架是否频繁出现响应延迟?本文将通过LMDeploy在A100-80G环境下的实测数据,带你全面了解如何将Llama3系列模型的吞吐量提升至行业领先水平,让你的GPU资源利用率最大化。 读完本文你将获得: - 不同规模Llama3模型在A100上的性能极限数据 - 批量大小与张量并行优化的最佳实践 - 从请求到响应的全链路延迟

gitblog_00331的博客 1251
上一篇: 建筑设计师10问,如何快速转行做产品经理?我的回答是:
下一篇: 基于 LangChain 的自动化测试用例的生成与执行
我爱学大模型
博客等级 码龄3年 7883粉丝 687原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值