快手「可灵」爆火:海外AI圈巨震,中国版Sora一号难求

国内AI大模型已近80个,哪个最有前途? 它是基于快手自研大模型可灵和可图,提供高质量视频及图像生成能力,通过更便捷的操作、更丰富的能力、更专业的参数和更惊艳的效果,满足创作者对创意素材生产与管理的需求。除了上面两个国产AI,当然像月之暗面Kimi、夸克AI、通义千问等模型我也认为比较有前途,有兴趣的同学可以具体体验下我提到的这些国产AI的功能,都是比较赞的!但是智谱清言它开源了,它的AI模型叫ChatGLM/GLM,而且是所有迭代模型都开源,从最开始的第一代到最近刚发布的GLM4。据测评,全球AI视频大模型排行榜,「可灵AI」No.1。 阅读详情

短短一年后,AI 生成的「吃面条」已经如此自然流畅?这让全球网友都感受到了亿点点震撼。
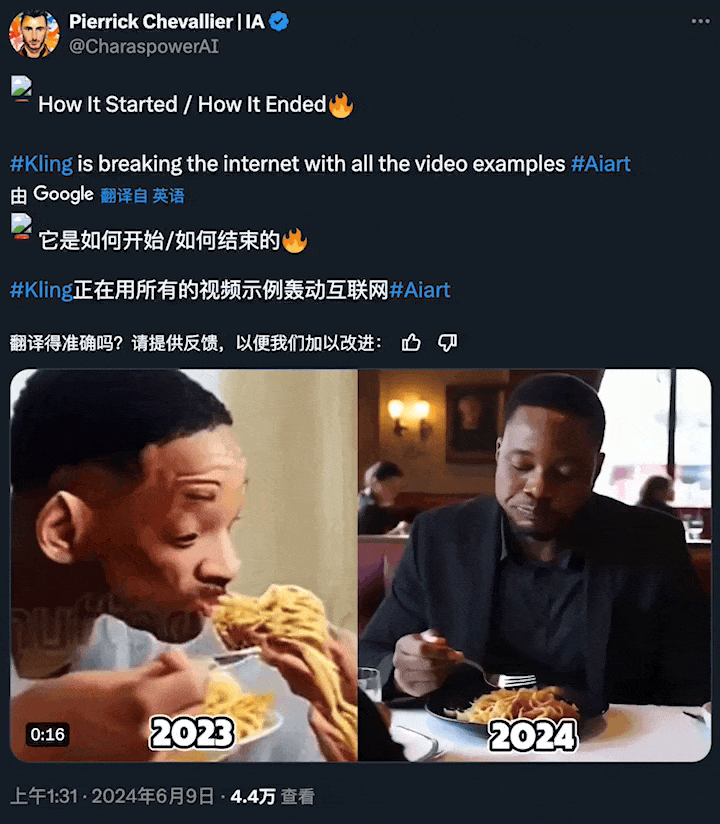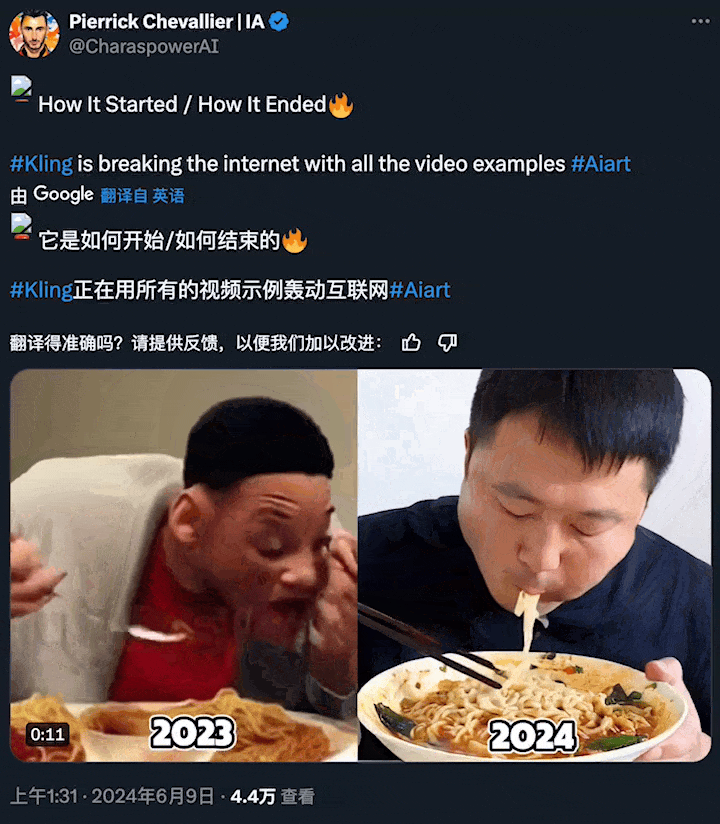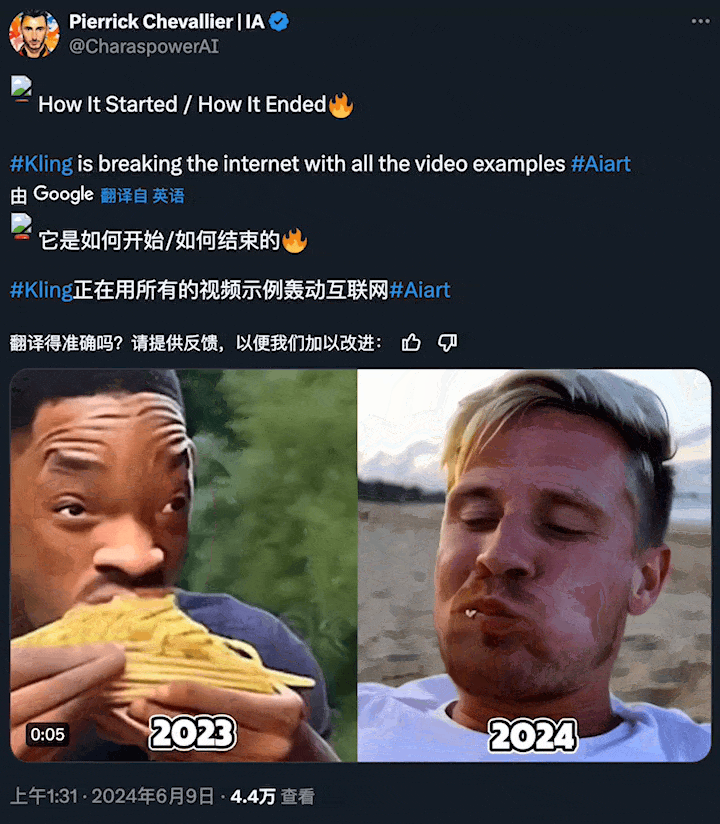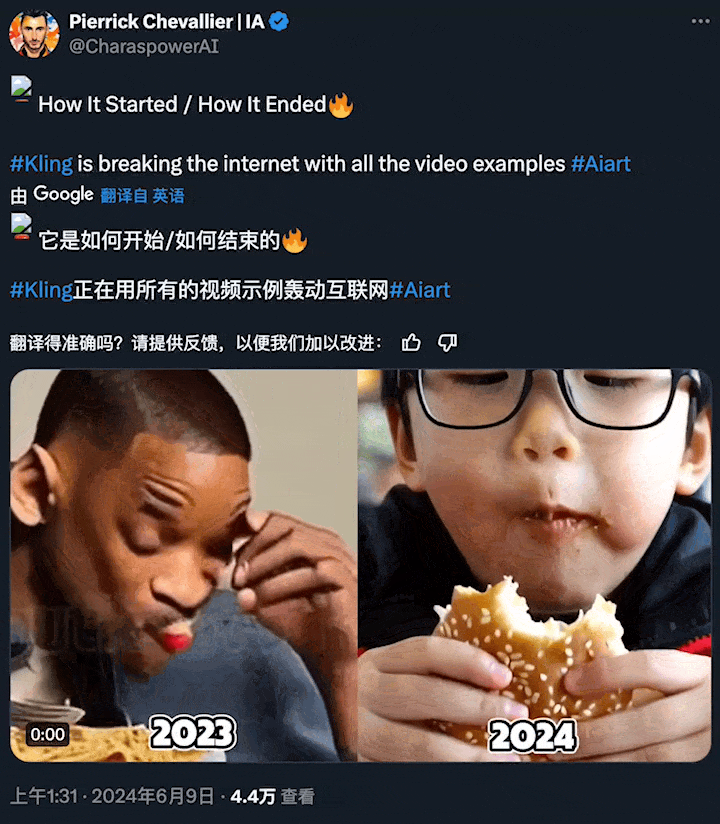
图片

*图源:https://x.com/CharaspowerAI/status/1799494388462063632
*

右侧的这些生成视频,都来自快手刚刚推出的文生视频大模型「可灵」(Kling)。

不是预发布、不是纯 Demo 合集,而是直接开放测试的产品级应用,人人都能申请。而且,可灵支持生成最长 2 分钟、30fps 的 1080P 视频,主打从头脑风暴到可发布作品的「一键转化」。(官网地址:https://kling.kuaishou.com/)

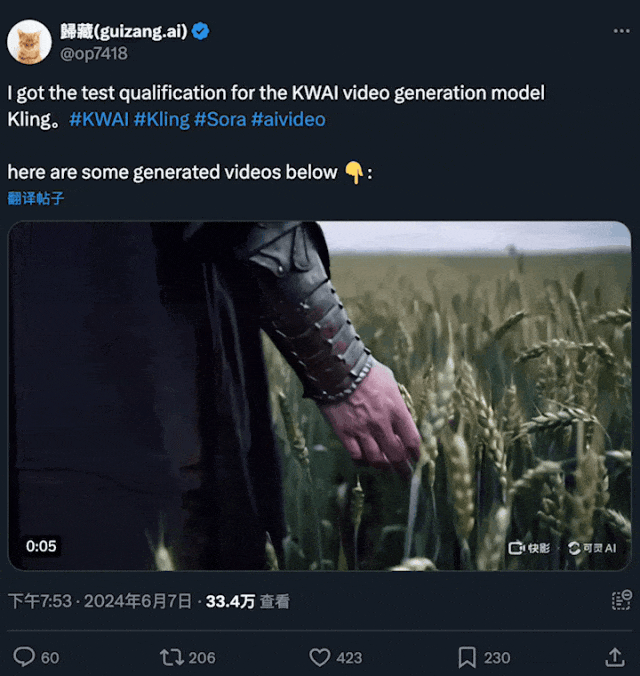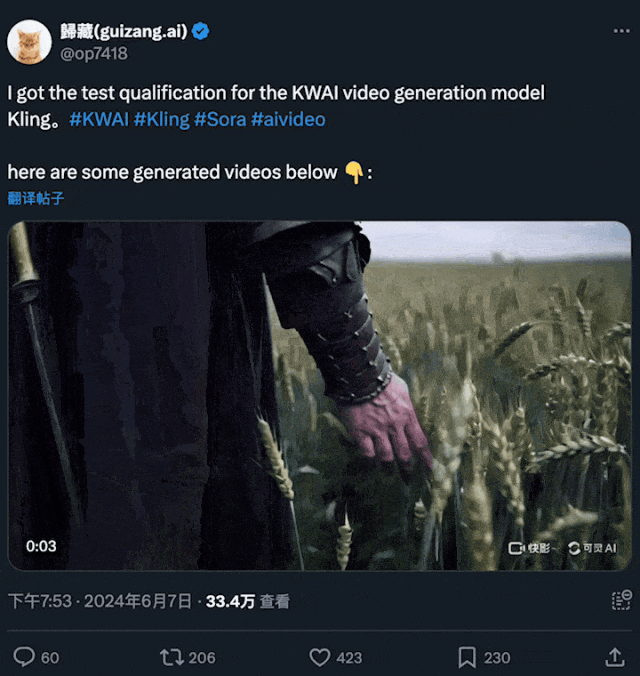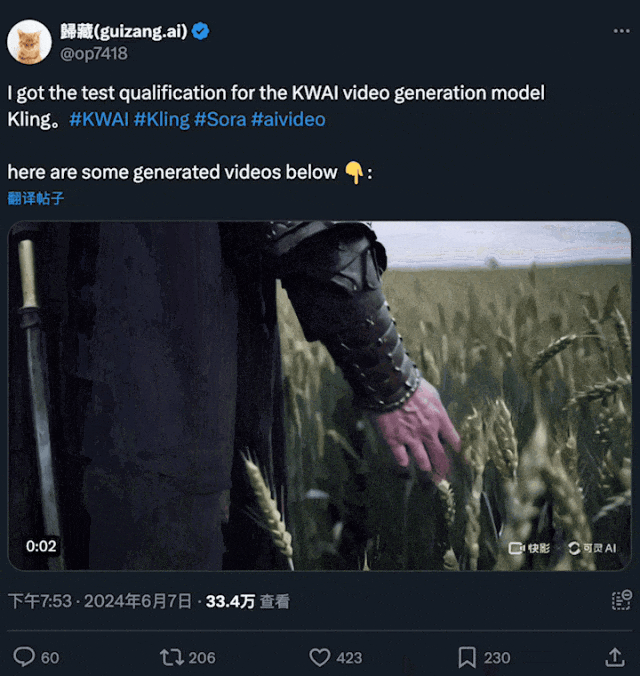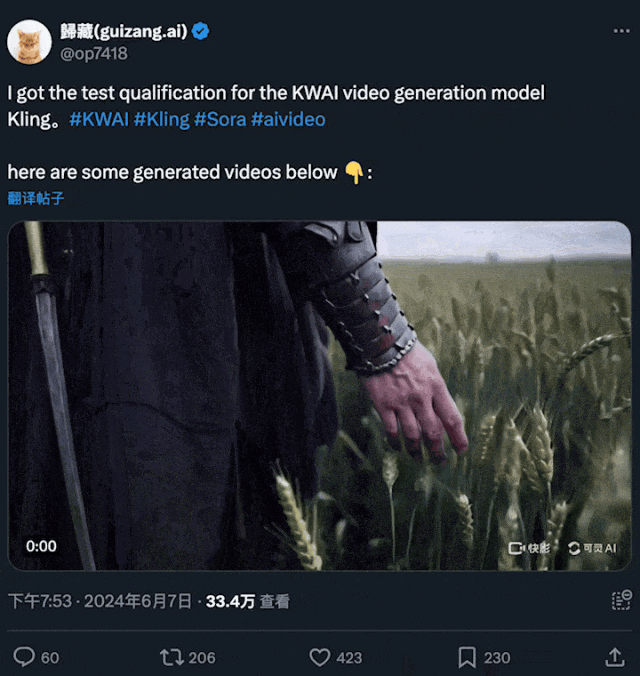
最早一批用上的用户已经「真香」:
图片

图源:https://x.com/op7418/status/1799047146089619589
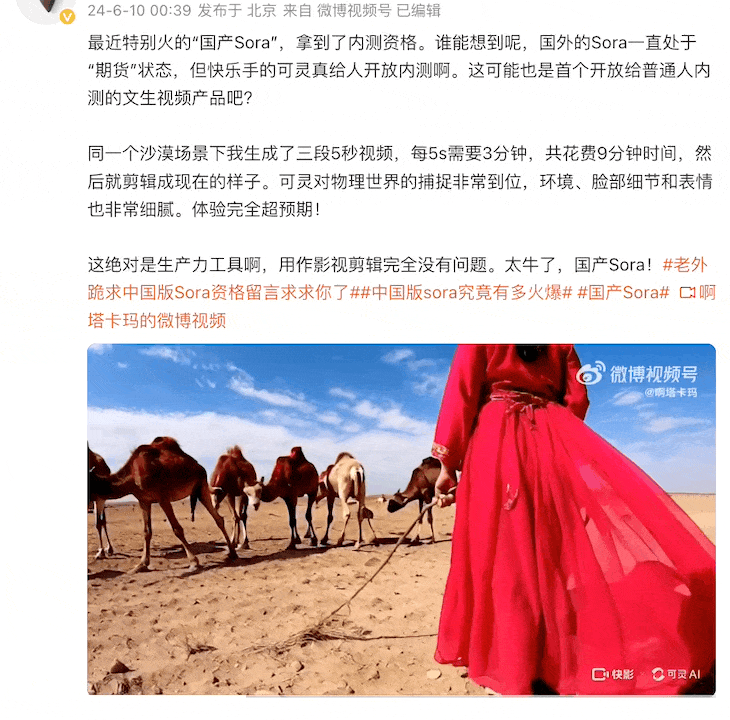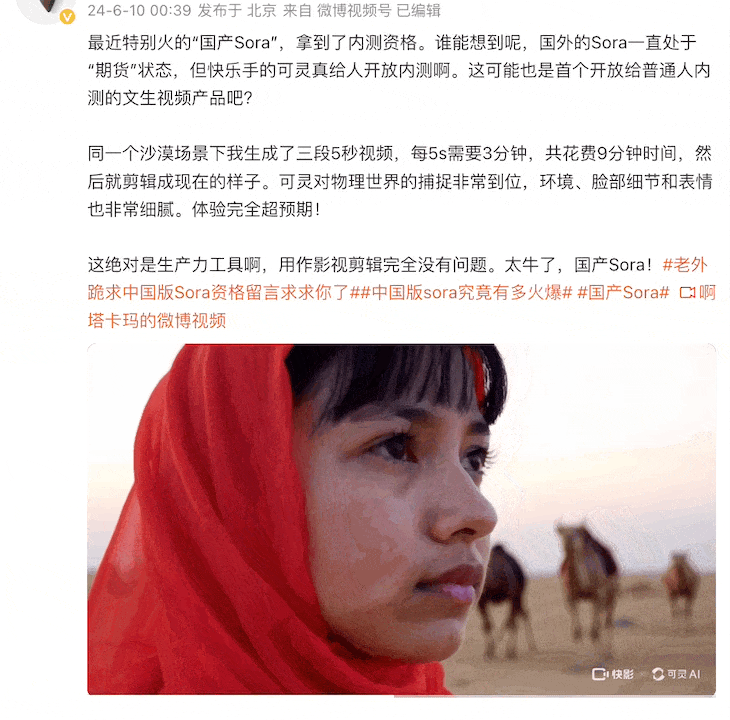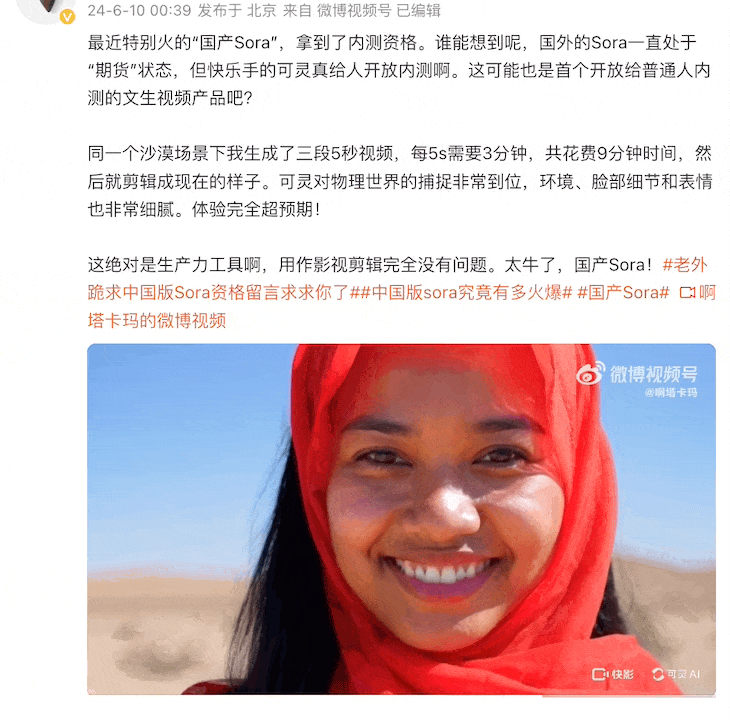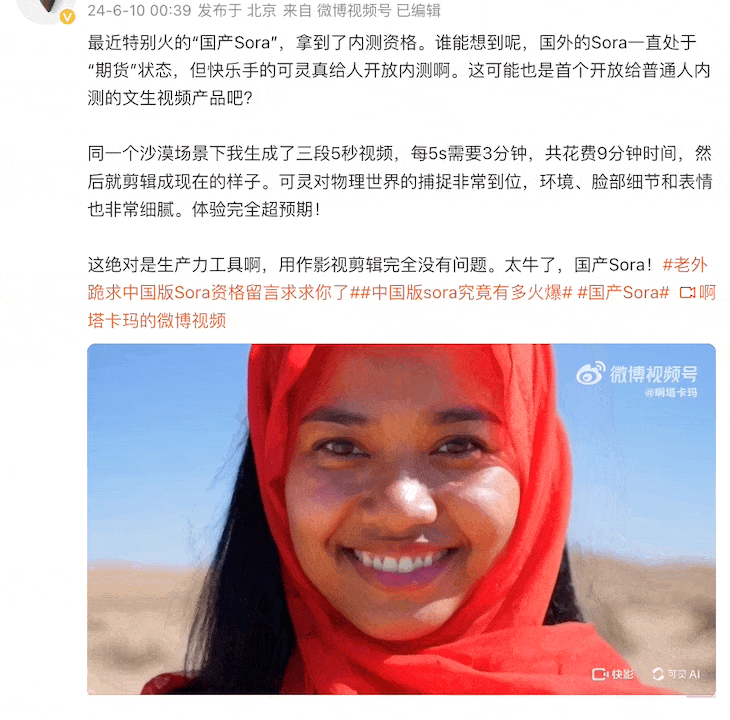
图片

图源:https://weibo.com/7714861068/Oig1Qm8Or?refer_flag=1001030103_

500 人上限的交流群,很快就满员了,满屏都是 tql:

还没用上的外国友人只能干着急,在社交媒体发「求求了」:
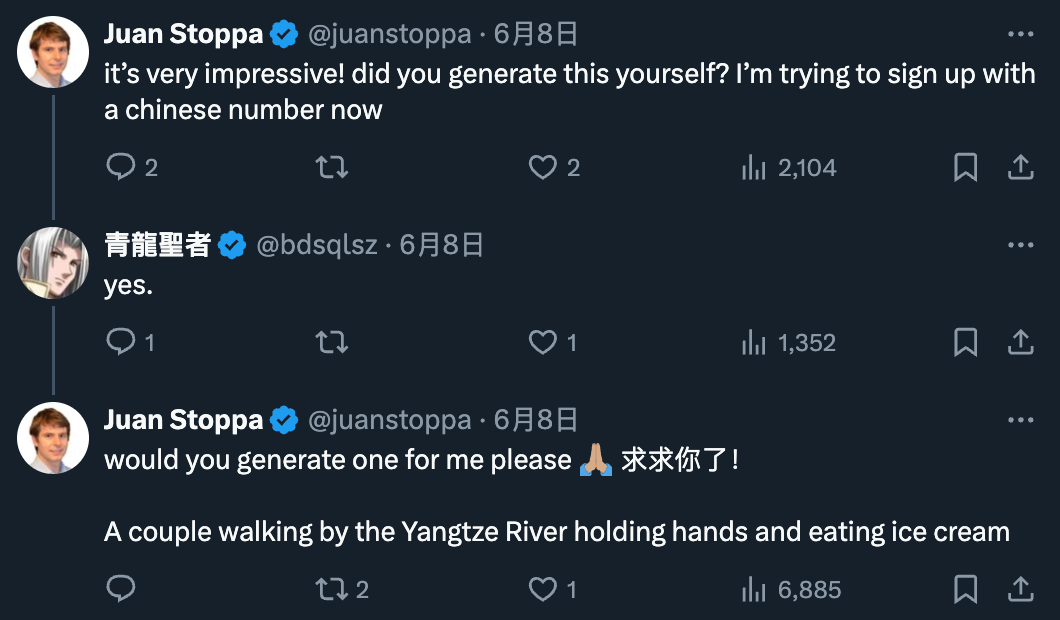
图片

不夸张地说,可灵现在是「一号难求」:

图片

图片

消息传到硅谷创投圈,更是引发了一场热议。

Stability AI 前 CEO Emad Mostaque 表示:「中国的 AI 技术有自己的优势。」

图片

图源:https://x.com/EMostaque/status/1799133463003684918

YC CEO 也在 X 平台转发了可灵生成的 Demo:
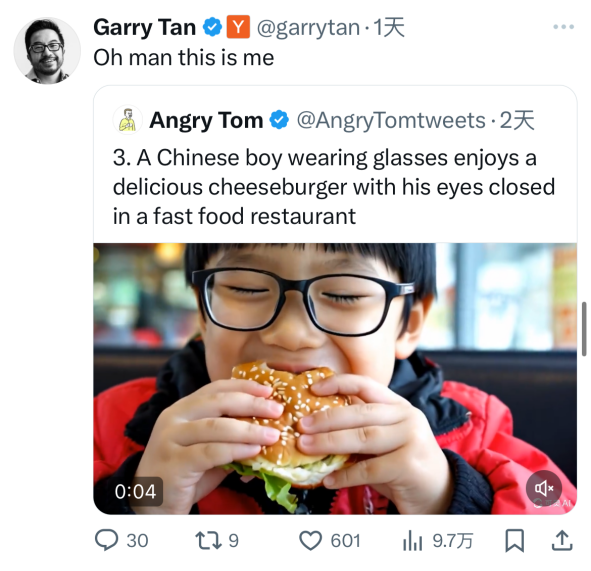
图片

就图中这个「吃汉堡」的案例而言,在相同的提示词下,可灵的生成效果确实比 Sora 更生动、真实:

Prompt:Une personne tapant son meilleur croc dans son hamburger
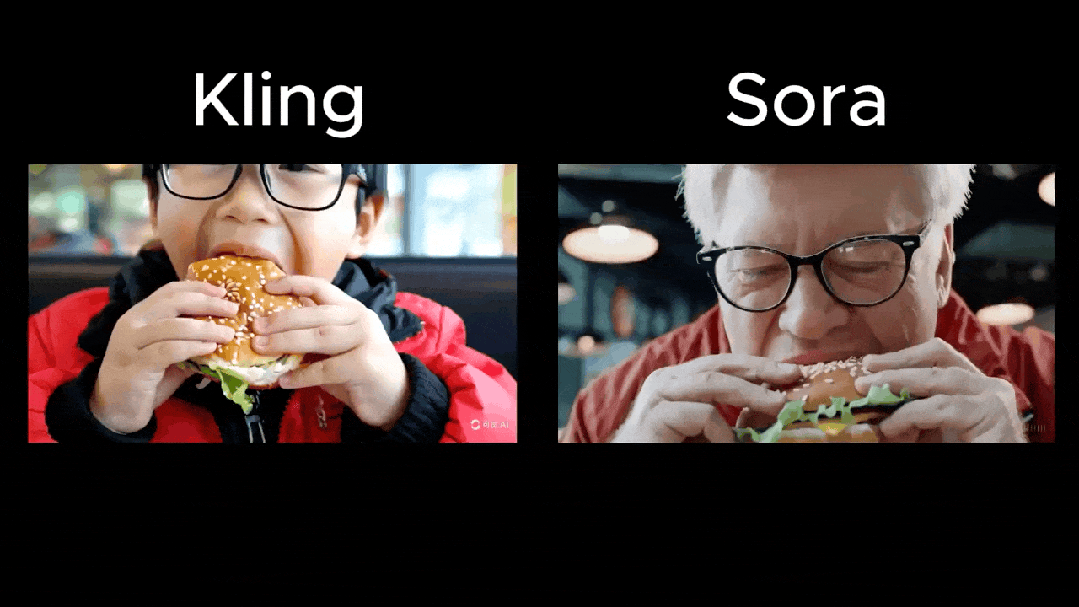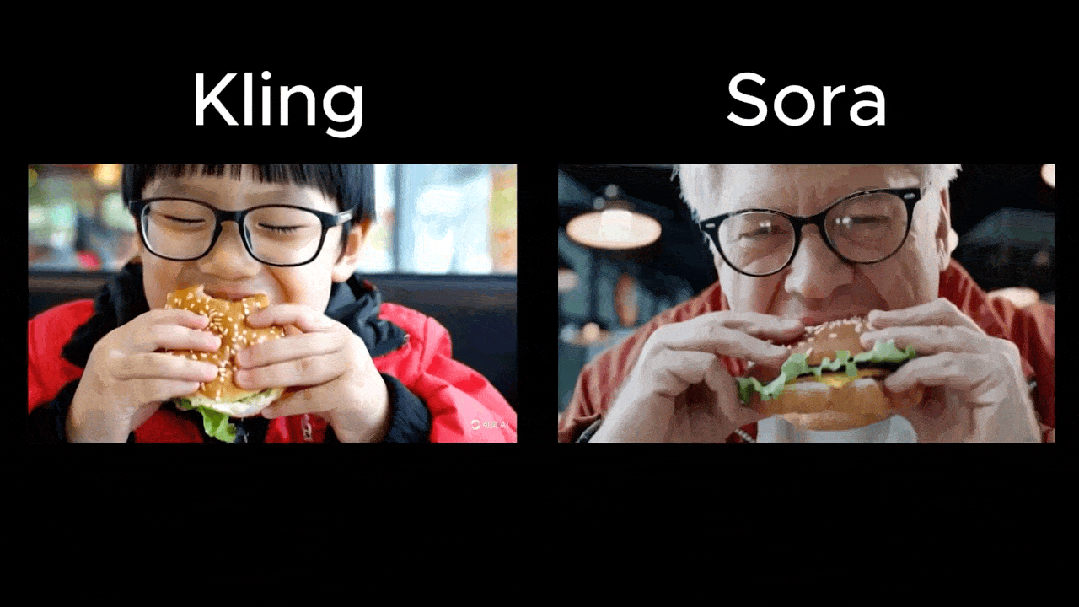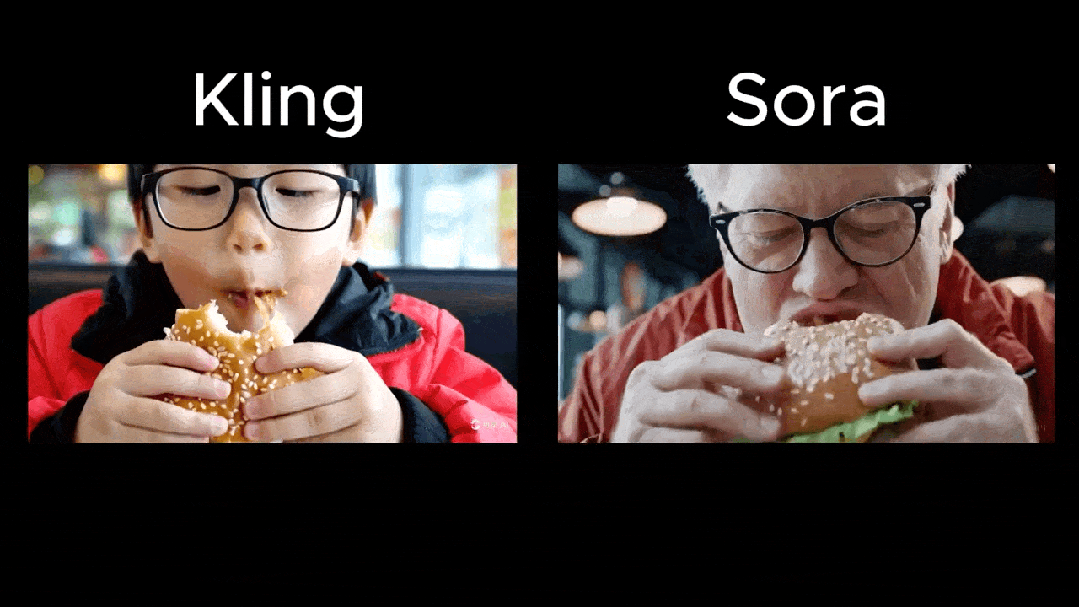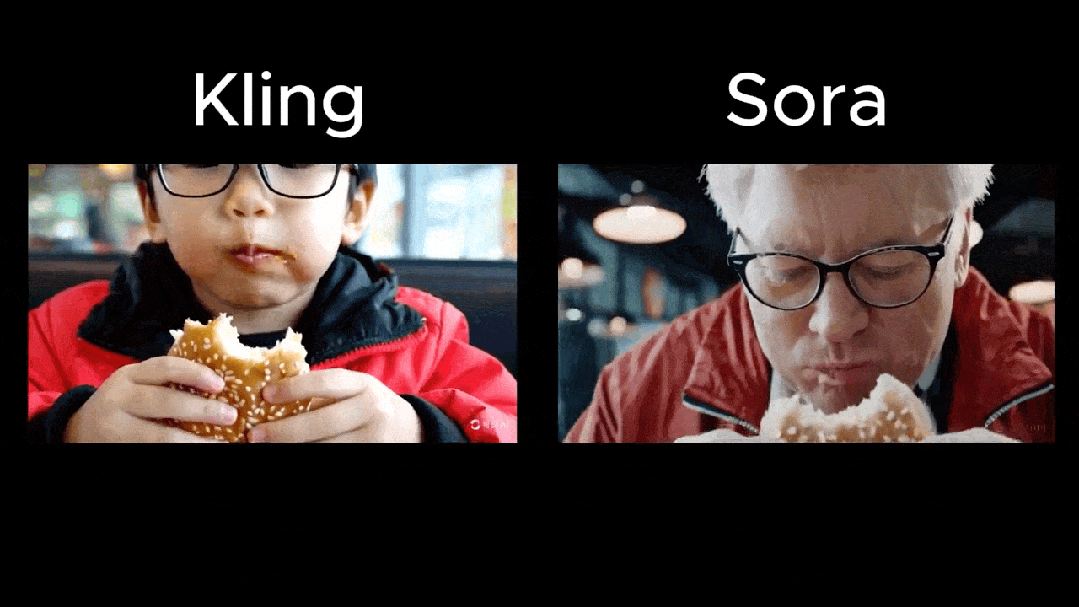
图片

视频地址:https://x.com/AngryTomtweets/status/1799787209651859910

对于关注 AI 的人来说,这几天一定陆陆续续看过很多可灵生成的作品了。机器之心也是第一时间就点进了申请通道,并拿到了试用资格。

接下来,我们不妨一边试用、一边分析可灵爆火的原因。

国内首个文生视频产品级应用

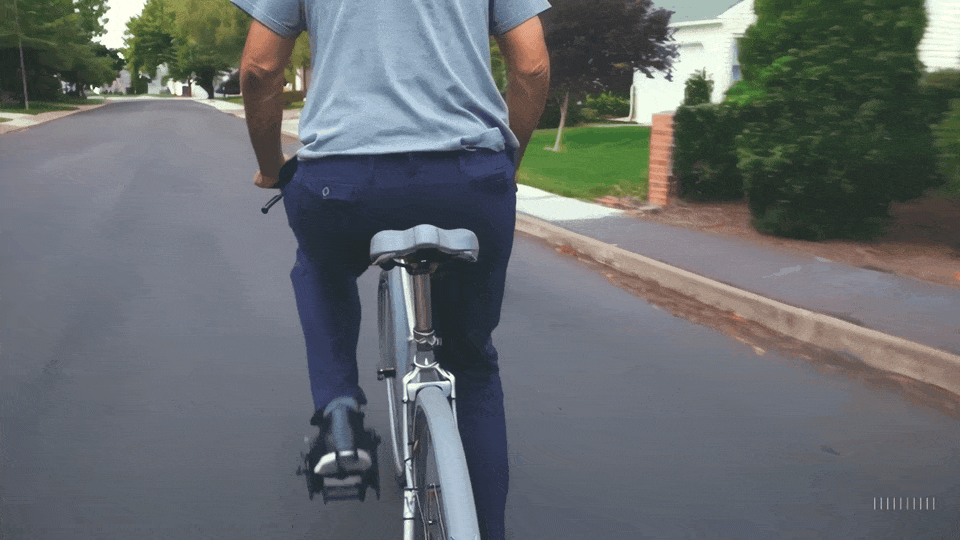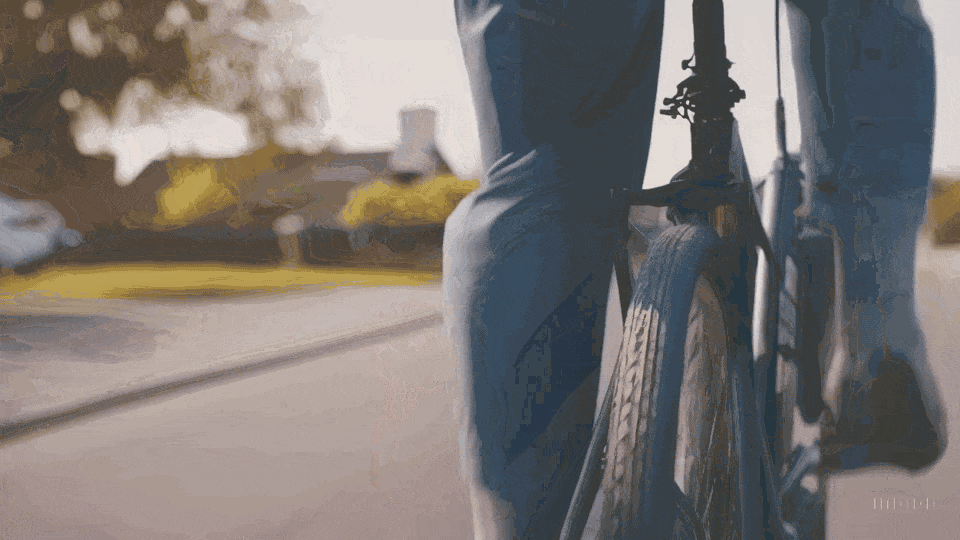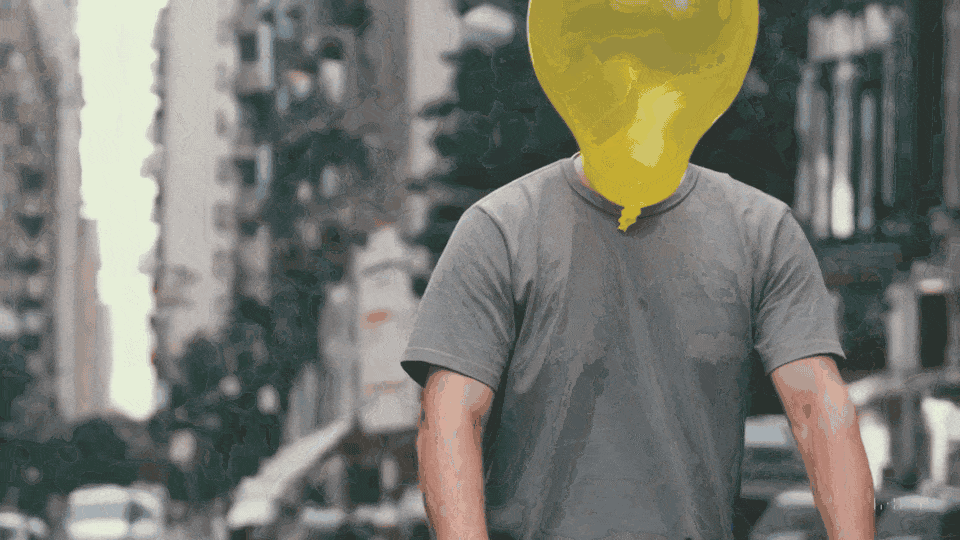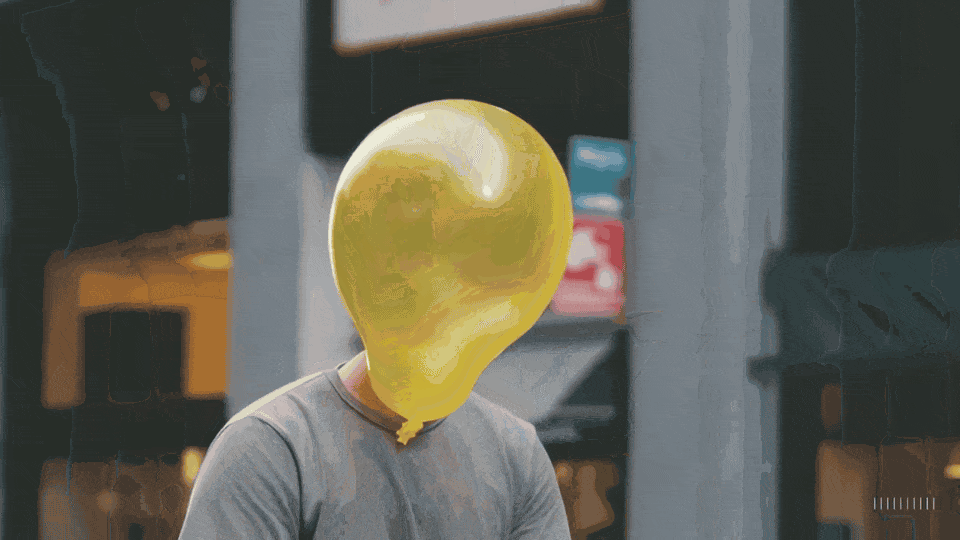
或许你还记得这个曾经非常火爆的「气球人」视频。三位创作者花费近两周时间,使用 Sora 制作了这条 1 分 21 秒的视频短片,让人感到十分惊艳。不过,负责后期制作的 Patrick Cederberg 坦白了过程中的很多问题,例如气球的颜色在每次生成中都会改变、镜头中会出现一些瑕疵等等。
图片

Sora 生成结果。完整视频地址:https://youtu.be/9oryIMNVtto?si=F6oDzvrhzfVcQGeh

对于此前的视频生成模型来说,「一气呵成」生成 1 分钟以上的内容确实有难度,特别是要求画面中的各种元素保持前后一致。

猎豹移动董事长兼 CEO、猎户星空董事长傅盛公开了自己用可灵制作的「气球人」视频,并表示自己仅用了「几十分钟」,就做出了连续性、真实度、清晰度都很优秀的短片。

有很多自媒体博主都晒出了自己做的短片,大家感兴趣的可以自行搜索。

哪些行业最先被改变?

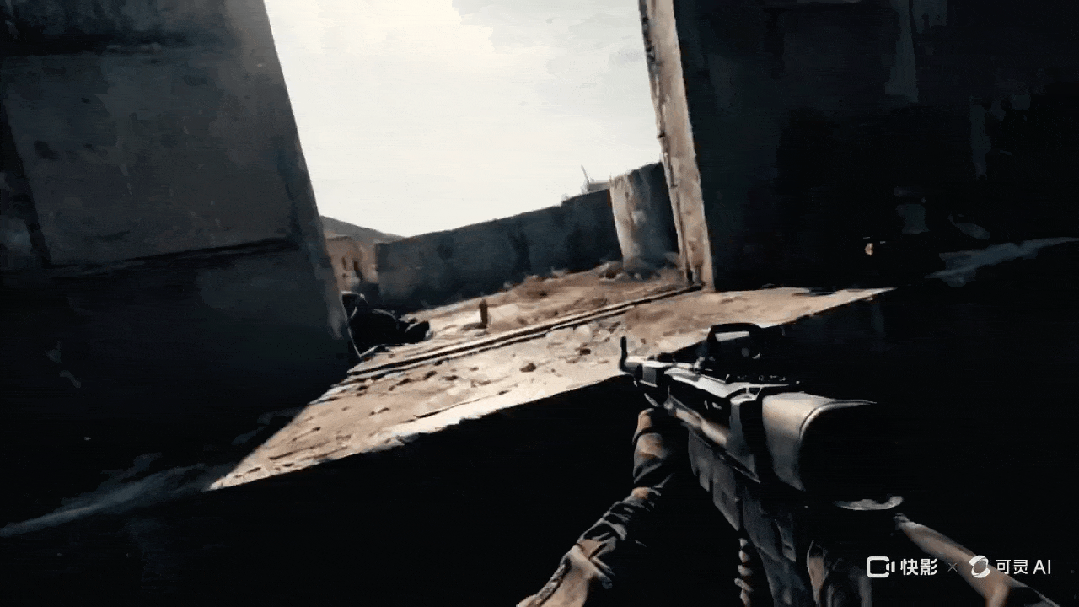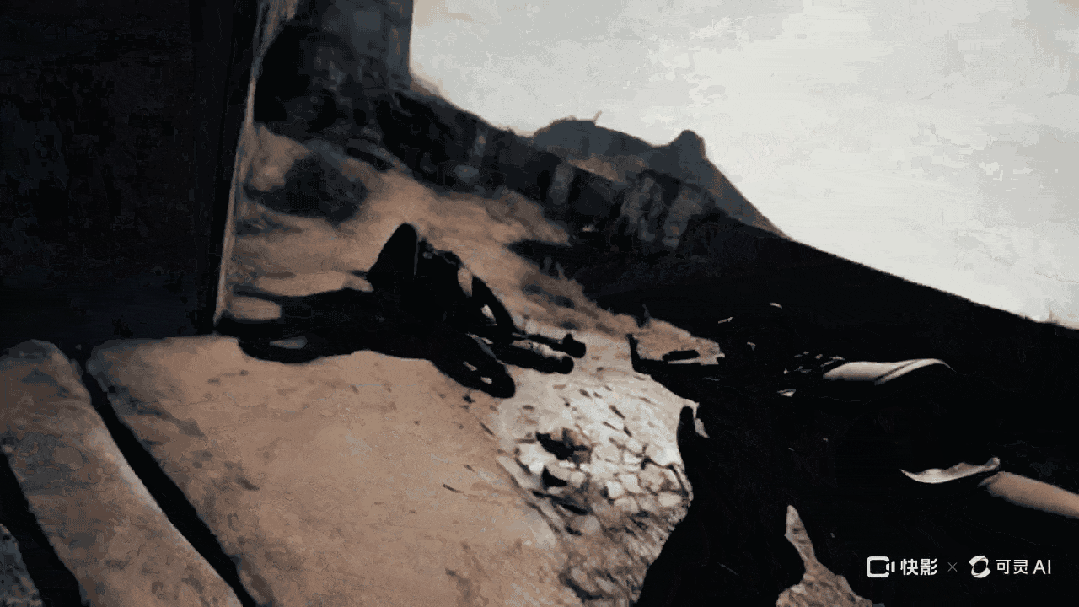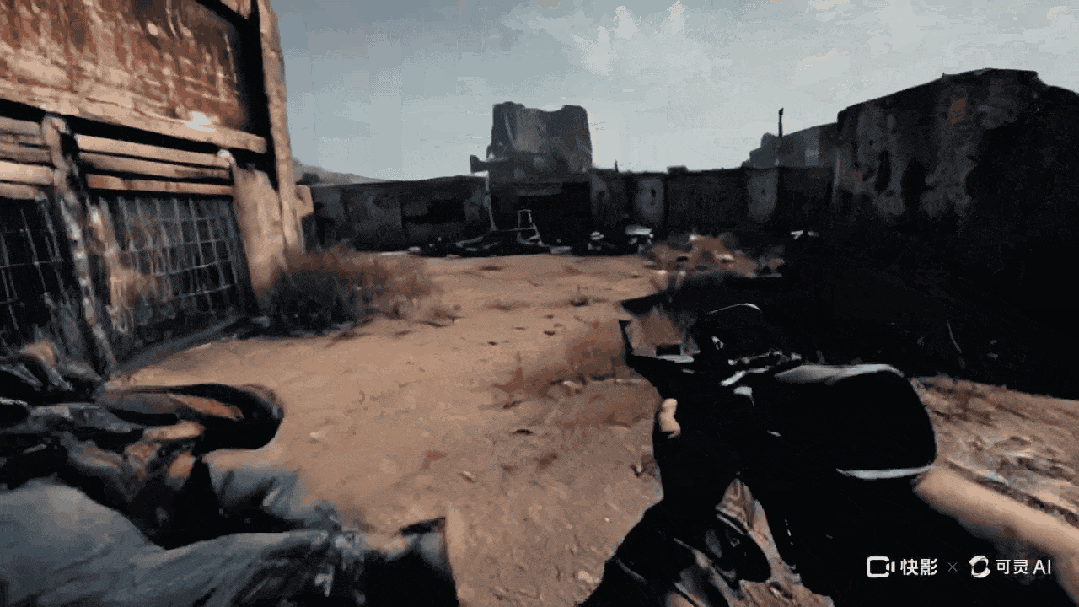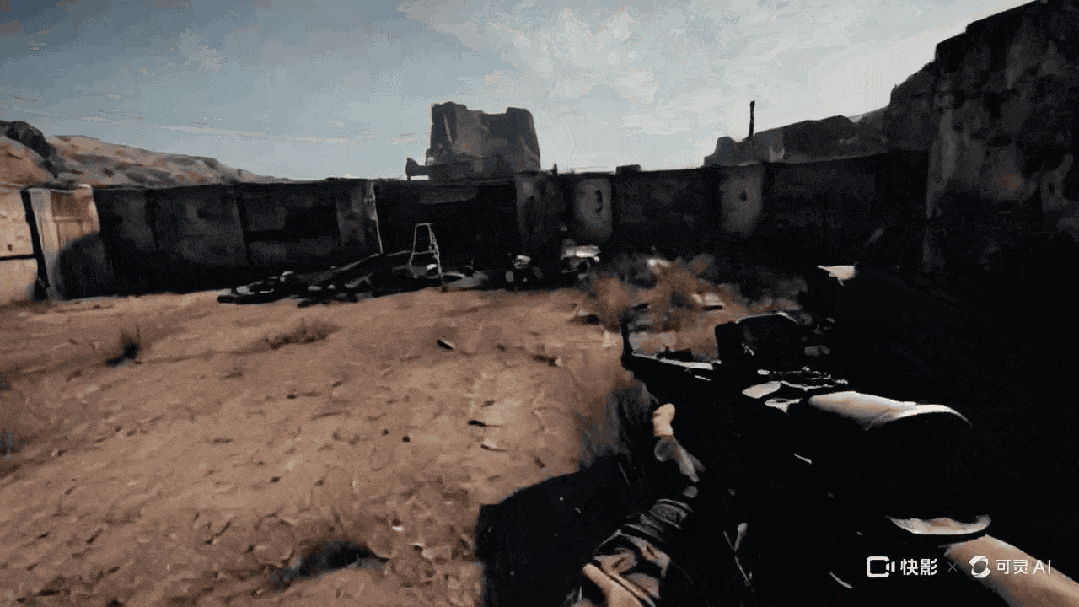
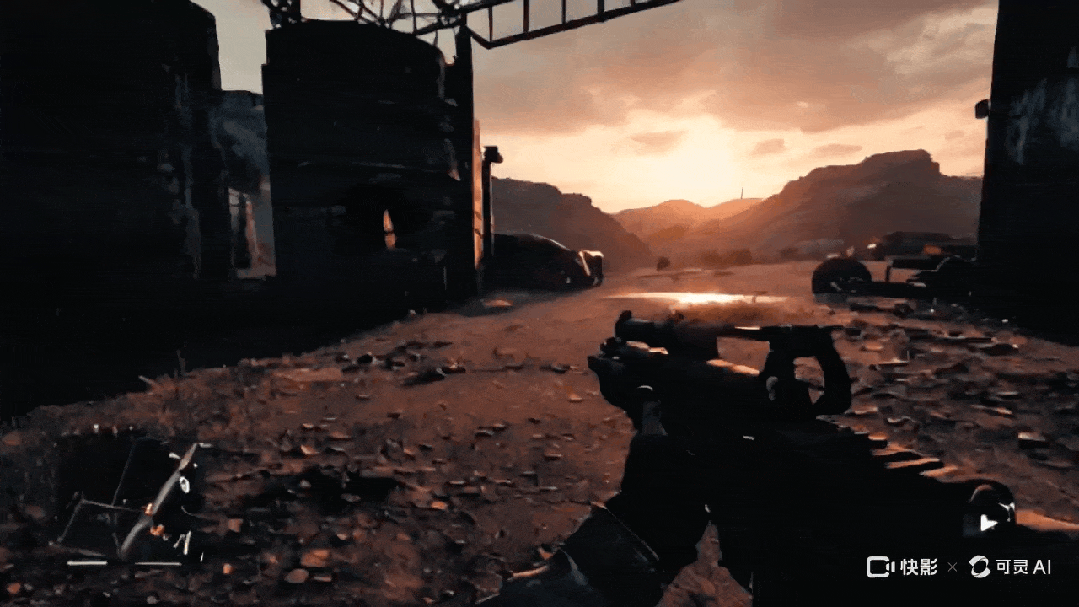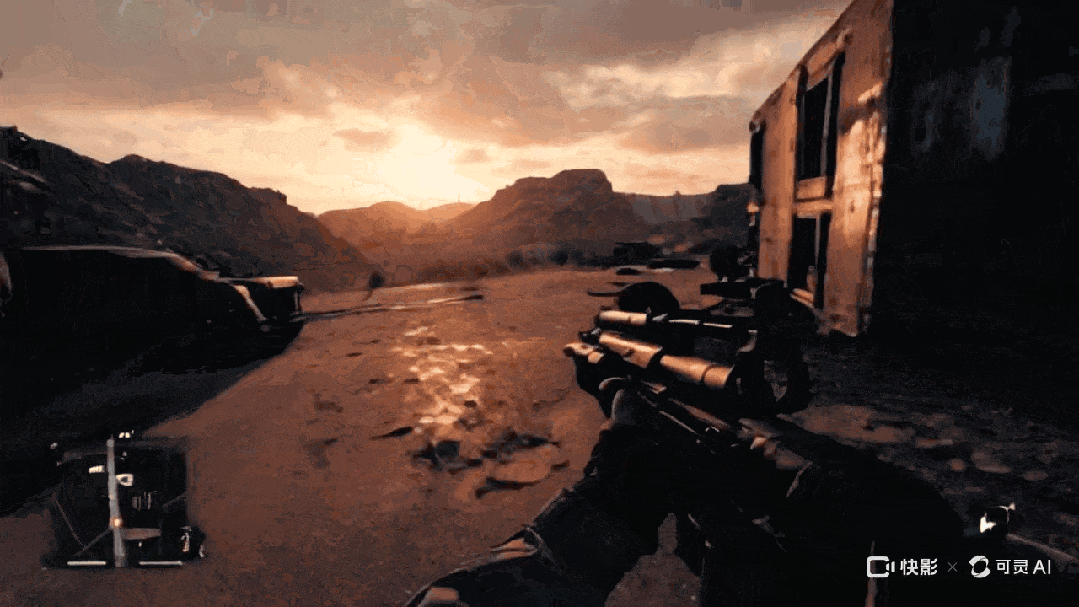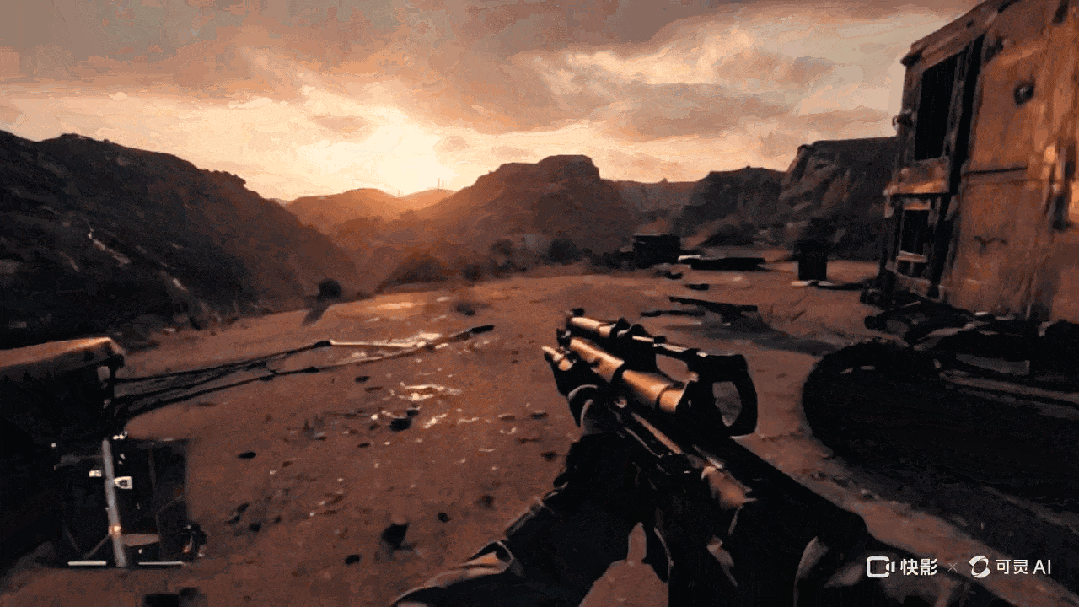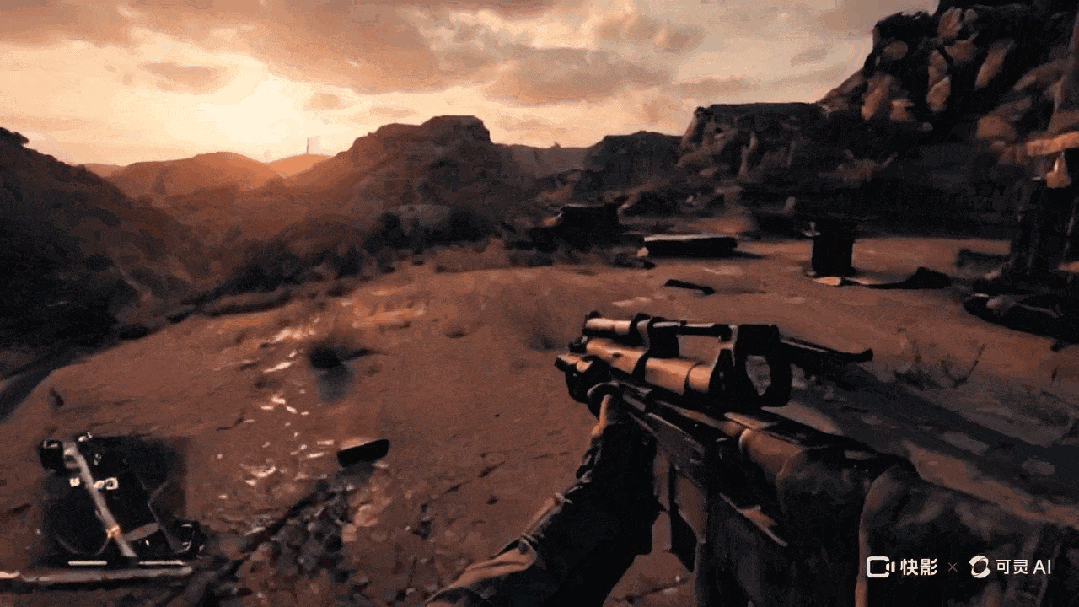
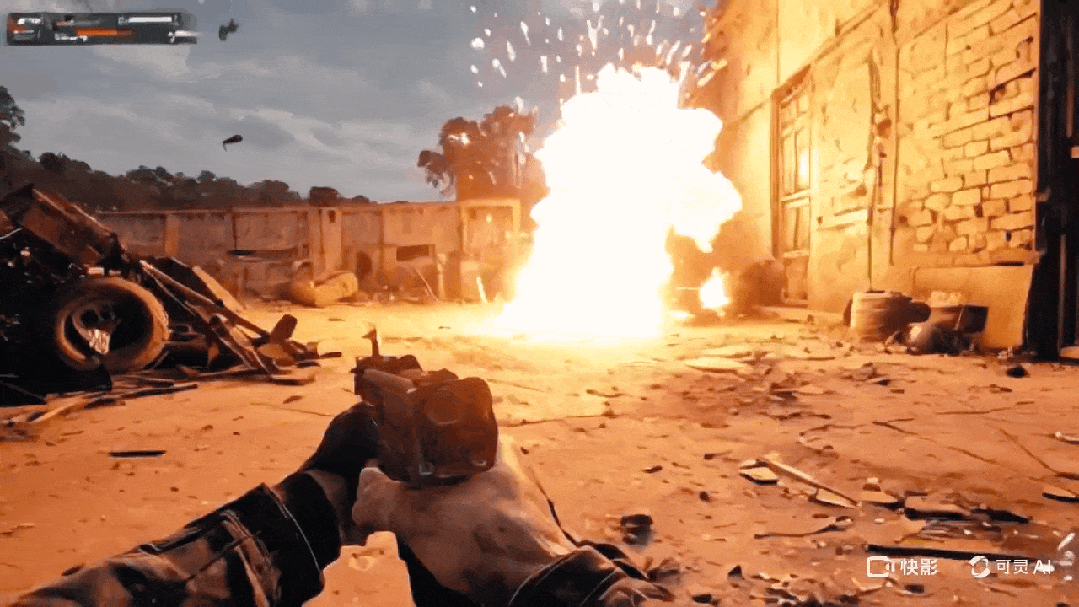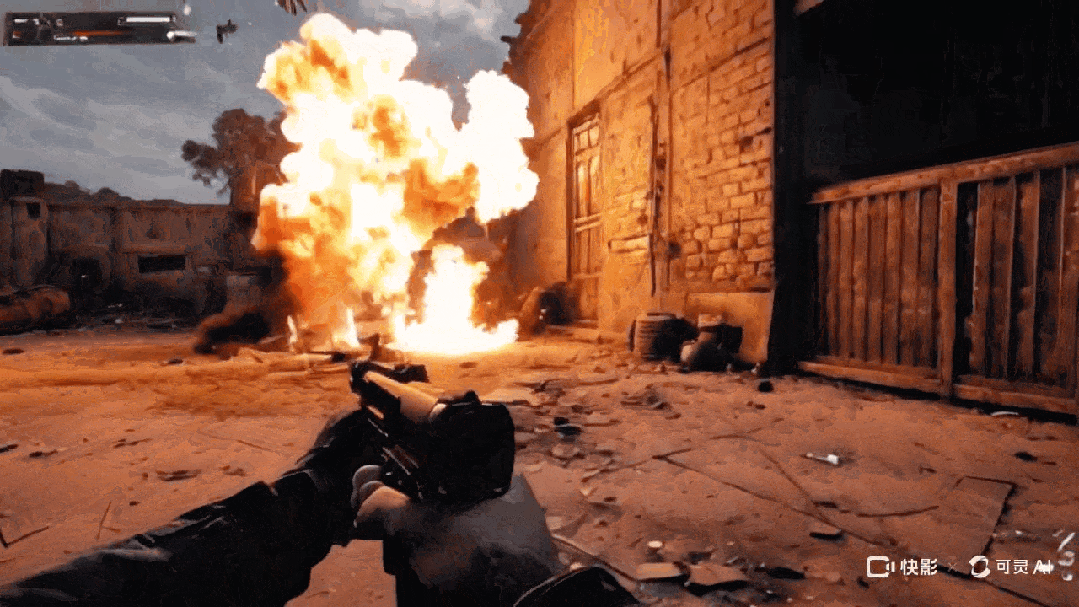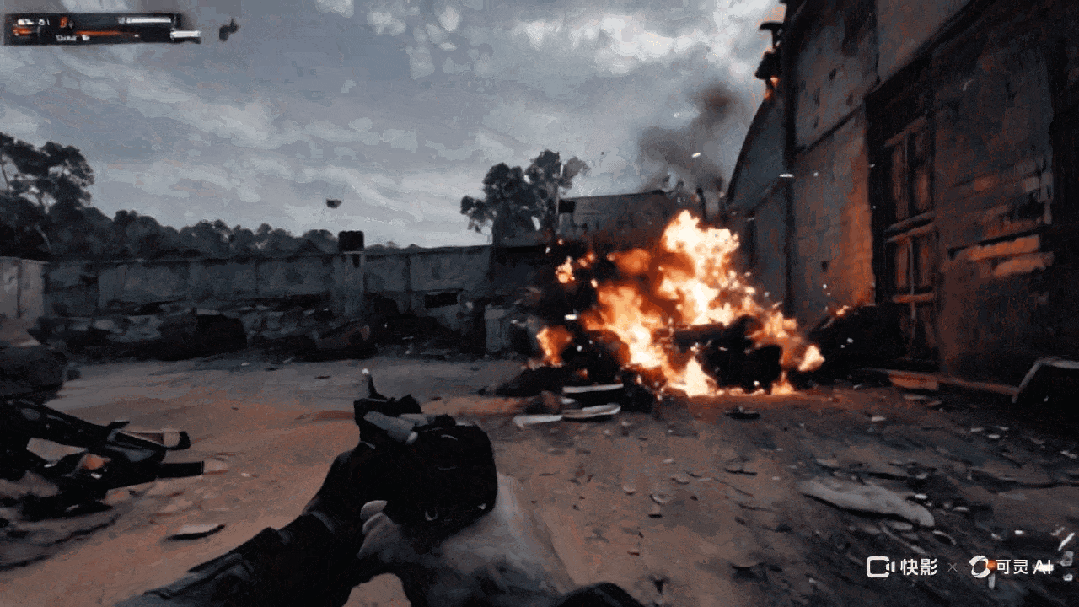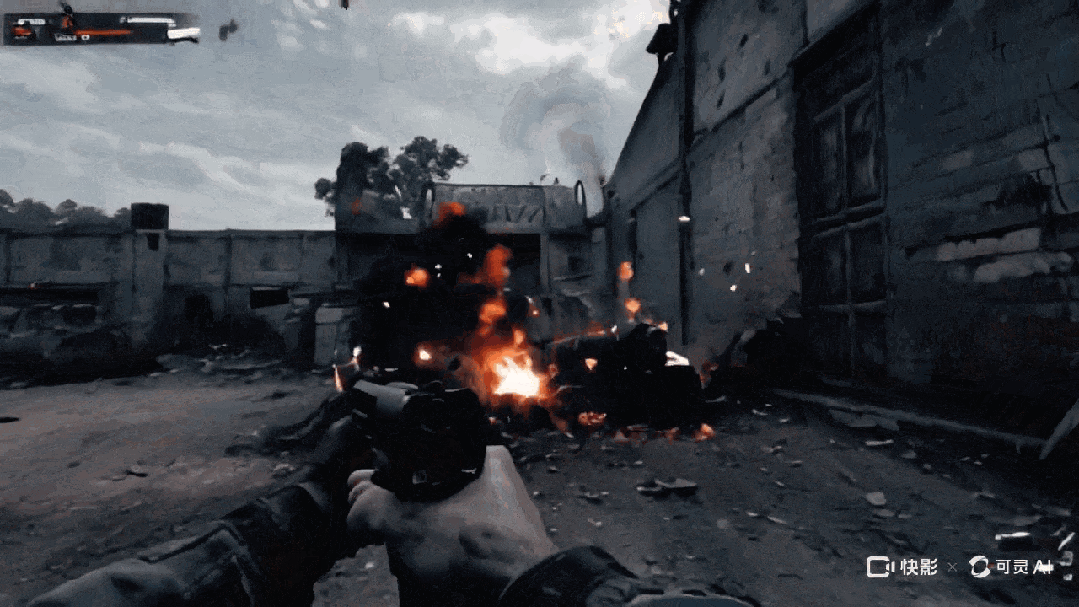
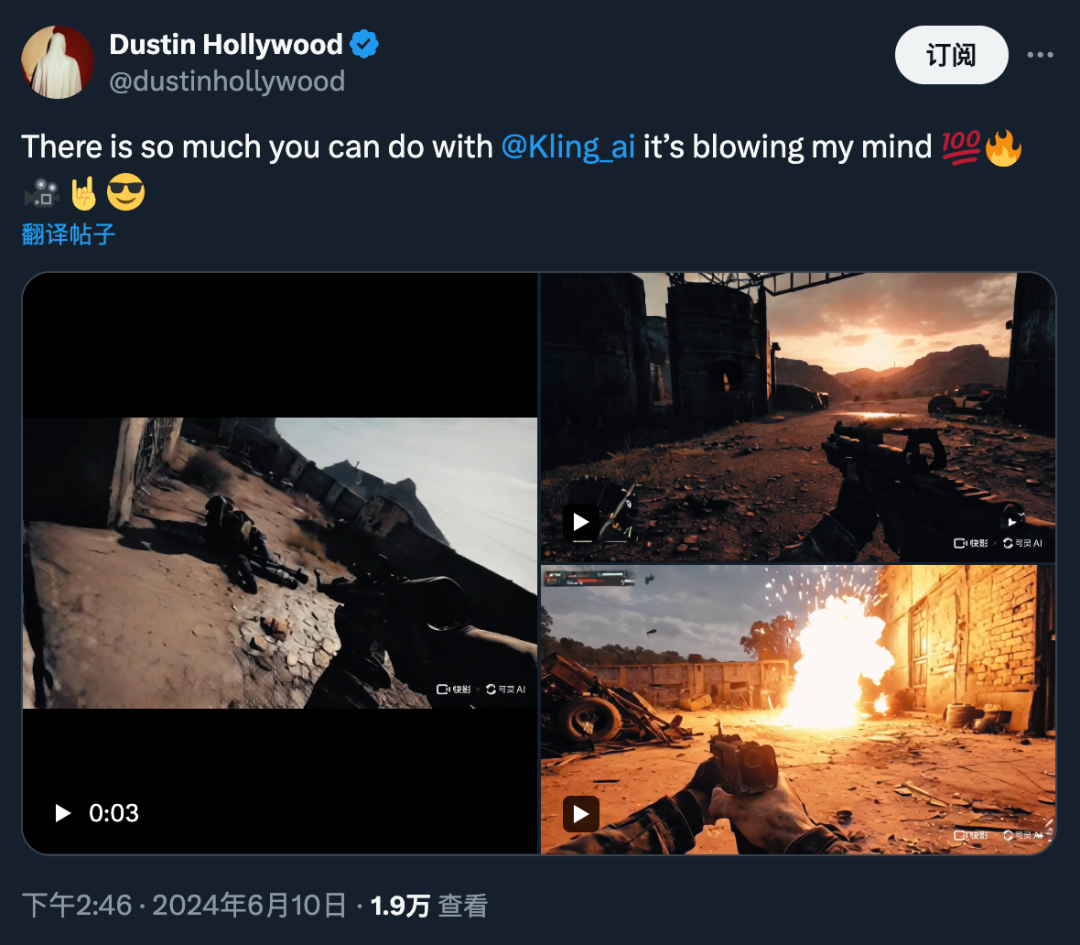
传统的游戏开发通常受到预先渲染的环境和脚本事件的限制。一旦将视频生成模型集成到游戏领域,游戏的开发、玩耍和体验方式都将得到创新,为讲故事、互动和沉浸式体验带来新的可能性。对于游戏开发者来说,最直观的一项玩法是,根据用户叙述生成定制的视觉效果甚至角色动作。

在下方的 demo 中,我们可以看到,用户能够借助可灵创造出无与伦比的身临其境体验:
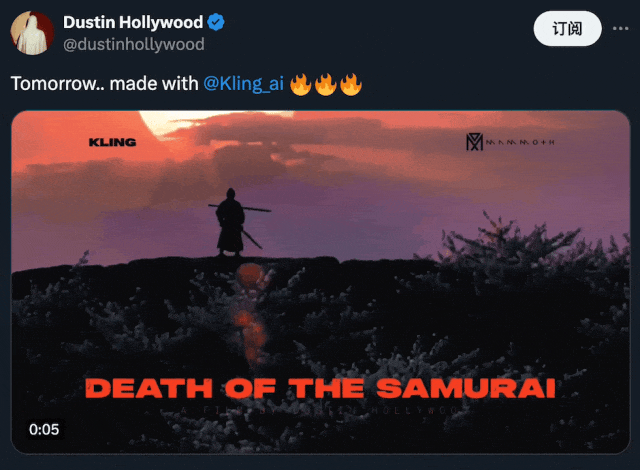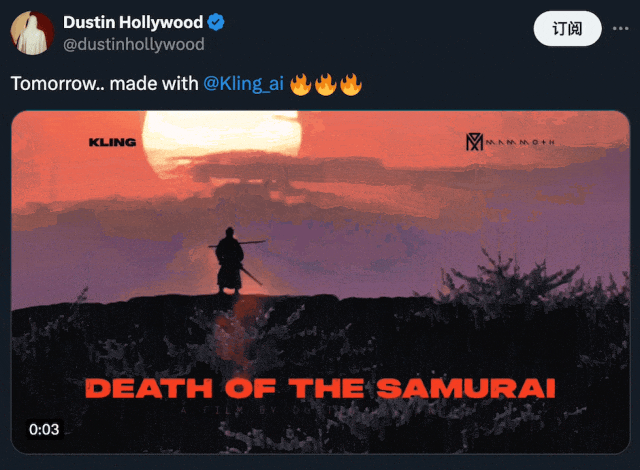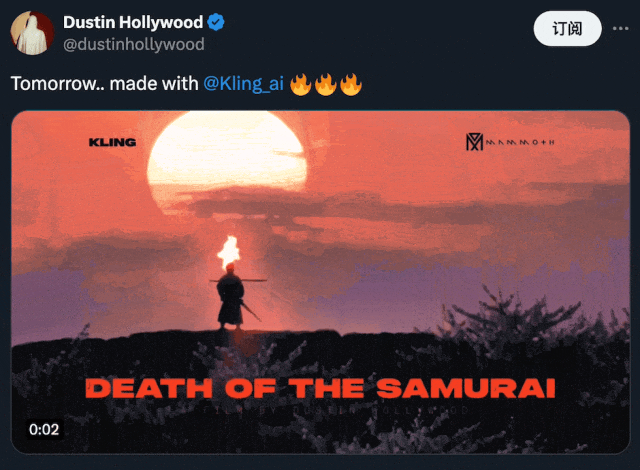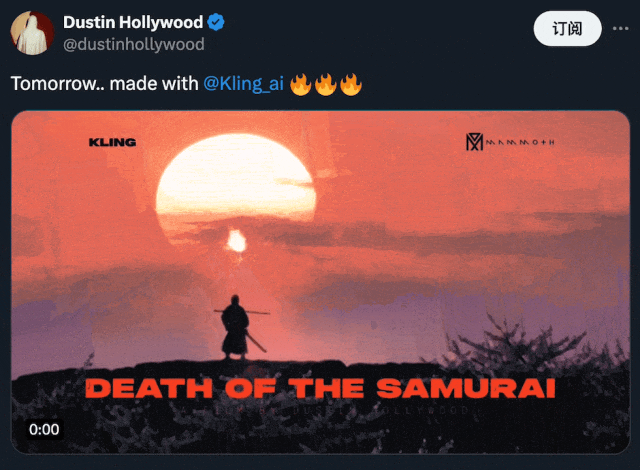
图片

图源:https://x.com/dustinhollywood/status/1800056286215553444
图片

图片

图片

图片

图源:https://x.com/dustinhollywood/status/1800056886693347624

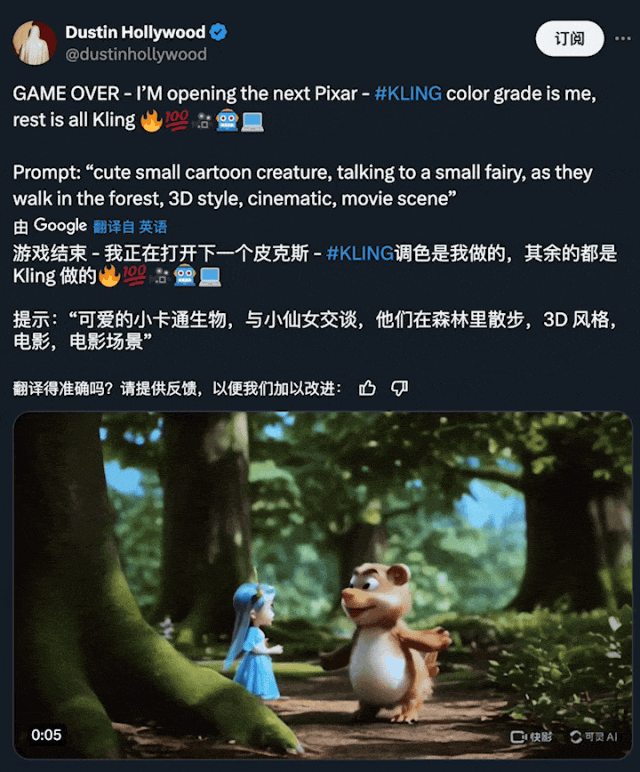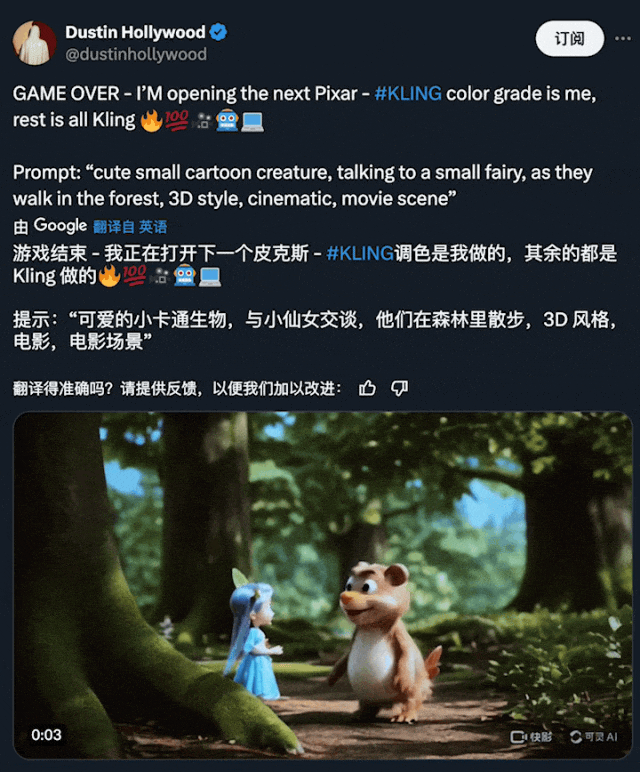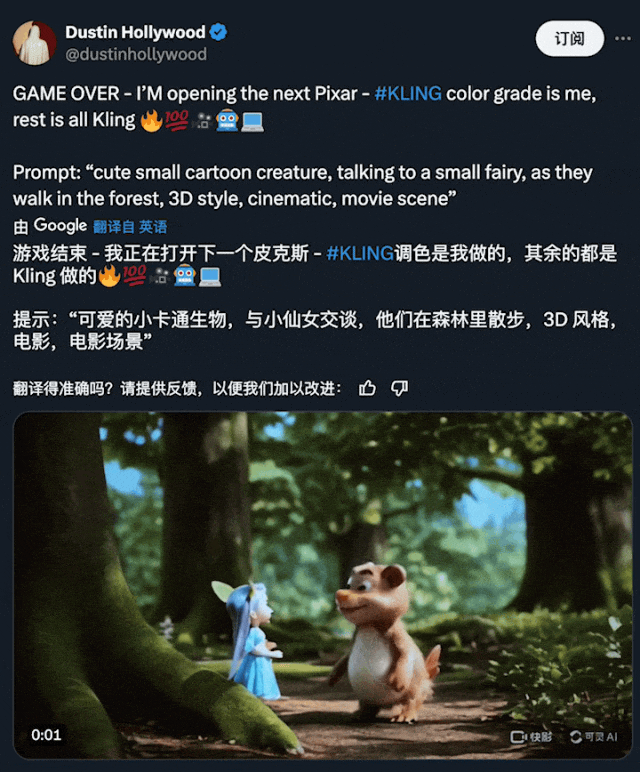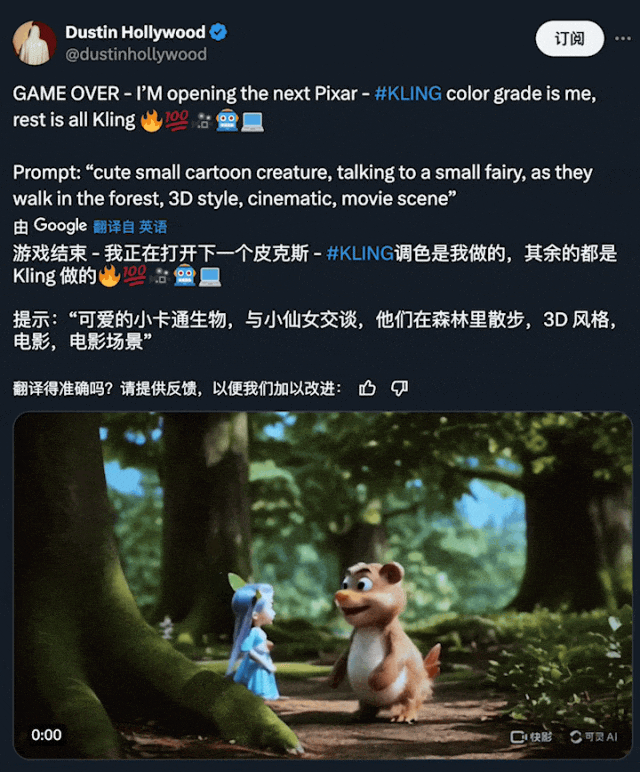
另外一个将被颠覆的行业就是影视制作。传统的电影制作是一个艰巨而昂贵的过程,往往需要数年的努力、大量的设备和资金投入。视频生成技术的出现预示着电影制作进入了一个新的「民主化时代」,从简单的文本输入中自主生成个人影视作品的梦想正在成为现实。

现在,我们用可灵生成的是 5 秒的单镜头片段,伴随着技术的不断演进,用户单次能够生成的视频时长也会增加。比如说,我们未来或许能够一次性生成更长的视频内容,保持故事场景的连贯性和观赏性。其中的运镜手法也许会更高级,比如连贯的长镜头。
图片

图源:https://x.com/dustinhollywood/status/1800007000849629674

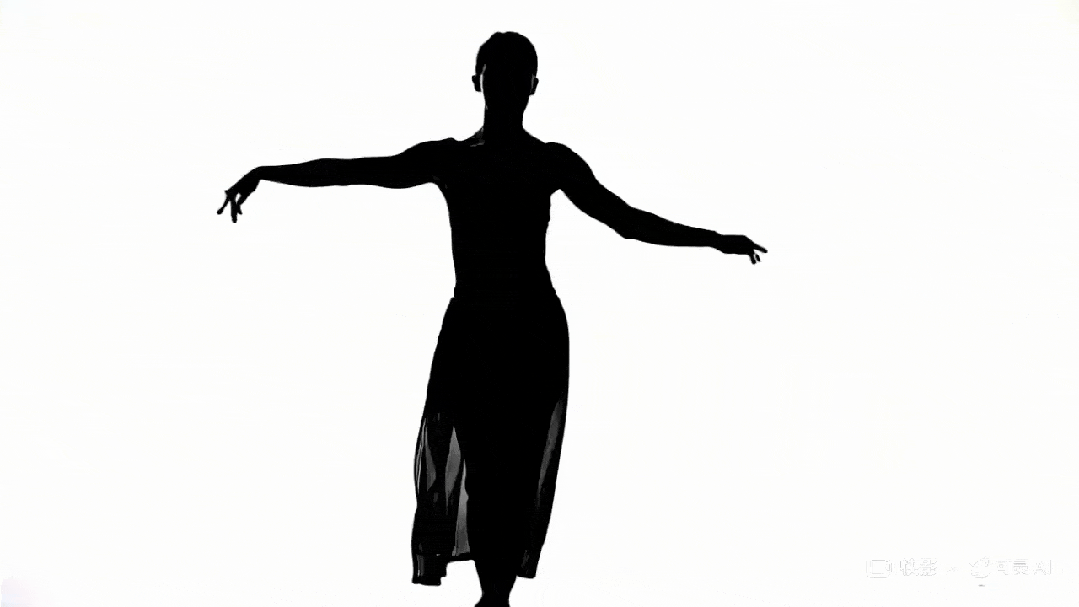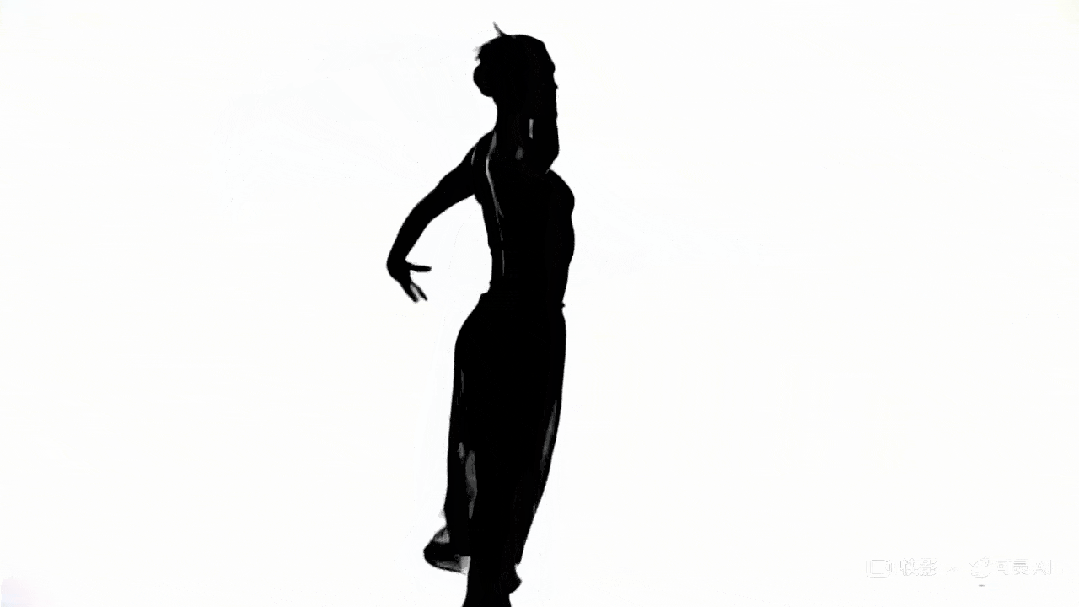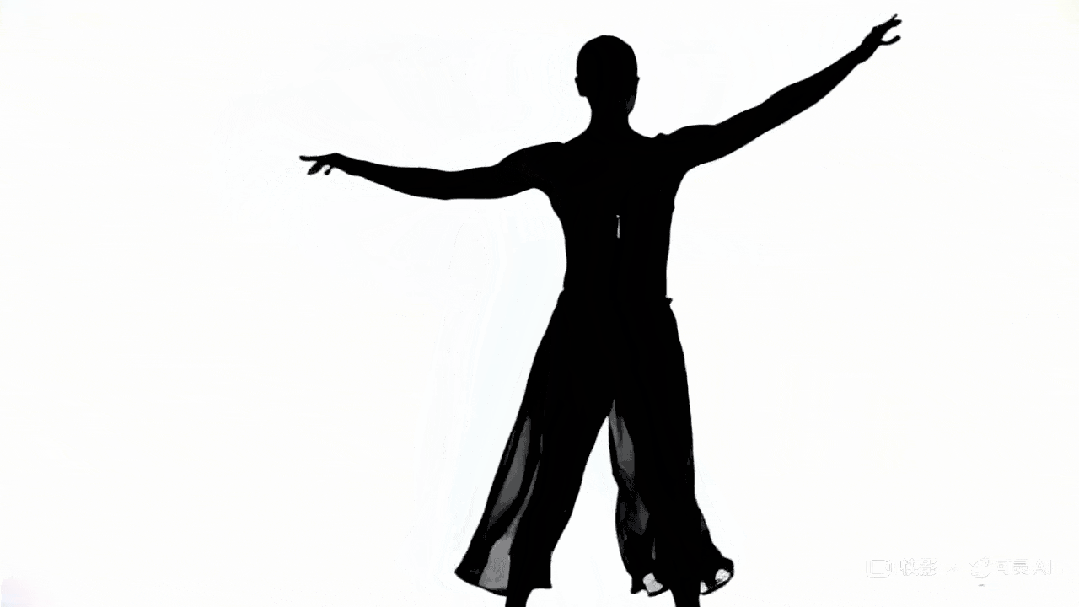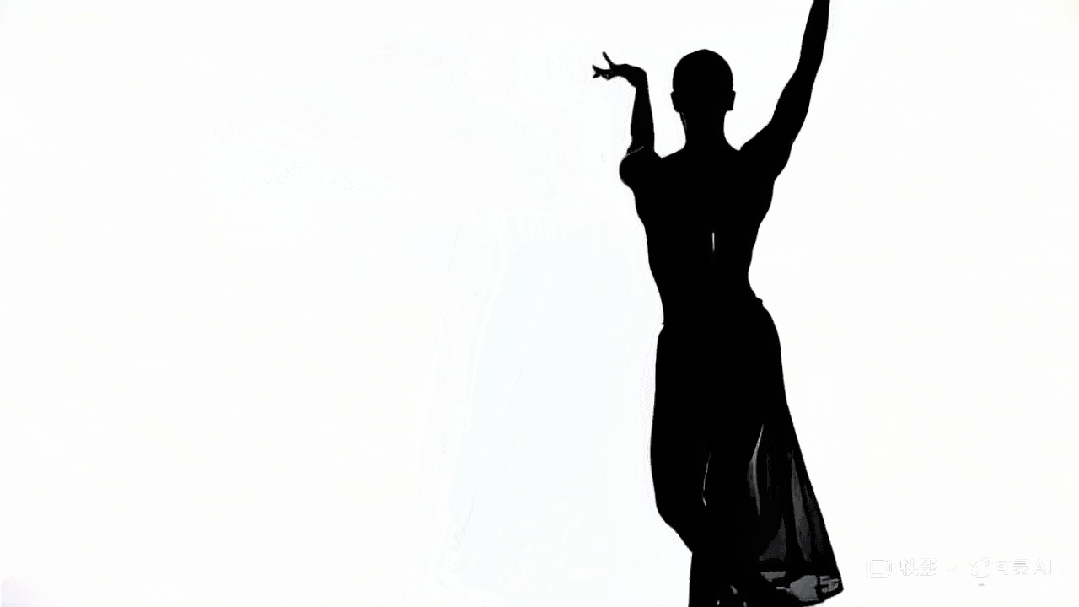
下面这段剪影作品再次印证了一点:AI 对艺术的理解力与审美水准,丝毫不逊于人类。

*Prompt:“A dancer’s silhouette transitions seamlessly through different dance styles, from hip-hop to ballet, in one continuous shot”*
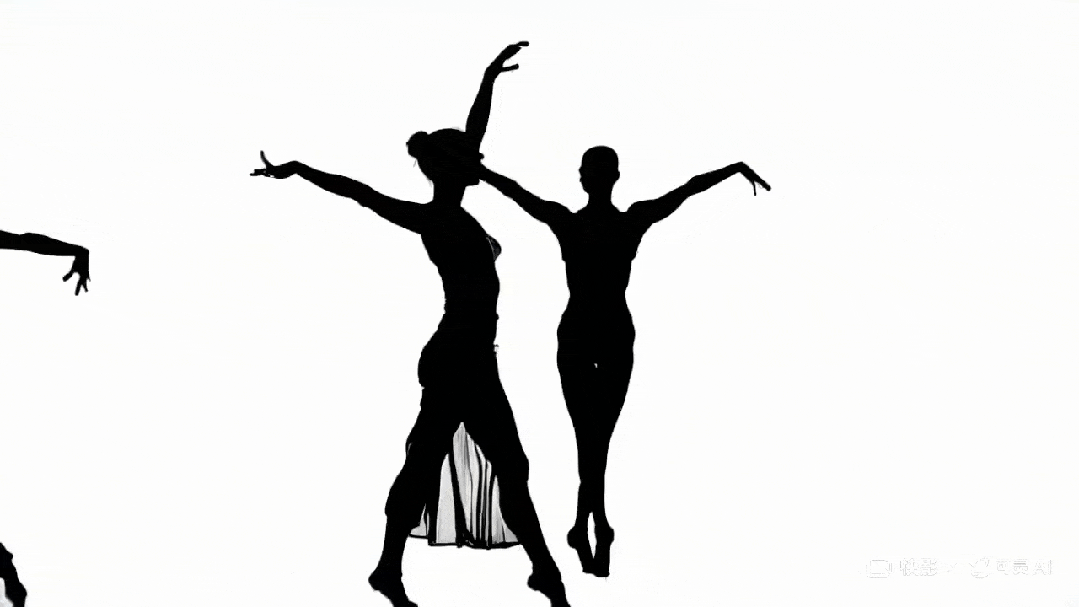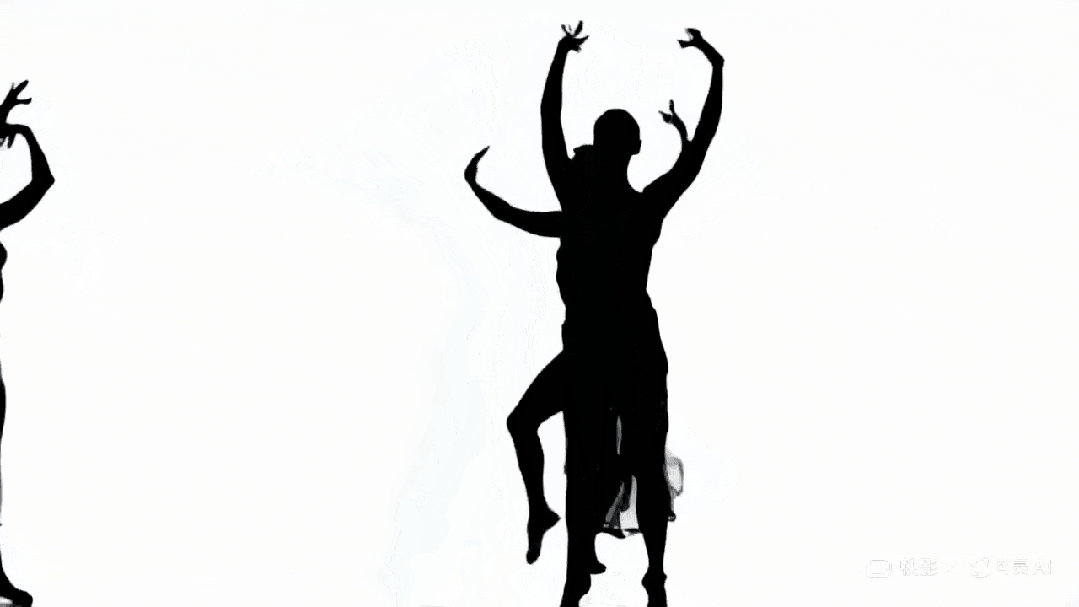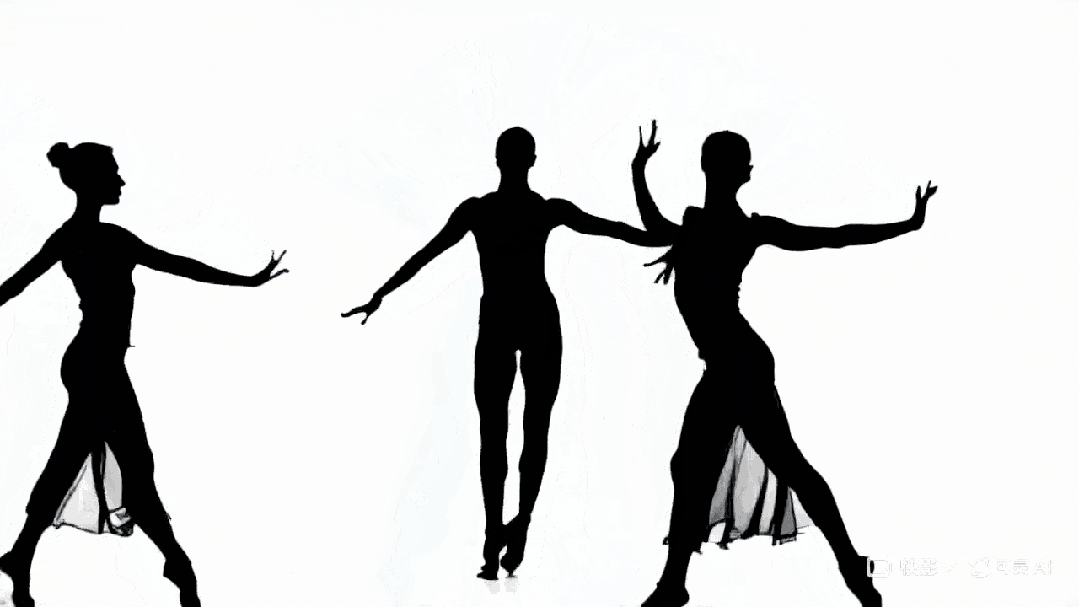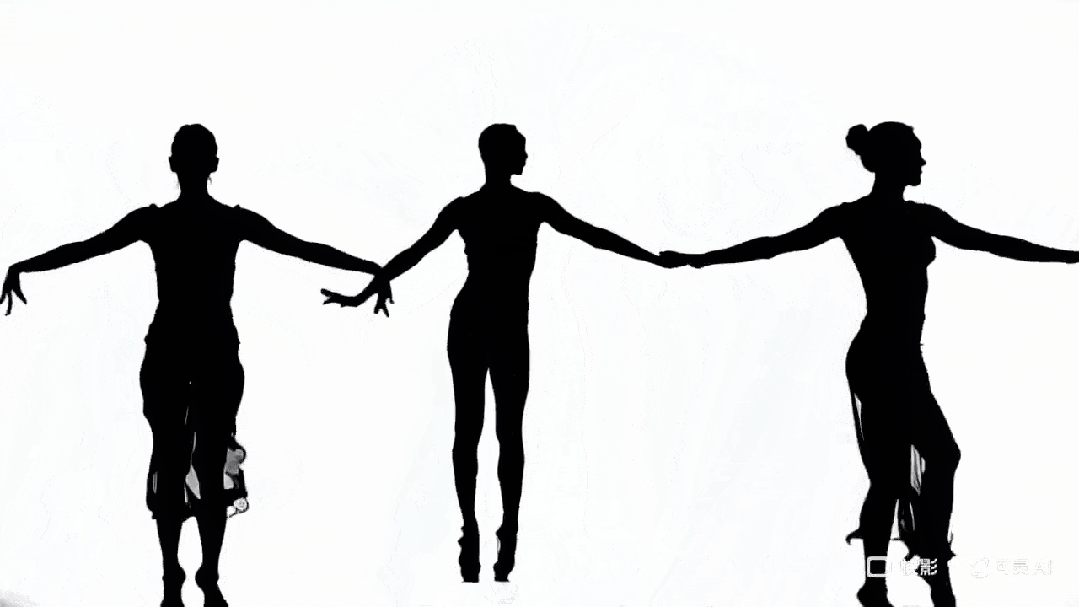
图片

图片

可灵生成作品。图源:https://x.com/dustinhollywood/status/1799970059957555210

可灵背后有哪些技术?

我们无法从 OpenAI 简略的技术报告中获得足够的 Sora 研发细节,但可灵大模型官网却披露了更具参考意义的信息,主要包括从数据准备、模型架构、训练方案及优化策略几个方面。

数据准备

依托快手在视频技术领域的多年积累,可灵大模型团队已经构建了完备的标签体系,包括从视频基础质量、美学、自然度等多个维度对视频数据质量进行刻画,并针对每一个维度设计多种定制化的标签特征,以此来精细化筛选训练数据或调整训练数据的分布。

为了满足训练文生视频模型过程中成对的视频和文本描述需求,可灵大模型团队自研了视频描述模型,可以生成精确、详尽、结构化的视频描述,显著提升视频生成模型的文本指令响应能力。

模型架构

高质量的标注数据准备完毕后,可灵大模型又是如何获得模拟物理世界特性与概念组合的能力呢?

在整体架构设计上,可灵采用了目前火热的 Diffusion Transformer (DiT) 。传统的扩散模型主要利用包含下采样和上采样块的卷积 U-Net 作为去噪网络骨干。但一些研究表明,U-Net 架构对扩散模型的良好性能并非至关重要。通过采用更灵活的 Transformer 架构,扩散模型可以使用更多的训练数据和更大的模型参数。DiT 就是这个研究思路下的代表作之一。

这几个月来,业内形成一个共识,视频生成模型的成功,归根结底是 Scaling Law 的作用。这一共识正是基于 DiT 论文的发现,使用 Transformer 能稳定地扩大模型规模:随着训练计算量的增加(训练模型的时间延长或模型增大,或两者兼而有之),性能也会随之提高。

这意味着,对于视频生成模型,只要用更多的算力、更多的数据去 Scale up,生成质量还会持续提升。

可灵之所以能够将用户的文本提示转化为具体的画面,包括那些真实世界中不会出现的虚构场景,就是基于对文本 - 视频语义的深刻理解和 Diffusion Transformer 架构的强大能力。在自研架构和 Scaling Law 激发出的强大建模能力推动下,可灵能够很好地模拟真实世界的物理特性,生成符合物理规律的视频。

与此同时,基于团队自研的 3D VAE 网络,可灵大模型能够生成 1080p 分辨率的电影级视频,无论是浩瀚壮阔的宏大场景,还是细腻入微的特写镜头,都能够生动呈现。
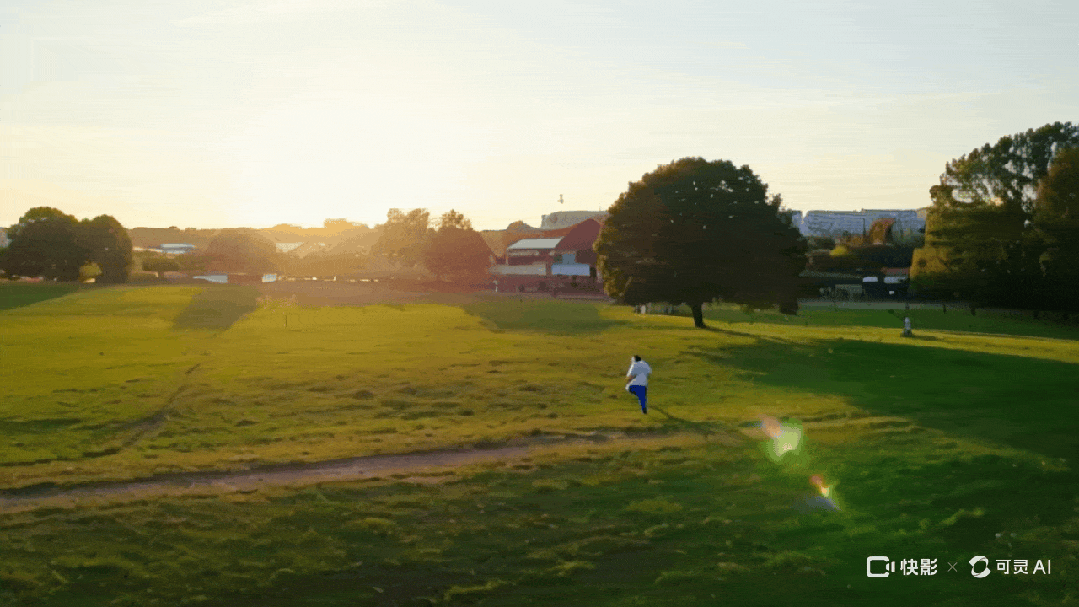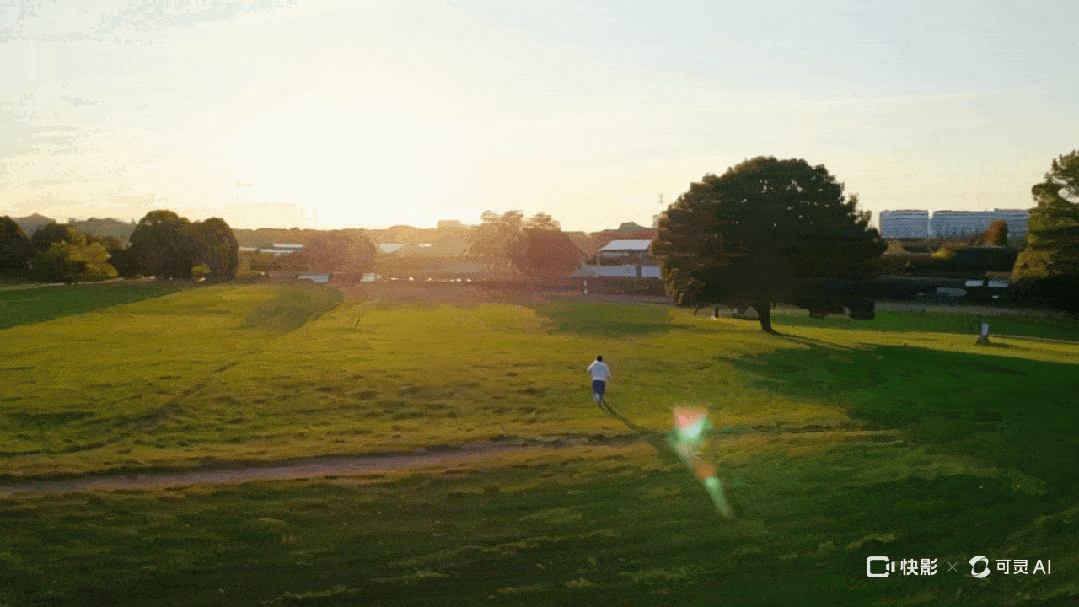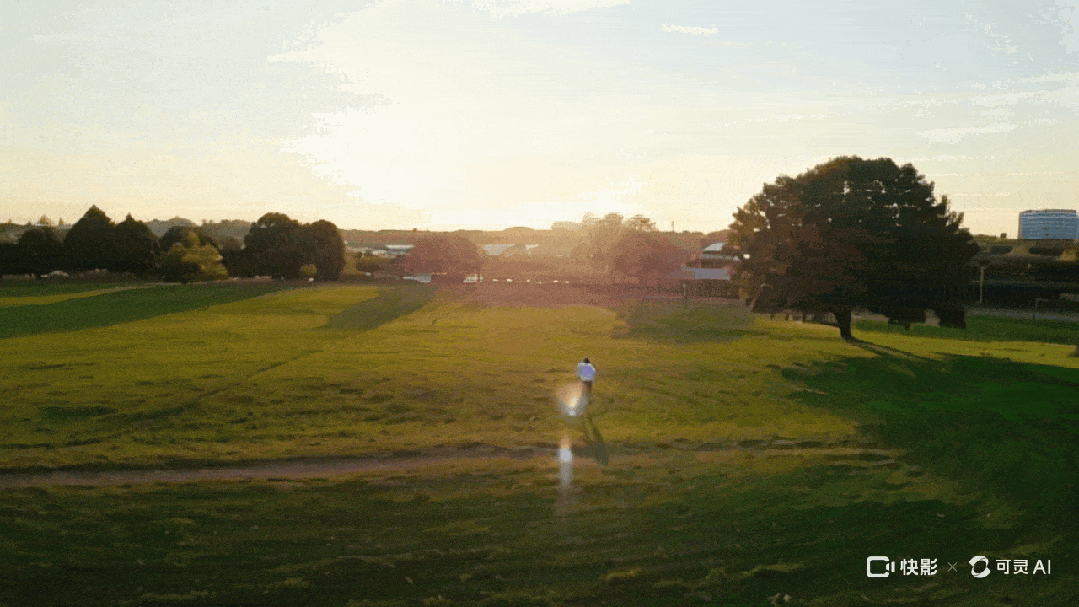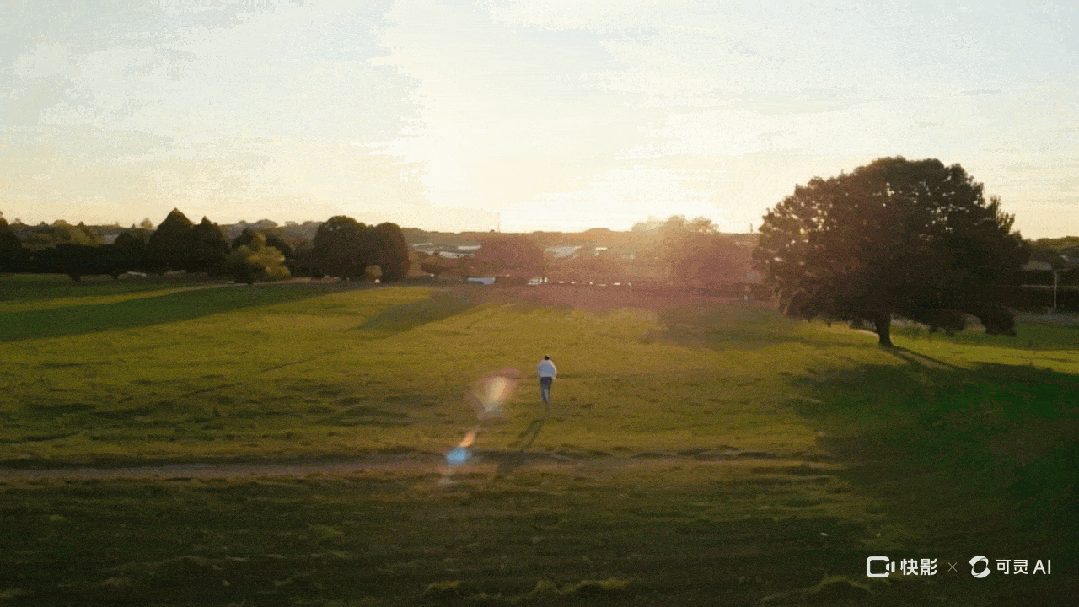
图片

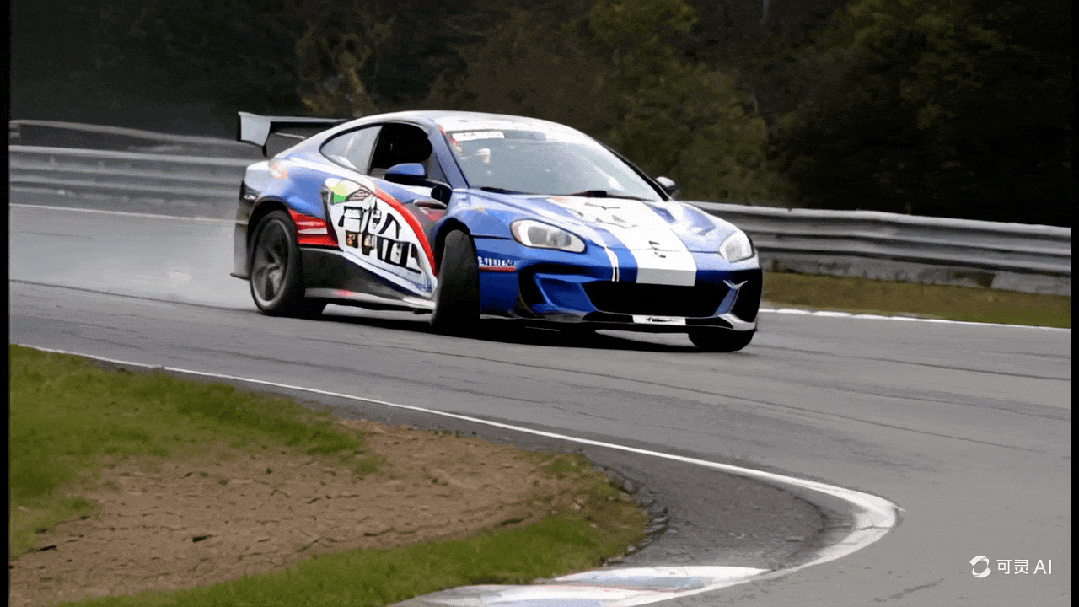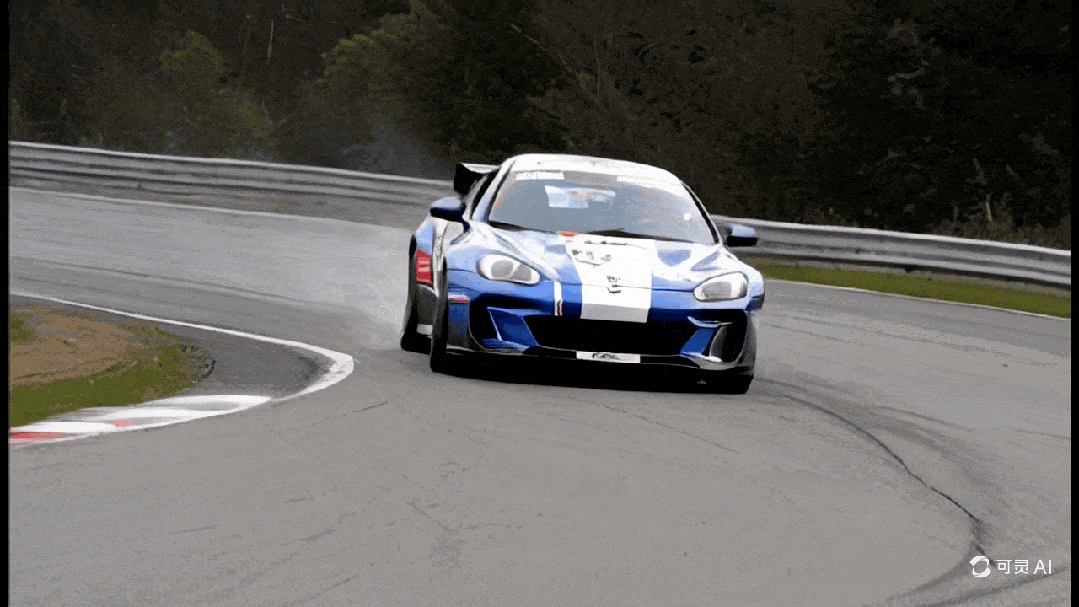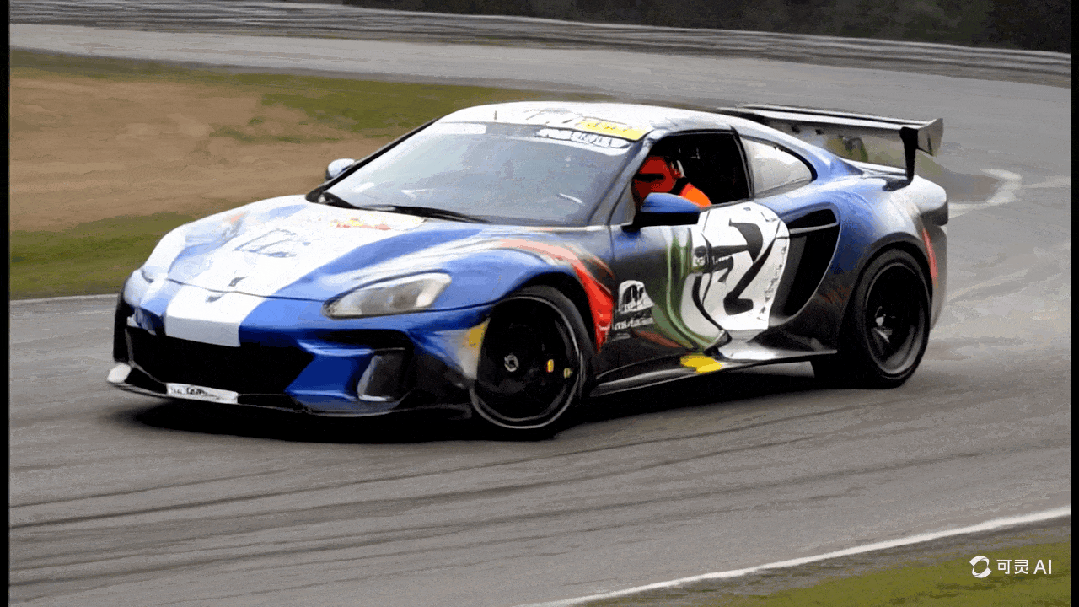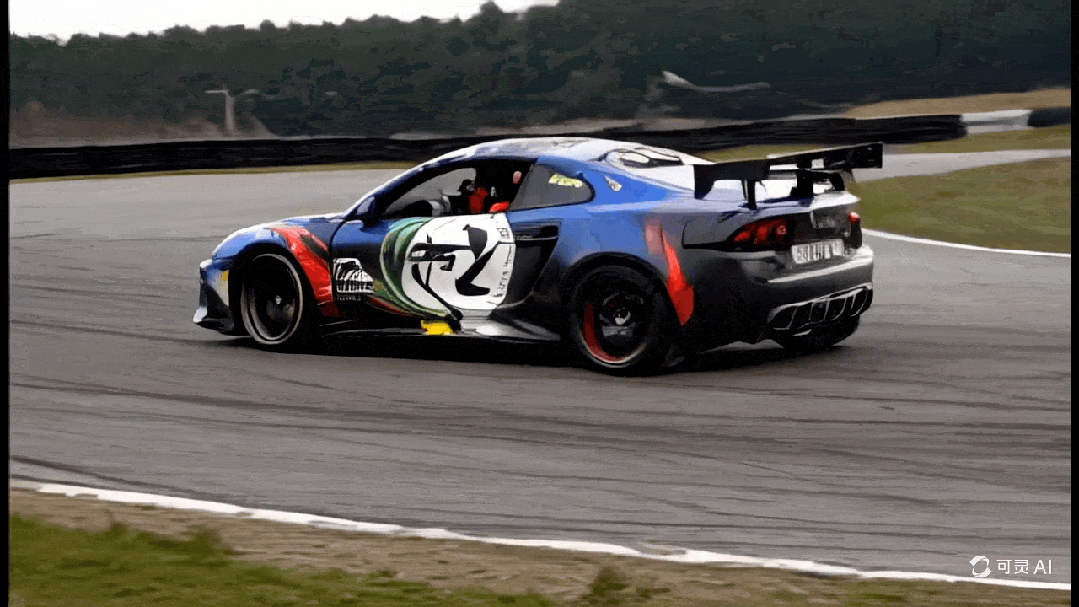
自然场景下,光线的变化很流畅。测试者:@杉杉

当然,对于视频生成模型来说,另一个必须考虑的因素是:视频是一种具有时间维度的视觉内容,不连贯的内容会让用户的观看体验大打折扣。

为了保证画面中运动的呈现更加合理,可灵大模型采用 3D 时空联合注意力机制,更好地建模复杂时空运动,即可生成较大幅度运动的视频内容,同时能够符合运动规律。
图片

训练及优化策略

如果你已经亲自测试过,就会发现可灵支持推理过程中同样的内容输出多种视频宽高比。这是因为可灵采用了可变分辨率的训练策略,目的是满足更丰富场景中的视频素材使用需求。

与此同时,得益于高效的训练基础设施、极致的推理优化和可扩展的基础架构,可灵大模型能够生成长达 2 分钟的视频,且帧率达到 30fps。

视频生成,不再是一场「追赶 OpenAI」的游戏

2024 年被称为视频生成技术的爆发之年,但在可灵之前,我们始终没见到 Sora 级的可用产品,而 Sora 何时开放也是未知数。

某种意义上说,可灵是第一个真正的「中国版 Sora」,并让这项技术真正进入了可用、好用、实用的阶段。

正如傅盛所说:「这可能是今天在全世界范围内,你能够使用到的最好的文生视频产品。」任何亲自试用过可灵的人,都会明白这绝不是过誉。

傅盛的视频还给到了另外一个观点:「反过来也说明,Sora 并不是一个技术性的突破,而是一个产品型的突破。」

还记得几个月前,Sora 以长达 60 秒的连贯视频、高清画面质感、连贯的镜头移动、运动方式等优点,拉高了整个视频生成赛道的技术水平,掀起了文生视频赛道的竞争浪潮。

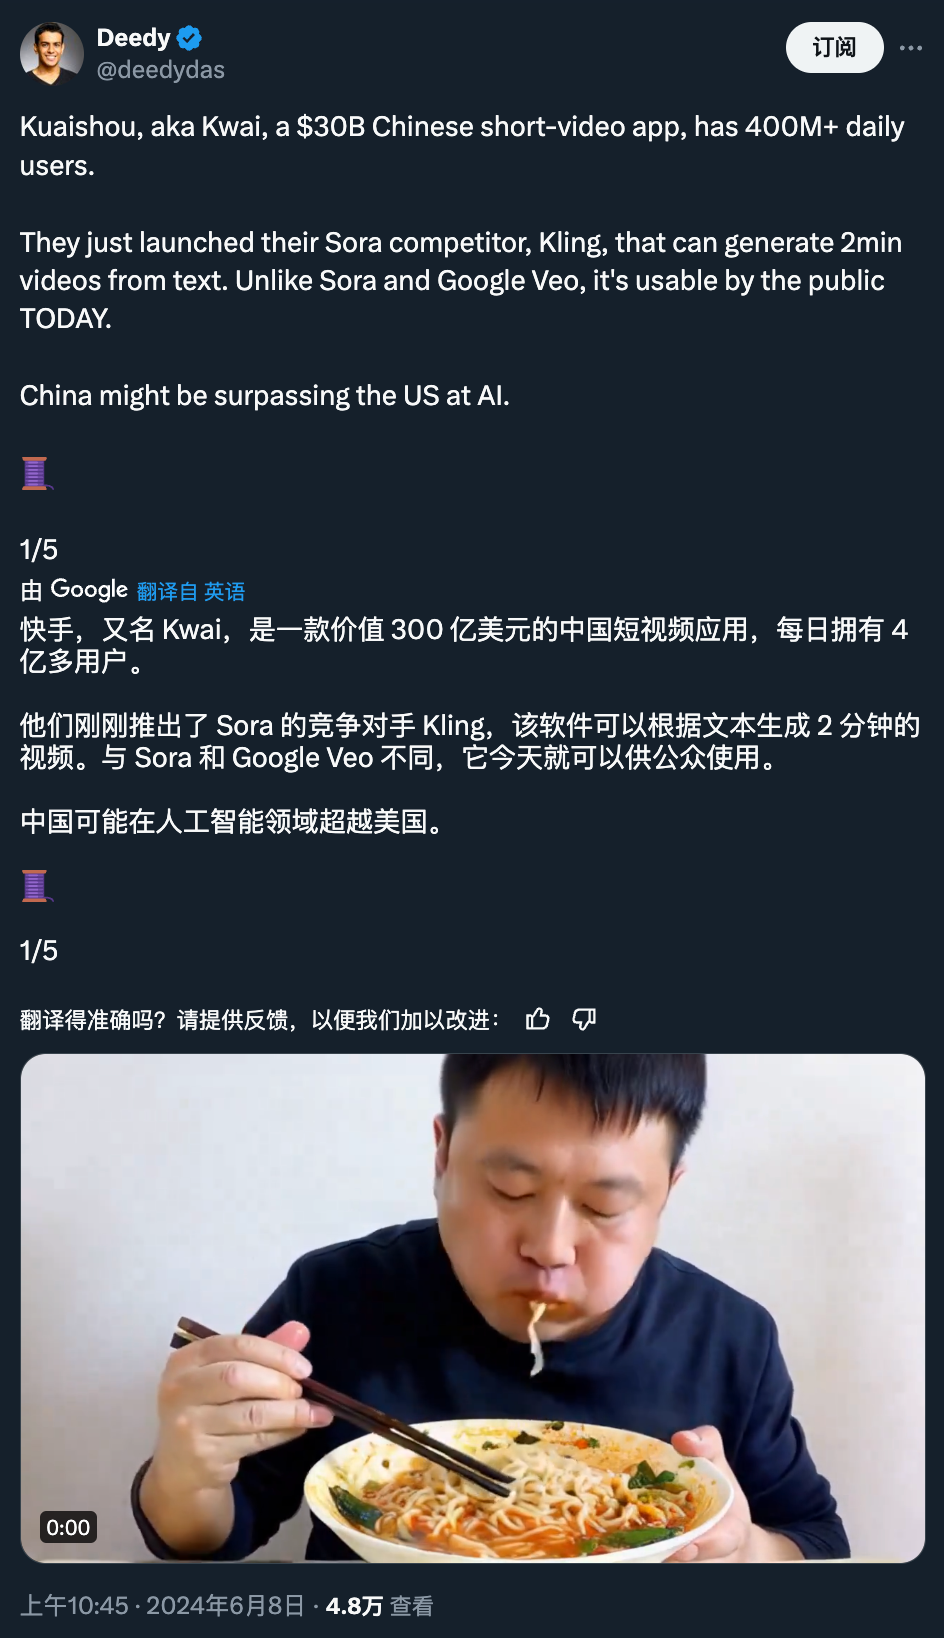
我们本以为,视频生成领域会像去年的文本大模型一样,演化为国内对海外的技术赶超。但可灵的发布,意味着国产文生视频大模型技术的探索已经达到了一个全新的高度,而且在产品落地层面做到了实质领先。我们可能不需要再重新经历一次「追赶 OpenAI」的游戏了。

有人给出判断:中国正在人工智能领域超越美国。
图片

可灵的诞生,或许意味着一个新时代开启了。在生成式 AI 时代,生成和编辑视频或许会像今天我们用手机 P 图一样简单,想象力与现实之间的阻隔将被彻底打破。

由于太过火爆,目前在排队测试可灵的人数已经超过了 5 万人。如果你对 AI 生成视频的玩法感兴趣,不妨先关注「可灵 AI 视频号」,收获更多优质案例。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
AIGC专题:Sora开启AIGC新纪元,海外龙头AI指引乐观 今天分享的是深度研究报告:《页。 阅读详情

相关推荐

智能驾驶感知模块评测实战:如何用回灌测试提升BEV模型准确率(附数据集处理技巧)

本文深入探讨了如何通过诊断型回灌测试系统性地提升智能驾驶BEV感知模型的准确率与鲁棒性。文章详细拆解了从场景切片、时空对齐到多维指标分析的完整评测流水线,并针对BEV模型特有的深度估计、特征融合等环节提供了优化思路,旨在帮助工程师将海量路采数据转化为精准的模型迭代燃料。

weixin_29045585的博客 395

实测完快手的AI视频「可灵」后,我觉得这才是第一个中国版Sora

6月6号,是快手的13周年生日。在这一天,所有AI圈的人都想不到,快手在13周年之际,没有任何预兆、没有任何宣传,直接发布了他们的AI视频大模型。给我也干了个措手不及。我当时正在看360的发布会,突然手机就叮叮当当一顿狂响,打开一看,一群人跟我说:快快快,看快手,他们发AI视频模型了。我当时想着,发个AI视频模型就发个AI视频模型呗,能有啥大惊小怪的,这年头,做AI视频的多了。要么就是发了个老技术的产品给大家先用着占坑,要么就是发了个Sora那种新技术的纯PR视频,又不给用纯粹To VC的。还能有啥。

python1222_的博客 4920

科研党必备:用MATLAB批量处理.mat文件数据的3种高效方法

本文为科研人员提供了使用MATLAB批量处理.mat文件数据的三种高效方法,涵盖智能数据加载、专业可视化与自动化报告生成。通过构建自动化框架、多维度数据画图策略及批量处理流程,帮助用户显著提升数据处理效率与图表专业性,解决海量实验数据的管理与分析难题。

weixin_29089057的博客 72

国产Sora真的来了!免费体验!实测快手可灵Kling文生视频大模型(附申请方法)

大家好,我是程序员X小鹿,前互联网大厂程序员,自由职业2年+,也一名 AIGC 爱好者,持续分享更多前沿的「AI 工具」和「AI副业玩法」,欢迎一起交流~自从年初(2024.2) OpenAI 发布 Sora 模型到现在,已经过去将近 4 个月的时间了。至今依然没能体验上 Sora(除了极少部分人)。真是吊足了人们胃口!而就在最近,国内第一个可以和 Sora 相媲美的 AI 视频生成模型发布了——它就是。相比之下,快手可就「实在」多了。快手可灵(Kling)视频生成大模型上线后,立马就开放了内测。

分享AI工具/AI副业玩法 5768

AD24层次原理图设计避坑指南:如何解决端口连接与自动交叉引用问题

本文深入解析AD24层次原理图设计的核心机制,聚焦端口连接错误、自动交叉引用干扰等常见问题。通过对比自上而下与自下而上设计流程,提供端口类型匹配、命名规范等实用解决方案,并指导如何关闭烦人的红色框线视觉干扰,帮助工程师高效避坑,实现复杂系统的模块化设计。

wdx01234567的博客 615

【YOLO11改进 - 特征融合】利用Hyper-YOLO 的混合聚合网络(MANet)改进yolo11,提升基础网络的特征提取能力

【YOLO11改进 - 特征融合】利用Hyper-YOLO 的混合聚合网络(MANet)改进yolo11,提升基础网络的特征提取能力

专注于图像领域,主要研究内容包括计算机视觉和深度学习,特别是在图像分类、目标检测和图像生成等方面有深入的研究和实践经验。 905

KLing源码(在屏幕实时显示键盘操作)下载及编译(Win10,VS2022)

下载网址: https://github.com/KaustubhPatange/Kling 下载完成后,得到压缩包 解压到目录“D:\SourceCodes\Kling-master”中 双击“Kling.sln”,使用VS2022打开解决方案: 这是个用C#编写的程序,需要为VS2022添加“.Net桌面开发”组件。 打开后,创建 创建结果在文件夹“D:\SourceCodes\Kling-master\bin\Release”中, 双...

Alexabc3000的专栏 1982

【异常】Milvus 向量数据库字段缺失错误分析与解决 MilvusVectorStoreServiceV2 - Failed to insert batch [0-1]: The field:

本文分析了Milvus向量数据库插入操作中出现的字段缺失错误。错误显示age_mode字段未提供,导致批量插入失败。根本原因是Milvus Schema要求所有定义字段必须存在,但代码中对部分字段采用条件添加方式。解决方案是将条件添加改为始终添加,为可能为null的字段提供空字符串默认值。文章总结了Schema约束、防御性编程等经验,并建议通过Schema变更检查、单元测试覆盖和数据校验层等预防措施避免类似问题。该问题影响product、mac、source等多个字段,修改后确保了数据插入的可靠性。

奶爸的编程之路,也就一周冷个三天 407

可灵AI:AI视频领域的国产之光

它的出现不仅在国内引起了广泛关注,还在国际上获得了高度评价,被认为是AI视频领域的“国产之光”。

2403_89593802的博客 5756

OpenLayers6入门,快速搭建Vue+OpenLayers地图脚手架项目

本章针对Vue初学者,对Vue不熟悉,甚至还不会Vue的入门学生读者。本章会详细讲解从环境到环境的各个步骤,再到使用脚手架快速生成项目,以及添加地图库依赖,编写简单的高德地图显示页面的。如果已有VUE项目或者熟悉VUE的读者可以不用看本章,直接添加ol依赖到VUE项目中即可。

GIS技术方向,GIS地图技术分享(GIS入门、Openlayers教程、Leaflet教程),做最好的GIS地图开发教程。关注博主公众号:eguid 5440

损失函数大汇总(五十三)(Boundary Loss附公式推导与代码)

摘要 Boundary Loss是一种针对图像分割任务的新型损失函数,特别适用于高度类别不平衡的细粒度分割场景。与传统的区域型损失(如Dice、交叉熵)不同,它通过计算预测边界与真实边界之间的距离来优化模型,更关注边界精度而非区域重叠。核心思想是利用距离图(distance map)将边界约束转化为区域积分形式,实现端到端训练。具体实现中,损失函数为预测概率与距离图的点积,梯度仅取决于距离图,具有明确的空间引导性。相比区域型损失,Boundary Loss能更好处理小目标、细长结构等边界敏感任务,可与Dic

悦学共鸣,温柔以待,汇聚光芒,共同成长 240

海外AI圈巨震,中国版Sora一号难求

而且,可灵支持生成最长 2 分钟、30fps 的 1080P 视频,主打从头脑风暴到可发布作品的「一键转化」。猎豹移动董事长兼 CEO、猎户星空董事长傅盛公开了自己用可灵制作的「气球人」视频,并表示自己仅用了「几十分钟」,就做出了连续性、真实度、清晰度都很优秀的短片。视频地址:https://x.com/AngryTomtweets/status/1799787209651859910。对于此前的视频生成模型来说,「一气呵成」生成 1 分钟以上的内容确实有难度,特别是要求画面中的各种元素保持前后一致。

WearY3kaka的博客 709

基于Mask-RCNN网络的书架图书书脊分割和检测(含代码)

图书馆的书架上的图书书脊分割/检测对于图书书名等信息的识别具有重要意义,因此,该博客基于Mask-RCNN网络实现了图书书脊的分割和检测,有利于进一步利用ocr文字识别技术实现图书书名等信息的入库。如下图所示,为书架原始数据和分割/检测后的结果。(本文已训练模型,无需训练)

qq_44619530的博客 2025

快手可灵全球上线,无需排队,我们终于向全世界输出中国Sora

在价格上,算下来是1条高性能5s视频是0.5rmb,也就是5毛钱,如果你玩跑失败了的话,也是不扣钱的,对比Runway的Gen3和Luma,这个价格还是很实惠的。AI Chat最好的是ChatGPT和Claude,AI绘图最好的是Midjourney,AI声音最好的是11Labs,就连套壳,最好最全的也是国外的POE。不过这也正常,为爱发电,肯定走不远的,而且我一个视频等一个小时,也特么挺离谱的,早收费早好,也可以保证付费用户的试用体验。而且最最最最最关键的是,终于可以TMD去水印了!

weixin_38978741的博客 1423

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

限时免费!国产Sora快手可灵Web网页端及全新功能上线!国货之光!

程序员X小鹿:快手可灵(Kling)这回是真的出息了!不敢说是否已经超过了 CloseAI 的 Sora,但肯定已经跻身世界第一梯队了!在 WAIC 2024 的大会上,快手公布了「可灵 AI」的 Web 端平台以及最新功能。

分享AI工具/AI副业玩法 2214

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

Sora给中国AI带来的真实变化

OpenAI的最新技术成果——文生视频模型Sora,在春节假期炸裂登场,令海内外的AI从业者、投资人彻夜难眠。如果你还没有关注到这个新闻,简单介绍一下:Sora是OpenAI使用超大规模视频数据,训练出的一个通用视觉模型,可以理解和模拟运动中的物理世界,生成不同时间、纵横比和分辨率的视频,最大版本的Sora能够生成长达一分钟的高保真视频。Sora发布之前,也有许多采用各种方法的视频生成模型,但都使...

脑极体 1565

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

AI视频生成技术全景:Sora2、Veo3、可灵3.0背后的Diffusion架构深度解析

老读者都知道,我写技术文章有个习惯——先讲一个"场景"。2024年2月,OpenAI甩出Sora的技术报告,整个AI圈炸锅。那时候大家还在争论"AI能不能生成一段5秒钟、不变形、不掉帧的视频"。快进到2026年7月。我打开快手可灵3.0,输入一句:15秒后,一段4K分辨率、人物肢体完全不扭曲、雨水会顺着衣服下落的视频就生成了。说实话,第一次看到的时候我后背有点发凉——这已经不是"AI生成视频"了,这是"AI在理解世界"。全球格局已经非常清晰了,我用一张"势力图"来概括: 根据全球知名AI基准测试机构 Art

weixin_54908067的博客 1万+

字节Seedance、快手可灵、阿里HappyHorse逐鹿AI视频市场,谁能构建“循环生态”?

从抖音“算法兴趣推荐”长出的Seedance、从快手“老铁生态”长出的可灵,都有庞大视频消费群体和“创作 - 分发 - 消费”闭环,母公司用户的视频消费数据是“模型评测系统”。据AI普瑞斯统计,按日算力消耗占比,Seedance超八成,可灵约14%,万相2.7约4%,HappyHorse不足1%。从事AI短剧的从业者张晓磊称,制作AI视频要看团队SOP,除视频生成,更看重语言和生图模型能力,新模型迭代会先试验。字节方面,番茄小说提供IP,Seedance生成漫剧,红果短剧和抖音分发,形成内容生态闭环。

IT界那些事儿 157

这7款国产AI视频工具,变态又好用,最后一个居然还有人不知道!(建议收藏)...

大家好,我是程序员X小鹿,前互联网大厂程序员,自由职业2年+,也一名 AIGC 爱好者,持续分享更多前沿的「AI 工具」和「AI副业玩法」,欢迎一起交流~前几天一位粉丝说给的 AI 视频工具的网址打不开。因为很多国外的 AI 工具,在国内访问是访问不了的,需要特殊的网络设置。不过目前国内已经有很多 AI 视频生成工具了,完...

weixin_40666375的博客 2万+

快手分拆可灵AI,30亿美元融资背后,视频生成赛道胜负几何?

嗷,2026年7月2日晚间,快手在港交所公告,可灵AI完成新一轮增资啦!投前估值150亿美元,融资约30亿美元,投后达到180亿美元咯。腾讯参与领投,阿里云、百度也同步入局,这三个大玩家的资本,罕见地坐到了同一张桌上呢!在此之前一个多星期,Artificial Analysis视频生成竞技场更新了7月的实时榜单。文生视频无音频榜的前四位,分别是阿里的HappyHorse - 1.0、阿里通义的Wan 2.5、字节的Seedance 2.0、快手的可灵Kling 3.0。榜单上压过可灵的两家,一家是四月才空降

IT界那些事儿 48

Sora给中国编程教育带来的“冲击”

与时俱进是万事万物发展的根基,要想不被淘汰就一定要赶上时代的步伐,少儿编程亦是如此,青少年是未来中国梦的建造者,市面上少儿编程的机构不在少数,主要编程语言有Scratch、Python、C++,不仅是带孩子学习编写知识,更着力于开发孩子的思维创造力、分析问题解决问题的能力。面对Sora的出现,我们也不必过分焦虑,正视自己的能力,专注自身发展。几只巨大的长毛猛犸象踏过一片雪白的草地,它们长长的毛发在微风中轻轻飘动着,远处覆盖着雪的树木和雄伟的雪山,午后的光线下有些薄云,太阳高悬在远方,营造出温暖的光芒。

happy_binary的博客 491

从Sora惊恐到即梦反杀,中国的AI视频生成之路

2024年底,我造访长春人工智能算力中心,该中心总规模300P的智能算力,其中200多P都被北京某高校的Sora对标项目占用,来自全栈国产化的算力支持、长春市的算力补贴政策,让科研团队有了复现Sora的底气。OpenAI的Sora在2024年初横空出世,一支“女生走在东京街头”的60秒视频,画面逼真程度堪比实拍,而彼时的国产视频模型,大多只能生成5—12秒的画面,表情僵硬、手指穿模、物理穿帮都是常态,效果一眼假。于是,这些企业放弃了对通用型模型的盲目追赶,转而针对具体的业务场景,解决用户的实际痛点。

脑极体 547

2025年AI大战:神仙打架谁封神——万字复盘2025年AI圈大事件及发展趋势

2025年AI领域迎来爆发式发展:国产模型DeepSeek V3以极致性价比搅动全球市场,Meta开源Llama4登顶开源榜首,谷歌Gemini3Pro凭借接近人类的思维能力封神。多模态成为标配,混合专家架构普及,AIAgent实现商业化爆发。中国厂商集体崛起,DeepSeek、阿里通义千问和Kimi构成"东方三巨头",推动开源生态繁荣。视频生成领域Sora2和NanoBananaPro重塑行业标准,AI手机等终端产品走进日常生活。

勇敢的喵的博客 1211

可灵AI融资30亿美元!BAT罕见同台押注,AI视频生成爆发前夜:普通人用手机就能拍大片

快手旗下可灵AI完成30亿美元融资,投后估值180亿美元,创全球视频大模型单笔融资纪录。腾讯、阿里、百度三大巨头罕见同台投资。在OpenAI关停Sora的背景下,可灵接过AI视频赛道旗帜。本文从技术、商业、用户视角,拆解AI视频生成的爆发前夜。

找方案 303
上一篇: 无限可能LangChain——构建代理
下一篇: 个人电脑秒变AI工厂:轻松搭建本地大模型!
我爱学大模型
博客等级 码龄3年 7883粉丝 687原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值