


文章指出前端岗位招聘需求大幅缩水,建议程序员转型 Agent 开发。重点介绍 Agentic RAG 技术,包括向量检索、BM25、父子文档、权限过滤、RRF、重排模型和 Graph RAG 等关键技术节点。文章强调通过 RAG 技术实现高效信息检索,并利用 RAGAS 对效果进行评估。最后提出建议,鼓励程序员利用现有工程经验拓展知识面,提前布局 Agent 开发领域。
近几年,前端岗招聘需求明显缩水,是所有技术岗里降得最狠的。
国内更扎眼,仅 2026 一季度报告,0-3 年初级前端招聘量暴跌 62%。
即使是做过复杂交互、工程化和性能优化的资深前端,招聘机会也很有限。
所以,趁着还有时间,认真考虑能力往哪里延伸。我的建议是,转 Agent 开发可以接着用已有的工程经验,从Agentic RAG 开始。

前端岗收缩,Agent 岗上涨
转型第一课:Agentic RAG
为什么要学 Agentic RAG?Agent 要回答「我不知道的东西」,得先从一堆资料里把相关的那几段捞出来,再喂给模型。
这个「捞出来」的动作,就是检索,RAG 全称检索增强生成。
向量检索、BM25、父子文档、权限过滤、RRF、重排、Graph RAG,就是搭 Agentic RAG 必会的技术节点。

RAG 完整框架
/ / /
向量检索(嵌入模型)
把文本丢进嵌入模型,映射成高维稠密向量。检索时要把query(用户问题)向量化,用余弦相似度算距离,取最近的一批。核心就一件事——算距离。代表模型有 text-embedding-3、bge。
简单来说,就是把每段话变成一串数字坐标。意思相近的话,坐标挨得近。你搜的时候,系统找的是「离你最近」的那几段,而不是「字面一样」的那几段。

文字变成向量坐标
/ / /
全文检索:BM25 算法精确查询
BM25 是 1994 年 Robertson 等人提出的概率检索排序函数。BM 是 Best Match,25 是函数编号。它靠词频、逆文档频率、文档长度归一化,做关键词精确匹配。Lucene、Bing 都在用。
简单来说,就是在极短的时间内,从资料库找出一个词出现几次、这文档有多长,算个分数。它不懂语义,但精确词一找一个准。
向量检索是语义匹配,全文检索是关键词匹配。通常是两路召回,混合检索。

BM25 关键词匹配 vs 向量语义匹配
/ / /
父子文档:检索用小块,喂模型用大块
把小粒度 chunk 建索引用于召回,命中后返回它所属的父级大块作为上下文。业内也叫 small-to-big 检索,目的是平衡「召回精度」和「上下文完整度」。
简单来说,就是检索的时候用小碎片找,找到了就把整段原文捞出来喂给模型。
切太碎,检索准了但上下文丢光;切太大,检索又变钝。父子文档两层一拆,两个问题都躲开。

父子文档:子块检索父块喂模型
/ / /
权限过滤:捞出来的结果,先过一道谁能看
在检索阶段依据用户或角色的 ACL 过滤候选文档,确保越权内容不进入上下文,是多租户知识库的必选项。
简单来说,就是搜出来的东西,先过一道「谁能看」的闸门。A 部门的文档,B 用户不该看,直接挡掉。
这个做过权限管理的应用,很容易理解。

检索前按权限过滤候选集
/ / /
RRF:多路结果合并
Reciprocal Rank Fusion,2009 年 SIGIR 论文提出的无监督排序融合算法。对每路结果不看分数、只看名次,按 1/(k+r) 求和(k 取 60),把向量和关键词等多路异构排序合成一份。
简单来说,就是多路召回结果各排一个名次,不看分数,把名次倒过来加一起,重新排。排完后,融合到一起,取前面的部分。
向量分数和 BM25 分数不是一个量纲,不能直接加到一起,交给 RRF 融合即可。

RRF 融合两路排序
/ / /
重排模型:RRF粗排后Rerank精排
rerank 用 cross-encoder 把 query 和候选文档联合编码打分,比双塔 embedding 更精细,但更慢,所以只对初排 top-N(常见 50)精排。开源有 bge-reranker,闭源有 Cohere Rerank。
简单来说,就是粗排先捞一堆,再让一个更聪明的模型把问题和文档放一起读,挑出最搭的排前面。
有个实测:加一个 rerank,RAGAS 综合分从 70.99 拉到 74.15。但在结构本就清晰的数据集上,它几乎没用。

召回粗排到 rerank 精排
/ / /
Graph RAG:知识图谱做多跳推理
先用 LLM 抽实体和关系,建知识图谱,再用 Leiden 算法做社区检测,为每个社区预生成摘要。它解决的是全局性、多跳推理这类「没有哪一段单独能答」的问题。微软 2024 开源的 graphrag 是代表。
简单来说,就是把文档织成一张关系网。问「这批东西整体在讲什么」,向量和全文检索都是关键词检索,只有图能答全局。
代价是,索引成本是普通 RAG 的 3 到 5 倍,延迟两倍多。

知识图谱 vs 向量检索
/ / /
评估 RAG 效果:RAGAS
用 LLM-as-judge 给 RAG 系统打分。四个核心指标——Faithfulness 看答案有没有瞎编,Answer Relevancy 看答案跑没跑题,Context Recall 看该捞的捞全没,Context Precision 看捞上来的有没有用。前两个查生成,后两个查检索。
简单来说,就是别只看答案像不像人话,拆开看是「没找到」还是「找到了但说错了」。
我的判断是:先跑一遍 RAGAS 定位是检索烂还是生成烂,再决定加 rerank 还是调 prompt。方向比努力重要,调 RAG 尤其如此。

RAGAS 四个评估指标
/ / /
grep 和 RAG,到底什么区别
其实 Claude Code 里跑的是 grep,不是向量检索。
grep 是精确匹配:你给它字符串或正则,它去文件里找字面一致的,本地、无索引、毫秒级。Claude Code 用 grep,是因为代码检索的大头是「找某个函数名、某个报错码」,这种精确查询 grep 又快又准。
向量检索是语义匹配:你把「想找什么」描述出来,它找意思相近的内容。代价是要建索引、要维护,还查不出精确词。
所以应用场景很清楚——做代码类 Agent,从代码里精确找一个名字,适合用 grep;做知识库类 Agent,按相关性查找内容,适合用向量检索。

grep 精确匹配 vs RAG 语义匹配
/ / /
两条腿走路,别等岗位回暖
可以先拿一个熟悉的业务场景,从检索、权限、生成和评估跑通。先跑通一个环节,对 Agent 有一个基本的理解。前端积累的工程经验还是很有帮助的,与其等岗位回暖,不如先拓展知识面,两条腿走路。
建议你把这篇文章复制给 AI,让它帮助你规划一个学习计划。
最后
2026 年一晃已经过半,AI 大模型的热潮不仅没有降温,反而持续升温!
金融行业用大模型做风控、医疗依靠 AI 解析影像,电商、制造、教育各行各业,都在把 AI 融入日常业务。曾经热闹的 “百模大战”,早就告别单纯比拼模型参数,正式进入落地应用时代。
现在企业疯狂紧缺一类人才:懂业务、懂 AI、能做出可上线项目的大模型开发工程师,岗位缺口大,薪资待遇十分可观。

风口再好,不如手握高薪 offer 实在。行情火热,普通人、程序员该怎样从零入门大模型,抓住这波机会?
今天整理好【2026 最新版】AI 大模型全套免费学习资源,覆盖零基础入门、项目实战、理论知识、大厂面试,从基础一路进阶。所有资料分类归档,没有多余杂料,无套路免费分享给想要入局 AI 赛道的程序员与零基础小白!
👇👇扫码免费领取全部内容👇👇

1、大模型系统化完整学习路线
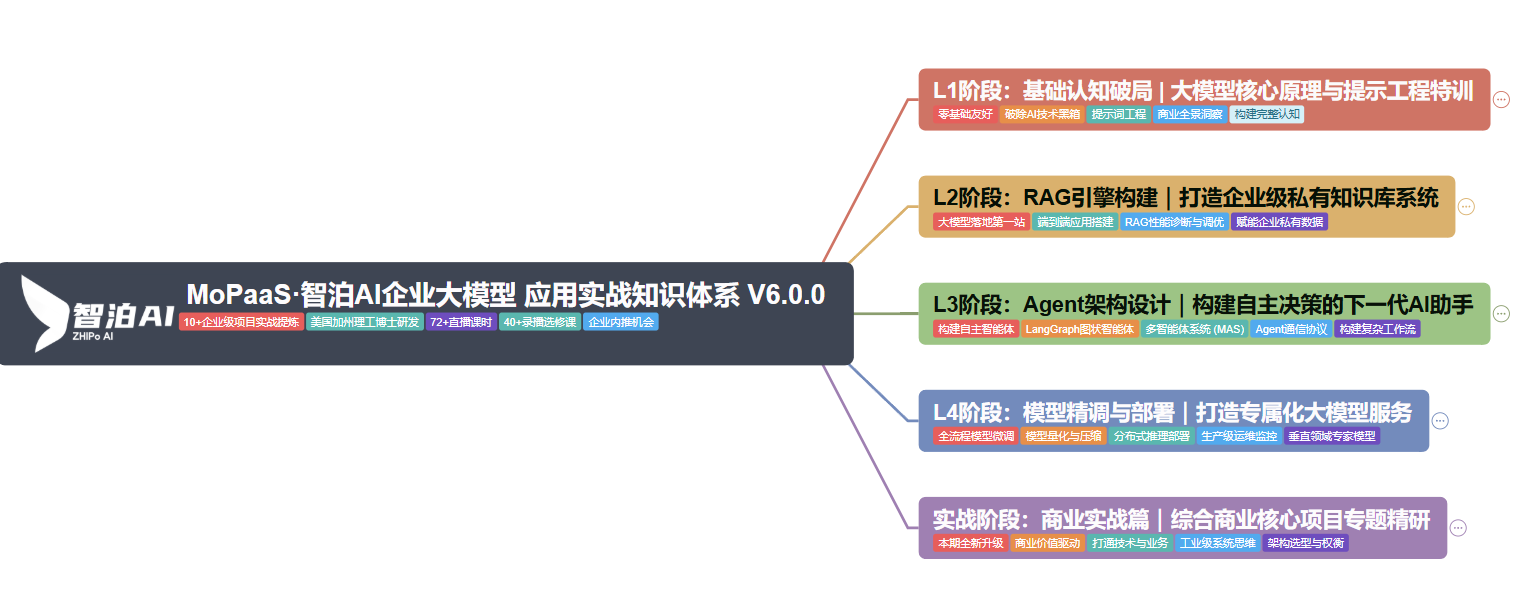
2、大模型经典书籍&文档

3、AI 大模型最新行业研究报告

4、企业级实战项目 + 完整配套源码

5、大厂大模型面试真题汇总

6、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。


这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 2613


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


