小白程序员轻松入门大模型内存机制,解锁更强大的LLM Agent

Hermes Agent 实战指南:从安装失败到生产级 YAML 配置 Agent 是一种将大语言模型与工具链、记忆机制和决策逻辑封装为可执行单元的智能体范式。其核心原理在于通过标准化运行时(Runtime)解耦模型调用与业务逻辑,实现声明式编排而非编码式开发。Hermes 正是这一理念的典型代表——它不提供 SDK 而提供 CLI 运行时,以 YAML 为部署单元,强调配置即代码、环境即契约。这种设计显著降低了 AI 工程化门槛,使非程序员也能基于真实业务场景(如自动抓取竞品价格、同步飞书表格、处理客户邮件)快速构建可维护的 AI 工作流。技术价值体现在可版本控制的 Agen 阅读详情

随着大模型能力的提升,LLM-based Agent正从单轮问答走向复杂长期任务。文章探讨了Agent Memory的重要性,指出了naive long-context prompting的问题,并介绍了统一框架下的四个核心组件:Information Extraction、Memory Management、Memory Storage和Information Retrieval。通过实验分析,文章展示了不同方法在性能、成本和鲁棒性上的表现,并提出了新的低token开销Agent Memory框架。对于想要了解和学习大模型内存机制的程序员来说,这篇文章提供了宝贵的指导和参考。

随着GPT、Qwen、Claude 等大模型能力持续提升,LLM-based Agent 正在从单轮问答走向更复杂的长期任务:多轮对话、个人助手、游戏智能体等。在这些场景中,Agent 不仅要理解当前输入,还要持续积累过去的交互、偏好、事实变化和任务状态。

一个直接方案是把历史消息全部放进 prompt,也就是 naive long-context prompting。但这种方式会带来几个明显问题:上下文窗口可能溢出,token 成本高,推理延迟增加,并且模型也不一定能找到真正相关的证据。

图片

因此,Agent Memory 的核心目标是:不要让模型“每次重读全部历史”,而是让系统主动维护一套记忆机制,在需要时取回相关信息,帮助 LLM 进行更可靠的长期推理。

Memory in the LLM Era: Modular Architectures and Strategies in a Unified Framework

Memory in the LLM Era: Modular Architectures and Strategies in a Unified Framework

这篇论文面向 LLM Agent 长期记忆机制的系统化理解与评测,从模块化视角统一抽象现有方法,并在一致实验设置下分析不同设计在效果、成本与鲁棒性上的表现,为后续记忆系统设计提供经验和参考。

  1. 统一框架:把 Agent Memory 放进同一张图里

论文提出的统一框架将 Agent Memory 拆解为四个核心组件:Information Extraction、Memory Management、Memory Storage 和 Information Retrieval。

图片

该框架可以统一刻画各种 Agent Memory 代表性方法,将它们拆解到同一组组件中进行系统分析。

图片

  1. 四个核心组件:Agent Memory 到底由什么组成?

Information Extraction:记什么?

信息提取决定哪些内容会进入记忆系统,现有方法主要包括三类:直接归档 、总结式提取 和 基于图的提取。

Memory Management:怎么维护记忆?

记忆管理决定新旧记忆如何融合、演化和遗忘。论文将该过程总结为五类操作:连接相关经验、整合碎片记忆、在不同记忆层级之间迁移、更新已有记忆、以及过滤无用信息。

图片

Memory Storage:存在哪里、用什么结构存?

记忆存储可以从两个维度理解:组织结构和表示方式。在组织结构上,分为 扁平式存储 (JSON、队列)和 层级式存储 (长短期、树结构中的不同层级)。在表示方式上,分为 基于向量的存储 和 基于图的存储 。

Information Retrieval:如何取回相关记忆?

信息检索决定当前 query 到来时,系统如何从记忆中找到最有用的信息。论文将其分为四类。

词汇匹配检索 例如 BM25 或 Jaccard,精确匹配实体、名称和关键词。

向量检索 依赖向量余弦相似度、ANN 算法,是许多方法的基础检索方式。

结构检索 利用图或树中的显式连接,通过邻居扩展、图遍历找到相关信息。

LLM辅助检索 让 LLM 参与检索过程,识别关键信息,或直接判断记忆相关性。

  1. 实验:统一复现、系统比较

3.1 做了哪些实验?

LOCOMO 是一个人类长期对话记忆数据集,问题覆盖单跳、多跳、时间推理和开放域知识等类型。

LONGMEMEVAL 是一个用户与 AI 长期交互记忆数据集,用于评估信息提取、多会话推理、知识更新和时间推理等能力。

围绕这两个数据集,我们统一复现并比较 10 个代表性 Agent Memory 方法,实验包括:整体性能对比、token 消耗情况及性能-成本权衡、上下文扩展性分析、证据位置敏感性分析,以及不同底层 LLM 下的表现对比。

3.2 主要结果与发现

图片

  • 在整体性能表现中,MemTree、MemoryOS、MemOS 等层次化或树状方法表现突出,说明多层结构能够同时保留高层摘要和底层证据,更适合复杂长期任务。
  • 将多轮对话作为一个整体进行处理可以显著降低 token 消耗,适当的粗粒度处理反而可能提升记忆效果。
  • 当上下文规模扩展到 200% 时,几乎所有方法都会出现性能下降。相比之下,采用更明确层次管理的方法通常更稳定。

图片

  • 多数方法存在证据位置敏感性:当关键证据位于更早会话时,很多方法更容易被后续信息干扰而检索失败。
  • 现有记忆架构仍然依赖底层 LLM 的推理能力。从 Qwen2.5-7B 扩展到 72B 后,多数方法都有明显提升。

3.3 新SOTA算法

基于上述发现,我们进一步组合 MemTree/MemOS 的树状组织能力与 MemoryOS 的分层存储架构,设计出一个新的低 token 开销 Agent Memory 框架。

lme-sota

lme-sota

cost sota

最后

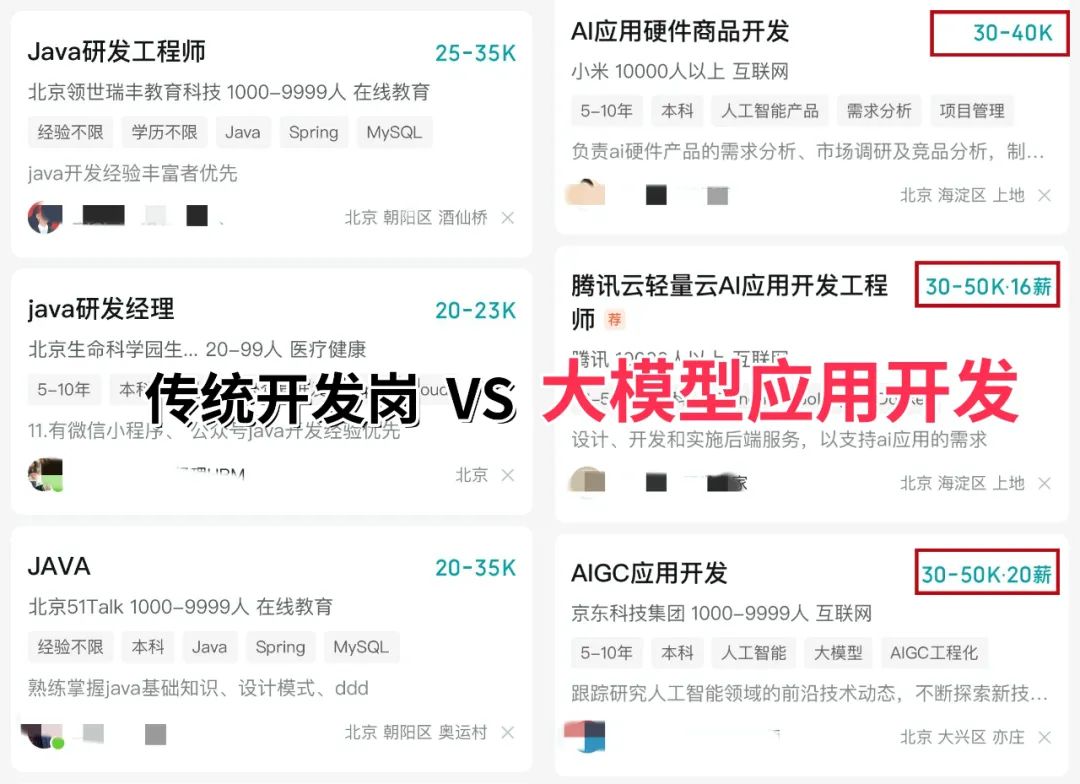
2026年技术圈的分化愈发明显:降薪裁员潮持续蔓延,传统开发、测试等岗位大批缩水,不少从业者陷入职业焦虑;与之形成鲜明对比的是,AI大模型相关岗位迎来疯狂扩招,薪资逆势飙升150%,大厂更是直接开出70-100W年薪,疯抢具备实战能力的大模型人才,甚至放宽年龄限制,只求能快速落地技术、创造价值!

很多程序员、职场新人纷纷入局大模型领域,绝非盲目跟风,而是实实在在看到了不可替代的价值优势,这也是2026年最值得抓住的职业风口:

1、窗口期红利,入门门槛友好:不同于成熟赛道的“内卷式招聘”,2026年大模型人才缺口巨大,简历只要达标(掌握基础AI应用+具备简单项目经验),年龄、学历均非硬性要求,小白可快速入门,转行程序员也能无缝衔接;

2、技术可复用,上手速度翻倍:如果你有前后端开发、测试、数据分析等基础,在大模型落地、系统部署、Prompt工程等环节会更具优势,无需从零开始,复用原有技术能力就能快速进阶;

3、懂业务更吃香,竞争力翻倍:单纯懂技术已不够,2026年大厂更看重“技术+业务”的复合型人才,有垂直领域(金融、医疗、工业等)经验者,能精准定位模型落地痛点,薪资比纯技术岗高出30%以上;

更重要的是,即便没有转型需求,用AI大模型工具为工作赋能、提升效率,也已经成为80%企业的硬性要求——不会用大模型提效,未来很可能被行业淘汰!
图片

那么2026年,小白/程序员该如何高效学习大模型?

很多人想入门大模型,却陷入两大困境:要么到处搜集零散资料,不成体系,越学越懵;要么被收费高昂的课程割韭菜,花了钱却学不到实战技能,白白浪费时间走弯路。

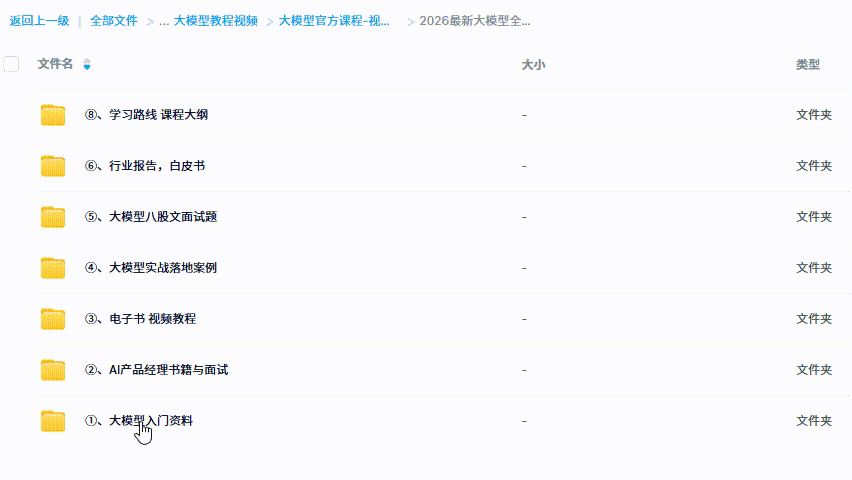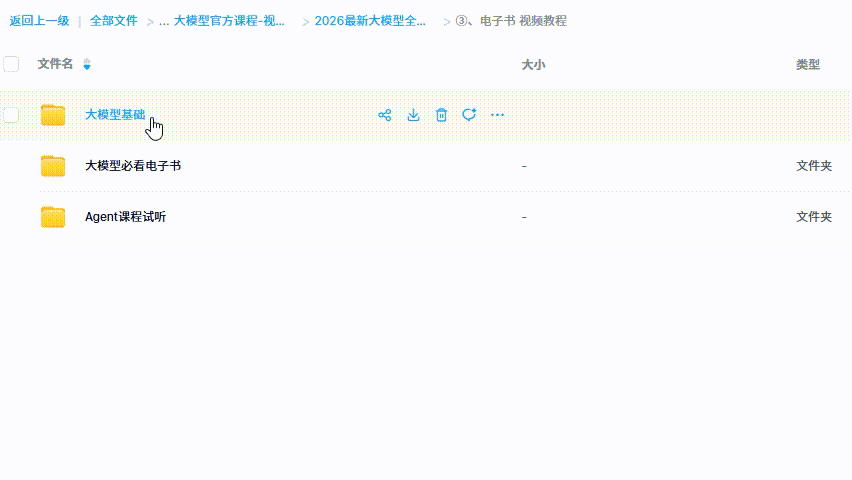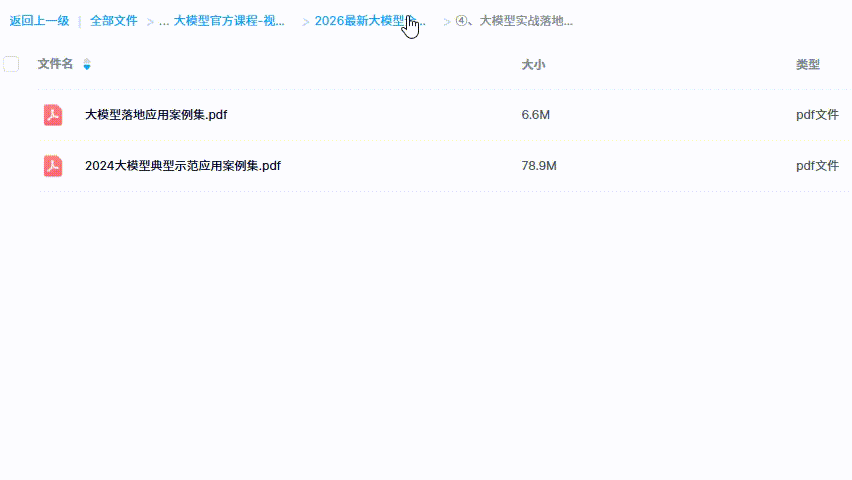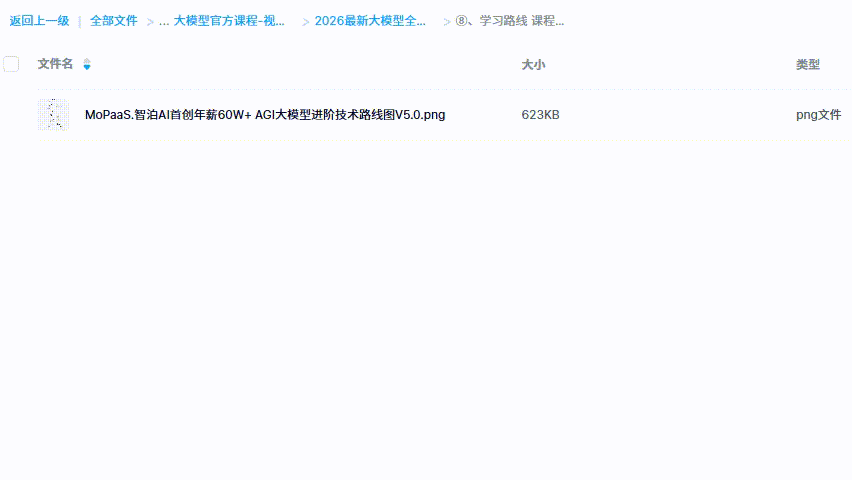
今天就给大家精心整理了一份2026年最新、免费、系统化的AI大模型学习资源包,覆盖从零基础入门到商业实战、从理论沉淀到面试通关的全流程,所有资料均已整理归档,无需拼凑,直接领取就能上手学习,小白可照做,程序员可进阶!
请添加图片描述

👇👇扫码免费领取全部内容👇👇

在这里插入图片描述

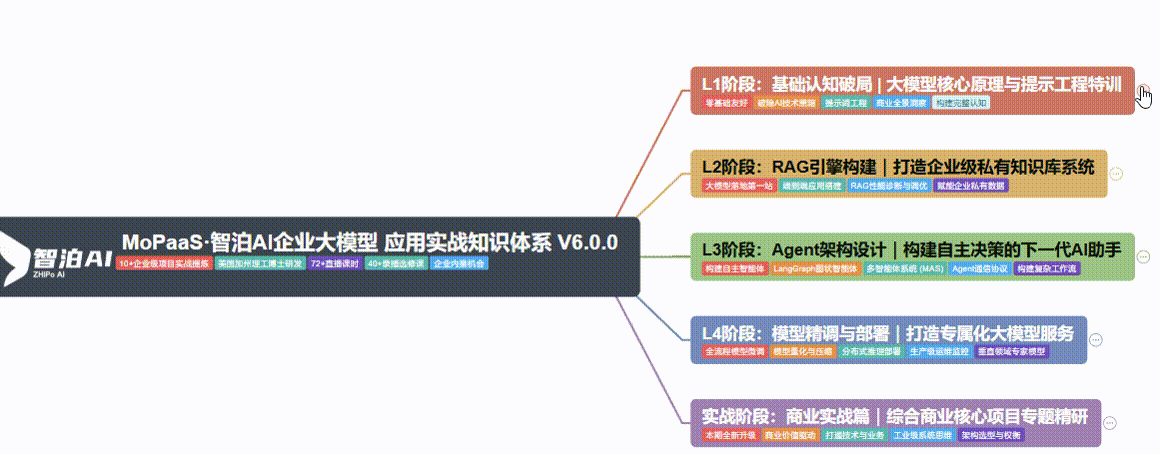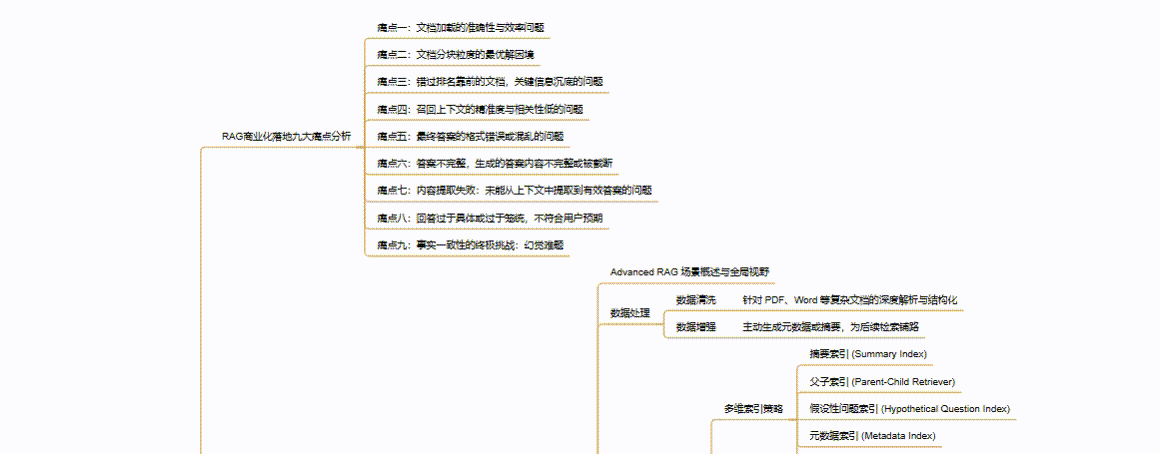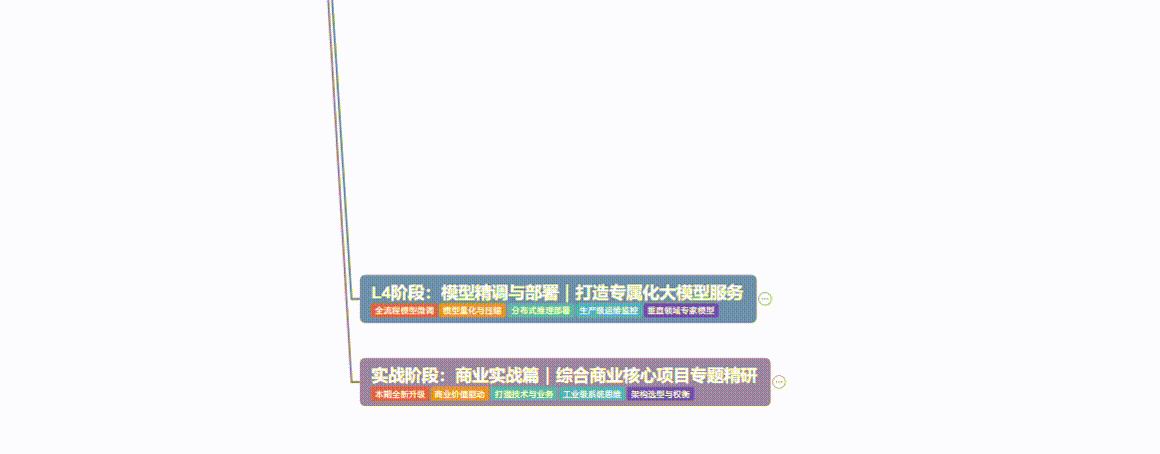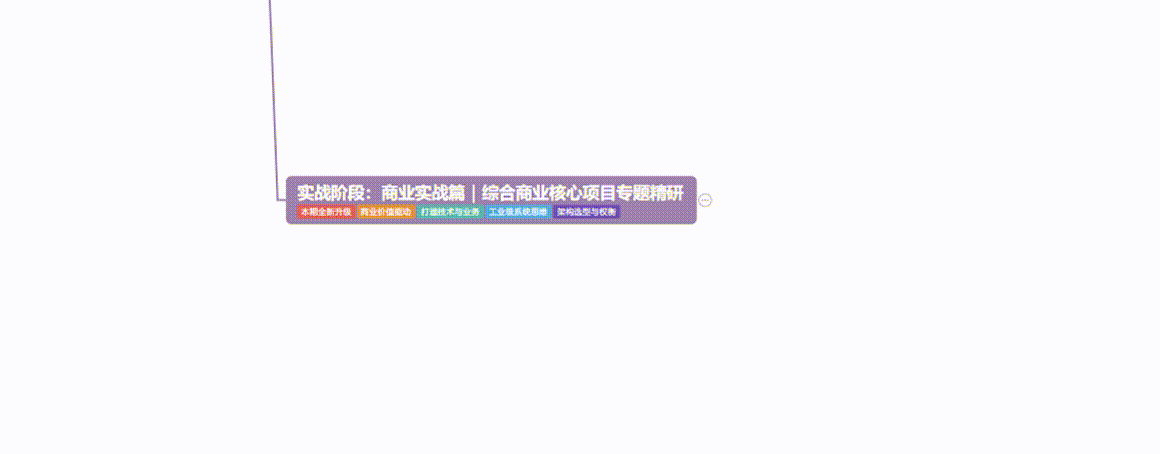
1、大模型系统化学习路线

这份学习路线结合2026年行业趋势和新手学习规律,由行业专家精心设计,从零基础到精通,每一步都有明确指引,帮你节省80%的无效学习时间,少走弯路、高效进阶,避免踩坑。
请添加图片描述

2、从0到进阶大模型学习视频教程

从入门到进阶这里都有,跟着老师学习事半功倍。

在这里插入图片描述

3、大模型学习书籍&电子文档

涵盖2026年最新技术要点,包括基础入门、Transformer核心原理、Prompt工程、RAG实战、模型微调与部署等内容
在这里插入图片描述

4、AI大模型最新行业报告

报告包含腾讯、阿里、甲子光年等权威机构发布的核心内容,还有2026年中文大模型基准测评报告、AI Agent行业研究报告等,帮你站在行业前沿,把握技术风口。
在这里插入图片描述

5、大模型项目实战&配套源码

项目包含Deepseek R1、GPT项目、MCP项目、RAG实战等热门方向,还有视频配套代码,手把手教你从0到1完成项目开发,既能练手提升技术,又能丰富简历,为求职和职业发展加分。

img

6、2026大模型大厂面试真题

2026年大模型面试已全面升级,不再单纯考察基础原理,而是转向侧重技术落地和业务结合的综合考察,很多程序员和新手因为缺乏针对性准备,明明技术不错,却在面试中失利。

img

适用人群

在这里插入图片描述

四阶段学习规划(共90天,可落地执行)
第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …
第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …
第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …
第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型

  • 带你了解全球大模型

  • 使用国产大模型服务

  • 搭建 OpenAI 代理

  • 热身:基于阿里云 PAI 部署 Stable Diffusion

  • 在本地计算机运行大模型

  • 大模型的私有化部署

  • 基于 vLLM 部署大模型

  • 案例:如何优雅地在阿里云私有部署开源大模型

  • 部署一套开源 LLM 项目

  • 内容安全

  • 互联网信息服务算法备案

  • …

👇👇扫码免费领取全部内容👇👇

在这里插入图片描述

7、这些资料真的有用吗?

这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。

资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。

在这里插入图片描述
在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

从零到一:基于Dify工作流与Agent框架构建企业级AI应用实战指南 如果你最近关注AI应用开发,可能会发现一个现象:很多团队不再从零开始写代码调用大模型API,而是转向了像Dify这样的可视化AI工作流平台。这背后反映的,不是一个简单的工具选择问题,而是一个根本性的效率鸿沟:传统开发模式下,一个包含对话、知识库、复杂逻辑判断的AI应用,从立项到上线可能需要数周;而现在,通过拖拽和配置,可能只需要几个小时。 这篇文章要解决的,正是这个效率鸿沟。我不会空谈“AI时代已来”这种大道理,而是直接带你上手Dify,通过拆解其核心概念和实战项目,让你在一周内,从“知道Dify这个名字” 阅读详情

相关推荐

从破解到自建:深度解析AI编程工具安全风险与本地化替代方案

在软件开发领域,软件授权验证机制是保护知识产权的重要技术手段,其核心原理涉及客户端校验与服务端硬校验的双重防护。随着SaaS(软件即服务)架构的普及,现代开发工具如AI编程助手的授权体系已从传统的本地激活转向云端身份验证与资源配额管理,这大幅提升了破解的技术门槛与法律风险。从技术价值看,合法使用开发工具不仅能保障代码资产与隐私安全,更是构建可持续、高效研发流程的基石。对于寻求功能扩展的开发者,采用开源模型本地部署(如通过Ollama运行DeepSeek-Coder)并配置编辑器自定义AI后端,已成为兼顾功能

weixin_33800463的博客 552

Agent基础知识学习,看这一篇就够了!

OpenAI的研究员 Lilian 写过一篇博客:《 LLM Powered Autonomous Agents》,将 Agents 定义为:LLM + memory + planning skills + tool use,即大语言模型、记忆、任务规划、工具使用的集合。Overview of a LLM-powered autonomous agent system.大语言模型 (LLM)是 Agent 的大脑,要求 Agent 具备以下 3 种能力来配合大脑完成任务:ReAct 的提示模板,大致格式如下

h1453586413的博客 3060

OpenClaw本地AI智能体Windows保姆级安装指南

AI智能体(AI Agent)是能自主执行操作的下一代AI应用形态,区别于传统聊天机器人,其核心在于本地化、可编程与任务闭环能力。OpenClaw作为典型代表,依托Node.js运行时、PowerShell系统集成与QQ通讯入口,实现真正‘开箱即用’的自动化工作流。它融合了命令行工具链、大模型调用与技能插件机制,技术价值体现在安全可控的本地执行、零API密钥的OAuth大模型接入(如Qwen),以及面向普通用户的低门槛交互设计。典型应用场景包括文件自动摘要、周报生成、网页表单填写、邮件会议纪要提取等办公提效

weixin_34167819的博客 524

AI 时代新出的最贵的工程师—— FDE 是什么?国内招吗?

💡 本文拆解一个最近在 AI 圈疯狂被讨论的岗位:FDE(Forward Deployed Engineer)。它从哪来、做什么、为什么 OpenAI 和 Anthropic 都在砸钱抢人、国内现在到底招不招、对普通开发者意味着什么。最近我在招聘网站上刷到一个岗位,岗位名字是「豆包 AI 大模型 FDE」,字节火山引擎挂的,杭州。薪资写的是,年薪算下来在之间。。更让我惊讶的是,蚂蚁那边类似岗位的标题甚至直接写着「」,连「驻场」两个字都没藏。这跟我对工程师岗位的传统印象差太远了。

weixin_46961967的博客 3509

什么是FDE?2026年下半年必火岗位

FDE(前沿部署工程师)是当前AI领域热门岗位,指深入客户现场定制化部署技术方案的工程师。他们不同于传统驻场开发或售前,而是兼具技术实现与业务理解能力,将AI系统真正嵌入企业流程。该概念源自军事领域,由Palantir引入商业,现被OpenAI等公司广泛采用。FDE需要快速响应客户需求、优化产品落地,并将经验反馈给产品团队,在AI时代成为解决技术落地难题的关键角色。这种复合型岗位薪资高、影响力大,预计2026年将持续火热。

全网120W+关注AI拉呱,专注人工智能以及科技前沿! 509

智能制造浪潮下的核心驱动力:AI智能体开发工程师深度解析与面试指南

北京舜天汇智科技招聘AI智能体开发工程师,要求统招本科相关专业,熟练掌握Python、数据库及科学计算工具,具备Langchain/LangGraph开发经验。岗位职责包括:基于开源大模型开发低代码平台,算法研究与模型优化,工业数据机器学习模块开发,NC-Link协议应用开发等。该职位聚焦智能制造领域AI技术落地,需应对工业数据复杂性、模型可靠性等技术挑战,是AI与制造业融合的关键技术岗位。

郑伟强dev的专栏 260

FDE(前沿部署工程师):AI时代年薪百万的新贵,到底值不值得冲?

值得冲,但有条件:如果你已经有2-3年AI应用开发经验→ 冲FDE是一个很好的职业升级方向,薪资涨幅明显如果你是完全小白→ 先打好模型部署基础,不要被"不写代码、年薪百万"的标签误导如果你喜欢纯研发→ FDE可能不适合你,客户沟通会消耗你大量精力FDE这个岗位确实被AI带火了,需求也是真实的。但它不是"躺赚"的岗位——你需要的技术广度、沟通能力、现场解决问题能力,一点也不比纯研发岗位要求低。新浪财经.《这个岗位被AI带火!数量一年暴涨7倍,年薪破百万》. 2026-05-18。

在渔村里看AI,偶尔捕点新鲜的。 5300

Unity 2021 LTS安装避坑指南:从下载到第一个3D项目的完整流程

本文提供了一份详尽的Unity 2021 LTS安装与首个3D项目创建指南。内容涵盖从Unity Hub下载、版本选择、模块安装避坑,到编辑器界面解析、创建旋转立方体脚本的完整流程,旨在帮助初学者快速搭建稳定开发环境并上手核心操作。

mango的博客 310

PEEK:构建上下文地图,解决LLM智能体长文档处理难题

在自然语言处理领域,检索增强生成(RAG)是一种将外部知识库与大型语言模型(LLM)结合的关键技术,旨在解决模型在处理长文本时存在的信息遗忘与定位困难问题。其核心原理是通过将非结构化文档转换为结构化的向量索引,构建一个语义化的“上下文地图”,使模型能够快速定位相关信息,而非依赖有限的上下文窗口进行硬记忆。这项技术的核心价值在于显著提升了LLM在长文档问答、知识库查询等场景下的准确性与效率,是构建实用智能体的工程基石。具体到应用层面,它广泛服务于需要处理技术文档、市场报告、代码库或多轮对话历史的智能体系统。本

weixin_30394669的博客 296

advanced installer 打包Flutter的Windows程序安装包(基本打包、开机自启、定时自动检测升级、包含卸载程序)

advanced installer 打包Flutter的Windows程序安装包(基本打包、开机自启、定时自动检测升级、包含卸载程序)

qq_45634989的博客 2878

DC算法竞赛——北京PM2.5浓度回归分析

北京PM2.5浓度回归分析 比赛结果(118/1150) 一. 概述 1、项目来源:https://www.dcjingsai.com/static_page/cmpList.html 2、给定数据字段如下: 3、使用方法:回归算法 4、目的:预测北京pm2.5值,使平均预测误差越小越好。 二、分析过程 setwd("E:/R数据源") #读入数据 data <- read.csv('p...

玻璃球的博客 3474

Transformer 时代的语言模型:大规模语言模型的发展脉络与技术演化

本文梳理了Transformer时代大规模语言模型(LLMs)的技术演进脉络。从2017年Transformer架构的提出开始,重点分析了关键技术创新:双向编码器BERT通过掩码语言建模实现深度理解;GPT-3证明模型规模与提示工程的协同效应;InstructGPT引入人类反馈强化学习(RLHF)实现指令对齐;LLaMA通过数据规模优化突破参数量限制;FlashAttention通过IO感知优化解决长序列处理瓶颈;LoRA和量化技术实现模型高效微调与部署;RAG架构扩展模型知识边界;智能体技术从工具调用发展

qq_44768937的博客 613

土壤水动力学_前 言

Van Genuchten (V-G) 模型是土壤水分特征曲线中最常用的模型之一。它通过数学方程描述了土壤基质吸力与体积含水量之间的关系,被广泛应用于土壤水分运移、土壤盐渍化、边坡稳定性等研究领域。V-G模型是描述土壤水分特征曲线的重要工具,但它并不是完美的。在实际应用中,需要根据土壤类型、试验条件等因素选择合适的模型。土壤基质吸力是土壤水分学中的一个重要概念,它对土壤水分的保持、植物的生长以及土壤的工程性质都有重要影响。

weixin_44259522的博客 5327

Qwen3-Coder:480B稀疏激活编程智能体实战指南

编程智能体(Agent)正从代码补全工具演进为端到端软件工程协作者,其核心在于执行驱动的推理能力与真实环境交互能力。Qwen3-Coder以4800亿总参数+350亿激活参数的MoE架构,实现高能力储备与低延迟响应的统一;依托256K原生上下文与YaRN外推技术,首次支持百万级token级代码库全局理解。该模型不追求泛化通用性,而是聚焦开发者真实工作流——从Figma生成可测试Vue组件、自动编写Jest/Playwright脚本,到集成CI/CD与私有知识图谱,本质是将‘写代码’升维为‘指挥系统’。本文深

shirlly 494

【ComfyUI专栏】ComfyUI 常用工作流下载与分享网址

首先我们来分享第一个网站,Openart 网站,这个网站同时也能提供比较多的其他类型。但是如果希望下载工作流,我们可以访问到如下的这个站点。作为ComfyUI的学习用户来说,我们通常需要借助他山之石来帮助我们快速成长,因此我们需要找到能够分享和下载的网址。,当前网站是综合性网站,在网站中可以下载各种不同的类型,其中工作流只是可以下载的非常小的部分。这个网站也可以浏览不同的工作流,这个工作流的地址和访问如下的站点。

技术与管理的平衡木- 7796

中兴交换机如何配置?有哪些常用的配置命令,本文值得收藏!

中兴交换机是一种常见的网络设备,用于构建和管理企业网络。它提供了丰富的功能和灵活的配置选项,使网络管理员能够根据特定需求进行定制化配置。本文将详细介绍中兴交换机的配置过程,包括登录、基本设置、VLAN配置、接口配置和安全配置等内容。

网络技术联盟站 1万+

AI全民制作人:从概念到实践,用AI生成游戏原型的完整指南

大语言模型(LLM)和生成式AI正在重塑内容创作流程,其核心原理是通过深度学习理解并生成文本、代码与多媒体内容。在游戏开发领域,这项技术的价值在于大幅降低创意验证和原型开发的门槛,使开发者能快速将想法转化为可交互的Demo。应用场景广泛,尤其适合独立开发者、游戏策划进行玩法测试和灵感激发。本文以“AI全民制作人”这一现象级项目为例,深入探讨了如何利用LLM和Godot引擎,通过分步骤、迭代式的协作流程,生成一个可运行的恐怖游戏原型。文章详细拆解了从游戏设计文档生成、核心代码编写到资源整合与调试的全过程,并针

weixin_34228387的博客 361

激光雷达点云可视化:Open3D与PCL实战

激光雷达点云可视化:Open3D与PCL实战 ,人工智能,计算机视觉,大模型,AI,该文围绕激光雷达点云可视化,介绍了Open3D与PCL的实战应用。先阐述点云基础概念、特点及可视化意义,接着讲解Open3D的简介、环境配置,以及其在点云读取、显示、颜色设置、下采样和滤波等方面的实战操作,还介绍了PCL的基础、环境配置及相关实战,包括点云读取、显示、颜色设置、下采样和滤波,同时对比了两者的易用性、功能覆盖、性能和适用场景,给出综合实战案例与常见问题解决方法,为点云可视化处理提供了全面指导。

不踩坑,不知道坑有多深;不总结,踩过的坑白踩。 12万+

什么是Agent?小白如何学习使用Agent?大模型时代的Agent开发:从理论到实践(建议收藏)

什么是Agent?为什么需要Agent?Agent的核心概念Agent的工作原理Agent的架构设计Agent的类型分类实际应用场景开发指南最佳实践常见问题解答总结Agent(智能代理)是一种能够感知环境、制定决策并自主执行行动的智能系统。它是人工智能领域的重要概念,代表了从被动响应到主动行动的技术演进。理论基础人工智能基础概念机器学习和深度学习自然语言处理技术强化学习理论技术实践熟悉主流AI框架(TensorFlow、PyTorch)掌握大语言模型应用学习Agent开发框架。

jennycisp的博客 1482

AI时代的软件质量保证新方法论

3.2.1 质量保证的方法论 质量保证(Quality Assurance, QA)是一种系统化的方法,用于确保产品或服务符合预定的质量标准。在AI时代,软件质量保证的方法论需要适应不断变化的AI技术和应用场景。 3.2.1.1 质量管理体系的构建 首先,构建一个完善

AI天才研究院 1352

VB摄像头监控

该VB模块可对摄像头捕获的画面进行录像等,可在创建的窗口进行控制

FDE(Forward Deployed Engineer)详解:AI时代正在崛起的新型工程师

FDE(前沿部署工程师)是AI时代连接技术与业务的新型工程角色。本文系统介绍FDE的定义、核心职责、能力模型、工作流程及职业发展,重点分析其如何融合业务理解、软件工程、AI工程与系统集成能力,通过快速原型、Agent开发、系统部署和持续迭代,将AI技术真正落地企业业务,最终实现可衡量的业务价值。

IT古董 1407

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

AI Agent开发学习路径:从入门到精通

阶段持续时间核心目标关键技术项目产出基础准备1-2周理解概念,搭建基础Python, API, LangChain基础概念验证Demo初级开发3-4周基础Agent实现工具调用, Prompt工程简单自动化工具中级开发4-6周增强Agent能力RAG, 记忆管理, 推理复杂任务处理系统高级开发6-8周复杂系统构建多Agent协作, 自治系统商业级解决方案专家拓展持续前沿探索与优化多模态, 行业应用创新产品与服务。

qq_20559365的博客 3670

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

【2026 最新】【Agent 开发】后端完整学习路线:从 LLM API 调用到生产级多 Agent 系统,按阶段学,不走弯路

本文为2026年Agent后端开发学习路线指南,面向有Python后端基础的开发者。文章将学习路径分为四个阶段:1)LLM API基础(2-3周),掌握API调用、Prompt工程和流式输出;2)工具调用与RAG(3-4周),学习Function Calling和向量数据库;3)Agent框架与MCP(4-6周),掌握LangGraph等框架;4)生产级多Agent系统(6-8周),学习编排和可观测性。每个阶段都设有里程碑项目,强调后端工程能力(如异步设计、可靠性)比AI知识更重要,并提供了技术栈选型和常见

小李同学_LSH的博客 1619

【必收藏】2026年大模型学习必看,小白/程序员入门进阶不踩坑

2026年技术圈的分化愈发明显:降薪裁员潮持续蔓延,传统开发、测试等岗位大批缩水,不少从业者陷入职业焦虑;与之形成鲜明对比的是,AI大模型相关岗位迎来疯狂扩招,薪资逆势飙升,大厂更是直接开出年薪,疯抢具备实战能力的大模型人才,甚至放宽年龄限制,只求能快速落地技术、创造价值!:不同于成熟赛道的“内卷式招聘”,2026年大模型人才缺口巨大,简历只要达标(掌握基础AI应用+具备简单项目经验),年龄、学历均非硬性要求,小白可快速入门,转行程序员也能无缝衔接;

EnjoyEDU的博客 517

FDE(前沿部署工程师)深度解析:AI时代最火爆的新型技术人才

前沿部署工程师(FDE):AI时代的关键角色 前沿部署工程师(FDE)是驻扎客户现场的技术专家,融合工程师与咨询顾问双重角色,负责将AI技术适配到具体业务场景。该模式由Palantir首创,在AI落地浪潮中爆发式增长,2025年相关岗位激增800%。FDE与传统驻场开发的核心区别在于:前者通过深度服务探索产品化路径,后者仅完成项目交付。典型案例包括工业产线优化、农业智能喷洒等。FDE需具备编程、业务理解、沟通协调等复合能力,其价值在于将现场经验沉淀为可复用的平台能力,推动AI技术从实验室走向产业应用。

鄙人kunzhi96,感恩遇见! 5642

Agent 快速学习指南

Agent(智能体)是能够自主感知环境、做出决策并执行行动的 AI 系统。自主性:能够独立运行,无需持续人工干预感知能力:能够获取和处理环境信息决策能力:基于感知信息做出合理决策执行能力:能够执行具体的行动和操作tools = ["description": "读取文件内容","description": "文件路径"},},"description": "写入文件内容",},

gaoyunwei的博客 712
上一篇: AI+制造:大小模型协同破解制造企业痛点,小白程序员必备收藏!
下一篇: 收藏!小白程序员抓住AI大模型应用开发红利期,转行就业新机遇!
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


