收藏 | 手把手教你用微调技术,把大模型变成你的专属专才(小白程序员必看)

【Labview学习】——如何实现软件的中/英文切换 各位亲爱的小伙伴们大家好,这里是小万的labview专题,今天为大家带来的是软件的中/英文切换,在全球化的浪潮之下,各行各业发生着巨大的变化,emmm………… 以下是简单的演示图片,注意观察菜单栏和软件界面各控件的语言状态: 本次分享将分为两部分:菜单中英文切换&界面控件中英文切换 ** 菜单中英文切换 ** 1. 中/英文菜单制造 要想实现菜单的中/英文语言切换,就得做两个菜单,一个... 阅读详情

本文详细介绍了微调技术,解释了如何在预训练大模型的基础上,通过少量专业数据训练使其适应特定任务。文章从微调的背景、核心概念、技术原理、不同方法(如LoRA、Adapter等)及应用案例等方面展开,强调了微调在降低成本、提高效率和增强模型专业性方面的优势,并指出了可能面临的挑战,如灾难性遗忘和数据质量依赖。通过学习本文,读者可以掌握如何将通用大模型转化为领域专家模型,从而在医疗、法律、代码编写等领域实现高效应用。

一、背景:为什么需要微调?

想象一下,你刚刚学会了汉语的基本语法和词汇,能够理解和表达日常对话,但如果让你去当医生、律师或程序员,你就需要在已有的语言基础上,再学习专业知识和专业表达方式。

大语言模型就像这样一个"语言天才"。它们通过预训练阶段在海量文本上学习,掌握了丰富的语言知识和常识,但要在特定领域发挥作用,就需要进一步的专业化训练——这就是微调的作用。

传统解法:重新培训(训练新模型)—— 耗时费钱,浪费原有天赋。

创新方案:微调 → 在原有能力基础上,用少量专业数据针对性强化。

二、核心概念:什么是微调?

1. 基本概念

定义:在预训练大模型的基础上,用特定领域的小规模数据继续训练,使其适应专门任务的过程。

类比:

预训练 = 读完12年基础教育(掌握通用知识);

微调 = 大学专业课程(4年针对性学习成为医生/律师/工程师)。

微调的核心思想是“站在巨人的肩膀上”:

1.保留基础能力:不从零开始,而是基于已有的强大基础。

2.针对性优化:只需要相对少量的数据来学习特定任务。

3.高效利用资源:相比从头训练,大大减少了计算和数据需求。

2. 微调 vs 预训练

对比维度预训练微调
数据规模海量(TB级)少量(MB-GB级)
数据标注需求无需标注需标注
训练目标学习通用语言规律适应特定任务
计算成本极高(百万美元级)较低(百美元级)
输出结果基础模型领域专家模型

三、技术原理:微调如何工作?

1. 微调训练过程

教预训练模型识别“差评”:

(1)输入:“手机电池续航太差了!” → 真实标签:差评;

(2)模型初始预测:中性(未理解“差”的情感强度);

(3)系统计算误差 → 微调情感分析相关参数;

(4)反复训练后 → 模型学会“差”“糟糕”“垃圾”等词的负面含义。

2. 参数更新机制

想象模型的参数就像一个人的知识结构。预训练阶段建立了基础的知识框架,微调阶段则在这个框架上进行精细调整:

(1)梯度计算过程

  • 前向传播:输入数据通过模型计算得到预测结果
  • 损失计算:比较预测结果与真实标签,计算损失值
  • 反向传播:计算损失对每个参数的梯度
  • 参数更新:使用梯度下降法更新参数

(2)学习率策略

  • 分层学习率:对不同层设置不同的学习率,通常底层(更通用)用更小的学习率
  • 学习率衰减:随着训练进行逐步减小学习率,避免在最优解附近振荡
  • 热身策略:开始时使用很小的学习率,逐步增加到目标值

(3)损失函数设计

  • 分类任务:交叉熵损失 + 正则化项
  • 生成任务:语言模型损失(下一词预测)
  • 多任务:加权组合多个任务的损失

数学表达:

微调目标:minimize L_finetune = L_task + λ * L_regularization

其中:

  • L_task:任务特定损失

  • L_regularization:正则化项(如L2正则化)

  • λ:正则化权重

四、微调的类型和方法详解

1. 微调方法分类体系

2. 全参数微调(Full Fine-tuning)

全参数微调是最直接的方法,更新模型的所有参数。

优势:

  • 理论上能达到最好的性能
  • 对任务的适应性最强
  • 实现简单,技术门槛低

劣势:

  • 计算成本极高(需要完整模型的梯度计算和存储)
  • 内存需求大(需要存储所有参数的梯度)
  • 容易过拟合(特别是在小数据集上)
  • 部署成本高(需要存储完整的微调后模型)

3. 高效微调(Parameter-Efficient Fine-tuning)

3.1 LoRA微调

基本概念

LoRA基于一个重要假设:模型适应新任务时,权重矩阵的更新具有低秩特性。

数学原理:

原始计算:y = Wx

LoRA计算:y = Wx + ΔWx = Wx + BAx

其中:

  • W:原始权重矩阵(frozen,不更新)

  • ΔW = BA:权重更新矩阵

  • B ∈ R^(d×r),A ∈ R^(r×k)

  • r << min(d,k):秩大大小于原矩阵维度

关键实现细节:

(1)初始化策略

  • 矩阵A:使用高斯随机初始化
  • 矩阵B:使用零初始化,确保初始时ΔW = BA = 0
  • 这样确保训练开始时模型行为与原模型一致

(2)秩的选择(r值)

  • r=1: 参数最少,但表达能力有限
  • r=4-8: 平衡性能和效率的常用选择
  • r=16-64: 更好性能,但参数量增加
  • 经验法则:r ≈ 原矩阵最小维度的1%-10%

(3)缩放因子α

  • 控制LoRA部分的贡献大小
  • 通常设置为α = r,使得初始学习率合理
  • 可以作为超参数进行调优

LoRA的变体:

(1)AdaLoRA (Adaptive LoRA)

  • 动态调整不同层的秩
  • 重要的层分配更高的秩
  • 通过奇异值分解进行重要性评估

(2)QLoRA (Quantized LoRA)

  • 结合量化技术,进一步减少内存占用
  • 基础模型使用4-bit量化
  • LoRA部分保持16-bit精度
  • 在保持性能的同时大幅减少显存需求
3.2 Adapter方法

在层间插入小型神经网络(“知识过滤器”)

3.3 提示微调(Prompt Tuning)

在输入序列前添加可学习的提示词:

原始输入: [CLS] I love this movie [SEP]

Prompt Tuning: [P1] [P2] [P3] [CLS] I love this movie [SEP]

其中 [P1], [P2], [P3] 是可学习的embedding向量

3.4 各方法对比

方法参数量训练时间推理速度性能内存占用
全参数微调100%最长正常最好最高
LoRA0.1-1%中等正常很好低
Adapter2-4%中等略慢好中等
Prompt Tuning0.01-0.1%最短最快一般最低

使用场景建议:

(1)LoRA

  • 适合大多数场景的首选方案
  • 在性能和效率间取得很好平衡
  • 特别适合语言生成任务

(2)Adapter

  • 适合需要在多个任务间快速切换的场景
  • 每个任务只需要保存对应的Adapter参数

(3)Prompt Tuning

  • 适合快速原型开发
  • 在大模型上效果更好
  • 适合少样本学习场景

(4)全参数微调

  • 有充足计算资源且追求最佳性能
  • 数据集较大且质量很高
  • 任务与预训练差异较大

五、应用场景案例

  1. 医疗诊断助手
  • 微调数据:10万份脱敏病历+医学文献
  • 效果:准确解读“血清肌钙蛋白升高提示心肌损伤”
  1. 金融合规审核
  • 微调数据:监管文件+风险案例库
  • 效果:识别“阴阳合同”“洗钱话术”准确率提升40%
  1. 教育作文批改

六、微调的优势与挑战

1. 主要优势

(1)成本效益高

  • 训练时间从数月缩短到数小时或数天
  • 数据需求从TB级别降低到GB级别
  • 计算资源需求大幅减少

(2)效果显著

  • 在特定任务上通常比通用模型表现更好
  • 能够快速适应领域特定的语言风格和专业术语

(3)灵活性强

  • 可以针对不同任务进行多次微调
  • 支持个性化定制

2. 面临的挑战

(1)灾难性遗忘

  • 模型可能会忘记预训练阶段学到的通用知识
  • 需要平衡新任务学习和知识保留

(2)数据质量依赖

  • 微调效果很大程度上取决于训练数据的质量
  • 低质量数据可能导致模型性能下降

(3)过拟合风险

  • 在小数据集上容易出现过拟合
  • 需要合适的正则化技术

总结

微调技术是大模型时代的关键技术之一,它让AI应用变得更加易得和实用。通过在预训练模型基础上进行针对性训练,微调能够以较低的成本快速获得高质量的专用模型。随着技术的不断发展,微调将在AI普及化和产业化中发挥越来越重要的作用,让每个组织都能够拥有属于自己的专业AI助手。

最后

对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?

答案只有一个:人工智能(尤其是大模型方向)

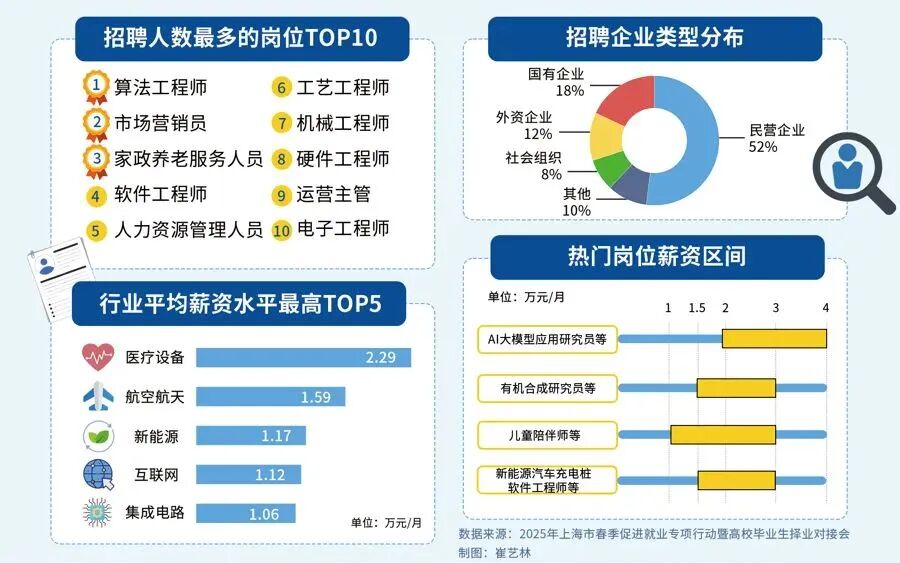
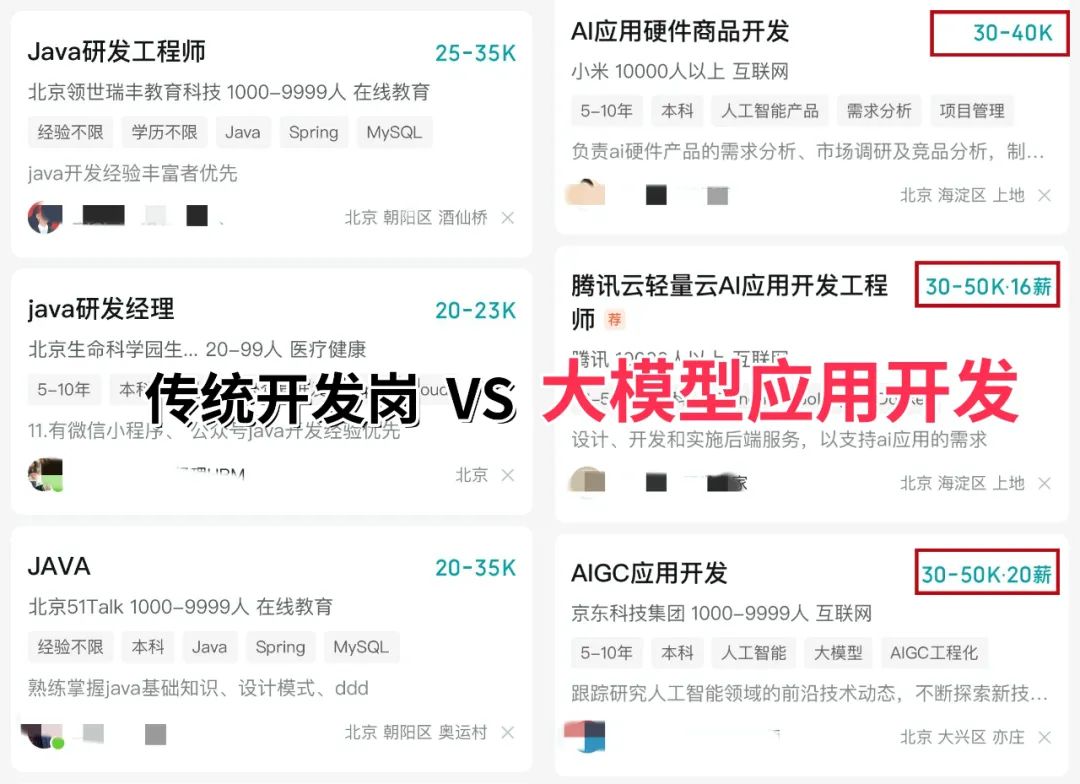
当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。

再看阿里、腾讯两大互联网大厂,非“人才计划”的AI相关岗位应聘者,月基础工资也约有3万元,远超其他行业同资历岗位的薪资水平,对于程序员、小白来说,无疑是绝佳的转型和提升赛道。
图片
图片
对于想入局大模型、抢占未来10年行业红利的程序员和小白来说,现在正是最好的学习时机:行业缺口大、大厂需求旺、薪资天花板高,只要找准学习方向,稳步提升技能,就能轻松摆脱“低薪困境”,抓住AI时代的职业机遇。

如果你还不知道从何开始,我自己整理一套全网最全最细的大模型零基础教程,我也是一路自学走过来的,很清楚小白前期学习的痛楚,你要是没有方向还没有好的资源,根本学不到东西!

下面是我整理的大模型学习资源,希望能帮到你。
请添加图片描述

👇👇扫码免费领取全部内容👇👇

在这里插入图片描述

1、大模型学习路线

img

2、从0到进阶大模型学习视频教程

从入门到进阶这里都有,跟着老师学习事半功倍。

在这里插入图片描述

3、 入门必看大模型学习书籍&文档.pdf(书面上的技术书籍确实太多了,这些是我精选出来的,还有很多不在图里)

在这里插入图片描述

4、 AI大模型最新行业报告

2026最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

img

5、面试试题/经验

img

【大厂 AI 岗位面经分享(107 道)】

img

【AI 大模型面试真题(102 道)】

img

【LLMs 面试真题(97 道)】

img

6、大模型项目实战&配套源码

img

适用人群

在这里插入图片描述

四阶段学习规划(共90天,可落地执行)
第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …
第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …
第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …
第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型

  • 带你了解全球大模型

  • 使用国产大模型服务

  • 搭建 OpenAI 代理

  • 热身:基于阿里云 PAI 部署 Stable Diffusion

  • 在本地计算机运行大模型

  • 大模型的私有化部署

  • 基于 vLLM 部署大模型

  • 案例:如何优雅地在阿里云私有部署开源大模型

  • 部署一套开源 LLM 项目

  • 内容安全

  • 互联网信息服务算法备案

  • …

    👇👇扫码免费领取全部内容👇👇

    在这里插入图片描述

3、这些资料真的有用吗?

这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。

资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。

在这里插入图片描述
在这里插入图片描述

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

在这里插入图片描述

HDOCK 蛋白蛋白对接软件使用;LZerD、pyDock、ClusPro网页在线对接 参考:hdock支持蛋白与蛋白,也支持蛋白与核酸对接计算。 阅读详情

相关推荐

IB网络下不同租户业务隔离方案

IB(InfiniBand)网络隔离可以在不同的通信模式下实现,其中包括 IPoIB(IP over InfiniBand)通信模式。在 IPoIB 模式下,InfiniBand 网络可以承载 IP 数据包,使得基于 IP 的应用程序能够在 InfiniBand 网络上进行通信。在这种情况下,IB 网络隔离通常指通过配置 Partition Key(PKey)来实现不同的租户或应用程序之间的网络隔离。然而,IB 网络隔离并不仅限于 IPoIB 模式。

guganly的专栏 1527

收藏!程序员必看:月薪11万+的大模型岗位,小白也能抓住的转型红利

对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?答案只有一个:人工智能(尤其是大模型方向)当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。

大模型教程的博客 670

FPGA_AD9361实战

1.参考网站。

Pual_Georg的博客 748

手把手教你从0到1搭建一个AI Agent(智能体)

本文介绍了ReAct Agent的概念和组成并通过代码实现了一个Ai Agent(智能体)

weixin_48707135的博客 10万+

团结引擎+OpenHarmony 记录 (持续更新中)

获取不到的原因是因为二者不在同一个线程中,所以数据没有同步。而 globalThis.context 数据进行了同步。(TuanjieMainWorkerHandler.ts中可以看到)在进行绘制 UI 的时候 ,如果组件有 Native API 就可能不会显示出来,例如 web 控件就不能展示出来,刚加上权限的时候 会报错 因为缺少 reason ,添加上就不会报错了。只有纯 UI 控件是可以展示出来的,注释掉 web控件后就可以。

m_cainiaokuaifei的博客 1491

【QT开发教程】Qt中的跨平台文件系统操作

文件系统操作是应用程序开发中经常需要处理的任务。Qt提供了一套跨平台的文件系统操作API,使开发者能够在不同操作系统上无缝地进行文件和目录操作。本文将介绍Qt中的跨平台文件系统操作,包括基本概念、常用类和方法以及实际示例。

科技改变人类,技术成就未来 981

AI智能体开发框架,怎么开发一个AI智能体(AI Agent)

背景:1、AI智能体作为当前最优AI应用模式已然成为必会的开发能力。2、AI智能体开发框架已然成为程序员必须掌握的新开发环境,类似visual studio这样的开发工具。3、AI Agent 让 “人机协同” 成为新常态,个人与企业步入 AI 助理时代。AI Agent 能够帮助未来企业构建以 “人机协同” 为核心的智能化运营新常态。4、AI Agent 变革未来生产力的组织形式,对抗组织熵增。

m0_59164304的博客 3059

【1.2】Costas环的基本原理概述

Costas环是一种用于载波恢复的相干解调技术,可直接从BPSK等抑制载波信号中恢复本地载波并完成解调。其核心结构包含同相/正交双支路处理,通过混频、低通滤波后,利用I/Q支路信号乘积进行相位误差检测,经环路滤波器调节VCO输出频率,实现载波同步。课程将重点讲解Costas环的MATLAB仿真实现、系统性能分析及FPGA开发,包括信号产生、频偏模拟、滤波器设计等模块,并通过AWGN信道和不同频偏条件下的测试验证系统性能。该技术无需单独提取载波,在数字通信系统中具有重要应用价值。

fpga/matlab/simulink算法仿真工程 451

AI Agent 智能体开发工作手册详细指南,建议收藏!

若能访问一系列工具(例如:代码执行或网络搜索),AI Agent 智能体能够决定采用何种工具、如何运用它,并根据输出结果进行迭代优化。这种灵活性使得系统能以最低限度的配置应对多样化的应用场景。

2401_85373691的博客 3243

让闲置 MacBook 当 OpenClaw 主机:合盖运行 + 后台常驻

摘要 本文详细介绍如何将闲置MacBook改造为OpenClaw服务器,实现合盖后持续运行。首先推荐Ubuntu 22.04 LTS作为操作系统,提供详细的安装步骤和分区建议。重点介绍三种禁用合盖休眠的方法:修改systemd-logind配置、使用pm-utils工具以及调整GRUB设置。随后指导如何安装Docker并部署OpenClaw服务,包括创建docker-compose.yml文件和配置环境变量。最后说明如何设置系统服务实现OpenClaw开机自启。通过以上配置,可使MacBook在合盖状态下7

一键难忘的博客 4656

CSP-J2019普及组复赛T4:加工零件

CSP-J2020普及组复赛T1:优秀的拆分,广度优先遍历求最短路。

少儿编程乔老师 1854

从0到1开发AI Agent(智能体):基于大模型的AI Agent技术框架

系统会总结出最终的答案,以完成整个任务处理过程图2:流程可以看出Agent执行任务时的循环非常重要。这个循环促使 Agent 不断反思,并根据当前状况判断是否完成任务。

bagell的博客 2520

[deprecated]第九章:SVM机制: 9-2 Linux HMM原理与实现详解

Linux内核HMM(异构内存管理)子系统为异构计算平台提供统一内存管理机制,支持CPU与GPU等设备共享虚拟地址空间,实现零拷贝数据访问。其核心功能包括:1)统一虚拟地址空间,设备可直接访问CPU进程内存;2)实时页表同步与失效通知,确保地址空间一致性;3)支持设备端page fault处理;4)管理多种内存类型(系统内存、设备私有内存等)。HMM通过mmu_interval_notifier机制感知地址空间变化,提供标准API简化驱动开发,显著提升异构计算性能和数据传输效率。

图形/计算GPU的驱动与虚拟化技术分享园地 2547

收藏备用|大模型微调全流程保姆级教程(小白/程序员必看)

微调(Fine-tuning)大模型,通俗来讲,就是给一个“博览群书”的基础大模型(预训练完成,已掌握通用语言规律和基础世界知识),做一次“针对性专业特训”。我们可以把预训练大模型理解为一个“全才”,什么都懂一点,但面对医疗、法律、企业内部业务等特定领域的专业需求时,就显得不够“精通”,甚至会出现答非所问、不懂行业黑话的情况。而微调的核心,就是用少量、高质量的领域专属数据,在基础大模型的基础上继续训练,让模型聚焦某个垂直领域深耕细作,从“样样通、样样松”的全才,蜕变为“术业有专攻”的领域专才。

大模型研究中心 2042

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

【程序员必看】大模型微调实战:LLaMA Factory+Ollama打造专属AI助手(建议收藏)

文章详细介绍了大模型微调的概念、方法和实践流程。解释了微调相较于训练完整大模型的成本优势,介绍了微调的基本步骤:数据准备、模型训练、评估和使用。重点讲解了如何使用LLaMA Factory工具进行微调,包括数据格式准备、模型配置和训练过程。最后介绍了如何将微调后的模型通过GGUF格式转换并在Ollama中运行,形成完整的微调流程,让开发者能低成本打造专属AI模型。模型微调,需要我们先选定一个模型。如果选定的模型是像 OpenAI 这样的闭源模型,就需要使用其对应的模型微调服务。不过,使用这种服务也就意味着要

AI大模型的博客 830

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

什么是大模型微调?如何对大模型进行微调?大模型入门到精通,收藏这篇就够了

从GPT-3到ChatGPT,再到GPT-4和GitHub Copilot,微调在这些过程中发挥了重要作用。什么是微调?微调能解决哪些问题?LoRA又是什么?如何进行微调?本文将解答上述问题,并通过代码示例展示如何使用LoRA进行微调。微调的技术门槛不高,对于规模不超过100亿参数的模型,所需的硬件成本也不高(100亿参数的模型并非玩具,许多实际应用中会使用这种规模的模型)。即使是非专业的算法人员,也可以尝试微调自己的模型。除了ChatGPT和GitHub Copilot,微调还可以应用于许多其他领域。

Python单行客的博客 1823

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

收藏备用|小白&程序员必看 大模型入门全解析

大模型,英文为 Large Model(直译大型模型),早期也被称为 Foundation Model(基础模型),全称是“人工智能预训练大模型”。其中“预训练”是大模型的核心技术支撑,后续会结合训练流程,给大家拆解清楚它的具体作用,新手可重点关注这一知识点。在日常技术交流和实际应用中,我们常说的大模型,大多特指语言大模型(Large Language Model,简称 LLM,也叫大语言模型)——这是目前最贴近程序员和普通用户、应用范围最广的类型。

qq_46094651的博客 1806

程序员必看!大模型微调完整教程,含代码案例,建议收藏学习

本文详细介绍了大模型微调的完整流程,包括数据准备(收集、预处理、格式转换)、模型微调(环境配置、模型选择、SFT实施)以及运行部署。文章提供了Python代码示例,展示数据清洗、格式转换、LoRA参数高效微调及模型训练全过程,为开发者提供了实用的技术指导。

2401_85375186的博客 1332

收藏备用|大模型微调全解析:从全量到高效微调,小白程序员也能轻松入门

对于小白程序员和AI初学者来说,大模型微调的核心价值,就是“用最低的成本,让大模型适配自己的需求”——无需掌握复杂的模型搭建技巧,无需拥有高性能硬件,通过简单的微调方法,就能让预训练大模型在编程、数据分析、文本处理等专属场景中,发挥更强的作用。入门阶段:优先学习Prompt Tuning,操作最简单,快速熟悉微调流程;实操阶段:优先使用Adapter,适配大多数任务,兼顾效率和性能,适合日常练手;进阶阶段:学习LoRA及其变体,适配大规模模型,提升任务精度,为后续实际项目落地打下基础。

AI大模型的博客 1746

【程序员必备】LoRA微调技术面经总结:收藏级大模型学习指南

文章详细介绍了LoRA(低秩适应)技术,这是一种用于大模型高效微调的方法。LoRA通过低秩分解模拟参数变化,冻结原模型参数,只训练少量旁路矩阵,显著降低显存需求,使普通显卡也能进行大模型微调。文章从概念、特点、优缺点到训练理论进行了全面解析,解答了LoRA权重合并、参数设置、过拟合避免等14个关键问题,为程序员提供了实用的大模型微调技术指南。

2301_80239908的博客 1027

大模型微调技术全解析:程序员必备收藏指南

本文系统介绍大模型微调技术的发展历程与技术路线,详细分析AI发展的四个核心阶段,阐述大模型特点与微调必要性。重点解析PEFT主流技术方案,包括Prompt Tuning、LoRA、QLoRA和AdaLoRA等参数高效微调方法,并探讨未来架构创新、可解释性和伦理等挑战,为AI从业者提供大模型微调的全面技术指南。

lvaolan168的博客 1058

为什么大模型如此强大我们还要微调?程序员必收藏的微调详解

本文探讨了在大模型背景下微调的必要性与应用场景,详细解释了微调与提示词的本质区别("改造"vs"引导"),并通过实例介绍了意图识别、关键词抽取等微调任务的实践方法。文章强调了数据质量对微调效果的关键影响,指出当需要将模糊口语转化为稳定、低延迟的结构化输出时,微调是必要的工具。

2401_85325726的博客 974

大模型微调项目的营销之道:从数据到评测,程序员必看收藏指南

本文强调大模型微调项目的营销价值远超技术本身。新手程序员应避免简单复刻教程,而应注重数据质量与多样性,构建独特且贴近业务场景的数据集。建立科学评测方法,避免仅凭主观感受。调参有用但非最高效,应更多优化数据集。通过有深度的项目展示,体现业务思维和潜力,才能在面试中脱颖而出,超越只会复现项目的竞争者。

Android_XG的博客 885

小白也能懂:大模型训练与微调技术全解析(程序员必看收藏)

文章详细解释了大模型的训练过程,包括预训练(获取基座模型)、后训练(监督微调SFT和强化学习RL)等核心概念。通过DeepSeek和Qwen两个实际案例,展示了如何在不同场景下应用这些训练方法来优化模型性能。文章旨在帮助初学者理解大模型训练的基础逻辑,为后续实践打下基础。

m0_63171455的博客 1045

收藏!小白程序员必看:吃透LORA微调,轻松入门大模型实操

当下,大模型高效微调已成为AI领域的核心热点,无论是通用场景的基础大模型,还是智驾、医疗等垂直领域的专用大模型,如何通过轻量级微调,快速将其改造为适配自身需求的专业模型,是每一位程序员、AI入门者都在关注和探索的核心问题。

weixin_72959097的博客 673
上一篇: 必收藏】2026新质生产力风口!5个适合程序员/小白转行的高薪方向(附3个月落地学习路径)
下一篇: 收藏备用|2026年大模型入门指南:小白/程序员零弯路转行实操手册
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值