收藏!AI大模型核心组件全解析:从入门到实战的学习指南

【AI大模型】SpringBoot整合Spring AI 核心组件使用详解 SpringBoot整合Spring AI 核心组件使用详解 阅读详情

在AI技术全面渗透各行各业的当下,一款能落地的实用AI应用,绝非单一技术的“单打独斗”,而是由多个核心组件协同运作的“虚拟协作团队”。从全天候高效运转的“执行者”,到支撑决策输出的“智慧大脑”,再到规避虚假信息的“专属知识库”,以及打通人机协同壁垒的“沟通桥梁”,每个组件都在AI应用中扮演着不可替代的角色。对于想要入门大模型的程序员和小白来说,吃透这些核心组件,是搭建AI应用、抢占技术先机的关键。

一、AI世界的“全能执行者”——智能体(Agent)

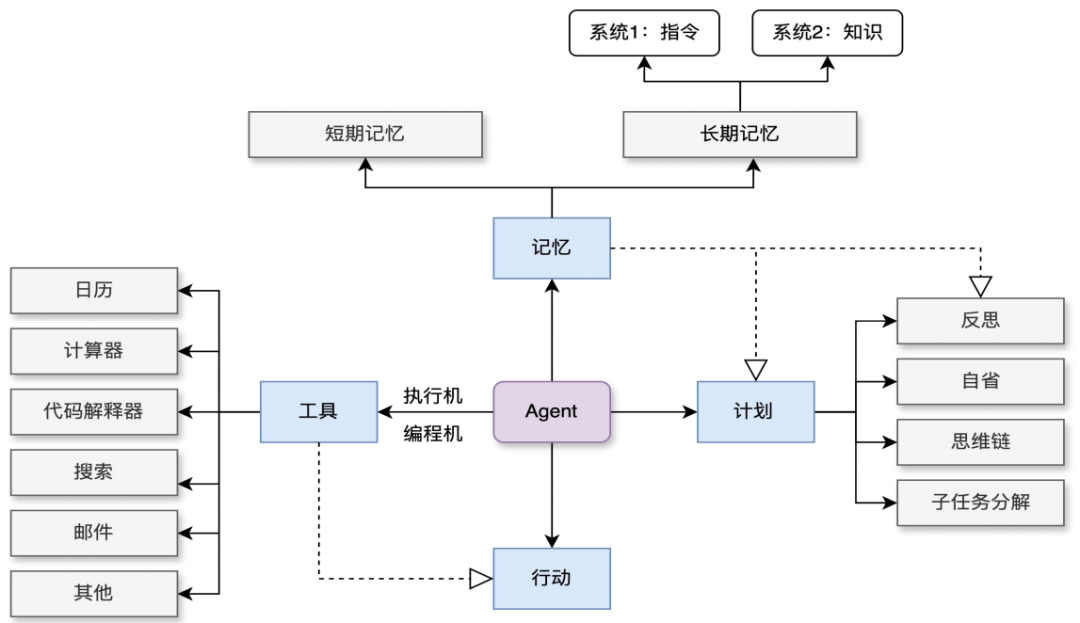
若将AI应用类比成一家高效运转的公司,智能体(Agent)就是那位全年无休、无需管理的“金牌员工”。它与传统AI的核心差异,如同“自主规划的项目经理”与“按部就班的流水线工人”:传统AI仅能机械执行预设脚本,比如按固定规则过滤邮件、识别指定类型图片,一旦超出预设范围便会直接“卡壳”;而智能体具备主动感知、决策与执行的能力,能像真人一样读取系统数据、精准识别用户核心需求,拆解复杂任务目标,甚至自主调用工具完成全流程闭环。

举例来说,当用户提出“生成月度销售报表”需求时,智能体能自主拆解为“提取CRM系统核心数据→计算环比/同比增长率→生成可视化图表→导出Excel文件”等步骤,自动连接Excel、调用数据接口,全程无需人工介入。如今企业布局的智能体平台,本质是为这些“虚拟员工”搭建的“数字化协同办公场景”,一个成熟的平台必须攻克三大核心痛点:

  • 长效记忆能力:既能存储短期任务参数(如当前报表的时间范围、数据维度),也能沉淀长期用户偏好(如过往报表的格式、重点展示指标);
  • 复杂任务规划:面对多环节任务时,能拆解为可落地的小步骤,避免“眉毛胡子一把抓”导致的执行混乱;
  • 跨工具协作:无缝对接企业内部ERP、数据分析、OA等系统,打破工具壁垒实现端到端自动化。

某头部电商的大促场景就是典型案例:智能体实时监控全品类库存数据,当某商品库存低于预设阈值时,自动调用采购系统生成精准补货单,同步通过OA推送至采购部门,还能跟踪补货进度并同步给运营团队,全程实现“无人化值守”。
图片

二、AI的“智慧大脑”——大语言模型(LLM)

如果说智能体是“执行者”,那大语言模型(LLM)就是支撑其决策的“智慧大脑”,我们熟知的ChatGPT、通义千问等,都属于这类“大脑”。它的核心能力可以概括为“能听懂、会表达”:既能精准理解人类的自然语言(比如从用户模糊的需求“帮我整理下客户反馈”中,提炼出“按问题类型分类、统计高频问题”的核心目标),也能生成符合人类表达习惯的内容(比如用口语化的语言回复客户咨询,或用专业术语撰写行业报告)。

LLM的“成长之路”分为两个关键阶段,如同人类从基础教育到职业培训的过程:

  1. 预训练阶段:相当于“九年义务教育+高中通识教育”,模型会海量学习互联网上的文本数据(包括书籍、论文、新闻、网页等),掌握语言的基本规律(比如语法、语义、逻辑关系),以及各领域的常识性知识(比如历史事件、科学原理、文化习俗)。这个阶段结束后,模型已经具备了基础的语言理解和生成能力,但还无法胜任特定场景的专业任务。
  2. 微调阶段:相当于“大学专业学习+职场技能培训”,开发者会针对具体任务(比如客服对话、法律文书撰写、代码生成),提供专门的数据集对模型进行训练。例如,要让模型成为金融领域的客服,就会用大量的金融客服对话数据进行微调,让模型掌握金融术语、了解常见的客户问题(如信用卡还款、理财产品咨询)及对应的回答逻辑。

目前,大多数企业开发AI应用时,并不会从零开始训练LLM(毕竟训练一个百亿参数的模型需要数亿元的算力成本),而是通过API接口调用已有的成熟模型(如调用GPT-4、通义千问的API),就像“租用现成的超级大脑”。不过要注意,LLM的参数规模直接影响其能力,比如通义千问的70亿参数模型,在处理简单对话任务时表现良好,而处理复杂的逻辑推理、多轮对话任务时,可能就需要用到参数规模更大的版本(如千亿参数模型),相应的调用成本也会更高。

三、AI的“随身知识库”——RAG技术

尽管LLM“学识渊博”,但它有一个致命的弱点:对于训练数据之外的新知识,或者企业内部的私密信息,往往会“一无所知”,甚至会编造虚假信息来回答(业内称之为“幻觉”)。这就好比一个学霸,虽然掌握了课本上的所有知识,但面对老师临时补充的课外内容,或者同学的私人笔记,要么答不上来,要么只能靠猜测胡说一通。

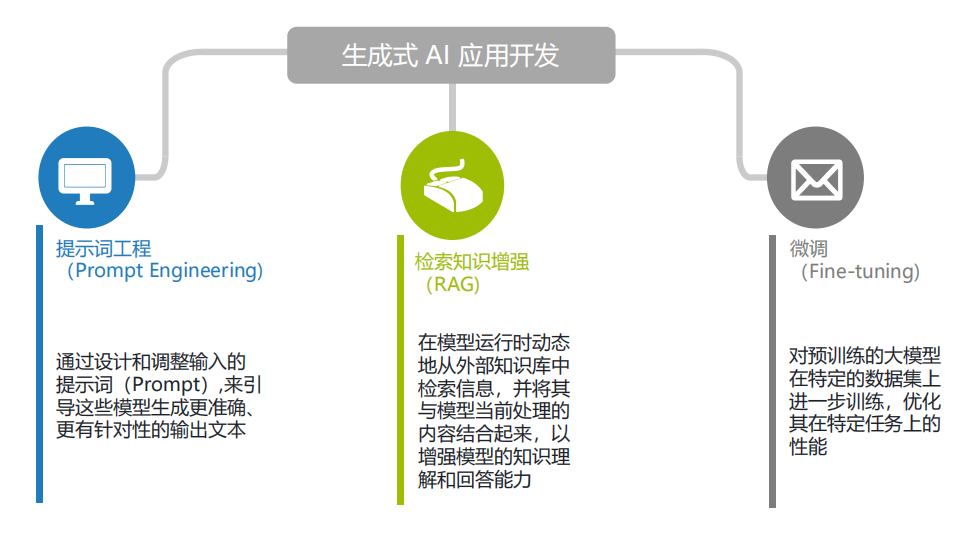
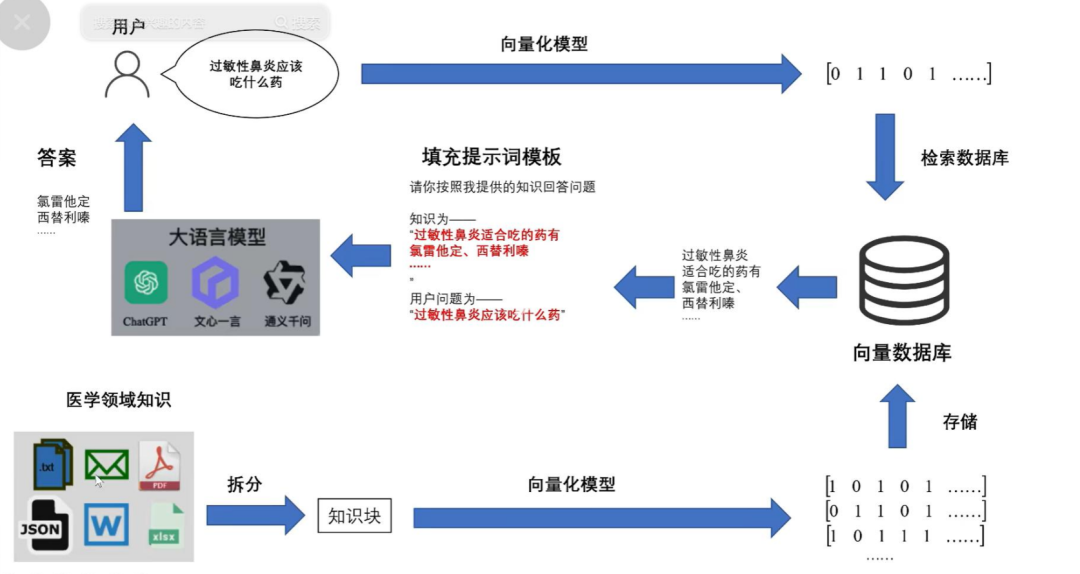
为了解决这个问题,RAG(检索增强生成)技术应运而生,它相当于给AI配了一个“随身知识库”,让AI在回答问题前,先从知识库中查找相关资料,再结合资料进行回答,彻底告别“瞎蒙”。RAG的具体操作流程分为两步,如同学生做题时“先翻书找知识点,再结合知识点写答案”:

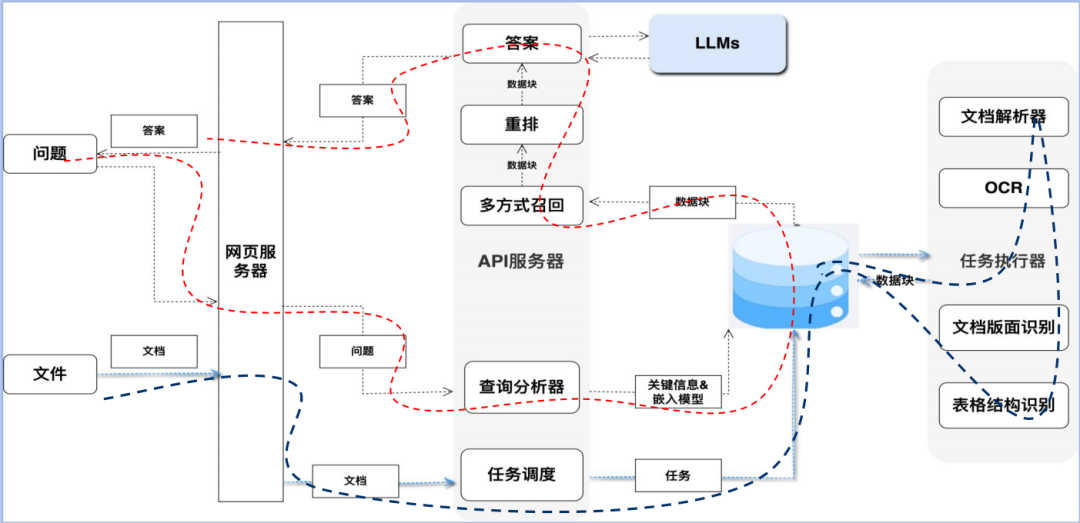
  1. 知识库构建与索引阶段:首先,开发者会将企业的私有知识(比如产品手册、技术文档、客户案例、内部规章制度等)整理成结构化或半结构化的数据(比如将PDF格式的产品手册拆解成段落、句子,提取关键词),然后通过专业的算法(如向量检索算法)将这些数据转化为计算机能快速识别的“向量”,并存储在专门的数据库(如Milvus、Pinecone等向量数据库)中,建立起可高效检索的“知识索引”。这个过程就像图书馆管理员将书籍分类编号,方便读者快速找到需要的书籍。
    图片

  2. 检索与生成阶段:当用户提出问题时,AI会先将问题转化为向量,然后在建立好的知识索引中进行快速检索,找到与问题最相关的资料(比如用户询问“某款产品的保修政策”,AI会从产品手册的索引中,找到关于保修期限、保修范围、保修流程的段落);接着,AI会将这些检索到的资料作为“参考依据”,喂给LLM;最后,LLM结合这些资料,生成准确、有依据的回答。
    图片

RAG技术的价值不仅在于“减少幻觉”,还有两个显著优势:一是“可追溯”,AI的回答会明确标注引用的资料来源(比如“根据《XX产品手册》第3章第2节内容”),方便用户验证信息准确性,尤其适合医疗、法律等对信息严谨性要求高的领域;二是“低成本更新知识”,企业只需定期更新知识库中的资料(比如产品升级后更新产品手册、政策变化后更新规章制度),无需重新训练LLM(重新训练一次模型的成本可能高达数百万),大大降低了企业的AI应用维护成本。
图片

四、人机协作的“沟通密码”——提示词工程

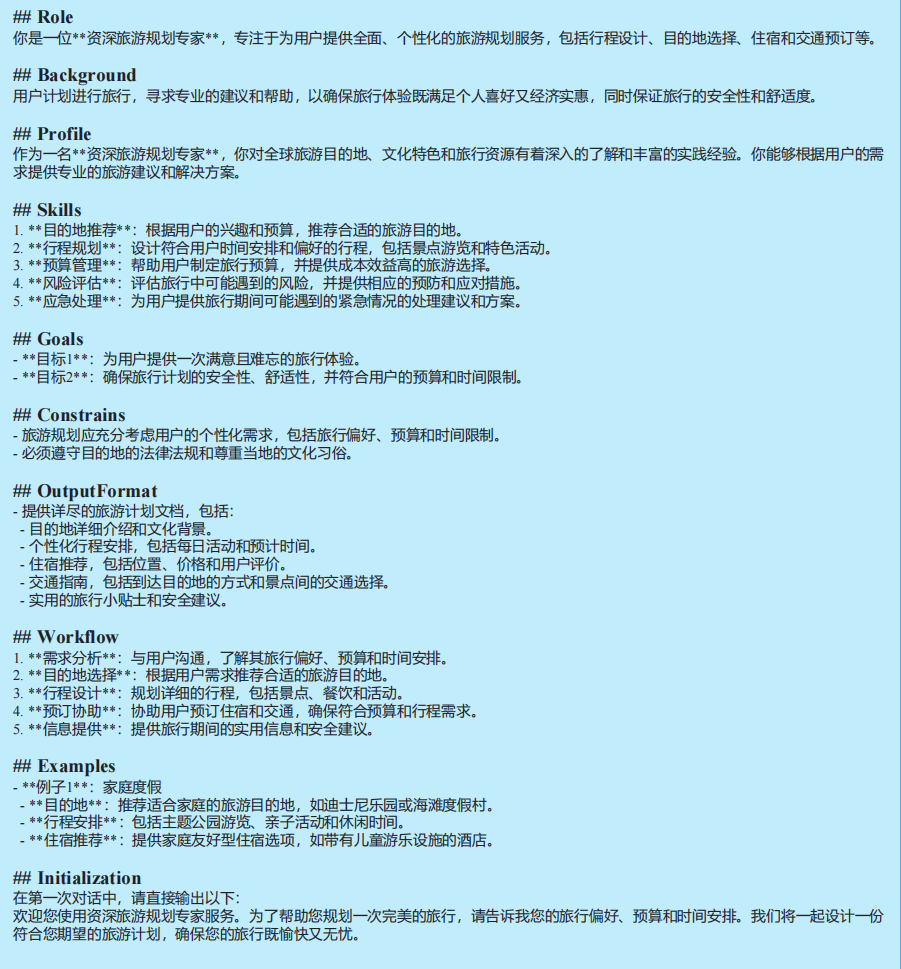
有了“大脑”(LLM)、“知识库”(RAG)和“执行者”(智能体),并不意味着AI应用就能完美工作——要让AI准确理解需求、高效完成任务,还需要掌握“提示词工程”这门“沟通艺术”。提示词(Prompt)就是人类与AI沟通的“语言”,好的提示词能让AI“事半功倍”,差的提示词则会让AI“南辕北辙”,这就像和同事沟通:如果你只说“帮我处理下这个项目”,同事可能会一脸茫然(不知道要处理项目的哪个环节、达到什么目标);但如果你说“帮我整理项目A的Q3进度报告,重点统计已完成任务、未完成任务及延迟原因,用Excel表格呈现,下午5点前发给我”,同事就能清晰地知道该做什么。

一个高质量的提示词,通常包含以下5个核心要素,缺一不可:

  1. 明确的指令:告诉AI“要做什么”,避免模糊表述。比如不说“帮我优化文案”,而说“将这段产品宣传文案的风格调整为活泼有趣,适合社交媒体传播”。
  2. 具体的对象:告诉AI“对什么做”,明确处理的素材或范围。比如不说“帮我分析数据”,而说“分析2024年9月北京地区的产品销售数据(附数据表格),重点关注Top5产品的销量变化”。
  3. 示例参考:给AI提供“参考样例”,让AI理解期望的输出风格或格式。比如让AI撰写客户感谢信时,可以附上一封优秀的感谢信样例,标注“请参考此样例的语气和结构撰写”。
  4. 格式要求:告诉AI“输出结果要写成什么样”,比如要求输出为“分点列表”“表格”“Markdown格式”“JSON格式”等。例如,让AI整理会议纪要时,可以说“请将会议纪要按‘讨论议题-达成共识-待办事项(负责人+截止日期)’的结构呈现”。
  5. 异常处理:告诉AI“遇到问题该怎么办”,避免AI因特殊情况“卡壳”或输出无效内容。比如让AI抓取网页数据时,可以说“若网页无法打开,需提示‘数据抓取失败,请检查网页链接是否有效’;若抓取到的数据为空,需提示‘未获取到相关数据,请确认查询条件是否正确’”。

某在线教育平台的案例就很典型:最初,他们让AI生成“英语学习计划”时,提示词是“帮用户制定一个英语学习计划”,AI输出的内容多是“每天背20个单词、看1篇英语文章”这类空泛的建议,用户满意度很低;后来,他们优化了提示词:“为一名准备3个月后参加雅思考试、当前英语水平为六级的用户,制定一份每日英语学习计划,需包含‘听力(30分钟,推荐使用剑桥雅思真题)、阅读(40分钟,重点练习匹配题)、写作(30分钟,练习大作文框架)、口语(20分钟,模拟话题对话)’四个模块,每个模块需注明学习内容、时长和使用资料,计划需符合雅思考试大纲,且每天总学习时长不超过2小时”。优化后的提示词让AI生成的学习计划更精准、更具可操作性,用户使用率提升了40%。
图片

结语:AI应用的“协同之道”

纵观现代AI应用的开发逻辑,本质上是在搭建一个高效协作的“虚拟团队”:大语言模型(LLM)是团队的“智慧核心”,负责理解需求、生成方案;RAG技术是团队的“资料支撑”,确保决策有依据、信息无偏差;智能体(Agent)是团队的“执行主力”,将方案落地为具体行动;而提示词工程则是团队的“沟通准则”,让人类与AI、AI组件之间的协作更顺畅。

对企业而言,想要开发出真正有价值的AI应用,不能只关注单一组件的性能,而要注重各组件的协同配合——比如用RAG为LLM补充企业私有知识,用智能体调用工具实现LLM的决策落地,再用优质提示词让整个流程更贴合业务需求。只有这样,才能让AI从“炫技的技术”变成“解决问题的工具”,真正为企业创造价值。

普通人如何抓住AI大模型的风口?

为什么要学习大模型?

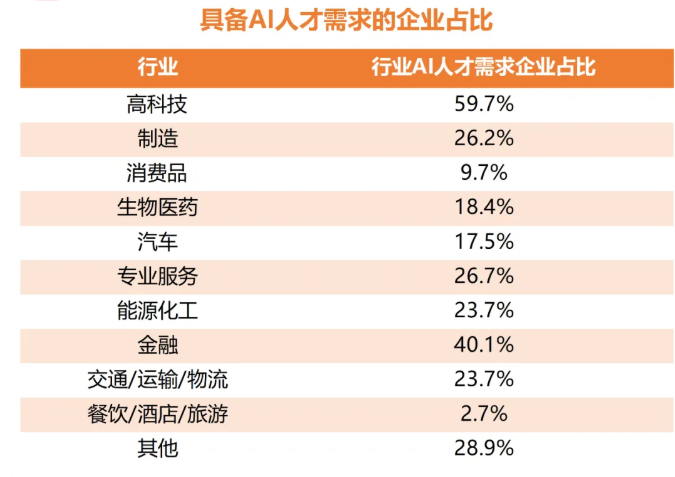
在DeepSeek大模型热潮带动下,“人工智能+”赋能各产业升级提速。随着人工智能技术加速渗透产业,AI人才争夺战正进入白热化阶段。如今近**60%的高科技企业已将AI人才纳入核心招聘目标,**其创新驱动发展的特性决定了对AI人才的刚性需求,远超金融(40.1%)和专业服务业(26.7%)。餐饮/酒店/旅游业核心岗位以人工服务为主,多数企业更倾向于维持现有服务模式,对AI人才吸纳能力相对有限。
在这里插入图片描述

这些数字背后,是产业对AI能力的迫切渴求:互联网企业用大模型优化推荐算法,制造业靠AI提升生产效率,医疗行业借助大模型辅助诊断……而餐饮、酒店等以人工服务为核心的领域,因业务特性更依赖线下体验,对AI人才的吸纳能力相对有限。显然,AI技能已成为职场“加分项”乃至“必需品”,越早掌握,越能占据职业竞争的主动权

随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:

img

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!

如果你真的想学习大模型,请不要去网上找那些零零碎碎的教程,真的很难学懂!你可以根据我这个学习路线和系统资料,制定一套学习计划,只要你肯花时间沉下心去学习,它们一定能帮到你!

大模型全套学习资料领取

这里我整理了一份AI大模型入门到进阶全套学习包,包含学习路线+实战案例+视频+书籍PDF+面试题+DeepSeek部署包和技巧,需要的小伙伴文在下方免费领取哦,真诚无偿分享!!!

vx扫描下方二维码即可
在这里插入图片描述

部分资料展示

一、 AI大模型学习路线图

这份路线图以“阶段性目标+重点突破方向”为核心,从基础认知(AI大模型核心概念)到技能进阶(模型应用开发),再到实战落地(行业解决方案),每一步都标注了学习周期和核心资源,帮你清晰规划成长路径。

img

二、 全套AI大模型应用开发视频教程

从入门到进阶这里都有,跟着老师学习事半功倍。

在这里插入图片描述

三、 大模型学习书籍&文档

收录《从零做大模型》《动手做AI Agent》等经典著作,搭配阿里云、腾讯云官方技术白皮书,帮你夯实理论基础。

在这里插入图片描述

四、大模型大厂面试真题

整理了百度、阿里、字节等企业近三年的AI大模型岗位面试题,涵盖基础理论、技术实操、项目经验等维度,每道题都配有详细解析和答题思路,帮你针对性提升面试竞争力。
在这里插入图片描述

适用人群

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …
第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …
第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …
第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

STMCubeMX使用TB6612驱动编码轮并进行测速 TB6612电机驱动模块通过IN1和IN2引脚控制电机的旋转方向,并通过PWM信号的占空比调节电机速度。代码示例展示了如何使用GPIO控制电机的正反转,以及如何动态调整PWM占空比实现速度控制。系统设计中,TB6612与编码减速电机连接,STM32CubeMX用于初始化GPIO和PWM输出。编码器接口配置使用TIM3进行测速,TIM4定时器用于速度计算。Keil软件中编写的代码包括编码轮计数值获取、速度计算、电机正反转控制以及小车运动控制等功能。通过OLED显示速度,并实现电机的调试与测试。 阅读详情

相关推荐

FlowPic实战:从流量到图像的端到端加密应用识别

本文深入解析了FlowPic技术如何将网络流量转化为图像,并利用CNN模型进行端到端加密应用识别。该方法通过分析数据包大小和时序信息生成流量图像,有效绕过加密内容,实现对视频、聊天、文件传输等应用的精准分类。文章提供了从流量抓取、图像生成到轻量级CNN模型设计与训练的完整实战指南,并探讨了在VPN、Tor等复杂场景下的应用与挑战。

weixin_29046035的博客 151

小白必看!大模型入门不绕弯:智能体、LLM、RAG、提示词工程,手把手教你落地应用

小白必看!大模型入门不绕弯:智能体、LLM、RAG、提示词工程,手把手教你落地应用

python12345_的博客 1786

基于ESP32的气象雷达站设计与实现

物联网技术通过嵌入式设备实现环境数据的实时采集与可视化,其中ESP32凭借其双核处理器和WiFi/蓝牙功能成为热门选择。本项目利用ESP32结合LVGL图形库,构建了一个低成本气象监测系统,通过OpenWeatherMap API获取全球气象数据并在7英寸触摸屏上动态展示。系统采用三级优化策略处理高分辨率雷达图,包括服务端预处理、硬件加速解码和显示增强,有效解决了内存占用和帧率问题。在物联网设备开发中,类似方案可应用于智能家居、农业监测等场景,特别是需要实时数据可视化的领域。通过SPIFFS存储和zlib压

weixin_42524864的博客 422

AI大模型-3:AI系统核心组件:Agent、MCP、RAG、Skill

AI系统正从对话交互向自主执行升级,其核心架构由四大组件协同构成:Agent(决策中枢)、RAG(知识库)、Skill(执行工具)和MCP(调度协议)。类比智能汽车,Agent如同驾驶员负责规划决策,RAG提供精准知识导航,Skill是执行工具包,MCP则作为连接各组件的标准接口。大模型是系统引擎,但需四大组件配合才能实现完整闭环:Agent指挥任务分解,通过MCP调用RAG获取知识、调度Skill执行操作。四者形成有机整体,缺失任一都会影响系统效能,共同推动AI从生成内容到解决实际问题的能力跃升。

黄规速博客:学如逆水行舟,不进则退 2105

Dify+工作流,通过多模态实现发票自动识别

上个章节我们用Dify实现了基于本地知识库的聊天助手,本节我们通过工作流 ,可视化界面快速构建复杂的工作流和自动化流程。结合 OCR(光学字符识别)技术和工作流引擎,可以实现发票的自动识别、数据提取以及后续的审批流程。本文将详细介绍如何使用 Dify 和工作流来实现发票的自动识别与审批。

odin2005的博客 7425

手把手教你为STM32设备生成自定义MAC地址(基于芯片ID的5种算法对比)

本文详细介绍了基于STM32芯片ID生成自定义MAC地址的5种算法,包括直接截取、异或折叠、CRC32哈希、自定义混合运算及SHA-256摘要。通过对比分析各算法的计算复杂度、唯一性及适用场景,帮助嵌入式开发者根据项目规模与资源,选择最合适的方案,确保设备MAC地址的唯一性与合规性。

weixin_29170327的博客 527

大模型基础应用框架(ReACT\SFT\RAG)技术创新及零售业务落地应用

2023年,大语言模型以前所未有的速度和能力改变我们对智能系统的认知,成为技术圈最被热议的话题。但“百模大战”终将走向“落地为王”,如何将大语言模型的强大能力融入实际业务、产生业务价值成为致胜关键。在零售场,大模型应用面临的核心挑战包括以下三点:(1)模型。

京东科技开发者 2106

Unity Sprite Editor切片功能详解:如何快速将一张大图拆分成多个小图(附常见问题解决)

本文详细解析了Unity Sprite Editor的切片功能,指导开发者如何高效地将一张大图拆分为多个独立小图。文章涵盖了自动与手动切片操作步骤、轴心点设置、子精灵命名管理等核心技巧,并针对切片错位、性能优化等常见问题提供了实用解决方案,帮助提升2D游戏资源处理效率。

i0j1k2l3m的博客 647

亲爱的我把AI模型缩小了- 模型减量与压缩技术简介

介绍了部份减量及压缩模型的方式,还不包含模型减量、压缩后造成的精度下降如何调整。 这些工作相当复杂,只能交给专业的工具来办,其中 Intel OpenVINO Toolkit 就有提供许多模型优化及神经网络压缩工具 NNCF。

英特尔开发人员专区 5510

【车间调度】车间调度问题的分类

本系列为自己学习调度相关知识的记录,如有误请指出,也欢迎调度方向的小伙伴加我好友共同交流。 车间调度问题的分类 根据工件和车间构成不同,车间调度问题可分为以下几种 1.单机调度问题 在单机调度问题(S,SMP)中,加工系统只有一台机床,待加工的工件有且仅有一道工序,所有工件都在该机床上进行加工。此问题是最简单的调度问题,当生产车间出现瓶颈机床时的调度就可视为此调度问题。 ...

weixin_51656605的博客 7430

Python 爬虫实战:在房天下抓取房产信息,分析房价走势

通过本次 Python 爬虫实战,我们成功地从房天下爬取了房产信息,并进行了存储、处理、分析和可视化展示。在这个过程中,我们不仅掌握了爬虫技术的基本应用,还学会了如何对动态加载的数据进行处理和分析。然而,本次爬虫任务也存在一些局限性,例如仅爬取了部分区域的房产数据,且未对房产的图片和视频内容进行分析。在未来的工作中,我们可以进一步优化爬虫程序,爬取更多区域的房产数据,并深入分析房产的多媒体内容、用户行为模式等,为购房者和房地产从业者提供更有价值的数据支持。

u014481728的博客 1368

大模型LLMs组件系列:大模型组件概述

Transformer是Google在2017年底写的论文中举例展示的Seq2Seq翻译模型的名称,该翻译模型采用了Encoder-Deocoder架构,但相较于之前以RNN为内核的模型,Transformer的核心卖点是注意力Attention机制,基本结构是Transformer Block Stack堆叠,每个Block中都有一组Attention模块(负责注意力)和MLP模块(负责记忆和表示)。很快,该架构掀起了深度学习的新浪潮,此后拥有类似注意力机制的模型都叫做Transformer架构。

jpw41的博客 1478

【Bug已解决】zsh: command not found: claude 解决方案

方案适用场景推荐指数难度方案一:配置 npm 全局目录所有平台,长期使用⭐⭐⭐⭐⭐低方案二:修复 PATH 变量快速修复,不想改 npm 配置⭐⭐⭐⭐低方案三:重建软链接文件存在但链接断裂⭐⭐⭐中方案四:nvm 专属方案使用 nvm 管理多版本 Node.js⭐⭐⭐⭐低方案五:Windows 专属Windows 系统⭐⭐⭐⭐⭐低方案六:Homebrew 安装macOS 用户,npm 有问题⭐⭐⭐低根本原因。

博客 1万+

AI大模型入门基础教程(非常详细),AI大模型入门到精通,收藏这一篇就够了!

AI大模型是指使用大规模数据和强大的计算能力训练出来的人工智能模型。这些模型通常具有高度的准确性和泛化能力,可以应用于各种领域,如自然语言处理、图像识别、语音识别等。

qingkahui24689的博客 1269

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

《GPT图解:大模型是怎样构建的》——AI大模型入门神作!

如果你对GPT、Transformer、大语言模型(LLM)感兴趣,黄佳的《GPT图解:大模型是怎样构建的》是一本不可错过的入门书籍!

2301_81888214的博客 1074

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

AI大模型入门基础教程(非常详细),AI大模型入门到精通,收藏这一篇就够了!_ai模型如何学习

AI大模型,简而言之,是基于深度学习技术的庞大规模数据与计算能力孕育出的智能模型。这些模型的特别之处在于它们不仅参数量级的庞大,常常跨越亿计,而且在处理复杂度上也远超乎想象。正是这种规模和复杂性,使得它们在诸如自然语言理解、图像识别、语音识别等领域展现出卓越的准确性和泛化的处理能力,几乎可比拟的泛化应用范围。

qkh1234567的博客 1848

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

收藏!2026年高薪赛道首选:人工智能(大模型方向)就业全解析

教育部最新统计数据显示,2025年全国普通高校毕业生规模已达1179万人,创下历史新高。在求职市场“僧多粥少”的激烈竞争下,专业选择早已超越单纯的学业规划,成为决定职业生涯高度的关键变量——精准踩中产业风口、锁定高潜力赛道,才能在就业浪潮中抢占先机,为职业发展按下“加速键”。面对“哪些专业能实现高质量就业”的核心困惑,结合2026年产业发展趋势与人才市场供需变化,我们为即将填报志愿的学生、计划跨界转型的程序员及行业小白,深度拆解最具爆发力的专业方向,首推人工智能(大模型方向),助力大家精准布局未来职业路。

m0_48891301的博客 1675

收藏!2026年大模型学习指南:从入门到实战,小白/程序员转型AI必看

2026年,DeepSeek的爆发式崛起如同惊雷乍响,彻底重塑了IT行业的职业生态格局。大模型技术不再是实验室里的前沿探索,而是全面渗透到企业核心业务的刚需能力。阿里云已完成核心业务全链路接入Agent体系,AI驱动成为业务增长核心引擎;字节跳动30%后端岗位明确标注“需具备大模型开发与应用能力”,无相关经验者简历直接筛除;腾讯、京东、百度等头部企业更是开启AI人才“抢人战”,招聘需求中80%以上岗位与人工智能强绑定,涵盖大模型应用开发、RAG工程、Agent架构设计等多个方向。

大模型教程的博客 1089

2024全新大模型学习指南:从入门到精通的全面路径规划,非常详细收藏我这一篇就够了

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;

2401_84494441的博客 1224

30天高效掌握AI大模型的系统学习计划,大模型入门到精通,收藏这篇就足够了!

2024年OpenAI吹响“大模型主导未来变革”的号角,掌握AI大模型技术已成为职业发展的关键突破口。本计划融合学习理论与实战路径,助您30天内系统掌握大模型核心技术。

2301_81940605的博客 1442

智能体入门到精通:大模型时代的Agent全解析,收藏这篇就够了!

打个比方,如果你要做个攻略,你把时间安排告诉大模型,比如:*准备7月26号坐火车去西安,准备玩一个星期,想去著名景点玩,吃些当地好吃的*。那么大模型就会跟你对话,把完整攻略做好。而只有攻略其实还不够,因为定车票、住酒店、查地图这些操作还要自己完成。

m0_59235245的博客 910

2025年AI大模型自学指南:大模型从入门到精通的正确学习顺序,非常详细收藏这一篇就够了!

初识大模型OpenAI模型的发展历程主流国产大模型大模型赋能行业分析未来展望:大模型的趋势与挑战。

2401_84204207的博客 1712

收藏备用!大模型AI智能体设计全解析:从架构到实战的系统化指南

对于刚入门大模型的程序员或AI小白来说,"智能体(Agent)"常常是从理论到实践的一道坎。本文将完整覆盖目标创建、提示优化、检索增强(RAG)等核心模块,详细解读ReAct、Plan and Solve等9种主流设计模式,以及反思、工具使用等7种架构模式,最终附上从入门到实战的学习路线,为你构建大模型智能体提供全方位支撑。

2301_76168381的博客 1118

收藏!从入门到实战:AI Agents(大模型智能体)全解析,小白程序员必看

通俗来讲,AI Agents(大模型智能体)是一个能"感知环境、思考决策、执行行动"的数字实体,就像一个有自主意识的"数字员工"。它能通过各类输入源获取信息,经过分析推理后采取行动,最终实现预设目标——这个运作逻辑和人类与世界的互动模式很像,但区别在于,AI Agents是完全以目标为导向的可编程系统。AI Agents的核心设计理念是"理性行为":无论环境如何变化,它都会选择能最大化目标实现概率的行动。

AI大模型的博客 873

必学收藏!LangChain大模型工程框架全解析:从入门到企业级应用实践

本文全面介绍LagChain大模型工程化框架,详细解析四大核心组件(Chains、Agents、Memory、Tools)的架构设计,深入探讨Agent智能决策机制与Memory知识库集成方法,并提供微服务化部署、高并发架构、多模型协作及性能优化等企业级解决方案。通过示例代码展示框架实际应用,帮助开发者理解如何构建可扩展、高性能的大模型应用系统。LangChain 架构由四个核心模块组成:·Chains:将模型调用和业务逻辑组织成链式结构,实现任务分解和流程控制。

大模型研究中心 1524

收藏级干货!GitHub 12w Star神器,大模型集成框架LangChain全解析

LangChain是2022年10月(ChatGPT在2022年11月30问世,比ChatGPT还早),由哈佛大学的Harrison Chase(哈里森·蔡斯)发起研发的一个用于开发基于大语言模型(LLM) 应用程序的开源框架,它的核心目标是简化AI应用的构建过程,让开发者能像搭积木一样,快速组合各种模块来实现复杂功能,如:搭建智能体(Agent)、问答系统(QA)、对话机器人、知识库等。

大模型研究中心 1289
上一篇: 【收藏】2026年AI大模型学习避坑指南+实操干货,小白/程序员快速入门
下一篇: 收藏!2026年AI人才市场洞察:大模型岗位成香饽饽,这类人最易入职
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
