小白也能学会的大模型开发指南:核心技术栈+实战案例+最佳实践(强烈推荐收藏)

什么是大模型? 大模型是指具有数千万甚至数亿参数的深度学习模型。近年来,随着计算机技术和大数据的快速发展,深度学习在各个领域取得了显著的成果,如自然语言处理,图片生成,工业数字化等。为了提高模型的性能,研究者们不断尝试增加模型的参数数量,从而诞生了大模型这一概念。大模型通常由深度神经网络构建而成,拥有数十亿甚至数千亿个参数。大模型的设计目的是为了提高模型的表达能力和预测性能,能够处理更加复杂的任务和数据。大模型采用预训练+微调的训练模式,在大规模数据上进行训练后,能快速适应一系列下游任务的模型。 阅读详情

大模型是参数规模巨大的深度神经网络,具备涌现能力和多任务学习能力。开发依赖Transformer架构、预训练+微调等技术,需结合Prompt工程和向量数据库。在金融、医疗、教育、电商等领域已展现显著价值,如智能客服、临床决策支持等。开发需遵循科学流程,注重安全伦理,开源工具可降低门槛。


1、 大模型是什么?

1.1 大模型的定义与核心特征

定义:大模型(Large Model)通常指参数规模巨大(数十亿至数千亿参数)、结构复杂的深度神经网络模型,具备强大的表达能力和泛化能力,能够处理复杂任务和海量数据。
核心特征 :

  • 巨量参数:参数规模从数十亿到万亿级别,模型体积可达数百GB甚至更大。
  • 涌现能力(Emergence):当模型规模达到一定阈值后,表现出小模型无法预见的复杂能力,如多步推理、复杂语言理解等。
  • 多任务学习:支持同时处理多种任务,如文本生成、翻译、摘要、问答等。
  • 大数据训练:依赖TB级甚至PB级海量数据进行预训练。
  • 强计算资源需求:训练和推理通常需要数百至上千GPU集群支持。

1.2 发展历程概述

阶段时间范围代表技术与事件说明
萌芽期1950-20051950年图灵测试、1980年CNN雏形、1998年LeNet-5AI从规则专家系统向机器学习转变,深度学习基础奠定。
探索沉淀期2006-20192013年Word2Vec,2014年GAN,2017年TransformerTransformer架构提出,预训练大模型兴起,NLP进入新阶段。
迅猛发展期2020至今GPT-3(1750亿参数)、ChatGPT、GPT-4、多模态模型预训练+微调范式成熟,涌现能力显著,多模态融合成为趋势。

1.3 核心技术突破

  • Transformer架构:基于自注意力机制,能够高效捕捉长距离依赖,成为大模型的基础架构。
  • 预训练+微调范式:先在大规模无标注数据上预训练,再针对具体任务微调,极大提升模型泛化能力。
  • 强化学习与人类反馈(RLHF):通过人类反馈优化模型输出质量,提升对话和生成的自然度与准确性。
  • 多模态融合:结合文本、图像、语音等多种数据类型,扩展模型应用边界。
  • 蒸馏与模型压缩:提升推理效率,降低部署成本。

2、大模型应用开发关键技术栈、开发流程与最佳实践

2.1 关键技术栈

技术层级主要技术与工具说明
模型架构Transformer、GPT、BERT、T5、PaLM大模型的核心架构,支持多任务和多模态。
训练优化分布式训练(Horovod、DeepSpeed)、混合精度训练支撑大规模模型训练的高效计算。
推理部署ONNX Runtime、TensorRT、FasterTransformer提升推理速度,支持在线服务。
向量数据库Chroma、Pinecone、FAISS支持语义检索和知识库构建。
应用框架LangChain、Dify、DeepSeek SDK简化大模型应用开发,支持Prompt工程、链式调用、插件扩展。
前后端开发Gradio、Streamlit、FastAPI快速搭建交互界面和API服务。
监控与运维Prometheus、Grafana、LLMOps保障模型服务稳定性和性能。

2.2 大模型应用开发流程

  1. 需求分析与目标确定明确应用场景、目标用户、核心功能和价值。
  2. 功能设计与架构搭建设计业务流程,搭建整体架构,通常采用“数据库+Prompt+大模型”模式。
  3. 数据准备与知识库构建收集业务相关数据,进行预处理、文本切分、向量化,存入向量数据库。
  4. Prompt工程设计设计和迭代Prompt,提升模型回答的准确性和业务适配度。
  5. 模型调用与集成通过API或SDK调用大模型,结合业务逻辑实现核心功能。
  6. 前后端开发与部署搭建用户交互界面和后台服务,完成系统上线。
  7. 验证与迭代优化收集Bad Case,持续优化Prompt和系统性能。
  8. 监控与维护实时监控系统运行状态,保障服务稳定。

2.3 开发最佳实践

  • 充分利用Prompt工程,减少对模型内部的改动,快速适配业务需求。
  • 构建小批量验证集,针对业务场景设计测试用例,持续迭代优化。
  • 结合向量检索技术,实现知识增强,提升回答的准确性和专业性。
  • 采用多模型融合策略,根据任务需求灵活切换或组合不同模型。
  • 注重数据安全与隐私保护,避免敏感信息泄露。
  • 遵循行业安全规范和伦理原则,防范模型滥用和偏见。
  • 利用开源工具和框架,降低开发门槛和成本。

3、大模型在各行业的典型应用案例与实施效果分析

3.1 金融行业

应用场景典型案例与效果说明
智能客服蚂蚁集团“支小宝2.0”智能金融助理,提升客户交易频率60%7×24小时在线客服,提供金融资讯、业务办理等基础服务。
投顾辅助摩根士丹利与OpenAI合作,提升财富管理服务效率和质量实时调用专业知识库,辅助投资顾问进行个性化推荐。
风险管理大模型辅助数据归纳和分析,提升风控效率结合传统AI模型,优化信贷审批、理赔定价等环节。
营销运营智能营销话术生成,客户需求洞察提升客户转化率和营销效率。

3.2 医疗健康

应用场景典型案例与效果说明
临床决策支持百度灵医大模型,提升诊断准确率和效率结合临床数据和知识库,辅助医生诊断和治疗方案制定。
个性化治疗圆心科技源泉大模型,实现精准患者画像和管理支持千人千面治疗方案,提高患者依从性和康复效果。
药物研发晶泰科技XpeedPlay平台,加速抗体筛选利用大模型预测分子结构,缩短研发周期。
医学影像分析北京天坛医院“龙影”大模型,实现快速病变识别自动分析MRI等影像,辅助放射科医生诊断。
患者服务百度文心与灵医联合AI药品说明书,提升患者体验支持语音和文本交互,提供用药指导和健康咨询。

3.3 教育领域

应用场景典型案例与效果说明
语言学习科大讯飞“星火语伴”APP,支持多语种口语练习实时语音纠错、口语陪练,提升学习者口语流利度和准确性。
数学辅导MathGPT,覆盖小学至高中数学,解题准确率领先支持多模态输入,提供详细解题步骤和讲解。
个性化学习Khanmigo,提供个性化学习方案和生涯规划结合Khan Academy资源,促进自主学习和批判性思维培养。
心理健康EmoGPT,基于心理学知识,提供情感支持和危机识别结合多模态数据,精准识别用户情绪,提供专业心理辅导。
教学辅助智海-三乐教育大模型,支持智能问答和试题生成基于教材和论文数据,提升教学资源智能化水平。

3.4 电商行业

应用场景典型案例与效果说明
智能客服乐言智能客服机器人,提升响应速度和转化率7×24小时服务,支持多渠道接入,降低客服成本。
营销服务京东言犀大模型,支持数字人直播,成交率提升46%结合用户行为数据,实现精准营销和个性化推荐。
搜索推荐京东电商大模型,提升意图理解和商品匹配准确率采用多阶段预训练和蒸馏技术,提升搜索体验和转化率。
内容生成AI生成营销文案和商品描述,提升内容生产效率降低人工成本,快速响应市场需求。

总结

大模型作为人工智能领域的核心技术,凭借其庞大的参数规模和强大的泛化能力,正在推动各行业的智能化转型。其发展经历了从传统神经网络到Transformer架构的革命,再到预训练+微调范式的成熟,形成了强大的技术基础。大模型应用开发依赖于完善的技术栈和科学的开发流程,强调Prompt工程和知识库的结合,注重安全与伦理。金融、医疗、教育和电商等行业的典型案例充分展示了大模型的广泛应用价值和显著成效,未来随着技术的不断进步和应用的深入,AI大模型将持续释放更大的社会和经济价值。

普通人如何抓住AI大模型的风口?

为什么要学习大模型?

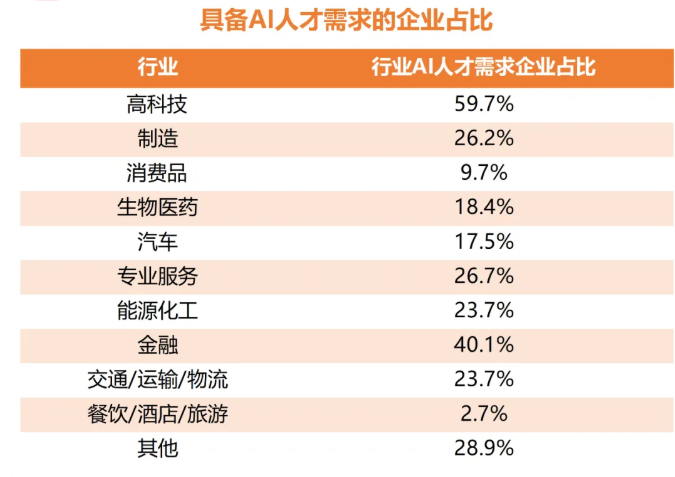
在DeepSeek大模型热潮带动下,“人工智能+”赋能各产业升级提速。随着人工智能技术加速渗透产业,AI人才争夺战正进入白热化阶段。如今近**60%的高科技企业已将AI人才纳入核心招聘目标,**其创新驱动发展的特性决定了对AI人才的刚性需求,远超金融(40.1%)和专业服务业(26.7%)。餐饮/酒店/旅游业核心岗位以人工服务为主,多数企业更倾向于维持现有服务模式,对AI人才吸纳能力相对有限。
在这里插入图片描述

这些数字背后,是产业对AI能力的迫切渴求:互联网企业用大模型优化推荐算法,制造业靠AI提升生产效率,医疗行业借助大模型辅助诊断……而餐饮、酒店等以人工服务为核心的领域,因业务特性更依赖线下体验,对AI人才的吸纳能力相对有限。显然,AI技能已成为职场“加分项”乃至“必需品”,越早掌握,越能占据职业竞争的主动权

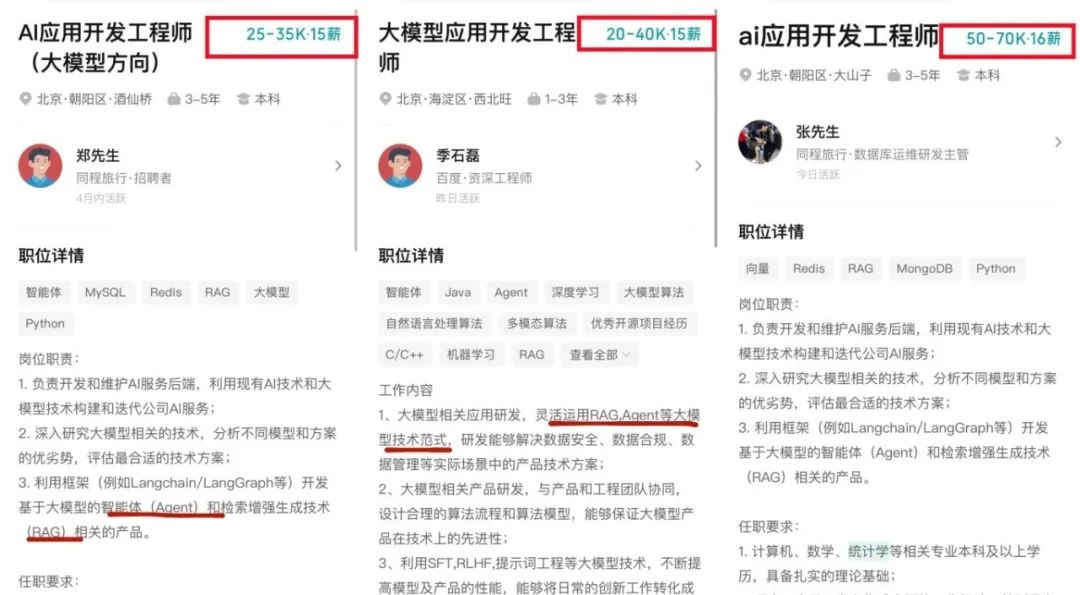
随着AI大模型技术的迅速发展,相关岗位的需求也日益增加。大模型产业链催生了一批高薪新职业:
img

人工智能大潮已来,不加入就可能被淘汰。如果你是技术人,尤其是互联网从业者,现在就开始学习AI大模型技术,真的是给你的人生一个重要建议!

如果你真的想学习大模型,请不要去网上找那些零零碎碎的教程,真的很难学懂!你可以根据我这个学习路线和系统资料,制定一套学习计划,只要你肯花时间沉下心去学习,它们一定能帮到你!

大模型全套学习资料领取

这里我整理了一份AI大模型入门到进阶全套学习包,包含学习路线+实战案例+视频+书籍PDF+面试题+DeepSeek部署包和技巧,需要的小伙伴文在下方免费领取哦,真诚无偿分享!!!

vx扫描下方二维码即可
在这里插入图片描述

部分资料展示

一、 AI大模型学习路线图

这份路线图以“阶段性目标+重点突破方向”为核心,从基础认知(AI大模型核心概念)到技能进阶(模型应用开发),再到实战落地(行业解决方案),每一步都标注了学习周期和核心资源,帮你清晰规划成长路径。

img

二、 全套AI大模型应用开发视频教程

从入门到进阶这里都有,跟着老师学习事半功倍。

在这里插入图片描述

三、 大模型学习书籍&文档

收录《从零做大模型》《动手做AI Agent》等经典著作,搭配阿里云、腾讯云官方技术白皮书,帮你夯实理论基础。

在这里插入图片描述

四、大模型大厂面试真题

整理了百度、阿里、字节等企业近三年的AI大模型岗位面试题,涵盖基础理论、技术实操、项目经验等维度,每道题都配有详细解析和答题思路,帮你针对性提升面试竞争力。
在这里插入图片描述

适用人群

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …
第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …
第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …
第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
在这里插入图片描述

AIGC与大模型学习路径全解析:从工程师到产品经理的实战指南 在人工智能浪潮中,大模型与生成式AI(AIGC)已成为驱动技术创新的核心引擎。其原理基于Transformer架构,通过海量数据预训练获得强大的理解和生成能力,技术价值在于能够处理复杂的自然语言任务,实现人机交互的智能化。在工程实践中,开发者通过API调用、框架应用(如LangChain)以及检索增强生成(RAG)等技术,将大模型能力集成到各类应用场景中,如智能客服、内容创作和数据分析。对于希望系统掌握AIGC技能的工程师和产品经理而言,明确的学习路径至关重要。本文聚焦**AIGC大模型工程师**和**AI 阅读详情

相关推荐

【收藏级】MySQL Binlog 全景解析指南

MySQL Binary Log(简称 Binlog),是一种逻辑日志,记录了所有对数据库执行更改的事件(SQL 或行数据变化),包括 DDL 和 DML。它存在于Server 层,不依赖存储引擎(和 InnoDB 的 Redo Log、Undo Log 区分开)。核心作用:主从复制(Replication)数据恢复(PITR, Point-in-Time Recovery)数据审计(Audit / CDC)一句话总结:没有 Binlog,就没有 MySQL 的主从复制和精准恢复。格式。

一起修行,不孤单。这里有编程语言、开发工具、学习方法论和踩坑笔记。用简单的话说复杂的事,陪你从小白到进阶。周更干货,欢迎一起成长! 643

什么是大模型?一文读懂大模型的基本概念

大模型通过训练海量数据来学习复杂的模式和特征,具有更强大的泛化能力,可以对未见过的数据做出准确的预测。引申到模型层面,涌现能力指的是当模型的训练数据突破一定规模,模型突然涌现出之前小模型所没有的、意料之外的、能够综合分析和解决更深层次问题的复杂能力和特性,展现出类似人类的思维和智能。ChatGPT对大模型的解释更为通俗易懂,也更体现出类似人类的归纳和思考能力:大模型本质上是一个使用海量数据训练而成的深度神经网络模型,其巨大的数据和参数规模,实现了智能的涌现,展现出类似人类的智能。

weixin_46880696的博客 11万+

什么是大模型

大模型(Big Model)是指在机器学习和人工智能领域中处理大规模数据和复杂模型的一种方法或技术。随着数据量的不断增加和模型的复杂度提高,传统的机器学习方法已经无法有效处理,因此大模型成为了解决这一挑战的重要工具之一。本文将介绍大模型的基本概念、应用场景以及一些常见的大模型技术。大模型是指在处理大规模数据和复杂模型时所采用的一种模型和算法。大模型通常需要处理海量的数据,这些数据可能来自于互联网、传感器、日志文件等各种来源。

私聊前往站内信:https://i.youkuaiyun.com/#/msg/chat/weixin_44976692 2万+

一文了解什么是大模型?到底大模型有什么用呢?

引申到模型层面,涌现能力指的是当模型的训练数据突破一定规模,模型突然涌现出之前小模型所没有的、意料之外的、能够综合分析和解决更深层次问题的复杂能力和特性,展现出类似人类的思维和智能。而当模型的训练数据和参数不断扩大,直到达到一定的临界规模后,其表现出了一些未能预测的、更复杂的能力和特性,模型能够从原始训练数据中自动学习并发现新的、更高层次的特征和模式,这种能力被称为“涌现能力”。在探索期,以Transformer为代表的全新神经网络架构,奠定了大模型的算法架构基础,使大模型技术的性能得到了显著提升。

2301_76168381的博客 4657

【大模型应用开发-大模型知识】(二)大模型分类和常见大模型

目前包含 Claude 和 Claude-Instant 两种模型可供选择,其中 Claude Instant 的延迟更低,性能略差,价格比完全体的 Claude-v1 要便宜,两个模型的上下文窗口都是 9000 个token(约 5000 个单词,或 15 页)它的目标是“更安全”、“危害更小”的人工智能。Google 还开发了多种 PaLM 的改进版本。更强大的基础模型: ChatGLM3-6B 的基础模型 ChatGLM3-6B-Base 采用了更多样的训练数据、更充分的训练步数和更合理的训练策略。

1万+

Spring Boot集成Jasypt踩坑实录:自定义SM4加密器Bean加载失败的终极解决方案

本文深入剖析了Spring Boot集成Jasypt时自定义SM4加密器Bean加载失败的根源,即Spring Boot启动流程中Bean加载顺序与Jasypt自动配置的时序冲突。文章提供了三种从源码层面解决问题的有效方案,包括使用ApplicationContextInitializer提前注册、调整Bean依赖顺序以及自定义PropertySource处理机制,并给出了完整的国密SM4加密器实现与测试示例。

weixin_29294975的博客 200

【强烈推荐】Agent Zero:新一代有机AI Agent架构与实战指南 - 值得收藏的AI Agent革命

Agent Zero是一款突破传统"工具箱"模式的革命性AI Agent框架,实现了有机生长的"有机体"架构。其核心技术包括动态工具生成、三层记忆系统、多智能体协作和可扩展插件架构。通过"计算机作为工具"的范式,Agent Zero能自主编写代码完成任务,并具备从经验中学习的能力。该框架在软件开发、数据分析、系统管理等领域表现出色,为AI Agent的发展开辟了新方向,是开发者深入了解AI Agent技术的必学项目。

嘴巴吃糖了 1597

MATLAB闪退别慌!5分钟搞定Windows系统预设文件修复(附详细截图)

本文针对MATLAB在Windows系统下频繁闪退的问题,提供了快速有效的解决方案。核心在于修复或重置损坏的MATLAB预设文件,通过图文并茂的五步法,指导用户定位AppData目录、重命名预设文件夹,从而让MATLAB自动生成全新配置以解决闪退。文章还涵盖了问题诊断、设置备份及进阶排查方法,帮助用户彻底根除启动故障。

weixin_29234423的博客 925

【强烈推荐】收藏这10个GitHub项目,从小白到专家系统学习AI智能体与大语言模型

Edward Donner开发的8周LLM工程师训练营,面向工程实践的大语言模型开发指南。涵盖从开发环境配置到部署的完整工程化流程,注重实战技能培养和最佳实践传授。这十个GitHub仓库构成了AI智能体技术栈的完整生态系统,从理论基础到工程实践,从开发工具到部署运维,为不同背景的开发者提供了系统性的学习路径。

python12345_的博客 2138

Oracle数据库的内存管理优化技巧

Oracle数据库作为企业级数据库管理系统,广泛应用于各种业务场景。内存管理是Oracle数据库性能优化的关键环节,合理的内存管理可以显著提高数据库的响应速度和吞吐量。本文的目的是深入探讨Oracle数据库内存管理的优化技巧,涵盖了系统全局区(SGA)和程序全局区(PGA)的管理、内存分配算法、内存参数调整等方面。通过详细的讲解和实际案例分析,帮助读者掌握优化Oracle数据库内存使用的方法,提高数据库的性能和稳定性。

2502_91592937的博客 996

T型三电平关管顺序要求

摘要: T型三电平拓扑中,IGBT关断必须遵循“外管先关、内管后关”的时序,否则易导致器件损坏。正常导通时,外管与内管共同分担电压;正确关断时,外管先关使电流经内管续流至中点,避免电压过冲;若内管先关,电流路径被强制切断,杂散电感引发高压尖峰击穿器件。这一时序本质是为电流提供低应力续流路径,需通过硬件或软件严格保障。

yun0804的博客 2379

【建议收藏】强烈推荐这些宝藏级Java书籍!

Java书籍有很多,下面我给你推荐一些比较经典的,这应该是全网整理得最全面的了,请收藏学习! 废话不多说,下边直接给你分享: 第一部分:Java语言篇 1.《Java编程规范》 适合对象:初级、中级 介绍:这本书的作者是被誉为Java之父的James Gosling,入门者推荐阅读,对基础的讲解很不错。 2.《Java编程思想》 适合对象:初级、中级 介绍:豆瓣给出了9.1的评分,全球程序员广泛赞誉。有人说这本书不适合初学者,不过小编认为作者并没有对读者已有的知识经验有过多要求,只是..

deqing271的博客 877

快速上手CH340N电路设计(CH340N USB转串口模块 USB Type-C接口 CH340系列芯片讲解)

一、上模块 二、功能分析 l 芯片:CH340N l 输入接口:USB、TYPE-C l 输出接口:TTL(5V\3.3V\GND\TX\RX) l 指示灯:电源、TX、RX 三、CH340x芯片 l CH340 是一个 USB 总线的转接芯片,实现 USB 转串口 l 全速 USB 设备接口,兼容 USB V2.0 l 硬件全双工串口,内置收发缓冲区,支持通讯波特率 50bps~2Mbps l 支持常用的 MODEM 联络信号 RTS、DTR、DCD、RI、DS...

东小东博客 5万+

进入过“阿里“的大佬强烈推荐的几本前端开发技术(HTML、CSS 和 JavaScript 等)的书籍!值得一看

第一本,入门 《Head first HTML&CSS》 最好的入门书。看两遍就对HTML & CSS 有个大概印象了。 此时把w3cschool作为备查手册收藏起来 第二本《CSS权威指南(第三版)》 最权威的CSS书籍,除了阅读W3C的文档外的不二选择(就是翻译有点操蛋,遇到感到难理解的地方可能还是要求助于网络资源)。有时间(无论是现在还是将来)可以反复看,并当做字典随时查。 第三本《精通CSS》 广受前辈推荐的一本书。上一本书是字典的话,这本书相当于《中学生作文大全》,汇集了一些CS.

软件测试小dao 988

ICC2如何写出floorplan信息

不用-exclude 的话rows_tracks / vias /blockages / routing_rules信息都会写出去,即便用了-include {macro ports}也不行,所以不介意这些东西的话可以用以下两种种def方式去写floorplan。write_floorplan用法和write_def一样,因为写出来的文件夹里就包含def,用write_floorplan的好处和innovus saveFPlan一样,都能写出voltage area和bound信息。

m0_61544122的博客 1071

华为OD机试真题2025双机位B卷 Java&Go 实现【朋友圈个数】

给定一组朋友关系,统计一下该朋友关系网中的朋友圈个数。 朋友圈的定义:一个朋友圈至少由3个朋友组成,且要求同一个朋友圈中的任意两个人都具有直接的朋友关系。 输入描述 输入一个朋友关系列表,如 Fiends =A.B],[A.C],IB,DI,其中的每一个元素 Friendsi表示 Friends[i][0)和 Friends [i][1] 是朋友关系 先输入一个数字 N 代表关系的总数,后面每条关系一行,两个成员以逗号分隔

MISAYAONE的博客 518

大模型微调实战:LoRA、SFT与DPO技术解析与Llama-Factory应用指南

大语言模型微调是提升模型在特定领域表现的关键技术。其核心原理是通过在预训练模型的基础上,利用特定数据调整模型参数,使其输出更符合特定任务或人类偏好。这项技术的核心价值在于,能以相对较低的成本,让通用大模型快速适应专业场景,如企业知识问答、客服对话风格定制等。在工程实践中,参数高效微调方法(PEFT)如LoRA,通过冻结原模型参数、仅训练低秩适配矩阵,大幅降低了计算和存储开销。而监督微调(SFT)和直接偏好优化(DPO)则代表了两种核心训练范式:SFT侧重于通过指令-输出配对数据教会模型新知识或技能;DPO则

weixin_30471561的博客 361

DCNv4+YOLOv8:2024最新可变形卷积赋能目标检测,从原理到实战的科研级优化指南

从理解DCNv4“自适应变形卷积核”的核心思想,到亲手将其嵌入YOLOv8并验证在复杂场景的检测效果,再到基于此探索属于自己的科研与工程方向——这个过程能让你深刻理解目标检测中“特征自适应提取”的核心价值。现在就开始行动,相信你会在目标检测的“自适应特征提取”之路上,走出一条属于自己的技术路径。实验通常会证明:嵌入DCNv4后,YOLOv8在复杂场景下的检测精度提升3-5个百分点,尤其是小目标和遮挡目标的AP提升更为明显,而推理速度仅下降5%-10%(可通过模型量化进一步优化)。2024年最新推出的。

m0_64661770的博客 268

NVIDIA Nemotron-4 万亿参数大模型部署与实战指南

大语言模型(LLM)作为人工智能领域的核心技术,通过海量参数模拟人类语言理解与生成能力,其核心原理基于Transformer架构的注意力机制,实现了对上下文信息的并行处理与长期依赖建模。这类模型的技术价值在于能够执行复杂的逻辑推理、代码生成和创造性内容创作,极大地推动了智能对话、自动化编程和知识密集型任务的发展。在实际应用中,企业级私有化部署、复杂任务求解以及作为基座模型进行领域微调是典型场景。本文聚焦于NVIDIA最新开源的万亿参数级模型Nemotron-4,深入探讨其基于TensorRT-LLM的推理优

weixin_30613727的博客 348

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

SpringBoot3+Vue3全栈项目实战:超市管理系统从环境搭建到二次开发

在软件开发领域,前后端分离架构已成为构建现代Web应用的主流范式。其核心原理在于将用户界面(前端)与业务逻辑和数据(后端)解耦,通过RESTful API进行通信,从而提升开发效率和系统可维护性。这种架构模式的技术价值在于支持团队并行开发、技术栈灵活选型以及更好的可扩展性,广泛应用于各类管理后台、电商平台和企业级应用。对于初学者而言,掌握一个完整的前后端分离项目是打通全栈开发技能的关键。本文聚焦于一个典型的实战案例——超市管理系统,它基于当前主流的技术栈组合:SpringBoot3后端框架与Vue3前端框架

weixin_34174422的博客 446

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

大模型进化新路径:模型融合与进化策略实战解析

如果你最近关注大模型领域,可能会注意到一个现象:当主流厂商还在卷参数、拼算力、优化Transformer架构时,一家名为Sakana AI的公司却拿出了一套截然不同的解题思路。他们推出的Fugu系列模型,没有追求千亿、万亿的参数量,而是将重点放在了“模型融合”与“进化策略”上,试图用更聪明、更“生物启发”的方式,从现有开源模型中“进化”出能力更强的模型。 这听起来有点玄乎,但背后是一个很实际的问题:对于大多数开发者和研究团队来说,从头训练一个大模型的成本和门槛高不可攀。那么,有没有一种方法,能像“育种”一样

weixin_33720956的博客 404

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

提示词工程:从入门到精通的完整指南(四)—— 思维链与示例,提示工程入门到精通,收藏这篇就足够了!

提示词工程:从入门到精通的完整指南(四)—— 思维链与示例,提示工程入门到精通,收藏这篇就足够了!

Y525698136的博客 2153

从零构建私有AI应用:本地部署、RAG知识库、LoRA微调与Dify编排实战指南

想用AI大模型做点自己的东西,但一上手就懵了? 看到别人用ChatGPT API轻松调用,自己却卡在本地部署的第一步;听说RAG能让模型“读懂”你的私有文档,但搜遍教程还是搞不定知识库的搭建;想针对自己的业务微调模型,又被LoRA、Adapter这些术语和复杂的代码劝退。 如果你正面临这些困境,那么这篇文章就是为你准备的。我不会空谈趋势,而是直接切入一个核心判断: 对于大多数开发者和中小团队而言,当前阶段掌握“本地部署 + RAG知识库 + 高效微调 + 应用编排”这条技术栈,是构建私有化、低成本、高可控A

weixin_30561177的博客 451

2025年最新版:Qt 学习全攻略(附超全资源合集)

这份Qt学习全攻略,专为C++开发者与GUI爱好者打造。它直击学习痛点——资料零散、路径不清晰,并提供系统化的解决方案。文章不仅包含完整的学习路线图,还推荐了一个持续更新的GitHub宝藏仓库,其中涵盖官方文档、视频课程、书籍及实战项目,助你高效入门与进阶。

qq_64978731的博客 2156

低显存LoRA微调实战:8G显卡本地部署大模型指南

参数高效微调(PEFT)是解决大语言模型训练资源瓶颈的关键技术,其核心原理是通过仅更新模型中的一小部分参数来适配新任务,从而大幅降低计算和存储开销。LoRA(Low-Rank Adaptation)作为PEFT的代表性方法,通过引入可训练的低秩矩阵来近似权重更新,在保持模型性能的同时显著减少了可训练参数量。这项技术的核心价值在于极大地降低了模型定制化的硬件门槛和成本,使得在消费级GPU上进行模型微调成为可能。其典型应用场景包括个人研究者在有限算力下的算法验证、中小企业基于私有数据的领域模型定制,以及教育场景

weixin_34259232的博客 1038
上一篇: 大语言模型入门必备:从概念到构建,一篇收藏够用的完整指南
下一篇: 【必学收藏】大模型知识增强技术:RAG实现与应用实战指南
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
